在 YARN 上运行 Flink 作业时,你有没有想过,一条 flink run-application 命令背后,YARN 是如何分配容器、启动 ApplicationMaster 的?AM 进程启动后,Flink 内部又依次启动了哪些组件?Dispatcher、ResourceManager、JobMaster 是按什么顺序启动的?Application 模式下用户 main 方法为什么在 AM 端执行?这篇从 YARN 层面的容器分配讲起,深入 Flink ApplicationMaster 内部启动流程,剖析 YarnApplicationClusterEntrypoint、ClusterEntrypoint、YarnResourceManager、ApplicationDispatcher 等核心类的源码,把 AM 从 JVM 启动到作业运行的完整链路讲透。
一、YARN Application 模式整体架构
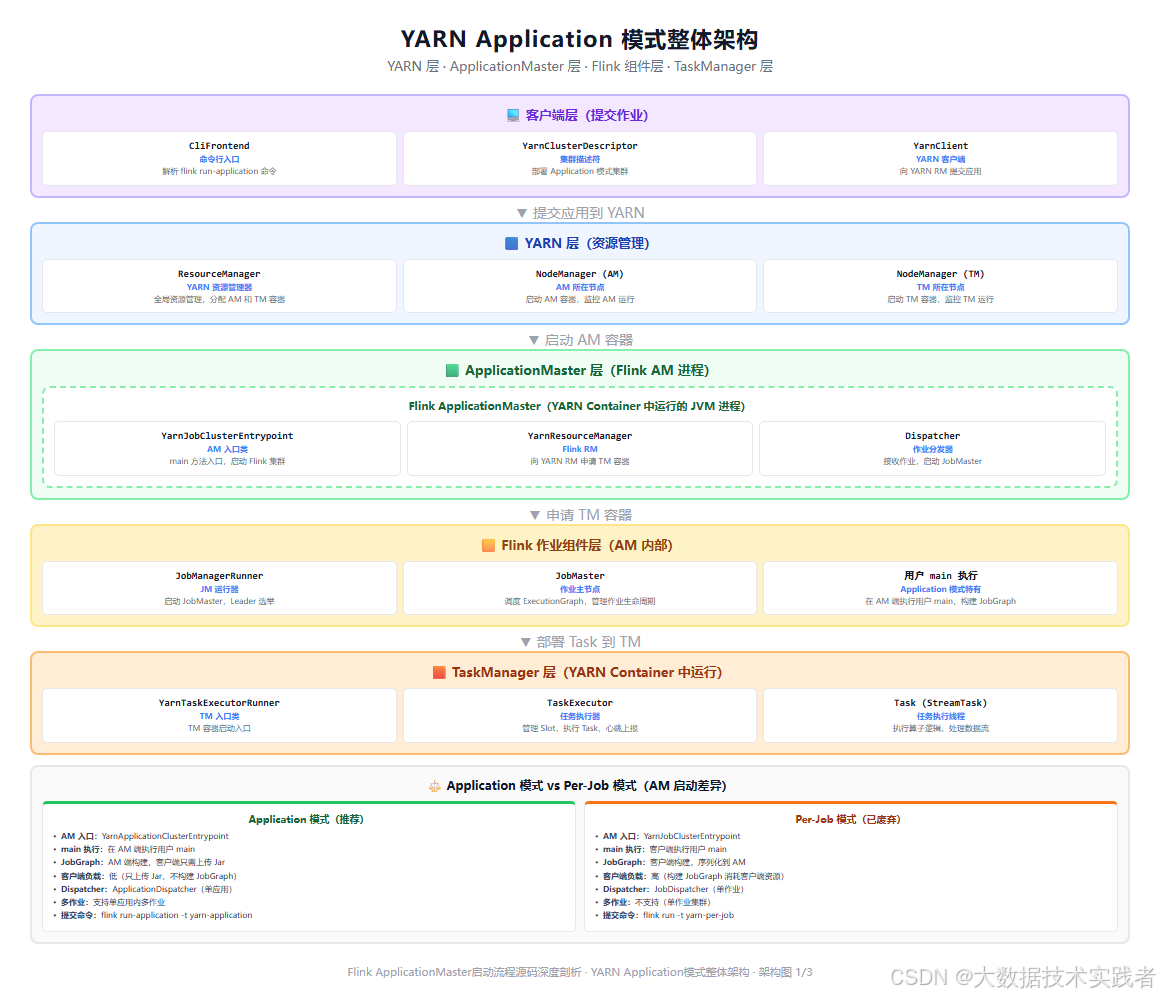
下面这张图是 YARN Application 模式整体架构,包括客户端层、YARN 层、ApplicationMaster 层、Flink 作业组件层和 TaskManager 层。
1.1 五层架构概览
YARN Application 模式下,整个系统分为五层:
客户端层 :CliFrontend 解析 flink run-application 命令,YarnClusterDescriptor 部署 Application 模式集群,YarnClient 向 YARN RM 提交应用。客户端只负责上传 Jar 和提交应用,不执行用户 main 方法。
YARN 层:ResourceManager 全局资源管理,分配 AM 容器和 TM 容器;NodeManager 启动和监控容器;AM 所在 NM 启动 AM 进程,TM 所在 NM 启动 TM 进程。
ApplicationMaster 层:Flink ApplicationMaster 是 YARN 容器中运行的 JVM 进程,入口类是 YarnApplicationClusterEntrypoint。AM 内部包含 Flink ResourceManager(YarnResourceManager)、Dispatcher(ApplicationDispatcher)、REST 端点(WebMonitorEndpoint)等核心组件。
Flink 作业组件层:AM 内部为每个作业启动 JobManagerRunner,JobManagerRunner 启动 JobMaster,JobMaster 构建 ExecutionGraph 并调度 Task。Application 模式下用户 main 方法在 AM 端执行,构建 JobGraph 后提交给 Dispatcher。
TaskManager 层:YARN 容器中运行的 TaskExecutor,入口类是 YarnTaskExecutorRunner,管理 Slot,执行 Task,向 ResourceManager 心跳和注册。
1.2 Application 模式 vs Per-Job 模式
Application 模式和 Per-Job 模式都为每个作业启动独立集群,但关键差异在于用户 main 方法的执行位置:
| 对比维度 | Application 模式(推荐) | Per-Job 模式(已废弃) |
|---|---|---|
| AM 入口类 | YarnApplicationClusterEntrypoint | YarnJobClusterEntrypoint |
| main 执行位置 | AM 端执行 | 客户端执行 |
| JobGraph 构建 | AM 端构建 | 客户端构建 |
| 客户端负载 | 低(只上传 Jar) | 高(构建 JobGraph) |
| Dispatcher | ApplicationDispatcher(单应用) | JobDispatcher(单作业) |
| 多作业支持 | 支持单应用内多作业 | 不支持 |
| 提交命令 | flink run-application -t yarn-application | flink run -t yarn-per-job |
Application 模式的核心优势:客户端只需上传 Jar 包,不构建 JobGraph,大幅降低客户端负载和网络带宽消耗;用户 main 在 AM 端执行,可以访问集群本地资源;支持单应用内多作业。Per-Job 模式已在 Flink 1.15 废弃,生产环境应使用 Application 模式。
二、YARN 层面 AM 启动流程
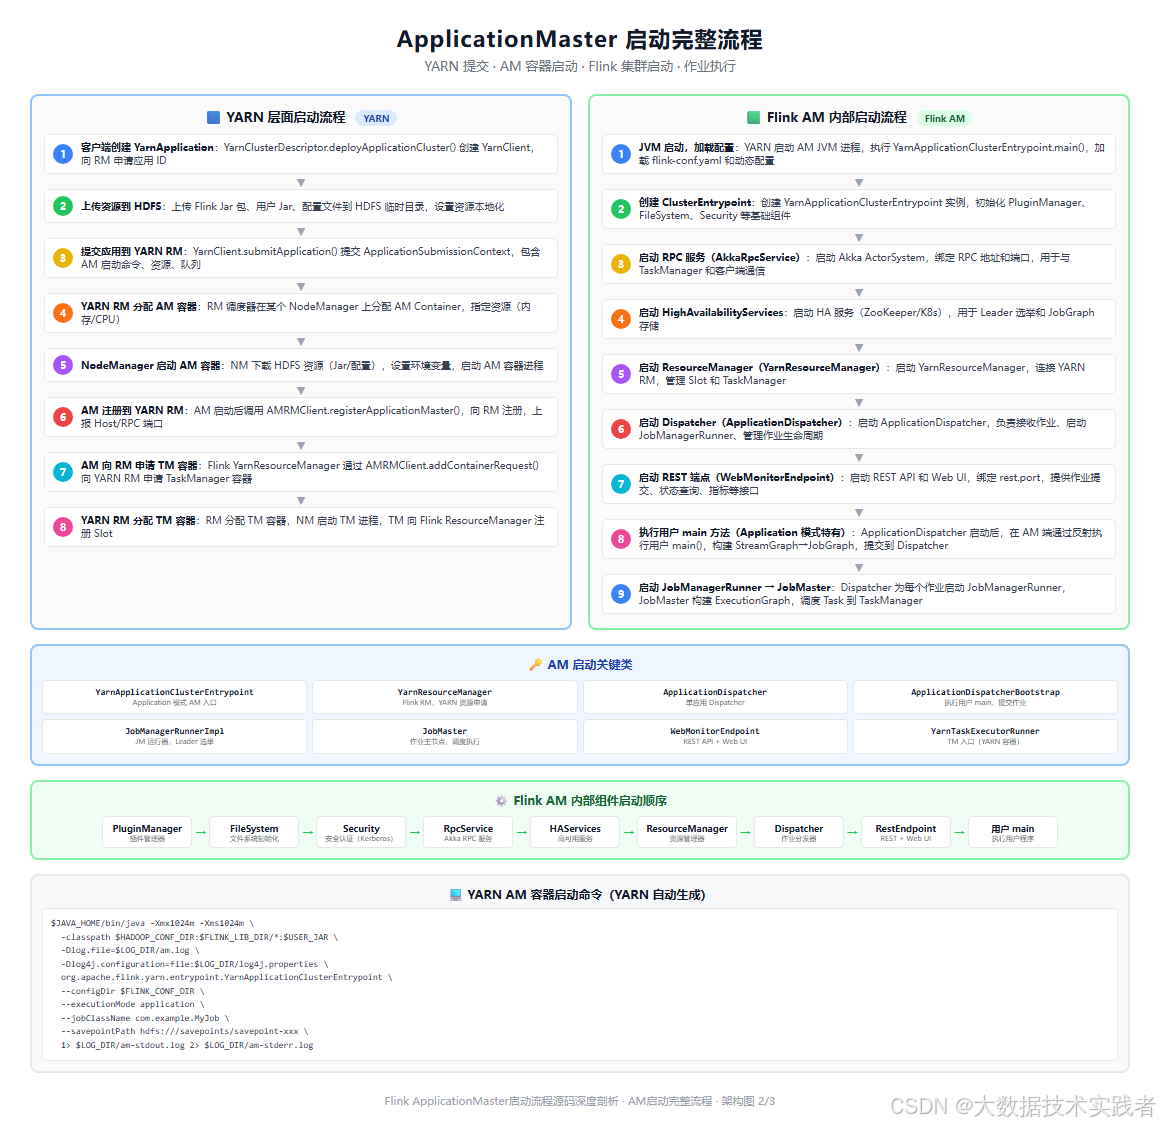
YARN 层面的 AM 启动分为8步,从客户端提交应用到 TM 容器启动:
2.1 八步启动流程
第1步:客户端创建 YarnApplication
- YarnClusterDescriptor.deployApplicationCluster() 被调用
- 创建 YarnClient,连接 YARN ResourceManager
- 调用 yarnClient.createApplication() 获取新应用 ID(ApplicationId)
第2步:上传资源到 HDFS
- 上传 Flink Jar 包(flink-dist.jar)到 HDFS 临时目录
- 上传用户 Jar 包到 HDFS
- 上传配置文件(flink-conf.yaml、log4j.properties)到 HDFS
- 设置资源本地化(LocalResource),指定 HDFS 路径、大小、时间戳、类型(FILE/ARCHIVE)
第3步:提交应用到 YARN RM
- 构建 ApplicationSubmissionContext
- 设置 AM 启动命令(ContainerLaunchContext)
- 设置 AM 资源(内存、CPU)
- 设置队列、优先级、应用名称
- 调用 yarnClient.submitApplication(context) 提交到 YARN RM
第4步:YARN RM 分配 AM 容器
- YARN RM 调度器(Capacity Scheduler / Fair Scheduler)接收应用
- 根据队列资源、优先级、用户限制等调度
- 在某个 NodeManager 上分配 AM Container
- 向该 NM 发送 ContainerLaunch 事件
第5步:NodeManager 启动 AM 容器
- NM 接收 ContainerLaunch 事件
- 从 HDFS 下载本地化资源(Jar、配置)
- 设置环境变量(JAVA_HOME、HADOOP_CONF_DIR、FLINK_CONF_DIR 等)
- 构建 AM 启动命令(java -cp ... YarnApplicationClusterEntrypoint ...)
- 启动 AM 容器进程(JVM)
第6步:AM 注册到 YARN RM
- AM JVM 启动后,YarnResourceManager 创建 AMRMClient
- 调用 amrmClient.registerApplicationMaster(host, rpcPort, trackingUrl)
- 向 YARN RM 注册 AM,上报 Host、RPC 端口、Web UI 跟踪 URL
- YARN RM 将应用状态从 ACCEPTED 改为 RUNNING
第7步:AM 向 RM 申请 TM 容器
- YarnResourceManager 根据 Slot 需求创建 ContainerRequest
- 调用 amrmClient.addContainerRequest(containerRequest)
- 向 YARN RM 申请 TaskManager 容器
- 指定资源(内存、CPU)、优先级、节点标签
第8步:YARN RM 分配 TM 容器,NM 启动 TM
- YARN RM 调度器分配 TM Container
- NM 下载资源,启动 TM 容器(YarnTaskExecutorRunner)
- TM 启动后向 Flink ResourceManager 注册 Slot
- JobMaster 部署 Task 到 TM Slot,作业开始运行
2.2 AM 启动命令
YARN 自动生成的 AM 容器启动命令大致如下:
bash
$JAVA_HOME/bin/java -Xmx1024m -Xms1024m \
  -classpath $HADOOP_CONF_DIR:$FLINK_LIB_DIR/*:$USER_JAR \
  -Dlog.file=$LOG_DIR/am.log \
  -Dlog4j.configuration=file:$LOG_DIR/log4j.properties \
  org.apache.flink.yarn.entrypoint.YarnApplicationClusterEntrypoint \
  --configDir $FLINK_CONF_DIR \
  --executionMode application \
  --jobClassName com.example.MyJob \
  --savepointPath hdfs:///savepoints/savepoint-xxx \
  1> $LOG_DIR/am-stdout.log 2> $LOG_DIR/am-stderr.log
关键参数:
--configDir:Flink 配置目录--executionMode application:执行模式(Application 模式)--jobClassName:用户作业入口类(Application 模式在 AM 端执行 main)--savepointPath:从保存点恢复(可选)
三、Flink AM 内部启动流程
AM JVM 进程启动后,Flink 内部依次启动9个阶段的组件:
3.1 九步内部启动流程
第1步:JVM 启动,加载配置
- YARN 启动 AM JVM 进程
- 执行 YarnApplicationClusterEntrypoint.main(String\[\] args)
- 解析命令行参数(--configDir、--executionMode、--jobClassName 等)
- 加载 flink-conf.yaml 配置文件
- 合并动态配置(YARN 传入的 -D 参数)
第2步:创建 ClusterEntrypoint
- 创建 YarnApplicationClusterEntrypoint 实例
- 初始化 PluginManager(加载插件)
- 初始化 FileSystem(文件系统,HDFS 等)
- 初始化 Security(安全认证,Kerberos)
- 初始化 MetricRegistry(指标注册)
第3步:启动 RPC 服务(AkkaRpcService)
- 创建 AkkaRpcService,启动 ActorSystem
- 绑定 RPC 地址(jobmanager.rpc.address,YARN 自动设置为容器 hostname)
- 绑定 RPC 端口(jobmanager.rpc.port,默认 6123)
- 用于与 TaskManager、客户端、ResourceManager 通信
第4步:启动 HighAvailabilityServices
- 根据 high-availability.type 配置创建 HA 服务
- ZooKeeper HA:创建 ZooKeeperClient,Leader 选举服务,BlobStore
- Kubernetes HA:创建 K8s Client,ConfigMap Leader 选举
- 用于 JobManager Leader 选举和 JobGraph 存储
第5步:启动 ResourceManager(YarnResourceManager)
- 创建 YarnResourceManager 实例
- 创建 AMRMClient(连接 YARN RM,申请容器)
- 创建 NMClient(管理 TaskManager 容器)
- 启动 SlotManager(管理 Slot 分配)
- 向 YARN RM 注册 AM(registerApplicationMaster)
第6步:启动 Dispatcher(ApplicationDispatcher)
- 创建 ApplicationDispatcher(单应用 Dispatcher)
- 创建 JobManagerRunnerFactory(用于启动 JobManagerRunner)
- 初始化已恢复作业(从 HA 存储恢复)
- 启动 ApplicationDispatcherBootstrap(Application 模式特有,执行用户 main)
第7步:启动 REST 端点(WebMonitorEndpoint)
- 创建 WebMonitorEndpoint(基于 Netty 的 REST 服务器)
- 绑定 rest.port(默认 8081)
- 注册所有 REST 处理器(作业提交、状态查询、指标、配置等)
- 启动 Web UI 静态资源服务
- 客户端通过 REST API 提交作业、查询状态
第8步:执行用户 main 方法(Application 模式特有)
- ApplicationDispatcherBootstrap 通过反射执行用户 main(String\[\] args)
- 用户代码创建 StreamExecutionEnvironment
- 添加 Source、Transformation、Sink
- 调用 env.execute() 触发 StreamGraph→JobGraph 构建
- JobGraph 提交给 Dispatcher(本地提交,不走 REST)
第9步:启动 JobManagerRunner → JobMaster,作业运行
- Dispatcher 为每个作业创建 JobManagerRunnerImpl
- JobManagerRunner 进行 Leader 选举(HA 模式)
- Leader 选举成功后启动 JobMaster
- JobMaster 构建 ExecutionGraph(JobGraph→ExecutionGraph)
- 向 ResourceManager 申请 Slot
- TaskManager 注册 Slot 后,JobMaster 部署 Task 到 Slot
- Task 启动,从 Source 开始消费数据,作业正式运行
3.2 内部组件启动顺序
AM 内部组件启动顺序是固定的,有严格的依赖关系:
PluginManager → FileSystem → Security → MetricRegistry → AkkaRpcService → HighAvailabilityServices → ResourceManager → Dispatcher → WebMonitorEndpoint → 用户 main → JobManagerRunner → JobMaster → TaskManager 注册 → 作业运行为什么是这个顺序:
- 基础组件(Plugin/FileSystem/Security/Metric)必须最先启动,其他组件依赖它们
- AkkaRpcService 必须在 HA 和 RM 之前启动,因为它们需要 RPC 通信
- HA 服务必须在 RM 和 Dispatcher 之前启动,因为它们需要 Leader 选举和 JobGraph 存储
- ResourceManager 必须在 Dispatcher 之前启动,因为 Dispatcher 启动 JobMaster 后需要向 RM 申请 Slot
- Dispatcher 必须在 REST 端点之前启动,因为 REST 端点需要 Dispatcher 来提交作业
- 用户 main 在 Dispatcher 启动后执行,因为需要 Dispatcher 来提交 JobGraph
- JobMaster 在用户 main 提交 JobGraph 后启动
- TaskManager 在 RM 启动后向 RM 注册,JobMaster 部署 Task
四、核心类源码剖析
4.1 YarnApplicationClusterEntrypoint
YarnApplicationClusterEntrypoint 是 Application 模式 AM 的入口类:
java
public class YarnApplicationClusterEntrypoint extends YarnJobClusterEntrypoint {

    public static void main(String[] args) {
        // 1. 解析命令行参数
        final CommandLineParser<YarnApplicationClusterConfiguration> parser =
            new CommandLineParser<>(new YarnApplicationClusterConfigurationParserFactory());
        YarnApplicationClusterConfiguration configuration = null;
        try {
            configuration = parser.parse(args);
        } catch (Exception e) {
            System.exit(1);
        }

        // 2. 安装默认文件系统
        installDefaultFileSystem(configuration.getConfigDir());

        // 3. 加载配置
        final Configuration config = loadConfiguration(configuration.getConfigDir());

        // 4. 创建并启动 ClusterEntrypoint
        final YarnApplicationClusterEntrypoint entrypoint =
            new YarnApplicationClusterEntrypoint(config, configuration);
        entrypoint.startCluster();
    }

    @Override
    protected Dispatcher createDispatcher(
            Configuration configuration,
            RpcService rpcService,
            HighAvailabilityServices haServices,
            ResourceManagerGateway resourceManagerGateway,
            BlobServer blobServer,
            HeartbeatServices heartbeatServices,
            JobManagerMetricGroup jobManagerMetricGroup,
            ExecutorService executorService) throws Exception {
        // 创建 ApplicationDispatcher(单应用)
        final ApplicationDispatcherBootstrap bootstrap =
            new ApplicationDispatcherBootstrap(
                applicationConfiguration.getJobClassName(),
                applicationConfiguration.getProgramArgs(),
                applicationConfiguration.getSavepointPath());

        return new ApplicationDispatcher(
            rpcService,
            haServices.getDispatcherLeaderElection(),
            ...
            bootstrap);
    }

    @Override
    protected ResourceManager<?> createResourceManager(
            Configuration configuration,
            ResourceID resourceId,
            RpcService rpcService,
            HighAvailabilityServices haServices,
            HeartbeatServices heartbeatServices,
            ...) throws Exception {
        // 创建 YarnResourceManager
        return YarnResourceManager.create(
            configuration,
            resourceId,
            rpcService,
            haServices,
            heartbeatServices,
            ...);
    }
}
关键逻辑:
- main 方法是 AM 进程入口,解析参数、加载配置、创建并启动 ClusterEntrypoint
- createDispatcher 创建 ApplicationDispatcher,并传入 ApplicationDispatcherBootstrap(用于执行用户 main)
- createResourceManager 创建 YarnResourceManager,连接 YARN RM 申请容器
- 继承自 YarnJobClusterEntrypoint,复用 YARN 相关的通用逻辑
4.2 ClusterEntrypoint
ClusterEntrypoint 是所有 Flink 集群入口的抽象基类,定义了标准的启动流程:
java
public abstract class ClusterEntrypoint implements AutoCloseable {
    private final Configuration configuration;
    private PluginManager pluginManager;
    private FileSystem fileSystem;
    private RpcService rpcService;
    private HighAvailabilityServices haServices;
    private ResourceManager<?> resourceManager;
    private Dispatcher dispatcher;
    private WebMonitorEndpoint<?> webMonitorEndpoint;

    public void startCluster() throws Exception {
        try {
            // 1. 初始化基础组件
            pluginManager = PluginUtils.createPluginManager(...);
            FileSystem.initialize(configuration, pluginManager);
            SecurityUtils.install(new SecurityConfiguration(configuration));
            MetricRegistry metricRegistry = createMetricRegistry(configuration);

            // 2. 启动 RPC 服务
            rpcService = createRpcService(configuration);

            // 3. 启动 HA 服务
            haServices = createHaServices(configuration, rpcService);

            // 4. 启动 BlobServer(Jar 存储)
            BlobServer blobServer = new BlobServer(configuration, haServices.createBlobStore());

            // 5. 启动 ResourceManager
            resourceManager = createResourceManager(...);
            resourceManager.start();

            // 6. 启动 Dispatcher
            dispatcher = createDispatcher(...);
            dispatcher.start();

            // 7. 启动 REST 端点
            webMonitorEndpoint = createRestEndpoint(...);
            webMonitorEndpoint.start();

        } catch (Exception e) {
            throw new FlinkException("Could not start cluster entrypoint.", e);
        }
    }

    // 抽象方法,由子类实现
    protected abstract Dispatcher createDispatcher(...);
    protected abstract ResourceManager<?> createResourceManager(...);
    protected abstract WebMonitorEndpoint<?> createRestEndpoint(...);
}
关键设计:
- startCluster 定义了标准的7步启动流程,模板方法模式
- 基础组件(Plugin/FileSystem/Security/Metric)最先初始化
- RPC → HA → BlobServer → ResourceManager → Dispatcher → REST 端点,顺序固定
- createDispatcher/createResourceManager/createRestEndpoint 是抽象方法,由子类(YarnApplicationClusterEntrypoint 等)实现
- 启动失败抛出异常,AM 进程退出,YARN 标记应用失败
4.3 YarnResourceManager
YarnResourceManager 是 Flink 在 YARN 上的 ResourceManager 实现:
java
public class YarnResourceManager extends ActiveResourceManager<YarnWorkerNode> {
    private final AMRMClient<ContainerRequest> amrmClient;
    private final NMClient nmClient;
    private final int taskManagerMemory;
    private final int taskManagerCPU;

    public static YarnResourceManager create(...) throws Exception {
        // 1. 创建 AMRMClient(连接 YARN RM)
        AMRMClient<ContainerRequest> amrmClient = AMRMClient.createAMRMClient();
        amrmClient.init(conf);
        amrmClient.start();

        // 2. 创建 NMClient(管理 TM 容器)
        NMClient nmClient = NMClient.createNMClient();
        nmClient.init(conf);
        nmClient.start();

        return new YarnResourceManager(..., amrmClient, nmClient);
    }

    @Override
    protected void initialize() throws ResourceManagerException {
        // 3. 向 YARN RM 注册 AM
        amrmClient.registerApplicationMaster(
            rpcService.getAddress(),
            rpcService.getPort(),
            webMonitorUrl);
    }

    @Override
    public CompletableFuture<Void> requestNewWorker(WorkerResourceSpec workerResourceSpec) {
        // 4. 向 YARN RM 申请 TM 容器
        final ContainerRequest containerRequest = new ContainerRequest(
            Resource.newInstance(taskManagerMemory, taskManagerCPU),
            null,  // 节点(null 表示任意节点)
            null,  // 机架
            Priority.newInstance(0));
        amrmClient.addContainerRequest(containerRequest);
        return CompletableFuture.completedFuture(null);
    }

    @Override
    public void onContainersAllocated(List<Container> containers) {
        // 5. YARN RM 分配容器回调
        for (Container container : containers) {
            // 6. 在 NM 上启动 TM 容器
            ContainerLaunchContext ctx = createTaskManagerLaunchContext();
            nmClient.startContainer(container, ctx);
        }
    }
}
关键逻辑:
- create 创建 AMRMClient(连接 YARN RM)和 NMClient(管理容器)
- initialize 向 YARN RM 注册 AM(registerApplicationMaster)
- requestNewWorker 创建 ContainerRequest,向 YARN RM 申请 TM 容器
- onContainersAllocated 是 YARN RM 分配容器的回调,调用 nmClient.startContainer 启动 TM
- TM 启动后向 Flink ResourceManager 注册 Slot
4.4 ApplicationDispatcherBootstrap
ApplicationDispatcherBootstrap 是 Application 模式特有的,负责在 AM 端执行用户 main 方法:
java
public class ApplicationDispatcherBootstrap implements DispatcherBootstrap {
    private final String jobClassName;
    private final String[] programArgs;
    private final String savepointPath;

    public ApplicationDispatcherBootstrap(
            String jobClassName,
            String[] programArgs,
            String savepointPath) {
        this.jobClassName = jobClassName;
        this.programArgs = programArgs;
        this.savepointPath = savepointPath;
    }

    @Override
    public void initialize(DispatcherGateway dispatcherGateway, FatalErrorHandler fatalErrorHandler) {
        try {
            // 1. 加载用户作业类
            Class<?> mainClass = Class.forName(jobClassName, true, Thread.currentThread().getContextClassLoader());

            // 2. 获取 main 方法
            Method mainMethod = mainClass.getMethod("main", String[].class);

            // 3. 通过反射执行用户 main 方法
            // 用户 main 内部会调用 env.execute(),构建 JobGraph 并提交给 Dispatcher
            mainMethod.invoke(null, (Object) programArgs);

        } catch (Exception e) {
            fatalErrorHandler.onFatalError(
                new FlinkException("Failed to execute application main method.", e));
        }
    }
}
关键逻辑:
- initialize 在 Dispatcher 启动后被调用
- 通过 Class.forName 加载用户作业入口类
- 反射调用 main 方法,传入程序参数
- 用户 main 内部创建 StreamExecutionEnvironment,调用 env.execute() 构建 JobGraph
- JobGraph 通过本地 DispatcherGateway 提交(不走 REST API,直接内存调用)
- main 方法执行失败调用 fatalErrorHandler,AM 进程退出
这就是 Application 模式的核心:用户 main 在 AM 端执行,客户端只需上传 Jar,不构建 JobGraph,大幅降低客户端负载。
五、AM 启动完整流程
下面这张图是 ApplicationMaster 启动完整流程,包括 YARN 层面8步和 Flink AM 内部9步,以及关键类和启动命令。
完整的 AM 启动链路可以总结为:
客户端 flink run-application
  → YarnClusterDescriptor.deployApplicationCluster
  → YarnClient.submitApplication
  → YARN RM 分配 AM Container
  → NodeManager 启动 AM JVM
  → YarnApplicationClusterEntrypoint.main
  → ClusterEntrypoint.startCluster(7步)
  → AkkaRpcService → HAServices → YarnResourceManager → ApplicationDispatcher → WebMonitorEndpoint
  → ApplicationDispatcherBootstrap.initialize(执行用户 main)
  → 用户 env.execute() → JobGraph 提交
  → Dispatcher 启动 JobManagerRunner
  → JobMaster 构建 ExecutionGraph
  → YarnResourceManager 申请 TM 容器
  → TaskManager 注册 Slot
  → JobMaster 部署 Task
  → 作业运行
六、AM 内部组件启动时序与配置
下面这张图是 Flink ApplicationMaster 内部组件启动时序与配置,包括9个阶段的时序、15个关键配置参数、6个常见问题和6条最佳实践。
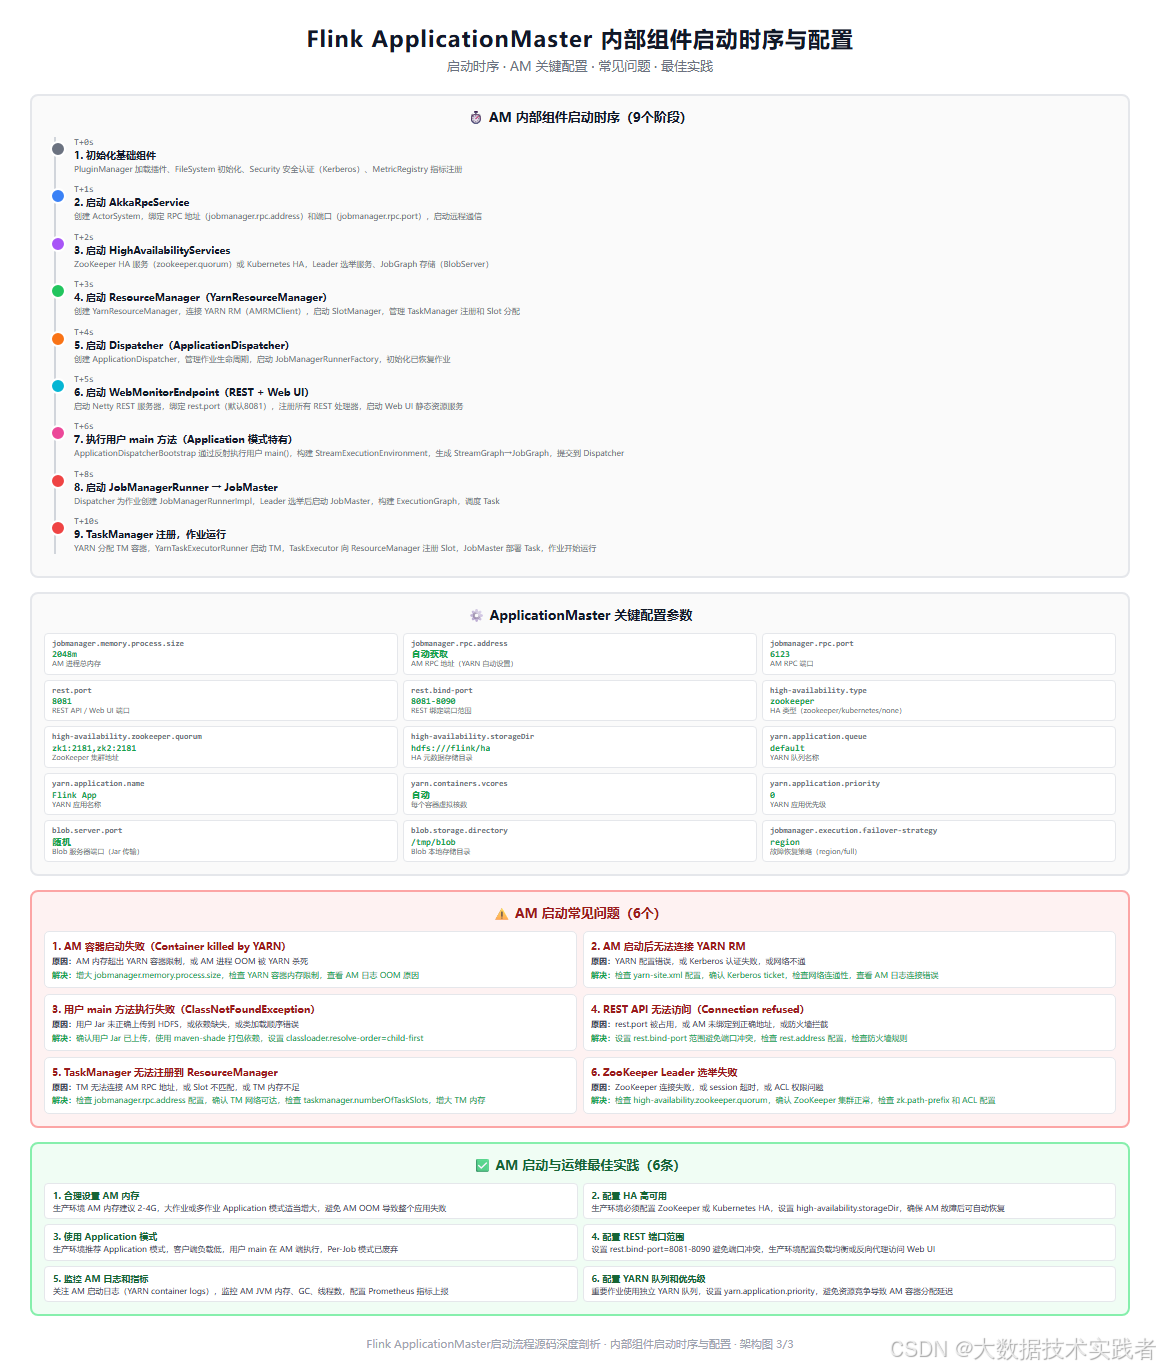
6.1 AM 关键配置参数
yaml
# AM 进程总内存(生产建议 2-4G)
jobmanager.memory.process.size: 2048m

# AM RPC 地址(YARN 自动设置为容器 hostname)
jobmanager.rpc.address: auto

# AM RPC 端口
jobmanager.rpc.port: 6123

# REST API / Web UI 端口
rest.port: 8081

# REST 绑定端口范围(避免端口冲突)
rest.bind-port: 8081-8090

# HA 类型(zookeeper/kubernetes/none)
high-availability.type: zookeeper

# ZooKeeper 集群地址
high-availability.zookeeper.quorum: zk1:2181,zk2:2181,zk3:2181

# HA 元数据存储目录
high-availability.storageDir: hdfs:///flink/ha

# YARN 队列名称
yarn.application.queue: default

# YARN 应用名称
yarn.application.name: Flink Application

# Blob 服务器端口(Jar 传输)
blob.server.port: 0

# Blob 本地存储目录
blob.storage.directory: /tmp/blob

# 故障恢复策略(region/full)
jobmanager.execution.failover-strategy: region
6.2 AM 启动常见问题
问题1:AM 容器启动失败(Container killed by YARN)
- 原因:AM 内存超出 YARN 容器限制,或 AM 进程 OOM 被 YARN 杀死
- 解决:增大 jobmanager.memory.process.size,检查 YARN 容器内存限制,查看 AM 日志 OOM 原因
问题2:AM 启动后无法连接 YARN RM
- 原因:YARN 配置错误,或 Kerberos 认证失败,或网络不通
- 解决:检查 yarn-site.xml 配置,确认 Kerberos ticket,检查网络连通性,查看 AM 日志连接错误
问题3:用户 main 方法执行失败(ClassNotFoundException)
- 原因:用户 Jar 未正确上传到 HDFS,或依赖缺失,或类加载顺序错误
- 解决:确认用户 Jar 已上传,使用 maven-shade 打包依赖,设置 classloader.resolve-order=child-first
问题4:REST API 无法访问(Connection refused)
- 原因:rest.port 被占用,或 AM 未绑定到正确地址,或防火墙拦截
- 解决:设置 rest.bind-port 范围避免端口冲突,检查 rest.address 配置,检查防火墙规则
问题5:TaskManager 无法注册到 ResourceManager
- 原因:TM 无法连接 AM RPC 地址,或 Slot 不匹配,或 TM 内存不足
- 解决:检查 jobmanager.rpc.address 配置,确认 TM 网络可达,检查 taskmanager.numberOfTaskSlots,增大 TM 内存
问题6:ZooKeeper Leader 选举失败
- 原因:ZooKeeper 连接失败,或 session 超时,或 ACL 权限问题
- 解决:检查 high-availability.zookeeper.quorum,确认 ZooKeeper 集群正常,检查 zk.path-prefix 和 ACL 配置
6.3 AM 启动与运维最佳实践
1. 合理设置 AM 内存:生产环境 AM 内存建议 2-4G,大作业或多作业 Application 模式适当增大,避免 AM OOM 导致整个应用失败。
2. 配置 HA 高可用:生产环境必须配置 ZooKeeper 或 Kubernetes HA,设置 high-availability.storageDir,确保 AM 故障后可自动恢复。
3. 使用 Application 模式:生产环境推荐 Application 模式,客户端负载低,用户 main 在 AM 端执行,Per-Job 模式已废弃。
4. 配置 REST 端口范围:设置 rest.bind-port=8081-8090 避免端口冲突,生产环境配置负载均衡或反向代理访问 Web UI。
5. 监控 AM 日志和指标:关注 AM 启动日志(YARN container logs),监控 AM JVM 内存、GC、线程数,配置 Prometheus 指标上报。
6. 配置 YARN 队列和优先级:重要作业使用独立 YARN 队列,设置 yarn.application.priority,避免资源竞争导致 AM 容器分配延迟。
七、总结
Flink ApplicationMaster 启动流程源码深度剖析要点回顾:
第一,YARN Application 模式整体架构是理解 AM 启动的基础。五层架构:客户端层(CliFrontend/YarnClusterDescriptor/YarnClient)、YARN 层(ResourceManager/NodeManager)、ApplicationMaster 层(YarnApplicationClusterEntrypoint/YarnResourceManager/ApplicationDispatcher)、Flink 作业组件层(JobManagerRunner/JobMaster/用户 main)、TaskManager 层(YarnTaskExecutorRunner/TaskExecutor)。Application 模式与 Per-Job 模式的核心差异是用户 main 在 AM 端执行,客户端负载低,Per-Job 已废弃。
第二,YARN 层面 AM 启动8步流程:客户端创建 YarnApplication → 上传资源到 HDFS → 提交应用到 YARN RM → RM 分配 AM 容器 → NM 启动 AM 容器 → AM 注册到 YARN RM → AM 申请 TM 容器 → RM 分配 TM 容器启动 TM。关键是 YARN 负责资源分配和容器启动,Flink 只负责在容器内运行自己的进程。
第三,Flink AM 内部9步启动流程:JVM 启动加载配置 → 创建 ClusterEntrypoint 初始化基础组件 → 启动 AkkaRpcService → 启动 HighAvailabilityServices → 启动 YarnResourceManager → 启动 ApplicationDispatcher → 启动 WebMonitorEndpoint → 执行用户 main(Application 模式特有)→ 启动 JobManagerRunner→JobMaster,作业运行。启动顺序有严格依赖关系:基础组件→RPC→HA→RM→Dispatcher→REST→用户 main→JobMaster。
第四,核心类源码是理解实现的关键。YarnApplicationClusterEntrypoint 是 AM 入口,main 方法解析参数启动集群,createDispatcher 创建 ApplicationDispatcher 并传入 ApplicationDispatcherBootstrap,createResourceManager 创建 YarnResourceManager。ClusterEntrypoint 是抽象基类,startCluster 定义标准7步模板方法。YarnResourceManager 创建 AMRMClient 连接 YARN RM,registerApplicationMaster 注册 AM,requestNewWorker 申请 TM 容器,onContainersAllocated 回调启动 TM。ApplicationDispatcherBootstrap 通过反射执行用户 main,是 Application 模式的核心。
第五,AM 关键配置和运维是生产实践的重点。15个关键配置包括 AM 内存、RPC 地址端口、REST 端口、HA 配置、YARN 队列、Blob 服务器、故障恢复策略。6个常见问题包括 AM 容器被杀、无法连接 YARN RM、main 执行失败、REST 无法访问、TM 无法注册、ZK 选举失败。6条最佳实践包括合理 AM 内存、配置 HA、使用 Application 模式、配置 REST 端口范围、监控 AM 日志指标、配置 YARN 队列优先级。
理解 Flink ApplicationMaster 启动流程,不仅能帮助排查 YARN 上作业启动失败的问题,更能体会到 YARN 资源管理与 Flink 计算引擎的分层协作------YARN 负责"在哪里跑"(容器分配),Flink 负责"跑什么"(作业执行)。Application 模式将用户 main 移到 AM 端执行,是 Flink 对生产环境客户端负载优化的重要设计,也是理解 Flink on YARN 架构的关键。