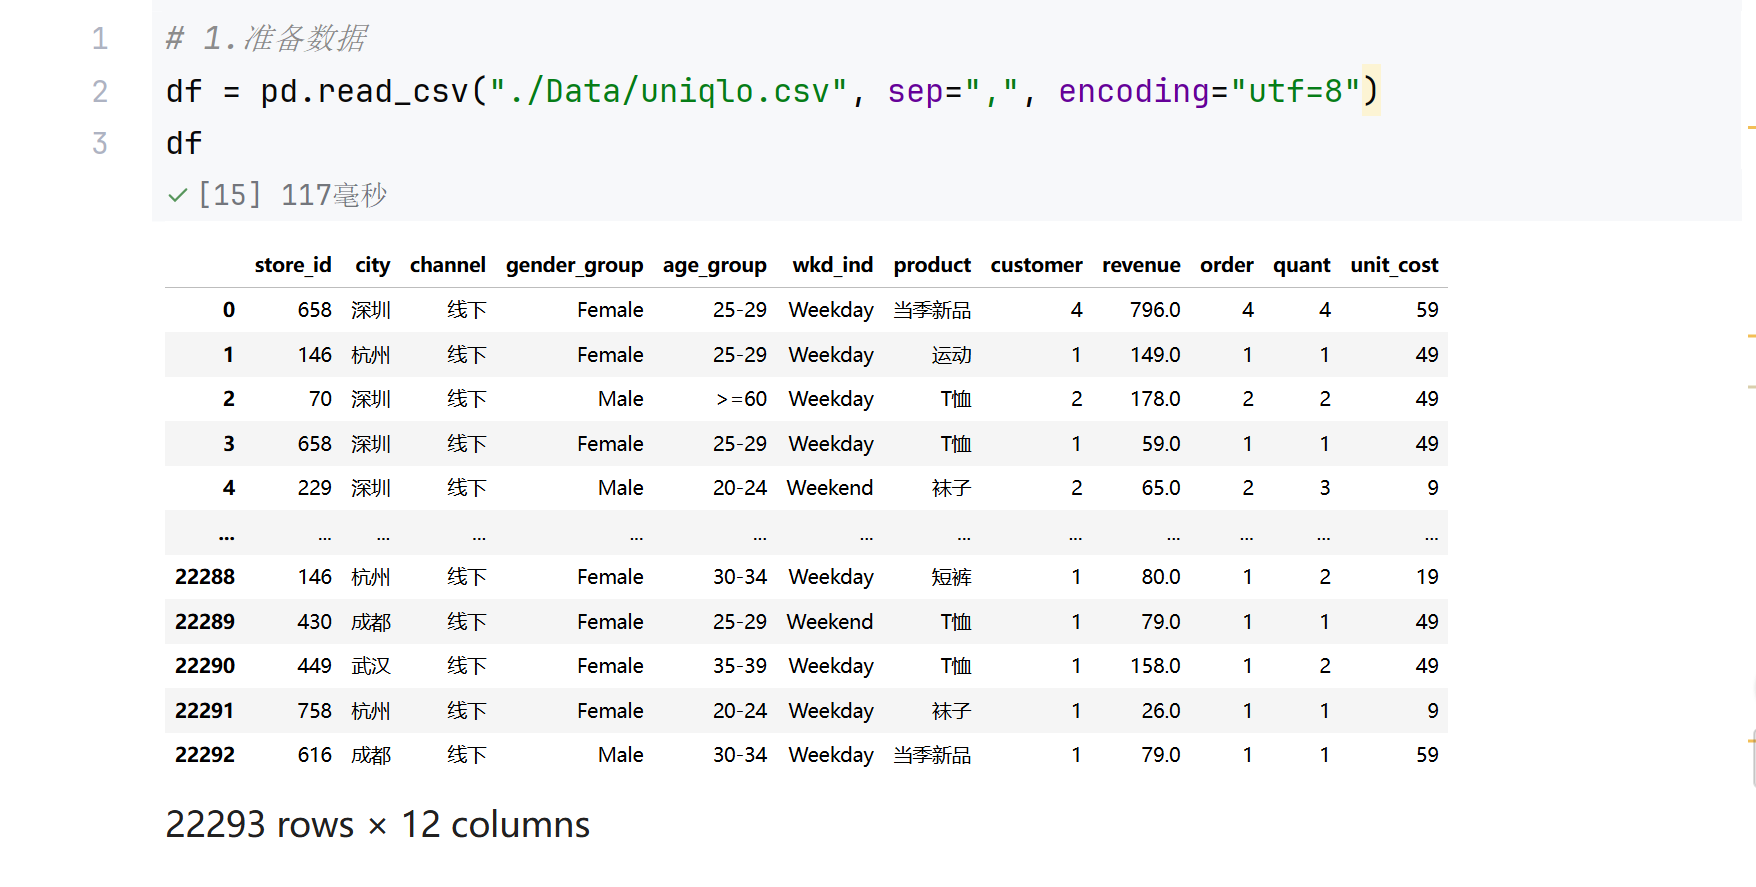
1.文件读取与存储
1.1 CSV文件读取与存储
Pandas 提供了功能完备的 CSV 读写能力,核心函数为pd.read_csv(),DataFrame.to_csv()
1.1.1 pd.read_csv()读取
语法如下:
import pandas as pd

df = pd.read_csv(文件路径)
核心参数:
- filepath_or_buffer :文件路径,支持本地路径、URL、文件对象
- sep / delimiter:字段分隔符,默认 ,
- encoding:文件编码,解决中文乱码的核心参数
- usecols:只读取指定列,传入列名列表或索引列表,大幅减少内存占用,如 usecols="name", "age"
- dtype:强制指定列的数据类型,字典形式
- index_col:指定某列作为行索引,如 index_col='id' 或者 index_col=0
当文件远超内存时,使用 chunksize 分块返回迭代器,逐块处理:
# 每次读取 10000 行,返回迭代器
chunk_iter = pd.read_csv(文件路径, chunksize=10000)

for chunk in chunk_iter:
    # 对每一块数据进行处理
    process_chunk(chunk)
1.1.2 DataFrame.to_csv()写入
语法如下:
# 最简写入:默认保留行索引、逗号分隔
df.to_csv(文件路径)

# 最常用写法:去掉行索引、兼容 Excel 中文
df.to_csv(文件路径, index=False, encoding='utf-8-sig')注意:to_csv()执行时默认会将行索引写入文件,因此绝大多数场景都需要添加 index=False 去掉冗余索引列
核心参数:
- path_or_buf:输出文件路径或文件对象
- sep:输出分隔符,默认 ,
- encoding:输出编码,中文场景推荐 'utf-8-sig'(Excel 打开不乱码)
- index :是否写入行索引,默认 True,高频使用 index=False
- columns:输出指定列
- header:是否写入列名表头,默认 True;追加写入时设为 False 避免重复表头
- mode:写入模式,默认 'w' 覆盖;设为 'a' 为追加模式,适合分批写入
特殊的CSV文件:TSV文件
- CSV文件:以 , 分隔字段数据
- TSV文件:以 /t 制表符 分隔字段数据
1.2 MySQL数据库读取与存储
Pandas 通过 SQLAlchemy 抽象层对接 MySQL,统一使用 read_sql 读取,to_sql 写入,屏蔽不同数据库的语法差异,是数据分析场景下最常用的读写方案
1.2.1 环境准备与连接创建
1.环境准备
pip install pymysql

pip install sqlalchemy- sqlalchemy :Pandas 官方推荐的数据库抽象层,负责连接管理与 SQL 生成
- pymysql :Python 对接 MySQL 的原生驱动
2.创建数据库连接引擎
from sqlalchemy import create_engine

engine = create_engine("mysql+pymysql://root:xiaoyan@localhost:3306/test1?charset=utf8")
# mysql:表示数据库类型
# pymysql:表示python对接数据库的驱动
# root:xiaoyan:表示数据库的用户名和密码
# localhost:3306:表示数据库的地址和端口
# test:表示数据库的名称
# charset=utf8:表示数据库的编码方式
1.2.2 pd.read_sql()读取
pd.read_sql():既支持直接读取整张表,也支持执行自定义 SQL 查询
1.读取整张表:
# 直接传入表名,等价于 select * from area
df = pd.read_sql(表名, con=engine)
2.执行自定义 SQL 查询:
sql = """
SELECT id, name
FROM area
WHERE parent_id = 110000
"""

# 传入sql语句
df = pd.read_sql(sql, con=engine)
核心参数:
- sql:表名 / 完整 SQL 语句,是同一个参数的两种用法
- con:数据库连接引擎
- index_col:指定某列作为 DataFrame 的行索引,如 index_col="id"
- chunksize:分块读取大表,返回迭代器,避免内存溢出
- columns:指定读取列
- pd.read_sql_table(表名,con):仅用于读取整张表,支持更细的表级别参数
- pd.read_sql_query(SQL语句,con):仅用于执行 SQL 查询
- pd.read_sql()是前两者的智能封装,绝大多数场景直接用它即可
1.2.3 DataFrame.to_sql()写入
DataFrame.to_sql() :自动建表、类型映射,支持追加 / 覆盖等多种写入模式
语法如下:
df.to_sql(
    name=表名,  # 目标表名
    con=连接引擎名,       # 连接引擎【必填】
    index=False,      # 不写入行索引
    if_exists="append" # 表已存在时的处理策略
)
核心参数:
- if_exists :如果表存在的处理方式
- fail:默认,表存在则报错
- replace:删除原表重建后写入
- append:在原表后追加数据
- index :是否将 DataFrame 行索引写入数据库,推荐设为 False
- **dtype:**字典形式,手动指定字段的数据类型
- chunksize:分批写入的行数
- method:写入方式
1.3 JSON文件读取与存储
Pandas 通过 pd.read_json() 解析读取 JSON 数据,通过 DataFrame.to_json() 将数据写入 JSON 文件
1.3.1 pd.read_json () 读取
语法如下:
import pandas as pd


df = pd.read_json(文件路径)
核心参数:
- path_or_buf :文件路径,可填入JSON 文件路径、URL 或 JSON 字符串
- orient :JSON 数据的结构格式,不指定时 Pandas 会自动推断
- encoding :文件编码,默认 utf-8
- typ :返回类型,
- frame:默认,返回 DataFrame
- series:返回 Series
- lines :是否按逐行 JSON(JSONL)格式读取
- False:默认
- True:每行一个 JSON 对象
- nrows:只读取前 N 行,仅 lines=True 时生效
1.3.2 常见 JSON 格式与对应读取方式
JSON 没有统一的表结构,不同 orient 对应不同的数据组织形式,以下是最常用的 5 种:
1.split格式
典型结构长这样,固定分成 columns,index,data 三块:
{
  "columns": ["id", "name"],
  "index": [0, 1],
  "data": [
    [1, 北京],
    [2, 上海]
  ]
}
2.records 格式(最通用,数组对象)
结构如下:
[
    {"id":1, "name":"北京"},
    {"id":2, "name":"上海"}
]
3.columns 格式(按列存储)
Pandas 默认写入的格式,按列维度组织数据:
{
    "id":{"0":1, "1":2},
    "name":{"0":"北京", "1":"上海"}
}
4.index 格式(按索引存储)
按行索引维度组织数据:
{
    "0":{"id":1, "name":"北京"},
    "1":{"id":2, "name":"上海"}
}
5.逐行 JSON
每行一个独立 JSON 对象:
{"id":1, "name":"北京"}
{"id":2, "name":"上海"}
读取代码:
df = pd.read_json("data.jsonl", lines=True)1.3.3 DataFrame.to_json()写入
语法如下:
# 最简写入
df.to_json(文件路径)

# 最常用写法:中文正常显示、格式化缩进、通用records格式
df.to_json(文件路径, orient="records", force_ascii=False, indent=2)
核心参数:
- path_or_buf(必填):输出的文件路径,不填则直接返回 JSON 字符串
- orient:输出的 JSON 结构格式,默认 columns
- force_ascii :是否强制转义中文为 Unicode
- True:默认
- 中文文件必须设为 False
- indent:缩进空格数,设置后 JSON 会格式化换行
- index :是否包含行索引
- True:默认
- orient=records 时推荐设置 False 避免冗余
- lines:是否输出为逐行 JSONL 格式,默认False
- double_precision:浮点数保留的小数位数,默认 10 位
2.DataFrame 数据的增删改查,去重操作
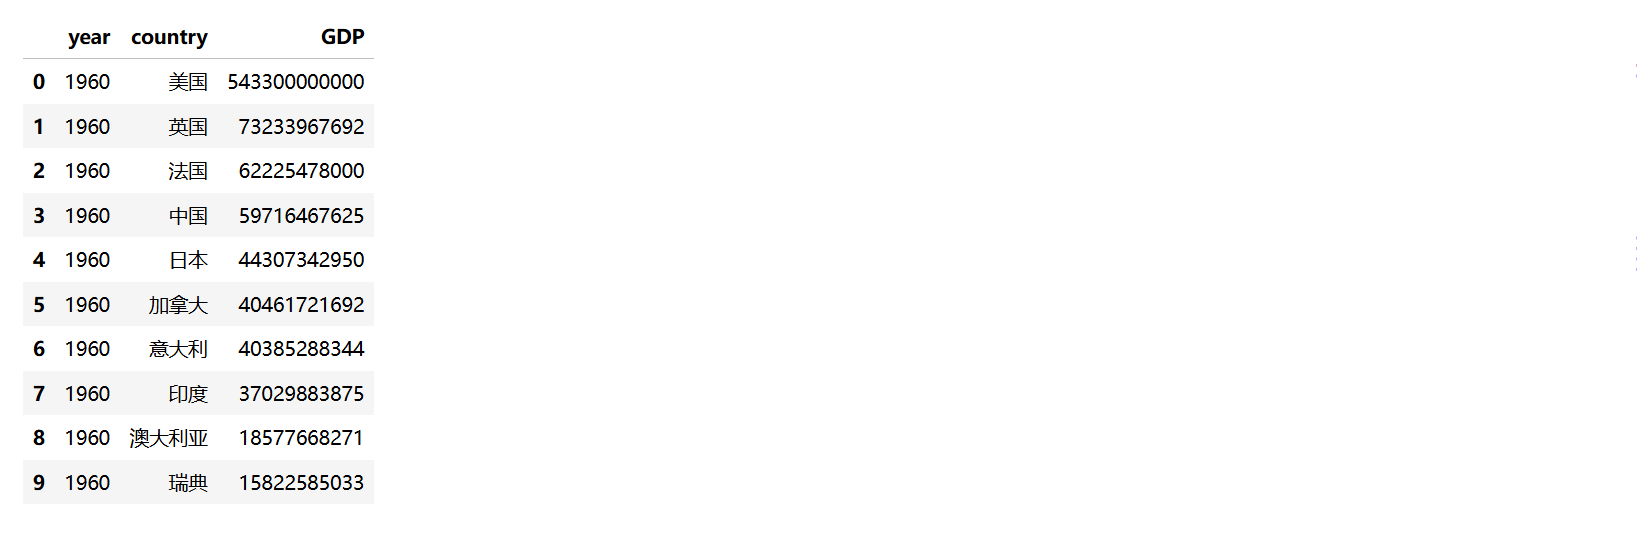
下面用统一的示例数据,演示查询、新增、修改、删除四类核心操作
2.1 增加
分为新增列 和新增行两类场景
2.1.1 新增列
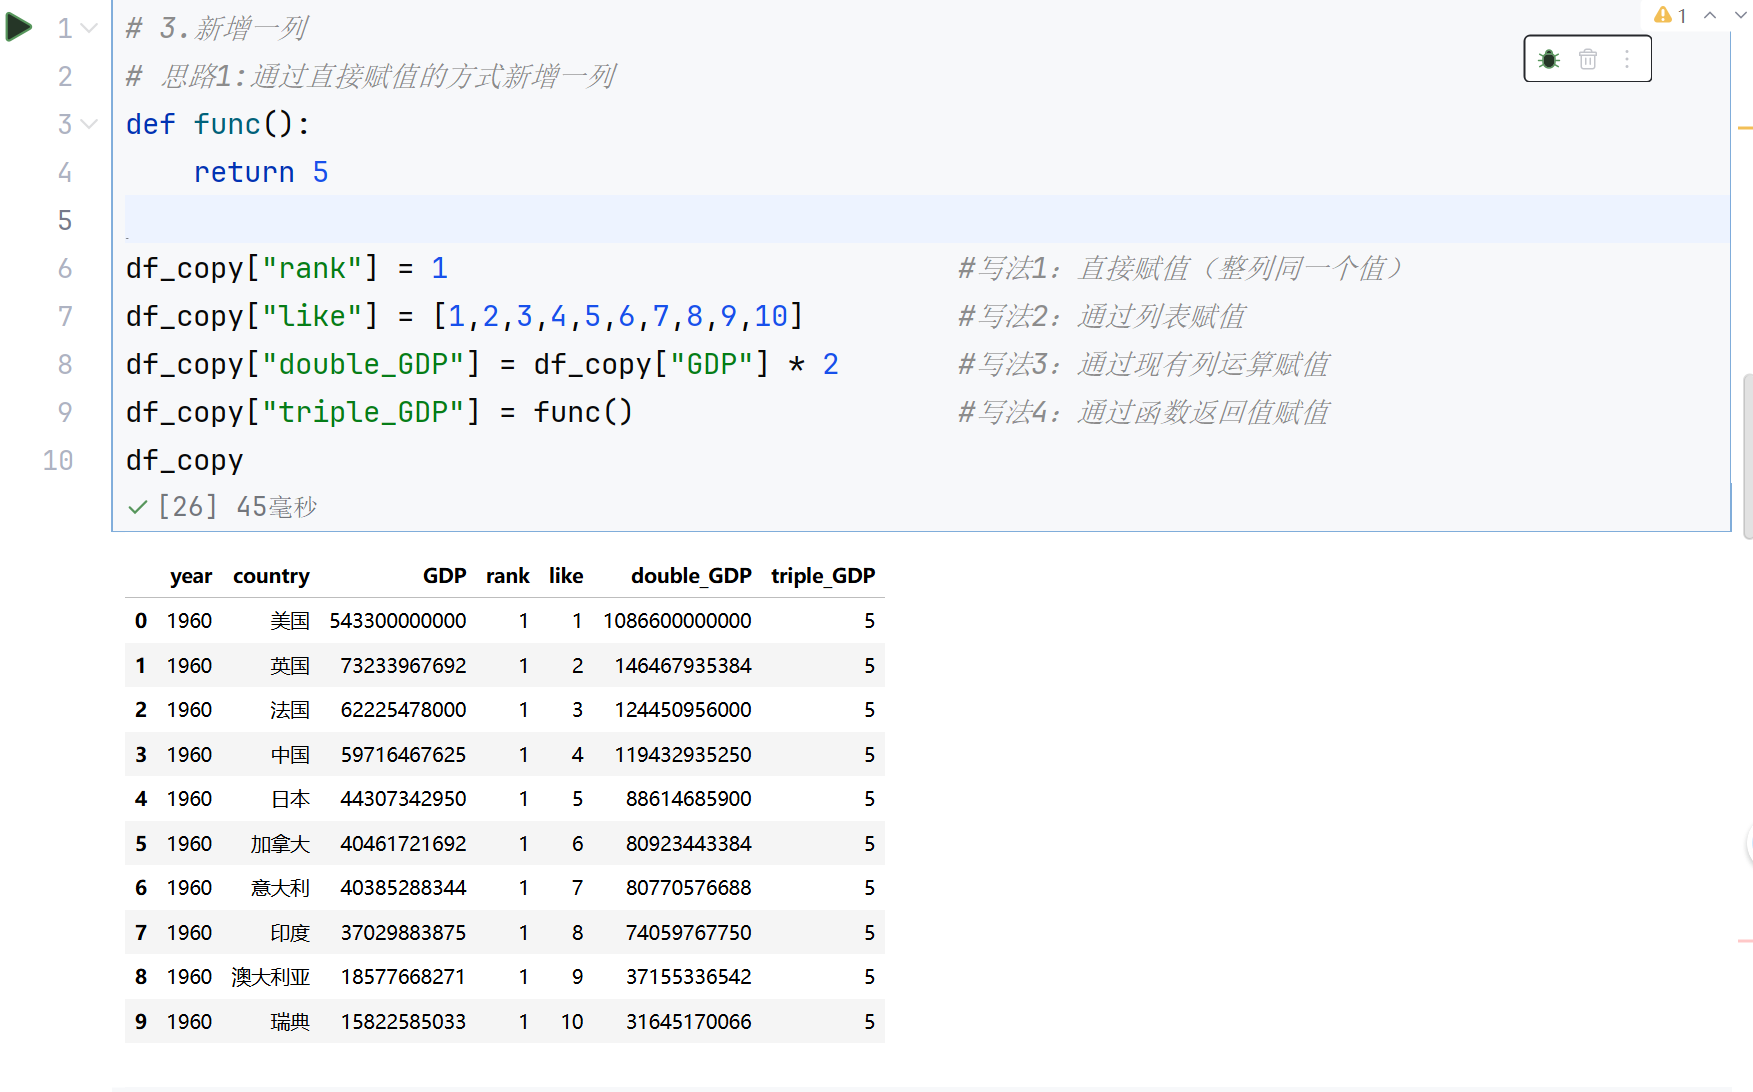
思路1:通过直接赋值的方式新增一列
- 标量赋值
- 列表赋值
- 现有列运算赋值
- 函数返回值赋值
思路2:通过 assign()方法新增 1 / n 列
语法如下:
df = df.assign(列名1=[直接赋值法], 列名2=[直接赋值法], ...)示例如下:
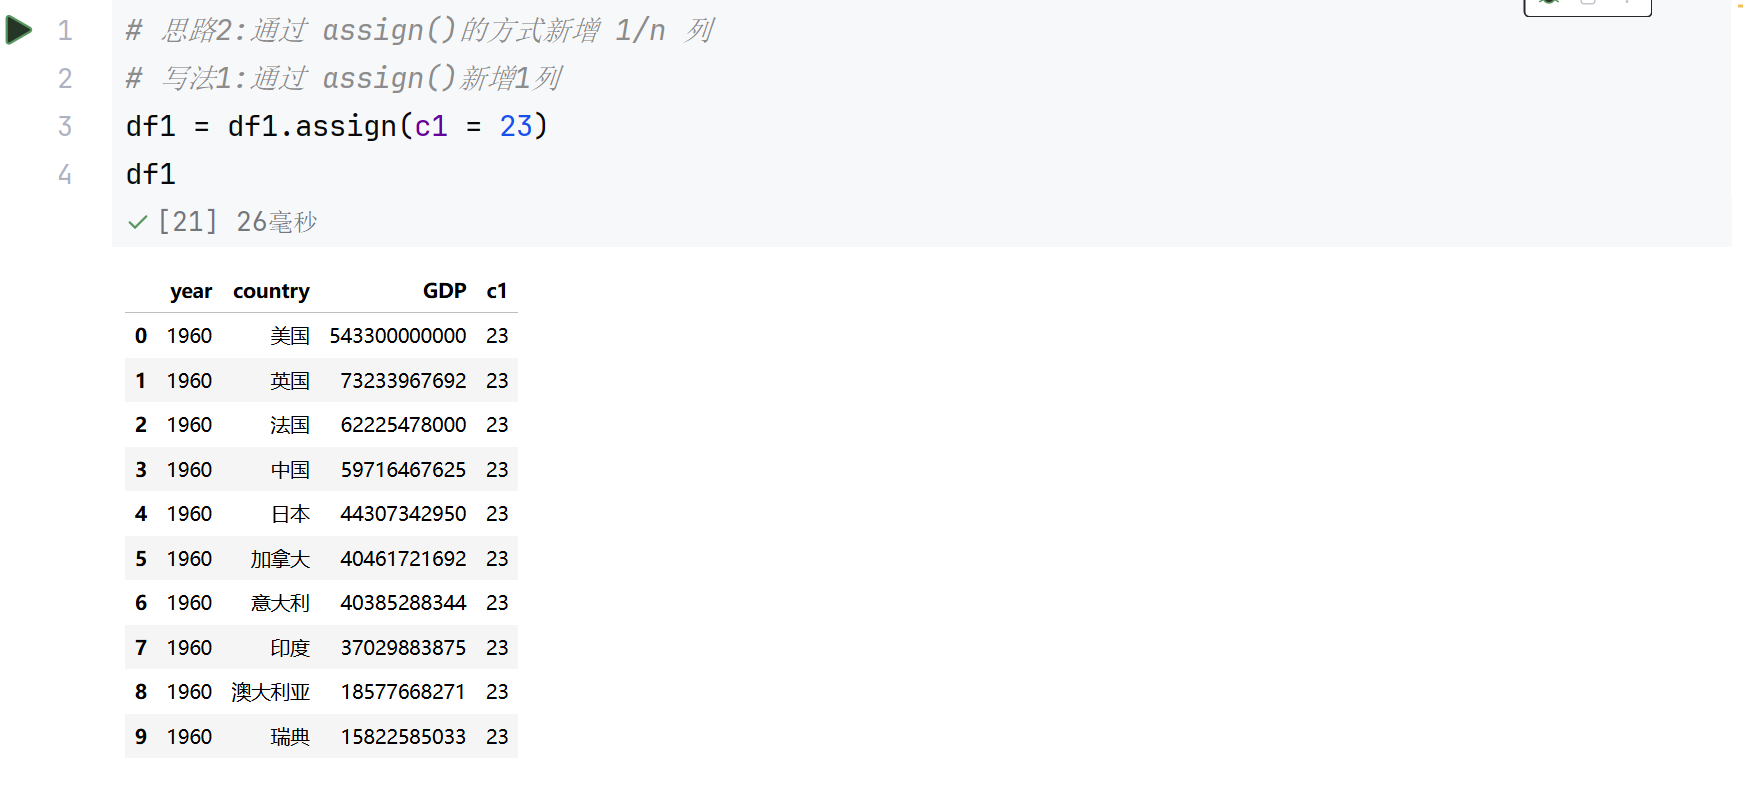
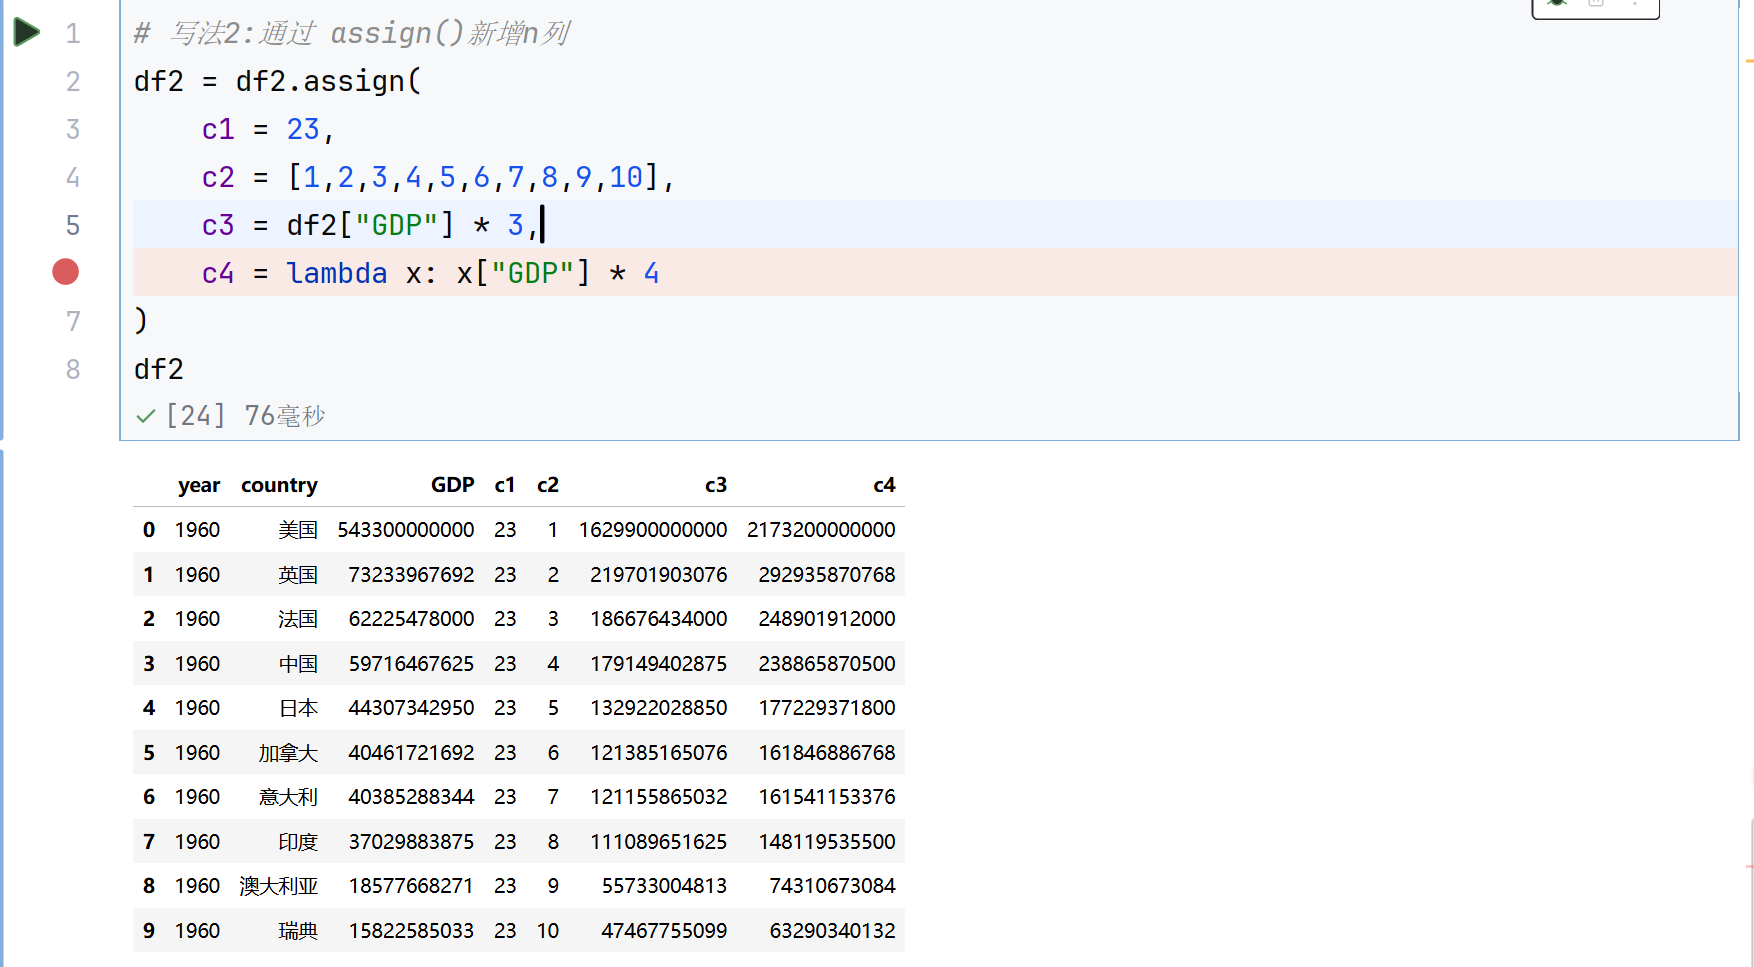
注意:assign()是 Pandas 的**不可变操作,**它不会改动原来的 DataFrame,只会返回一个新增列后的新对象
2.1.2 新增行
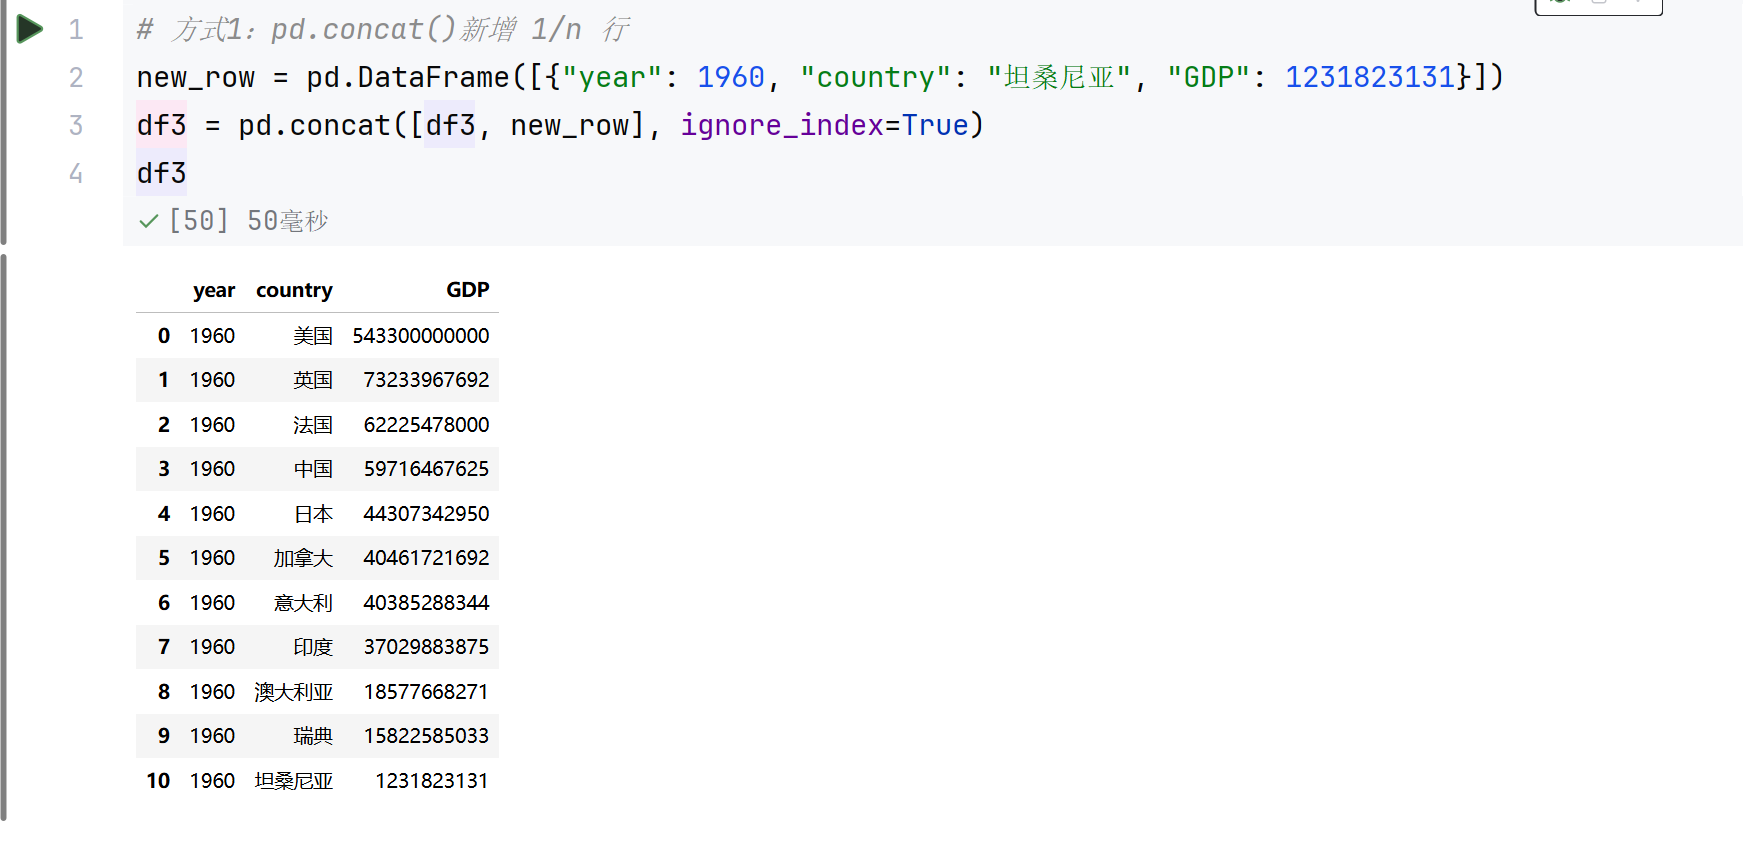
方式1:使用 pd.concat()
核心参数:
- objs :要拼接的对象列表,形式为 DataFrame / Series 对象1,DataFrame / Series 对象2,可以传入DataFrame、Series,支持同时拼接多个
- axis :拼接方向
- 0 :默认,纵向拼接,上下堆叠,
- 1:横向拼接,左右并排 ignore_index
- ignore_index :是否重置行索引
- False:默认,保留每个表原来的索引
- True:扔掉所有原表的行索引,重新生成
0,1,2...连续不重复的新索引
方式2:loc 按索引追加
df.loc[行索引] = [数据1, 数据2, ...]示例如下:
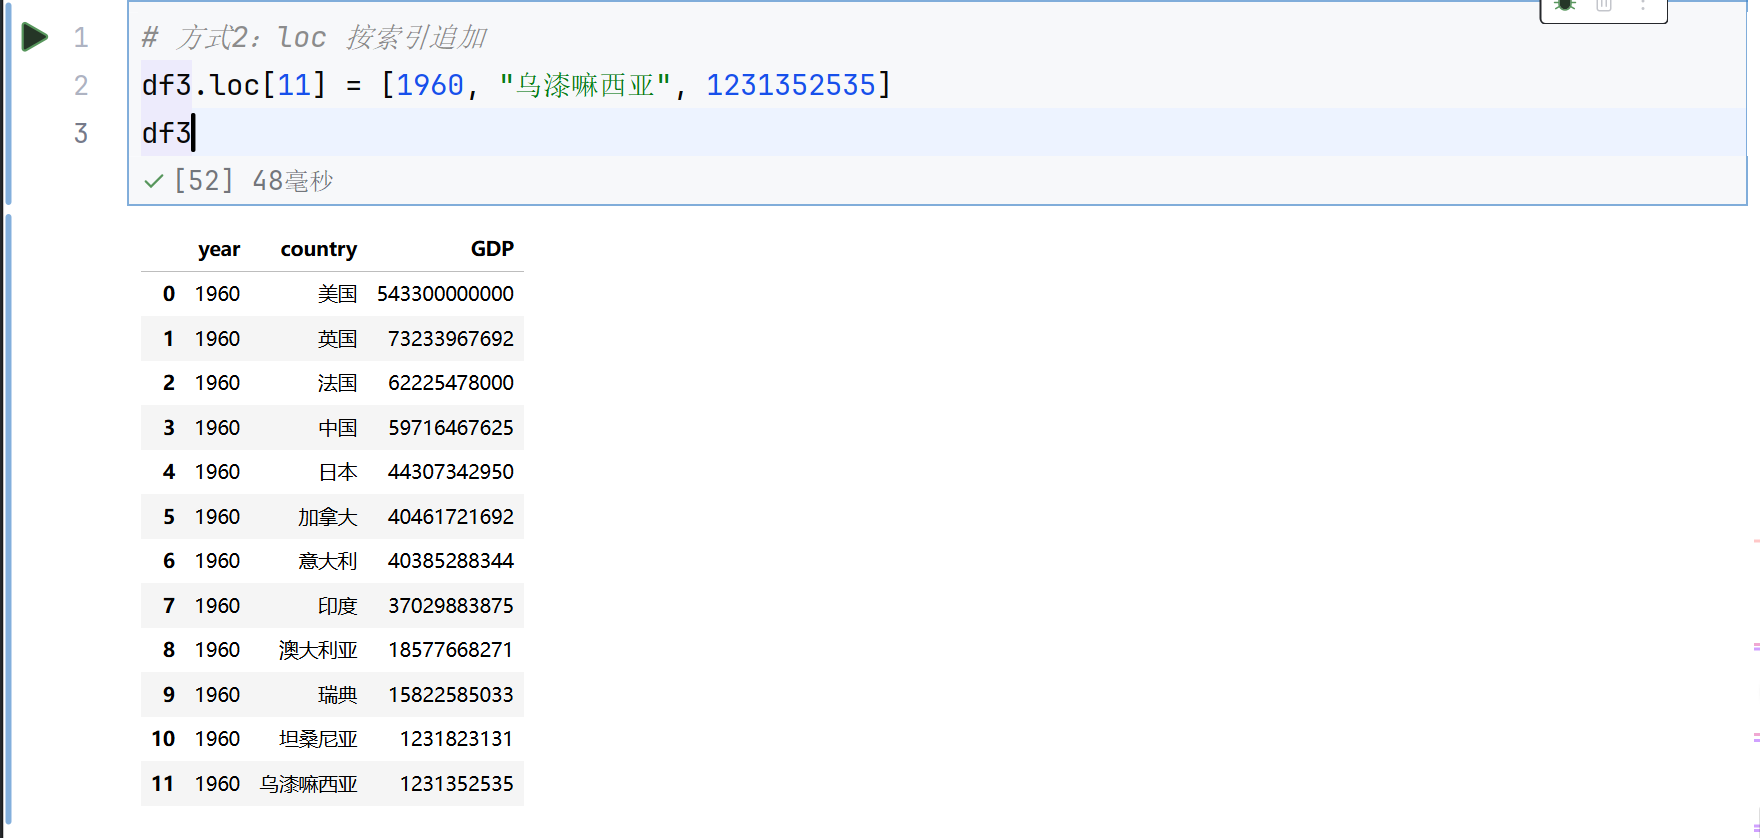
2.2 删除
df.drop():用于删除 行/列 数据
- axis = 0:表示操作行(默认值)
- axis = 1:表示操作列
2.2.1 删除行数据
语法如下:
df = df.drop([行索引1, 行索引2, ...], axis=0)2.2.2 删除列数据
语法如下:
df = df.drop([列索引1, 列索引2, ...], axis=1)使用 del 删除指定的列
del df[列索引1, 列索引2, ...]
- del 是直接删除原 df 中的列
- drop 是返回删除后的 df / Series,原 df / Series 没有被修改
示例如下:
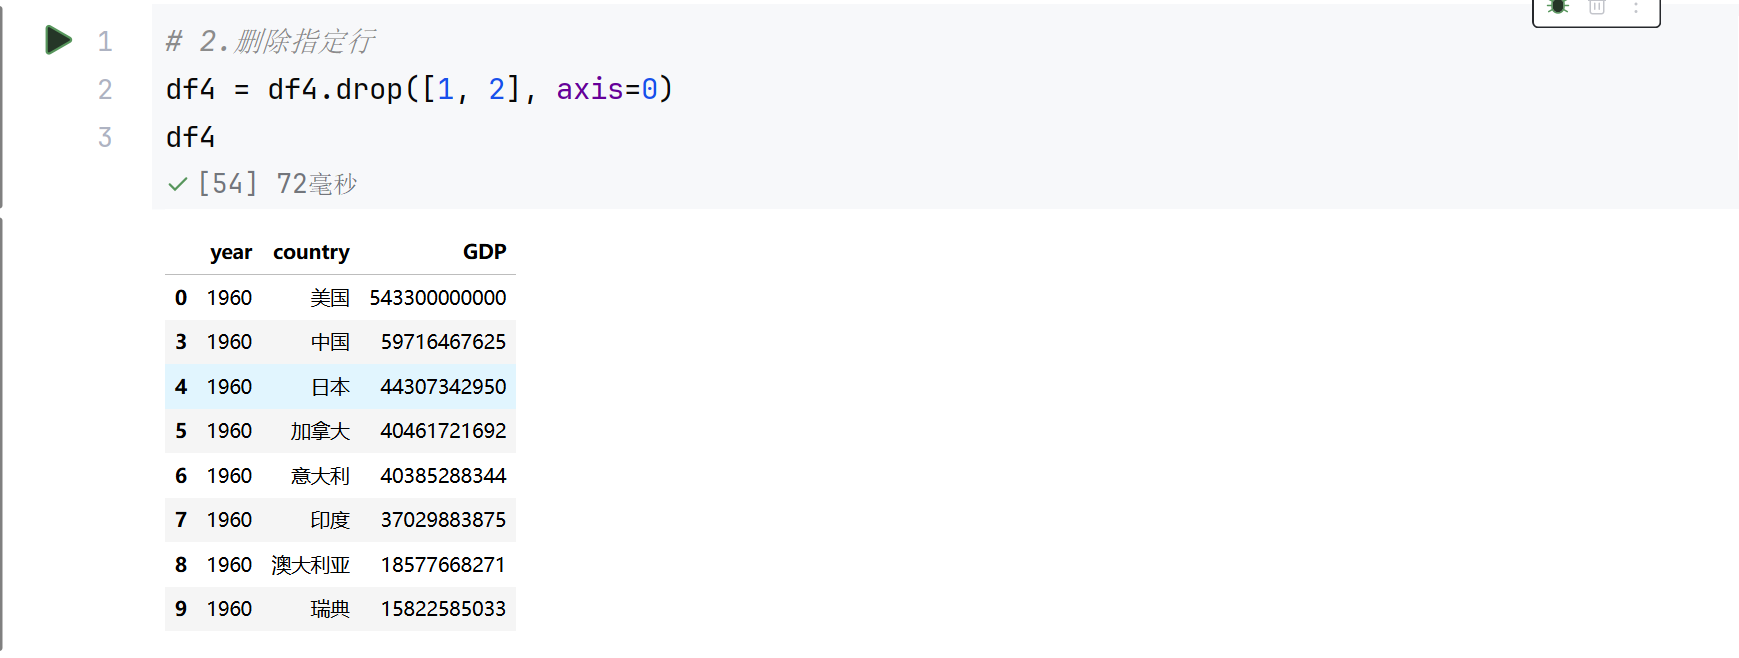
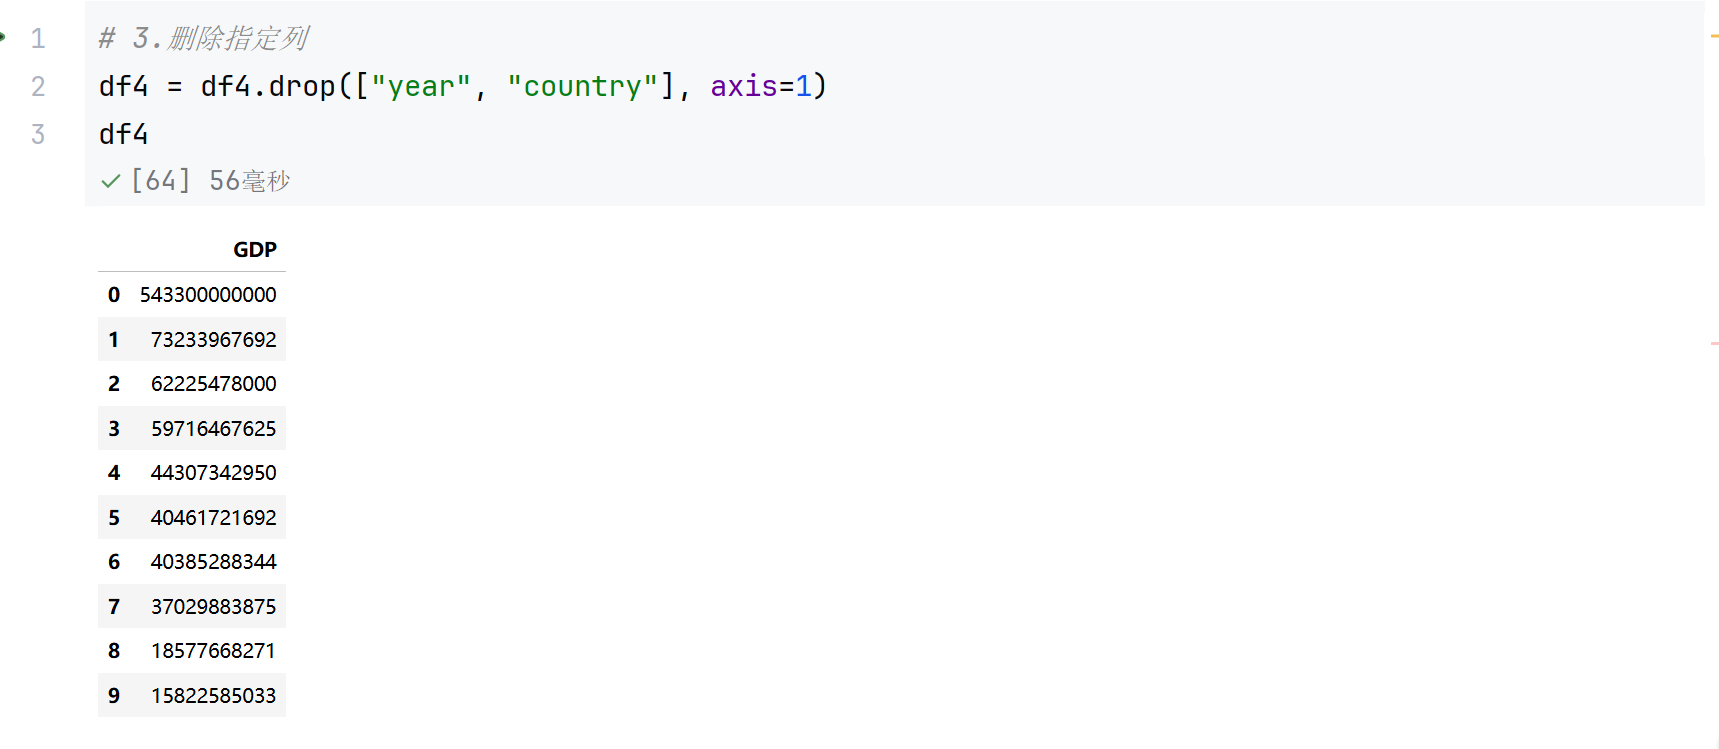
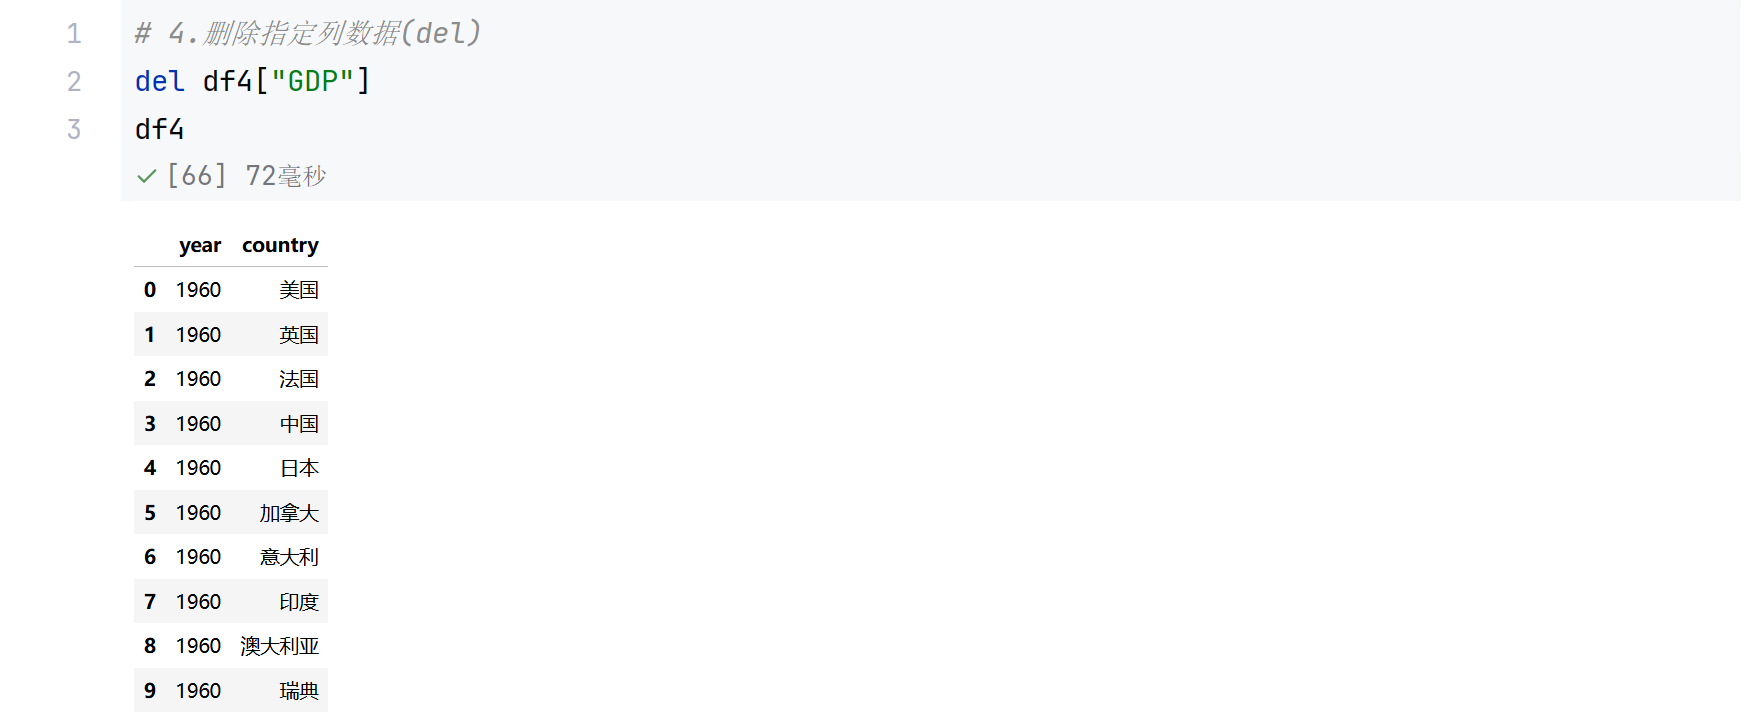
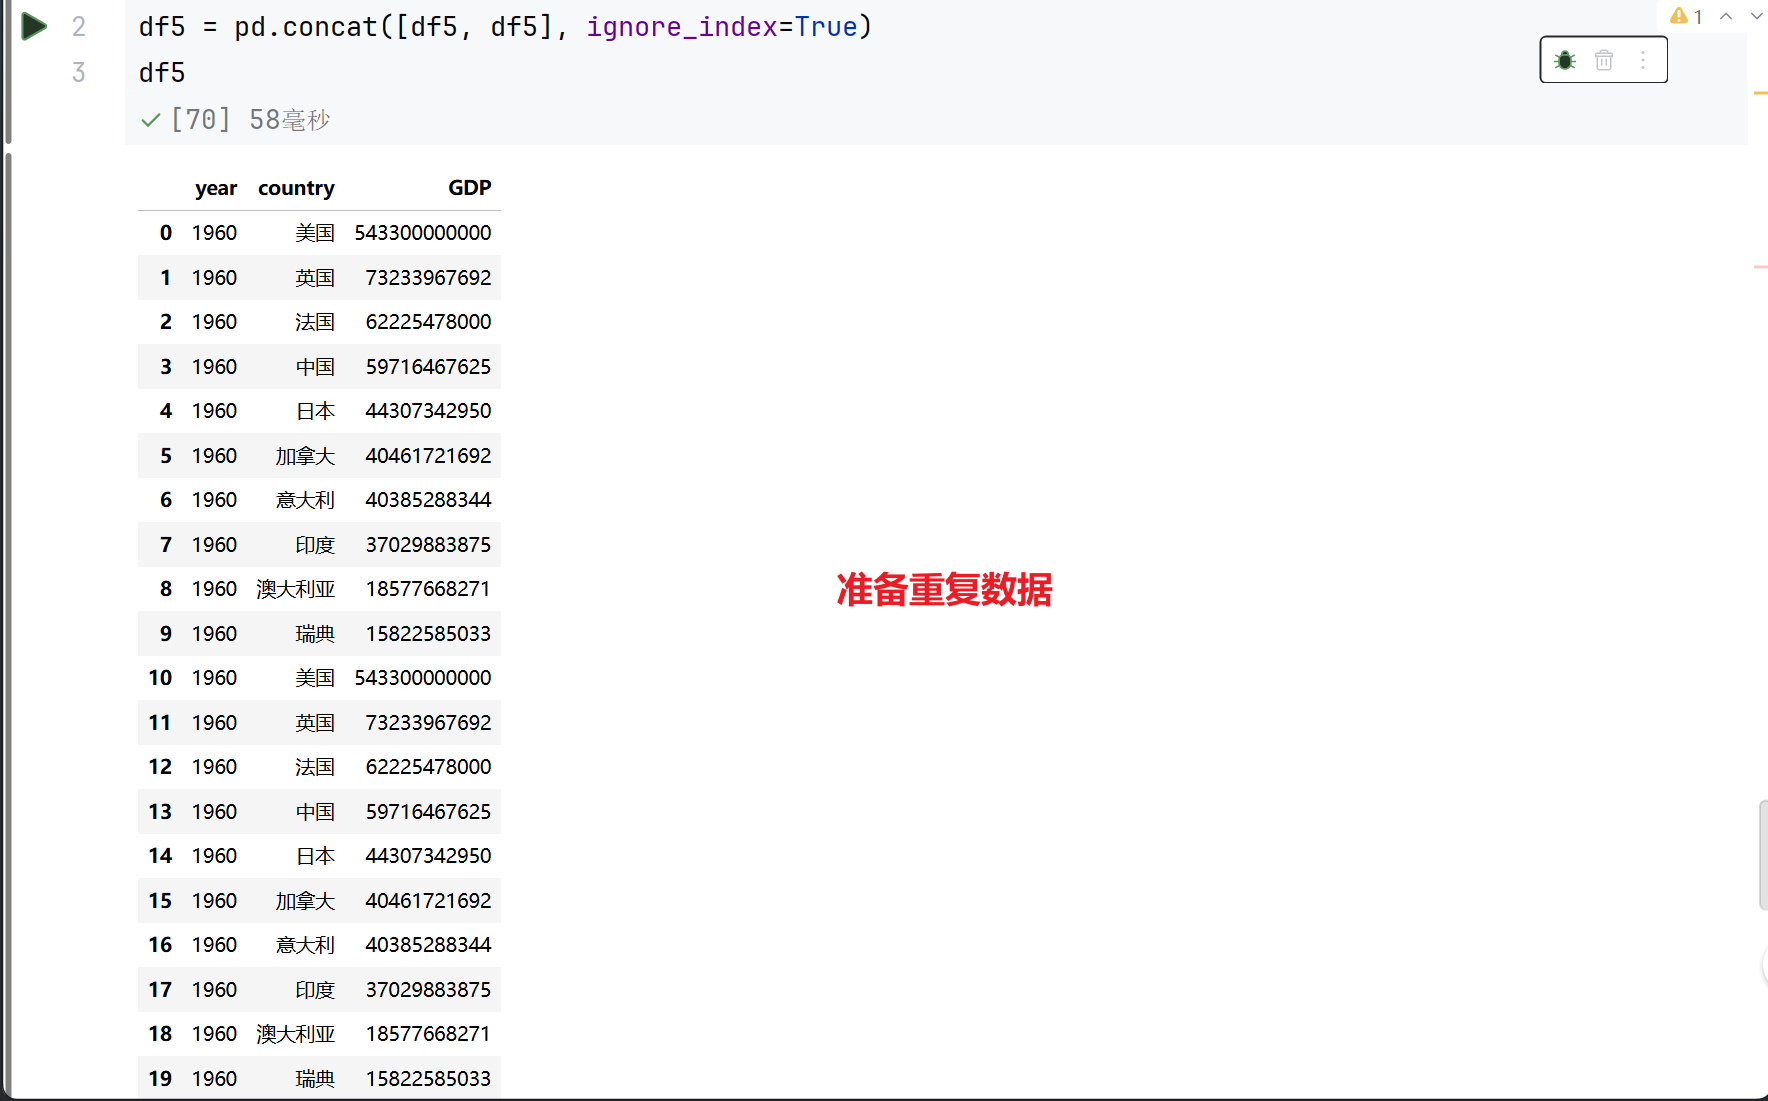
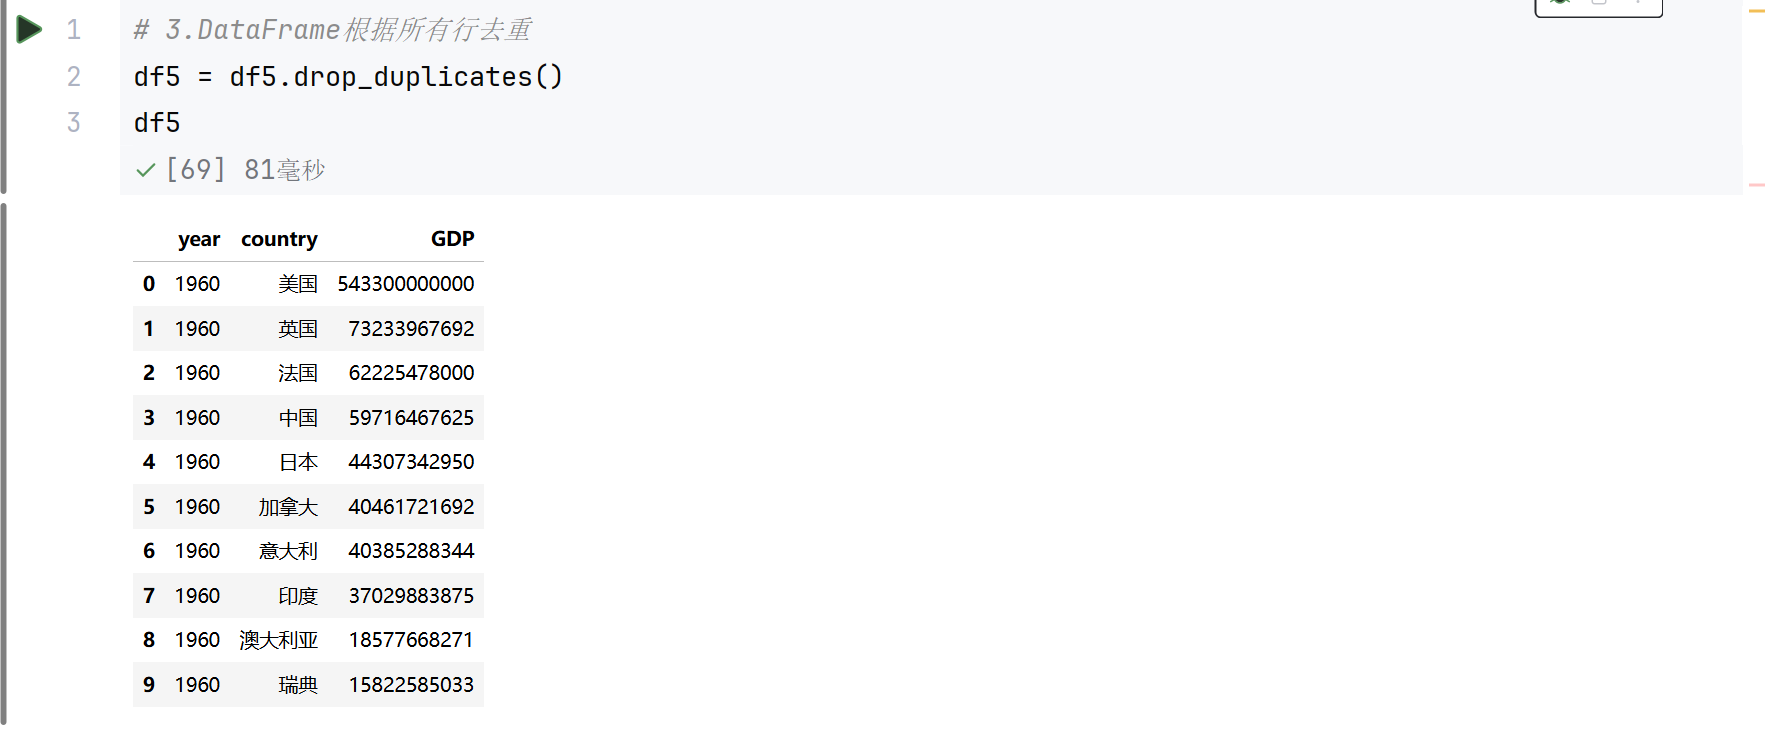
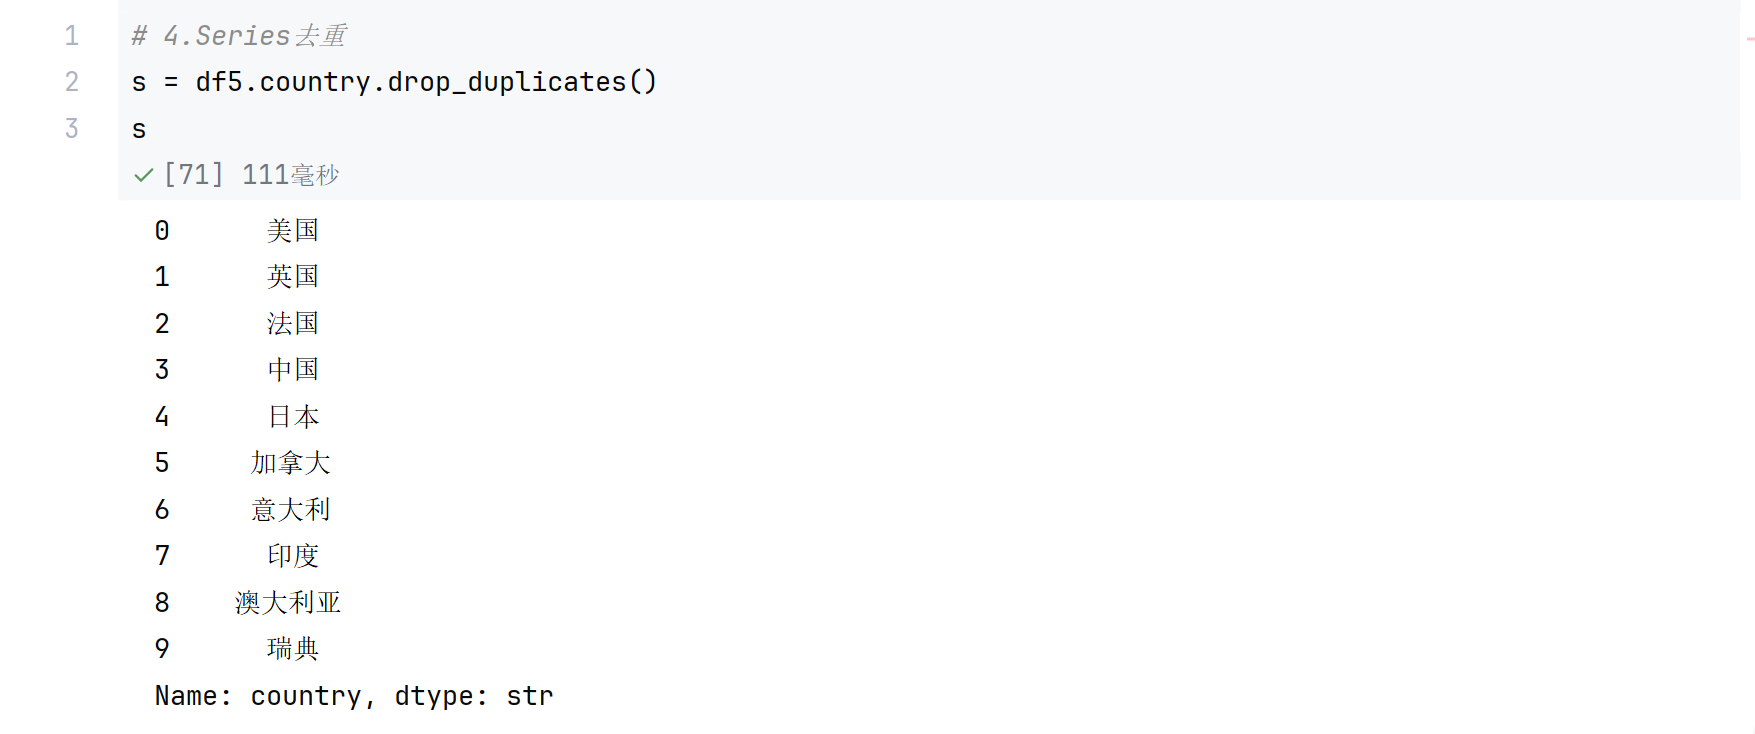
2.3 去重
Pandas 去重的核心方法是df.drop_duplicates()
核心参数:
- subset :指定按哪些列判断重复;默认不写时,整行所有列都参与对比
- keep: 重复行的保留规则
- "first"(默认):保留第一条出现的
- "last":保留最后一条出现的
- "False":删除所有重复行,一条都不保留
- ignore_index :去重后是否重置行索引
- False:默认,保留原索引编号
- Ture:重新生成 0,1,2... 连续索引
- inplace:是否直接修改原数据,默认 Fasle
2.3.1 DataFrame行数据去重
df = df.drop_duplicates(subset=[字段1, 字段2, ...])2.3.2 Series数据去重
s = s.drop_duplicates()示例:
2.4 修改
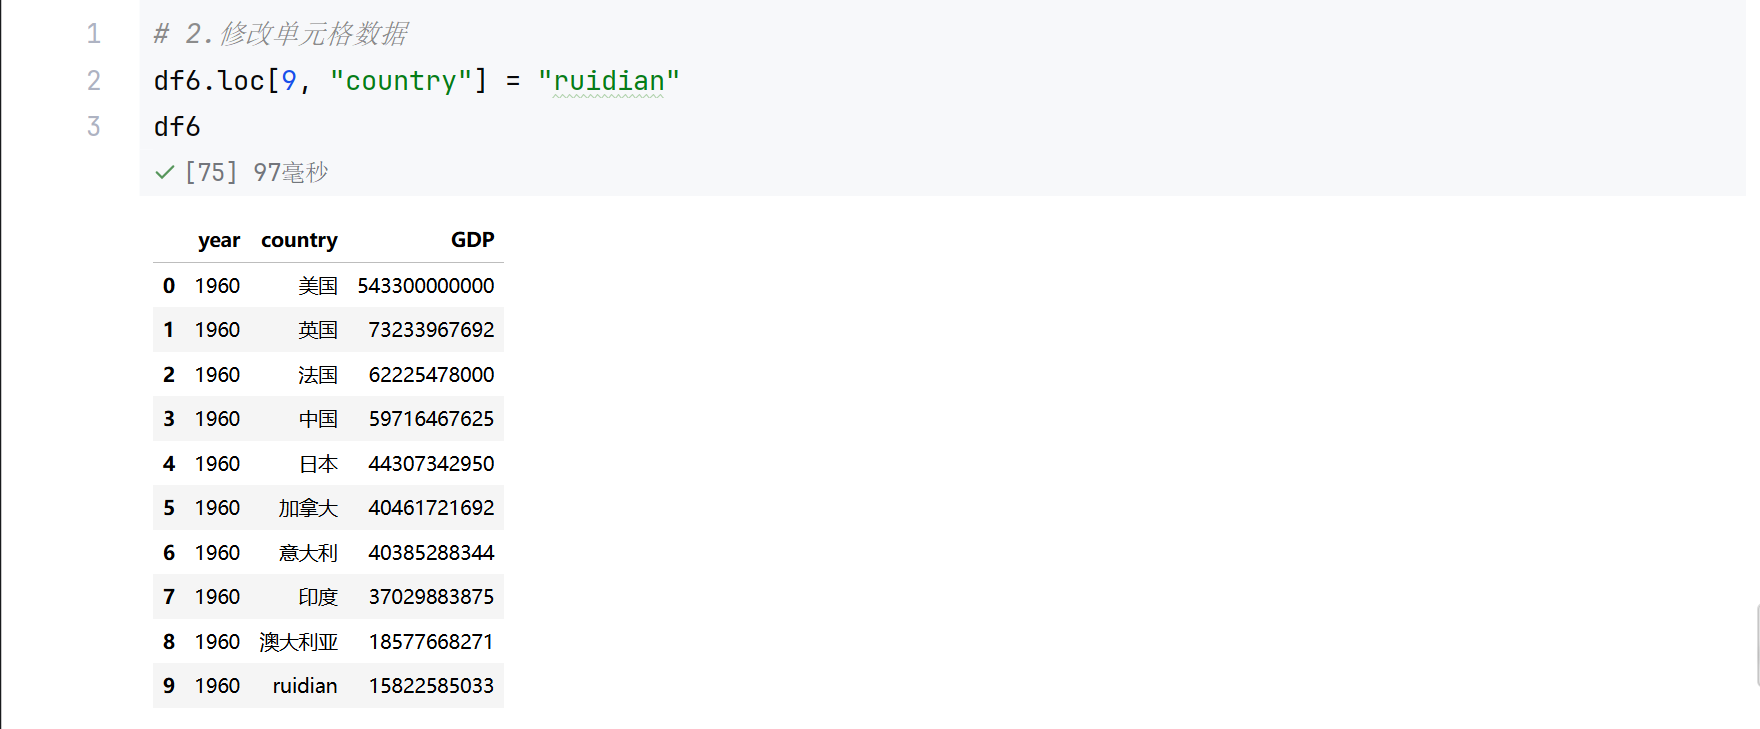
2.4.1 修改单元格
1. loc行索引, 列索引 修改
语法如下:
df.loc[行索引, 列索引] = 修改后数据2. iloc行号,列号 修改
语法如下:
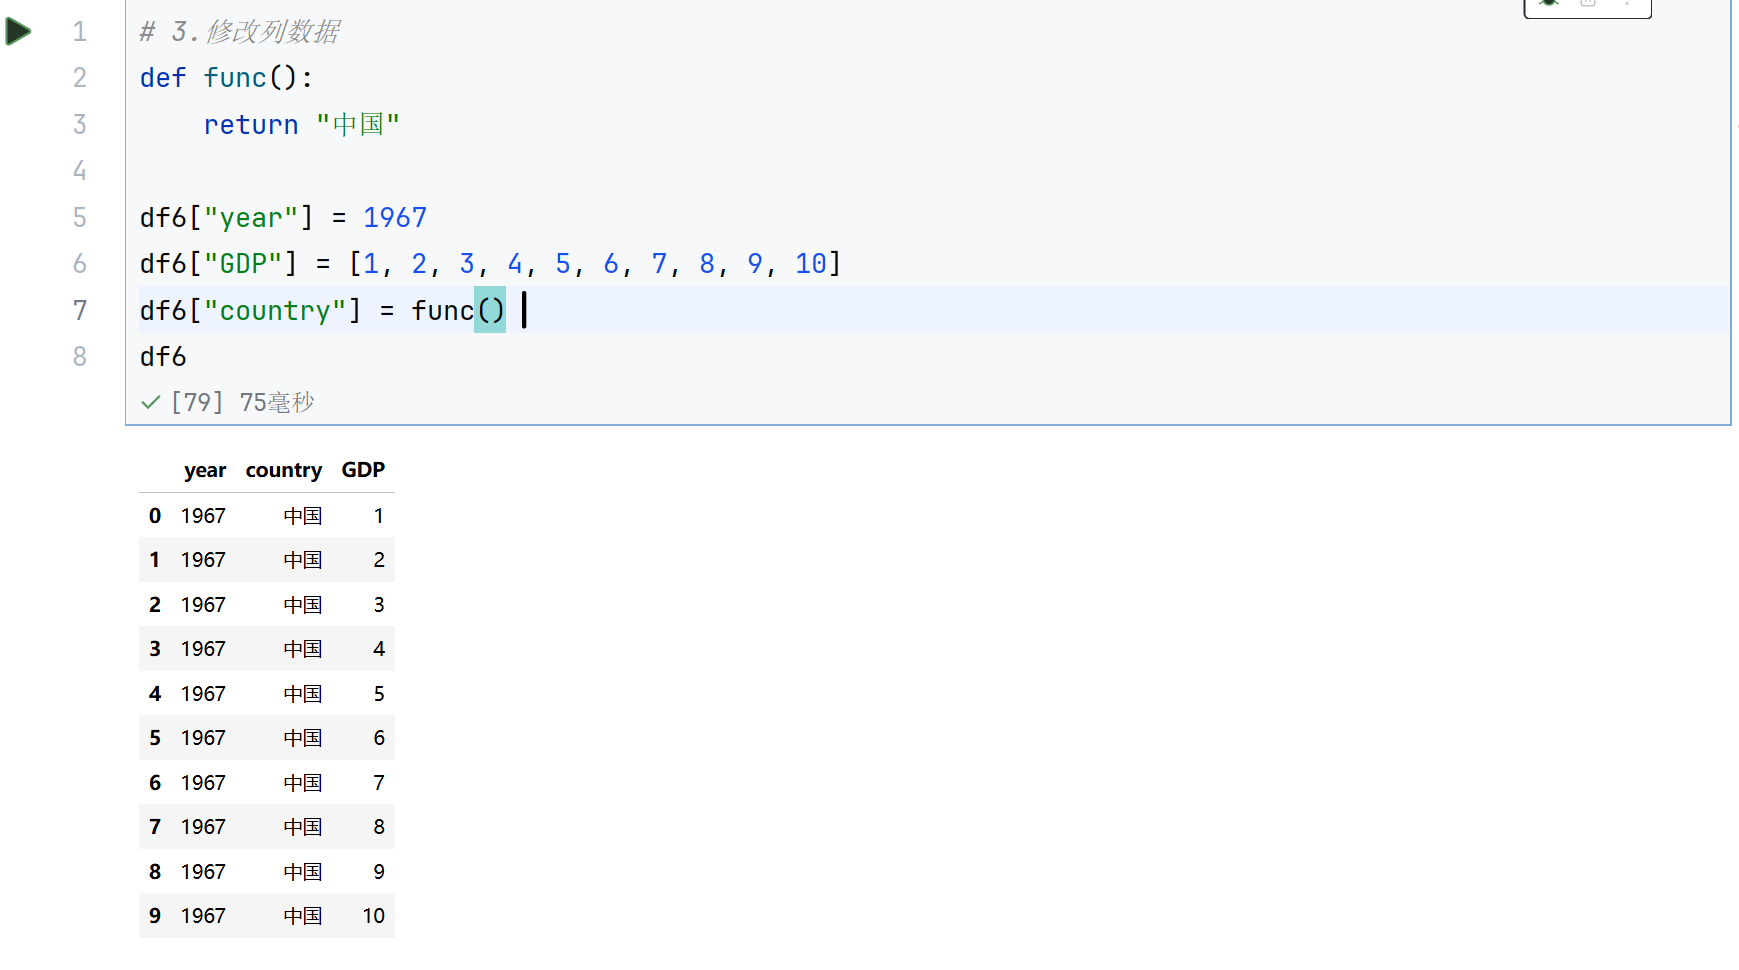
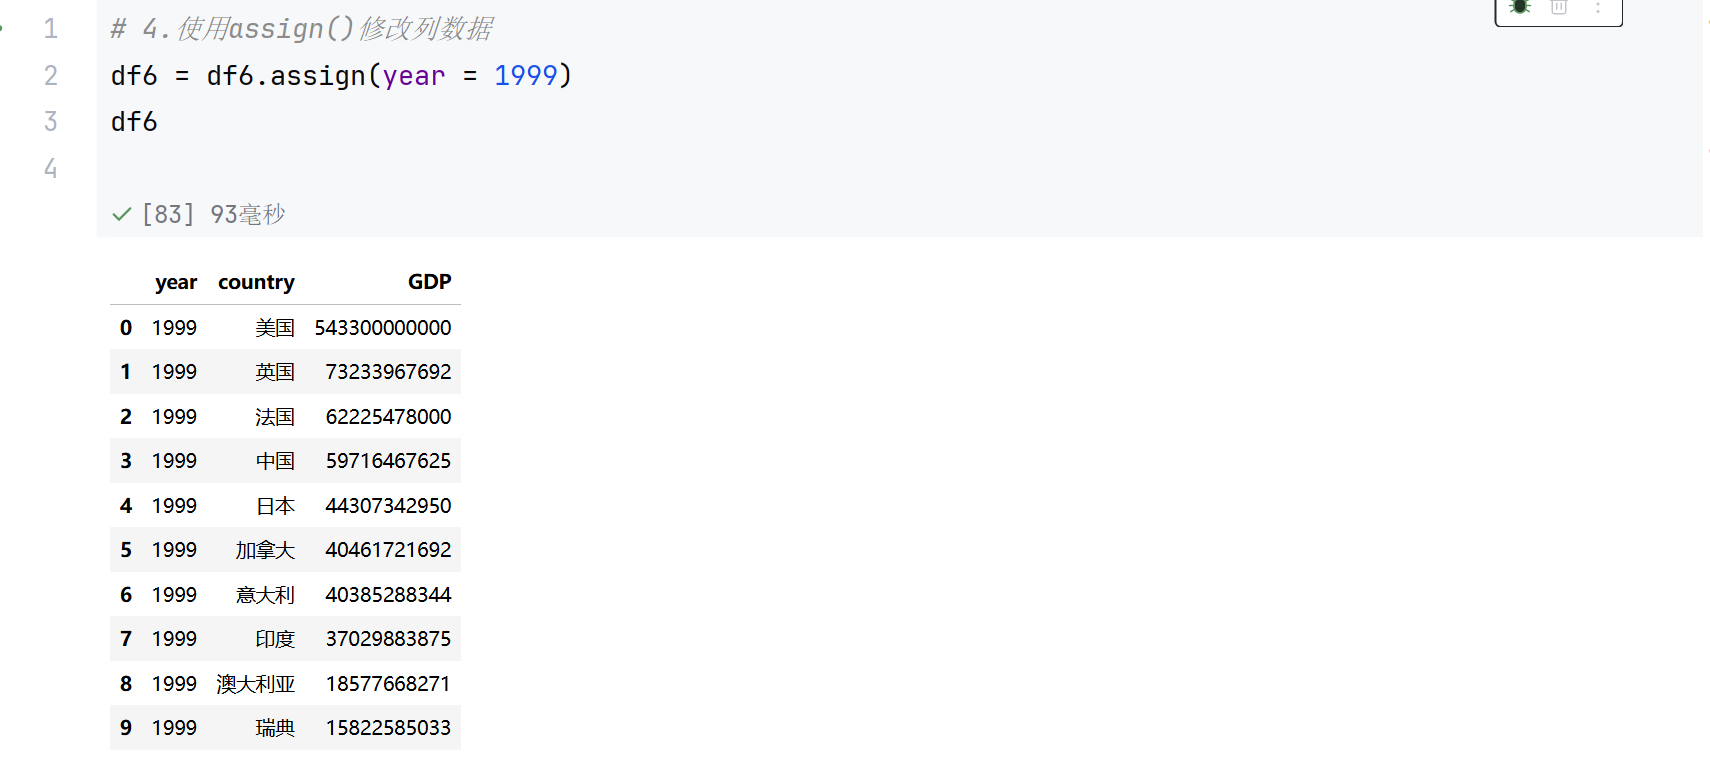
df.loc[行号, 列号] = 修改后数据2.4.2 修改列数据
思路1:直接赋值的方式
- 标量赋值
- 列表赋值
- 现有列运算赋值
- 函数返回值赋值
思路2:通过 assign()方法替换 1 / n 列
示例如下:
思路3:replace()函数
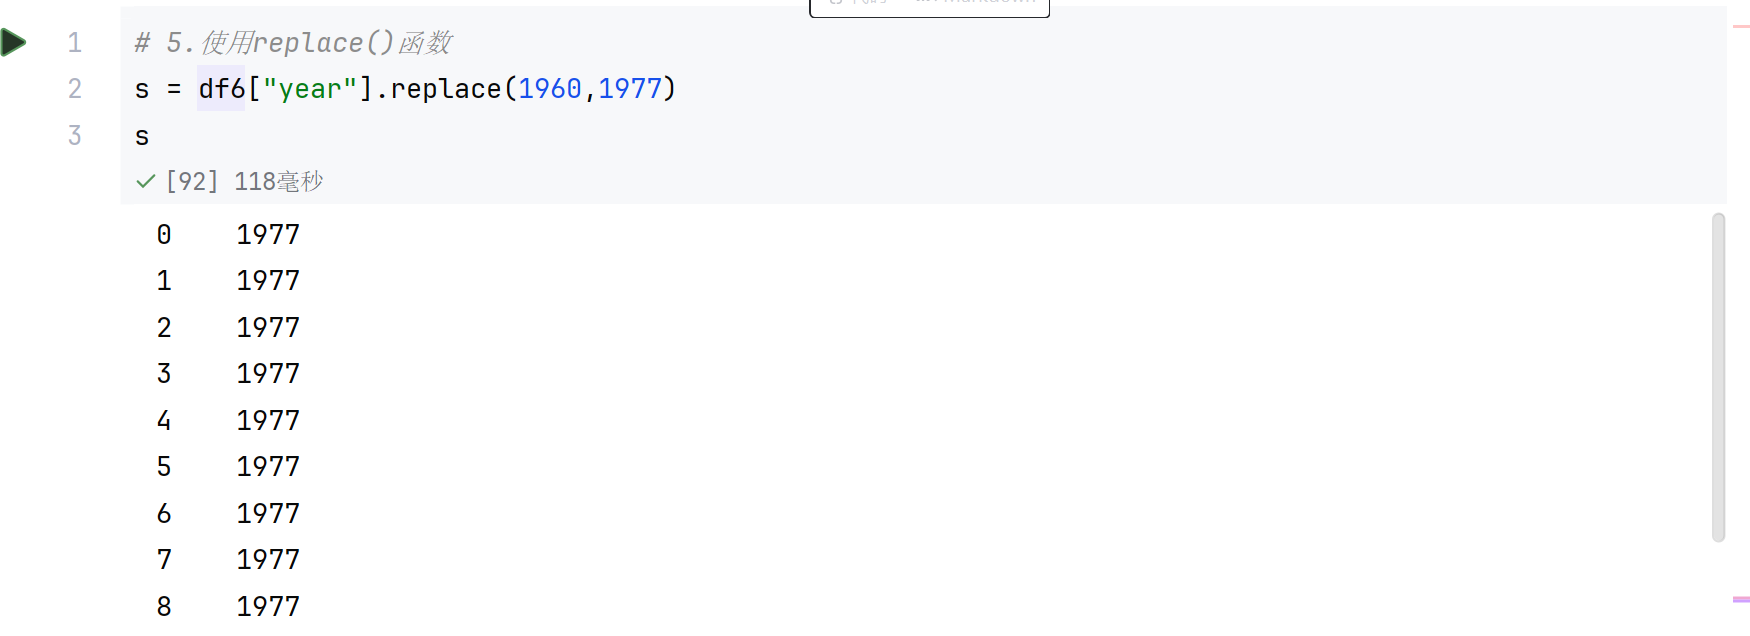
语法如下:
df = df[字段名].replace(要替换的数据, 替换后的数据)- replace()作用于 Series 时返回 Series
- replace()作用于 DataFrame 时返回 DataFrame
注意:参数 inplace = False(默认),此时 replace()并不会修改原对象的值;只有当 inplace = True 时,才会在原对象基础上修改数据
示例如下:
2.5 查询
1. head()
DataFrame对象名.head(n):获取前 n 行数据
2. tail()
DataFrame对象名.tail(n):获取后 n 行数据
3. 根据列索引获取列数据
**DataFrame对象名\[列1,列2,...]:**获取多列数据并返回新的 DataFrame 对象
4. 根据行索引切片获取行数据
**DataFrame对象名行索引切片:**获取多行数据并返回新的 DataFrame 对象
5.通过query()函数,结合条件获取数据
DataFrame对象名.query(字符串表达式): 是 Pandas 提供的字符串表达式行筛选方法
2.6 排序
Pandas 排序核心分为两类:按数据值排序 sort_values() 、按索引标签排序 sort_index()
另外补充排名函数 rank() 用于生成排名序号,不改变原数据顺序
2.6.1 按值排序:sort_values ()
根据一列或多列的数值大小排序,Series 和 DataFrame 均支持
核心参数:
| 参数 | 说明 | 默认值 |
|---|---|---|
by |
字段名 / Series,DataFrame 必填,指定按哪列排序 | --- |
axis |
0 = 按行排序,1 = 按列排序 |
0 |
ascending |
True 升序,False 降序;多列时可一 一对应升降序 |
True |
inplace |
是否直接修改原数据 | False |
na_position |
空值 NaN 的位置:'last' 放最后,'first' 放最前 |
'last' |
ignore_index |
排序后是否重置为从 0 开始的连续整数索引 | False |
Series排序:
import pandas as pd
s = pd.Series([12, 4, 7, 9, None])

# 默认升序,空值放末尾
s.sort_values()

# 降序排列,空值放最前面
s.sort_values(ascending=False, na_position='first')
DataFrame 单列排序:
df = pd.DataFrame({
    "班级": ["一班","一班","二班","二班"],
    "分数": [85, 92, 78, 92],
    "姓名": ["张三","李四","王五","赵六"]
})

# 按分数升序排列
df.sort_values(by="分数")

# 按分数降序,同时重置索引
df.sort_values(by="分数", ascending=False, ignore_index=True)
DataFrame 多列排序:by 列表中越靠前的列,排序优先级越高;第一列值相同时,再按第二列排序
# 先按班级升序,同班内再按分数降序
df.sort_values(by=["班级", "分数"], ascending=[True, False])
2.6.2 按索引排序:sort_index ()
根据行索引或列索引顺序排序
核心参数:
| 参数 | 说明 | 默认值 |
|---|---|---|
axis |
0:行索引排序;1:列索引排序 |
0 |
ascending |
True:升序(默认);False:降序; |
True |
inplace |
是否就地修改原数据 | False |
na_position |
索引缺失值的位置:'last' 放最后,'first' 放最前 | last(默认排最后) |
level |
指定排序层级(多层索引用) | 层级名称或层级序号 |
kind |
排序算法 | quicksort(快排) |
常用写法如下:
# 行索引降序排列
df.sort_index(ascending=False)

# 按列名字母顺序,左右调换列的顺序
df.sort_index(axis=1)
2.6.3 排名函数:rank ()
不改变数据行的顺序,仅新增一列排名序号 ,专门处理并列排名的不同规则
语法如下:
DataFrame.rank() 或者 Series.rank()返回值:以 Series / DataFrame 的类型返回数据排名
参数:
- method:排名的计算方式
- ascending :设置升序还是降序
- True:默认升序
- False:降序
- axis :设置沿哪个轴进行排序
- axis=0:默认,沿纵轴排序
- axis=1:沿横轴排序
- numeric_only:是否仅仅计算数字类型的列,默认为 False
- na_option :NaN空值在排序后的放置位置
- keep:放在原有位置
- top:放在顶部
- bottom:放在底部
- pct:是否以排名的百分比显示排名,默认 False
核心参数 method 取值:
| method | 规则说明 | 示例:值 [92, 92, 78] 的降序排名 |
|---|---|---|
average |
平均排名(默认) | 1.5, 1.5, 3 |
min |
并列取最小名次 | 1, 1, 3 |
max |
并列取最大名次 | 2, 2, 3 |
first |
按出现先后排,同名次不并列 | 1, 2, 3 |
dense |
密集排名,名次不跳号 | 1, 1, 2 |
示例:
# 给分数列生成排名,并列分数取相同最小名次
df["排名"] = df["分数"].rank(method="min", ascending=False)
3.Pandas 高级处理
3.1 缺失值处理
3.1.1 缺失值基础知识
Pandas 中标准的缺失值标识有三类:
- 数值型缺失:np.nan(Not a Number),属于 float 类型
- 对象型缺失:None,常见于字符串、混合类型列
- 时间型缺失:pd.NaT(Not a Time),专门用于 datetime 类型
注意:空字符串 " ","NA","null","-"等业务层面的缺失标识,不会被自动识别,需要手动转换为标准缺失值
3.1.2 缺失值查询
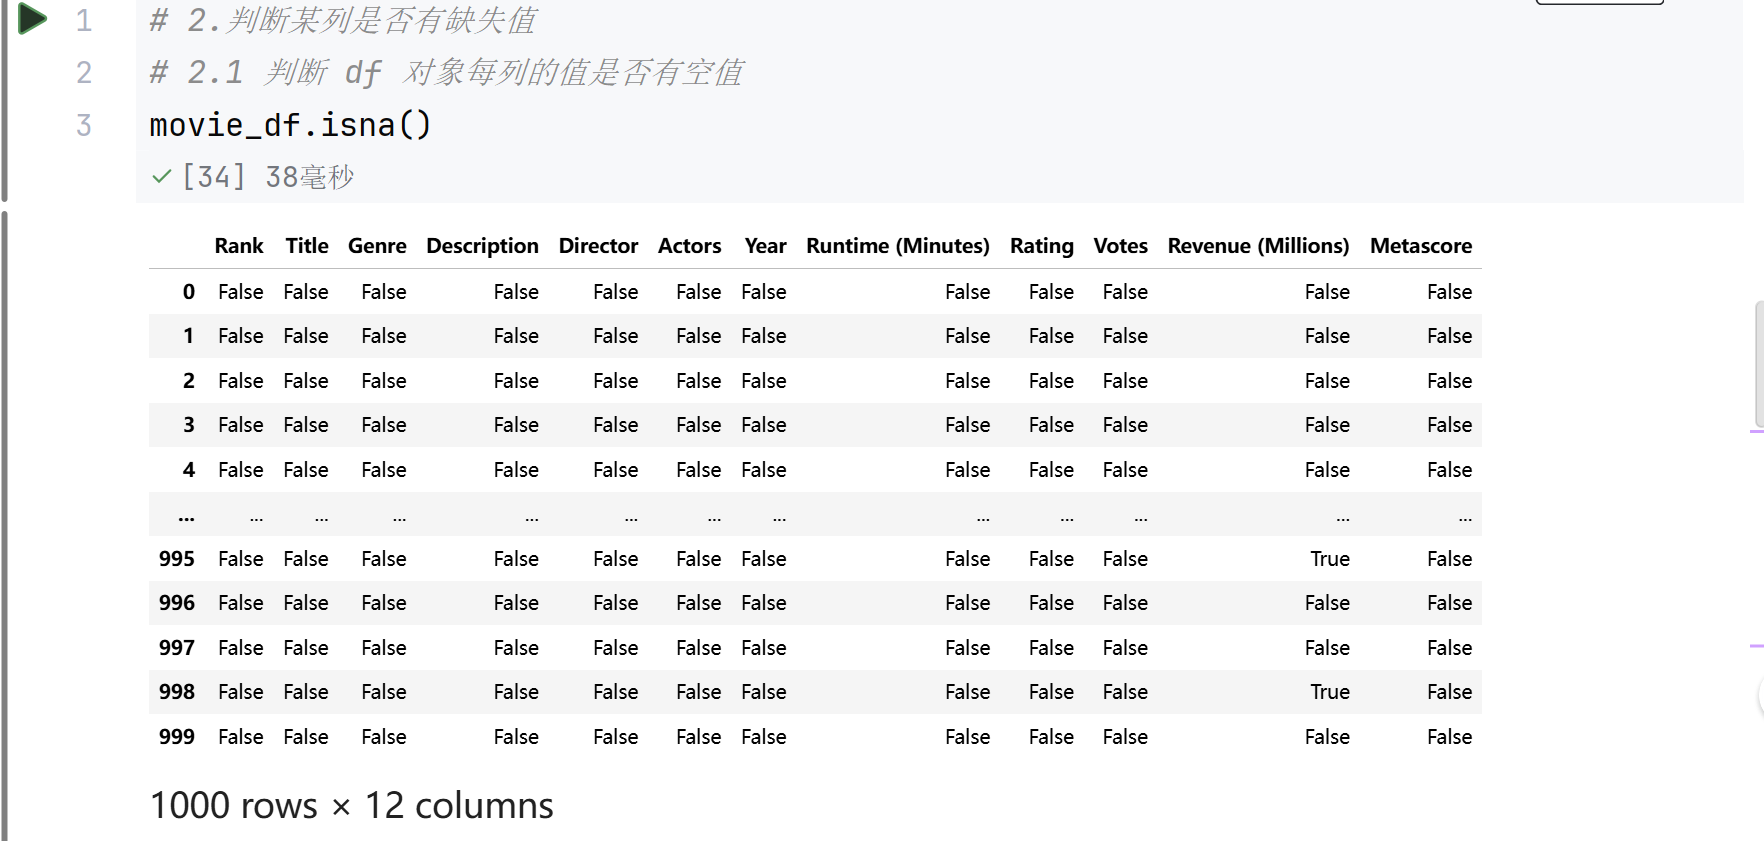
1. 布尔判断
如果是数值型缺失值 NaN,可以用以下函数查询数据中是否有 NaN:
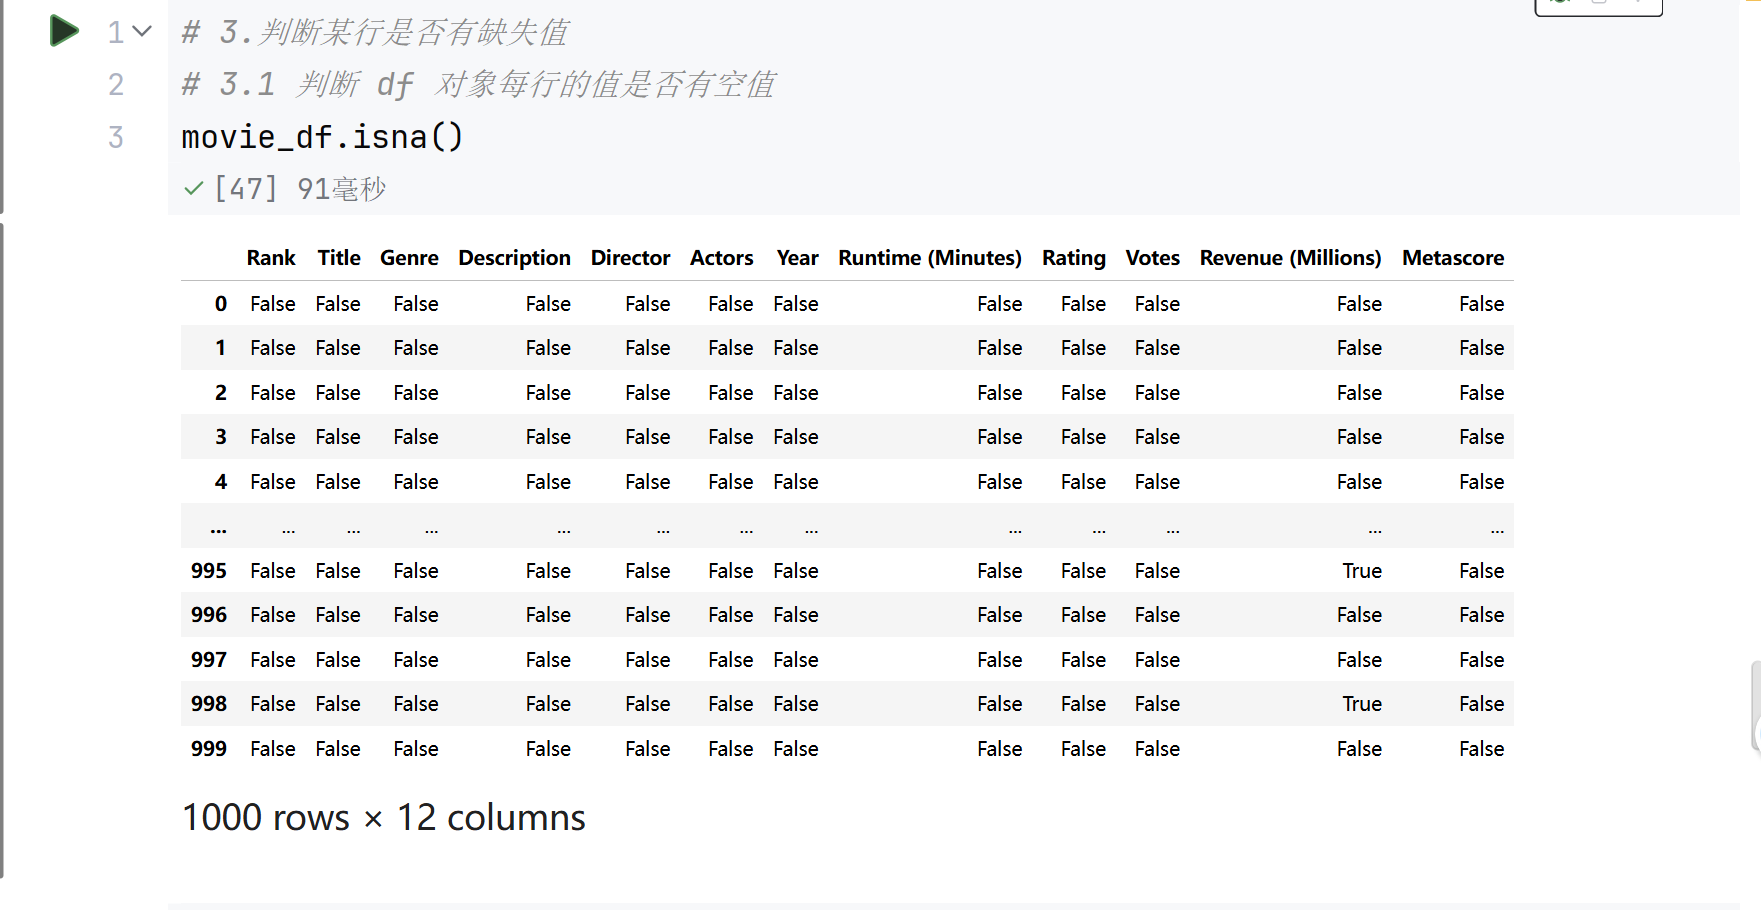
df.isna()   #等效 pd.isnull(DataFrame对象)

df.notna() #等效 pd.notnull(DataFrame对象)返回值:布尔型 DataFrame(缺失为 True)
2. 数量统计
# 按列统计缺失数量
df.isna().sum(axis=0)   # axis=0 默认

# 按行统计缺失数量
df.isna().sum(axis=1)
3.快速概览
df.info() # 直接查看每列的非空数量、数据类型4.筛选某行 / 列是否含缺失值
核心逻辑:通过 isna()生成布尔矩阵,配合 **any()/ all()**判断
注意:
- df df.isna().any(axis=1):axis=1是按行维度判断,返回的是「每行是否含缺失值」的布尔序列(长度 = 列数,索引是列名)
- df 布尔序列:默认是对行做筛选,要求布尔序列长度等于行数
查看有缺失值的行:
| 需求场景 | 代码 | 说明 |
|---|---|---|
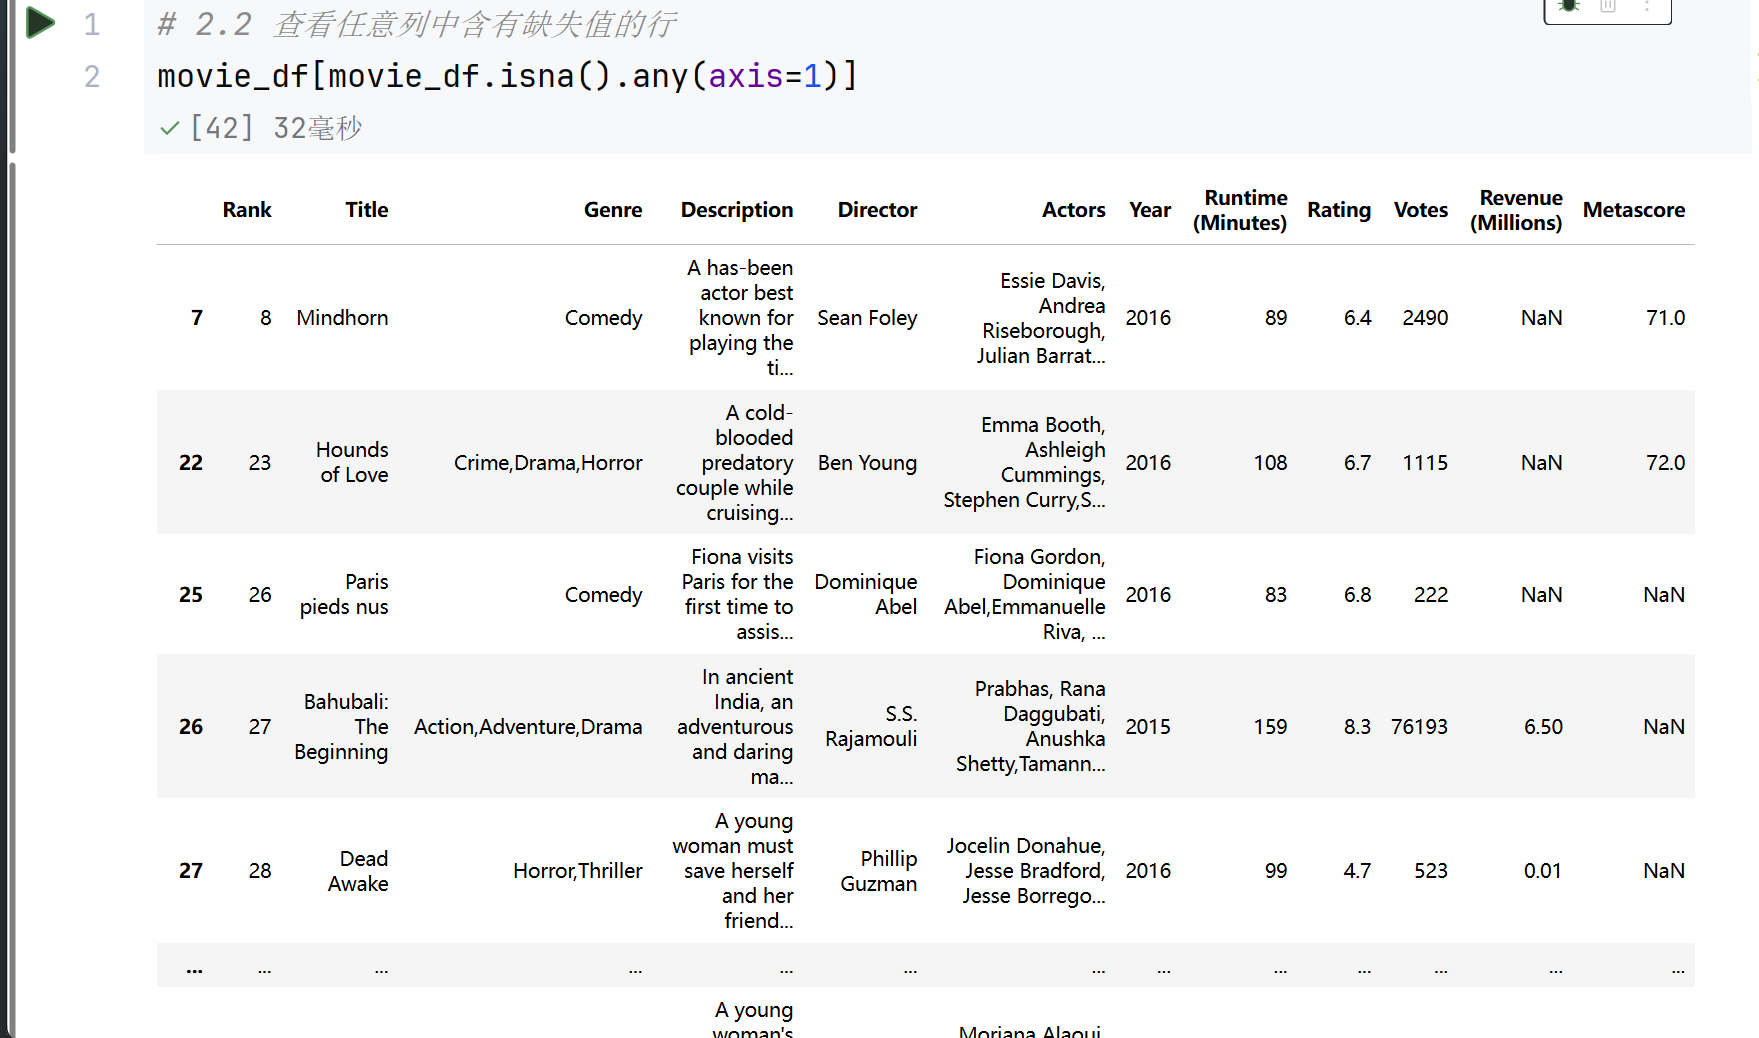
| 查看任意列有缺失的行 | df[df.isna().any(axis=1)] |
最常用,只要某一行有一个缺失值就会被筛选出来 |
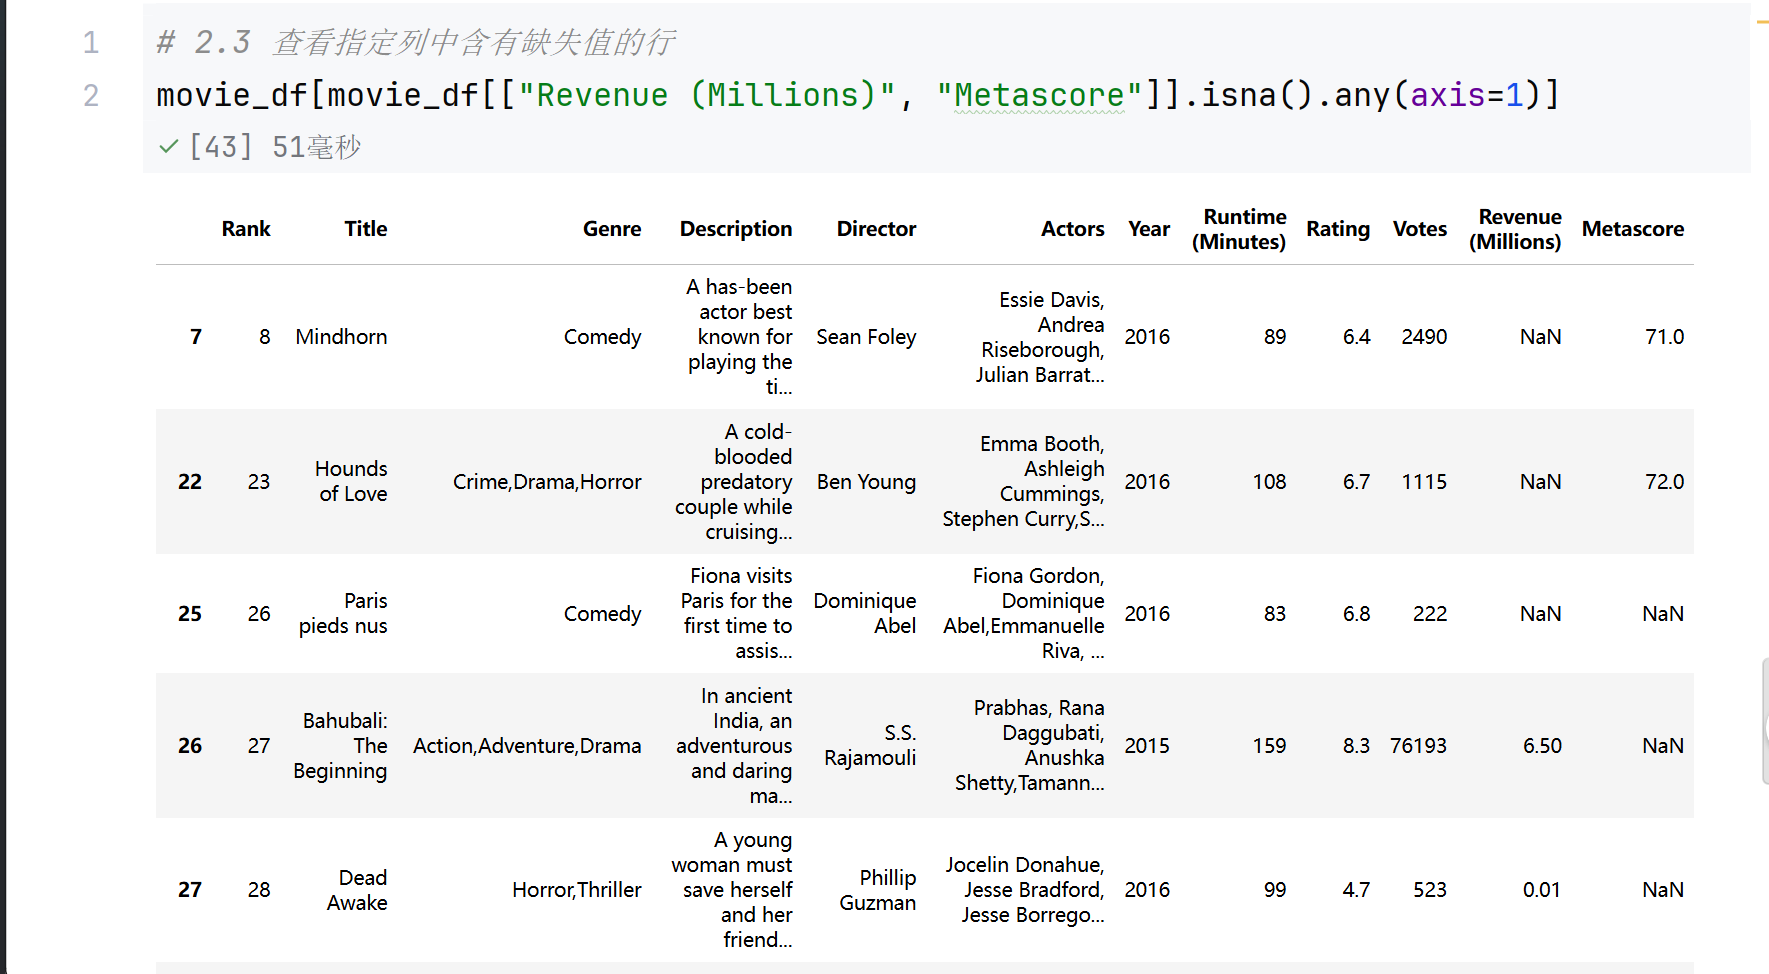
| 查看指定列有缺失的行 | df[df[['列1','列2']].isna().any(axis=1)] |
只检查指定的几列,仅当这些列里有缺失时才筛选该行 |
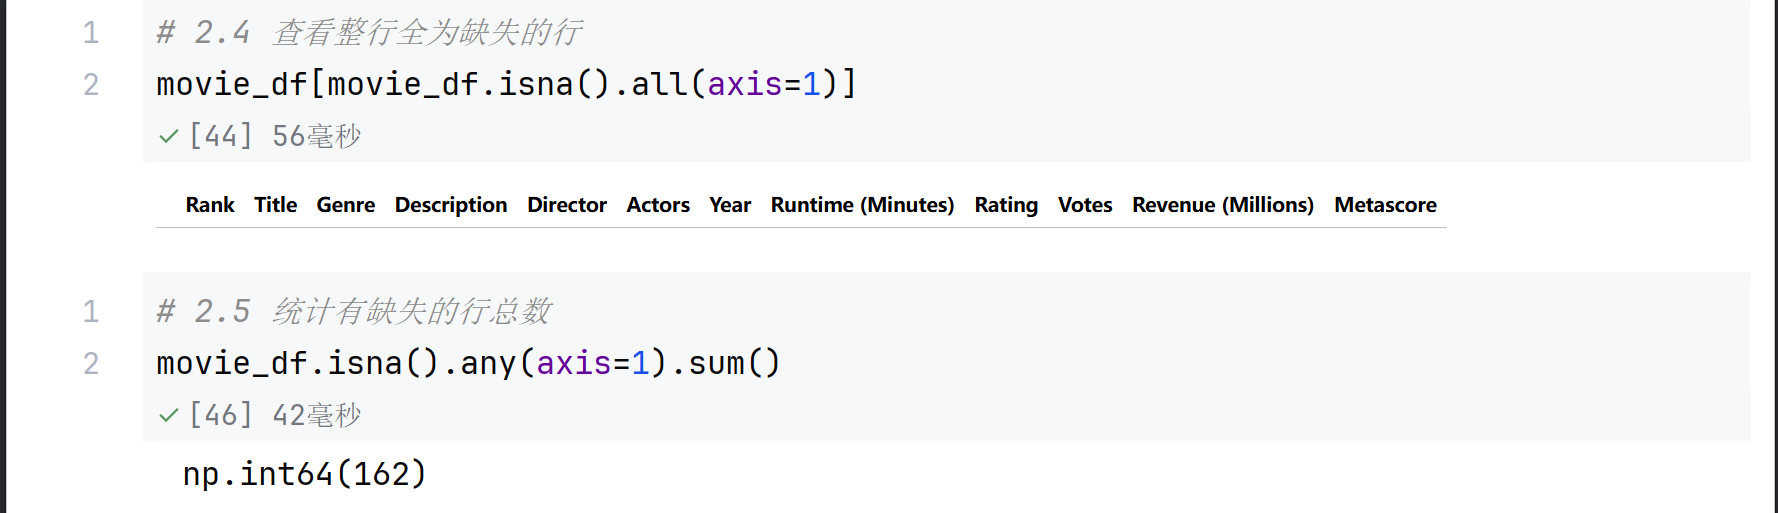
| 查看整行全为缺失的行 | df[df.isna().all(axis=1)] |
只有某一行所有列都是缺失值时才会被筛选出来 |
| 统计有缺失的行总数 | df.isna().any(axis=1).sum() |
直接返回含缺失行的数量,无需查看具体数据 |
补充说明:
- axis=1 表示按行维度判断,axis=0 是按列(默认)
- any = 只要有缺失就显示;all = 全为缺失显示
案例如下:
查看有缺失值的列:
| 需求场景 | 代码 |
| 查看任意行有缺失的列 | df.loc[:, df.isna().any(axis=0)] |
| 查看指定行有缺失的列 | df.loc[:, df[['列1','列2']].isna().any(axis=0)] |
| 查看整列全为缺失的列 | df.loc[:, df.isna().all(axis=0)] |
| 统计有缺失的列总数 | df.isna().any(axis=0).sum() |
|---|
案例如下:
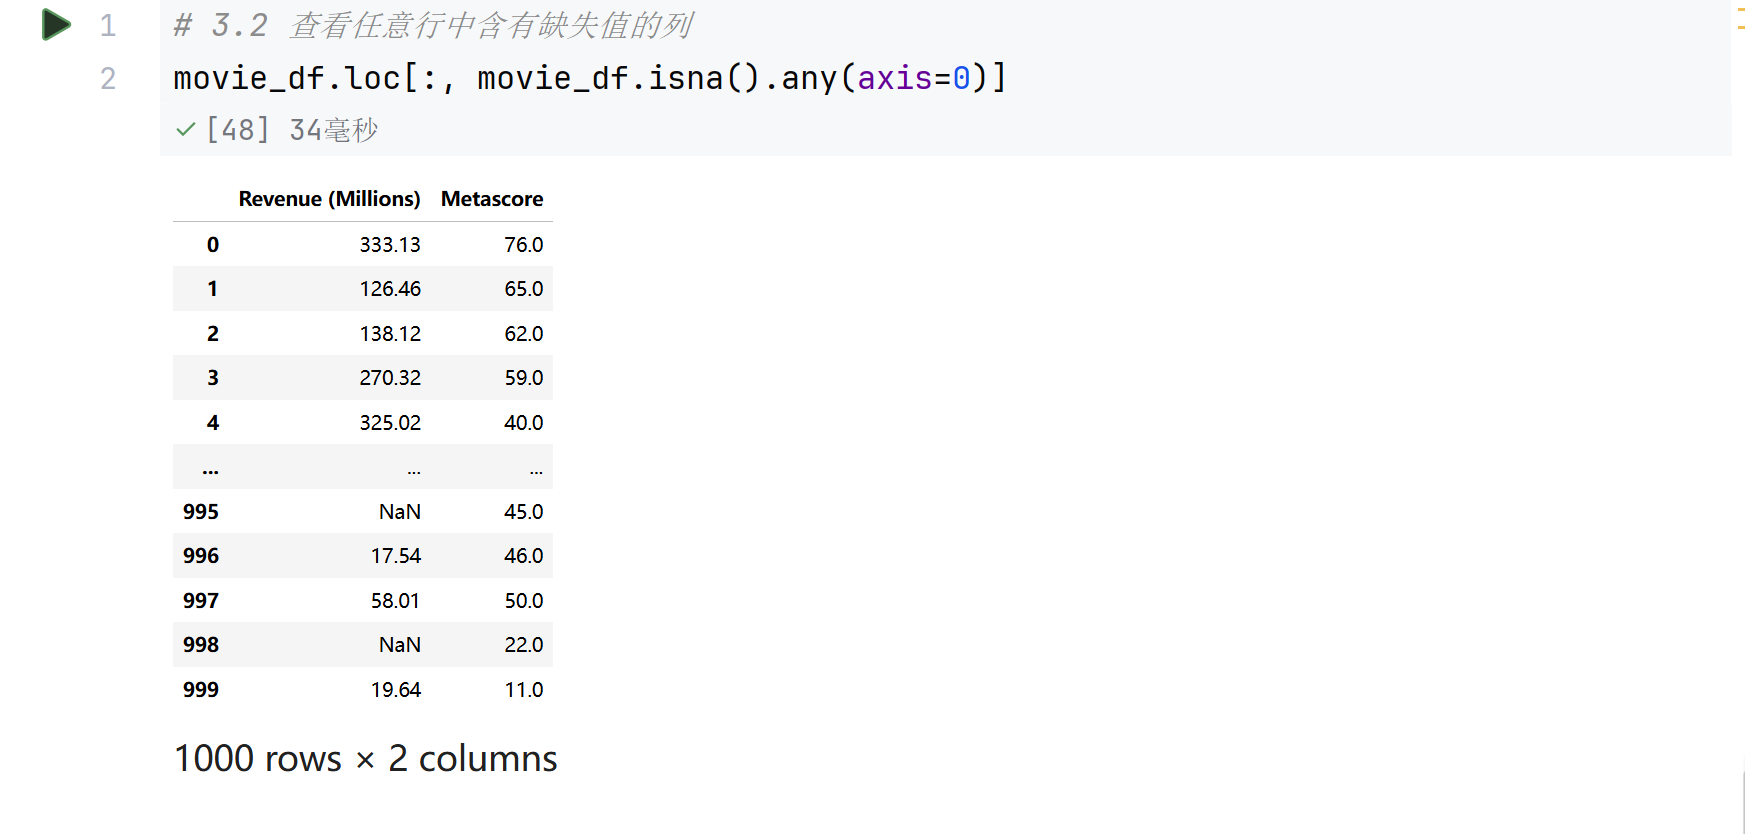
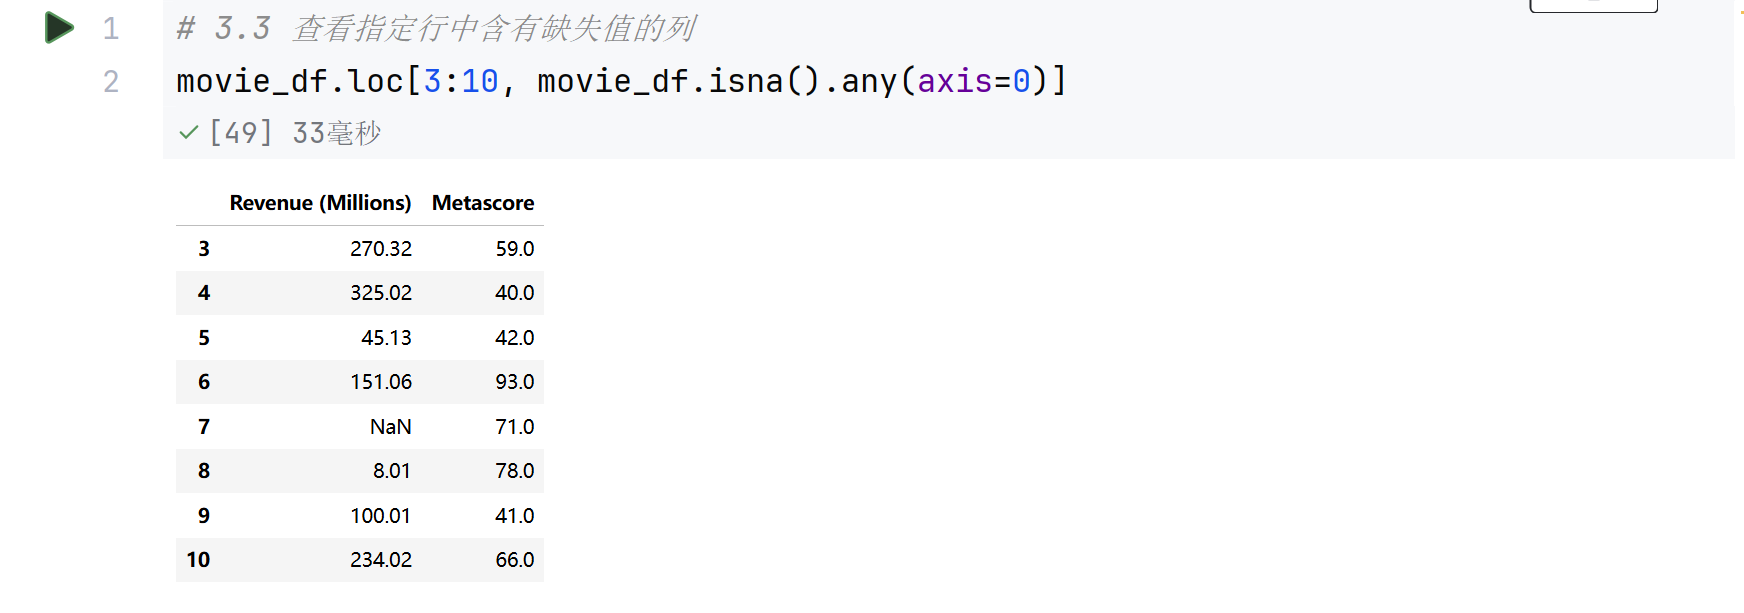
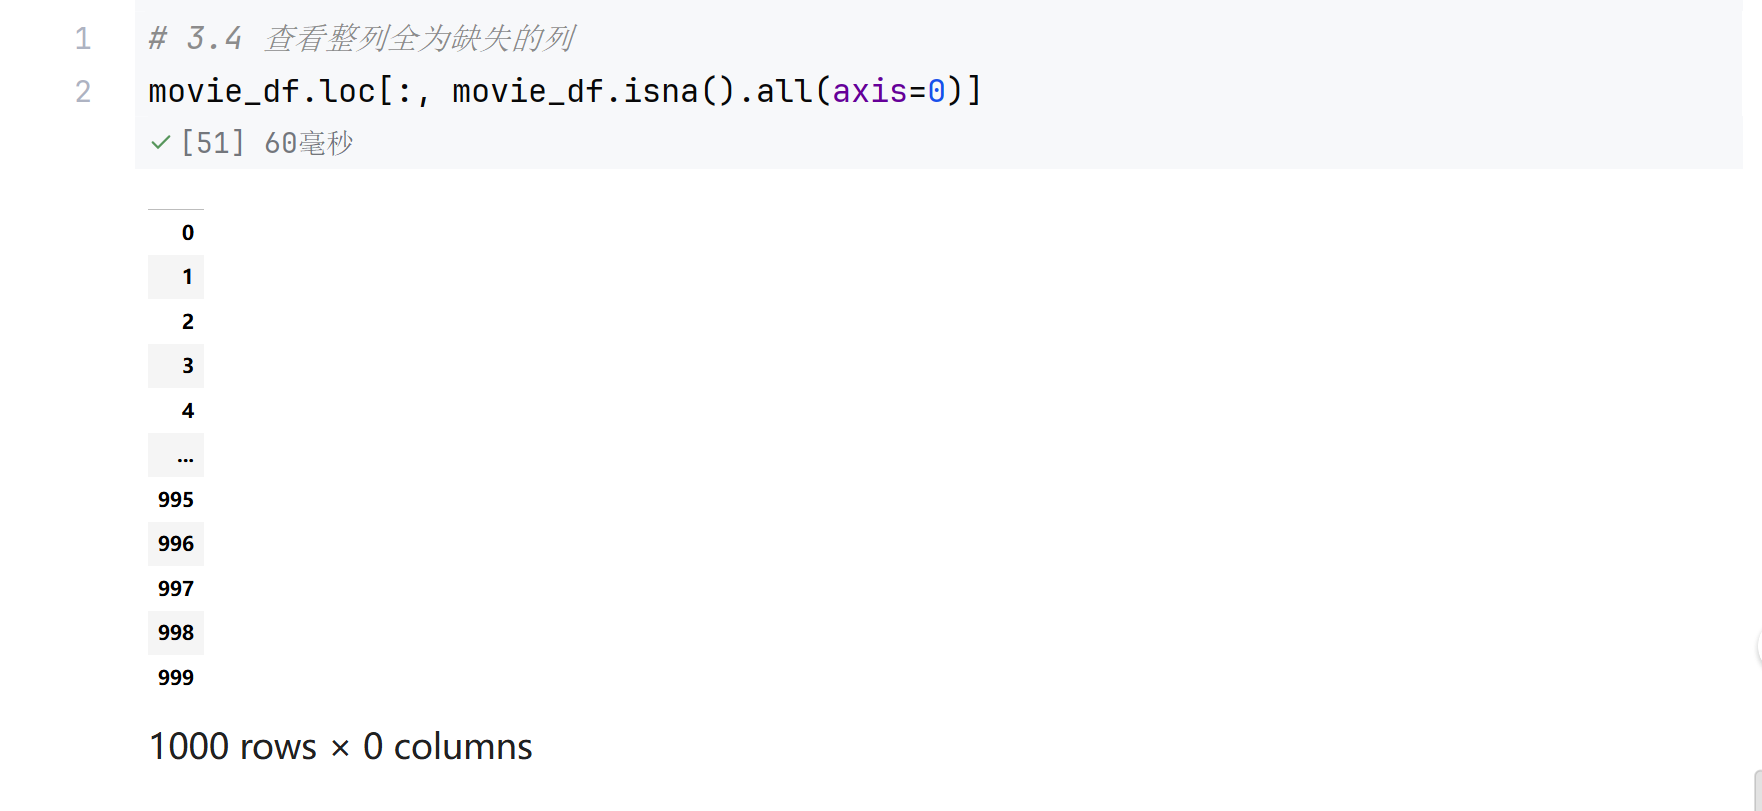
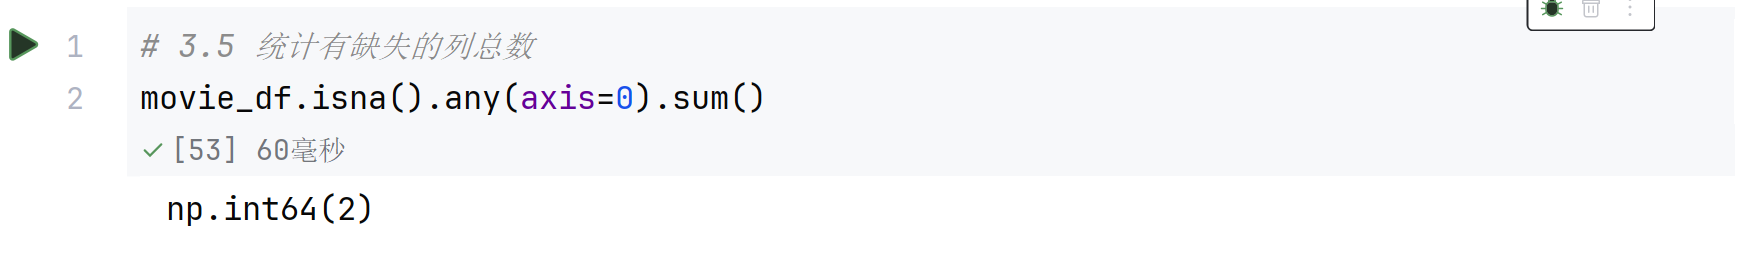
3.1.3 缺失值删除
删除存在的缺失值:df.dropna()
语法如下:
df.dropna(axis=0, how='any', thresh=None, subset=None, inplace=False)核心参数:
| 参数 | 说明 |
|---|---|
axis |
0 = 删除行(默认);1 = 删除列 |
how |
any= 只要有缺失就删(默认);all= 全为缺失才删 |
thresh |
整数,保留至少有 n 个非空值的行 / 列,默认为 None |
subset |
列表,只检查指定列的缺失情况,默认为 None |
inplace |
是否直接修改原数据,默认为 False |
3.1.4 缺失值填充
删除存在的缺失值:df.fillna()
语法如下:
df.fillna(value=None, method=None, axis=None, inplace=False, limit=None)核心参数:
| 参数 | 说明 |
|---|---|
value |
填充值,默认为 None;支持传入标量、字典、Series、DataFrame,指定替换缺失值的具体内容 |
method |
填充方式,默认为 None;ffill/pad = 前向填充(用上一个非空值填充);bfill/backfill = 后向填充(用下一个非空值填充) |
axis |
填充方向,0 = 填充行(默认);1 = 填充列 |
inplace |
是否直接修改原数据,默认为 False;True = 直接修改原对象,False = 返回填充后的新对象 |
limit |
连续填充上限,默认为 None;传入整数,限制连续缺失值的最大填充数量 |
注意 :如果缺失值没有使用 NaN 作为空值标记(比如使用 ?),应该先使用 **df.replace(?,np.nan)**替换为 NaN,再进行填充
1. 固定值填充
(1)常数填充
# 所有缺失填充为 0
df.fillna(0, inplace=True)

# 分类列填充「未知」
df['城市'].fillna('未知', inplace=True)
(2)统计量填充
# 均值填充
df['收入'].fillna(df['收入'].mean(), inplace=True)

# 中位数填充
df['年龄'].fillna(df['年龄'].median(), inplace=True)

# 众数填充
df['学历'].fillna(df['学历'].mode()[0], inplace=True)
可以使用 for 循环来实现多个列的统计量填充,不过前提是:使用同一统计量
# 1.获取每列的列名
for col_name in df.columns:
    # 2.判断该列是否有缺失值
    flag = np.all(df.col_name.notna())
    if flag == False:
        # 3.打印有缺失值的列名
        print(col_name)
        # 4.统计量填充
        df.col_name.fillna(df.col_name.median(), inplace=True)
np.all()和 np.any() 二者都是 NumPy 的布尔聚合函数,本质是对数组元素做逻辑判断,核心区别:
- np.all() :全部为真才返回真(逻辑与 AND)
- np.any() :只要有一个为真就返回真(逻辑或 OR)
2. 前后向填充
利用相邻的非空值填充,适合有顺序逻辑的数据(如时间序列、排名数据)
# 前向填充:用上一个非空值填充
df.fillna(method='ffill', inplace=True)   # 等价于 df.ffill()

# 后向填充:用下一个非空值填充
df.fillna(method='bfill', inplace=True)   # 等价于 df.bfill()

# 限制连续填充数量(最多连续填充 2 个)
df.ffill(limit=2, inplace=True)
3. 按分组填充
按类别分组后,用组内统计量填充
# 按性别分组,用每组的均值填充年龄缺失
df['年龄'] = df.groupby('性别')['年龄'].transform(lambda x: x.fillna(x.mean()))

# 按城市分组,用组内众数填充行业缺失
df['行业'] = df.groupby('城市')['行业'].transform(lambda x: x.fillna(x.mode()[0]))
3.2 数据合并处理
Pandas 提供了三类核心合并方式,覆盖轴向拼接、键值关联、索引对齐三大场景,分别对应 pd.concat(),pd.merge(),df.join()
3.2.1 **pd.concat():**轴向拼接
**pd.concat():**按指定轴(行 / 列)直接拼接多个 DataFrame/Series,纯粹按位置堆叠
核心参数:
| 参数 | 说明 |
|---|---|
objs |
列表,存放要拼接的对象,如 [df1, df2, df3] |
axis |
拼接轴:0= 纵向按行拼接(默认);1= 横向按列拼接 |
join |
拼接方式:"outer"= 取并集(默认);"inner"= 取交集 |
ignore_index |
是否重置结果索引,默认为False;True 生成 0~n 连续新索引 |
keys |
为每个拼接对象添加层级索引,用于区分数据来源 |
sort |
拼接后是否按列名排序,默认 False |
1.纵向拼接
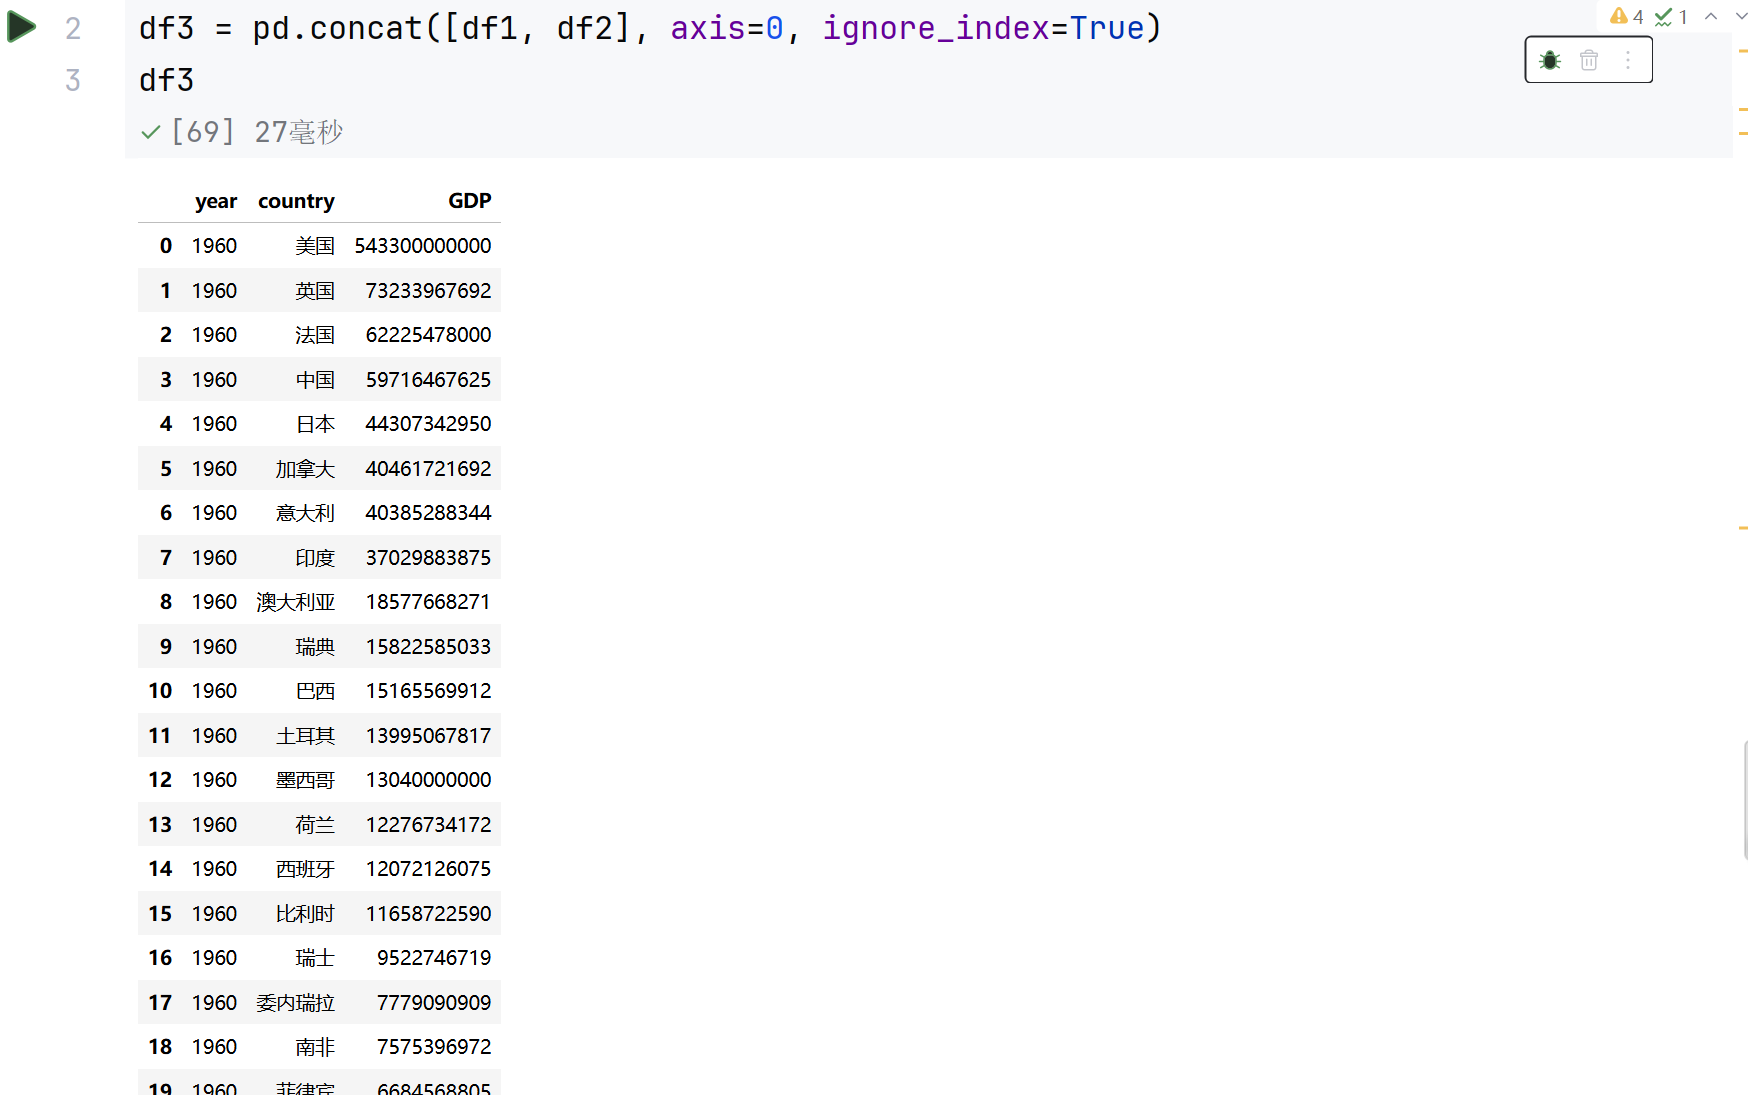
# 两个结构相同的表上下拼接,重置索引
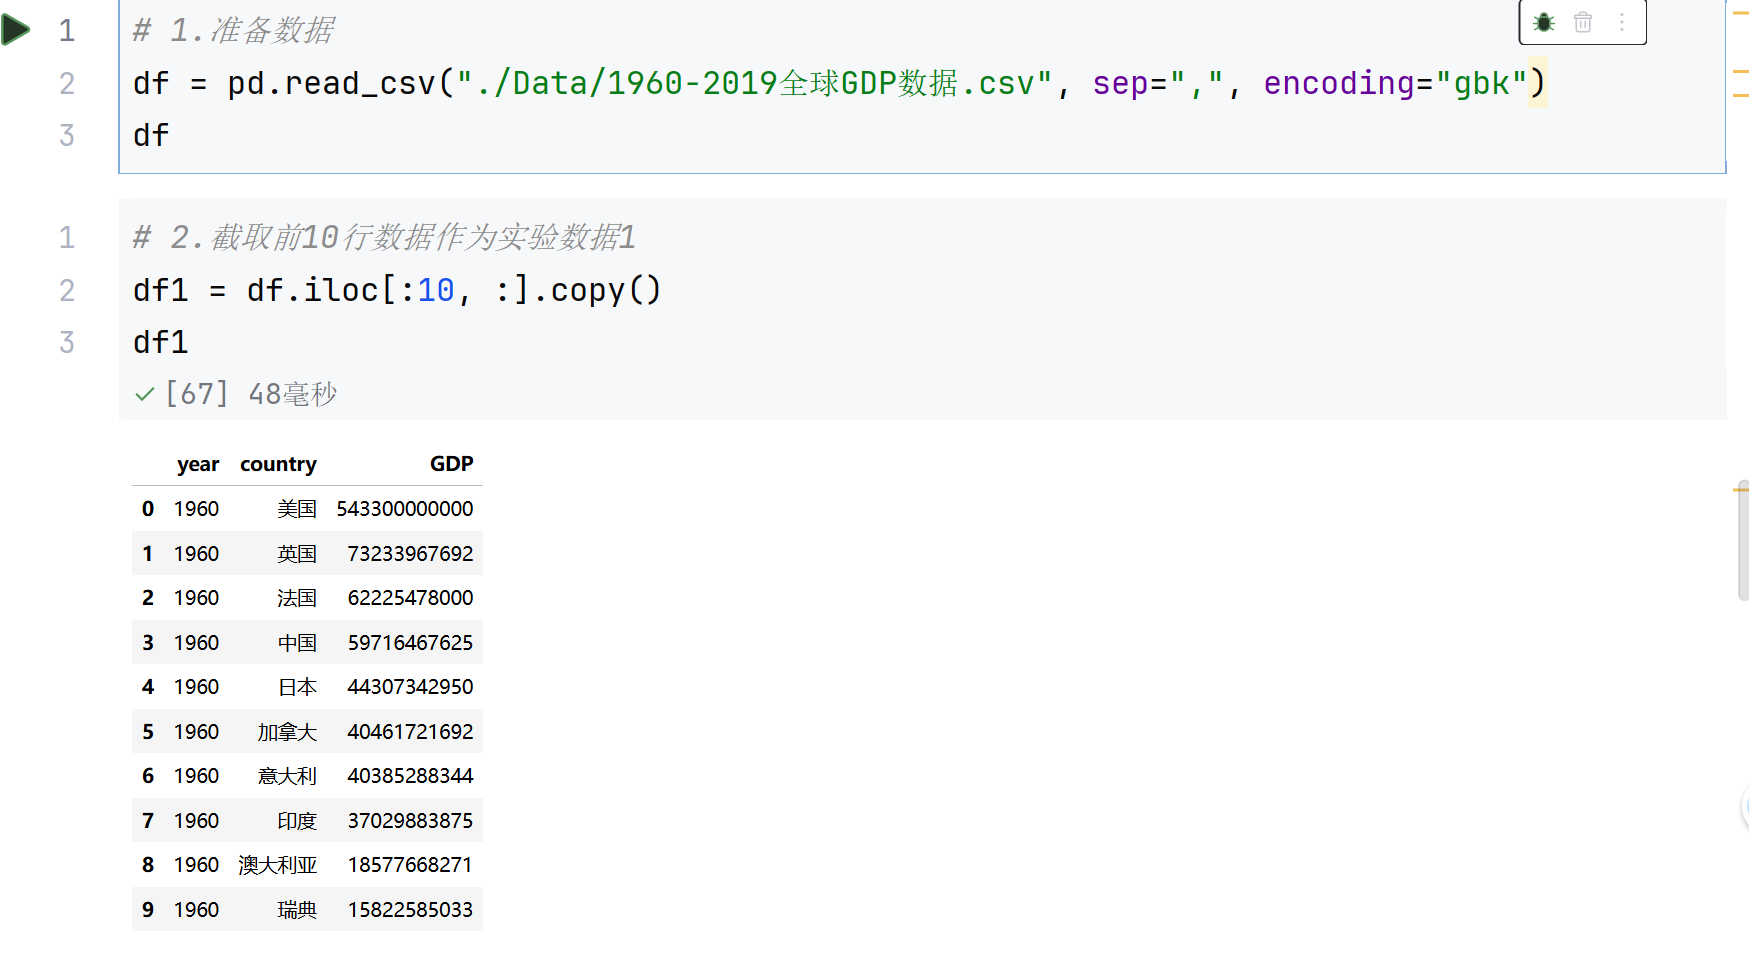
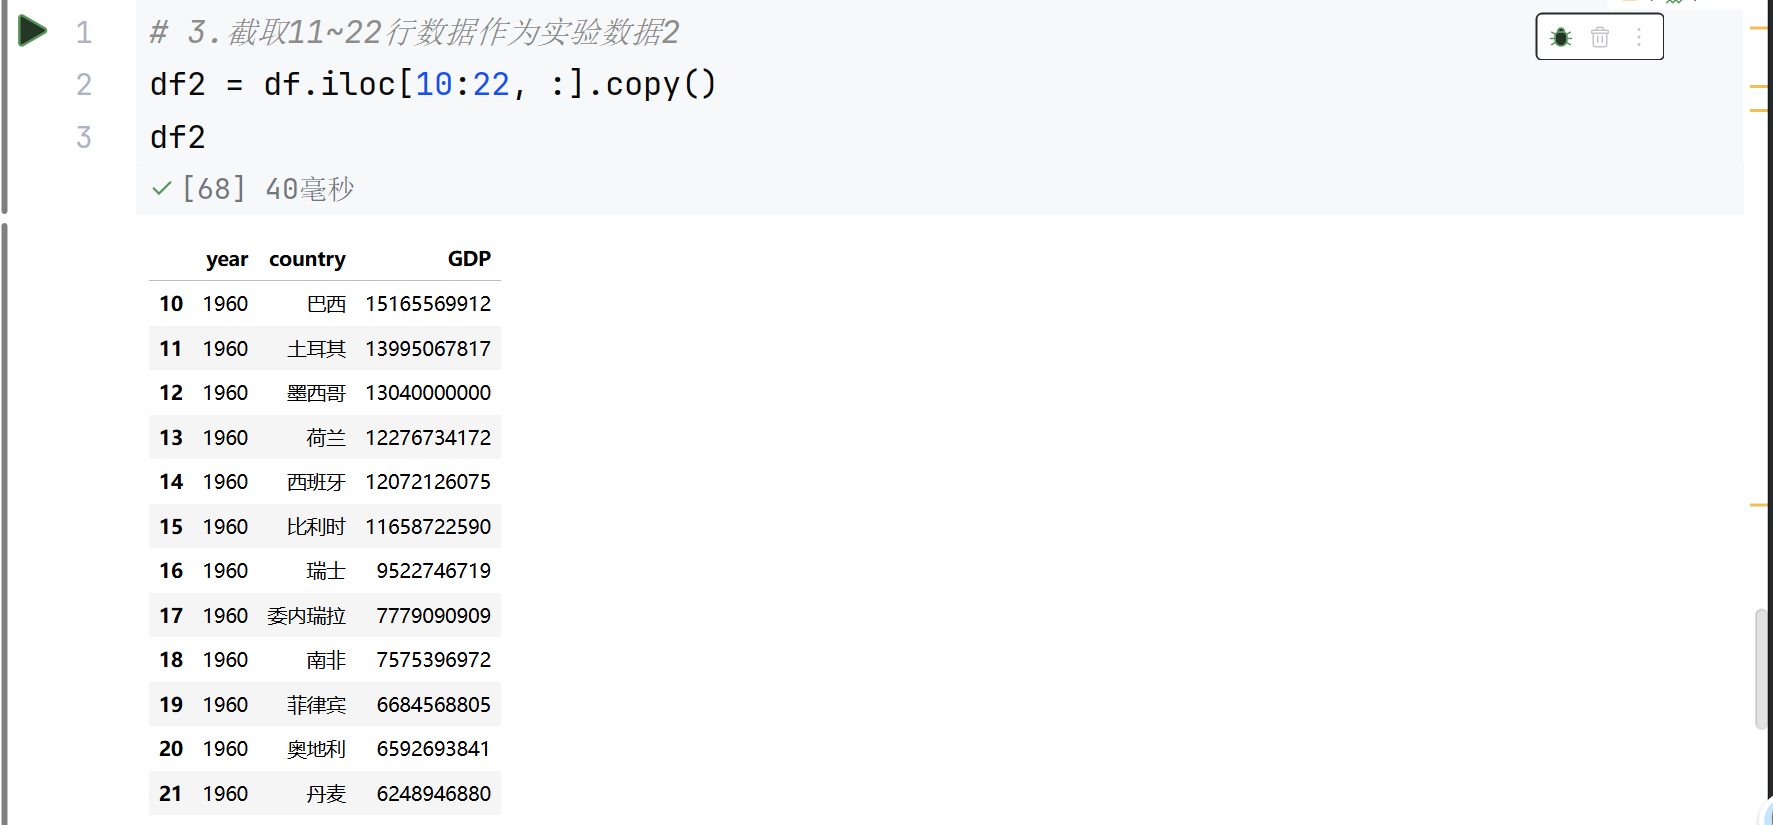
df_all = pd.concat([df1, df2], axis=0, ignore_index=True)纵向拼接默认参考列索引,未匹配位置填充 NaN
2.横向拼接
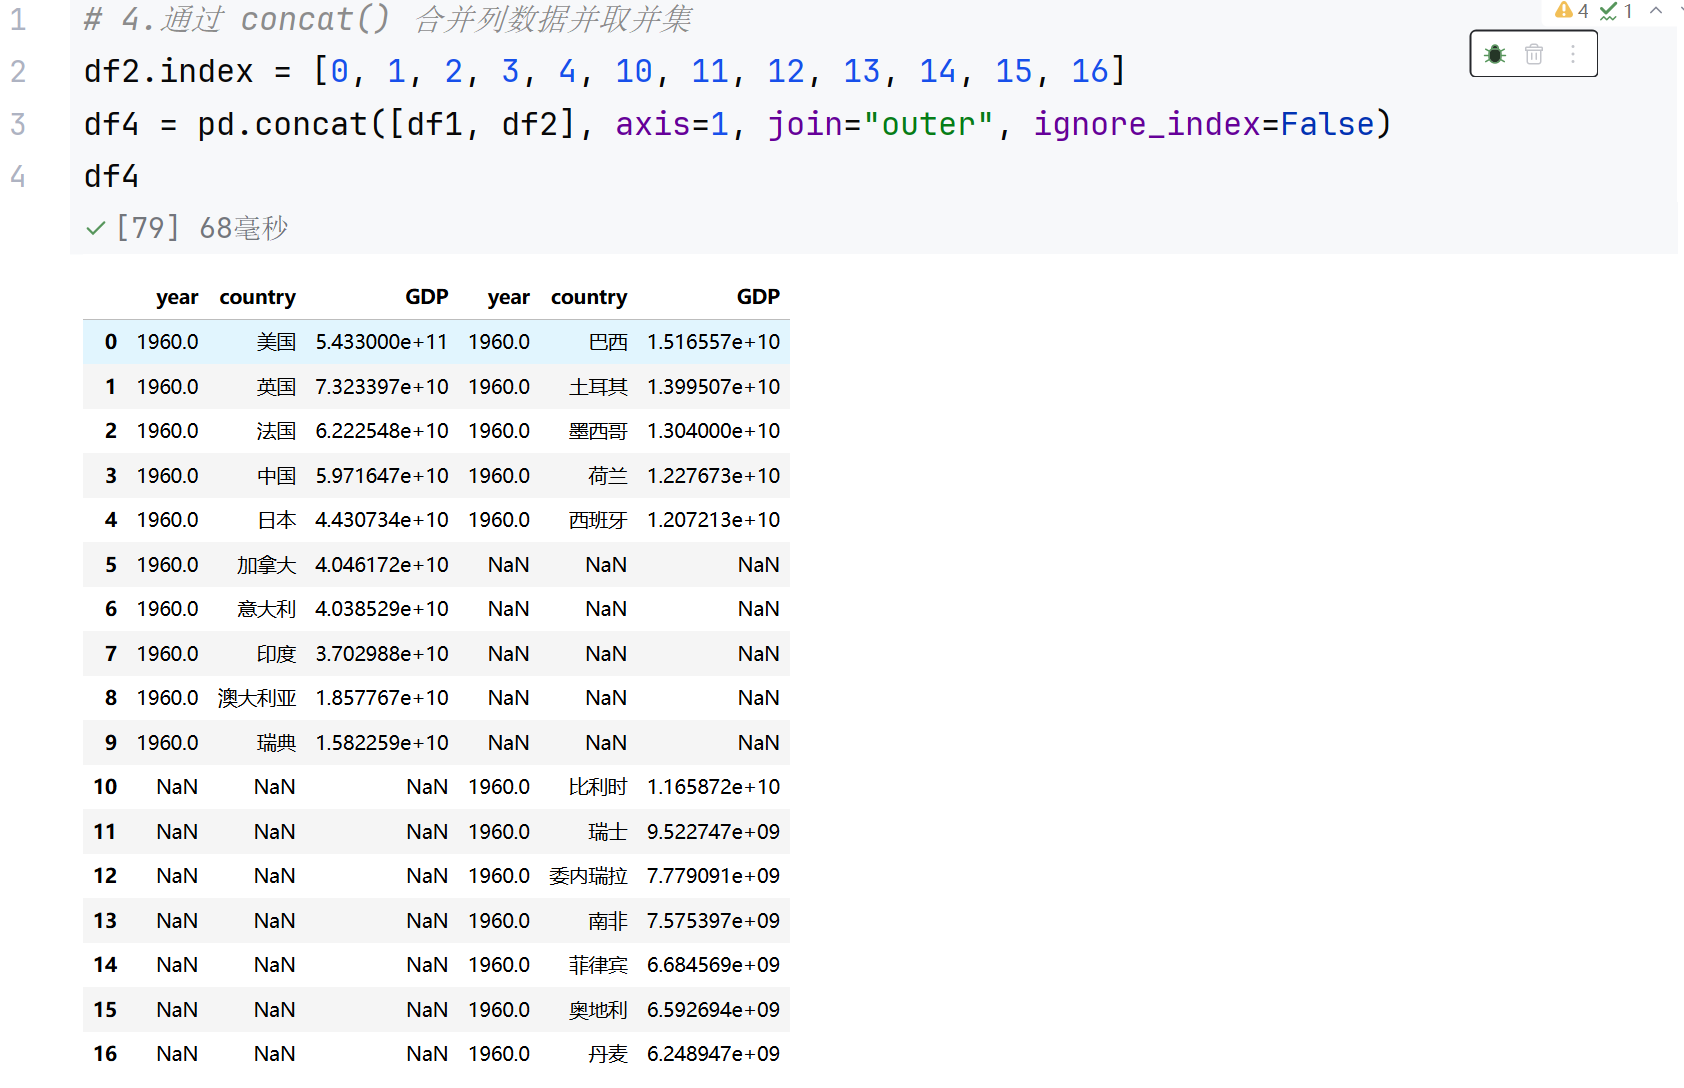
# 按索引对齐,左右拼接;inner 只保留索引共有的行
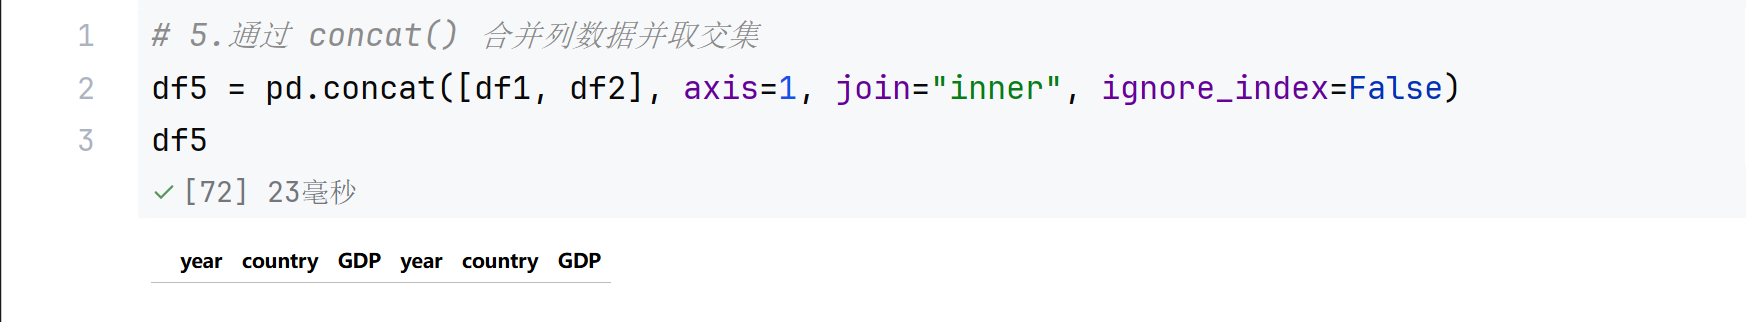
df_wide = pd.concat([df_a, df_b], axis=1, join='inner')
横向拼接默认参考**行索引,**未匹配位置填充 NaN
案例如下:
3.2.2 pd.merge():键值关联合并
pd.merge() :通过指定的关联列 / 索引匹配两张表的数据,类似 SQL 的 JOIN 操作,是最灵活的合并方式
核心参数:
| 参数 | 说明 |
|---|---|
left / right |
左表、右表 |
how |
连接类型:'inner'(默认)、'left'、'right'、'outer' |
on |
关联列名,两表列名相同时使用,支持列表实现多键合并 |
left_on / right_on |
左右表的关联列名,两表列名不同时使用 |
left_index / right_index |
是否用索引作为关联键,布尔值 |
suffixes |
元组,指定重名列的后缀,默认 ('_x', '_y') |
indicator |
是否新增列标记数据来源(left_only/right_only/both) |
validate |
校验连接类型,如 'one_to_one' 避免笛卡尔积 |
存在四种连接类型:
| how 取值 | 对应 SQL | 效果说明 |
|---|---|---|
inner |
inner join | 只保留两表关联键匹配的行(交集),默认 |
left |
left join | 保留左表全部行,右表匹配不上的位置为 NaN |
right |
right join | 保留右表全部行,左表匹配不上的位置为 NaN |
outer |
full outer join | 保留两表全部行(并集),匹配不上的位置为 NaN |
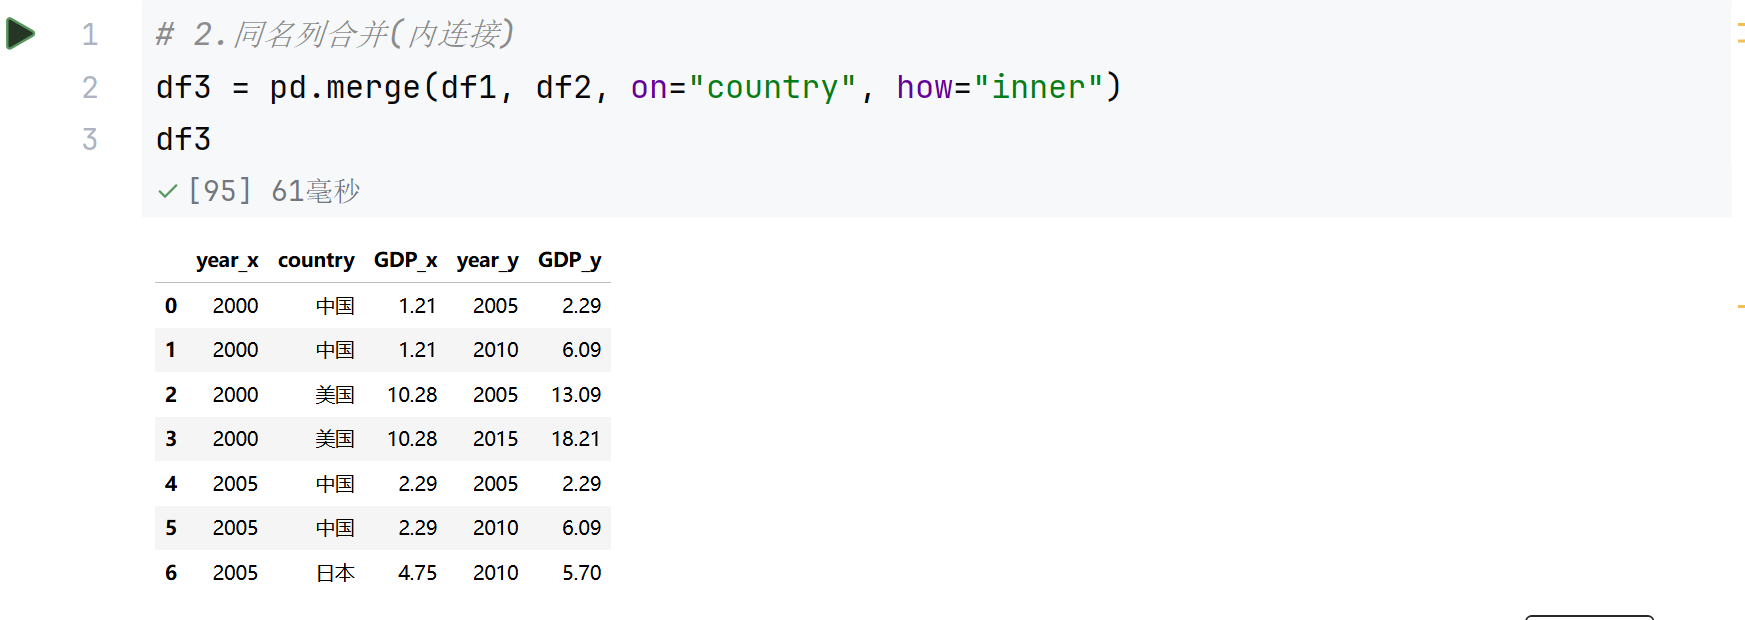
1.同名列关联
# 两表都有 user_id 列,按该列左连接
df = pd.merge(左表df1, 右表df2, on='user_id', how='left')
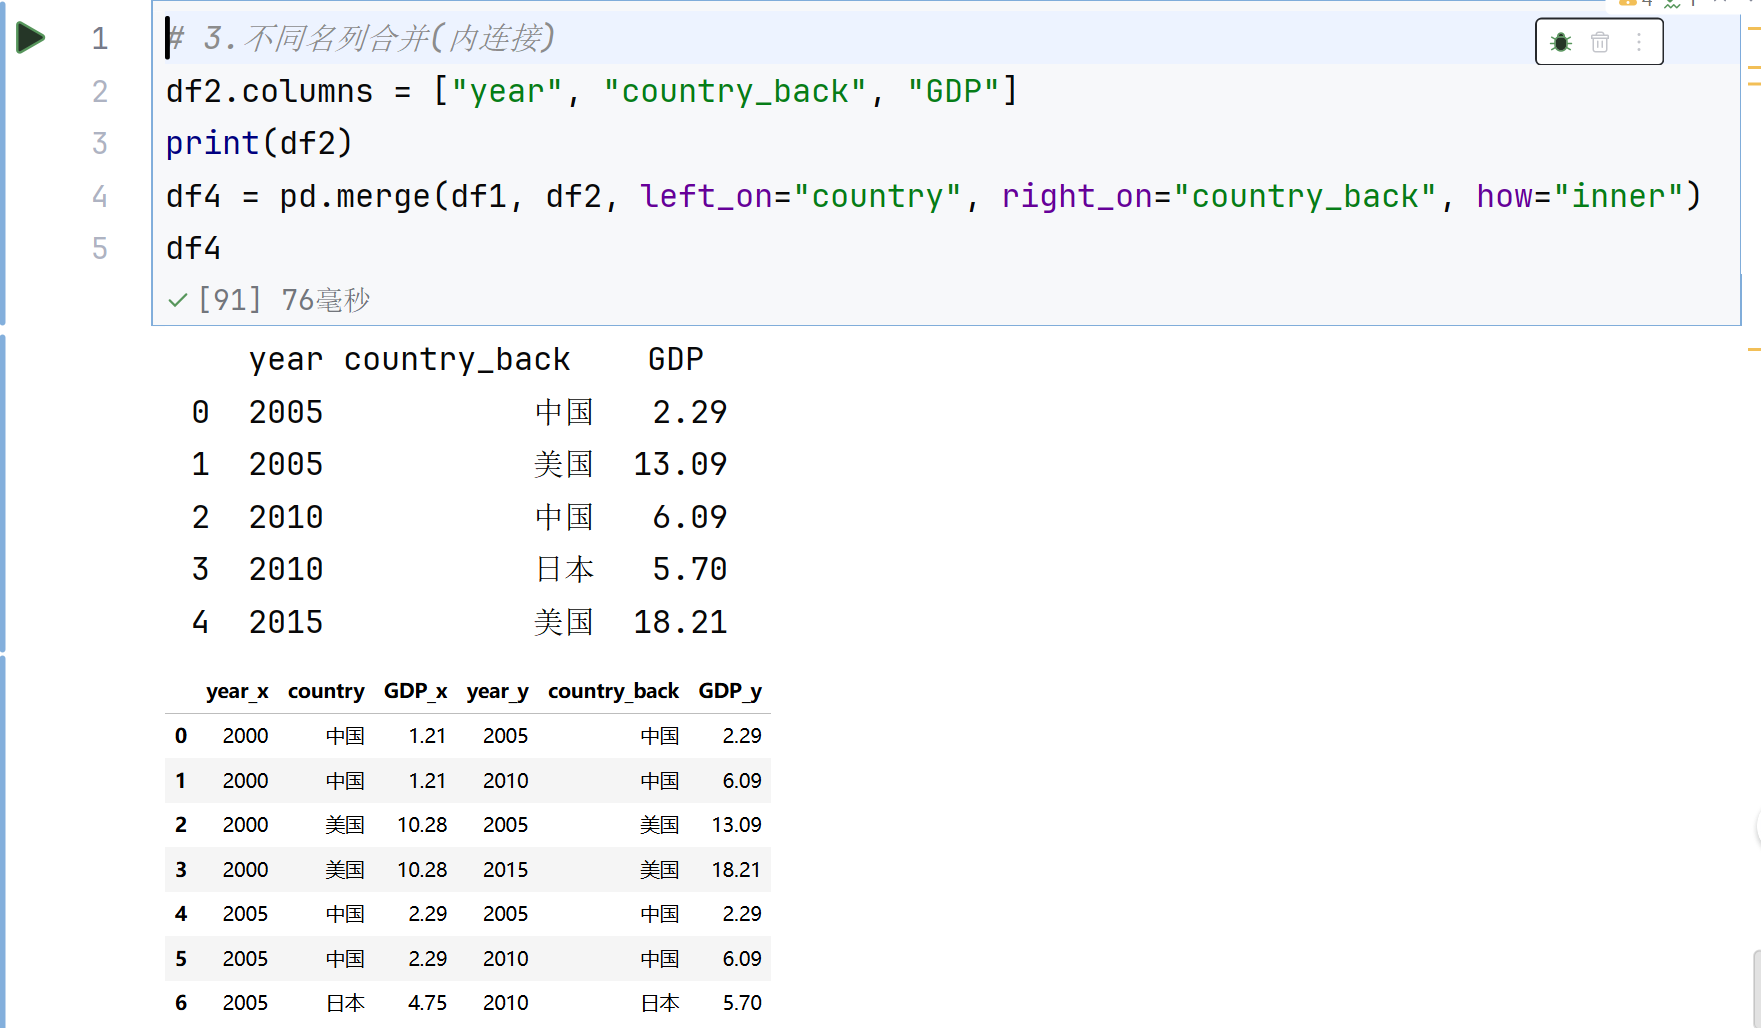
2.不同名列关联
# 左表列名 id,右表列名 user_id
df = pd.merge(左表df1, 右表df2, left_on='id', right_on='user_id', how='inner')
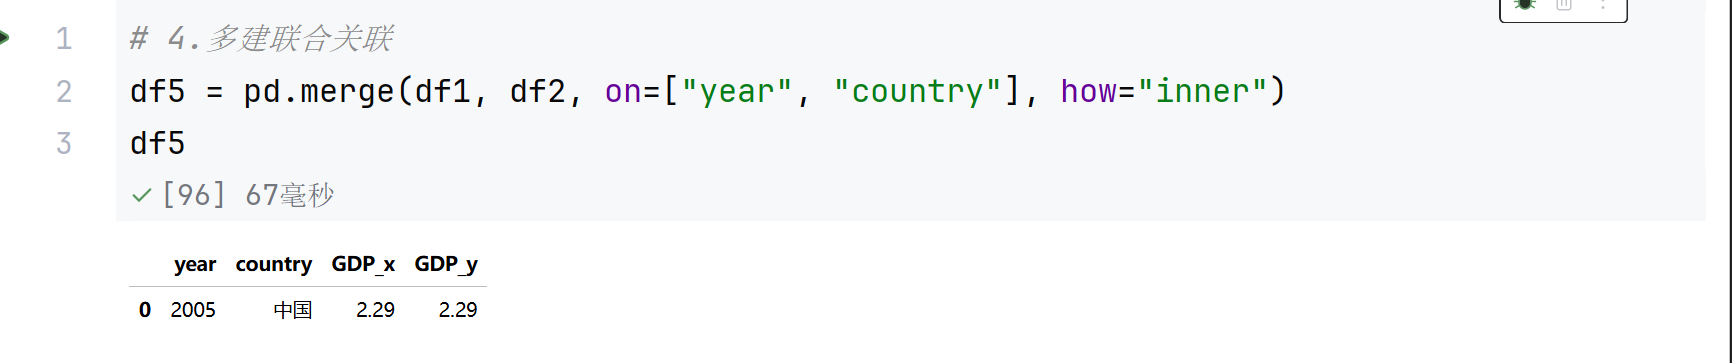
3.多建联合关联
# 按 日期+门店 两个字段联合匹配
df = pd.merge(左表df1, 右表df2, on=['日期', '门店'], how='left')
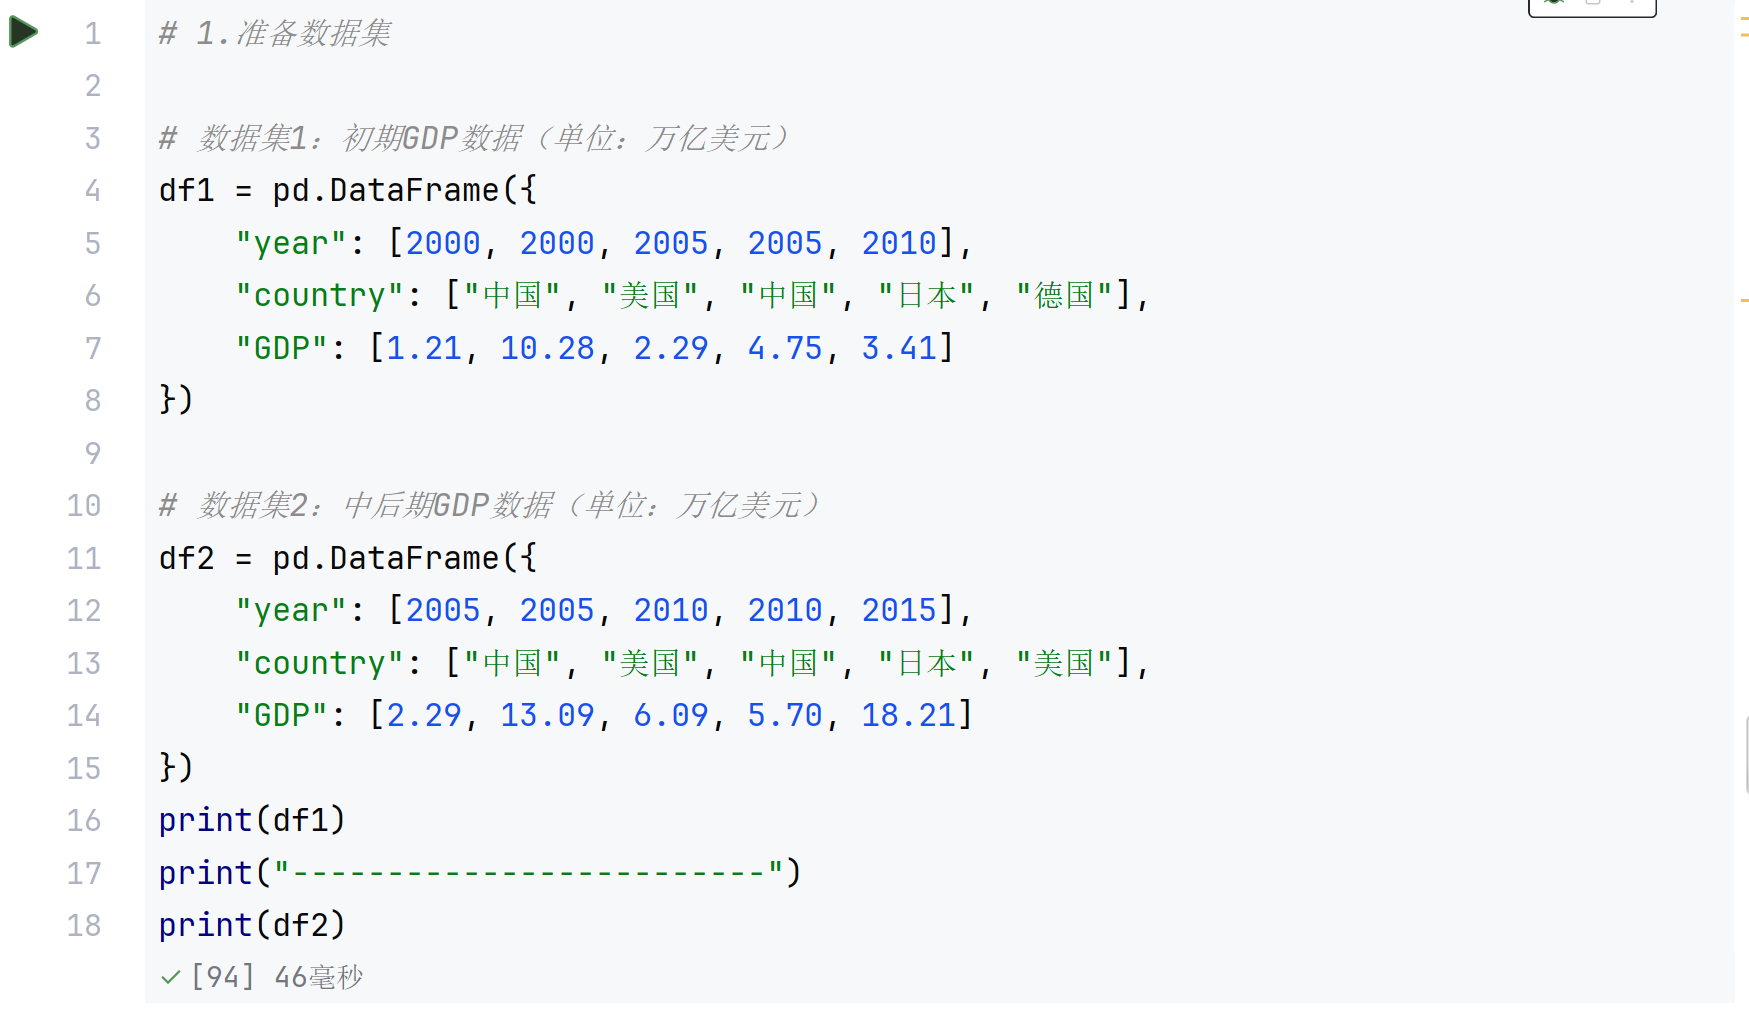
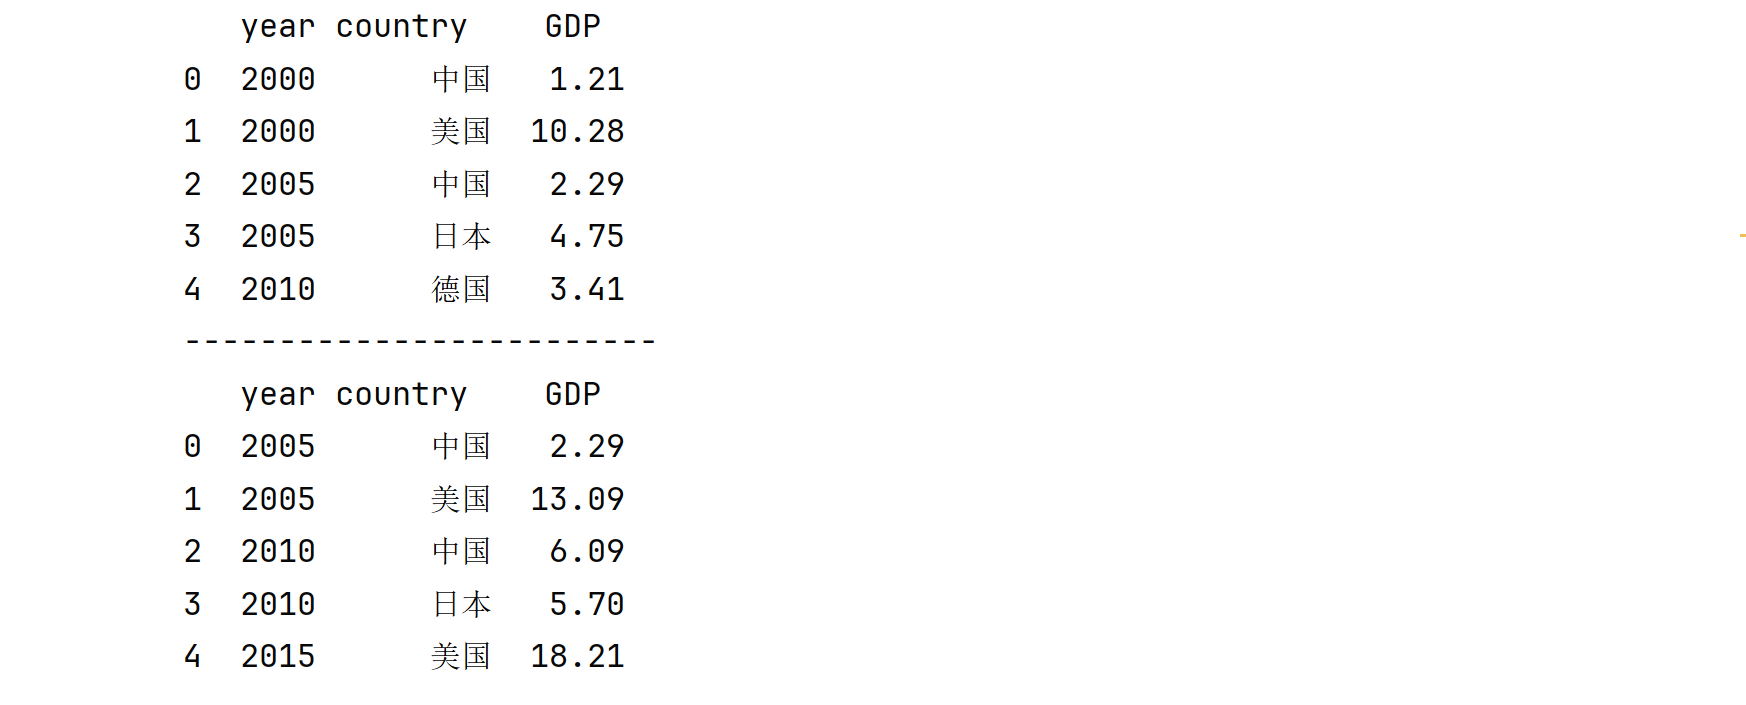
案例如下:
3.2.3 DataFrame.join ():索引级合并
DataFrame.join () :专门基于行索引进行合并,是pd.merge()的语法糖
核心参数:
| 参数 | 说明 |
|---|---|
other |
右表,支持单个或多个 DataFrame |
on |
左表用于关联的列,右表默认用索引匹配 |
how |
连接方式,默认 'left' |
lsuffix / rsuffix |
左右表重名列的后缀 |
语法如下:
# 按索引左连接,重名列加后缀区分
df = df1.join(df2, lsuffix='_左', rsuffix='_右')

# 左表用 user_id 列,右表用索引关联
df = df1.join(df2, on='user_id')
3.3 数据分组处理
数据分组基于拆分 - 应用 - 合并范式:
- 按指定键将数据拆分为多个独立子组
- 对每组分别执行计算逻辑
- 最终合并所有结果
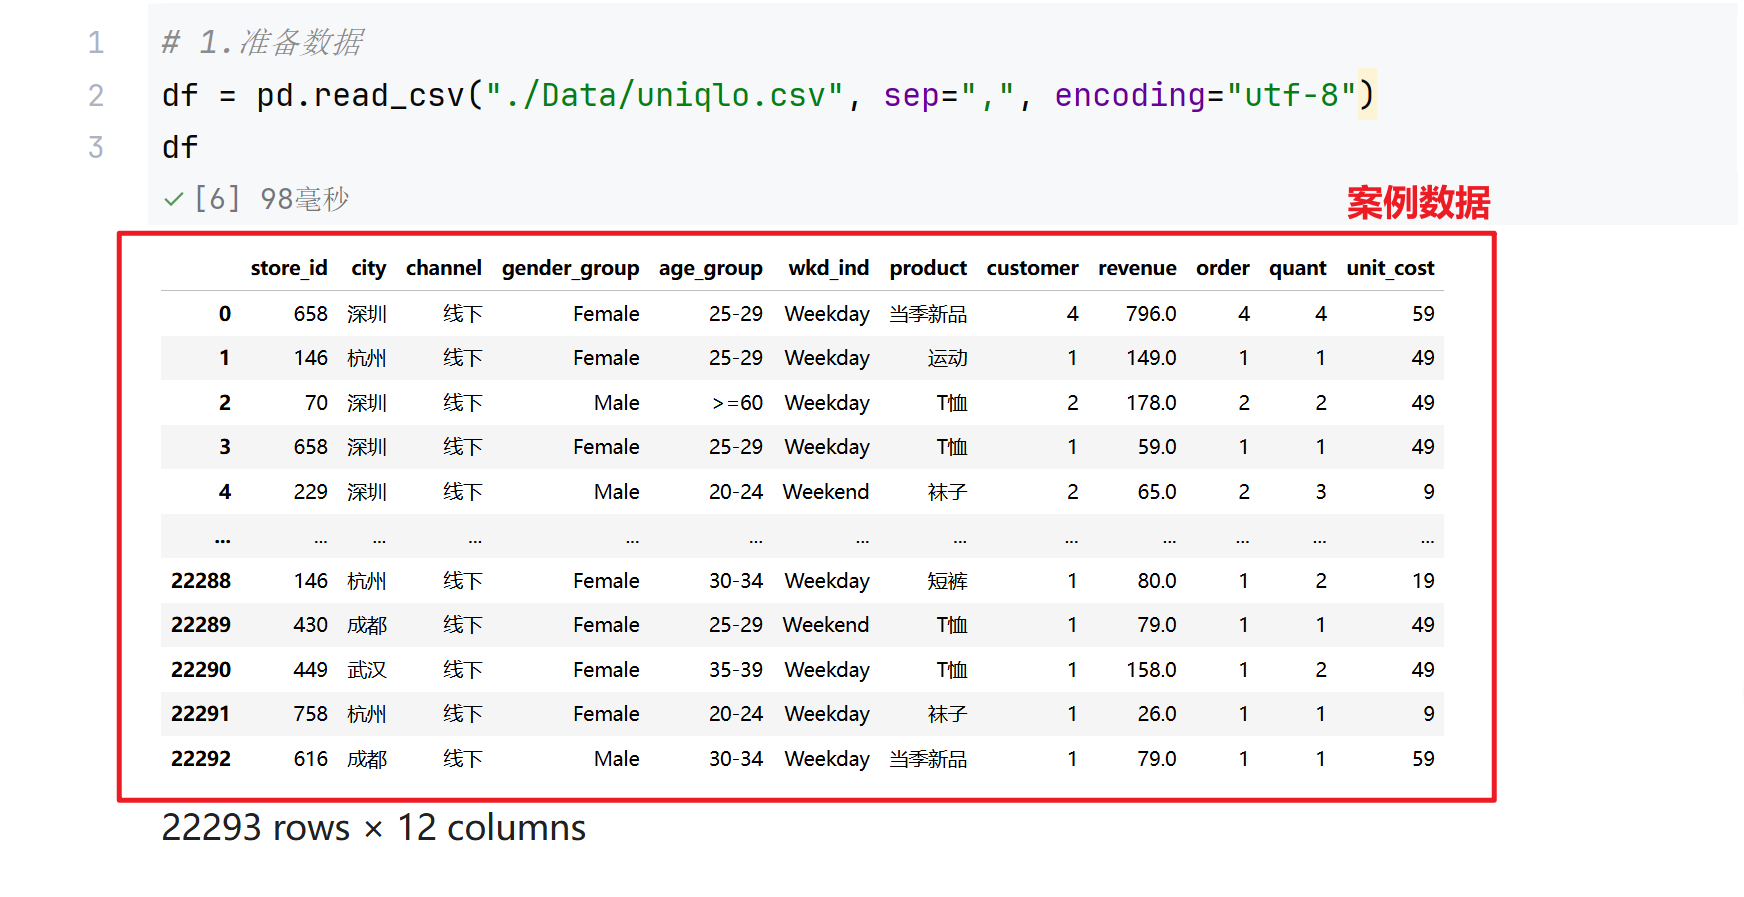
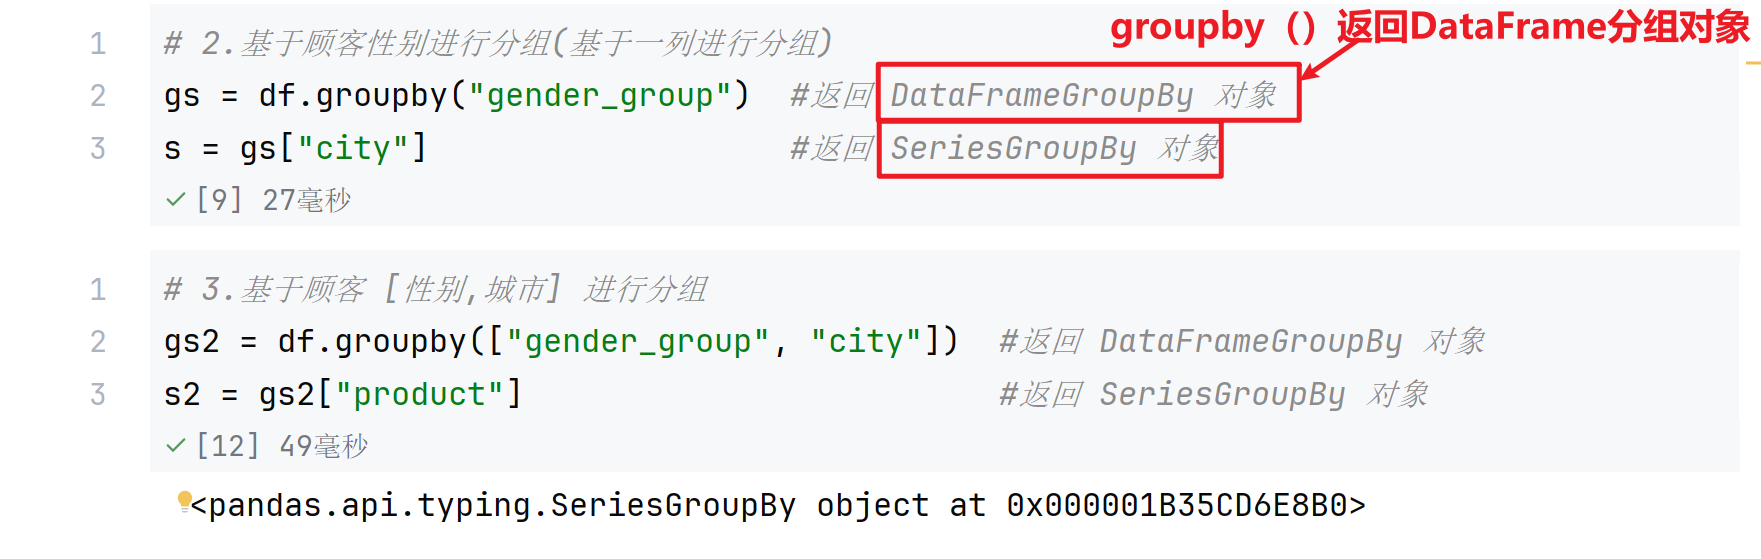
3.3.1 df.groupby ():分组
df.groupby ():按指定键生成分组对象,必须接后续操作才会返回结果
核心参数:
| 参数 | 说明 |
|---|---|
by |
分组键(核心) ,支持传入列名字符串、列名列表、字典、映射函数、Series |
axis |
分组维度,0= 按行分组(默认);1= 按列分组 |
as_index |
是否将分组键作为结果的行索引,默认 True;设为 False 会转为普通列 |
sort |
是否对分组键排序,默认 True;大数据量设为 False 可提升性能 |
group_keys |
是否在结果中添加分组键层级索引,默认 True |
dropna |
是否删除分组键为 NaN 的组,默认 True;设为 False 可保留缺失分组 |
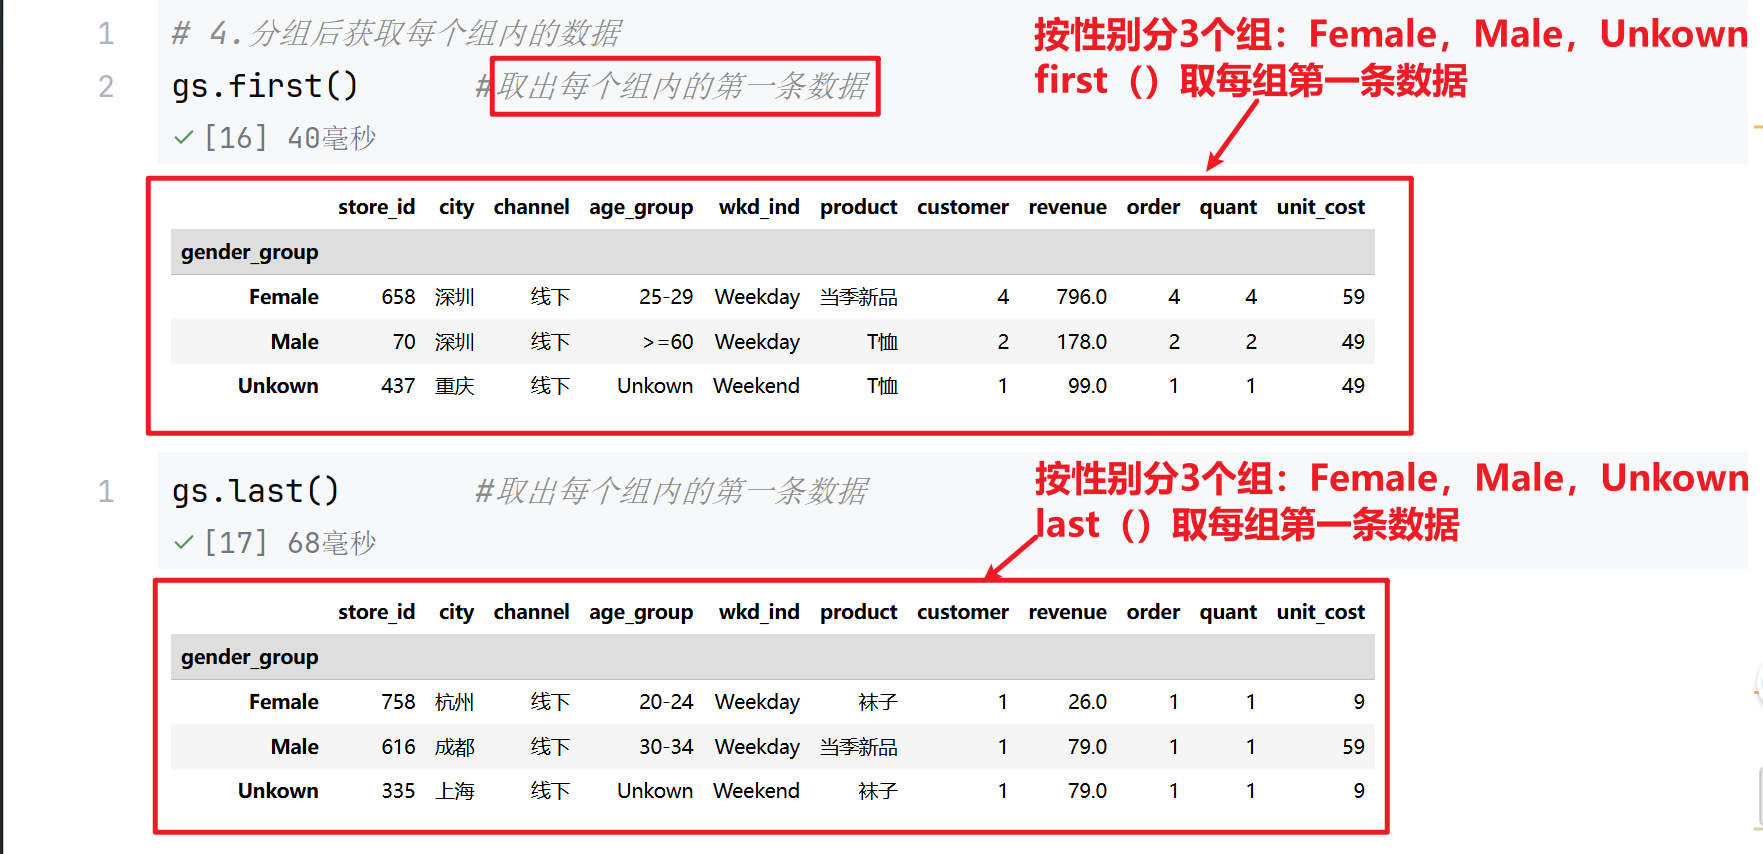
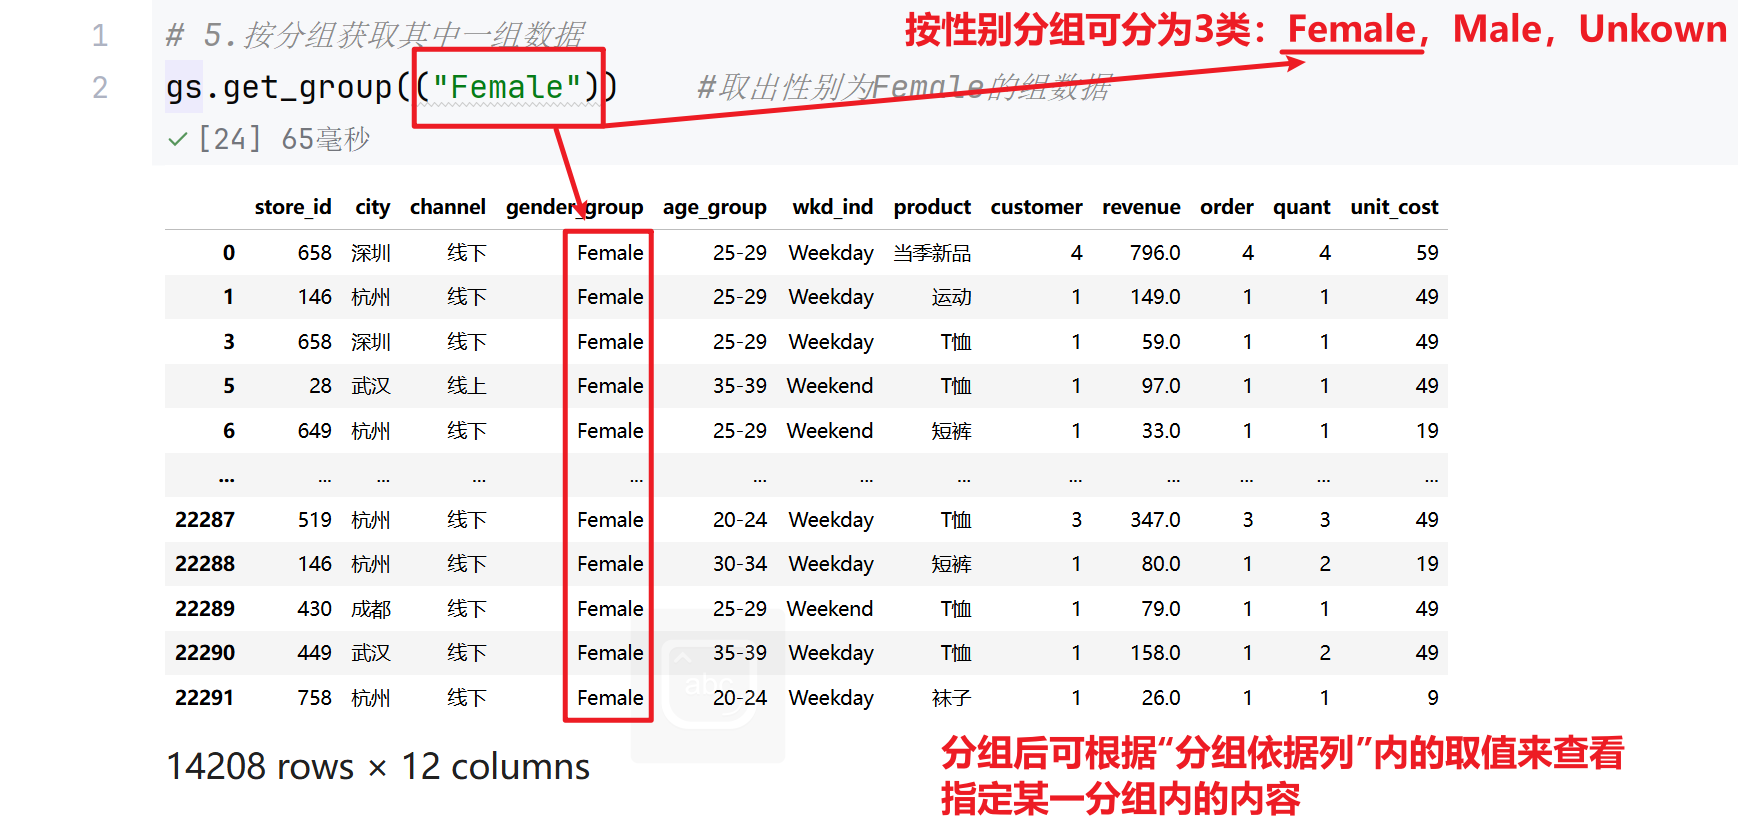
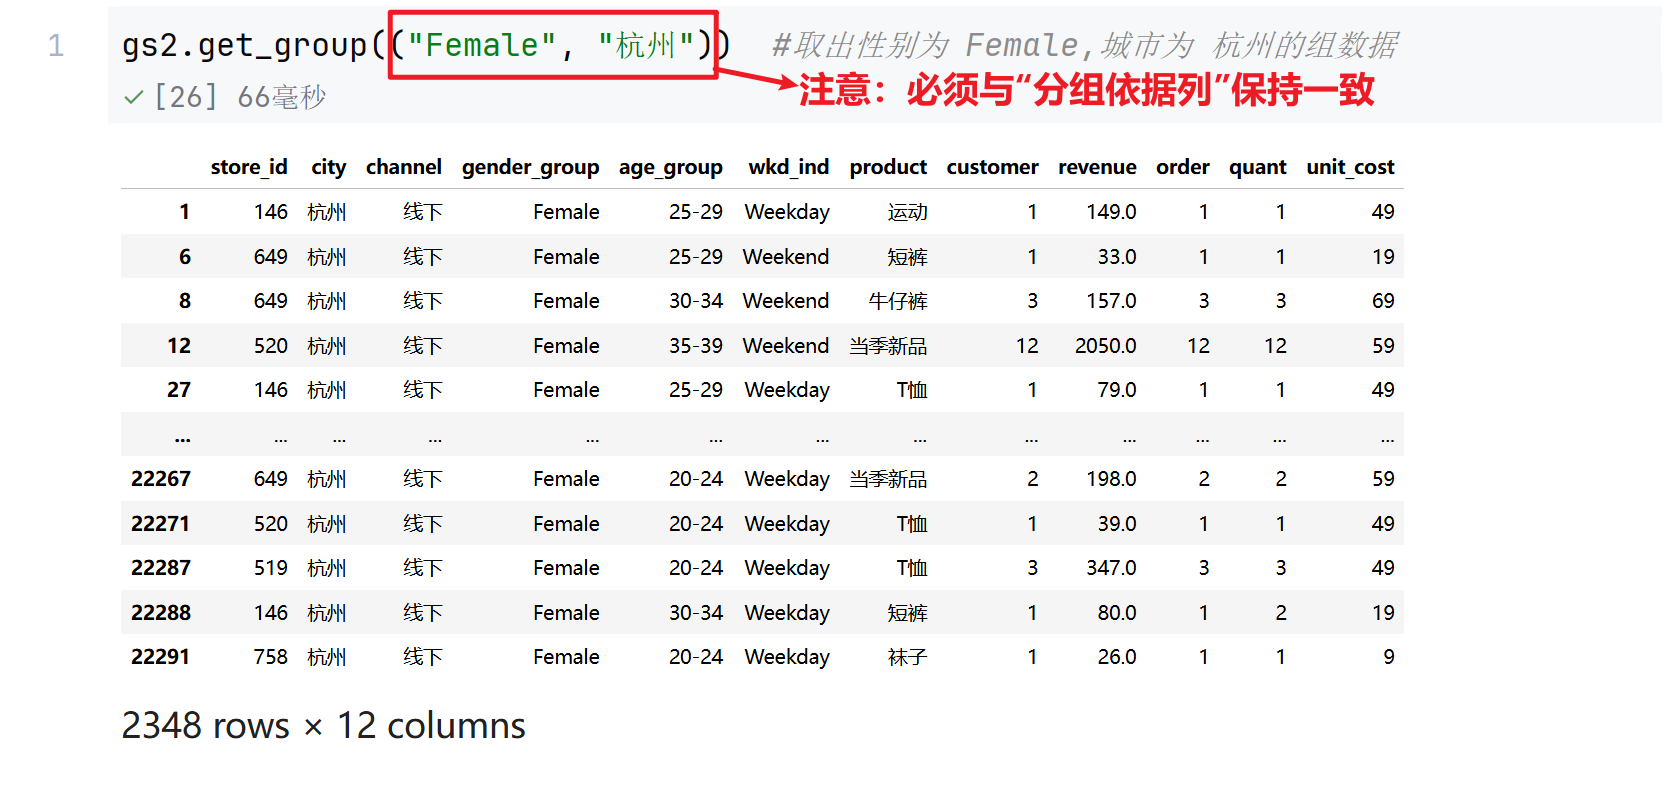
案例如下:
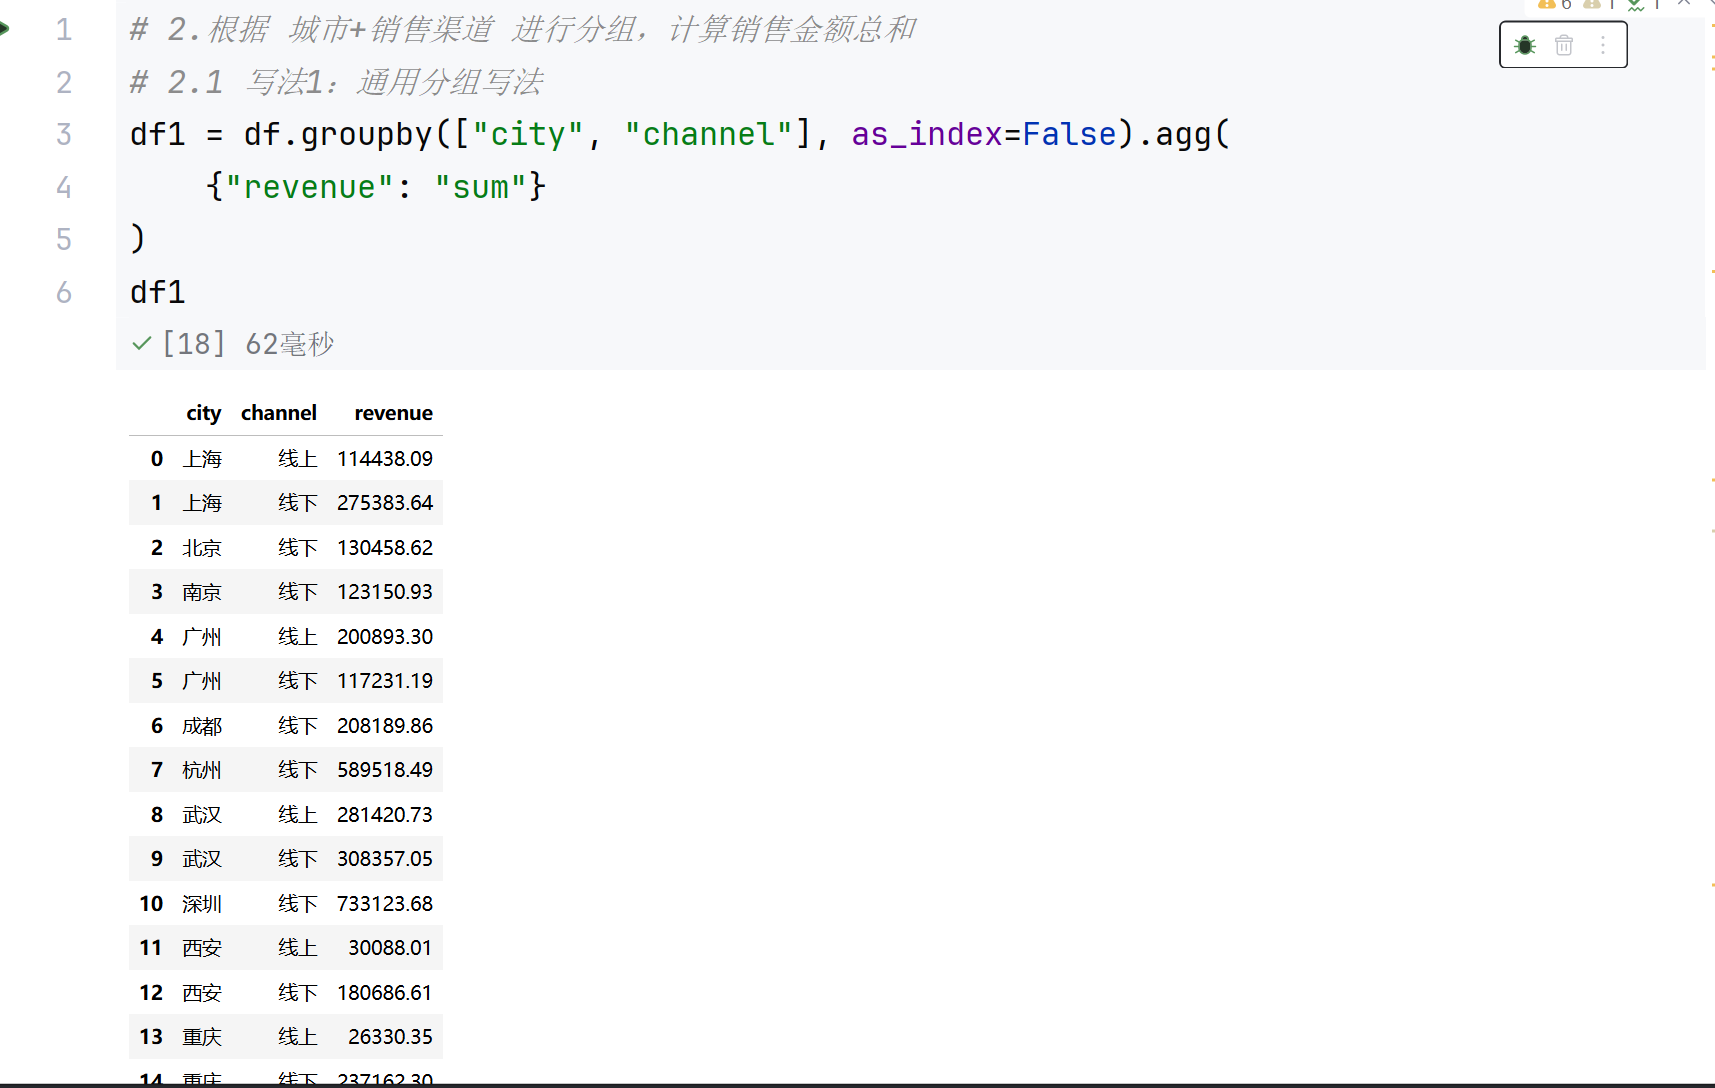
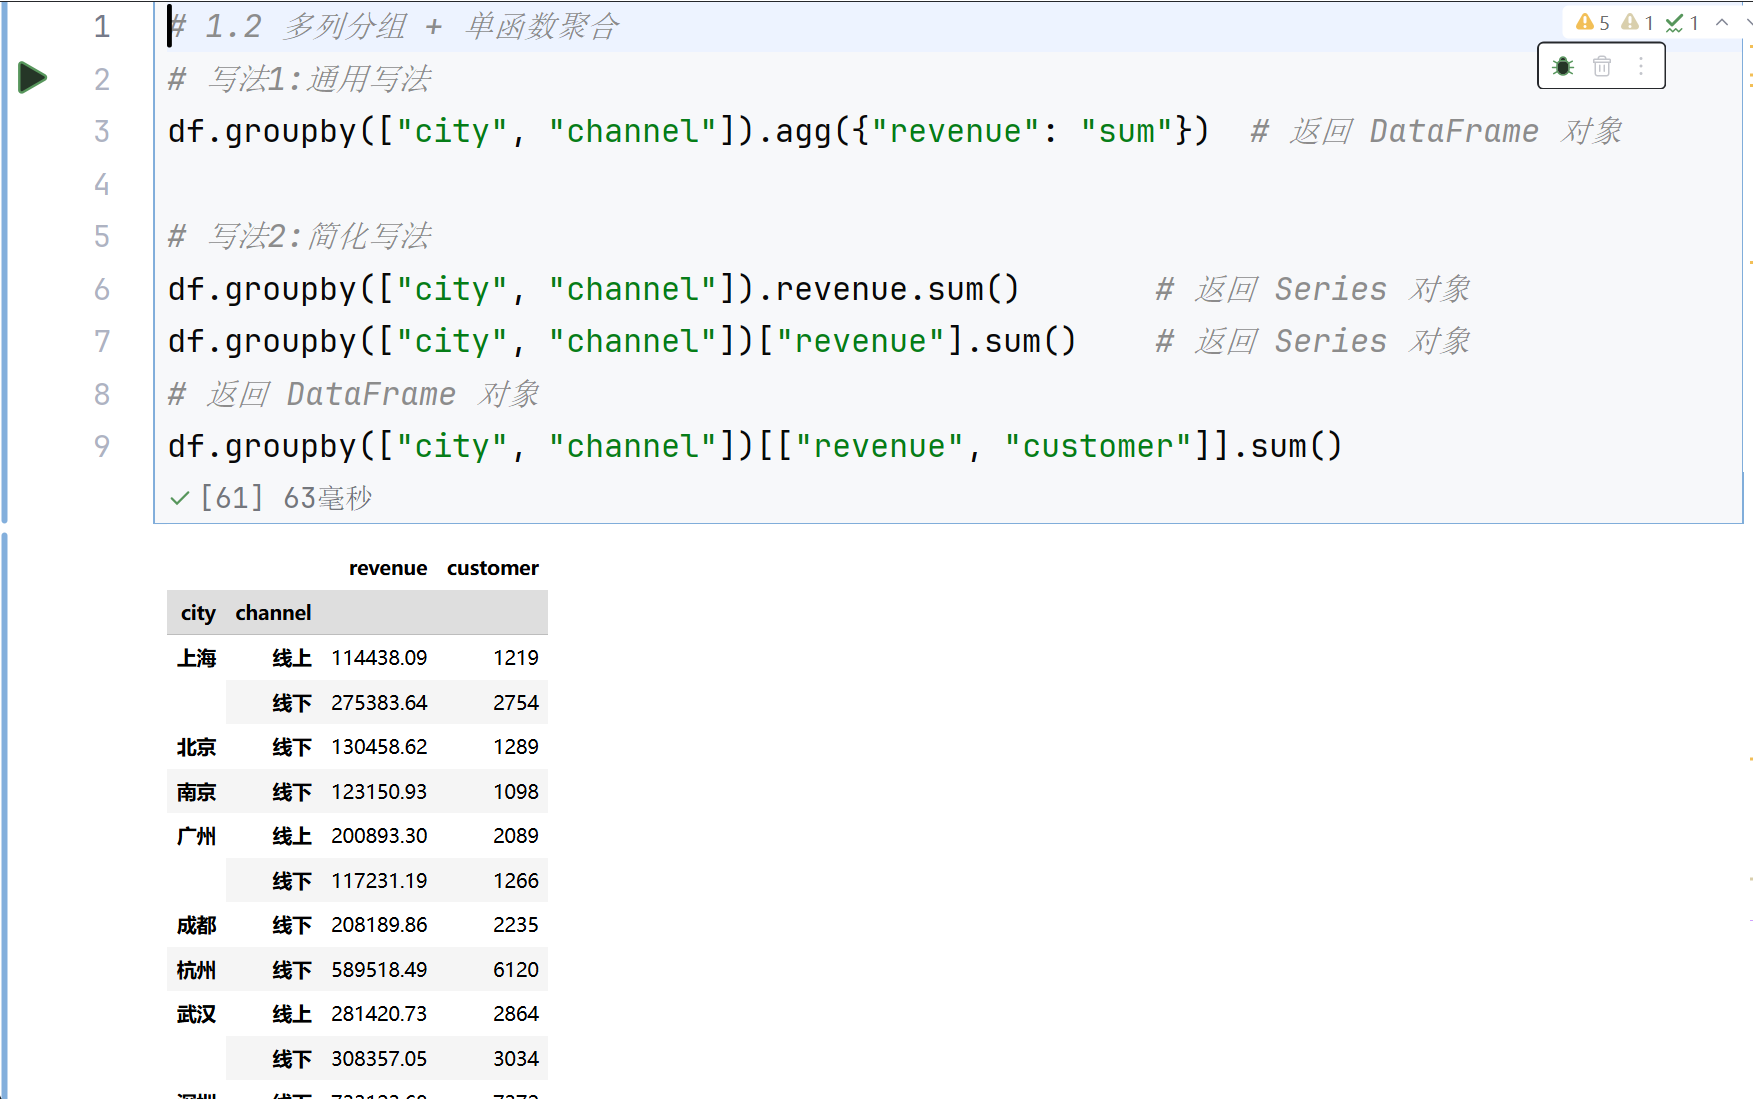
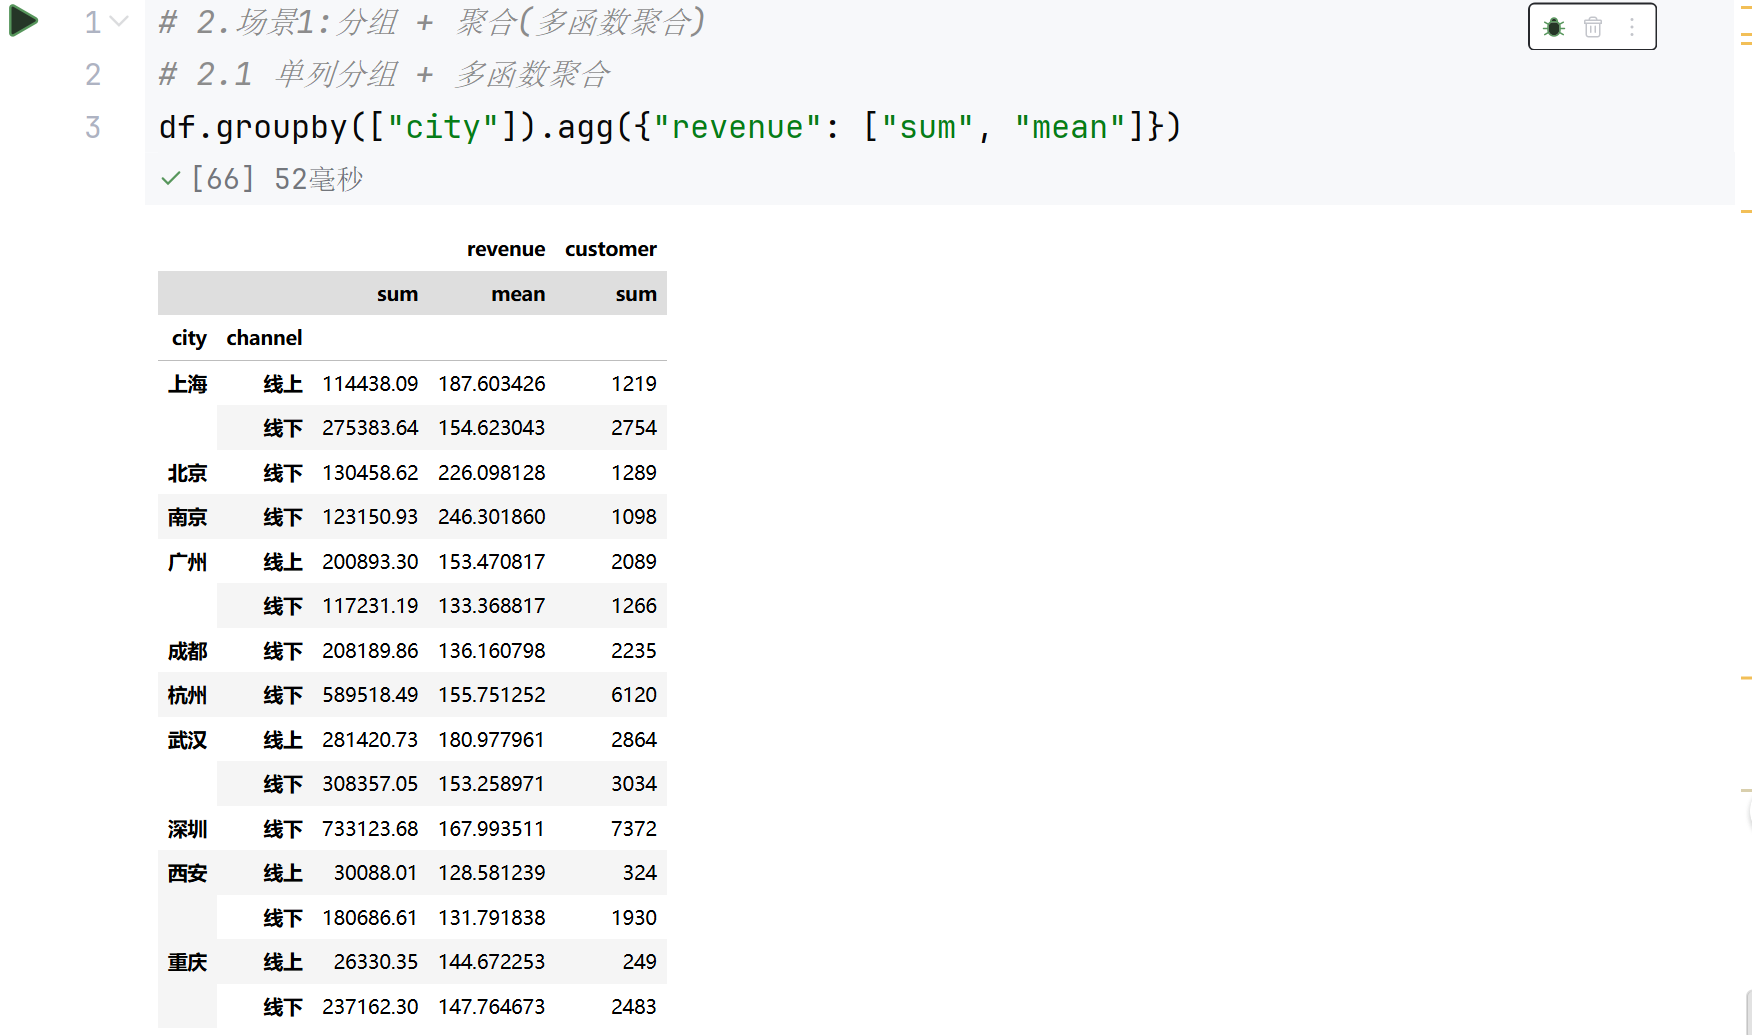
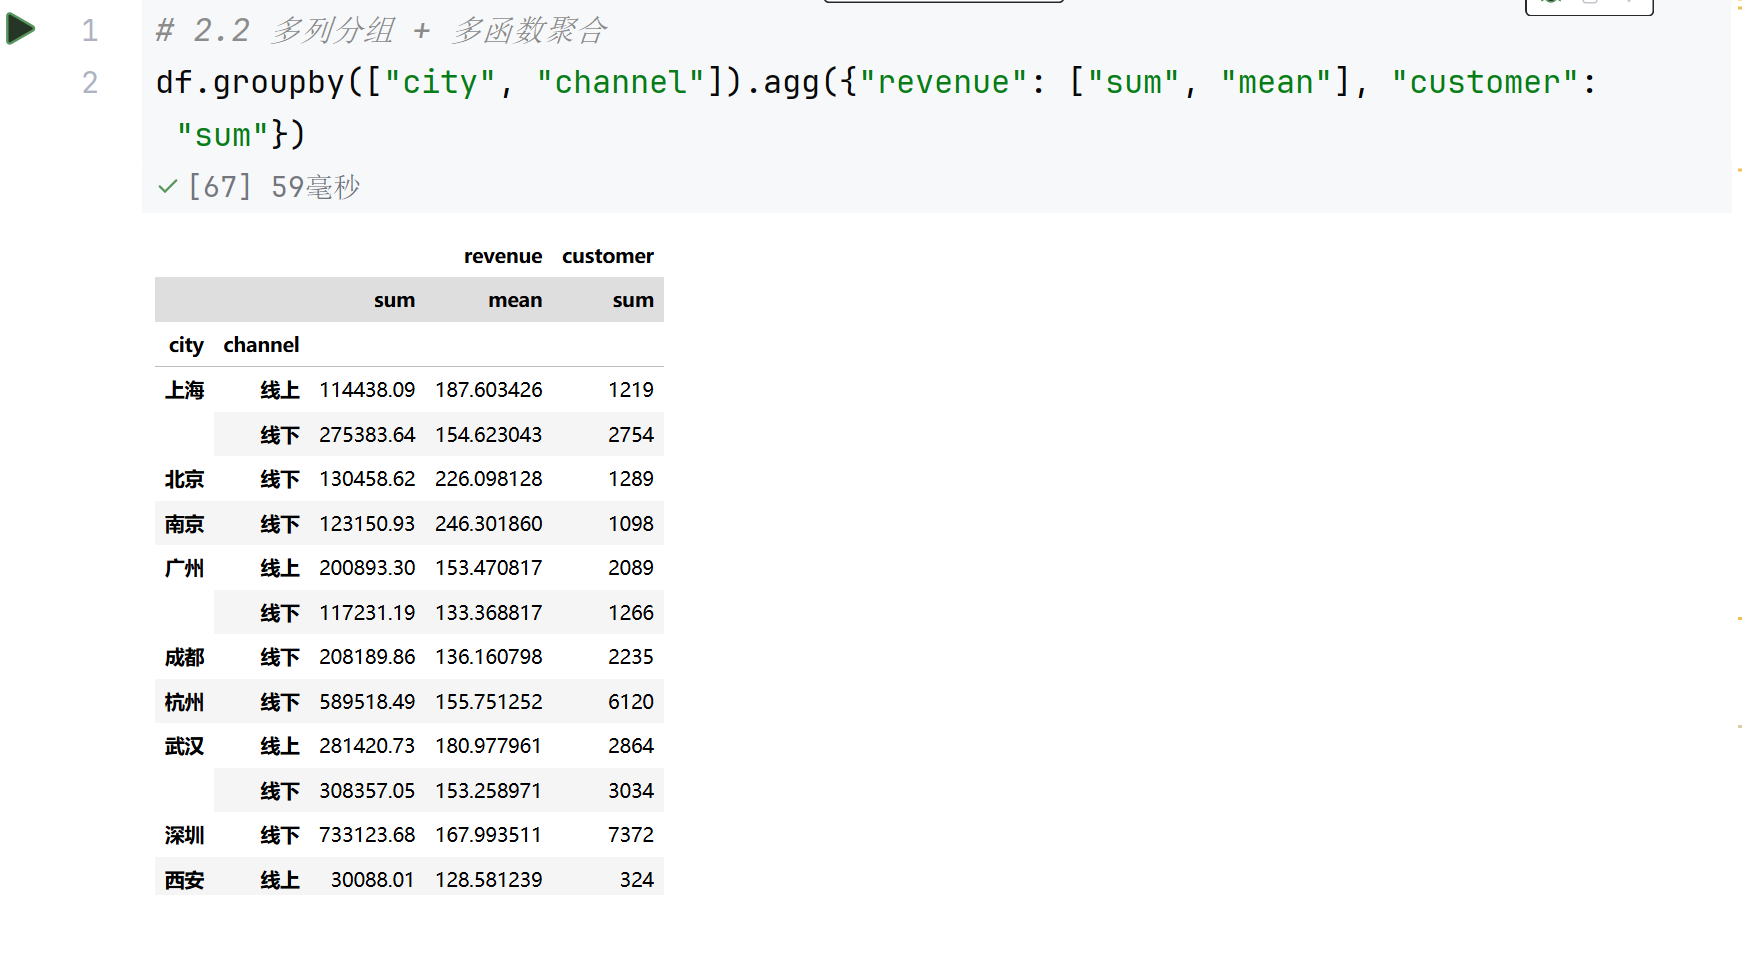
3.3.2 聚合统计(agg)
对每组数值列计算统计量,返回压缩后的结果(一行对应一个分组)
1. 单函数聚合
# 按单列分组,计算所有数值列的均值
df.groupby(列名1)[列名2].mean()

# 按 列名1 + 列名2 双列分组,仅计算列名3的数值总和
df.groupby([列名1, 列名2])[列名3].sum()
2. 多函数聚合
# 对列名3同时计算 总和、均值、最大值、计数
df.groupby([列名1, 列名2])[列名3].agg(['sum', 'mean', 'max', 'count'])
3. 多列分别聚合
df.groupby([列名1, 列名2, ...]).agg({
    '指定列1':'聚合函数名',
    '指定列2':'聚合函数名',
    '指定列3':'聚合函数名',
    ...
})
aggregate:聚合
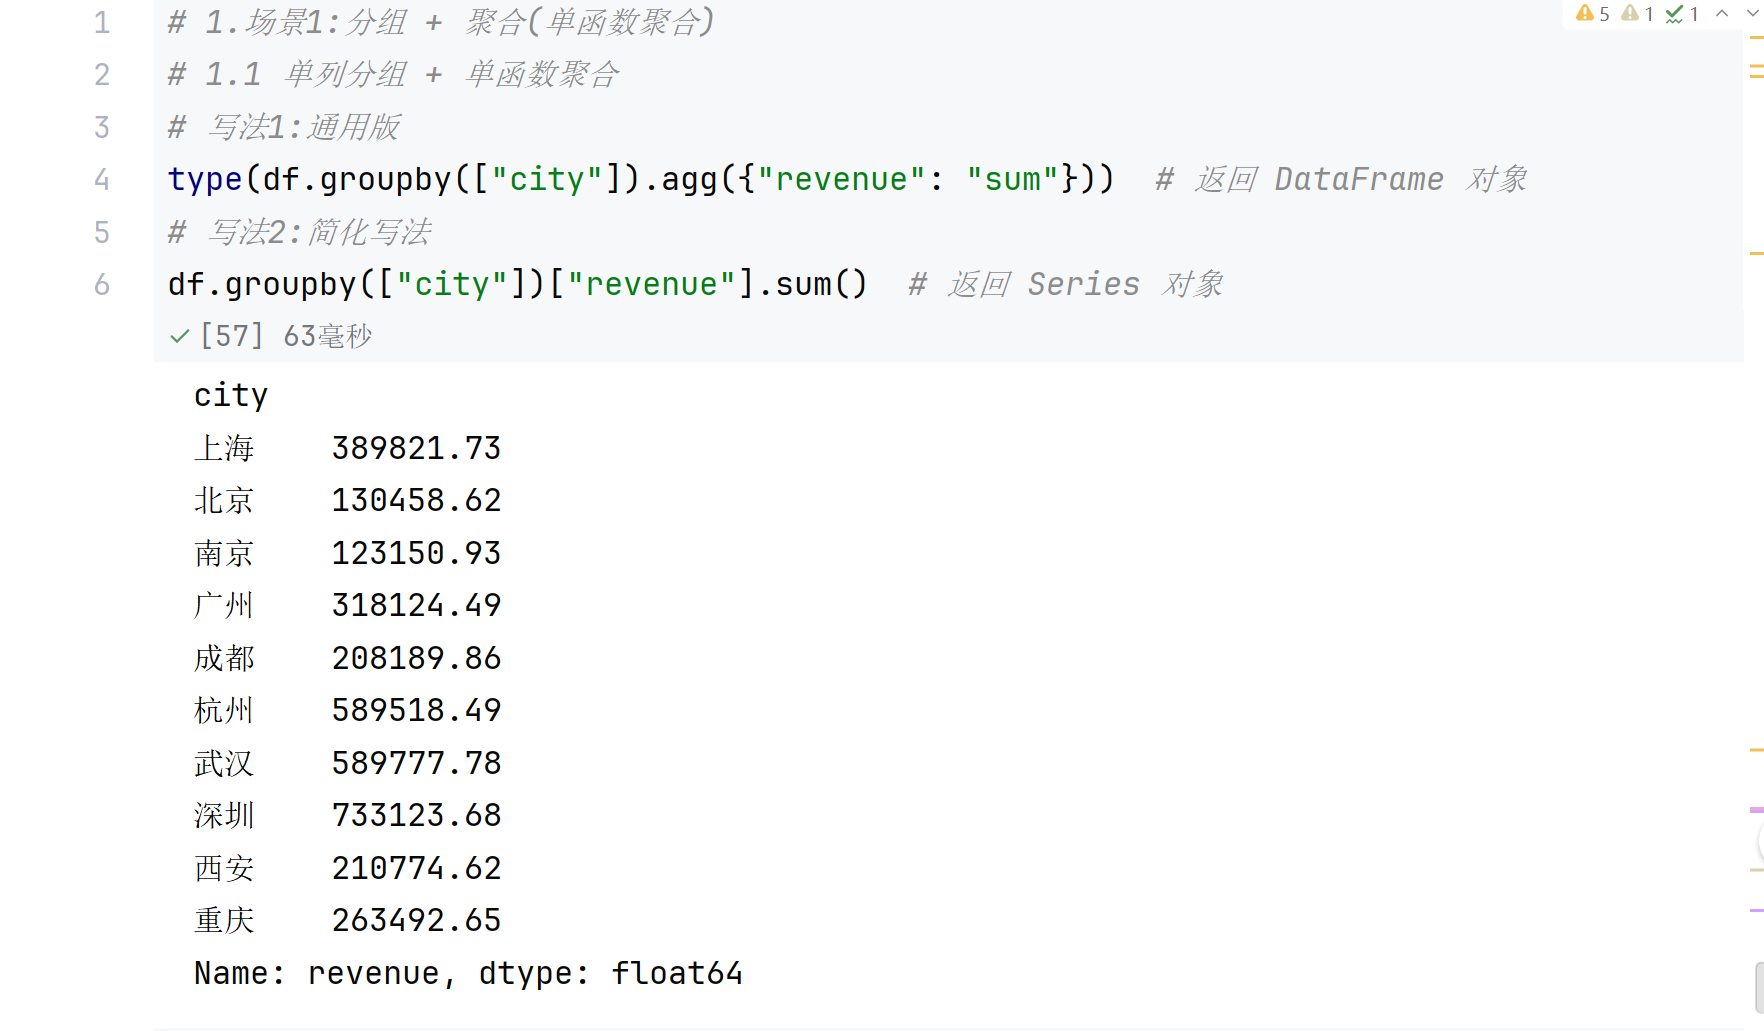
案例如下:
3.3.3 分组转换(transform)
groupby.transform() :是 Pandas 分组体系中专门用于逐行变换的核心工具,核心特性是「分组计算,广播回填」------ 返回和原数据行数完全一致的结果,索引自动和原表对齐
原理:
transform 遵循「拆分 - 应用 - 广播」的执行流程:
- 拆分:按分组键将原数据拆分为多个子组
- 应用:对每个子组的指定列执行变换函数
- 广播:将计算结果回填到原分组的每一行,最终输出行数和原数据完全相同
和 agg 最本质的区别:
- agg:每组返回 1 行汇总结果,总行数 = 分组数量
- transform:每组返回和原分组行数相同的结果,总行数 = 原数据行数
注意:分组转换类似于MySQL的窗口函数
语法如下:
def 自定义函数(分组子df, 可选参数):
    # 对单个分组的子df做任意处理
    return 处理后的结果


df.groupby(分组键)[目标列].transform(变换函数, 可选参数)
适用场景:
1. 组内缺失值填充
# 按地区分组,用组内中位数填充销售额缺失值
df['销售额'] = df.groupby('地区')['销售额'].transform(lambda x: x.fillna(x.median()))
2.组内标准化 / 归一化
# 按产品分组,对销售额做组内标准化
df['销售额_组内标准化'] = df.groupby('产品')['销售额'].transform(
    lambda x: (x - x.mean()) / x.std()
)
3. 组内排名
# 按地区分组,销售额从高到低排名
df['地区内销售排名'] = df.groupby('地区')['销售额'].transform('rank', ascending=False)
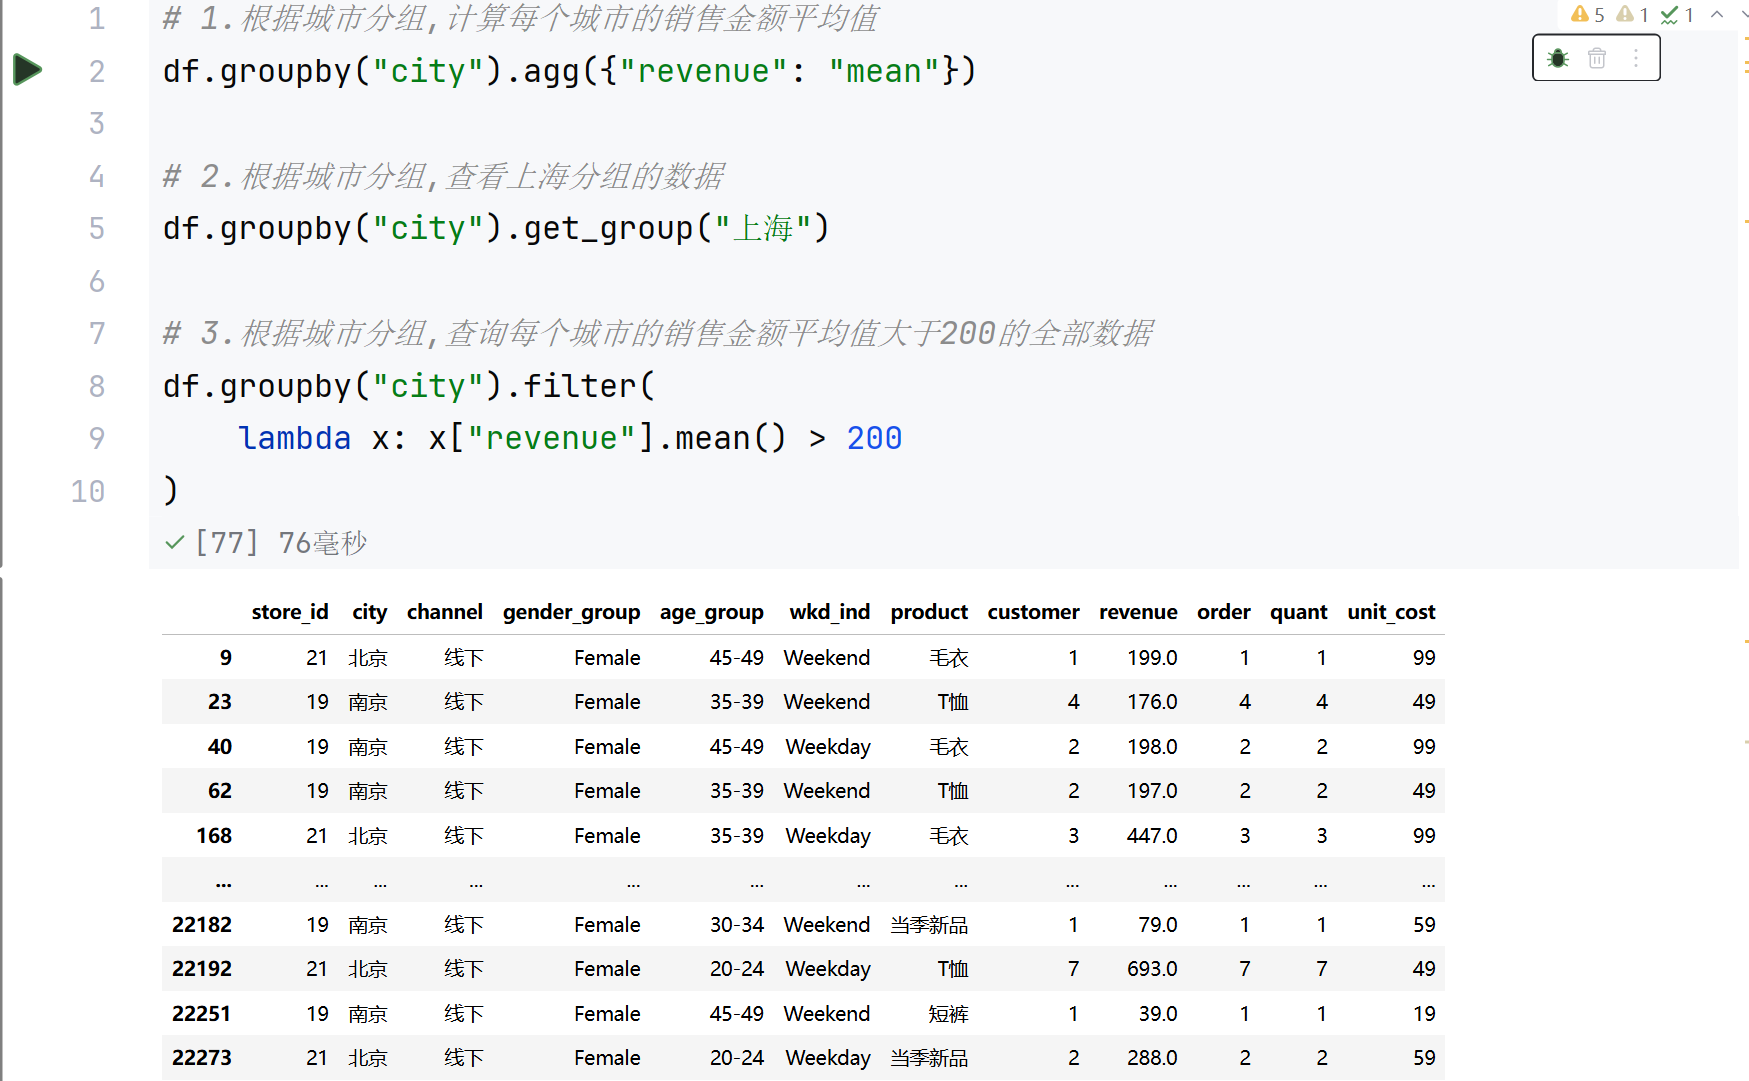
3.3.4 分组过滤(filter)
filter() :按组整体的条件 筛选数据,符合条件的整组保留,不符合的整组删除,返回原表结构的子集
格式如下:
def 判断函数(分组子df, 可选参数):
    # 对整个分组做判断,必须返回单个布尔值 True/False
    return 布尔条件

df.groupby('分组列').filter(判断函数, 可选参数值)
案例如下:
3.3.5 分组应用(apply)
groupby.apply():最灵活的分组方法,它可以对每个分组的完整子 DataFrame 执行自定义逻辑,再合并结果
核心原理
groupby.apply 的执行流程:
- 拆分:按分组键把原 DataFrame 拆成多个独立的子 DataFrame
- 应用 :把每个子 DataFrame 作为参数,传入你定义的函数
- 合并:将所有分组的返回结果拼接成最终输出
它的核心优势是:函数内部可以访问分组内的所有列、所有行,可以写任意复杂的业务逻辑
基础语法如下:
def 自定义函数(分组子df, 可选参数):
    # 对单个分组的子df做任意处理
    return 处理后的结果

df.groupby('分组列').apply(自定义函数, 可选参数值)
3.3.6 交叉表和透视表
Pandas 中pivot_table(透视表)和 crosstab(交叉表)都是多维度数据聚合与统计分析 的核心工具,本质是分组聚合的语法糖,但定位和适用场景有明显区别:
- 透视表 :通用型多维数值聚合工具,对标 Excel 数据透视表;
- 交叉表 :专门用于分类变量的频数 / 占比分析,生成列联表
1.交叉表
corsstab :专门生成列联表(交叉频数表),默认统计分类变量组合的出现次数,也支持自定义聚合;它是 Pandas 顶级函数,不能通过 DataFrame 直接调用
语法如下:
table = pd.crosstab(index, columns, values=None, aggfunc=None, ...)核心参数:
| 参数 | 说明 |
|---|---|
index |
行维度(Series / 数组 / 列表) |
columns |
列维度(Series / 数组 / 列表) |
values |
待聚合的数值列,必须配合 aggfunc 使用 |
aggfunc |
聚合函数,默认 None(此时执行计数) |
normalize |
标准化计算占比:'index' 行占比、'columns' 列占比、'all' 整体占比 |
margins |
是否显示边际合计,默认 False |
rownames/colnames |
行 / 列索引的自定义名称 |
代码示例:
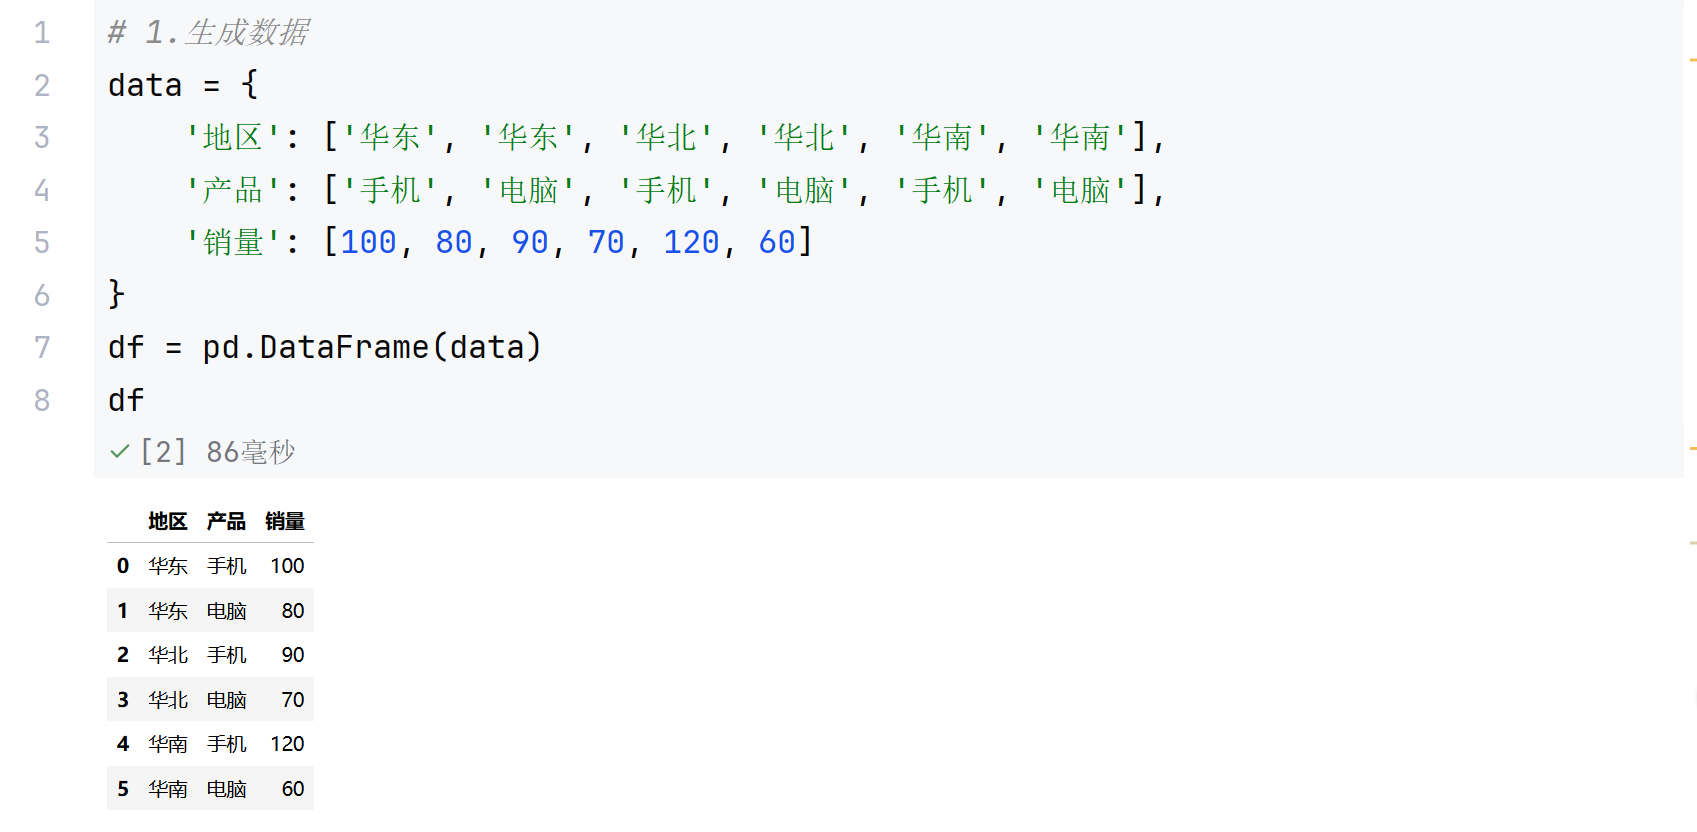
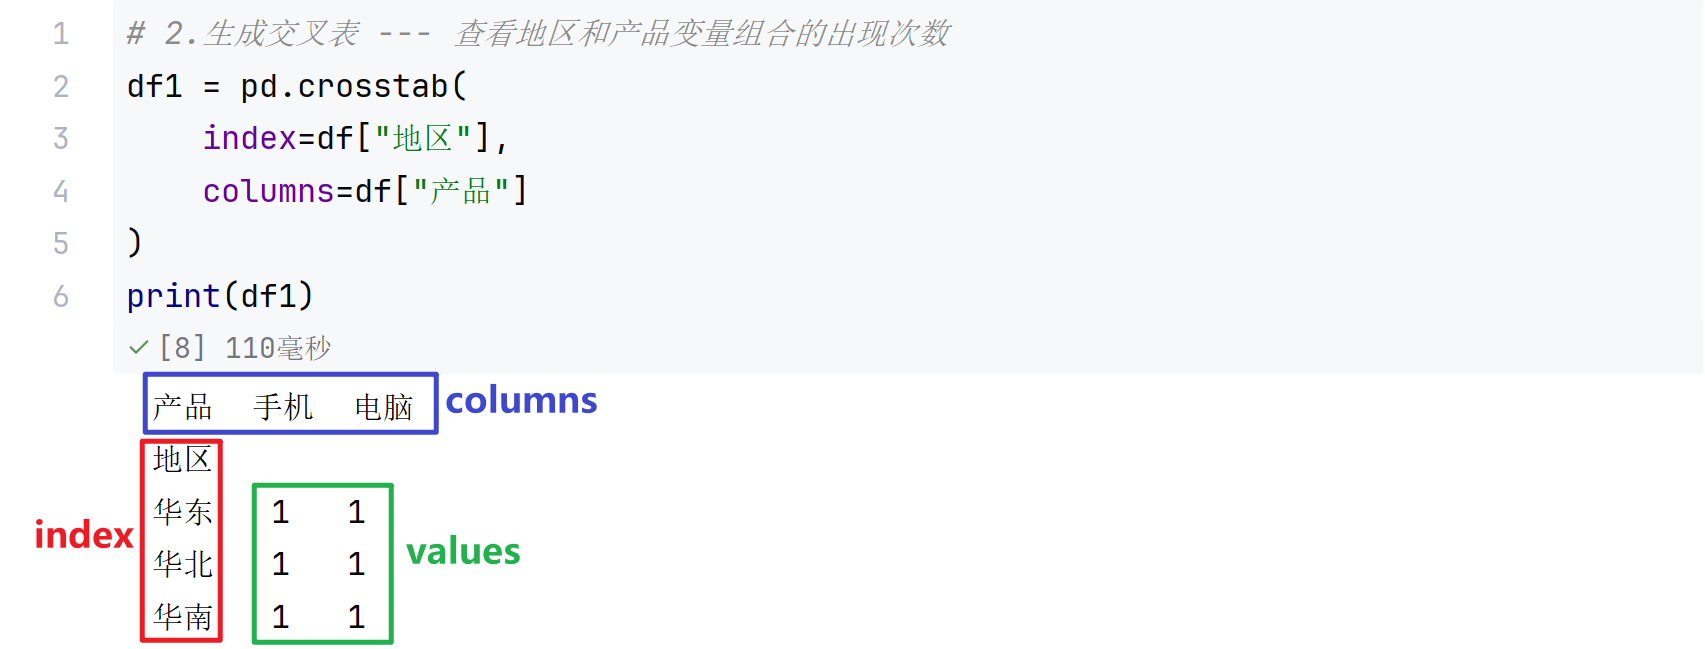
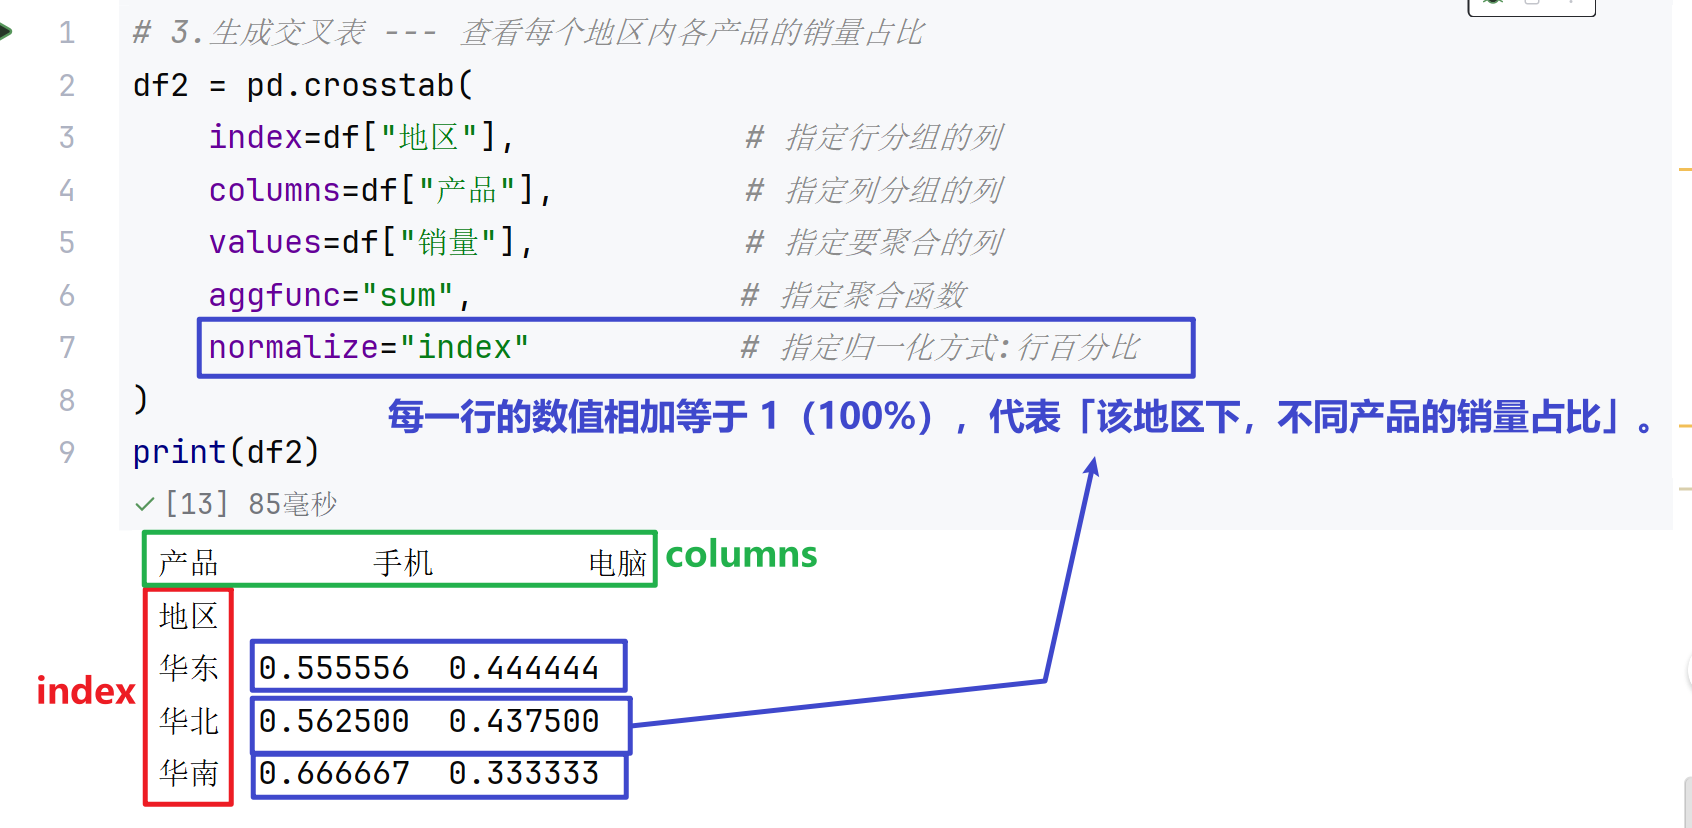
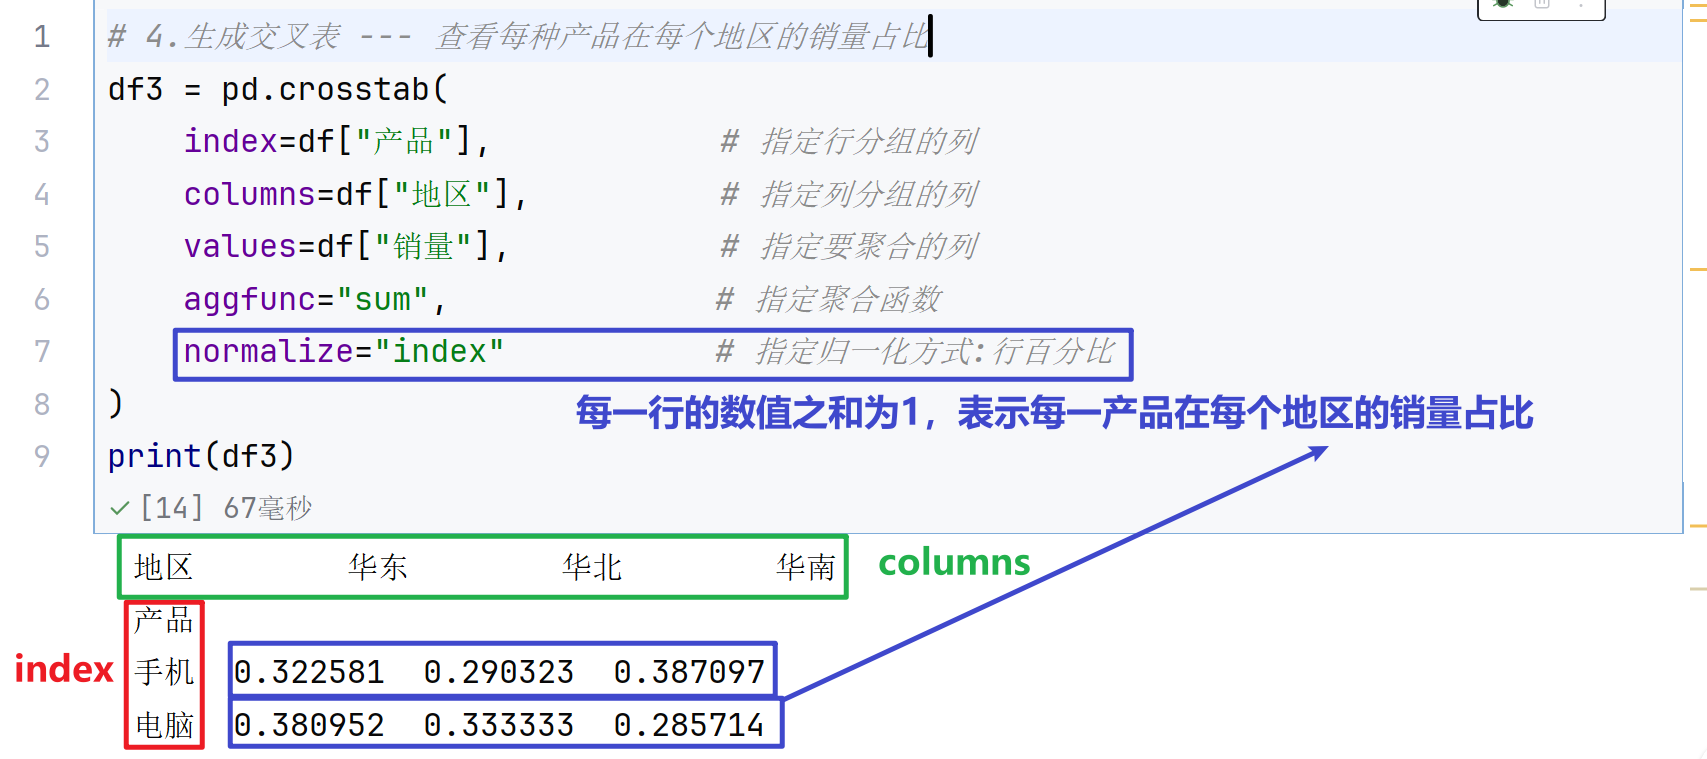
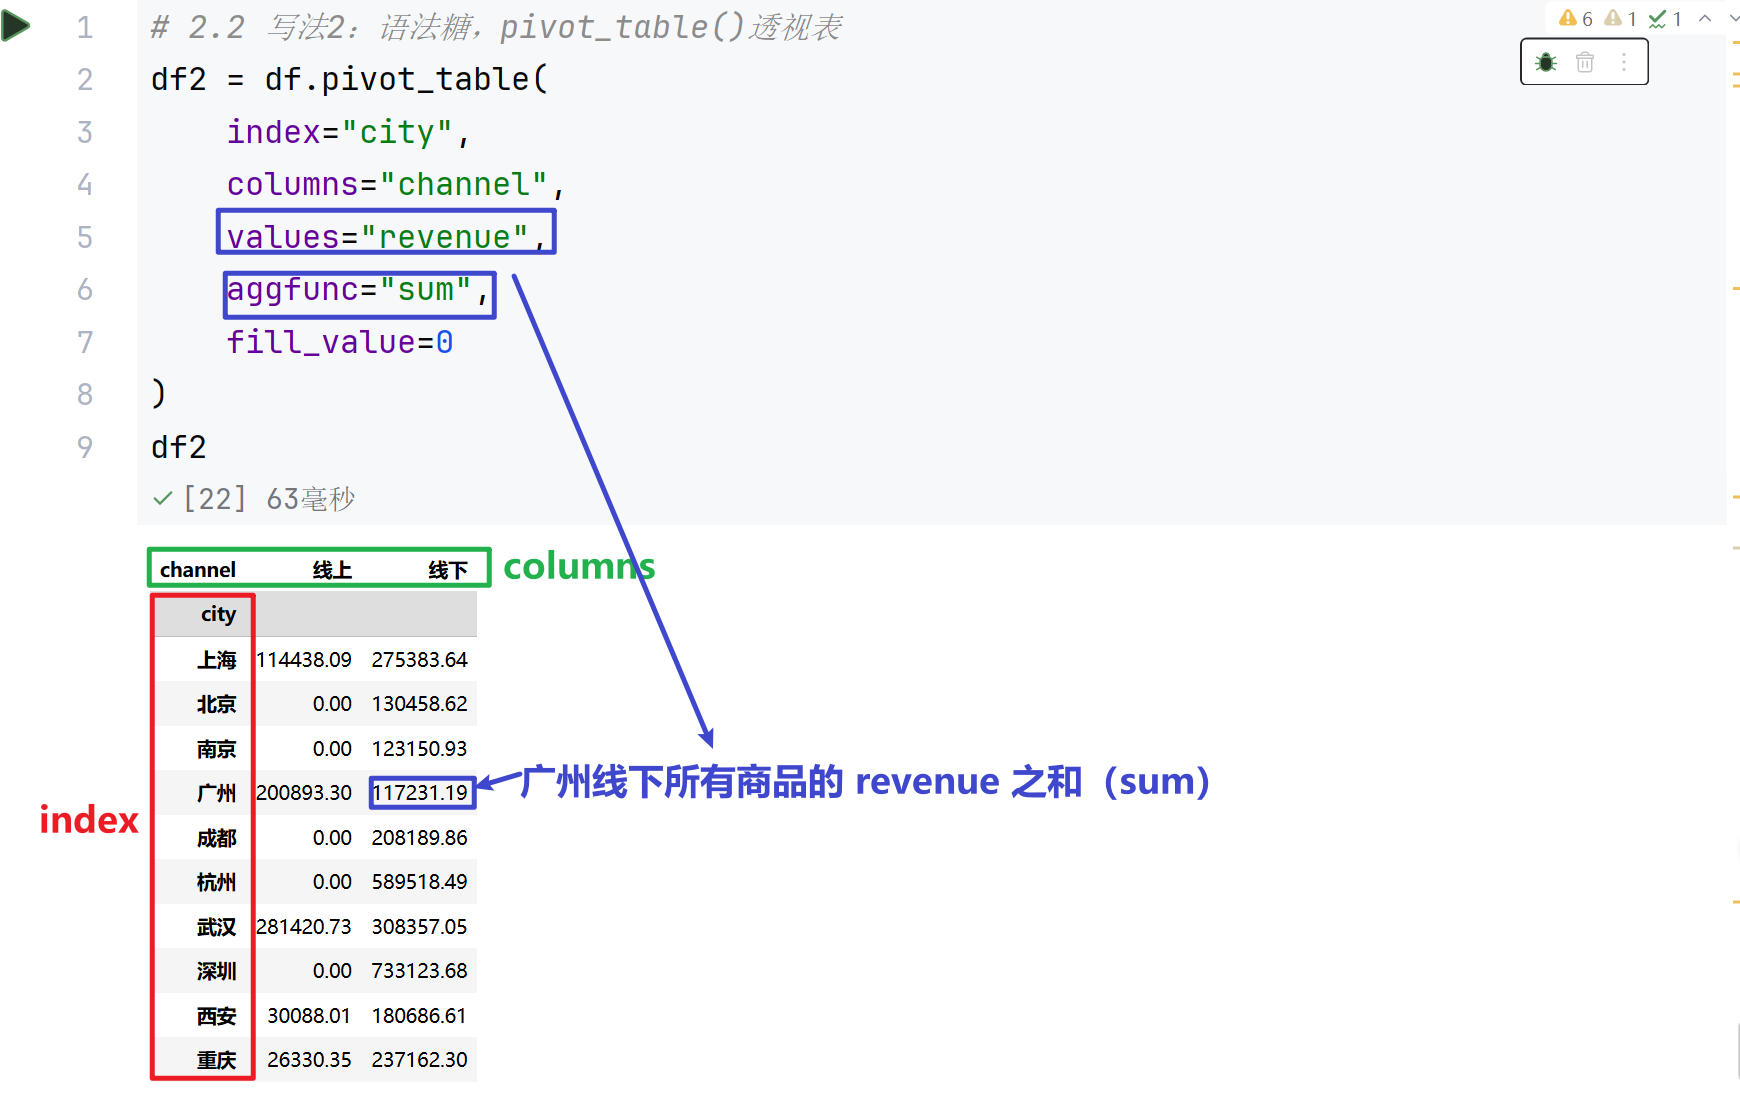
2.透视表
pivot_table :按行、列维度对数值字段进行聚合运算(求和、均值、计数等),支持多维度、多聚合函数、多层索引,是最常用的透视分析工具
语法如下:
# 方式1:顶级函数
pd.pivot_table(data, ...)

# 方式2:DataFrame 方法
df.pivot_table(...)`(更常用)
核心参数:
| 参数 | 说明 |
|---|---|
index |
行分组键(字符串 / 列表),作为透视表行索引 |
columns |
列分组键(字符串 / 列表),作为透视表列名 |
values |
待聚合的数值列(字符串 / 列表),省略则聚合所有数值列 |
aggfunc |
聚合函数,默认 'mean';支持 sum/count/min/max、字典、自定义函数 |
fill_value |
结果中缺失值的填充值 |
margins |
是否显示行 / 列总计,默认 False |
margins_name |
总计行 / 列的名称,默认 'All' |
案例如下: