AIOps实战07:AIOps的地基是数据,可观测三支柱怎么喂给AI
我是老计。前面几篇讲了 AIOps 的能力、产品和需求,都是上层的东西。这一篇往下挖,挖到最根本的地基,数据。一句话先撂在这:AIOps 再智能,本质上也是建立在运维数据之上的。数据这个地基没打好,上面盖的所有智能高楼,都是空中楼阁。 这一篇,我结合做 SRE 和可观测的经验,讲清 AIOps 的数据到底是什么、怎么喂给 AI。
一,为什么说数据是AIOps的命根子
先讲个我印象很深的事(细节已脱敏)。
有个团队信心满满地上了一套挺贵的 AIOps 平台,指望它能自动发现异常、定位根因。结果用了一段时间,效果差得让人失望:异常检测报的一半是误报,根因分析动不动就给个八竿子打不着的结论。大家一开始怪平台不行、怪算法不智能,可扒到最后发现,锅根本不在算法,在数据。 他们的监控数据缺胳膊少腿、各系统的服务名五花八门对不上、变更记录压根没接进来。算法拿到的是一堆残缺、混乱、对不上号的数据,再聪明也只能算出垃圾。
这件事把一个道理砸得很实:
AIOps 再智能,本质上也是建立在运维数据之上的。数据这个地基没打好,上面盖的所有智能高楼,都是空中楼阁。
为什么?因为 AIOps 的所有智能,无论是异常检测、根因分析还是预测,都是从运维数据里学出来、算出来的。数据就是 AI 的原料、燃料。 原料是垃圾,再好的工艺也产不出好东西,这就是那句老话,垃圾进、垃圾出。
反过来也成立:如果你的数据采集得全、质量高、组织得好,哪怕用相对朴素的算法,也能做出很有价值的分析。 所以在 AIOps 里,数据的重要性,怎么强调都不过分。做 AIOps,与其一上来纠结用什么高级算法,不如先老老实实把数据地基打好,这是我做 SRE 这些年最深的体会之一。
还有个容易被忽视的现实:在整个 AIOps 的投入里,数据相关的活往往占了大头。 采集、清洗、准备数据这些又脏又累的工作,才是真正吃时间的地方,调算法反而是少数。谁想跳过数据、直接享受智能的果实,最后往往都要回来补课。 想明白这点,你就会对数据这个地基,抱有足够的敬畏和耐心。
二,可观测三支柱,AIOps的三类核心数据
那 AIOps 吃的数据具体有哪些?做过 SRE 和可观测的人都熟,就是可观测性的三支柱,指标、日志、链路。这三样我天天打交道,用大白话讲讲它们各是什么、又各自最适合喂给 AI 干什么活。
第一支柱,指标(Metrics),是最规整的那个。 它就是按时间记录的一串数值,CPU 使用率、内存占用、请求量、响应延迟、错误率,每隔一段时间采一个点,连成一条时间序列曲线。它的性格是:
- 结构化、数值化,机器最好处理
- 量相对小,适合长期存、快速查
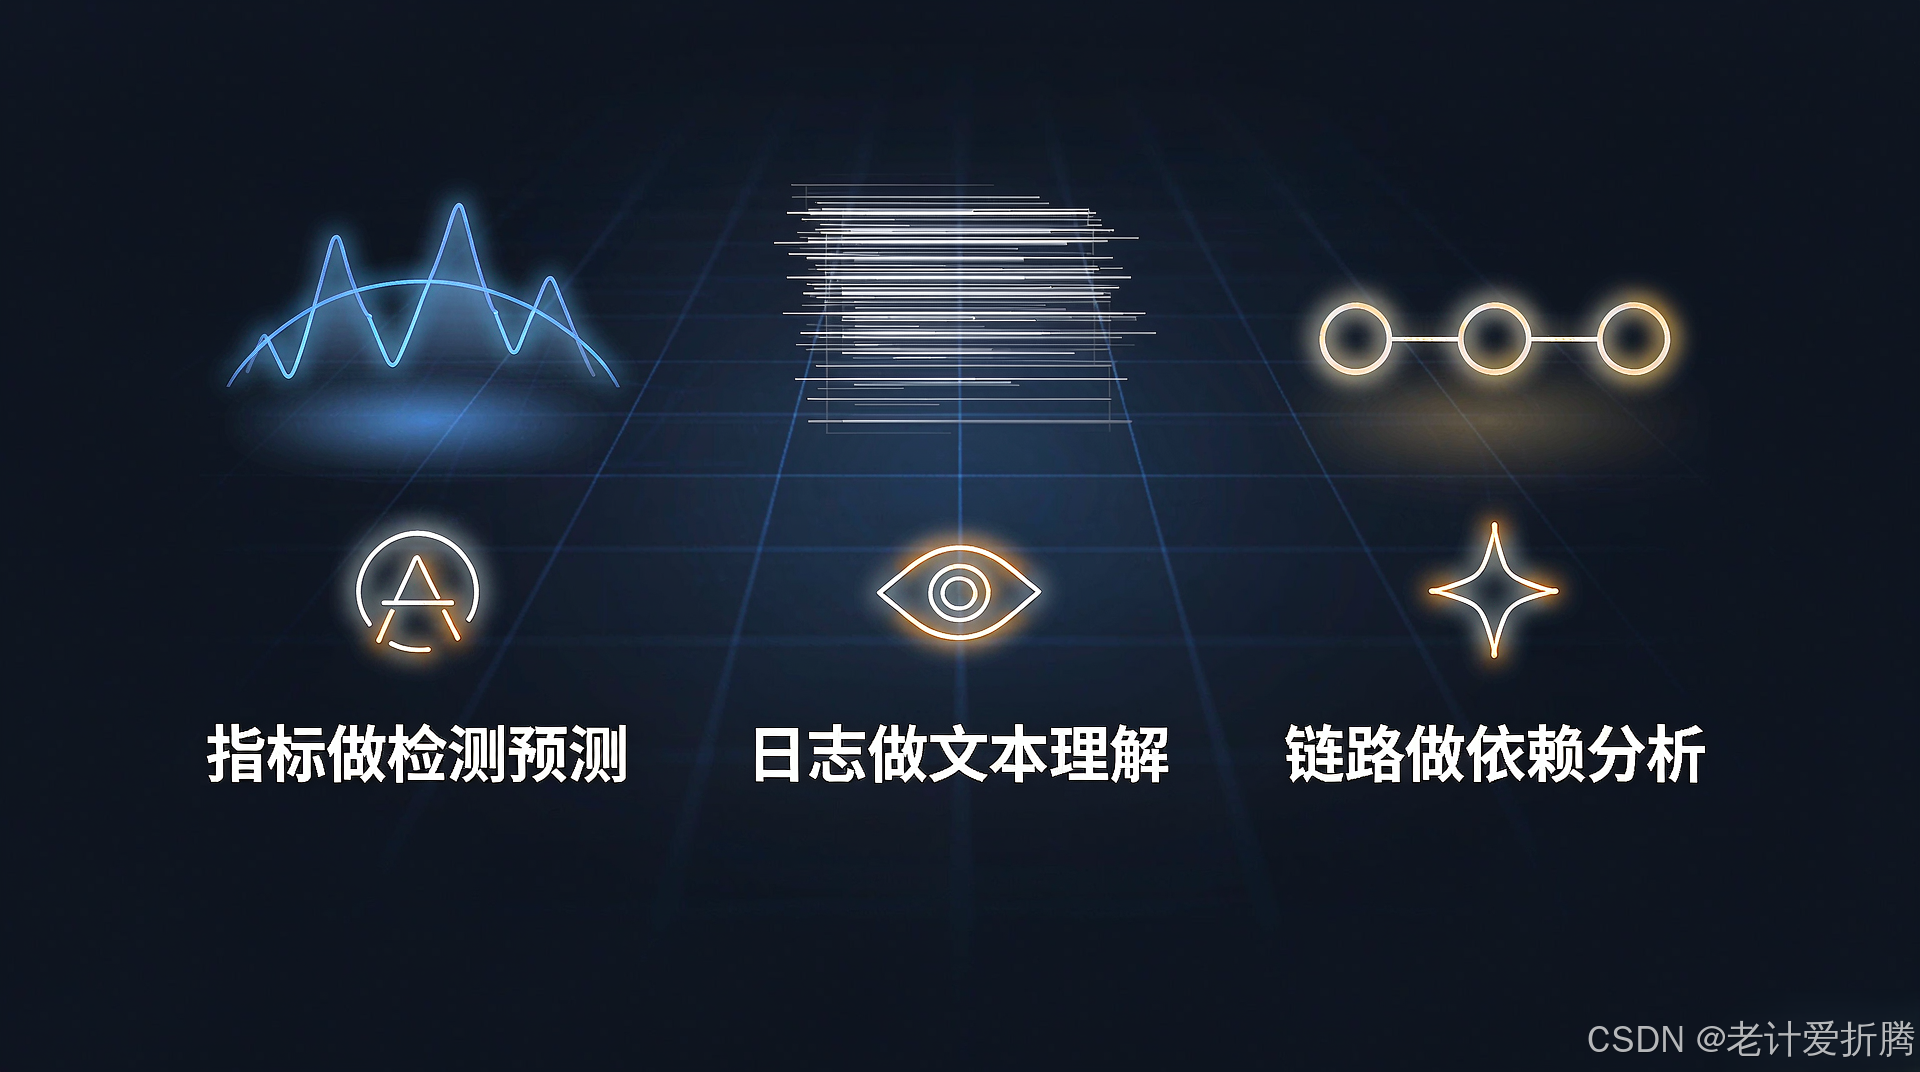
- 最适合喂给 AI 做异常检测(数值偏离基线)和趋势预测(容量预测)
一句话,指标是传统 AIOps 最主要的口粮,前面讲的那套机器学习方法,嚼的主要就是它。
第二支柱,日志(Logs),是最?嗦、也最有料的那个。 它是系统和应用运行时打出的文本记录,一条条带时间戳的事件,比如一段错误堆栈、一次请求的处理细节。它的性格是:
- 半结构化甚至非结构化的文本,机器难啃
- 信息最丰富,出问题的细节往往藏在这里
- 它是文本,恰恰撞在大模型的枪口上,用大模型读日志、理解报错、总结异常,是 LLM for Ops 的核心场景
日志过去是运维最头疼的一座数据大山,而大模型的到来,第一次让机器能真正读懂这座山。
第三支柱,链路追踪(Traces),是最懂关系的那个。 它记录一个请求在分布式系统里穿过了哪些服务、每一段花了多久,能把一次调用的完整路径还原出来。它的性格是:
- 能还原一次请求的完整路径和耗时分布
- 天生带着服务之间的依赖和调用关系,这对根因分析极其宝贵
故障定位时,靠链路你能看清是哪个环节、哪个服务先出的问题、影响是怎么一路传开的。指标告诉你哪儿不对劲、日志告诉你为什么、链路告诉你从哪传过来的,三者各管一段,缺一不可。
三,三支柱之外,别忘了这些数据
三支柱是核心,但只盯着它们还不够。做 AIOps,尤其想做好根因分析,还有三类数据同样关键,偏偏很多人会漏:
- 事件与告警数据。 各系统产生的事件、发出的告警,本身就是重要的分析对象,告警降噪、事件关联全靠它。
- 变更数据。 谁在什么时候上线了什么、改了什么配置。这类数据对根因分析价值巨大,因为大量故障就是变更引起的。
- 拓扑与配置数据。 服务之间的依赖关系、系统架构拓扑、资源配置。这是根因分析做推理的地图,没有它就没法沿依赖去追根因。
其中变更数据,我要特别多说一句,因为它是我做 SRE 反复验证过的一条铁律:
线上出了故障,第一个该问的永远是,最近改了什么。
我排障时,十有八九是先去翻变更记录,看看故障发生前后有没有上线、有没有改配置,命中率高得惊人。很多时候,根因就明晃晃地写在最近的一次变更里。 所以 AIOps 想把根因分析做好,把变更数据接进来、和故障时间对齐,几乎是必修课。可惜现实中,变更数据往往散落在各种发布系统、工单里,最容易被漏采。
这几类数据,和三支柱一起,才构成 AIOps 完整的数据版图。别只顾着采指标日志这些显眼的,把变更和拓扑这些真正决定根因分析成败的漏了。
四,三支柱各有各的采集难处
顺带提醒,这三类数据采起来、用起来,各有各的现实难处,做 AIOps 前得心里有数,别以为数据采上来就万事大吉:
- 指标的难处在选和存。 现代系统的指标维度会爆炸,一个指标叠上各种标签,能组合出海量时间序列。既要采得够用、又不能滥采撑爆存储和成本。
- 日志的难处在量和噪。 信息最丰富,但量最大、噪音也最多,绝大部分平时根本没人看。全采成本高,不采又怕漏了关键线索。
- 链路的难处在覆盖和开销。 要真有用得各服务都埋点,覆盖不全就断链;全量采集又有性能开销,通常得靠采样,得在覆盖度和开销间权衡。
指标那条我踩过实实在在的坑。有一阵我们的指标基数悄悄失控,标签组合越滚越多,直接把时序库拖垮了,查询慢得能泡杯茶,存储成本也蹭蹭涨。 后来花了不少功夫去治理标签、砍掉没人用的高基数维度,才缓过来。这件事让我明白:指标看着最简单,其实选对采什么、控制好基数,是门不小的学问,采得多不等于采得好。
了解这些难处,你在规划 AIOps 数据地基时,就会更务实地去权衡采什么、采多少、怎么采,而不是一股脑全采、最后被数据自己压垮。
五,从可观测到AIOps,数据视角的升级
最后讲一个认知升级,帮你理解 SRE 的可观测和 AIOps 在数据上的关系。
做 SRE 和可观测,我们采集三支柱数据,主要是给人看的:人盯着仪表盘、人查日志、人看链路来排障。 数据是给人的眼睛用的。
到了 AIOps,同样这些数据,服务对象从人变成了 AI。 数据不再只是给人看的仪表盘,而是要喂给算法和模型去自动分析。这个转变,对数据提出了新要求: 给人看,数据差不多、有个大概就行,人能脑补、能容错;但喂给 AI,数据就得更规范、更完整、更标准化,因为算法没有人的脑补和容错能力,它对数据质量非常敏感。
所以,从可观测到 AIOps,不只是加了些算法,更是对数据地基提出了更高的要求。 这也引出了下一篇的主题:数据质量和治理。你原来给人看的那套数据,要喂给 AI,往往还得好好收拾一遍。 理解这个从服务人到服务 AI 的数据视角升级,你就理解了为什么 AIOps 必须格外重视数据。
小结
这一篇回到 AIOps 最根本的地基,数据:AIOps的所有智能都建立在数据之上,数据是燃料,垃圾进垃圾出,数据地基没打好上层智能全是空中楼阁。核心数据就是可观测三支柱:指标(数值时序,适合喂给AI做异常检测和趋势预测)、日志(文本,适合大模型做理解和模式挖掘)、链路(调用链,含依赖关系,对根因分析宝贵)。三支柱之外别漏了事件告警、变更、拓扑配置数据,尤其变更和拓扑是做好根因分析绕不开的。认知升级:从可观测到AIOps,数据的服务对象从人变成AI,对规范、完整、标准化提出了更高要求。
下一篇,我们就接着讲,喂给 AI 的数据到底要满足什么,数据质量与治理。这块虽然琐碎,却是决定你 AIOps 能不能真正落地的关键一环,值得你花足够的耐心去打磨。
延伸阅读
- OpenTelemetry 官方文档,指标日志链路统一采集标准(opentelemetry.io/docs)
- 《Site Reliability Engineering》Google SRE 官方在线书,监控与可观测章节(sre.google/books)
- Prometheus 官方文档,时序指标(prometheus.io/docs)
- Grafana 官方文档,可观测数据可视化(grafana.com/docs)
(本文为技术经验分享,旨在梳理AIOps的数据基础与可观测三支柱。文中观点结合个人运维与SRE经验,不构成具体产品或采购建议,实际落地请结合自身环境评估。)