Runnable 在 LangChain 中的作用
Runnable :LangChain 里所有可调用组件的统一基类,Prompt、ChatModel、OutputParser、Retriever 都属于 Runnable
作用:提供统一的 .invoke() / .stream() / .batch(),以及 .ainvoke() / .astream() / .abatch() 接口;支持管道运算符 |(LCEL)链式拼接
备注:.ainvoke() / .astream() / .abatch() 接口是 .invoke() / .stream() / .batch() 接口的异步版本
模块化优势:组件解耦,可以自由组合、替换、复用;支持流式输出、同步/异步、批处理;方便单独测试每个组件,快速搭建和调试 LLM 应用
LangChain 中的 LLM 与聊天模型 ChatModel 的异同
相同点
两者都是大模型包装,都接收文本输入、返回模型生成文本,都可以接入 Chain
不同点
接口格式
LLM:底层补全模型,接口是字符串 prompt → 字符串输出,延续文本续写(completion)ChatModel:对话模型,接口是消息列表([HumanMessage, AIMessage, SystemMessage]),区分角色
用例
- LLM:自由文本续写、文本生成、简单补全任务
- ChatModel:对话聊天、多轮对话、Agent,支持系统提示、用户、助手角色,现在主流
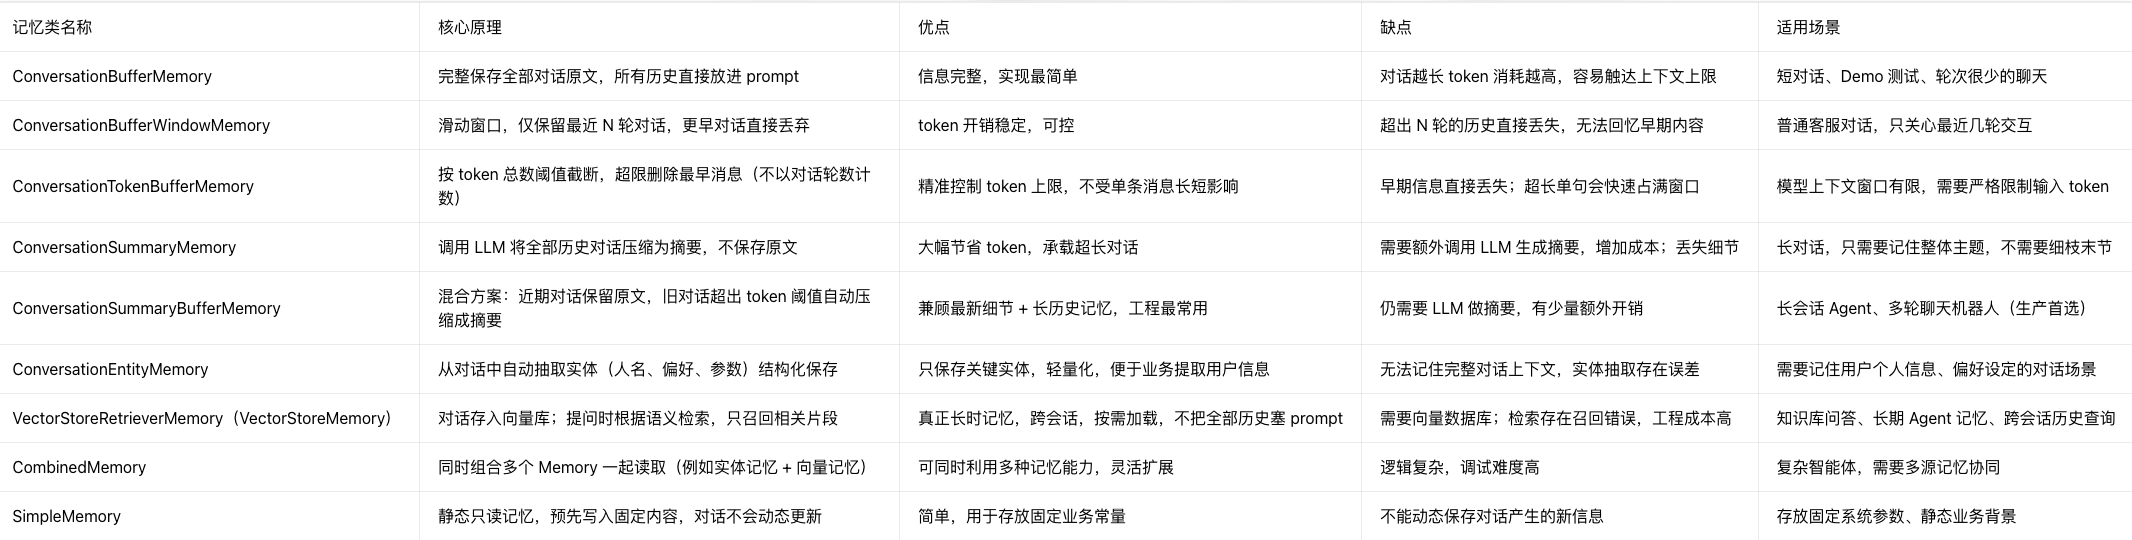
记忆组件
ConversationBufferMemory
核心原理:完整保存全部对话原文,所有历史直接放进 prompt
优点 :信息完整,实现最简单
缺点:对话越长 token 消耗越高,容易触达上下文上限
适用场景 :短对话、Demo 测试、轮次很少的聊天
ConversationBufferWindowMemory
核心原理:滑动窗口,仅保留最近 N 轮对话,更早对话直接丢弃
优点 :token 开销稳定,可控
缺点:超出 N 轮的历史直接丢失,无法回忆早期内容
适用场景 :普通客服对话,只关心最近几轮交互
ConversationTokenBufferMemory
核心原理:按 token 总数阈值截断,超限删除最早消息(不以对话轮数计数)
优点 :精准控制 token 上限,不受单条消息长短影响
缺点:早期信息直接丢失;超长单句会快速占满窗口
适用场景 :模型上下文窗口有限,需要严格限制输入 token
ConversationSummaryMemory
核心原理:调用 LLM 将全部历史对话压缩为摘要,不保存原文
优点 :大幅节省 token,承载超长对话
缺点:需要额外调用 LLM 生成摘要,增加成本;丢失细节
适用场景 :长对话,只需要记住整体主题,不需要细枝末节
ConversationSummaryBufferMemory
核心原理:混合方案,近期对话保留原文,旧对话超出 token 阈值自动压缩成摘要
优点 :兼顾最新细节 + 长历史记忆,工程最常用
缺点:仍需要 LLM 做摘要,有少量额外开销
适用场景 :长会话 Agent、多轮聊天机器人(生产首选)
ConversationEntityMemory
核心原理:从对话中自动抽取实体(人名、偏好、参数)结构化保存
优点 :只保存关键实体,轻量化,便于业务提取用户信息
缺点:无法记住完整对话上下文,实体抽取存在误差
适用场景 :需要记住用户个人信息、偏好设定的对话场景
VectorStoreRetrieverMemory(VectorStoreMemory)
核心原理:对话存入向量库;提问时根据语义检索,只召回相关片段
优点 :真正长时记忆,跨会话,按需加载,不把全部历史塞 prompt
缺点:需要向量数据库;检索存在召回错误,工程成本高
适用场景 :知识库问答、长期 Agent 记忆、跨会话历史查询
CombinedMemory
核心原理:同时组合多个 Memory 一起读取(例如实体记忆 + 向量记忆)
优点 :可同时利用多种记忆能力,灵活扩展
缺点:逻辑复杂,调试难度高
适用场景 :复杂智能体,需要多源记忆协同
SimpleMemory
核心原理:静态只读记忆,预先写入固定内容,对话不会动态更新
优点 :简单,用于存放固定业务常量
缺点:不能动态保存对话产生的新信息
适用场景 :存放固定系统参数、静态业务背景
对比
LangChain 中的 Fan-out 和 Fan-in
Fan-out:一个节点结束,分岔,同时启动多个并行分支(分发),Fan-out 扇出,1 → 多
Fan-in:所有并行分支全部跑完,汇聚合并回一条主线(收拢),Fan-in 扇入,多 → 1
LangGraph 以超级步骤为单位执行工作流,在同一个超级步骤内可并行调用多个节点,随后合并这些节点的状态信息。如果状态中某个key冲突了怎么办
LangGraph 并行(fan-out/fan-in)同一个超级步骤里多个节点,输出同一个 state key 时:
不是直接覆盖,而是使用在 Annotation 定义的 reducer 合并函数(归约)来处理冲突;没有自定义 reducer,则默认直接覆盖(后执行的结果覆盖前面的)
超级步骤 = 一次图调度迭代:并行节点全部跑完 → 统一执行状态合并 → 生成一份新全局 state,再进入下一个超级步骤
ts
import { StateGraph, Annotation } from "@langchain/langgraph";

// 状态定义
const State = Annotation.Root({
  messages: Annotation<BaseMessage[]>({
    reducer: (prev, next) => prev.concat(next), // 数组追加
  }),
  score: Annotation<number>(), // 无reducer,冲突会覆盖
});

// 前置节点:准备任务
const prep_node = async (state: typeof State.State) => {
  return { messages: [{role:"ai", content:"开始并行任务"}] };
};

// 并行worker A
const worker_a = async (state: typeof State.State) => {
  return { messages: [{role:"ai", content:"A完成"}], score: 10 };
};

// 并行worker B
const worker_b = async (state: typeof State.State) => {
  return { messages: [{role:"ai", content:"B完成"}], score: 20 };
};

// 汇总节点
const summary_node = async (state: typeof State.State) => {
  return { messages: [{role:"ai", content:`汇总,最终score=${state.score}`}] };
};

// 构建图
const builder = new StateGraph(State)
  .addNode("prep", prep_node)
  .addNode("worker_a", worker_a)
  .addNode("worker_b", worker_b)
  .addNode("summary", summary_node)
  .addEdge("__start__", "prep")
  // fan-out:prep执行完,同时走到 worker_a、worker_b
  .addEdge("prep", "worker_a")
  .addEdge("prep", "worker_b")
  // fan-in:worker_a 和 worker_b 都完成,才走到 summary
  .addEdge(["worker_a", "worker_b"], "summary")
  .addEdge("summary", "__end__");

const graph = builder.compile();
超级步骤 #1:执行 prep
- 运行 prep_node,返回状态更新
- 合并到全局 state,#1 超级步骤结束
超级步骤 #2(fan-out + fan-in)
- Fan-out:调度器同时启动
worker_a、worker_b - 两个 worker 读取同一份来自 prep 的 state 快照,并行跑;执行过程中互不修改全局 state
- worker_a 返回
{messages:[A消息], score:10} - worker_b 返回
{messages:[B消息], score:20} - Fan-in:两个节点全部跑完,一次性合并状态
messages有 reducer:prev.concat([A消息]).concat([B消息]),两条消息都保留score没有 reducer:直接覆盖,结果随机是 10 或 20(不确定性坑)
- 合并完成,超级步骤 #2 结束
超级步骤 #3:执行 summary
- 拿到上一步合并后的完整 state,运行 summary_node
- 合并结果,#3 超级步骤结束
备注:
一个超级步骤内:所有并行节点全部执行完成,才会做状态合并,中间不会更新全局 state
状态冲突只发生在 Fan-in 合并阶段
每一轮超级步骤结束后,才会进入下一轮节点
如果要支持 score 叠加,可使用如下的配置
ts
import { StateGraph, Annotation } from "@langchain/langgraph";
import { BaseMessage } from "@langchain/core/messages";

// 状态定义:score 增加求和reducer
const State = Annotation.Root({
  messages: Annotation<BaseMessage[]>({
    reducer: (prev, next) => prev.concat(next), // 消息数组追加
  }),
  score: Annotation<number>({
    // 自定义reducer:新旧值相加
    reducer: (prev: number, next: number) => prev + next,
  }),
});
LangGraph的关键特性之条件边
条件边的本质是 Python 函数
LangGraph 的状态管理
概念
LangGraph 相比于 LangChain,能开发&执行称为图(graph)的工作流
注意概念:图、工作流
一个图由节点及其之间的边组成,工作流是图上由节点组成的路径,工作流有壮态
注意概念:壮态
什么是状态?
状态通过记录用户输入与先前的计算结果,让节点能够感知到当前上下文
状态 = 整个工作流的全局 "共享笔记本",所有节点都能读这本笔记本;节点写完内容,下一个节点就能看见,这样就能感知上下文了
状态允许在任何时刻持久化工作流的执行过程
利用 checkpointer / MemorySaver 等,程序崩溃、暂停,下次拿快照,直接恢复到当时的状态继续跑
状态使工作流具备交互能力,节点可以通过更新状态来改变工作流的行为
节点可以往状态写新内容;后面路由逻辑看状态内容,决定下一步走哪条分支
例:路由判断 if 有tool_calls → 走tools节点,判断依据就是状态里的 messages
归约的三种方式
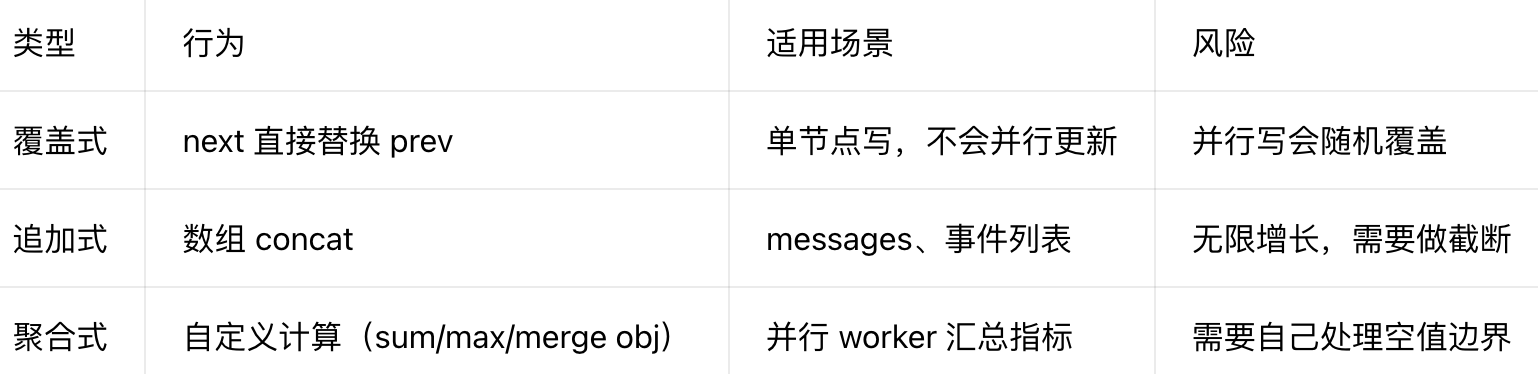
Python 用 TypedDict + Annotated,第二个参数就是 reducer 函数,签名:(prev_value, new_value) -> merged_value
TypedDict 是 Python 类型构造器,可定义具有预定义键集合的字典,且每个键都有各自的数据类型,而并不使用 Dictstr, str这种构造
LangGraph 状态的模式并不一定要定义为 TypedDict,也可以使用数据类或者 Pydantic 模型
py
from typing import TypedDict, Annotated
from langchain_core.messages import BaseMessage

# ========== 1. 覆盖式 reducer(LangGraph 默认行为) ==========
# 逻辑:永远用新值替换旧值
def cover_reducer(prev, new):
    return new

class StateCover(TypedDict):
    result: Annotated[str, cover_reducer]

# ========== 2. 追加式 reducer(messages 最常用) ==========
# 逻辑:数组追加,保留全部历史消息
def append_reducer(prev: list[BaseMessage], new: list[BaseMessage]) -> list[BaseMessage]:
    return prev + new

class StateAppend(TypedDict):
    messages: Annotated[list[BaseMessage], append_reducer]

# ==========3. 聚合式 reducer(自定义业务合并逻辑) ==========
# 3.1 数值求和
def sum_reducer(prev: int, new: int) -> int:
    return prev + new

# 3.2 取最大值
def max_reducer(prev: int, new: int) -> int:
    return max(prev, new)

# 3.3 字典浅层合并
def dict_merge_reducer(prev: dict, new: dict) -> dict:
    return {**prev, **new}

class StateAgg(TypedDict):
    score: Annotated[int, sum_reducer]
    max_score: Annotated[int, max_reducer]
    meta: Annotated[dict, dict_merge_reducer]
Python Annotated
Annotated 是 Python 3.9+ 内置(typing)的类型注解工具,本身不改变变量类型,只给类型附加额外的元数据
py
from typing import TypedDict, Annotated基础语法
Python 原生完全忽略后面的元数据;是 LangGraph 框架主动读取这个注解拿到 reducer,Python 本身不认识 reducer
Annotated[类型, 元数据1, 元数据2, ...]- 第一个参数:真实类型(
list[BaseMessage]/int) - 后面所有参数:附加的元数据,LangGraph 在这里专门放 reducer 合并函数
普通 TypedDict(无 Annotated),LangGraph 不知道怎么合并,使用默认覆盖 reducer
py
class State(TypedDict):
    score: int
加上 Annotated,传给 reducer
py
def sum_reducer(prev, new):
    return prev + new

class State(TypedDict):
score: Annotated[int, sum_reducer]- 字段
score,类型是int - 附加元数据:
sum_reducer函数 - LangGraph 读取这个注解:当多个节点更新同一个 key 时,调用这个函数做合并
备注
Annotated = 给类型 "贴标签",Python 只做类型提示;LangGraph 识别这个标签,拿到 reducer 来处理状态合并
一个Annotated可以放多个元数据(不常用)
py
Annotated[int, sum_reducer, "描述:并行打分"]LangGraph 只会取第一个可识别的 reducer 函数
如果不写Annotated,等价于:
py
score: Annotated[int, lambda prev,new: new]也就是默认覆盖式 reducer
LangGraph 使图可配置 - RunnableConfig
recursion / rɪˈkɜːʃn / 递归
configurable dict - 自定义参数透传
recursion_limit - 防止死循环
编排写的是「图的路由规则」,不是「最多跑多少轮」;图可以写循环环(回边),路径可以无限反复跑,所以必须 recursion_limit 做安全上限
① 无环 DAG(有向无环图)
所有路径是单向往前走,没有回边
比如 START → prep → [workerA,workerB] → summary → END 这种图,执行路径固定,超级步骤总数固定,跑完就结束
这种场景 recursion_limit 基本碰不到,只是兜底
② 带循环的图(ReAct Agent 最典型)
call_model → router → tools → call_model → router → tools ...循环在编排时,只定义了 router 满足条件就跳回 call_model。但是编排无法预先知道"这个循环要跑多少次"
- 用户问题简单:循环 2 轮就结束
- 用户问题很难、或者大模型出错一直触发工具调用:无限循环
编排只描述「可以走哪些边」,不规定最多循环多少次
图定义是静态的;实际执行多少超级步骤,是运行时动态决定的
编排相当于写交通规则,如果有工具调用,就掉头回到模型节点:
- 规则本身没有写最多掉头多少次
- recursion_limit 就像红绿灯的安全熔断:最多允许掉头 N 次,超过直接强制停车,防止死循环
切换不同 LLM 提供商
LangGraph 如何保证 LLM 的生成特定结构的输出 - 受控输出生成
目的:
后续步骤的输入需要结构化的数据,非 LLM 自然语言生成,因此需要保证 LLM 的输出符合特定的格式
让大模型严格按指定格式输出(JSON、固定 Schema、枚举、正则),拒绝自由文本、拒绝幻觉乱输出
模型输出文本后,代码层解析 + 重试
PydanticOutputParser:按 Pydantic 类 schema 解析 JSONRetryWithErrorOutputParser:解析失败 → 把错误丢回模型,让模型修正(缺点:模型依然可能输出非法文本,靠重试补救)
RetryWithErrorOutputParser(官方现叫 RetryOutputParser)
包装一个底层 Parser(通常是 PydanticOutputParser)。当底层解析抛异常时,拿着【原始 prompt + 大模型错误输出 + 报错信息】重新调用 LLM,让模型重新生成一次符合规范的结果
执行流程
- 先用底层 parser 尝试解析 LLM 输出
- 解析成功 → 返回结果;
- 解析失败 → 抛出
OutputParserException:- 把原始 prompt、模型上一轮错误输出、Pydantic 校验报错打包,发给 LLM
- 让模型参考错误信息,基于原始任务重新生成一次合规 JSON
- 再用底层 parser 解析新返回结果
注意:原生RetryOutputParser默认只重试 1 次,不是无限循环;要多次重试需要自己套循环 / LangGraph 回边
代码
py
from pydantic import BaseModel, Field
from langchain_core.output_parsers import PydanticOutputParser
from langchain.output_parsers import RetryOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_openai import ChatOpenAI

# 订单摘要,定义Pydantic模型:规定想要的数据结构
class OrderExtract(BaseModel):
    order_id: str = Field(description="订单编号")
    amount: float = Field(description="订单金额")
    need_refund: bool = Field(description="是否需要退款")

# 基础解析器:负责把文本转成OrderExtract对象,做类型校验
parser = PydanticOutputParser(pydantic_object=OrderExtract)

# LLM
llm = ChatOpenAI(model="gpt-4o", temperature=0)

# 构造重试解析器,包装 Pydantic 解析器
# 当 parser 解析失败时,自动调用 llm 重试修复
retry_parser = RetryOutputParser.from_llm(parser=parser, llm=llm)

prompt = PromptTemplate(
    template="提取订单信息\n{format_instructions}\n用户文本:{query}",
    input_variables=["query"],
    partial_variables={"format_instructions": parser.get_format_instructions()}
)

prompt_value = prompt.format_prompt(query="订单A123,金额200元,申请退款")
# 模拟一次错误的LLM输出(缺少amount)
bad_llm_output = '{"order_id":"A123", "need_refund":true}'

# 核心方法:parse_with_prompt,必须传入原始prompt
# 1. 先用底层 `parser` 尝试解析 `bad_llm_output`
# 2. 解析失败,捕获 `OutputParserException`,拿到 Pydantic 报错信息:`amount字段缺失`
# 3. **自动构造一条新请求发给 LLM**,内容类似:
## > 原始任务:提取订单信息。
## > 模型上一轮输出:`{"order_id":"A123", "need_refund":true}`
## > 错误:amount 字段缺失,请重新输出符合 schema 的 JSON。
# 4. LLM 重新生成正确 JSON:`{"order_id":"A123", "amount":200, "need_refund":true}`
# 5. 再次调用底层 parser 解析新文本
# 6. 校验成功,返回 Pydantic 对象 `result`
result = retry_parser.parse_with_prompt(bad_llm_output, prompt_value)
print(result)
retry_parser.parse_with_prompt 为什么要用 parse_with_prompt,不能直接用 parse()?
parse() 只接收文本,没有原始 prompt。重试时,模型不知道原来的任务是什么,没法修复
parse_with_prompt 同时传入【模型错误输出 + 原始完整 prompt】,重试时上下文齐全
默认情况下,RetryOutputParser 内部的那次 LLM 调用,对外是黑盒,上层调用方看不到它内部重试的那一轮模型请求
上层只能看到:
- 要么成功拿到对象
- 要么重试之后依旧失败,抛出异常
外部看不到中间重试的 LLM 请求、看不到重试产生的 token 消耗、看不到重试那一轮的原始文本
和 OutputFixingParser 的区别
OutputFixingParser:不拿原始 prompt,只让模型修补这段坏 JSON 字符串。适合语法引号错,缺字段经常补不上RetryOutputParser:带上原始任务 prompt 重新跑一遍任务,让模型从头生成,补缺失字段能力更强
区分两个容易混淆的 parser
OutputFixingParser:不重新调用原始 prompt,只让 LLM 修复这一段错误文本,适合语法错,但缺字段时很难补全RetryOutputParser(RetryWithErrorOutputParser):带着原始 prompt 重新跑一轮大模型,让模型从头生成新回答,适合字段缺失、逻辑缺失这种严重错误
LangGraph 的失败捕获
失败情况:基础模型 API 调用失败;LLM 生成异常的输出;外部服务不可用;工具不可用
直接利用 Python 的 异常捕获机制
LangGraph 的三种失败重试机制
核心区分维度:重试发生在哪一层、触发条件、是否占用超级步骤、可见性
- Runnable 通用重试(Runnable.with_retry ()):底层 Runnable 层面,捕获异常自动重试
- 特定节点重试(Graph 层面回边路由重试):LangGraph 图调度层面,异常捕获后路由跳回节点,超级步骤+1
- 语义输出修复(RetryOutputParser / OutputFixingParser):节点内部,解析校验失败,在节点内再调用 LLM 修复输出,不新增超级步骤
Runnable 通用重试(with_retry)
LangChain 所有 Runnable(LLM、Chain)自带.with_retry(),属于 Runnable 内部封装
当这个 Runnable 执行抛出异常(网络超时、API 限流、500),在 Runnable 内部自动重试,不退出当前节点
属于节点内部行为,不会增加超级步骤计数,Graph 调度器感知不到重试
适用触发:运行时异常(网络、API 错误),不是输出格式错误
- ✅ 网络超时、OpenAI 429 限流、500 服务报错
- ❌ 模型输出 JSON 格式不对、Pydantic 校验失败(不属于异常,是返回内容业务错误)
py
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o", temperature=0)
# 给llm加上重试:最多重试2次,捕获指定异常
llm_with_retry = llm.with_retry(
    stop_after_attempt=2,
    retry_if_exception_type=(Exception,)
)
在 LangGraph 节点内直接使用llm_with_retry.invoke()
特点
- 重试发生在当前节点内部,同一个超级步骤
- stream 看不到内部重试 chunk
- 重试耗尽直接抛异常,抛出后节点失败,交给 graph 处理
- 只处理调用异常,不处理输出内容不合规
特定节点重试(Graph 层面回边路由重试,图级重试)
节点执行抛出异常,异常透出到 LangGraph 调度器,路由函数捕获异常,路由回原始节点重新跑
每一次回跳,超级步骤 + 1,recursion_limit 计数 + 1,Graph 完全感知
适用:任何节点抛出异常(API 异常、解析异常都可以)
可以把 RetryOutputParser 抛出来的异常,直接交给图路由,实现图层面重试
py
def call_model_node(state):
    try:
        resp = llm.invoke(...)
        parsed = parser.parse_with_prompt(resp, prompt_val)
        return {"result": parsed}
    except Exception as e:
        # 把异常存入state,交给路由
        return {"error": str(e)}

def route_after_model(state):
    if state.get("error"):
        return "call_model_node" # 回边,重新跑模型节点
    else:
        return END
特点
- 每一次重试 = 新的超级步骤,会占用
recursion_limit配额 - 重试记录写入 state,可持久化、可中断恢复
stream能看到每一轮的输出,调试友好- 可以控制最大重试次数(在 state 里维护 retry 计数器)
- 适合:需要记录重试历史、人工介入、Saga 补偿场景
语义输出修复(RetryOutputParser / OutputFixingParser)
节点内部:LLM 返回文本成功(API 没有报错),但是输出内容不符合 Schema,Pydantic 校验失败
parser 内部自动再次调用 LLM,拿着报错 + 原始 prompt,让模型修正输出内容
重点:API 调用本身成功,失败是"输出语义 / 格式不满足约束",不是网络异常
重试完全封闭在 parser 内部,同一个节点,不新增超级步骤
触发条件:LLM 接口返回 200,但输出 JSON 残缺、字段缺失、类型错误
特点
- 只解决输出格式 / 结构化校验失败,不解决网络异常
- 内部隐藏 LLM 调用,graph 调度器完全看不见
- 默认仅重试 1 次;修复失败,抛出
OutputParserException,异常透出到节点
Pydantic 是什么?
Pydantic 是 Python 的数据校验 + 类型定义库
核心:用 Python 类型注解定义数据结构,自动做校验、类型转换、报错
常用于:API 请求体、LLM 结构化输出、配置解析
LangChain 的回退机制 with_fallbacks
定义
Runnable 层级定义回退机制,执行失败的话,会用相同的入参触发替代链
比如 LLM 供应商的替换
LangChain Runnable 的 with_fallbacks :给一个 Runnable 配置降级备选执行器
主 Runnable 执行抛异常 → 自动切到备选 Runnable;备选失败继续下一个 fallback
和 with_retry 不一样:
with_retry:同一个实例反复重试(网络错,再试一次这个模型)with_fallbacks:换另一个 Runnable(主模型挂了,切备用模型)
py
runnable_with_fallback = primary_runnable.with_fallbacks([fallback1, fallback2])primary_runnable:主链路(优先跑)[fallback1, fallback2]:备选列表,依次尝试,直到成功或者全部失败
触发条件:主 Runnable 抛出异常才会触发 fallback:
- LLM 超时、429 限流、服务不可用、API 报错
- 注意:业务校验失败(比如 Pydantic 解析 JSON 不合规)不属于异常,不会触发 fallback
fallback 只捕获执行层面异常;模型返回内容不对,不会自动切备用模型
示例
py
from langchain_openai import ChatOpenAI

# 主模型
gpt4o = ChatOpenAI(model="gpt-4o", temperature=0)
# 降级备选模型
gpt35 = ChatOpenAI(model="gpt-3.5-turbo", temperature=0)

# 主失败,自动切gpt35
llm_with_fallback = gpt4o.with_fallbacks([gpt35])

res = llm_with_fallback.invoke("你好")
print(res.content)
执行流程:
- 调用 gpt-4o
- 成功 → 返回结果
- 抛异常 → 自动调用备选 gpt-3.5-turbo
- 备选成功则返回;备选也失败,抛出最终异常
结合 with_retry 组合(生产常用)
py
# 先对主模型做内部重试,重试耗尽异常后,再降级到备用模型
primary = gpt4o.with_retry(stop_after_attempt=2)
llm_with_fallback = primary.with_fallbacks([gpt35])
链路:调用 gpt4o → 内部重试 2 次(with_retry)依然失败 → 触发 fallback,切 gpt35
在 LangGraph 里的行为
- fallback 切换发生在当前节点内部,属于 Runnable 内部逻辑
- 不会新增超级步骤,Graph 调度器看不到内部切换
stream看不到内部切换过程;上层只能拿到最终结果- 整个 fallback 过程如果最后依然失败,异常抛出到节点外,交给 graph 路由处理
和前面三种重试机制对比
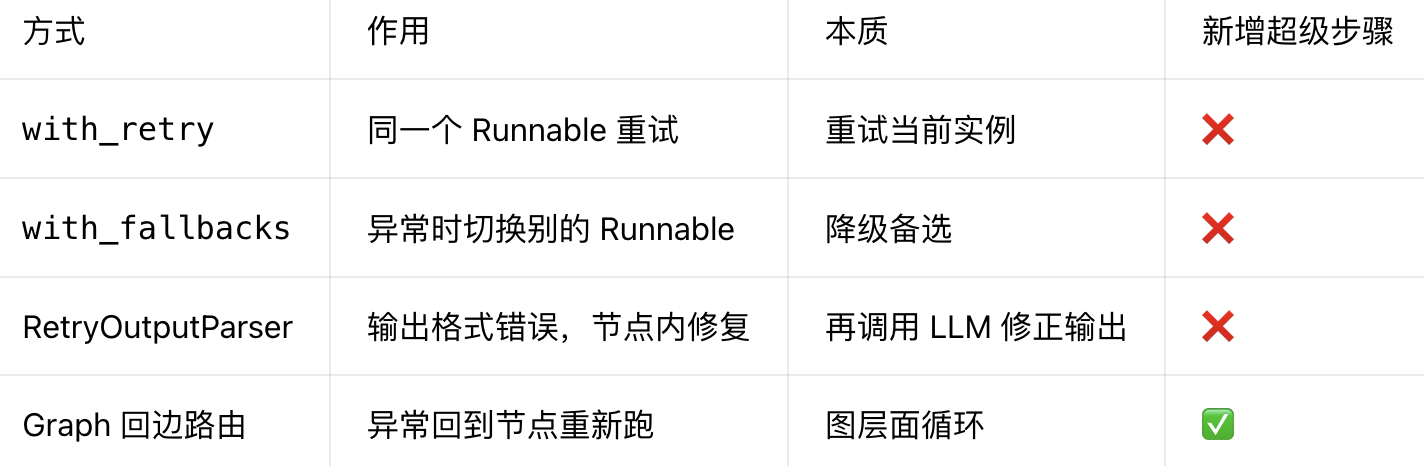
- fallback 只捕获执行异常。模型正常返回但是输出 JSON 错误,不会触发 fallback
- fallback 是顺序尝试,不是并行
- fallback 内部可以继续套
with_retry,每个备选都可以自带重试 - 异常透传:全部 fallback 都失败,抛出最后一个异常
适用场景
- 主模型服务限流 / 不可用,自动切低优先级备选模型
- 主 API 不稳定,切换备用服务商
- 多级降级策略(gpt4o → gpt3.5 → 本地开源模型)
如果注册多个fallback,中间某个执行失败时,回退产生副作用
with_fallbacks 原生的硬伤
with_fallbacks 只是 Runnable 调用层面的异常捕获 + 切换,完全没有内置回滚、补偿逻辑
场景举例:
primary(主 Runnable)执行,已经调用工具:创建工单、扣余额、发消息,业务操作已经落地,然后后面代码抛异常 → 触发 fallback 切第二个 Runnable
主 Runnable 已经做完的外部操作不会自动撤销,直接脏数据
✅ 安全场景:纯计算、纯 LLM 推理,没有外部写操作
- 只是调用 LLM 生成文本 / 结构化输出,没有 DB 写入、消息发送、扣费、创建工单
LLM 接口报错、超时,切备用模型,没有外部状态被修改,不会留下垃圾
❌ 不适合:包含有副作用的工具调用(写库、对外提交)
只要 Runnable 内部包含写外部系统逻辑,绝对不能直接用 with_fallbacks,会出现部分执行、数据不一致
怎么解决这个问题
方案 A:把副作用延后,全部成功之后再提交(发件箱模式 / 事务发件箱)
- 所有决策、LLM 生成、多 fallback 尝试全部在纯只读阶段跑完
- 全部链路成功之后,一次性执行写入外部系统的动作
只读阶段:LLM 推理、多次 fallback 切换,只在内存生成指令,不写 DB
确认拿到有效结果,才执行写操作。这样就算 fallback 来回切换,外部系统不会产生任何垃圾
方案 B:Saga 编排,给每个带副作用的步骤注册补偿逻辑
如果操作已经提交,后续失败,主动调用补偿事务撤销。这就是之前讲的编排式 Saga /ˈsɑːɡə/
缺点:复杂度高,每个业务操作都要写对应的补偿函数
方案 C:用幂等操作 + 业务状态标记
外部操作设计成幂等;同时在状态里标记「是否已经执行」
fallback 触发后,先检查状态,不再重复执行已经做完的步骤,避免重复创建工单 / 重复扣费
和 LangGraph 结合的选型
- 纯 LLM 生成(无写操作):放心用
with_fallbacks,很方便 - Runnable 里面包含工具写库、对外提交:
- 不要在 Runnable 内部直接副作用 + with_fallbacks
- 放到 LangGraph 图里,用图级重试 / Saga,可以在 state 记录执行标记,必要时触发补偿