🏭【博文导航】四阶段学习路径版(持续更新) 关于【智联工坊】那些事
📌 文章摘要
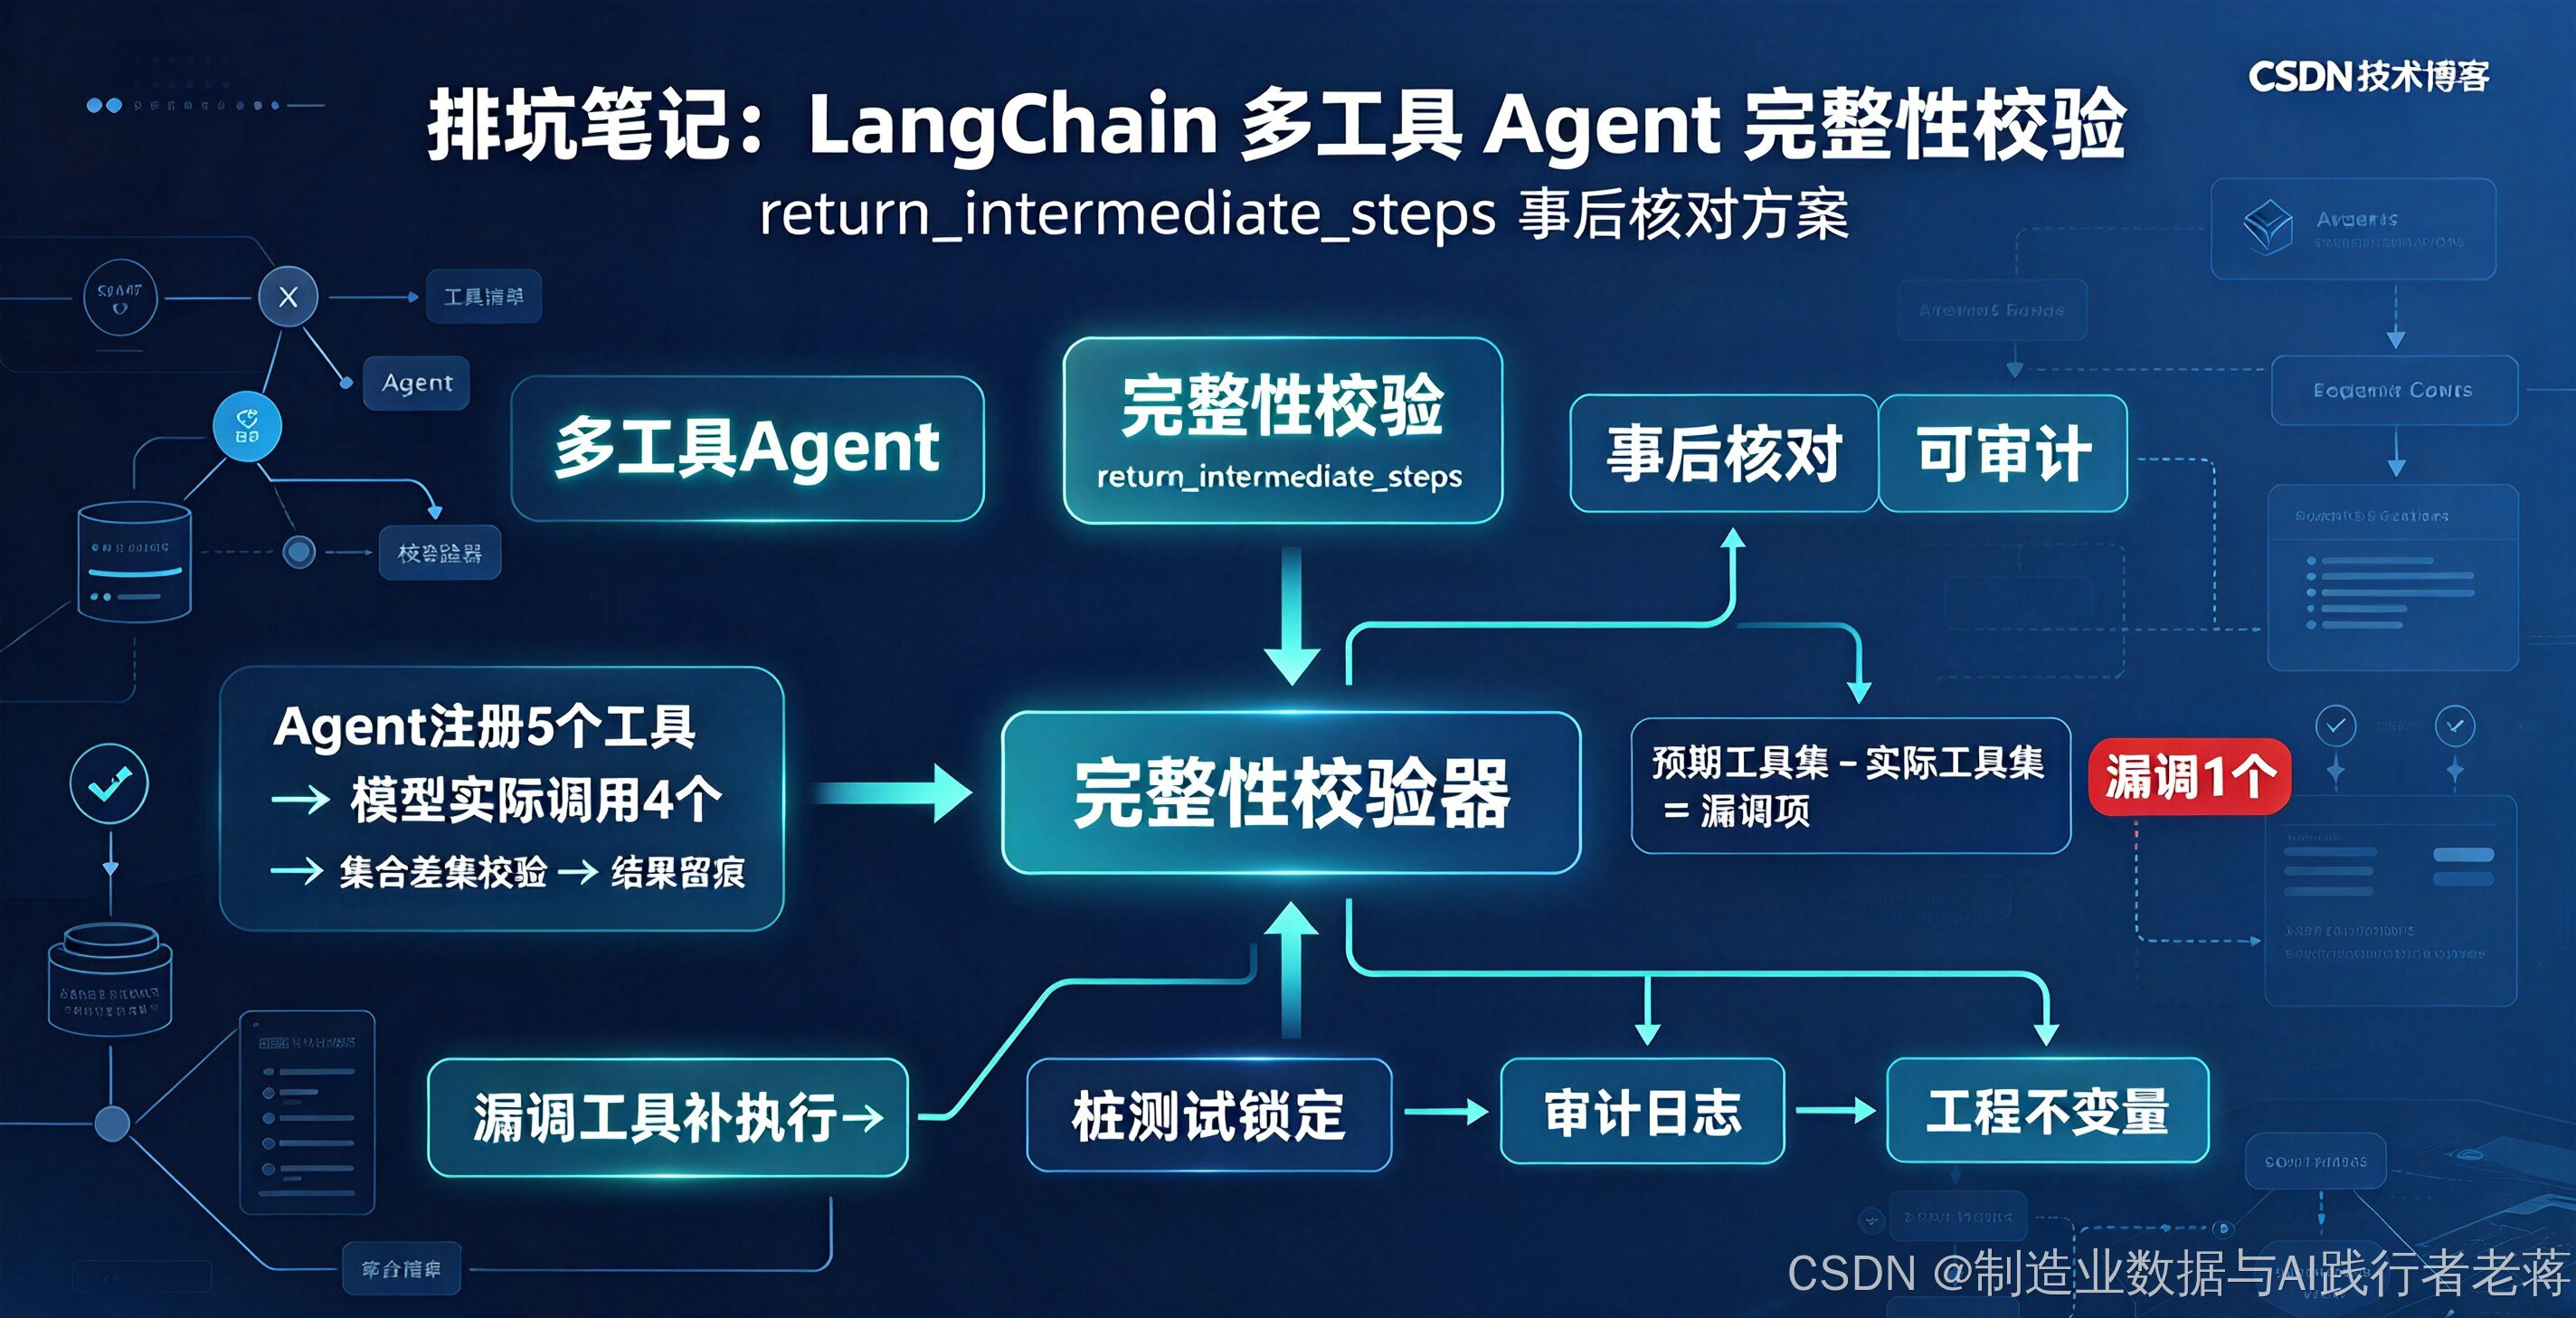
多工具数据质量巡检 Agent 注册 5 个工具,模型只调用 4 个就输出结论,报告看似完整却缺失维度?靠提示词约束始终是概率性的。本文提供工程化解决方案:通过集合差集校验做事后完整性兜底,漏调工具自动补执行并留痕,配合桩测试锁定效果,把工具调用完整性从模型自觉变成可度量、可审计的工程不变量,适用于所有生产级多工具 Agent 场景。
目录
[方案二:集合差集校验 + 漏调留痕(核心)](#方案二:集合差集校验 + 漏调留痕(核心))
[📎 系列导航](#📎 系列导航)
[💣 评论区互动](#💣 评论区互动)
与既有笔记的关系 :Agent 反复调用工具死循环?(163609470) 与 Prompt 写了 2000 字,Agent 反而躺平了?(163478743) 都在讲「用 Prompt 规则约束工具调用行为」,return_intermediate_steps 一开 Memory 就报警(163479398) 讲的是这个开关与 Memory 的配置冲突。本文的切入口不同 :不依赖模型守规矩,用同一个
return_intermediate_steps开关去做事后完整性核对,并把核对结果变成可观测指标。
一、问题现象
【智联工坊】实践之旅的案例《工业数据质量自动检测方案 3σ 原则 + Agent 编排 + 分层容错》一文中对50 万行传感器数据的对话式巡检实测。Agent 注册了 5 个工具:null_check、duplicate_check、outlier_check、delay_check、structure_check。开 verbose 盯日志,它顺次调了 4 个内容检测工具,然后直接输出 Final Answer------structure_check 全程没被调用。整轮耗时 2m07s,报告排版完整、结论完整、语气笃定,唯独缺了整个结构维度。
我的第一反应是:这不科学啊...... 系统提示词里工具清单写得清清楚楚,还专门写了「结构体检与内容检测同等重要」,模型怎么就当没看见?
📋 快速自检:你是不是也遇到了这些现象?
▢ 注册了 N 个工具,实测只调了其中一部分,报告却看不出缺项
▢ 靠人工翻 verbose 日志才发现漏调,下一次有没有漏全凭运气
▢ 提示词里写了硬约束,模型这次遵守、下次不遵守,无法复现
本文一次性解决以上所有问题。
二、影响范围
漏检的危害取决于漏掉的是什么,而不是漏了多少个:
| 漏掉的维度 | 后果 | 发现难度 |
|---|---|---|
| 结构体检(本次) | 编码/列结构/时间戳未验证,下游检测的输入本身不可信 | 高:报告格式正常,人工审阅看不出来 |
| 数值类检测 | 异常值漏报,故障苗头被抹平 | 中:与历史基线对比才可能发现 |
| 重复/延迟类 | 统计口径失真,但不致命 | 中 |
| 提示词层面 | 同类漏调在每次巡检随机复现 | 最高:漏调率无法统计 |
最麻烦的一点是延迟暴露:报告当天看不出问题,直到某天按它做了决策,才发现那个维度从来没查过。
三、排查过程
第一层:确认是「模型没调」,而不是「工具没注册」
💡 快速自检命令
开启
return_intermediate_steps=True后,执行以下代码即可快速核对工具调用完整性:
pythonfrom agent.guard import _called_tools # 执行完Agent后提取已调工具集合 called = _called_tools(result) print(f"已调工具:{sorted(called)}")先排除工程侧问题,再去怀疑模型。
bash
python -c "from agent.builder import build_executor; e = build_executor(); print([t.name for t in e.tools])"本次输出 5 个工具,注册正常。再看 verbose 日志里的调用轨迹,确认 structure_check 是从未出现在轨迹里,而不是调用了但抛异常被吞掉。
排查陷阱:拿到注册列表就下结论「模型偷懒」很容易误判。如果工具在注册时因为异常被跳过(编码错、参数缺),日志上看到的现象和模型漏调一模一样。
第二层:定位小模型为什么提前收敛
7b 级模型在 ReAct 循环里,拿到 4 项长 JSON 结果后,Observation 区已经很长,模型「感到信息充分」直接收敛。提示词升级 v1.0.1 加了「全部工具返回前禁止 Final Answer」的硬约束后复跑,确实调齐了 5 个------但这属于概率性守规矩,不是保证。
第三层:换个思路,把完整性从「事前约束」挪到「事后校验」
事前约束(提示词)作用于概率,事后校验(代码)作用于确定。既然漏调率需要长期观测、需要在回归里锁死,位置就必须在代码侧,且必须能留下数据。
四、解决方案
三道防线(方案)成本与定位分析表:
| 防线层级 | 方案 | 可靠性 | 成本 | 定位 |
|---|---|---|---|---|
| 第一道 | 提示词硬约束 | 概率性 | 低 | 覆盖大多数常规场景 |
| 第二道 | 集合差集校验 + 漏调补执行 | 确定性 | 中 | 核心兜底,生产级必备 |
| 第三道 | 桩测试回归验证 | 确定性 | 低 | CI / 交付前校验,锁死效果 |
方案一:提示词硬约束(保留,成本低)
【硬性约束】必须依次调用全部工具各一次:null_check、duplicate_check、outlier_check、delay_check、structure_check。
五个工具全部返回结果之前,禁止输出 Final Answer。它能覆盖大多数场景,但只能当第一道防线,不能当保障。
方案二:集合差集校验 + 漏调留痕(核心)
思路:执行结束后取「已调工具集合」,与「注册工具全集」求差集,差集非空即触发补执行,并把差集写进结果里长期可查。
python
# agent/guard.py(节选)
def run_with_tool_guard(executor: Any, tools: Sequence[Tool], query: str) -> Dict[str, Any]:
    """带工具完整性兜底的 Agent 执行入口(编排层第二道防线)。

    设计思路: 第一道防线是系统提示词的"全工具必调"约束(低成本、覆盖大多数场景);
              第二道防线是本函数的代码级校验(确定性强、不依赖模型自觉)。
    边界情况: 漏调工具补执行失败时返回 {error, suggestion} 结构占位,
              保证报告维度齐全可审计;合并失败降级为原文追加,主流程不中断。
    """
    raw = executor.invoke({"input": query})   # executor 须开 return_intermediate_steps=True
    result: Dict[str, Any] = dict(raw) if isinstance(raw, dict) else {"output": str(raw)}

    expected = {t.name for t in tools}        # 注册全集 = 完整性核对基准
    called = _called_tools(result)            # 从 intermediate_steps 提取已调工具
    missing = sorted(expected - called)       # 差集 = 漏调清单
    result["expected_tools"] = sorted(expected)
    result["called_tools"] = sorted(called)
    result["fallback_executed"] = missing     # 留痕:可统计漏调率

    if not missing:
        logger.info("工具完整性校验通过: 已调 %d/%d 个工具", len(called), len(expected))
        return result

    logger.warning("完整性兜底触发: 模型漏调 %s,编排层自动补执行", missing)
    name_to_tool = {t.name: t for t in tools}
    extra: Dict[str, str] = {}
    for name in missing:
        try:
            extra[name] = str(name_to_tool[name].func(""))
        except Exception as exc:  # noqa: BLE001  补执行失败不中断主流程,留结构化占位
            logger.error("兜底补执行 %s 失败: %s", name, exc)
            extra[name] = json.dumps(_TOOL_ERROR_FALLBACK, ensure_ascii=False)
    result["fallback_outputs"] = extra

    draft = str(result.get("output", ""))
    if AGENT_FALLBACK_MERGE:
        try:
            result["output"] = _merge_with_llm(query, draft, extra)
            return result
        except Exception as exc:  # noqa: BLE001  模型不可用时降级为原文追加
            logger.error("兜底合并失败,降级为原文追加: %s", exc)
    result["output"] = draft + _append_raw(extra)
    return result
四个设计点:差集核对是 O(n) 的集合运算,成本可忽略;补执行失败不中断主流程 ,留 {error, suggestion} 结构占位,保证维度齐全可审计;合并走 LLM 但失败自动降级为原文追加;无论是否触发都写 fallback_executed,漏调率因此可统计------跑一周就知道是稳定复现还是偶发。
方案三:用桩测试把这条不变量锁死
python
# tests/test_guard.py(节选)
def test_guard_catches_missing_tools() -> bool:
    """漏调场景:模型只调 2 个工具,兜底必须补齐其余 3 个并留痕。"""
    builder = QualityAgentBuilder(str(DATA_FILE))
    builder.register_detection_tools()          # 注册与构建解耦,工具层可脱离模型测试
    assert builder.tools, "注册工具集为空,差集校验会恒真空转"   # 防基准为空
    executor = _StubExecutor(["null_check", "duplicate_check"])
    result = run_with_tool_guard(executor, builder.tools, "帮我检查数据质量")

    called = set(result["called_tools"])
    fallback = set(result["fallback_executed"])
    assert called == {"null_check", "duplicate_check"}, f"桩调用集合不符: {called}"
    assert fallback == {t.name for t in builder.tools} - called, f"兜底集合不符: {fallback}"
    return True
桩 Executor 只返回与真实 AgentExecutor(return_intermediate_steps=True) 相同的结构,被测代码走的是生产同一条路径;合并开关置 false,测试零模型依赖,CI 里也能跑。
五、验证结果
| 验证层 | 方式 | 结果 |
|---|---|---|
| 真实模型 | 50 万行 AGENT_VERBOSE=true python 02_test_cli.py |
2m48s,5/5 工具调齐,报告含结构体检,数字与独立检测一致 |
| 桩单测·漏调 | 只调 2 个工具 | 兜底精确补齐 3 个,输出含追加小节 |
| 桩单测·全调 | 5 个工具全调 | 零触发、原样透传,不产生额外模型开销 |
✅ 修复成功三大标志
- ✅ 日志出现「工具完整性校验通过: 已调 5/5 个工具」,或「完整性兜底触发: 模型漏调 ...」+ 补执行清单
- ✅ 结果字典留痕齐全:
expected_tools/called_tools/fallback_executed可审计、可统计- ✅ 桩单测两条路径全绿,且基准集合非空断言在位(见预防措施第三条)
六、预防措施
怕你忘了,我再啰嗦一遍:凡是「靠模型自觉」保证的流程完整性,都要在代码层补一次事后校验,并让校验结果可统计、可回归。
落到具体操作上就是三条:
- 完整性靠集合运算判定:已调集 ⊇ 注册全集,取差集即可,不做字符串匹配、不解析自然语言。
- 兜底必须留痕:补执行清单写进结果字典与日志,漏调率才是可观测指标;否则你只能靠人肉翻日志。
- 包含性断言先验基准非空 :本次写单测时踩过一个隐蔽坑------工具注册耦合在
build()内部,测试里直接取.tools拿到的是空列表 ,expected空集让差集恒为空,兜底「未触发」全绿通过。「核对已调 ⊇ 注册全集」这类校验,基准为空时恒真,形同虚设却显示通过 ,比没有校验更危险。解法是注册与构建解耦(register_detection_tools()公开方法),并对基准集先断言非空。
适用范围:
适用于所有多工具 Agent(ReAct / Function Calling),尤其工具数 ≥ 3、且各维度结果不允许缺失的巡检、审计、合规类场景。模型越小、Observation 越长,事前提示词约束越不可靠,事后校验越必要。建议如下:
・推荐场景:工具数≥3、维度不允许缺失的巡检、审计、合规类生产级 Agent;
・简易场景:单工具、对话式 Demo、容错要求低的场景,仅提示词约束即可;
・模型越小、观察上下文越长,事后校验的必要性越高。
标签 :#LangChain #AI Agent #排坑笔记 #多工具协同 #工具调用 #工程化 #质量保障 #Agent开发
📎 系列导航
- 系列传送门: 【制造业数据与AI落地实战】 【AI赋能数据开发工程手册】【数据与AI工程排坑笔记】
本文问题源自: 智联工坊实战:工业数据质量自动检测方案 3σ 原则 + Agent 编排 + 分层容错完整实践
【热榜文&精品推荐】
TOP1、我用 WorkBuddy 分析了 30 篇 CSDN 博客,发现 3 个反直觉的流量真相
TOP2、还在翻 git log 写周报?WorkBuddy 一键生成结构化周报
TOP3、老攻城狮的AI开发环境搭建全记录:从零到跑通本地大模型(一日速通版)
TOP4、LangChain Agent 反复调用工具死循环?结构化返回 + Prompt 规则
TOP5、智联工坊实战:多工具协同Agent,让AI像人类一样规划与执行复杂任务
TOP6、代码审查不想得罪人?WorkBuddy 先做第一轮审查
💣 评论区互动
兄弟们,Agent 工具漏调的排坑指南更了,不靠改提示词,用代码级集合差集校验做兜底,漏调自动补执行还留痕,可统计可审计。
整理好了可直接复用的 guard.py 模块和桩测试代码,评论区留 「Agent 兜底」 我发你。
你们做生产级 Agent 还踩过什么工程化的坑?评论区聊聊,点赞高的我接着出排坑篇。