作者:来自 Elastic Jesse Miller
我们通过连接泄漏导致一个正在运行的 RDS 实例出现故障,而该 workflow 返回了 Postgres 拒绝连接、下游 5xx 错误,以及一个无需任何人手动编写的根因分析结果。
在你的数据所在的位置构建和观测 AI agent。从 Elastic Agent Builder 开始。你也可以立即开始**免费 Cloud 试用,或者在你的 本地机器**上试用 Elastic。
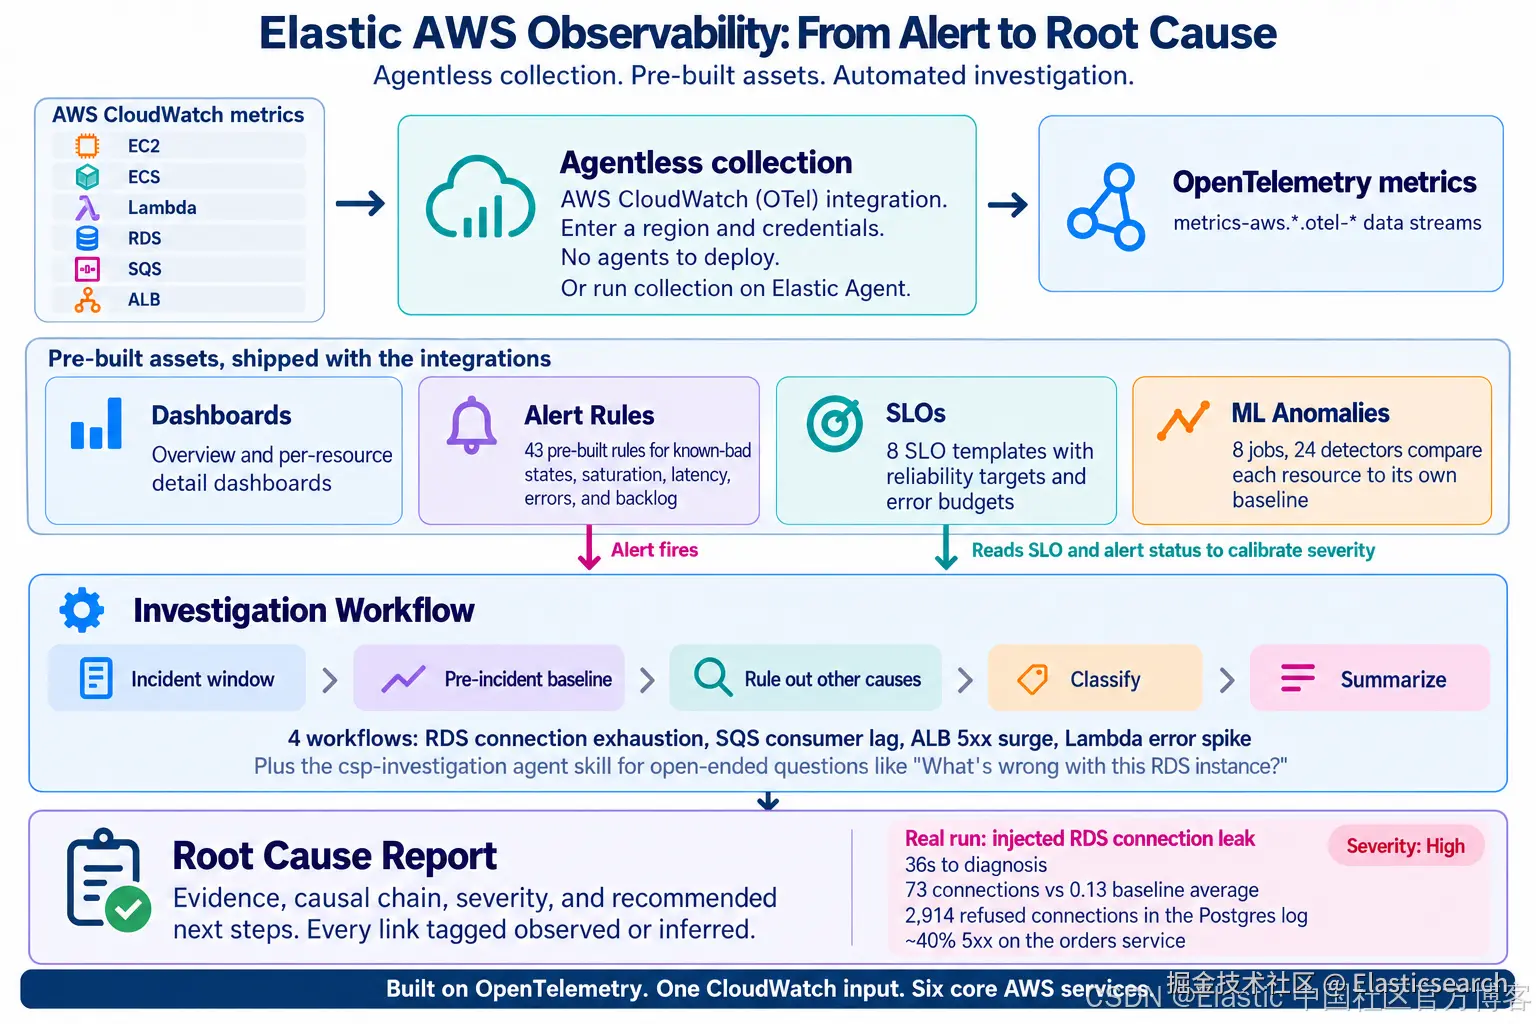
AWS 自动化根因分析会在告警触发的瞬间运行。我们向一个正在运行的 Amazon Relational Database Service(Amazon RDS)实例注入了一个连接泄漏,36 秒后,该 workflow 就已经确定了根因。连接数在 73 的上限处趋于稳定,Postgres 日志中出现了 2,914 次拒绝连接,下游 orders 服务的错误率则达到了 40%。每个数字都是根据该实例自身在故障发生前的基线进行判断,而不是使用固定阈值。
此次发布包含四个 workflow,同时还提供了一个用于开放式问题场景的 agent skill。同样的集成还提供 dashboard、43 个告警规则模板、8 个 Service Level Objective(SLO)模板,以及 8 个 机器学习 (ML)异常检测 job,覆盖 Amazon Elastic Compute Cloud(Amazon EC2)、Amazon Elastic Container Service(Amazon ECS)、AWS Lambda、Amazon RDS、Amazon Simple Queue Service(Amazon SQS)和 Application Load Balancer(ALB)。
此外,这套功能无需 agent。只需在 Amazon CloudWatch(OpenTelemetry OTel)集成中输入 region 和凭证,指标就会自动流入,无需在你的账户中部署任何东西。
统一英文技术术语的翻译方式修正链接中的转义字符保持原文的链接格式
今年早些时候,我们为 Kubernetes 发布了相同的模式。我们在一篇博客文章中介绍了 dashboard、告警和异常检测 ,并在另一篇文章中介绍了**agentic 调查层**。本次发布将这一模式应用到了 AWS。在今天的博客文章中,我们将介绍这两个部分:基础资产,以及使用这些资产的 workflow。
这里的一切都构建在采用 OTel schema 的 CloudWatch 指标之上,因此,如果你正在将 OTel 作为标准化的数据管道,这些集成可以直接接入其中。本文介绍的 AWS OTel 集成已在 Elastic Cloud Serverless(Serverless)、Elastic Cloud Hosted(ECH)和自托管部署中正式发布(GA),并且要求 Kibana 9.5.0 或更高版本。Workflow Template Library 目前处于技术预览阶段。
完整的 AWS 监控包括什么
单独一个 dashboard 只能告诉你应该去哪里查看,但前提是你已经知道出现了问题。这些集成的设计目标是覆盖完整的运维闭环:通过 dashboard 查看整体概况并深入了解细节,通过告警模板捕获已知的异常状态,通过 SLO 模板根据预算跟踪可靠性,通过 ML job 根据每个资源自身的基线发现偏差,通过调查 workflow 在告警触发时执行诊断,以及通过 agentic skill 从你选择的 harness 中驱动调查。
以下是每项服务随版本发布的内容:
| 服务 | 告警模板 | SLO 模板 | ML job(检测器) |
|---|---|---|---|
| EC2 | 8 | 1 | 1(3) |
| ECS | 4 | 0 | 1(2) |
| Lambda | 9 | 2 | 2(5) |
| RDS | 11 | 1 | 1(6) |
| SQS | 5 | 2 | 1(3) |
| ALB | 6 | 2 | 2(5) |
| 总计 | 43 | 8 | 8(24) |
本文接下来将使用随版本发布的这些资产,逐层介绍每个部分。
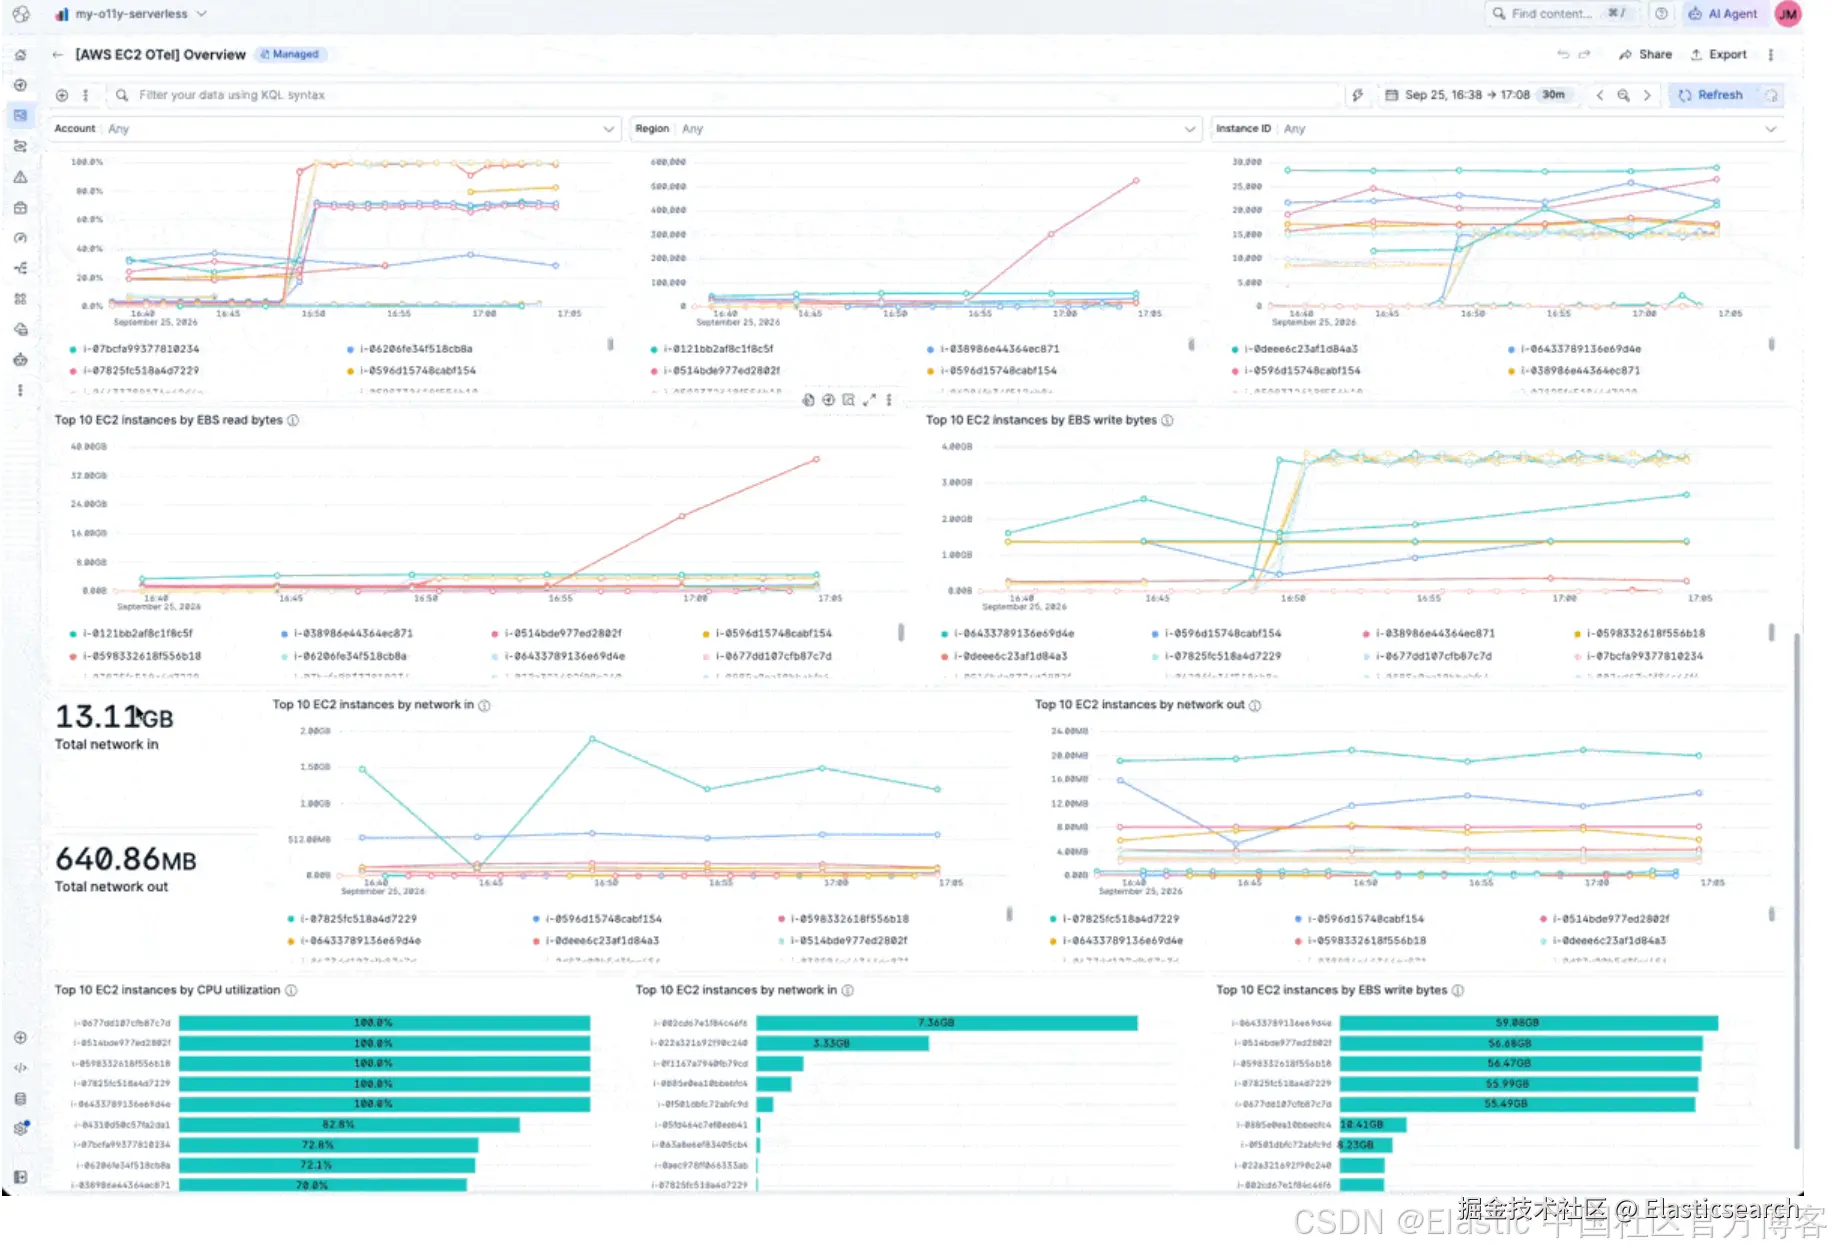
EC2、ECS、Lambda、RDS、SQS 和 ALB 的 CloudWatch dashboard
这些服务套件采用概览加深入查看的模式:EC2、ECS、Lambda 和 RDS 各自包含一个概览 dashboard 和一个资源详情 dashboard。SQS 有一个 dashboard,而 AWS Elastic Load Balancing(ELB)则包含一个概览 dashboard,以及分别用于 ALB、Network Load Balancer(NLB)和 Gateway Load Balancer(GLB)的详情 dashboard。
概览 dashboard 回答的是这样一个问题:在我运行的所有服务中,现在有什么需要关注? 它通过状态摘要,以及根据状态或你选择的指标进行着色的六边形地图来呈现信息(无需执行查询即可显示异常值),同时通过 Top-N 分解展示异常值。
详情 dashboard 回答后续问题:为什么这个看起来不健康? 不同服务的布局经过有意设计,保持一致,因此从 EC2 切换到 Lambda,再切换到 RDS 时,不需要重新学习界面。
以 EC2 详情 dashboard 为例,顶部会显示实例、账户、region 和当前状态,并提供直接链接,分别指向 Discover 中的原始指标和 AWS console 中的实例。状态时间线会显示整个时间窗口内的饱和、低存储空间和运行正常状态。
在此下方,每个核心信号都清晰可见:当前值及趋势,同时提供最小值、最大值、平均值和最后值统计,以及最后值与平均值之间的差值,覆盖 CPU 、存储、读取和写入延迟、每秒输入/输出操作次数(IOPS)以及网络吞吐量。
得益于我们最近推出的**指标列式引擎**,dashboard 可以快速且低成本地完成渲染。
统一保留或翻译英文术语将"服务套件"改为 "服务集合" 统一 dashboard 的中英文表达
43 个针对 AWS 故障模式的 CloudWatch 告警模板
这六个服务套件提供了 43 个预构建的**告警规则模板**。每个模板都基于一个 **Elasticsearch Query Language(ES|QL)**查询,你可以查看并调整该查询,然后模板会以预填充的规则表单打开,你可以直接将其连接到你的通知渠道。
它们遵循与 Kubernetes 模板相同的理念,也就是从那些从定义上来说就是错误的状态开始。EC2 实例状态检查失败始终是一个问题,消息停留在死信队列(DLQ)中也是如此;两者都意味着工作处理失败。无法将事件写入其配置的 DLQ 的 Lambda 函数,则会在不知不觉中丢失事件。拒绝连接的 ALB 已经达到连接上限,表明发生了严重的容量故障。这样的模板既不需要基线,也不需要调优,因此从第一天开始就可以有效地触发告警。
其余模板则是针对饱和度和延迟的阈值规则,阈值由你根据自己的工作负载进行设置,包括:EC2 和 RDS 持续高 CPU 使用率、ECS 的 CPU 和内存预留量及利用率、负载均衡器和目标层面的 ALB 5xx 错误率、SQS backlog 深度、Lambda 错误率和限流率,以及 RDS 延迟和最低内存。
综合来看,这些模板覆盖了 AWS 运维人员实际上会收到告警的故障模式:可用性、饱和度、延迟、错误、处理延迟、存储和成本。下面的覆盖范围图展示了在本次发布中,每项服务在哪些方面提供了即时检测或 SLO 结果:
润色重复和生硬的表达统一技术术语和中英文格式优化最后一段的衔接
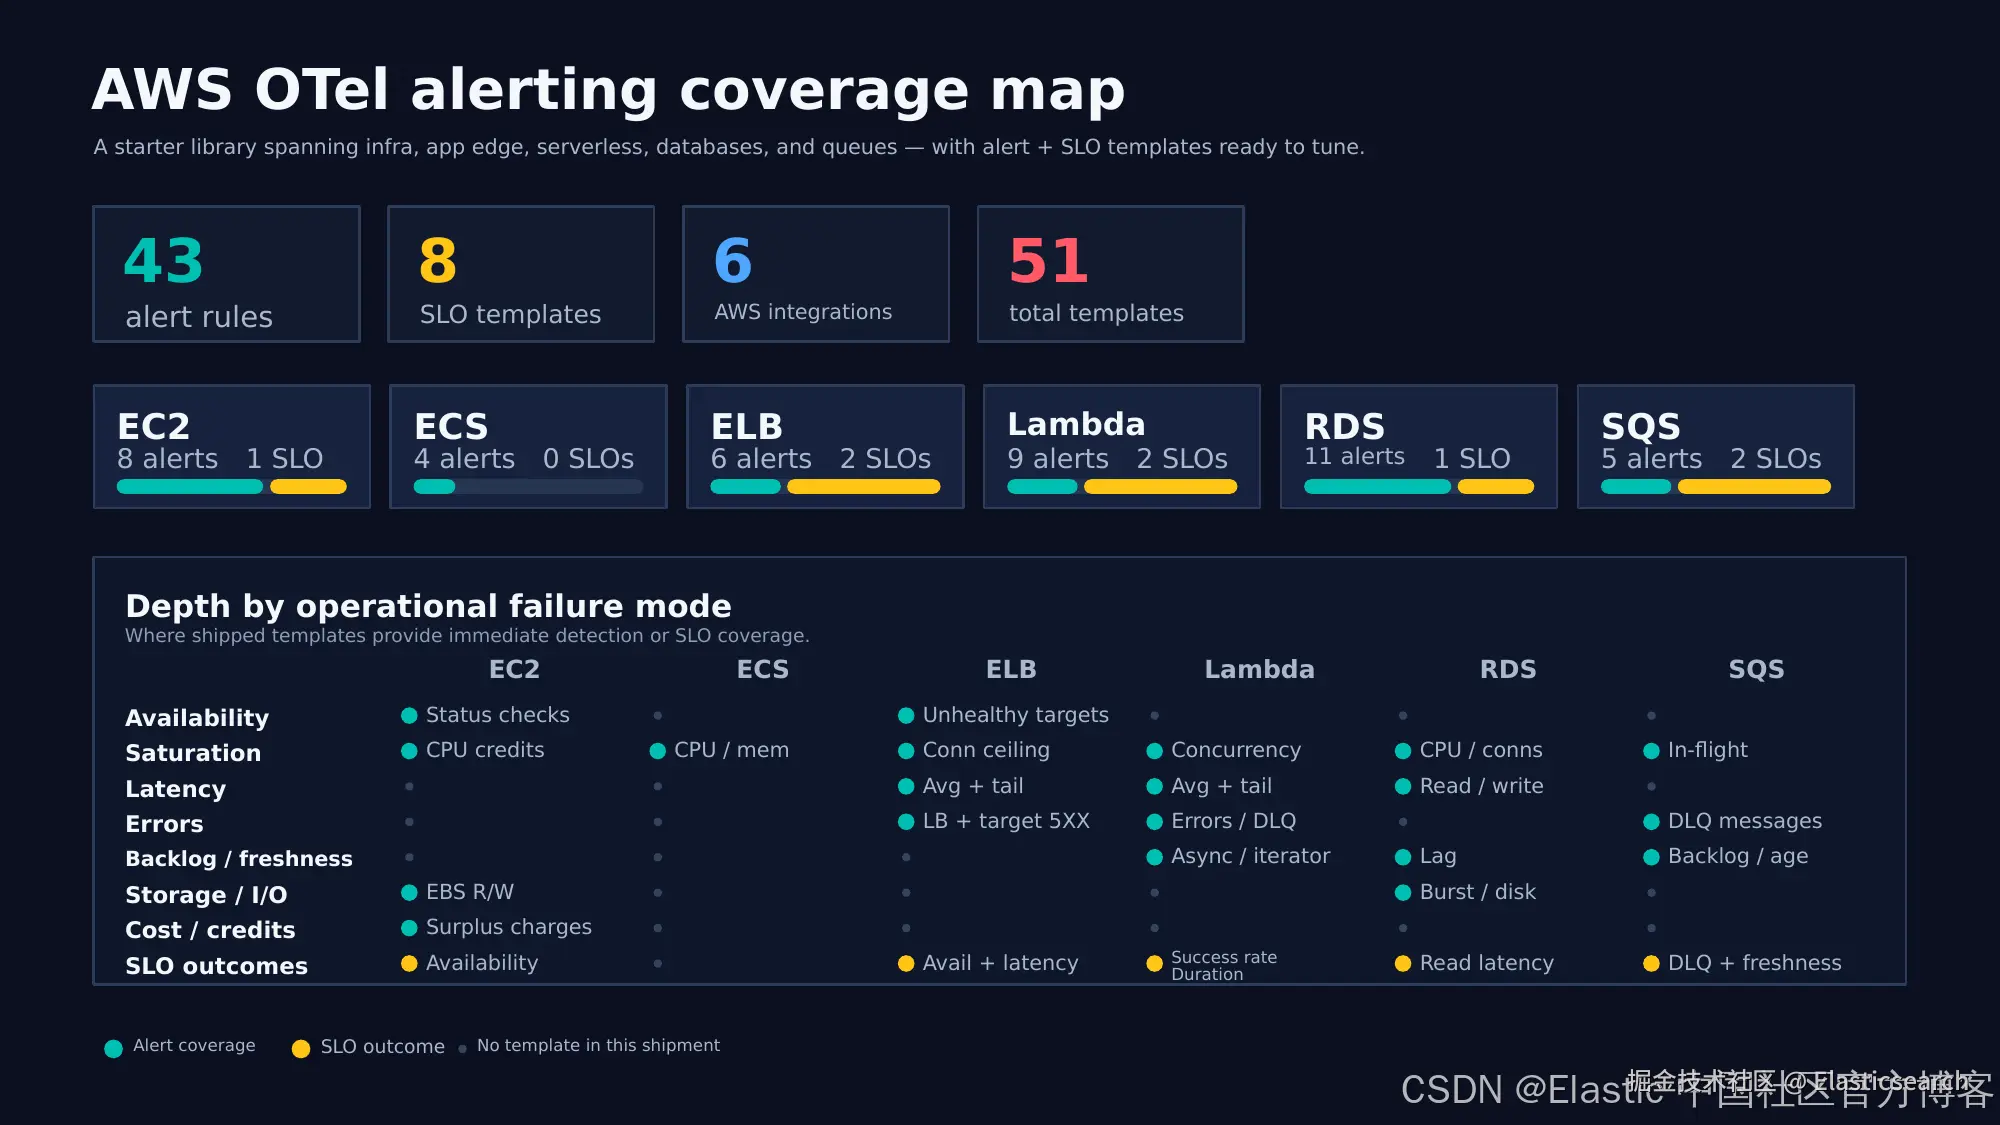 六个 AWS OTel 集成中 43 个告警规则模板和 8 个 SLO 模板的覆盖范围图,按运维故障模式进行组织。
每条规则都包含了一位经验丰富的 AWS 运维人员会写在 runbook 注释中的运维判断。
-
EC2 Amazon Elastic Block Store(EBS)吞吐量。 EBSReadBytes 衡量的是已挂载的 EBS 卷,而不是实例存储。如果你的实例使用的是本地磁盘,该规则会指引你查看本地磁盘指标。
-
RDS 连接数。 CloudWatch 不会发布
max_connections,因此阈值必须根据你的数据库引擎限制来设置,而不能使用百分比。 -
RDS burst balance。 gp2 credits 耗尽通常会先于磁盘队列深度和延迟出现峰值,而后者才是你可能最终收到告警的指标。
-
ALB 尾部延迟。 该规则会监控 Maximum 统计值,将其作为尾部延迟的代理指标,用于本集成所采集的指标。
SLO 模板:每项服务的可靠性目标和错误预算
这些套件还提供了 SLO 模板。告警可以捕获眼前发生的故障事件,而 SLO 则可以告诉你,一项服务在数周时间内是否达到了其可靠性目标,以及一次故障事件消耗了多少错误预算:
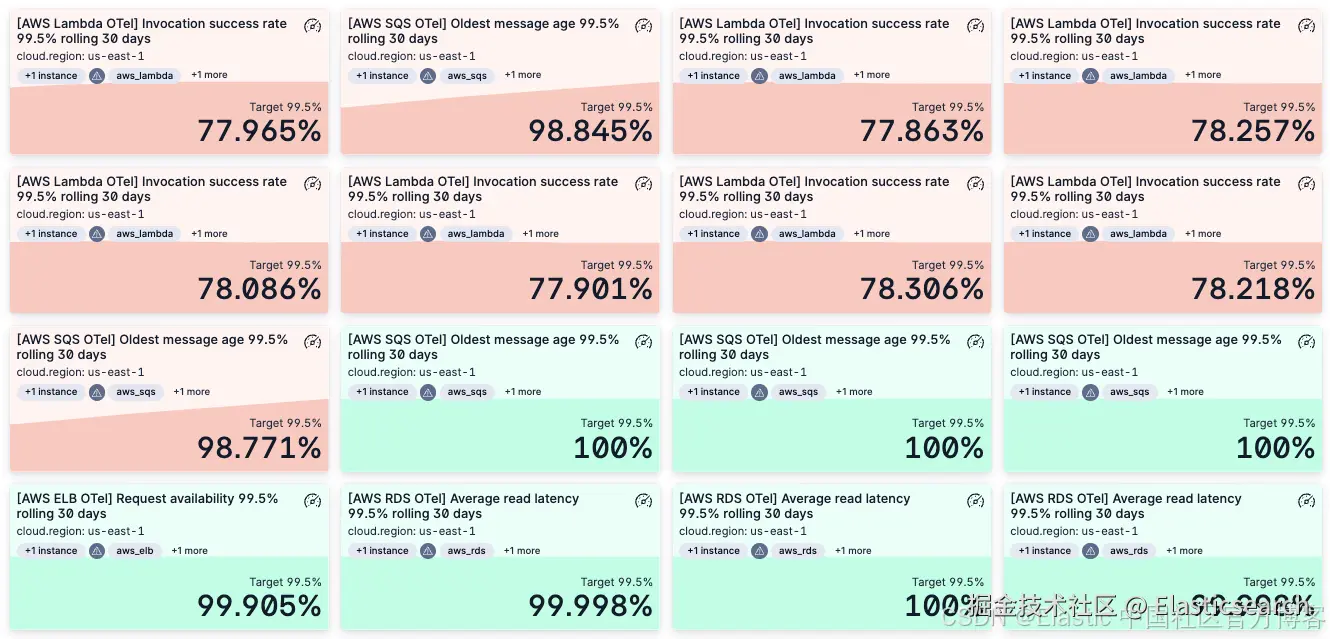 Lambda、SQS、RDS 和 ELB 服务的 SLO 活动。
每项服务都提供一到两个 SLO 模板,针对的是该服务运维人员实际需要关注的可靠性结果:
-
Lambda 和 ALB 的请求成功率和延迟。
-
RDS 的读取延迟。
-
SQS 的处理时效性(最旧消息的年龄)以及空的 DLQ。
-
EC2 的状态检查可用性。
所有 SLO 都采用 99.5% 的目标和滚动 30 天的时间窗口,并且都设计为可以进行调整,甚至会记录 DLQ 模板所匹配的队列名称模式。本次发布中,ECS 仅提供告警模板。上面的覆盖范围图展示了每项服务跟踪的是哪一种结果。
CloudWatch 指标的 ML 异常检测
告警回答的是*"出现故障了吗?",而 **异常检测**回答的是"有什么正在发生变化吗?"*大多数故障事件在达到故障标准之前,会先表现为变化,例如某个 RDS 实例的可释放内存逐日下降,或者某个队列的 backlog 在周一早上属于正常水平,但在周六晚上却不正常。
这种职责划分已经写入 job 配置本身:超过阈值的问题由告警规则负责,而 ML job 则负责检测发生在阈值以内、但可能预示问题的渐进式变化。连接数逐渐向连接池上限攀升还不能算是故障事件,而设置一个足够低的静态阈值来捕获这种增长,又会在每个繁忙的周二都触发告警。基于该实例自身历史数据训练的 模型 ,则可以在不产生噪声的情况下捕获这种变化。
将英文术语统一为中文为异常检测补充过渡句统一中英文标点和空格
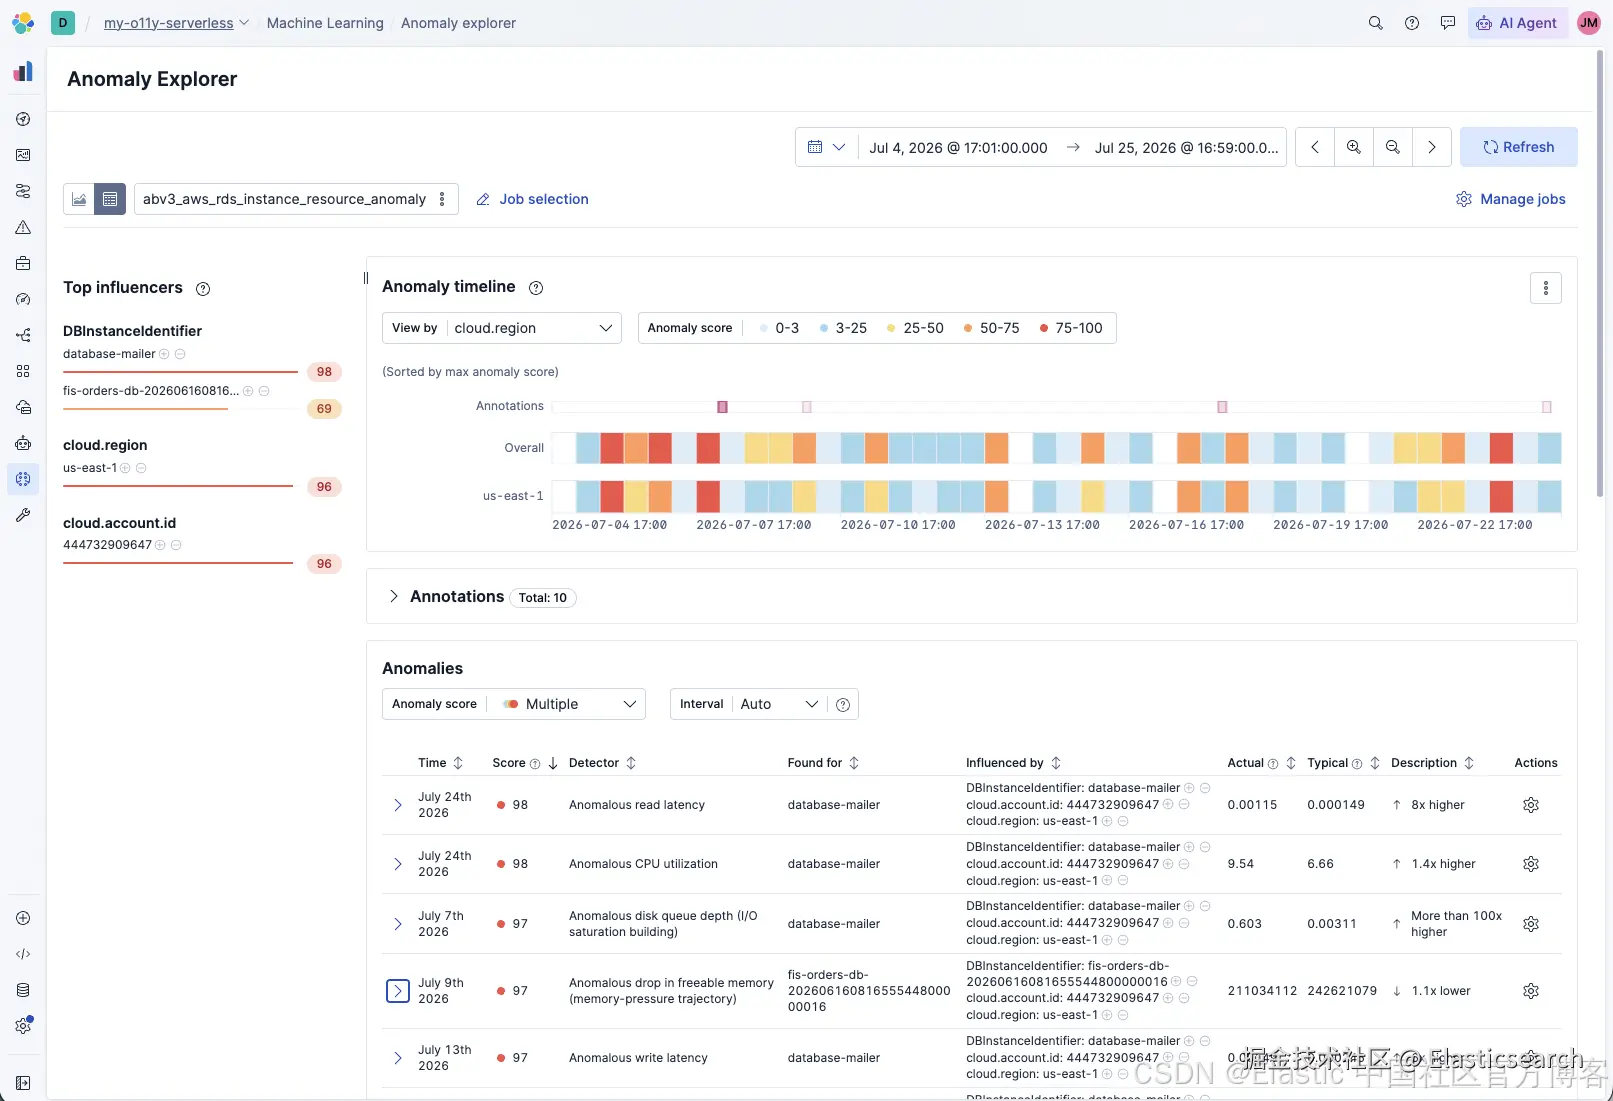 RDS 实例资源的异常检测 job,展示了针对读取/写入延迟、CPU、磁盘和内存触发的检测器。
此次发布提供了 8 个异常检测 job,包含覆盖 6 项服务的 24 个检测器:
-
RDS instance resources 是最深入的 job,包含 6 个检测器:连接数(连接池耗尽趋势)、CPU、读取和写入延迟、可释放内存以及磁盘队列深度,并且每个检测器都针对每个数据库(DB)实例分别建模。
-
EC2 instance resources 监控 CPU、逐渐耗尽的可突发 CPU credits,以及网络出站流量。
-
ECS service resources 在每个 cluster 中按 service 对 CPU 和内存进行建模,可以捕获那些即使经过 task 回收仍然持续存在的缓慢内存泄漏趋势。
-
Lambda 提供两个 job,一个用于检测错误率、限流率和死信失败率,另一个用于检测执行时长的漂移,以及逐渐逼近账户上限的并发量。
-
SQS queue backlog 监控每个 queue 的可见 backlog、进行中的消息数量以及最旧消息的年龄。
-
ALB 同样提供两个 job,一个用于检测负载均衡器和 target 的 5xx 错误率,以及被拒绝的连接数;另一个用于检测每个 target group 的 target 响应时间和不健康主机数量。
每个 job 都会将资源标识符、region 和 account 作为影响因素(influencers)显示出来。因此,在多账户部署中,异常会被归因到产生该异常的 account 和 region,而不会被报告成无法区分具体来源的整个 fleet 范围信号。
自动化根因分析:调查 workflow 如何运行
本次发布中的调查 workflow 会实际执行诊断:当关联的告警触发时自动运行,或者通过手动触发器按需运行。要自动执行,请启用 workflow,声明一个告警触发器,然后通过 Run Workflow action 将 workflow 关联到告警规则。你也可以手动按需运行 workflow。
这些 workflow 是一个 YAML 过程,由固定顺序的 ES|QL 查询和两个有边界的 AI 步骤 ai.classify 和 ai.summarize 组成。(要让这些步骤正常工作,你需要配置一个 generative AI connector。)
每次运行时,查询都会收集相同类别的证据,而两个判断步骤则由模型驱动。每个 workflow 都会查询故障事件时间窗口,查询故障发生前的基线以进行比较,运行针对特定故障模式的 correlation 查询,对结果进行分类,并根据需要读取已部署的 SLO 和告警状态来校准严重程度,最后将所有信息汇总成一份报告,其中包含根因、证据、因果链以及建议的后续步骤。
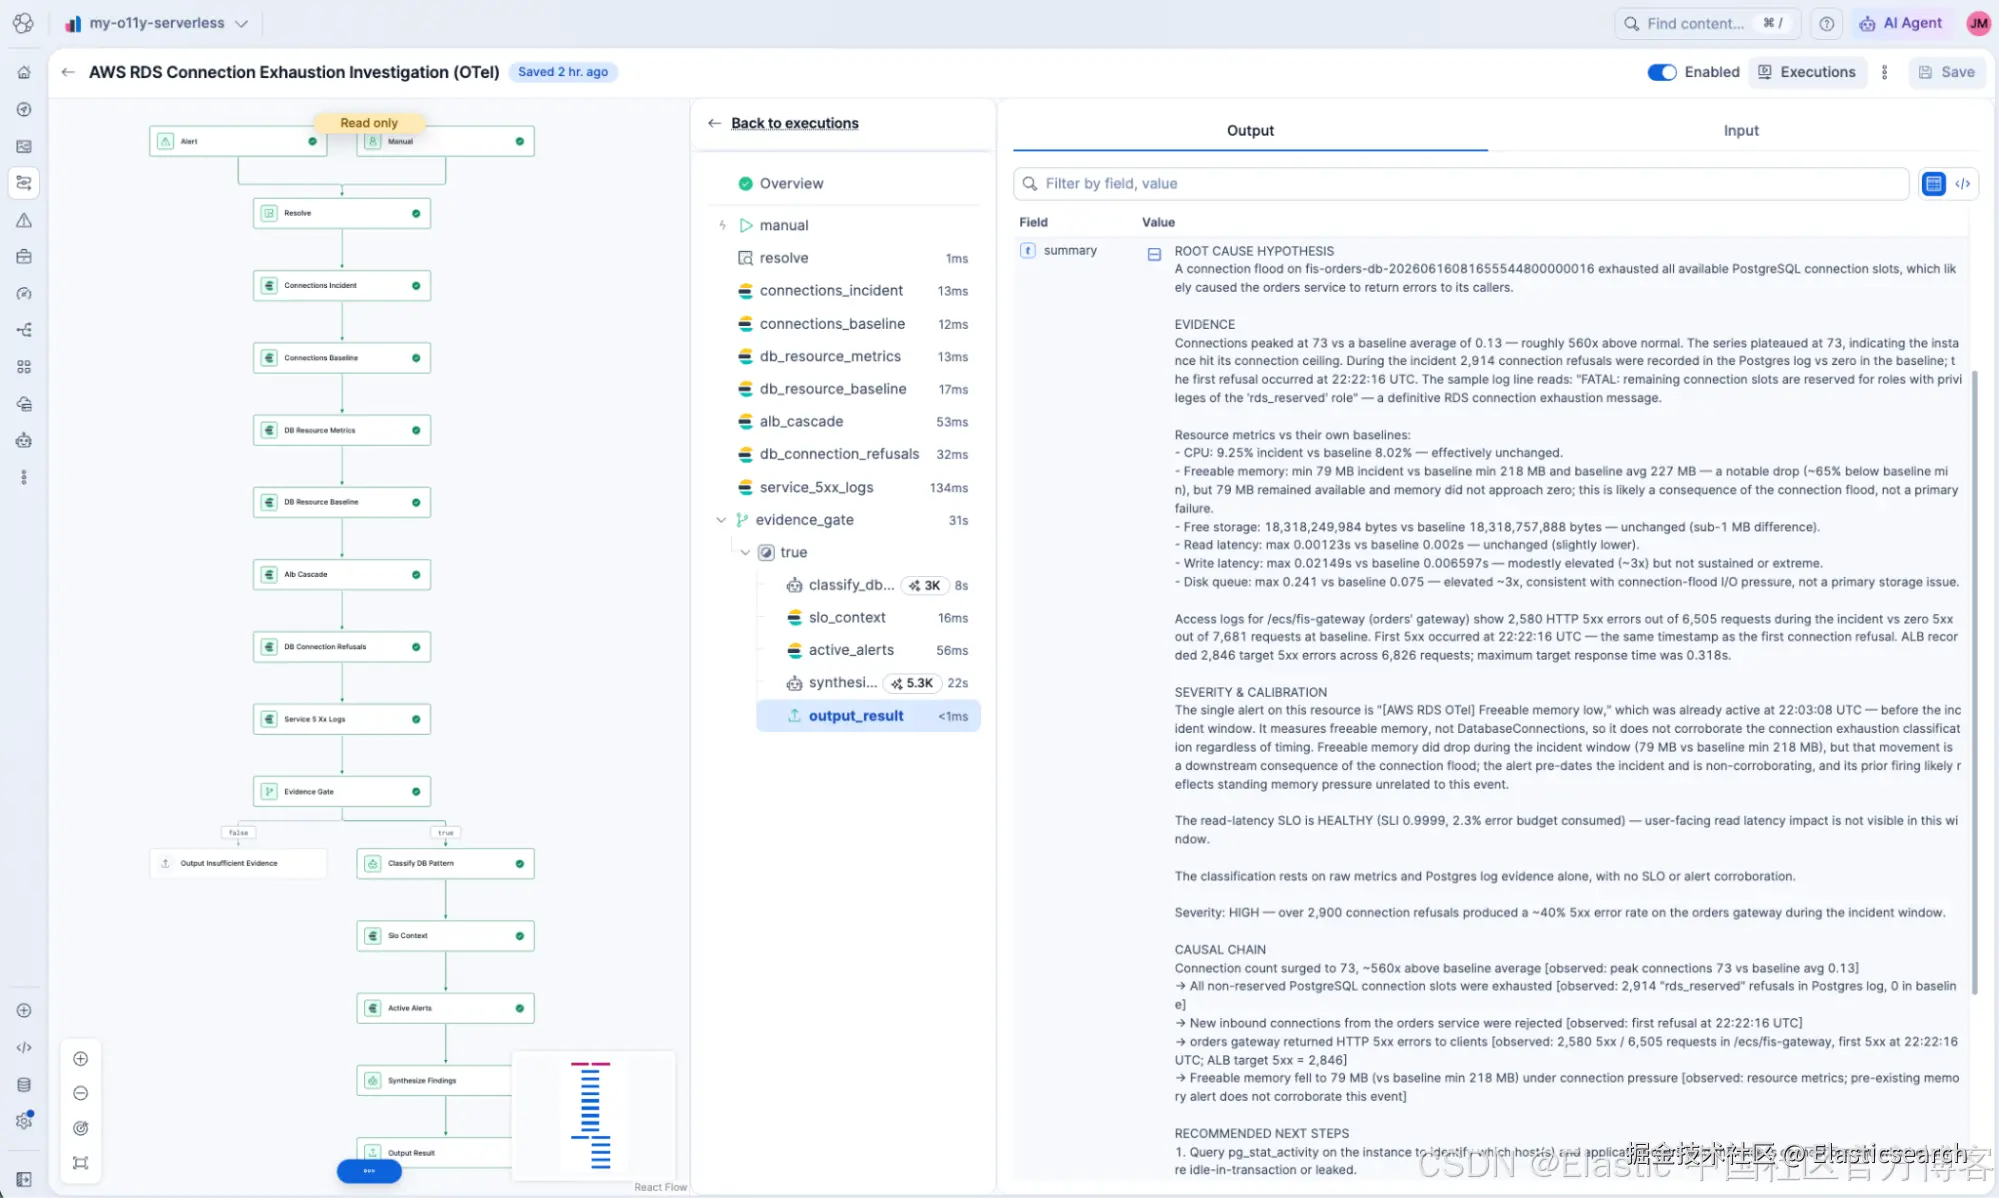 Workflow 执行流程图及结果摘要(AWS RDS 连接耗尽调查)。
本次发布包含 4 个 workflow,通过 Workflow Template Library 分发:
-
**RDS connection exhaustion。**判断拒绝连接的数据库究竟是达到了连接上限,还是遇到了其他瓶颈(CPU、内存、IO、存储),并根据每项资源在故障发生前的基线进行判断。然后,它会确认整个级联过程,而不是直接假定存在级联:RDS Postgres 日志中的拒绝连接、依赖服务 access log 中的 5xx 响应,以及前端 ALB 上的 target 5xx 数量。
-
**SQS consumer lag。**判断不断增长的 backlog 是因为 consumer 无法跟上、consumer 完全停滞,还是 producer 出现流量激增。它会综合考虑可见 backlog、最旧消息的年龄,以及发送吞吐量与删除吞吐量,并分别与 queue 的基线速率进行比较,从而避免将 producer 激增误判为 consumer 处理缓慢。
-
**ALB 5xx surge。**判断升高的 5xx 响应究竟来自后端 target 故障、负载均衡器没有健康 target 可以进行路由,还是延迟出现了恶化。
-
**Lambda error spike。**判断 function 究竟是彻底失败、因并发而受到限流,还是随着执行时长增加而逐渐恶化。
这 4 个 workflow 都已经通过在真实 AWS 环境中注入故障进行了端到端验证。
从告警到根因:RDS connection exhaustion 演练
下面是一次真实运行结果。我们在一个真实的 AWS 测试环境中注入了 connection-leak 故障。connection-leak fault 是一种 bug:应用程序打开数据库连接,却从不关闭它们,因此打开的连接不断累积,直到数据库达到连接上限并拒绝新的连接。
workflow 接收了 RDS 实例标识符、依赖服务(orders)、前端 load balancer 以及告警时间戳作为输入,并在 36 秒内完成了分析。
workflow:
-
查询整个故障事件时间窗口内的连接数,并检查耗尽的特征:连接数不断上升到一个稳定的上限并在那里趋于平稳。
-
在故障发生前的基线时间窗口内查询相同指标,以确定偏差程度。RDS 不会发布连接限制或
max_connections指标,因此必须从症状中推断连接耗尽,而 workflow 将这种推断编码其中。 -
在故障事件时间窗口内查询其他可能的解释(CPU、内存、IO、存储),以避免将其他瓶颈误诊为连接池耗尽。
-
在基线时间窗口内查询这些相同的资源指标,从而根据该实例自身的正常状态进行判断,而不是根据某个固定的"正常值"进行判断。
-
关联前端 ALB 上的 5xx 数量,以确定下游影响。
-
在两个时间窗口内搜索 RDS Postgres 日志中的拒绝连接。CloudWatch 无法显示被拒绝的连接,但 Postgres 会为每次拒绝记录一行日志,因此这一步将"连接被拒绝"从推断变成了实际观察结果。当 RDS 日志和 service 的 access log 已经发送到 Elastic 时,这两个日志检查才会运行;否则,报告会将它们标记为_不可用_。
-
在应用 access log 中统计每个 service 的 5xx 响应,并将基线与故障事件进行比较,这样报告就可以指出哪个依赖 service 开始发生故障,并证明它在故障发生前并没有出现故障。
-
使用确定性的证据门控机制,如果故障事件时间窗口内没有该实例的数据,则拒绝进行诊断。
-
对故障模式进行分类。
-
读取该实例的 SLO 和针对该实例的任何告警,并标记每个告警是在故障事件时间窗口之前还是期间开始的。只有测量已分类信号、且在时间窗口内开始的告警,才能作为佐证;其他所有告警都会被报告为既有上下文。
-
对所有内容进行汇总,并将因果链中的每个环节标记为已观察到(附有显示该环节的证据)或推断得到。
调查结果:
-
在这次运行中,故障事件时间窗口查询发现连接数峰值达到 73,并稳定在这个水平;而该实例在基线期间的平均连接数不足 1。
-
资源检查将每个其他指标与其自身在故障发生前的基线进行了比较,而不是使用绝对阈值:CPU(9.3% 对比 8.0%)、可用存储空间和读取延迟均没有变化,而可释放内存从 218 MB 降至 79 MB,写入延迟和磁盘队列深度则上升了约 3 倍,这表明这些变化是由 73 个繁忙的后端连接产生的影响,而不是由另一个竞争性原因造成的。下游级联影响也得到了端到端的观察:Postgres 日志记录了 2,914 次拒绝连接,从 22:22:16 开始;orders service 的 gateway access log 从零个 5xx 变为 6,505 个请求中的 2,580 个 5xx,并且同样从这一秒开始;ALB 则在 6,826 个请求中统计到 2,846 个 target 5xx。
-
classify 步骤将其判定为_connection exhaustion_。报告将此次激增描述为一场洪流;至于这些连接究竟是泄漏的,还是确实处于繁忙状态,这正是它推荐的第一步(检查
pg_stat_activity)要解决的问题。 -
随后的校准查询加入了运维上下文。该实例的读取延迟 SLO 仍然处于 HEALTHY 状态,并且一个 AWS RDS OTel Freeable memory low alert 在故障注入之前就已经处于活动状态。报告将其列为既有上下文,并拒绝将其作为佐证,即使内存在故障期间确实下降了,因为该告警监控的是错误的信号,而且早于此次事件就已经存在。
workflow 生成的报告就是最终答案,其中附带了相应的证据:
vbnet
`
1. ROOT CAUSE HYPOTHESIS
2. A connection flood on fis-orders-db-20260616081655544800000016 exhausted all available PostgreSQL connection slots, which likely caused the orders service to return errors to its callers.
5. EVIDENCE
6. Connections peaked at 73 vs a baseline average of 0.13 --- roughly 560x above normal. The series plateaued at 73, indicating the instance hit its connection ceiling. During the incident 2,914 connection refusals were recorded in the Postgres log vs zero in the baseline; the first refusal occurred at 22:22:16 UTC. The sample log line reads: "FATAL: remaining connection slots are reserved for roles with privileges of the 'rds_reserved' role" --- a definitive RDS connection exhaustion message.
9. Resource metrics vs their own baselines:
10. - CPU: 9.25% incident vs baseline 8.02% --- effectively unchanged.
11. - Freeable memory: min 79 MB incident vs baseline min 218 MB and baseline avg 227 MB --- a notable drop (~65% below baseline min), but 79 MB remained available and memory did not approach zero; this is likely a consequence of the connection flood, not a primary failure.
12. - Free storage: 18,318,249,984 bytes vs baseline 18,318,757,888 bytes --- unchanged (sub-1 MB difference).
13. - Read latency: max 0.00123s vs baseline 0.002s --- unchanged (slightly lower).
14. - Write latency: max 0.02149s vs baseline 0.006597s --- modestly elevated (~3x) but not sustained or extreme.
15. - Disk queue: max 0.241 vs baseline 0.075 --- elevated ~3x, consistent with connection-flood I/O pressure, not a primary storage issue.
18. Access logs for /ecs/fis-gateway (orders' gateway) show 2,580 HTTP 5xx errors out of 6,505 requests during the incident vs zero 5xx out of 7,681 requests at baseline. First 5xx occurred at 22:22:16 UTC --- the same timestamp as the first connection refusal. ALB recorded 2,846 target 5xx errors across 6,826 requests; maximum target response time was 0.318s.
21. SEVERITY & CALIBRATION
22. The single alert on this resource is "[AWS RDS OTel] Freeable memory low," which was already active at 22:03:08 UTC --- before the incident window. It measures freeable memory, not DatabaseConnections, so it does not corroborate the connection exhaustion classification regardless of timing. Freeable memory did drop during the incident window (79 MB vs baseline min 218 MB), but that movement is a downstream consequence of the connection flood; the alert pre-dates the incident and is non-corroborating, and its prior firing likely reflects standing memory pressure unrelated to this event.
25. The read-latency SLO is HEALTHY (SLI 0.9999, 2.3% error budget consumed) --- user-facing read latency impact is not visible in this window.
28. The classification rests on raw metrics and Postgres log evidence alone, with no SLO or alert corroboration.
31. Severity: HIGH --- over 2,900 connection refusals produced a ~40% 5xx error rate on the orders gateway during the incident window.
34. CAUSAL CHAIN
35. Connection count surged to 73, ~560x above baseline average [observed: peak connections 73 vs baseline avg 0.13]
36. → All non-reserved PostgreSQL connection slots were exhausted [observed: 2,914 "rds_reserved" refusals in Postgres log, 0 in baseline]
37. → New inbound connections from the orders service were rejected [observed: first refusal at 22:22:16 UTC]
38. → orders gateway returned HTTP 5xx errors to clients [observed: 2,580 5xx / 6,505 requests in /ecs/fis-gateway, first 5xx at 22:22:16 UTC; ALB target 5xx = 2,846]
39. → Freeable memory fell to 79 MB (vs baseline min 218 MB) under connection pressure [observed: resource metrics; pre-existing memory alert does not corroborate this event]
42. RECOMMENDED NEXT STEPS
43. 1. Query pg_stat_activity on the instance to identify which host(s) and application users hold the excess connections and whether any are idle-in-transaction or leaked.
44. 2. Review connection-error and pool-timeout lines in the orders service application logs to confirm it was exhausting its pool rather than a third party.
45. 3. Check distributed traces for the incident window to correlate 5xx responses with database timeout errors in the orders service.
46. 4. Drain or forcibly close leaked/idle connections (pg_terminate_backend) to restore headroom immediately.
47. 5. Restart the orders service to reset its connection pool if leaked connections cannot be reclaimed in place.
48. 6. Review max_connections on the RDS instance and the orders service pool size configuration; increase the pool ceiling with appropriate headroom and add a connection timeout/backoff to prevent unbounded growth.
49. 7. Investigate the root cause of the leak (missing pool.release() calls, long-running transactions, or misconfigured pool max) and fix in code.
50. 8. Evaluate the pre-existing freeable memory alert separately; with only 79 MB remaining under load, instance sizing or parameter tuning may be warranted.
53. DOWNSTREAM IMPACT
54. - orders service (via /ecs/fis-gateway): 2,580 HTTP 5xx errors (~40% error rate) during the incident window --- observed.
55. - End users of the orders service experienced request failures --- observed (ALB 2,846 target 5xx).
56. - Read latency SLO remained healthy; no storage or CPU impact on downstream consumers --- observed.
`AI写代码为什么使用 workflow,而不是 AI agent ?
我们通过一个定制的内部 harness 对其进行了测量:在真实 AWS 环境中注入已知根因的故障,冻结 telemetry,然后使用一系列方法对相同的数据进行调查:裸 agent、配备越来越具体指令的 agent,以及 workflow。所有方法都调查了相同的注入故障,并根据已知的 ground truth 进行评分。
在 frontier model 上,各种方法的表现相近;而在小型模型上,workflow 的得分保持在接近 0.87 的水平,而裸 agent 则降至 0.07,因为只有 workflow 中两个有边界的判断步骤依赖模型。我们将在后续文章中发布完整的方法论和量化结果,包括模型选择、评分、重复测试以及污染控制。
面向开放式调查的 AI 根因分析:csp-investigation skill
虽然使用 workflow 自动化确定性的调查路径很有帮助,但并不是每次调查都能如此规整,因此我们还为开放式场景构建了一个配套的 agent skill;也就是说,当工程师只提供资源名称和一个大致时间范围,然后询问*"这个 RDS 实例出了什么问题?"*时,就可以使用它。该 skill 为模型提供了与 workflow 所编码的相同类型的推理能力,从而支持灵活的调查。
csp-investigation skill 会指导调查所使用的大语言模型(LLM)将 cloud resource 与其自身的基线进行比较,将错误数量除以请求量得到错误率,排除在相同时间窗口内恰好触发的无关故障事件,并将"这里没有任何问题"视为一个有效答案。
我们是根据实际测量结果编写这个 skill 的。我们让真实注入的 AWS 故障事件通过没有任何指导的弱模型和强模型,并记录它们出错的地方,然后只加入那些能够提高得分的指导。在一次 Lambda 错误率故障事件中,一个弱模型在没有 skill 的情况下得分为 0.06(满分 1 分),使用 skill 后则达到 0.44。当要求它检查一个实际上运行正常、且没有触发任何告警的资源时,得分从 0.06 提升到了 0.74,这表明正是这个 skill 阻止了模型凭空捏造一个并不存在的故障。
该 skill 名为 csp-investigation,在顶层采用 router 模式,将模型引导到相应的 cloud service provider 上下文中(目前仅支持 AWS,但很快还会加入 Google Cloud Platform(GCP)和 Azure)。
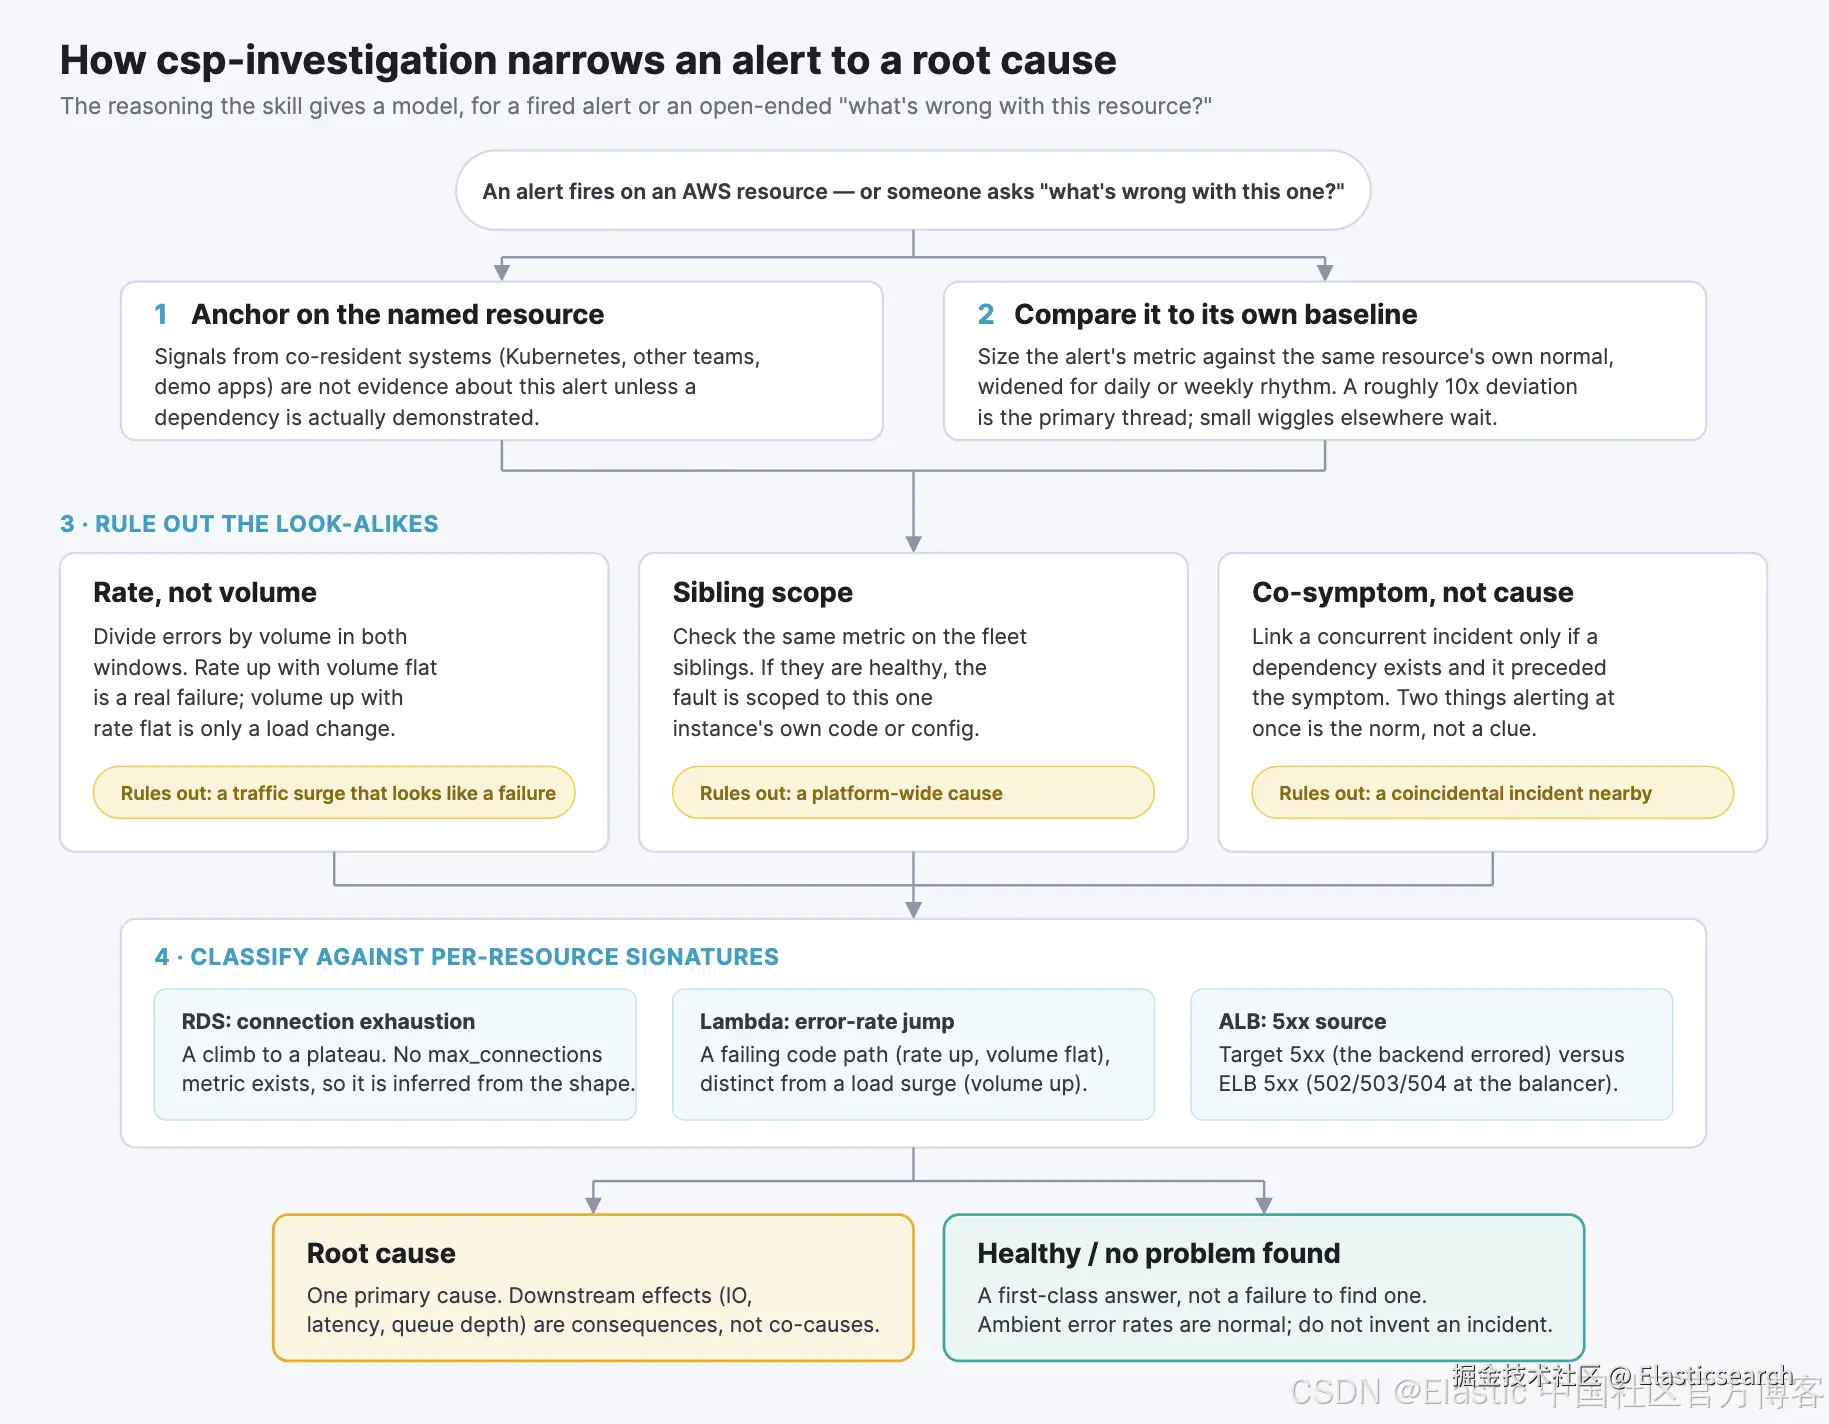 对于已触发的告警,或开放式的"这个资源出了什么问题?"提示,csp-investigation skill 为模型提供的推理和策略。
开始在 Elastic 中使用 AWS 监控
步骤 1:将你的 AWS 账户连接到 Elastic
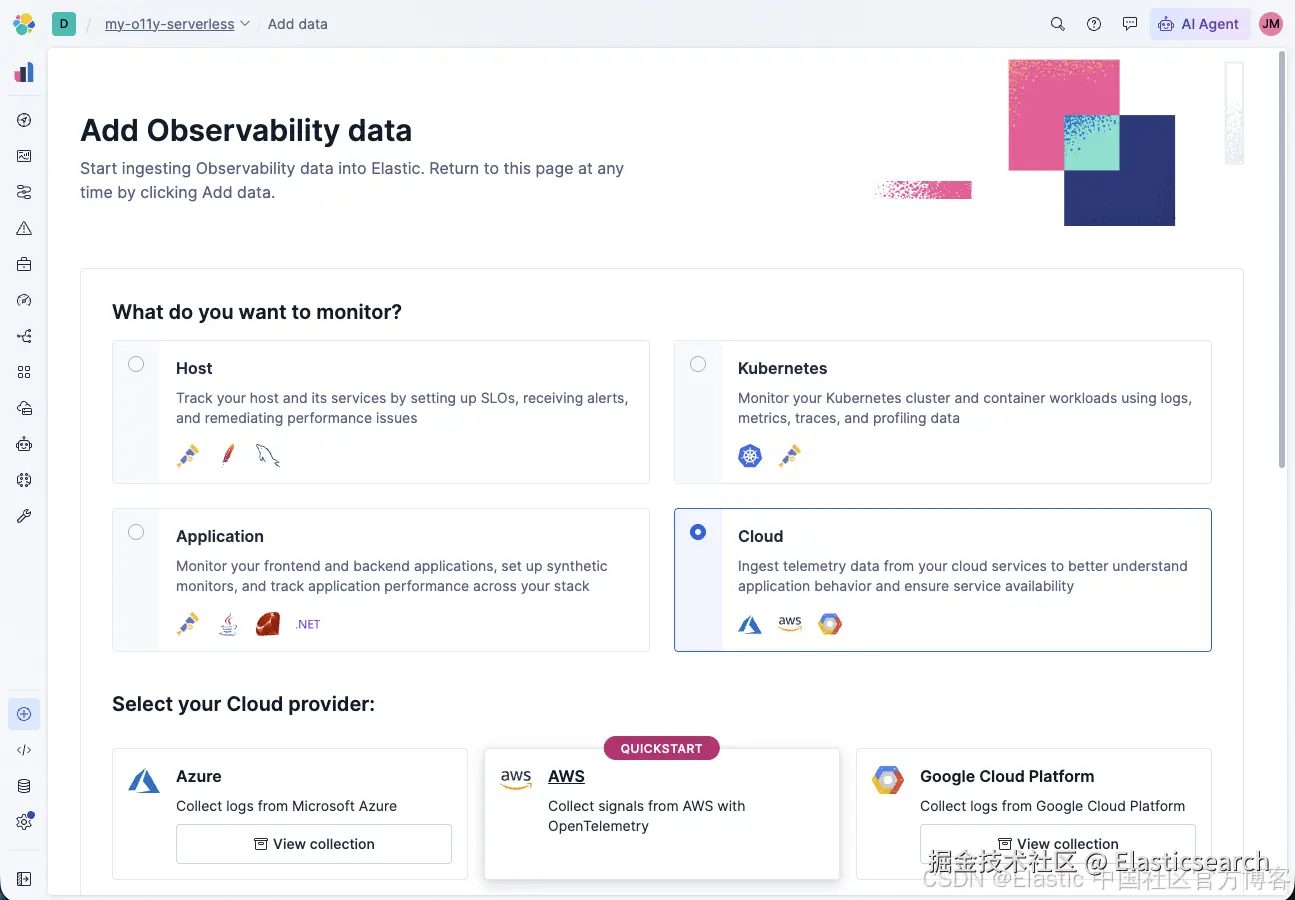
在 Add Data 页面中,从 quickstart 路径中选择 Cloud ,然后选择 AWS。这会进入 AWS CloudWatch(OpenTelemetry)输入集成(aws_cloudwatch_input_otel),并提供两种部署路径供选择。
这 6 个服务套件仅包含内容,添加该输入集成后会自动安装这些套件,因此你启用的服务所对应的 dashboard、告警规则模板和 SLO 模板,会在第一条指标到达之前就准备就绪。
请使用仅具有 CloudWatch 只读访问权限的 AWS 凭证。该集成至少需要 cloudwatch:ListMetrics 和 cloudwatch:GetMetricData 权限。
将英文界面术语统一为中文统一服务套件相关术语
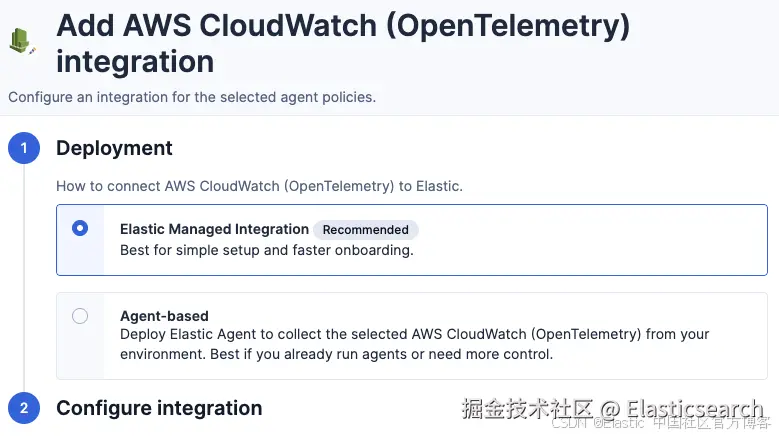
Elastic Managed Integration 路径无需 agent。Elastic 会为你运行数据采集,其底层使用 OpenTelemetry Collector 的 CloudWatch metrics receiver。输入 AWS region 和凭证(access key 和 secret,或者带有 session token 的临时 AWS Security Token Service(STS)凭证)后,指标就会开始流入 metrics-aws.*.otel-* 数据流。你的账户中无需部署、修补或扩展任何东西,从安装集成到看到数据之间的间隔,也就是填写一个表单的时间。
基于 agent 的路径会在你的环境中部署 Elastic Agent,以运行相同的数据采集。如果你已经在运行 agent,或者需要控制数据采集的运行位置,请选择此路径。
统一技术术语的中英文格式让两种路径的对比更清晰优化首段长句的表达
接下来,指定 AWS region 并选择一种身份验证方式:access key ID 和 secret access key、带有 session token 的临时 STS 凭证,或者通过 IAM role assumption 进行角色承担,并可选择提供 external ID。Fleet 会将集成 policy 中的**敏感信息**与 policy 的其他部分分开存储,并在 Fleet UI 和渲染后的 agent policy 中隐藏这些信息。
启用你所需的服务 namespace:EC2、ECS、Lambda、RDS、SQS 以及负载均衡器系列。在每个已启用的 namespace 中,该集成会自动发现 CloudWatch 指标,最多达到配置的 Autodiscover Limit。启用数据采集之前,请检查该限制和采集间隔,因为 CloudWatch 会根据请求的指标数量收费。
在同一个页面中,你还可以启动 EDOT Cloud Forwarder,这是一个 AWS CloudFormation stack,用于从 Amazon S3 中采集 ELB access log。
统一术语并优化中文表达保留所有链接格式并完善翻译
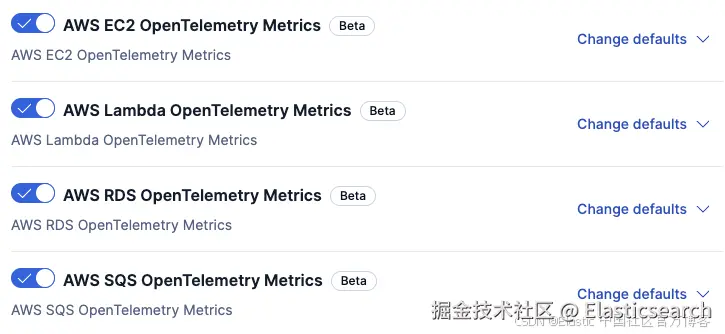 在 Elastic 中添加 AWS CloudWatch OpenTelemetry 集成,并选择无需 agent 的 Elastic Managed 部署路径。
步骤 2:启用告警规则模板
打开 Alert Rules 管理页面,点击 Create rule,找到与你的环境相关的模板。然后确认或定义阈值,并连接你的通知渠道。
步骤 3:根据模板创建 SLO
打开 SLOs,根据模板创建 SLO,并根据你的 Service Level Agreements(SLAs)调整目标和阈值。
步骤 4:启用 ML 异常检测 job
在 Kibana 中打开 Machine Learning,进入 Anomaly Detection,然后选择 Manage jobs 。接着选择 Create job ,并选择 metrics-* data view。提供的 AWS 异常检测 job 会显示在那里,可以直接启用。
步骤 5:安装调查 workflow
这 4 个 AWS 调查 workflow 以模板形式发布在 Workflow Template Library 中。这是一个公共目录,Kibana 中的 Workflows app 会从该目录浏览和安装模板。(该库在 Kibana 9.5.0 中处于技术预览阶段。)启用模板库的说明可以**在这里找到**。
在 Kibana 中打开 Workflows,找到 AWS 调查模板,然后安装或 remix 适用于你所运行服务的模板。每个模板都会作为一个已保存的 workflow 出现在你的 Kibana 中,可以直接关联到对应的告警规则,从而在告警触发时运行调查。
 直接在 Kibana 中浏览、安装和 remix 来自 Elastic Workflow Template Library 的 workflow。
接下来我们将发布什么
我们期待在后续文章中分享这些调查 workflow 背后的 skill 与 workflow 实验,包括完整的方法论和结果。
如果你目前在 AWS 上运行这些服务,请告诉我们,你目前仍然需要手动调查哪些故障模式,以及其中哪些故障模式是你最愿意首先交给 workflow 进行诊断的。你提供的反馈将直接影响我们下一步构建哪些调查功能。你可以**在这里加入 Elastic 社区讨论**。
本文所述任何版本和功能的发布及发布时间均由 Elastic 自行决定。目前尚未提供的任何版本或功能可能无法按时交付,也可能根本不会交付。
原文:Automated root cause analysis for AWS in 36 seconds | Elastic Observability Labs