🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :系统梳理
<ctype.h>与<string.h>中最常用的字符、字符串函数,不只介绍"怎么调用",还把终止符、容量、可写性、重叠、隐藏状态和返回值契约讲清楚。💡 学习目标 :能正确使用字符分类与转换函数;理解并模拟实现
strlen、strcpy、strcat、strcmp、strstr;分清strncpy、strncat、strncmp中n的不同含义;掌握strtok、strerror、perror的状态与副作用。📌 核心前提 :C 字符串不是一种独立类型,而是以空字符
\0结尾的字符序列。标准字符串函数通常只收到起始地址,并不知道目标数组的总容量,因此边界责任始终在调用者一侧。
文章目录
- 一、先建立统一模型:字符串函数到底在操作什么
- [二、字符分类函数:用 ctype.h 读懂一个字符](#二、字符分类函数:用 ctype.h 读懂一个字符)
- [三、字符转换函数:tolower 与 toupper](#三、字符转换函数:tolower 与 toupper)
- 四、strlen:长度来自第一个空字符
- 五、strcpy:复制时必须把终止符一起带走
- 六、strcat:先找末尾,再从终止符处追加
- 七、strcmp:比较字典序,不比较长度
- [八、带 n 的三个函数:strncpy、strncat、strncmp](#八、带 n 的三个函数:strncpy、strncat、strncmp)
- 九、strstr:在主串中寻找子串
- 十、strtok:会改写源字符串的分词器
- [十一、strerror、errno 与 perror:读懂系统错误](#十一、strerror、errno 与 perror:读懂系统错误)
- 十二、统一检查清单与高频问答
- 总结
一、先建立统一模型:字符串函数到底在操作什么
在 C 语言中,下面两个对象都可以保存 "hello",但语义并不相同:
c
char array[] = "hello";
const char *pointer = "hello";
array 是一个可修改数组,内部共有 6 个字符:
text
'h' 'e' 'l' 'l' 'o' '\0'pointer 指向字符串字面量。字面量不能被程序修改,所以使用 const char * 更能表达真实约束。把它交给 strcpy 的源参数没有问题,但绝不能把它当作可写目标。
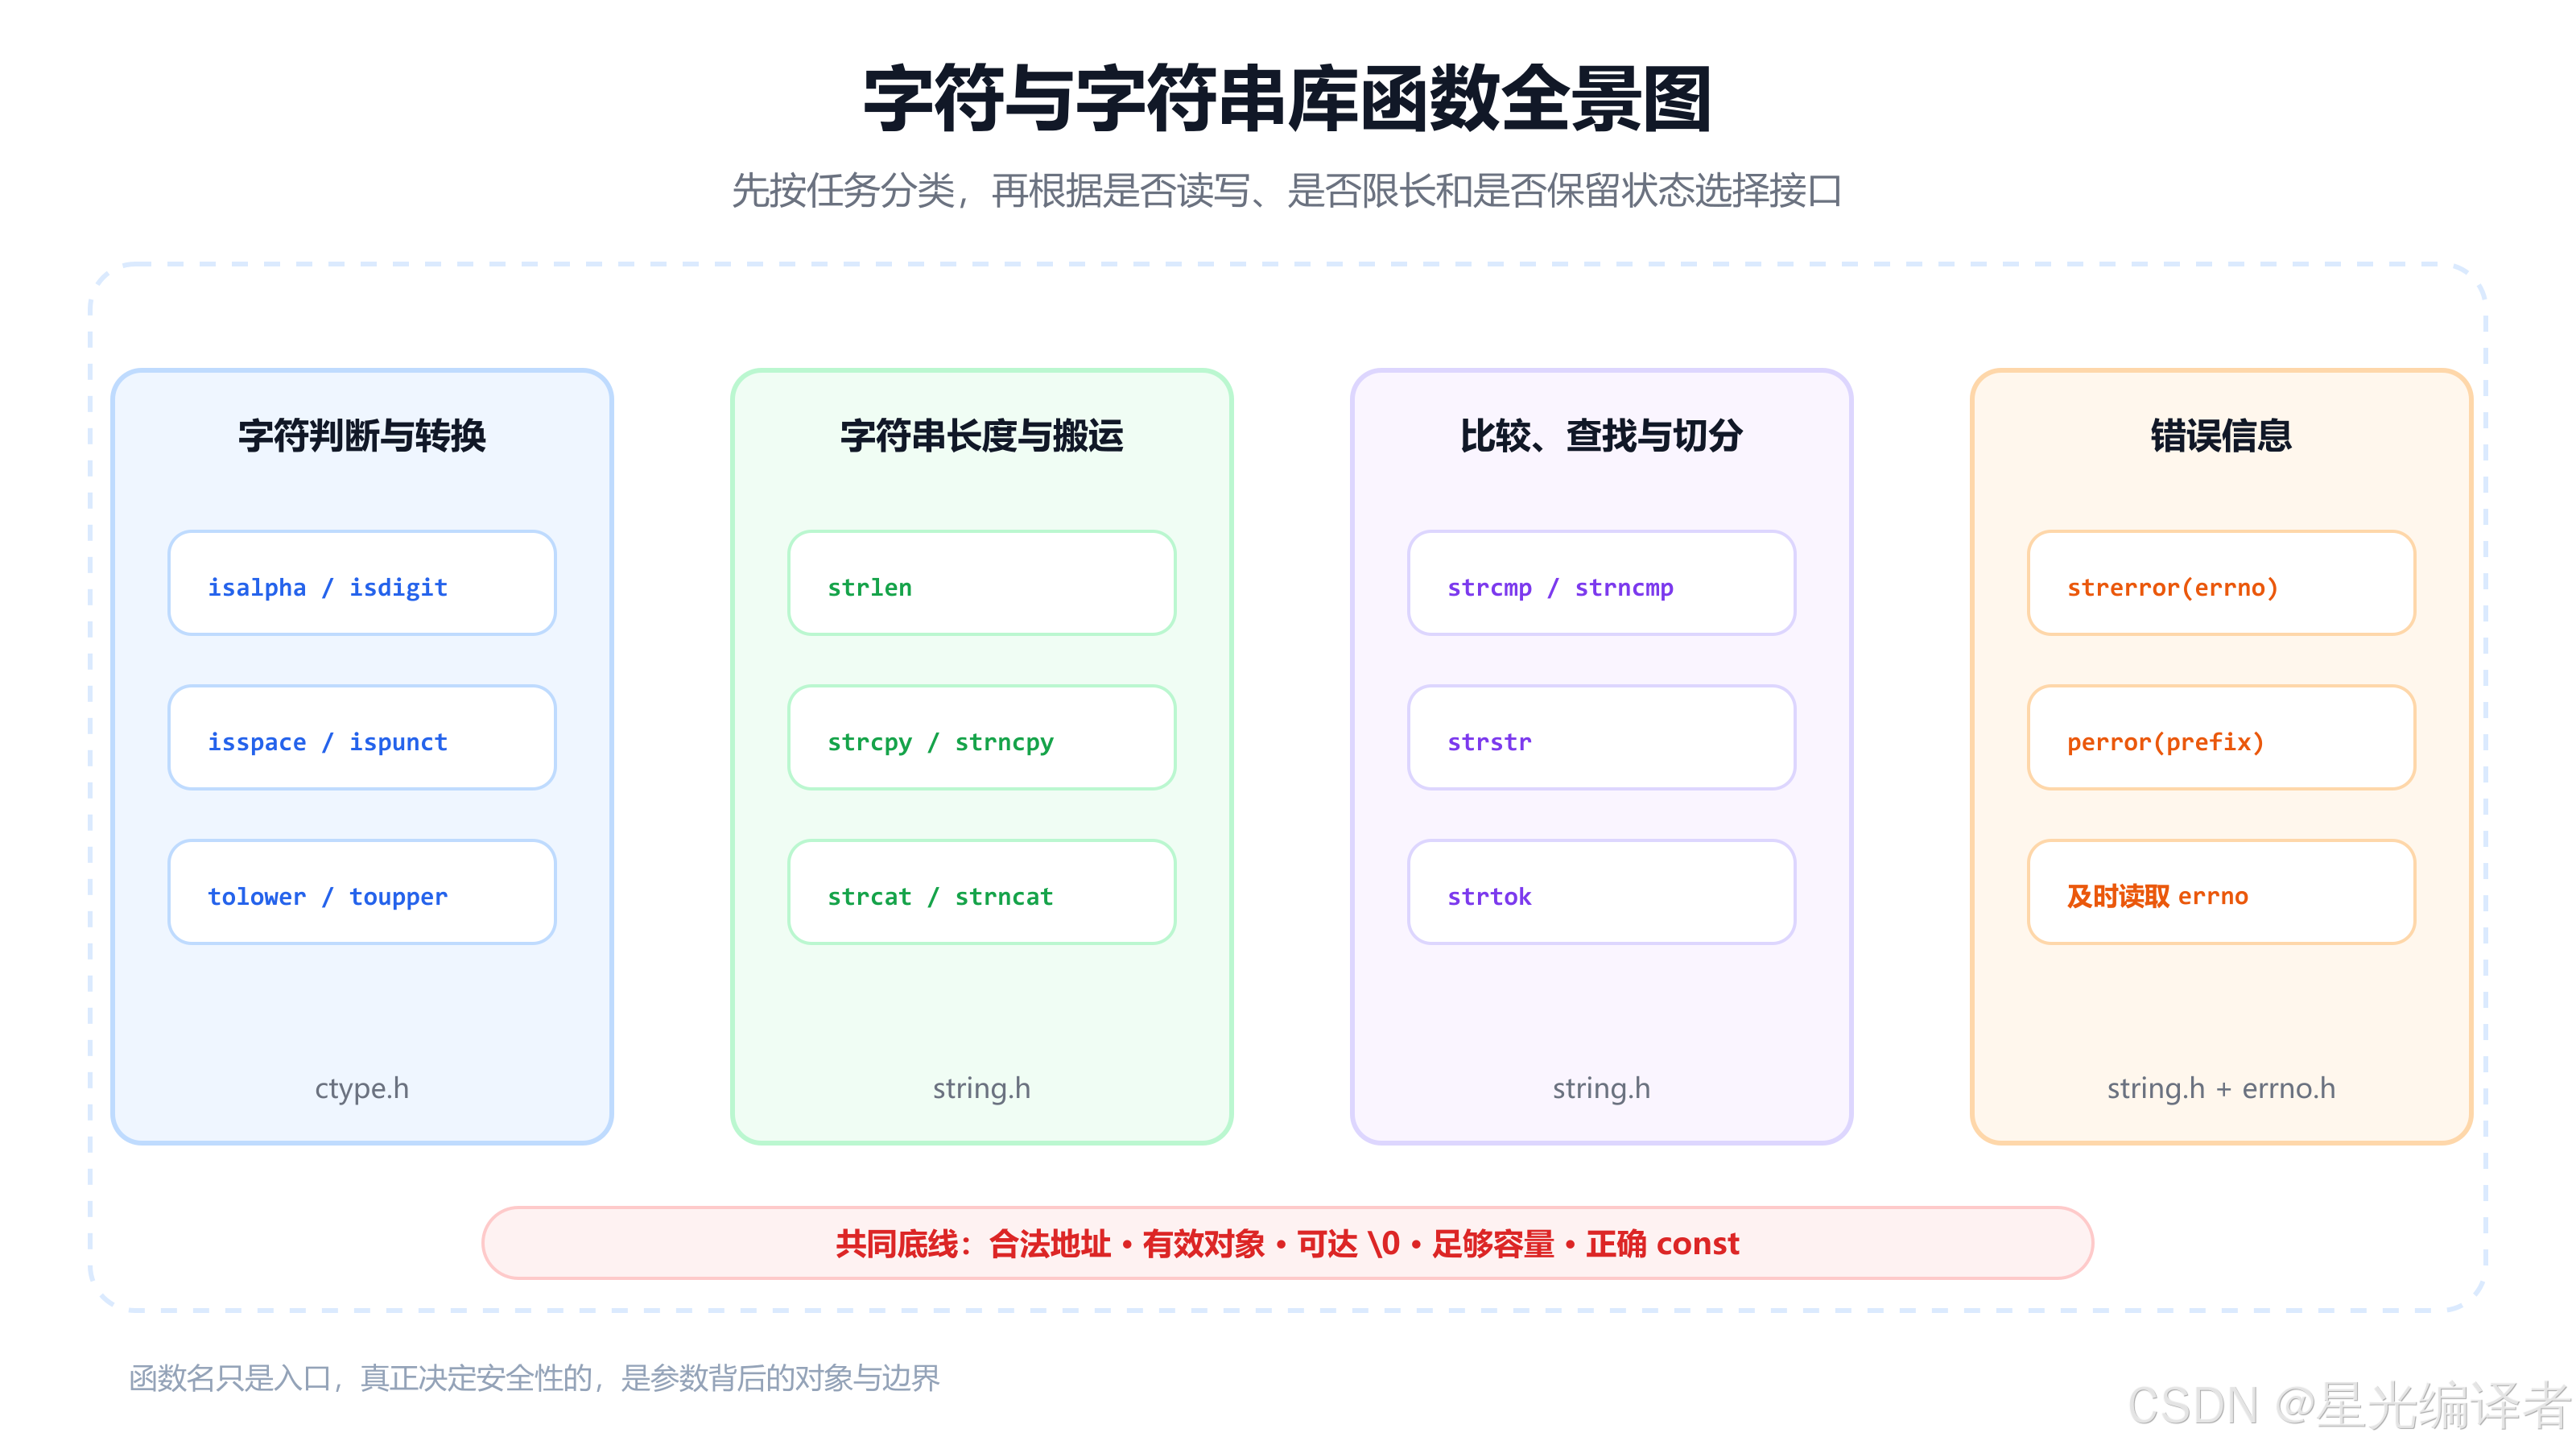
面对任意字符或字符串函数,可以先问五个问题:
- 参数是一个字符值,还是一个字符地址?
- 函数是否会读取到
\0,这个终止符在有效对象范围内吗? - 函数是否会写入,目标对象可修改吗?
- 目标空间能容纳所有字符以及新的
\0吗? - 源与目标是否可能重叠,函数是否保存了隐藏状态?
这五个问题比死记函数名重要。许多字符串漏洞并不是函数"不工作",而是调用者没有满足它的前置条件。
二、字符分类函数:用 ctype.h 读懂一个字符
字符分类函数声明在 <ctype.h> 中,常见接口如下:
| 函数 | 判断内容 |
|---|---|
isalnum |
字母或十进制数字 |
isalpha |
字母 |
isblank |
空格或横向制表等空白 |
iscntrl |
控制字符 |
isdigit |
十进制数字 0~9 |
isgraph |
有图形表示的可打印字符,不含空格 |
islower |
小写字母 |
isprint |
可打印字符,包含空格 |
ispunct |
标点字符 |
isspace |
空格、换行、制表、回车等空白字符 |
isupper |
大写字母 |
isxdigit |
十六进制数字字符 |
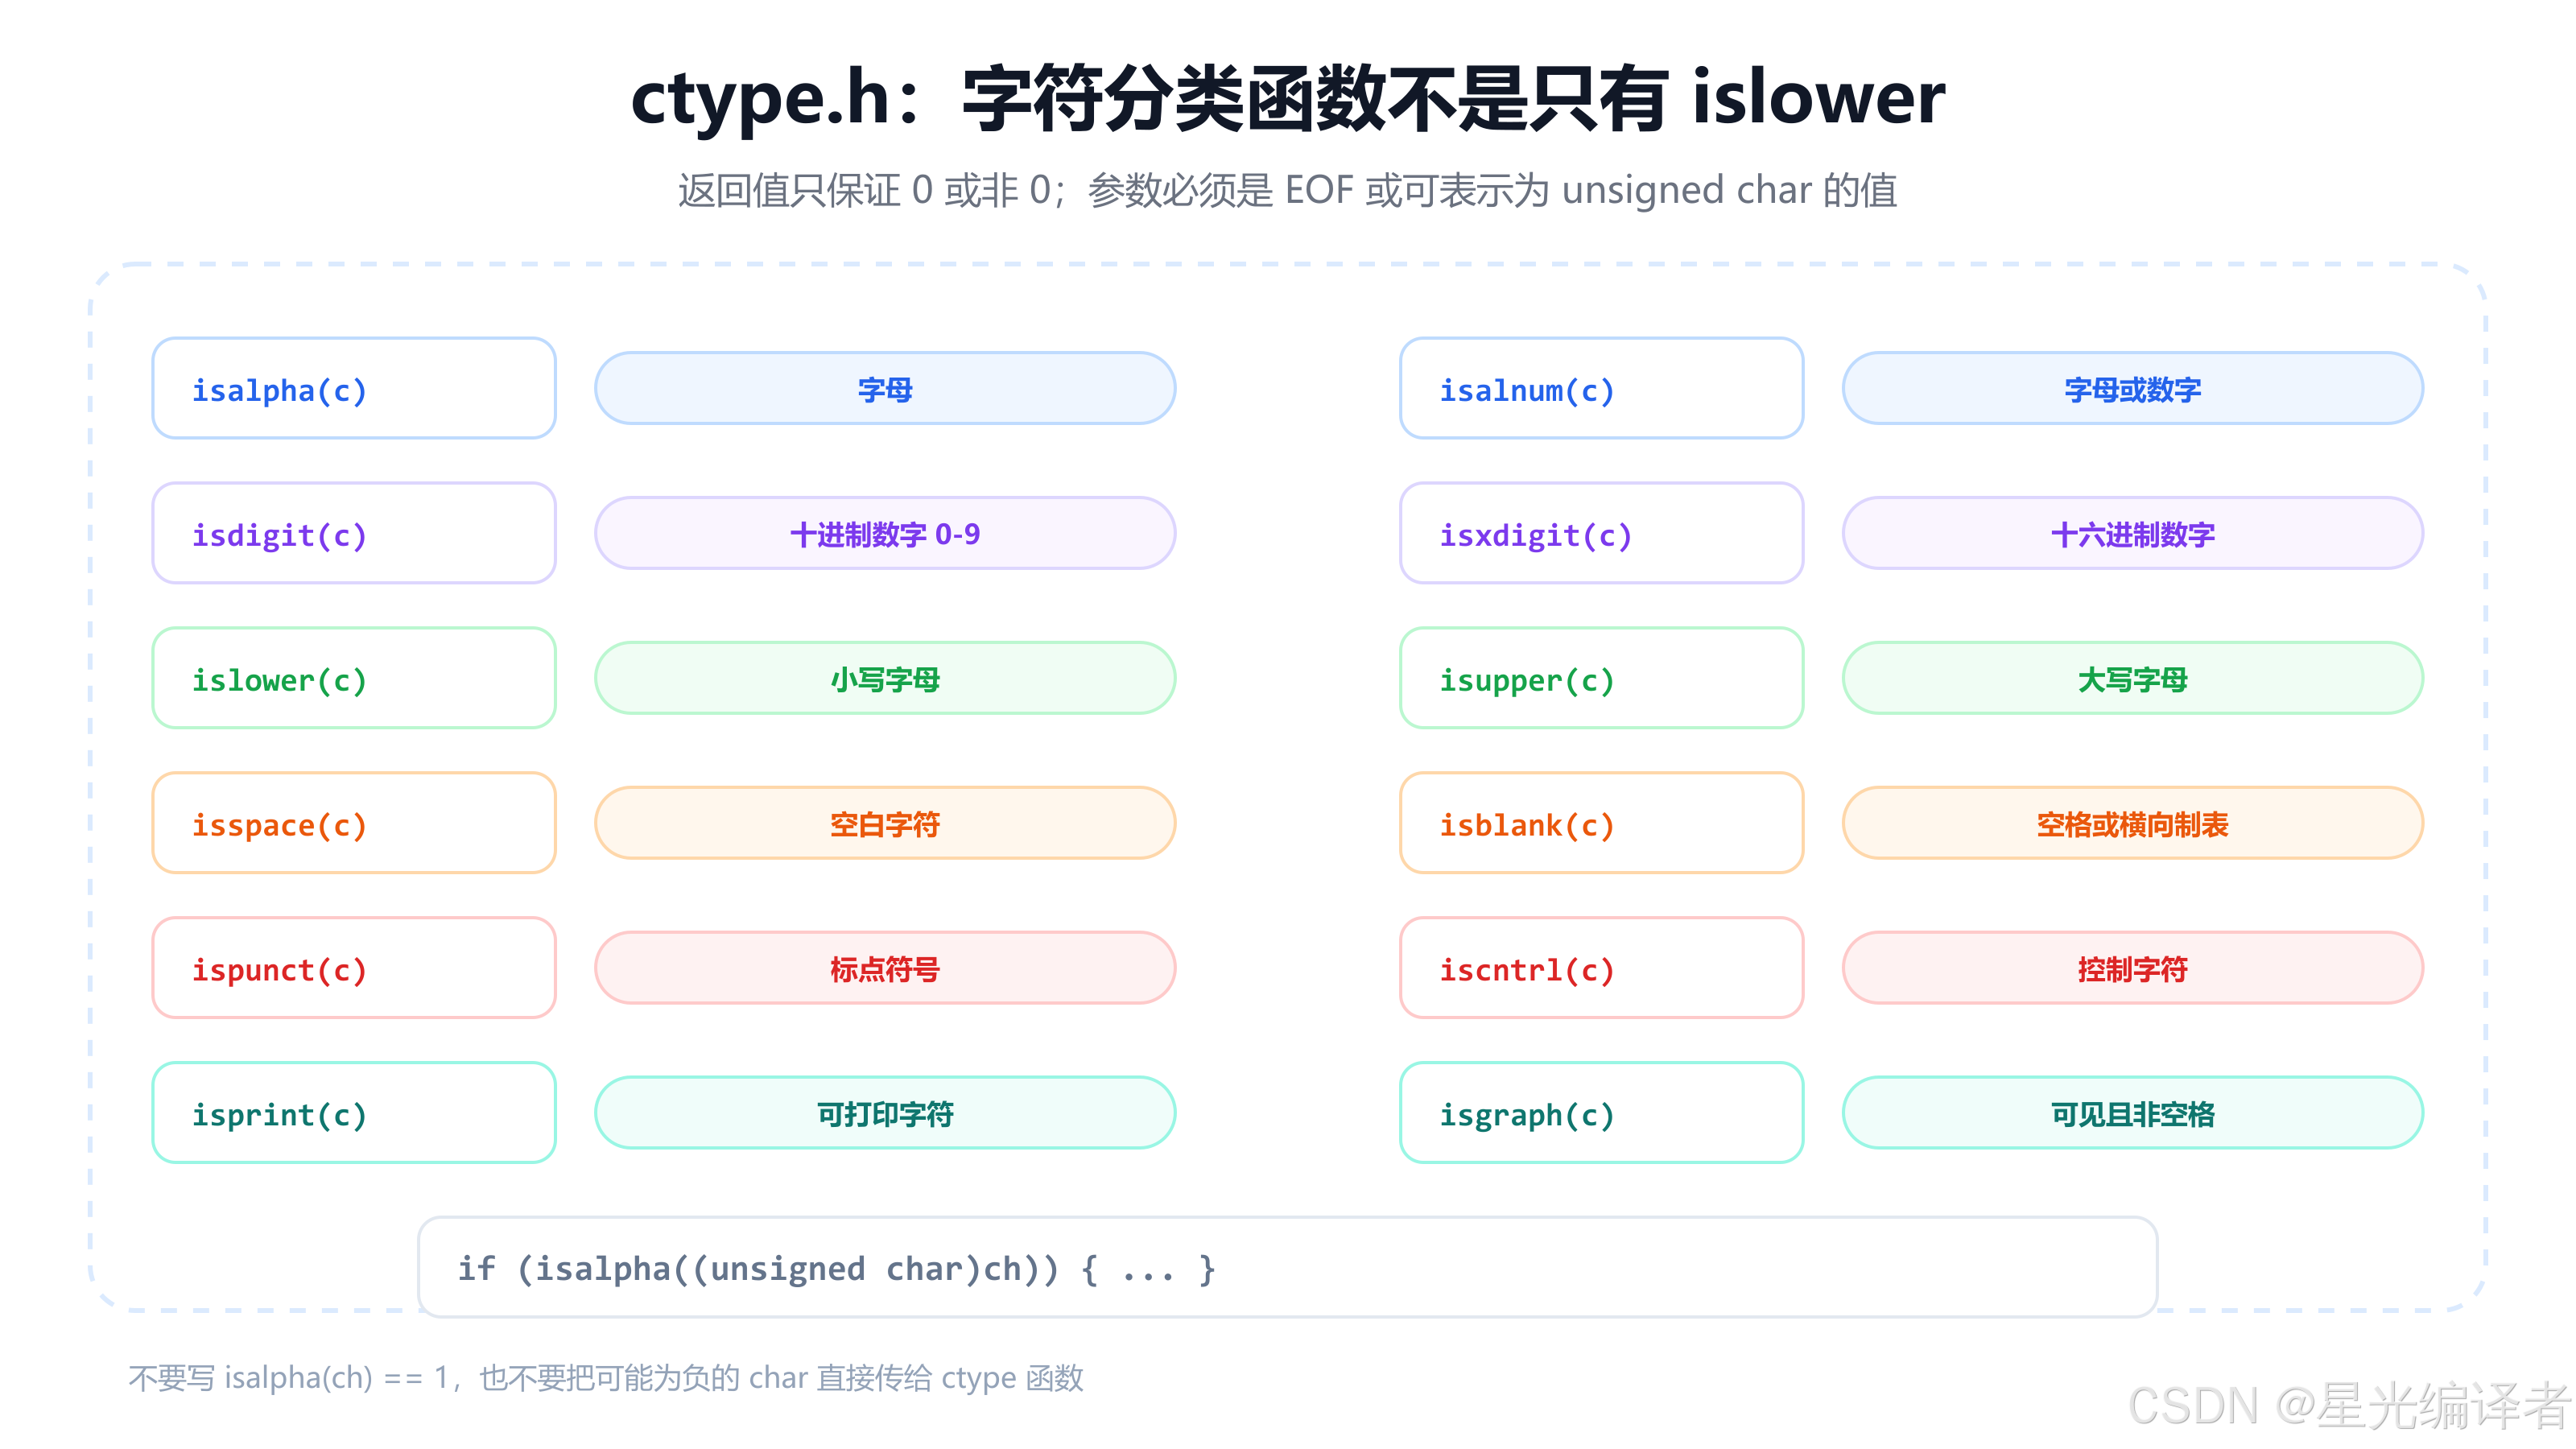
2.1 返回值只有"零"和"非零"两类
以 islower 为例:
c
int islower(int c);若 c 属于小写字母,函数返回非零值;否则返回 0。标准没有承诺"真"一定等于 1,因此不要写:
c
if (islower(ch) == 1) { /* 不推荐 */
}
正确写法是直接把返回值当作逻辑条件:
c
if (islower((unsigned char)ch)) {
    puts("lowercase");
}
2.2 为什么经常需要转成 unsigned char
ctype 系列函数的参数类型是 int,但合法实参范围不是"任意 int",而是:
- 宏
EOF的值; - 或者能够表示为
unsigned char的值。
若当前平台的 char 默认有符号,一个高位为 1 的字节可能先变成负数。把这个负数直接传给 isalpha、toupper 等函数会产生未定义行为。处理普通字节流时,更稳妥的写法是:
c
unsigned char uc = (unsigned char)ch;

if (isalpha(uc)) {
    /* ... */
}
若字符来自 fgetc,则应先用 int 保存返回值,以便区分所有无符号字符值和 EOF:
c
int c;

while ((c = fgetc(stdin)) != EOF) {
    if (isdigit(c)) {
        putchar(c);
    }
}
2.3 练习:统计字符串中的字符类型
c
#include <ctype.h>
#include <stdio.h>

int main(void)
{
    const char text[] = "C17: hello, world!\n";
    size_t letters = 0;
    size_t digits = 0;
    size_t spaces = 0;

    for (size_t i = 0; text[i] != '\0'; ++i) {
        unsigned char ch = (unsigned char)text[i];

        if (isalpha(ch)) {
            ++letters;
        } else if (isdigit(ch)) {
            ++digits;
        } else if (isspace(ch)) {
            ++spaces;
        }
    }

    printf("letters=%zu digits=%zu spaces=%zu\n",
           letters, digits, spaces);
    return 0;
}
三、字符转换函数:tolower 与 toupper
<ctype.h> 还提供两个字符转换函数:
c
int tolower(int c);
int toupper(int c);
tolower 把大写字母转换为对应小写字母;toupper 把小写字母转换为对应大写字母。若参数不属于需要转换的类别,函数返回原值。
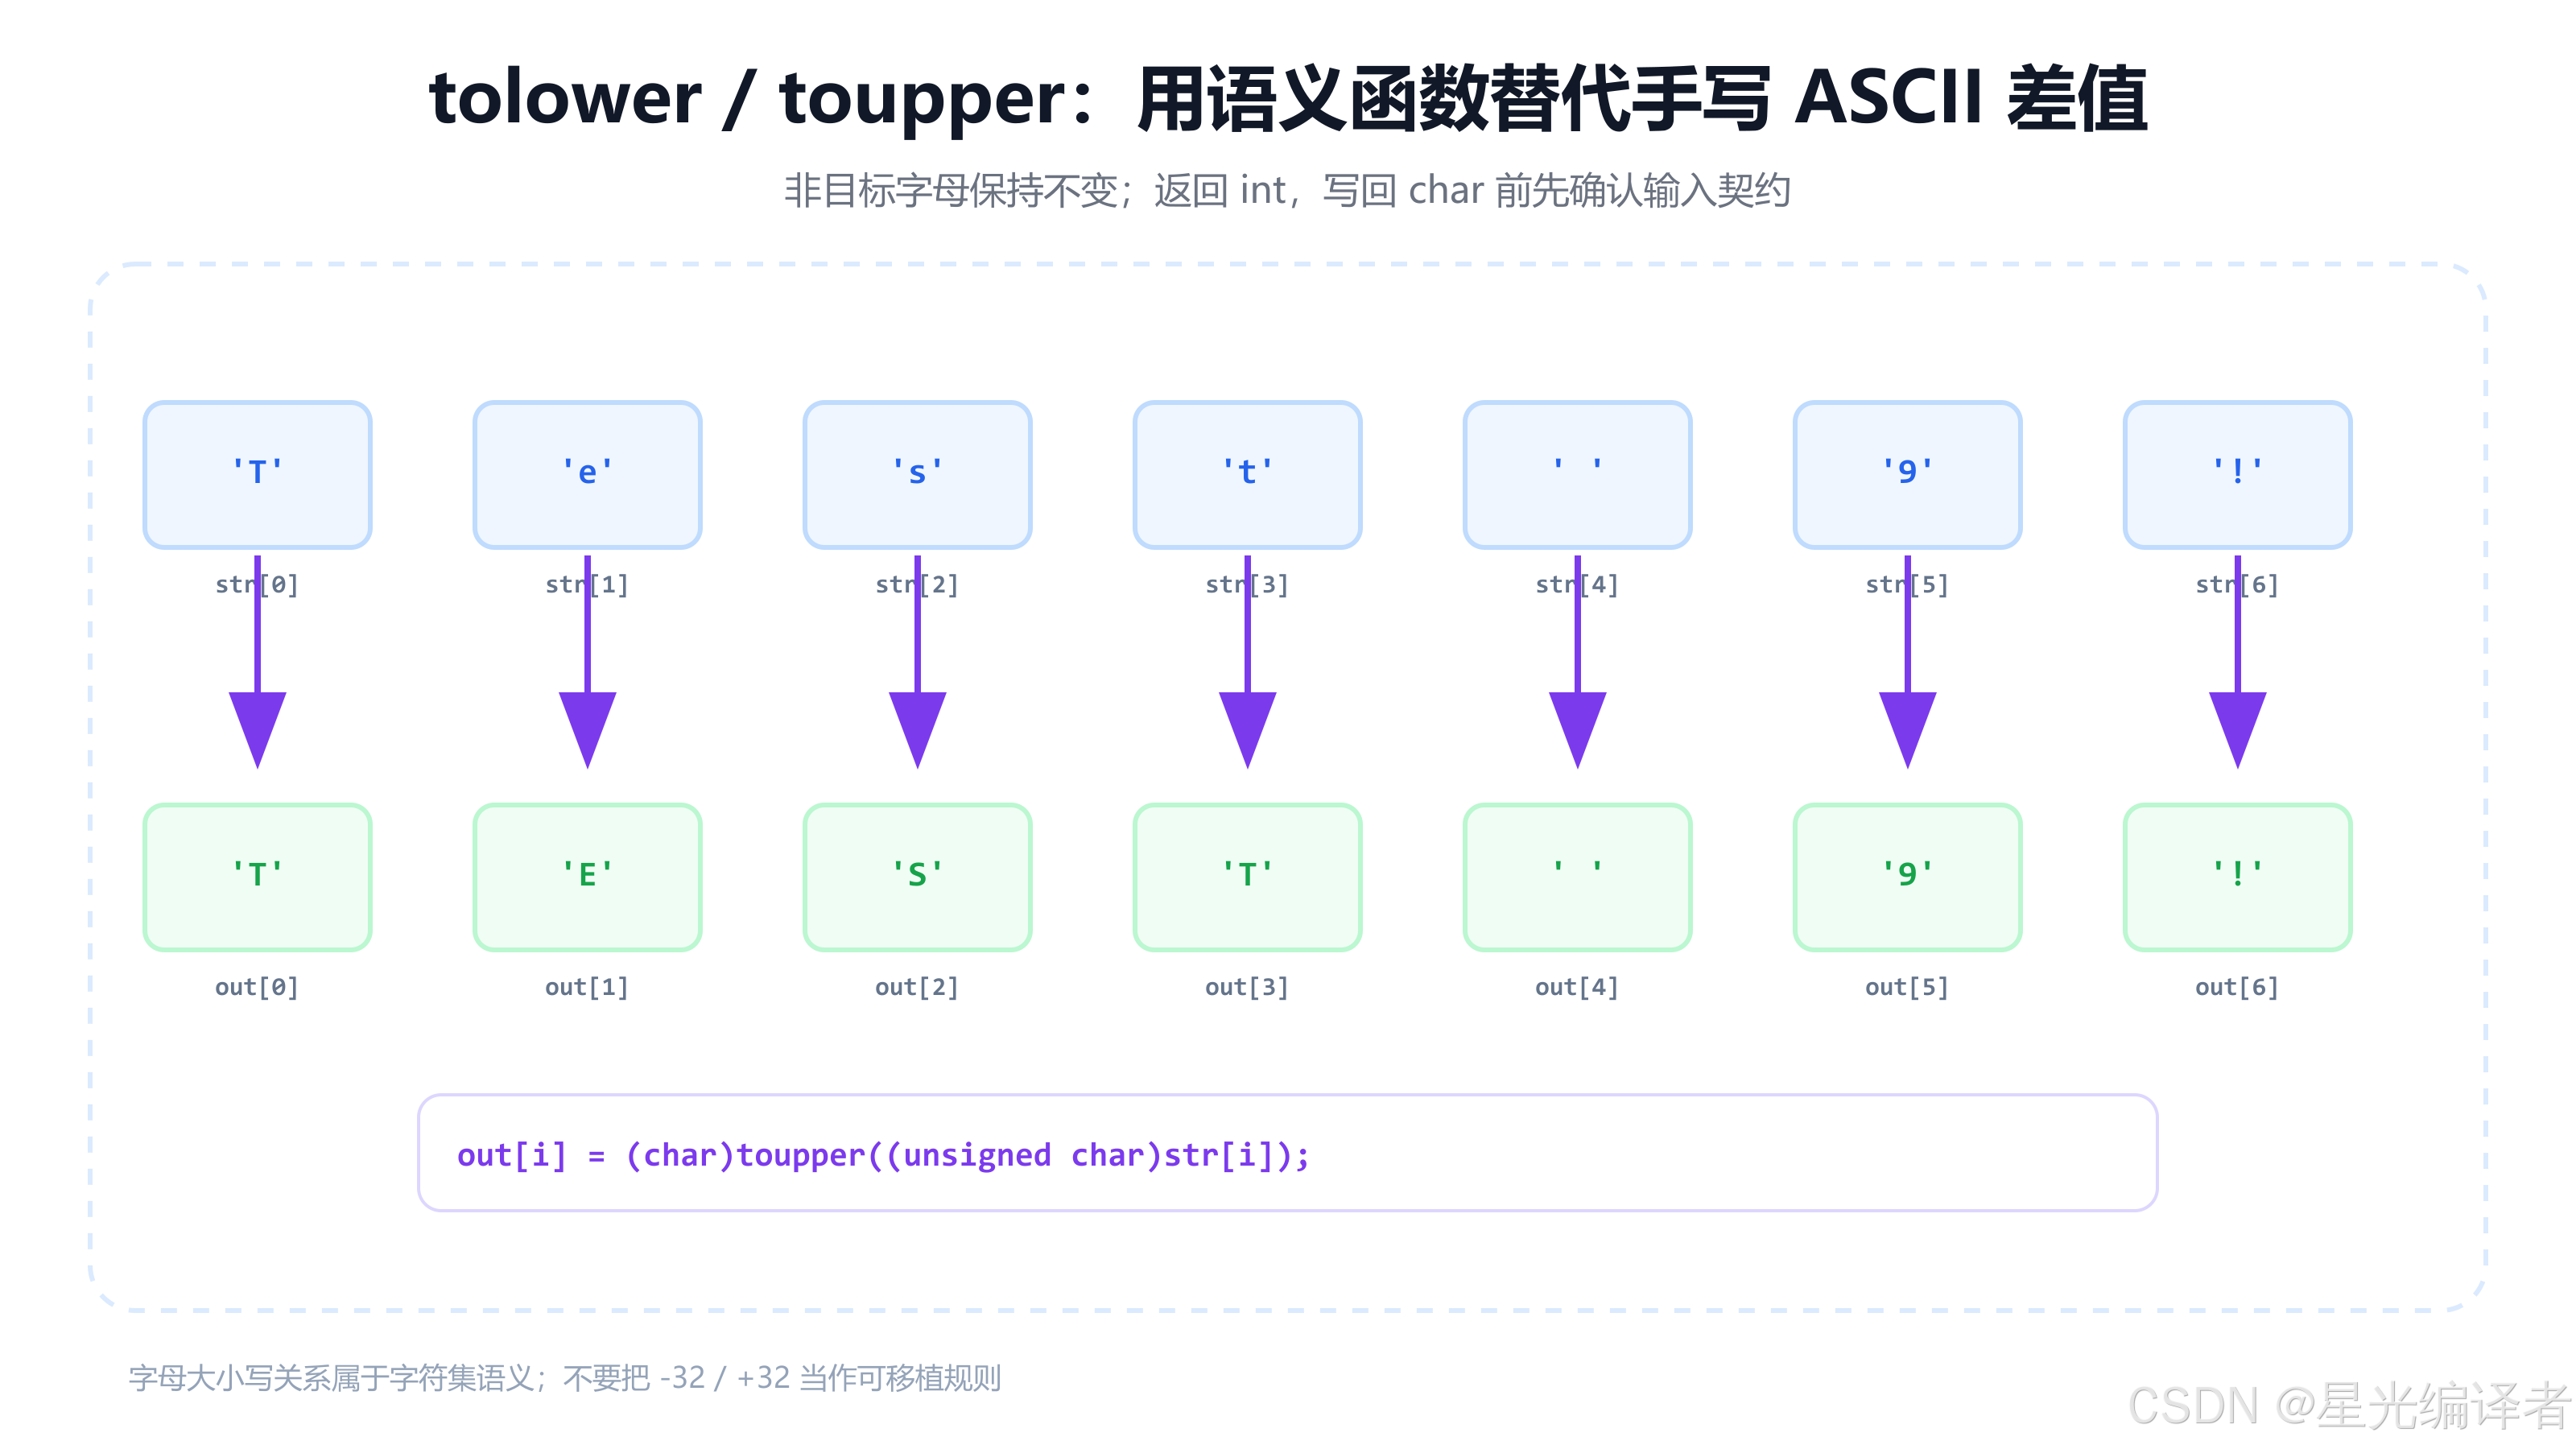
下面把字符串中的小写字母转为大写,其他字符保持不变:
c
#include <ctype.h>
#include <stdio.h>

int main(void)
{
    char text[] = "Test String 9!";

    for (size_t i = 0; text[i] != '\0'; ++i) {
        unsigned char ch = (unsigned char)text[i];
        text[i] = (char)toupper(ch);
    }

    puts(text);
    return 0;
}
输出:
text
TEST STRING 9!不要通过 ch - 32 或 ch + 32 手工转换。ASCII 编码里大小写字母确实相差 32,但 C 语言接口表达的是字符类别和当前区域设置下的转换语义。使用标准库函数更清晰,也更可移植。
四、strlen:长度来自第一个空字符
strlen 声明在 <string.h>:
c
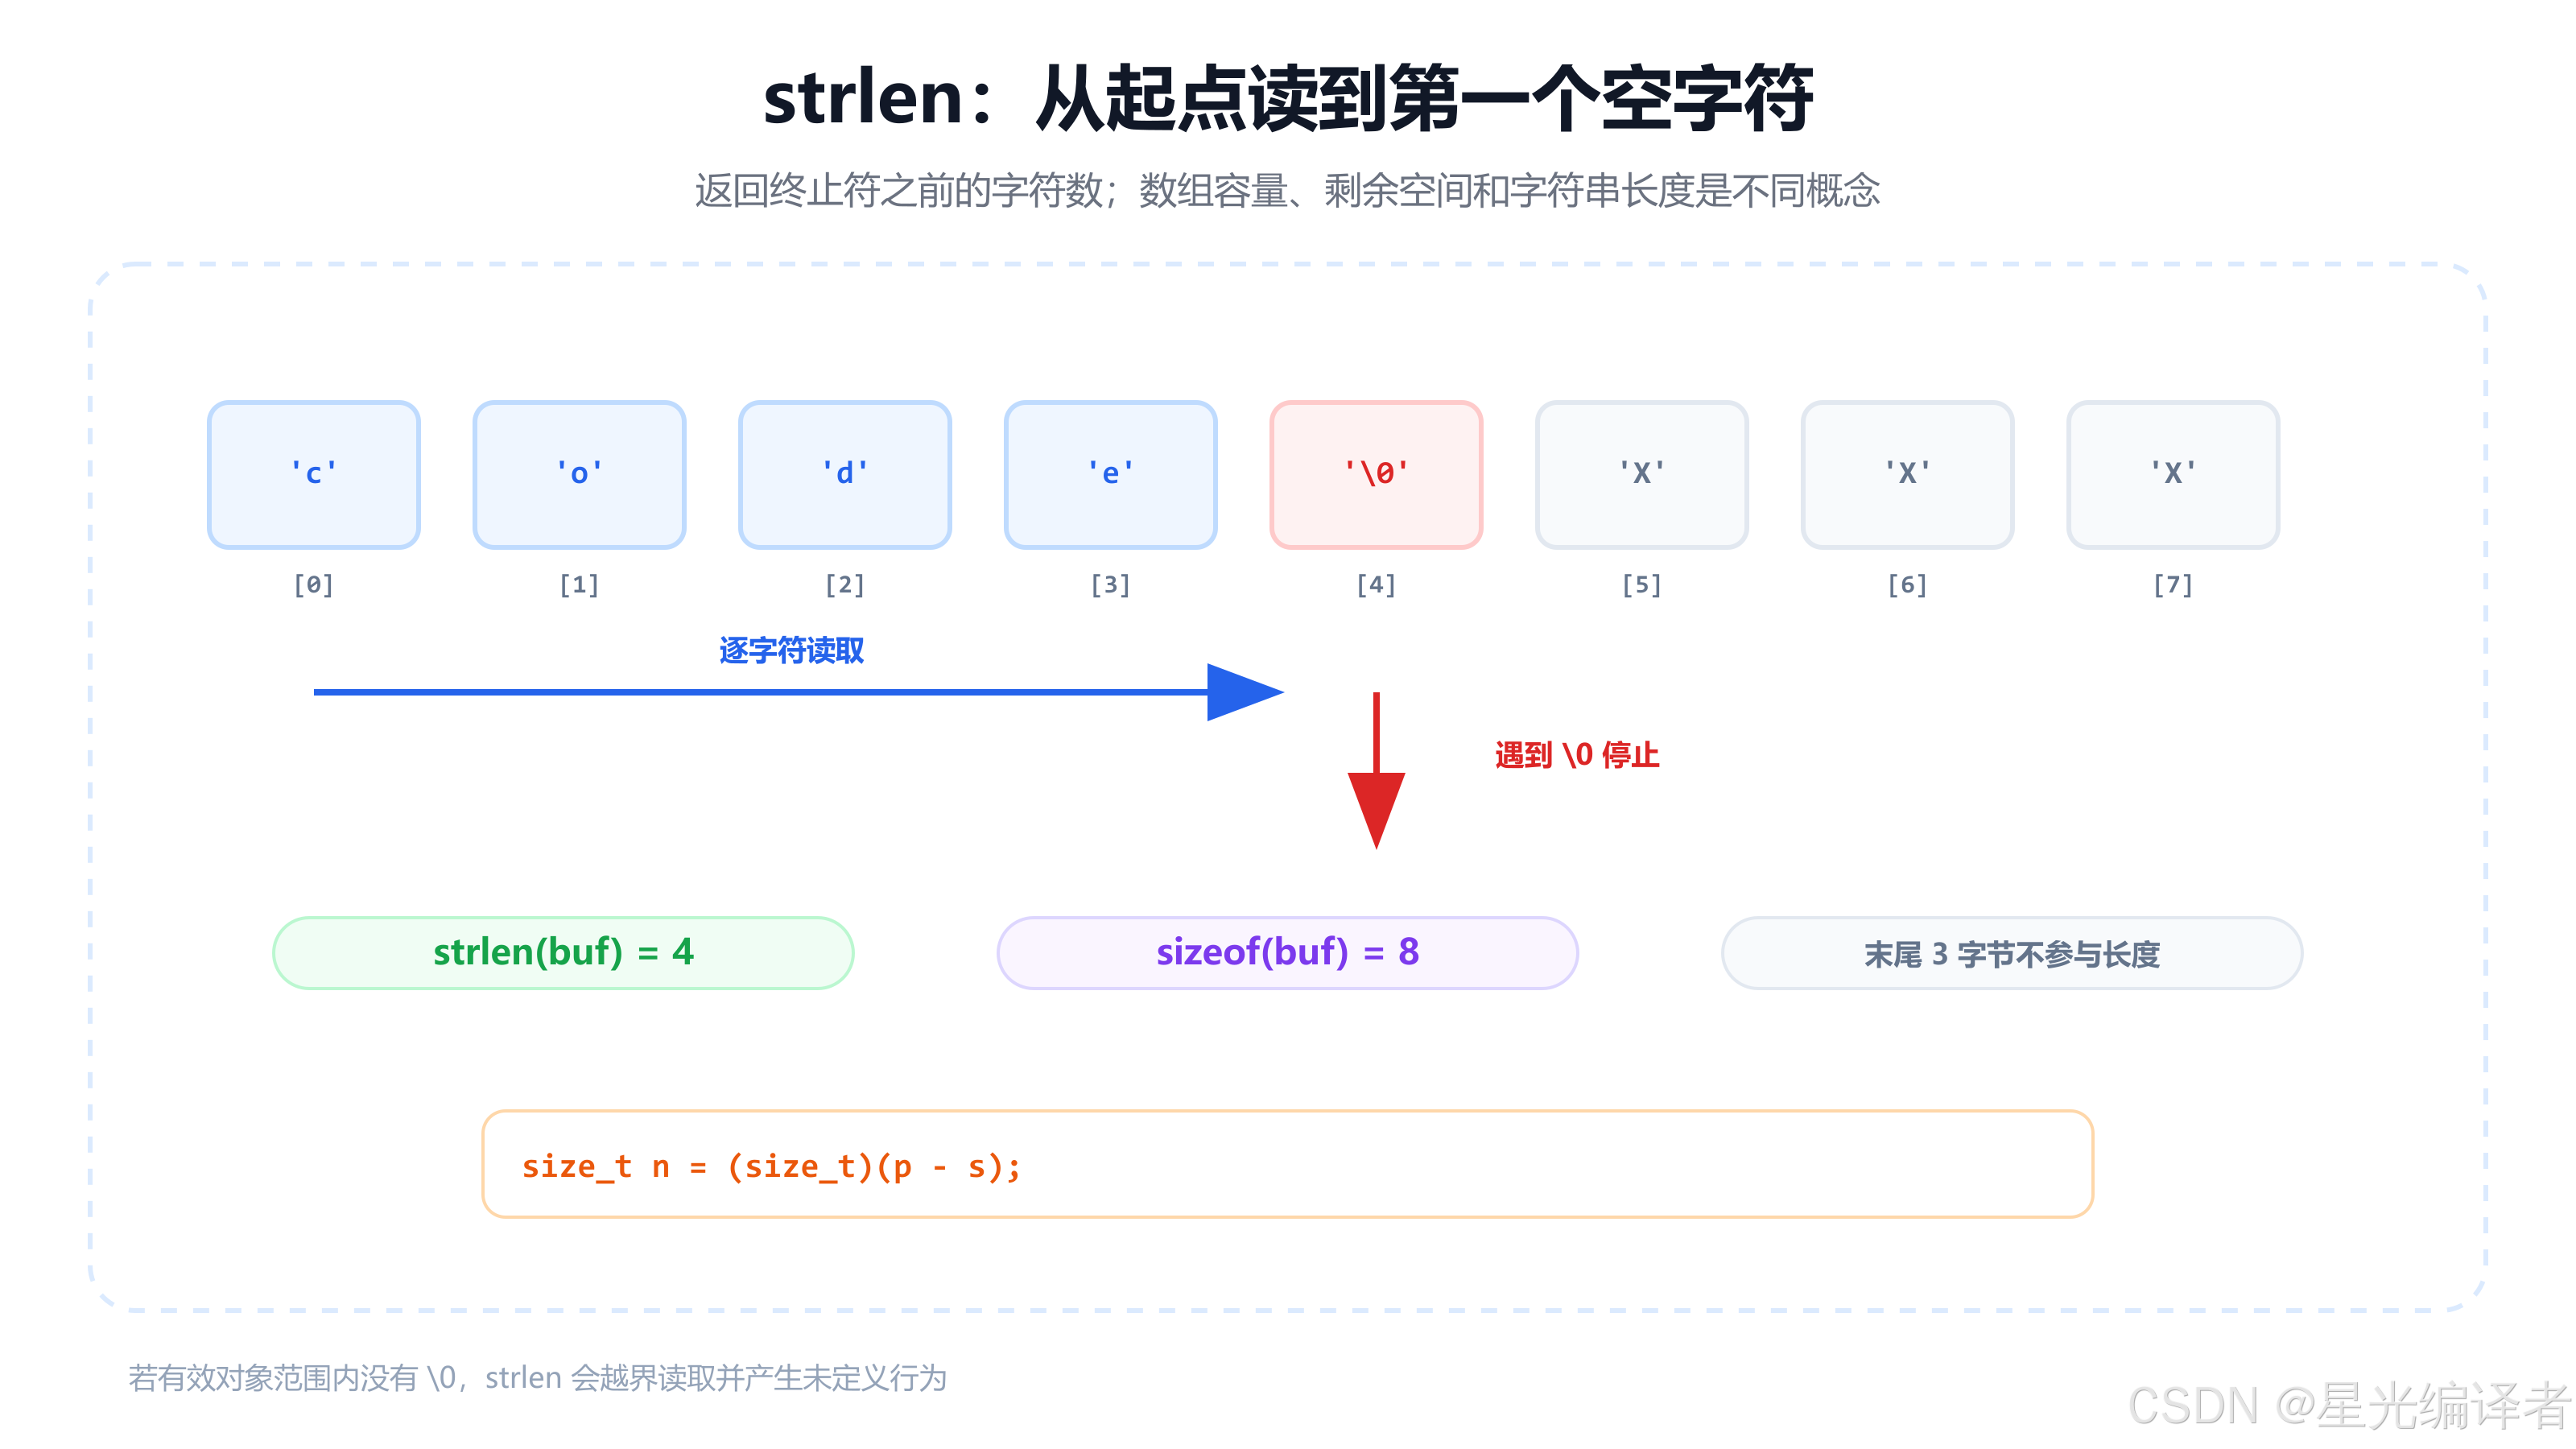
size_t strlen(const char *str);它从 str 指向的位置开始读取,直到遇到第一个 \0,返回此前的字符个数,不包含终止符本身。
c
char buffer[8] = {'c', 'o', 'd', 'e', '\0', 'X', 'X', 'X'};

printf("%zu\n", strlen(buffer)); /* 4 */
printf("%zu\n", sizeof buffer);  /* 8 */
这段代码同时出现了三个不同概念:
| 概念 | 本例结果 | 含义 |
|---|---|---|
| 数组容量 | 8 字节 | 整个对象有多大 |
| 字符串长度 | 4 | 第一个 \0 之前有几个字符 |
| 剩余空间 | 3 字节 | 终止符之后仍属于数组的区域 |
4.1 size_t 的无符号陷阱
strlen 返回 size_t,它是无符号整数类型。因此下面的比较有问题:
c
if (strlen("abc") - strlen("abcdef") < 0) {
    puts("shorter");
}
数学上是 3 - 6,但无符号运算会回绕为一个很大的正数。不要先相减,直接比较:
c
if (strlen("abc") < strlen("abcdef")) {
    puts("shorter");
}
打印 size_t 使用 %zu。
4.2 三种模拟实现
计数器版本:
c
#include <assert.h>
#include <stddef.h>

size_t my_strlen(const char *str)
{
    size_t count = 0;

    assert(str != NULL);
    while (*str != '\0') {
        ++count;
        ++str;
    }
    return count;
}
指针相减版本:
c
size_t my_strlen_pointer(const char *str)
{
    const char *end = str;

    assert(str != NULL);
    while (*end != '\0') {
        ++end;
    }
    return (size_t)(end - str);
}
递归版本也能表达定义:
c
size_t my_strlen_recursive(const char *str)
{
    assert(str != NULL);
    return *str == '\0' ? 0 : 1 + my_strlen_recursive(str + 1);
}
递归写法适合帮助理解,但长字符串会产生很深的调用栈,工程代码应优先使用循环。
最重要的前置条件是:str 必须指向一条有效 C 字符串。若对象范围内没有 \0,strlen 会越界读取,行为未定义。
五、strcpy:复制时必须把终止符一起带走
原型:
c
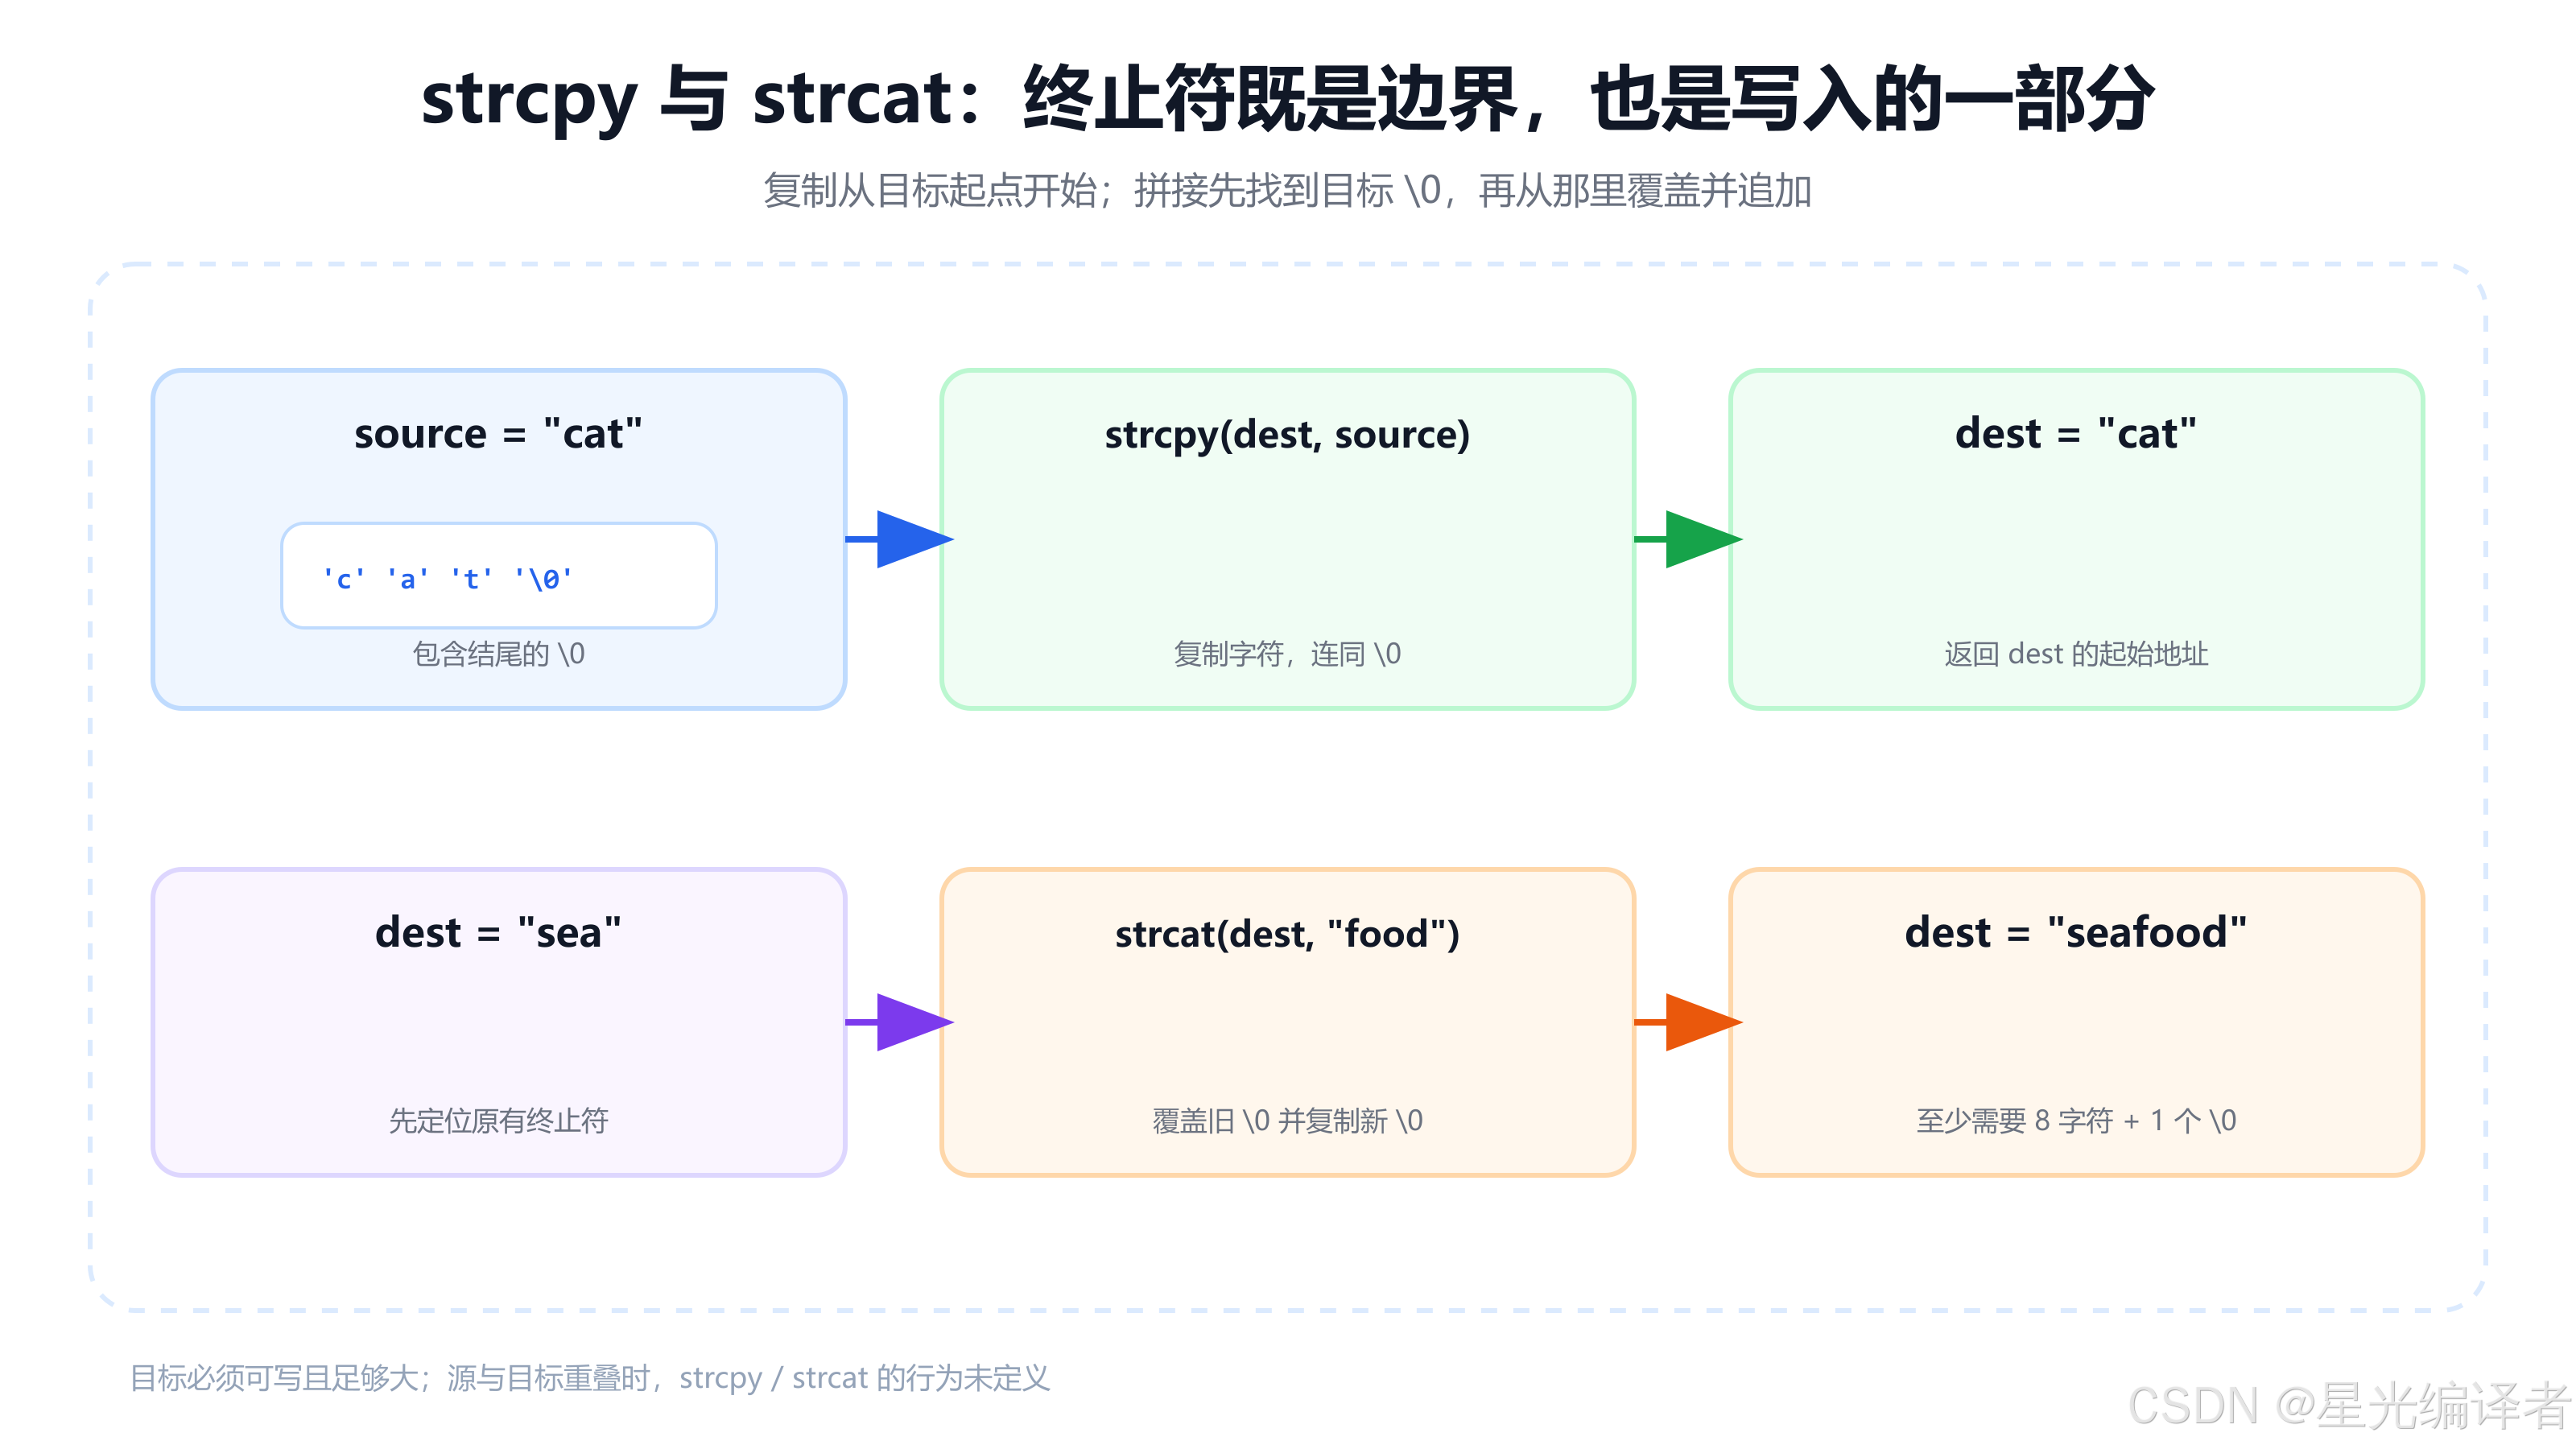
char *strcpy(char *destination, const char *source);strcpy 把 source 指向的字符串复制到 destination,并把结尾的 \0 一起复制。返回值是目标起始地址 destination。
c
#include <stdio.h>
#include <string.h>

int main(void)
{
    char destination[16];

    strcpy(destination, "cat");
    puts(destination);
    return 0;
}
调用者必须同时保证:
source在有效范围内以\0结束;destination可写;- 目标容量至少为
strlen(source) + 1; - 两个对象不能以不允许的方式重叠。
下面两种写法都错误:
c
char small[4];
strcpy(small, "hello"); /* 需要 6 字节,目标溢出 */

char *literal = "hello";
strcpy(literal, "hi");  /* 尝试修改字符串字面量 */
5.1 模拟实现 strcpy
c
#include <assert.h>

char *my_strcpy(char *destination, const char *source)
{
    char *result = destination;

    assert(destination != NULL);
    assert(source != NULL);

    while ((*destination++ = *source++) != '\0') {
        ;
    }
    return result;
}
循环中的赋值表达式先完成复制,再判断刚复制的字符是否为 \0。因此终止符也会被写入,指针随后停止前进。
assert 只能帮助调试空指针,不能验证目标数组究竟有多大。真正的接口若要可靠控制边界,必须让调用者显式提供容量,或在更高层封装中保存长度信息。
六、strcat:先找末尾,再从终止符处追加
原型:
c
char *strcat(char *destination, const char *source);strcat 先寻找 destination 中原有的 \0,再从这个位置开始复制 source,最后写入新的 \0。
c
char text[16] = "sea";

strcat(text, "food");
printf("%s\n", text); /* seafood */
所需总容量为:
text
strlen(destination) + strlen(source) + 1对于 "sea" + "food",需要 3 + 4 + 1 = 8 字节。
6.1 模拟实现 strcat
c
#include <assert.h>

char *my_strcat(char *destination, const char *source)
{
    char *result = destination;

    assert(destination != NULL);
    assert(source != NULL);

    while (*destination != '\0') {
        ++destination;
    }

    while ((*destination++ = *source++) != '\0') {
        ;
    }
    return result;
}
第一段循环找到目标字符串尾部;第二段循环与 strcpy 的复制逻辑相同。
"字符串自己给自己追加"不是一道值得依赖执行结果的技巧题:
c
char text[32] = "abc";
strcat(text, text); /* 源和目标重叠,行为未定义 */
如果确实要基于同一缓冲区构造新内容,应先保存原长度,仔细计算容量,并使用允许重叠的字节搬运方案或独立临时缓冲区。
七、strcmp:比较字典序,不比较长度
原型:
c
int strcmp(const char *str1, const char *str2);strcmp 从头开始比较两条字符串的对应字符:
- 第一处不同字符决定大小;
- 若此前都相同,则较早遇到
\0的字符串更小; - 两条字符串完全相同则返回 0。
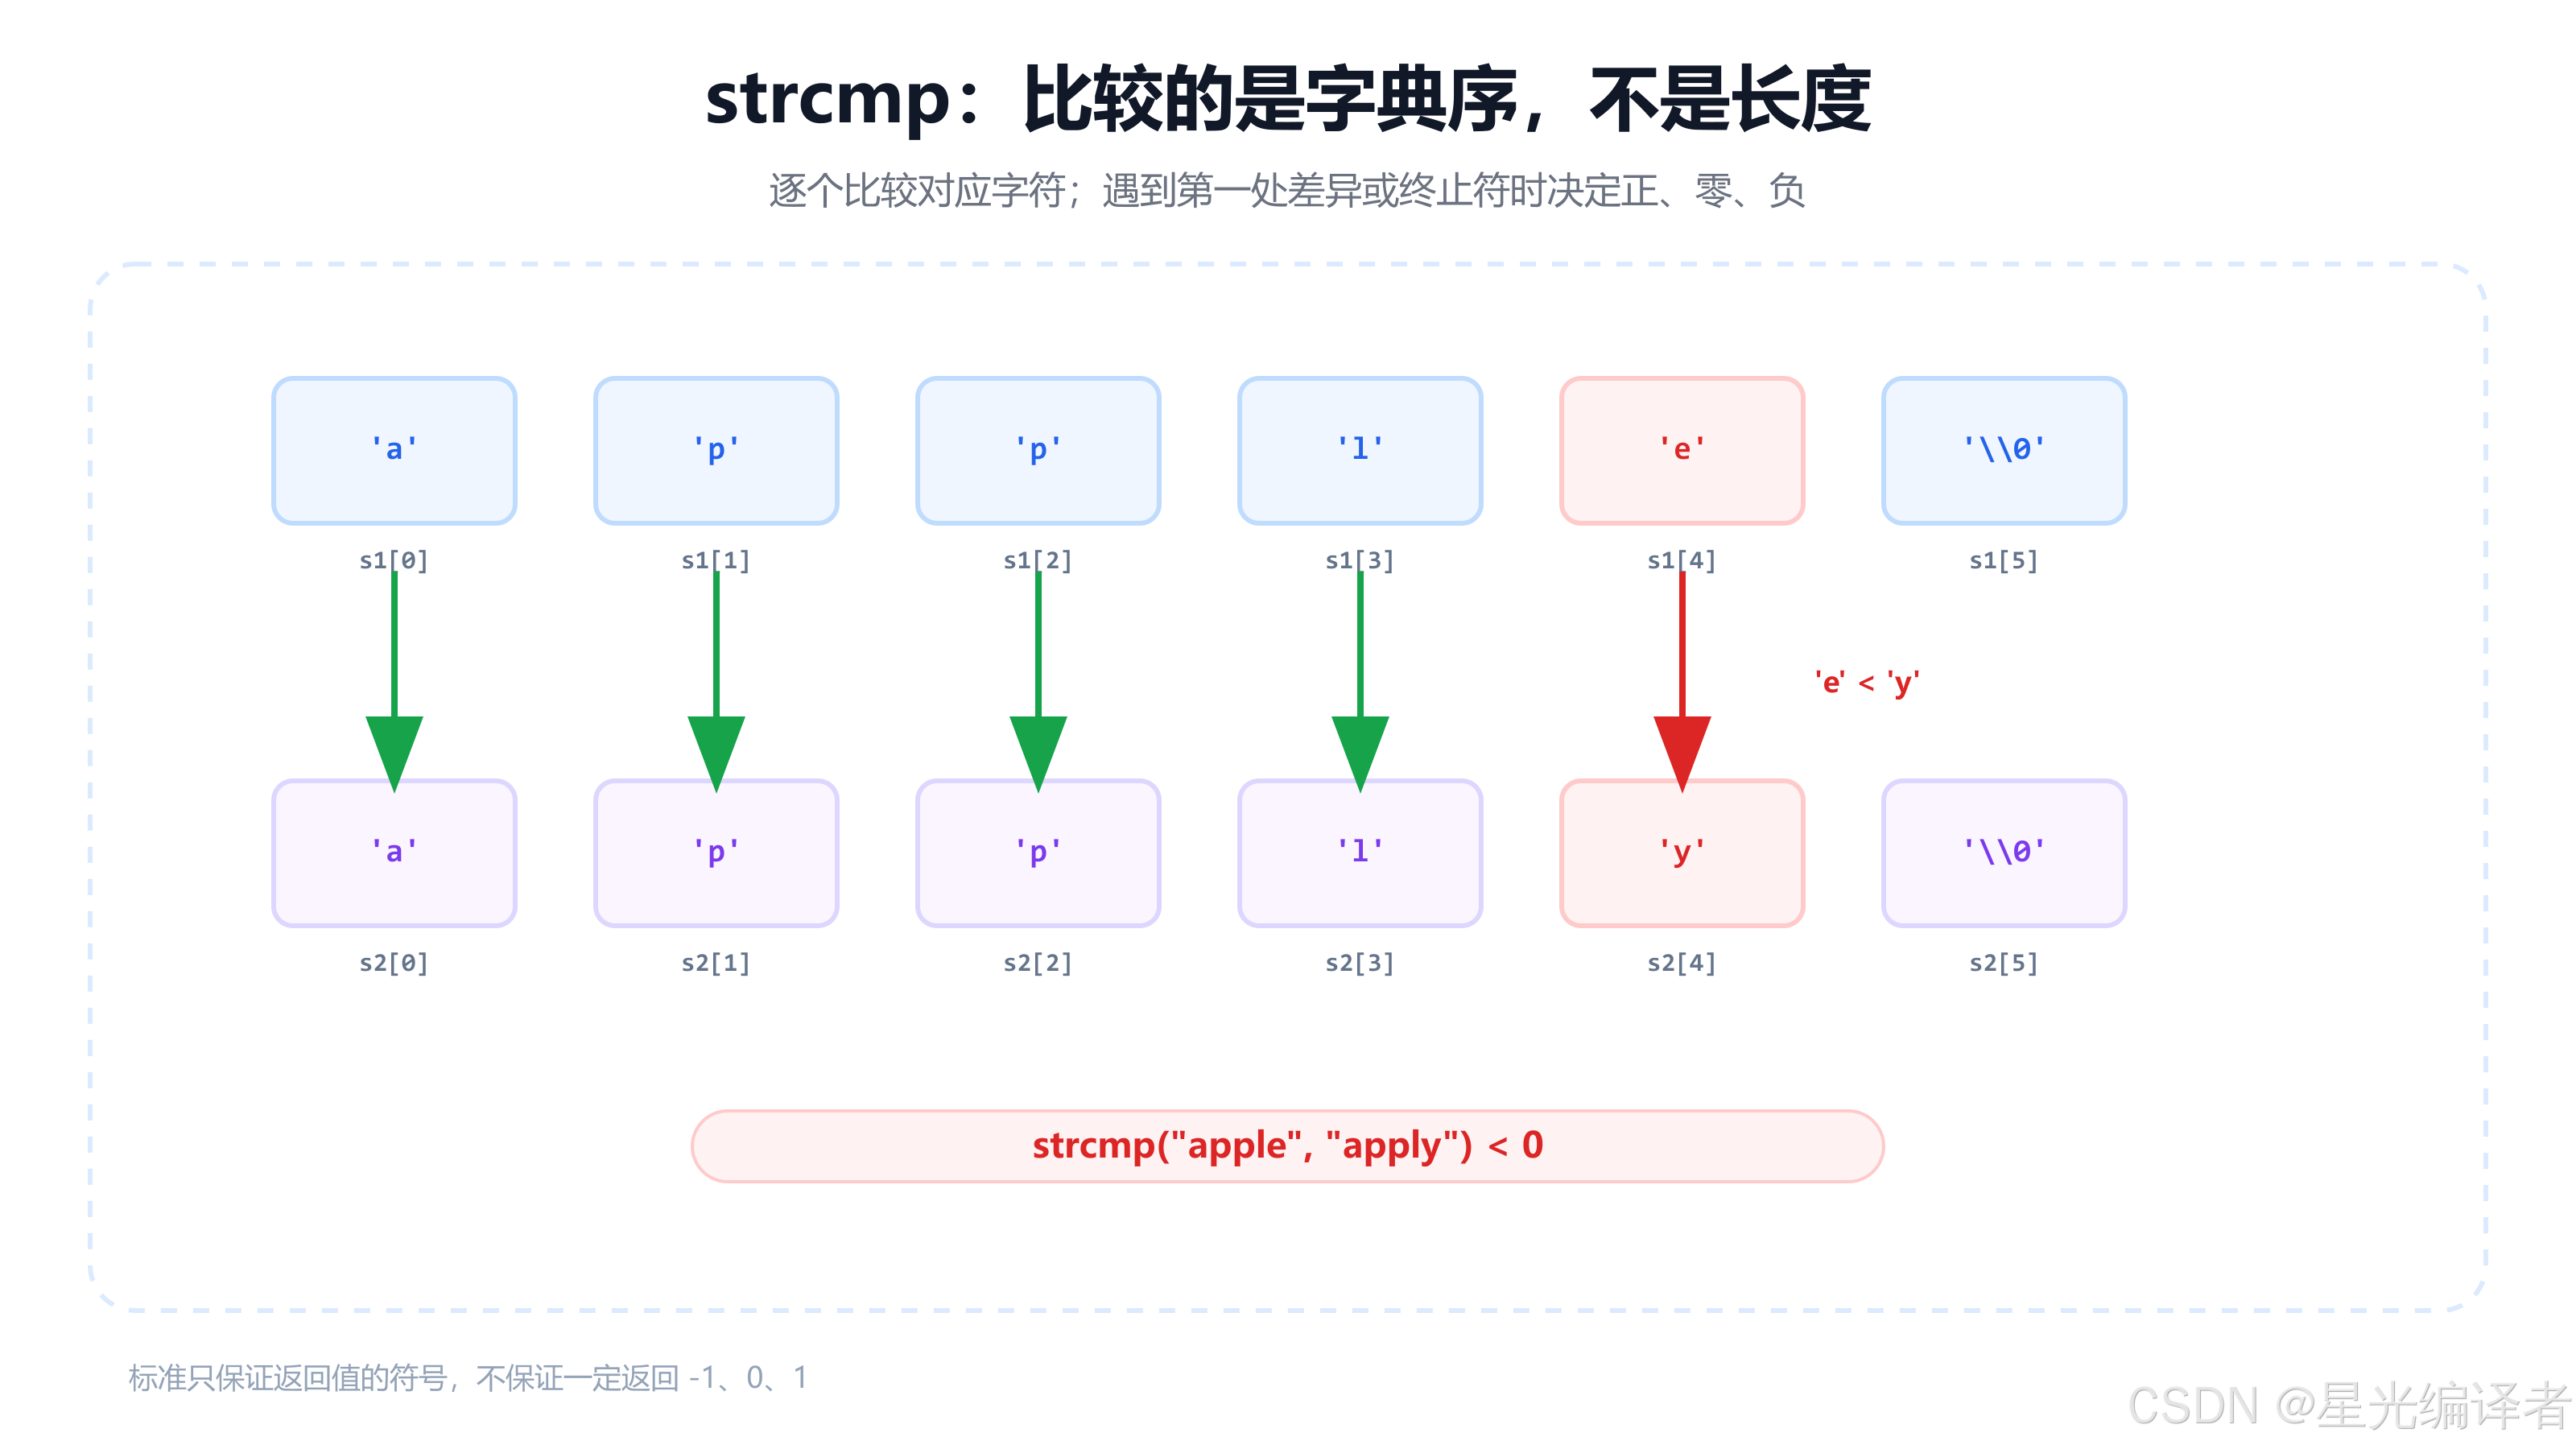
标准只保证返回值的符号:
| 结果 | 含义 |
|---|---|
< 0 |
str1 小于 str2 |
== 0 |
两条字符串相等 |
> 0 |
str1 大于 str2 |
不要假设小于必然返回 -1,大于必然返回 1。
c
if (strcmp("apple", "apply") < 0) {
    puts("apple comes first");
}
7.1 模拟实现 strcmp
c
#include <assert.h>

int my_strcmp(const char *str1, const char *str2)
{
    assert(str1 != NULL);
    assert(str2 != NULL);

    while (*str1 != '\0' && *str1 == *str2) {
        ++str1;
        ++str2;
    }

    return (unsigned char)*str1 - (unsigned char)*str2;
}
最后转换为 unsigned char,是为了按标准字符串比较的无符号字符值语义计算首个差异。判断字符串相等时直接检查结果是否为 0,而不是比较两个指针地址。
八、带 n 的三个函数:strncpy、strncat、strncmp
这三个函数都有一个 size_t n,但 n 的含义并不相同。把它们统称为"安全版函数"会制造新的误解。
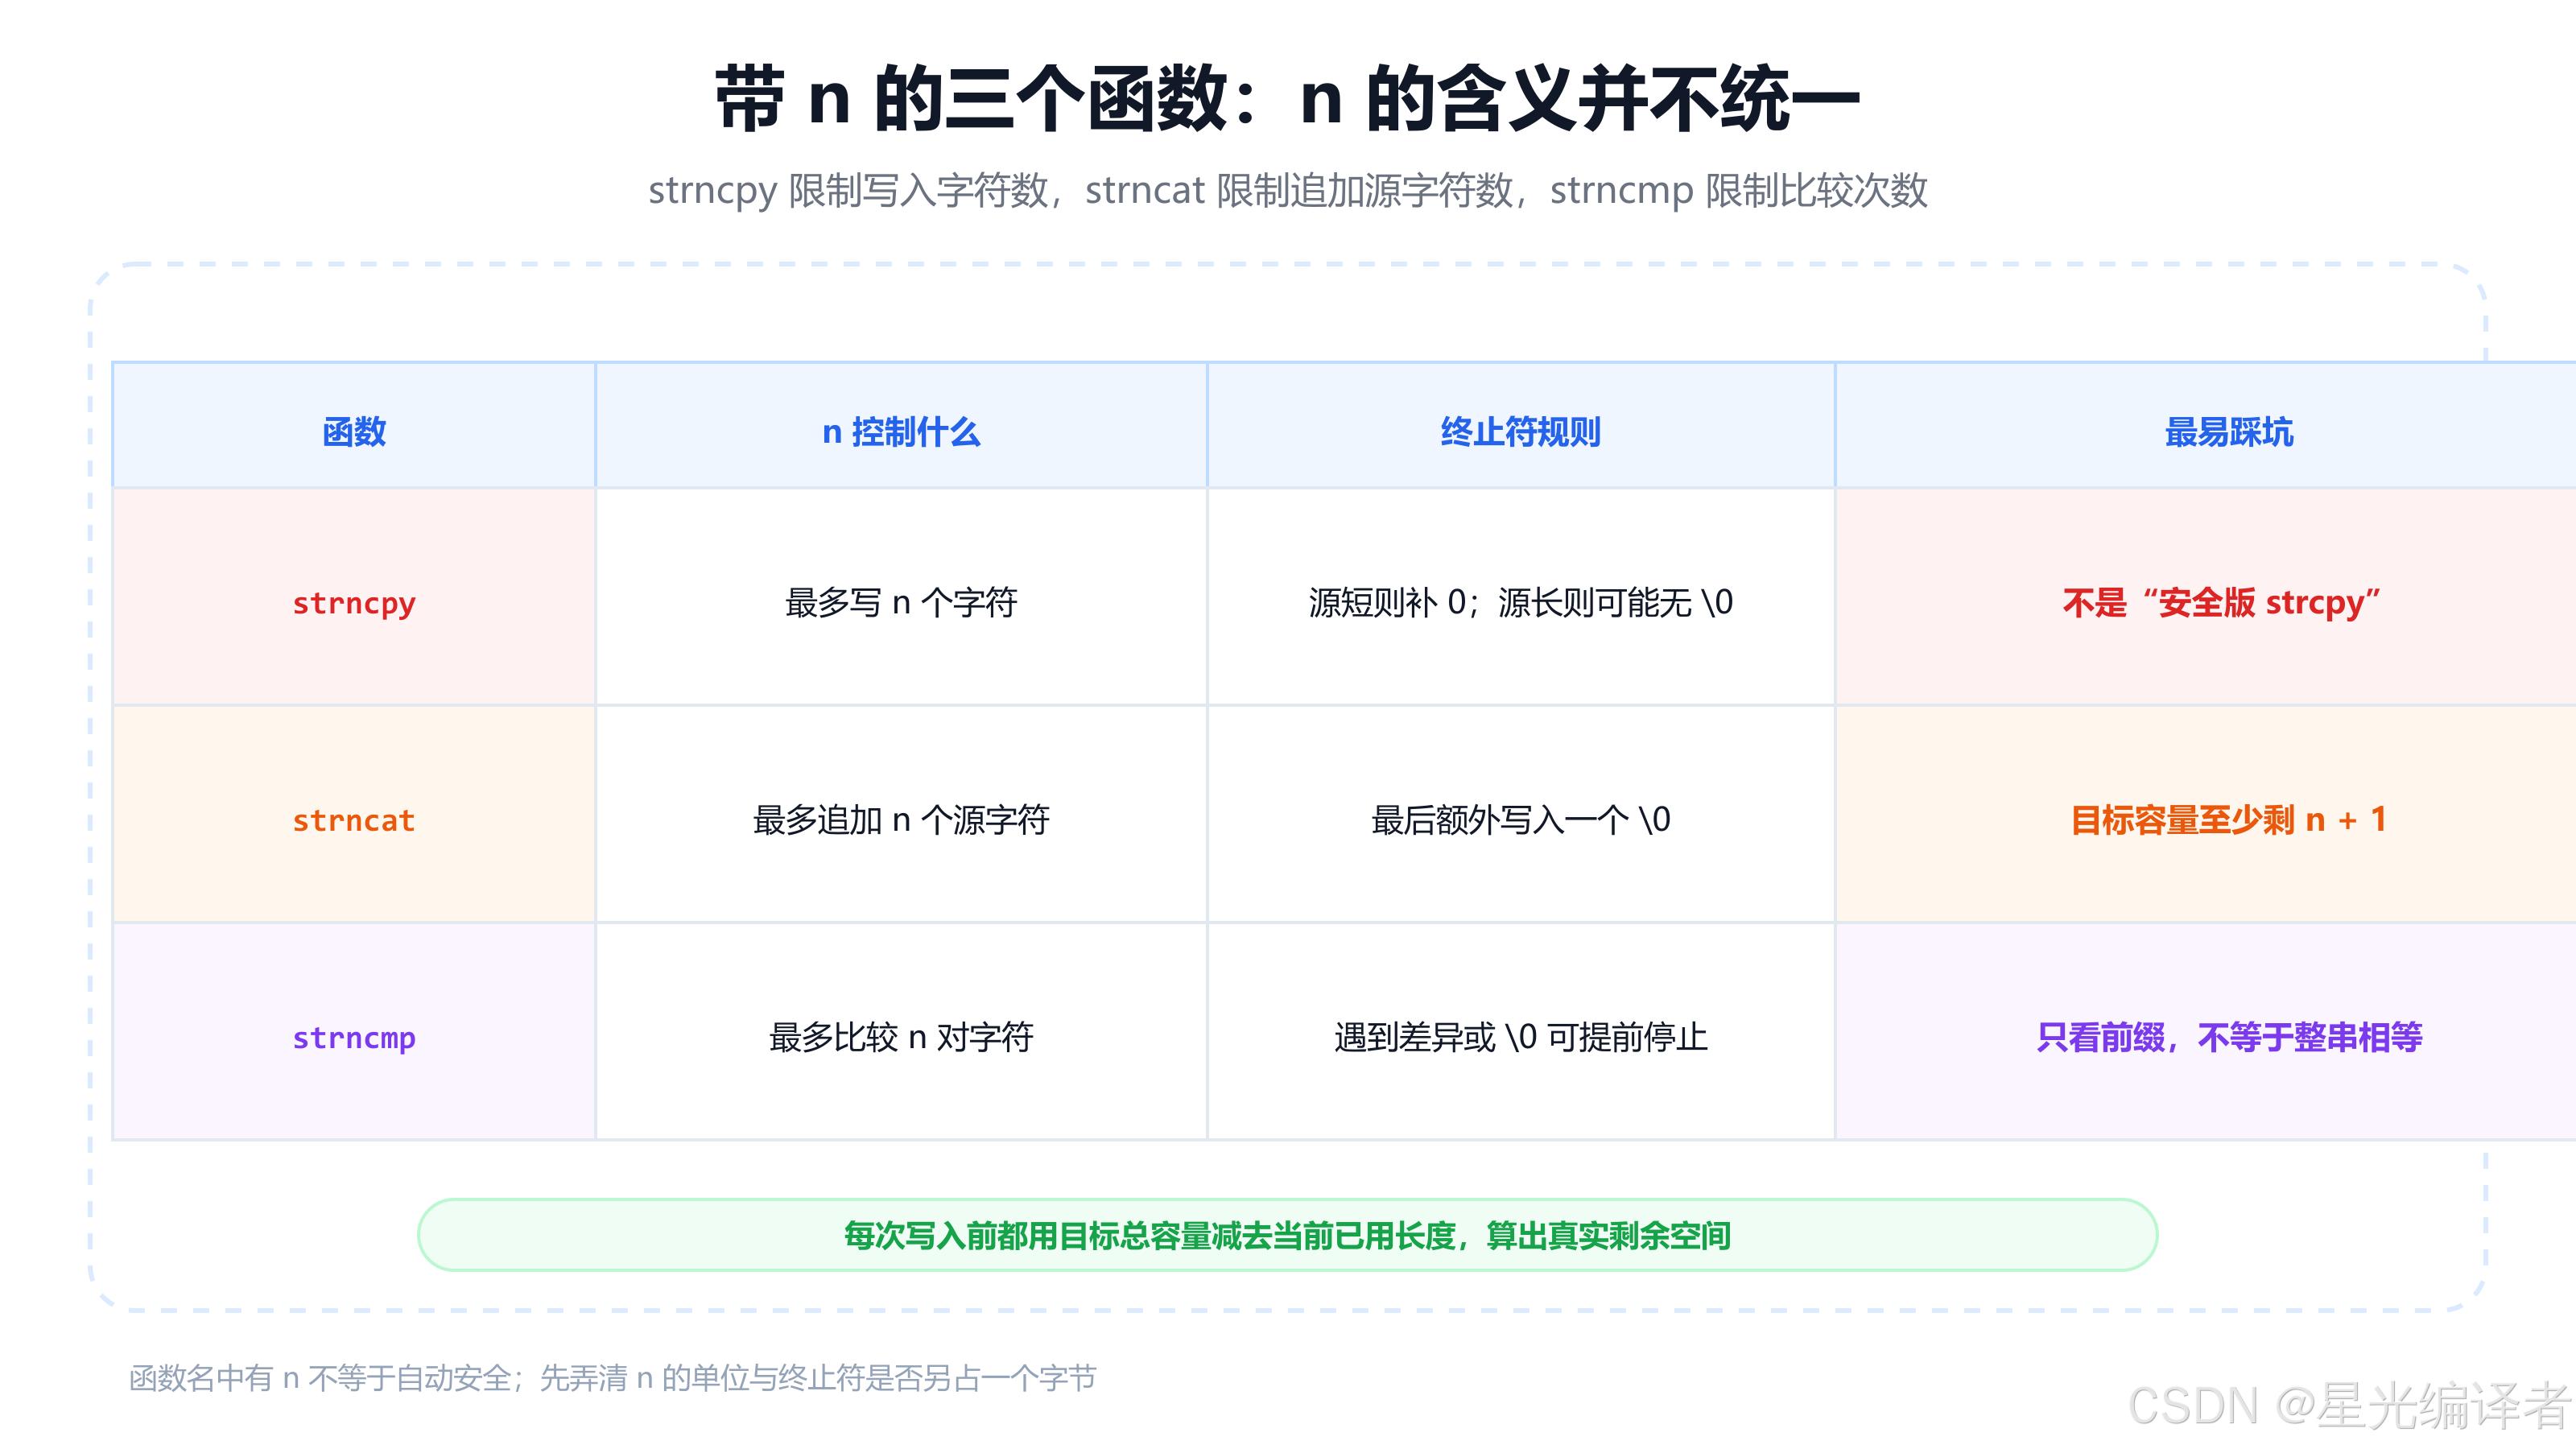
8.1 strncpy:最多写 n 个字符,但不保证总有终止符
原型:
c
char *strncpy(char *destination, const char *source, size_t n);规则分两种:
- 若
source长度小于n,复制终止符后继续用\0填充,直到一共写满n个字符; - 若
source长度大于或等于n,只写前n个字符,结果可能没有\0。
c
char buffer[5];

strncpy(buffer, "abcdef", sizeof buffer);
/* buffer 中是 a b c d e,没有终止符,不能直接当字符串输出 */
若目的是得到截断后仍可用的字符串,可以预留一个字节:
c
char buffer[5];

strncpy(buffer, "abcdef", sizeof buffer - 1);
buffer[sizeof buffer - 1] = '\0';
这段模式要求目标容量大于 0,而且可能产生截断;调用者仍需决定截断是否可接受。
8.2 strncat:n 限制追加的源字符数,终止符另写一个
原型:
c
char *strncat(char *destination, const char *source, size_t n);它最多追加 source 的前 n 个字符;若源串更短,则在源终止符处提前停止。无论追加多少字符,最终都会再向目标写一个 \0。
c
char text[20] = "To be ";

strncat(text, "or not to be", 6);
puts(text); /* To be or not */
目标所需容量至少为:
text
原目标长度 + min(n, 源字符串长度) + 1因此,n 不是目标数组容量。若把整个 sizeof destination 直接当作 n,往往会多算已有内容,造成溢出。
8.3 strncmp:最多比较 n 对字符
原型:
c
int strncmp(const char *str1, const char *str2, size_t n);它最多比较 n 个位置;若提前遇到差异或 \0,立即结束。返回值同样只看符号。
c
strncmp("version-1", "version-2", 8); /* 0,前 8 个字符相同 */
strcmp("version-1", "version-2");     /* 小于 0 */
前缀相同不代表整串相同。若业务要求完整相等,使用 strcmp,或在限长比较之外继续验证长度与终止条件。
九、strstr:在主串中寻找子串
原型:
c
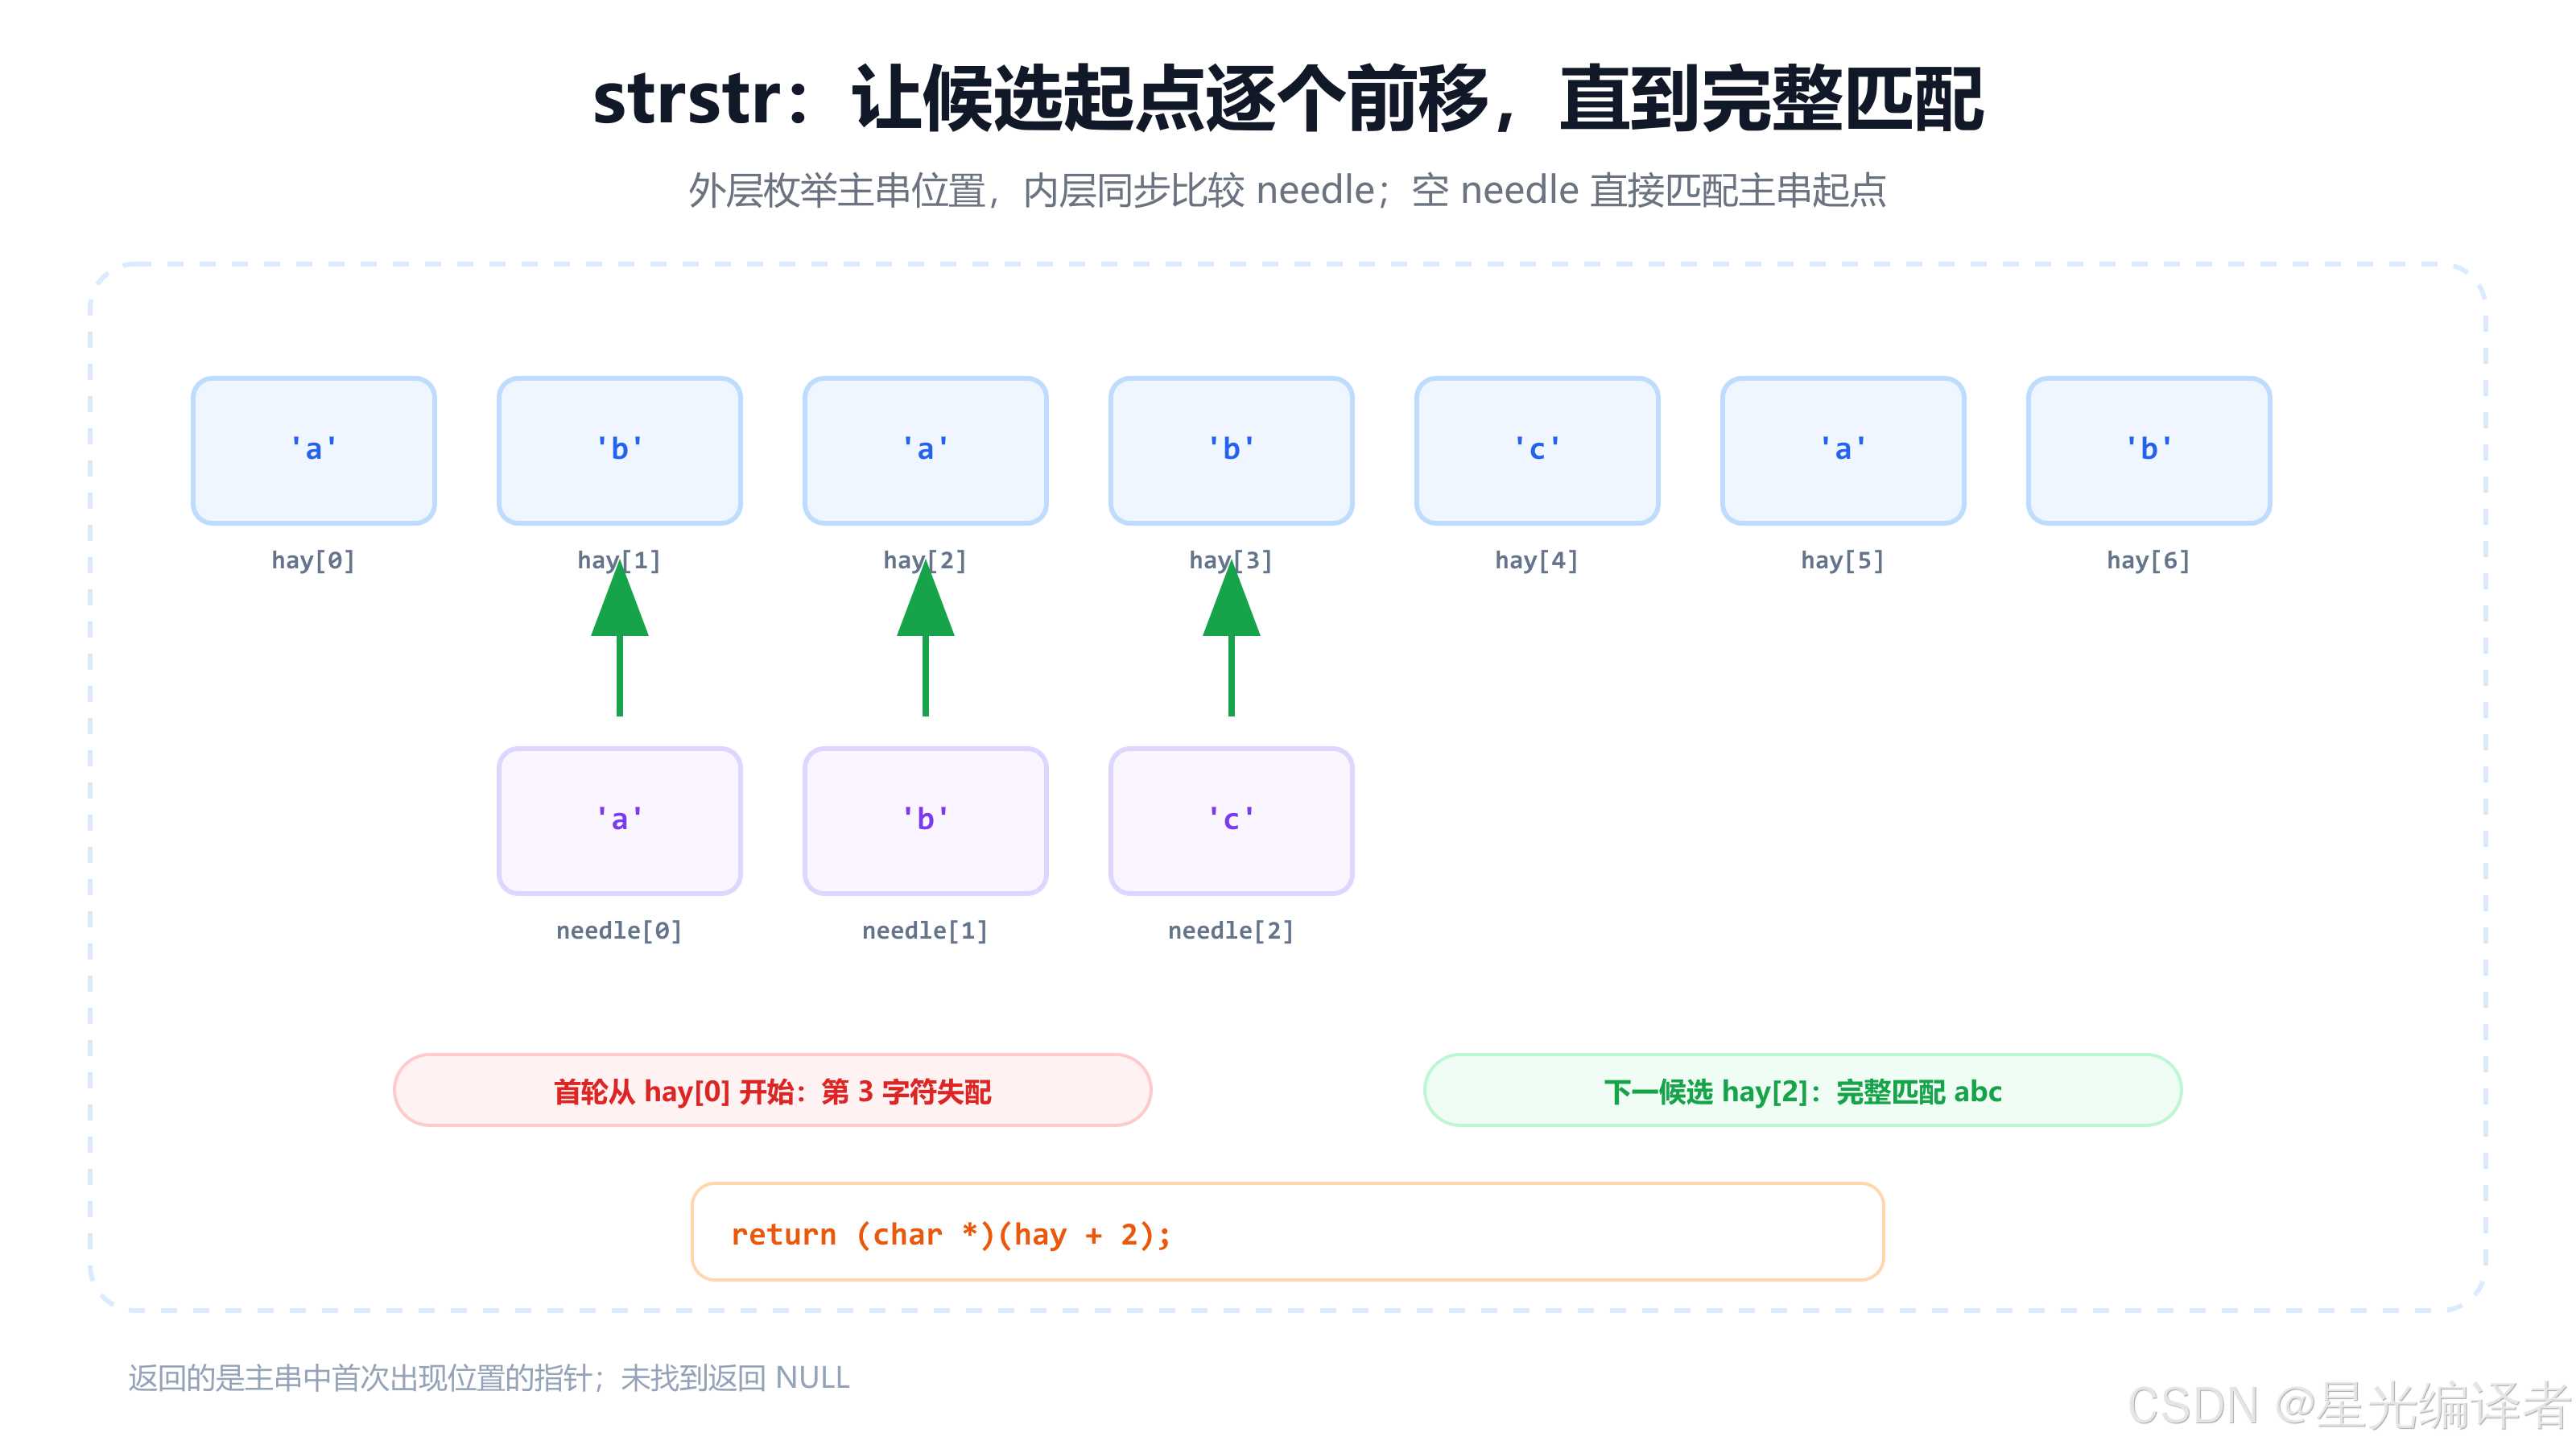
char *strstr(const char *haystack, const char *needle);strstr 返回 needle 在 haystack 中第一次出现位置的指针;找不到返回 NULL。若 needle 是空字符串,则返回 haystack 起始位置。
c
#include <stdio.h>
#include <string.h>

int main(void)
{
    char text[] = "This is a simple string";
    char *position = strstr(text, "simple");

    if (position != NULL) {
        printf("offset=%td, suffix=%s\n", position - text, position);
    }
    return 0;
}
9.1 朴素模拟实现
c
#include <assert.h>
#include <stddef.h>

const char *my_strstr(const char *haystack, const char *needle)
{
    assert(haystack != NULL);
    assert(needle != NULL);

    if (*needle == '\0') {
        return haystack;
    }

    for (const char *candidate = haystack;
         *candidate != '\0';
         ++candidate) {
        const char *h = candidate;
        const char *n = needle;

        while (*h != '\0' && *n != '\0' && *h == *n) {
            ++h;
            ++n;
        }

        if (*n == '\0') {
            return candidate;
        }
    }
    return NULL;
}
算法有两层:外层把候选起点逐个右移,内层从候选位置开始与子串同步比较。若子串走到 \0,说明完整匹配;若主串先结束或字符不同,则换下一个候选起点。
这个朴素算法在重复字符很多时会重复比较,最坏复杂度可达到 O(nm)。学习标准库模拟实现时它足够直观;更大规模的文本搜索可考虑 KMP 等算法。
十、strtok:会改写源字符串的分词器
原型:
c
char *strtok(char *str, const char *delimiters);delimiters 不是一个完整分隔串,而是分隔字符集合 。例如 ",;" 表示逗号或分号任意一个都可作为分隔符。
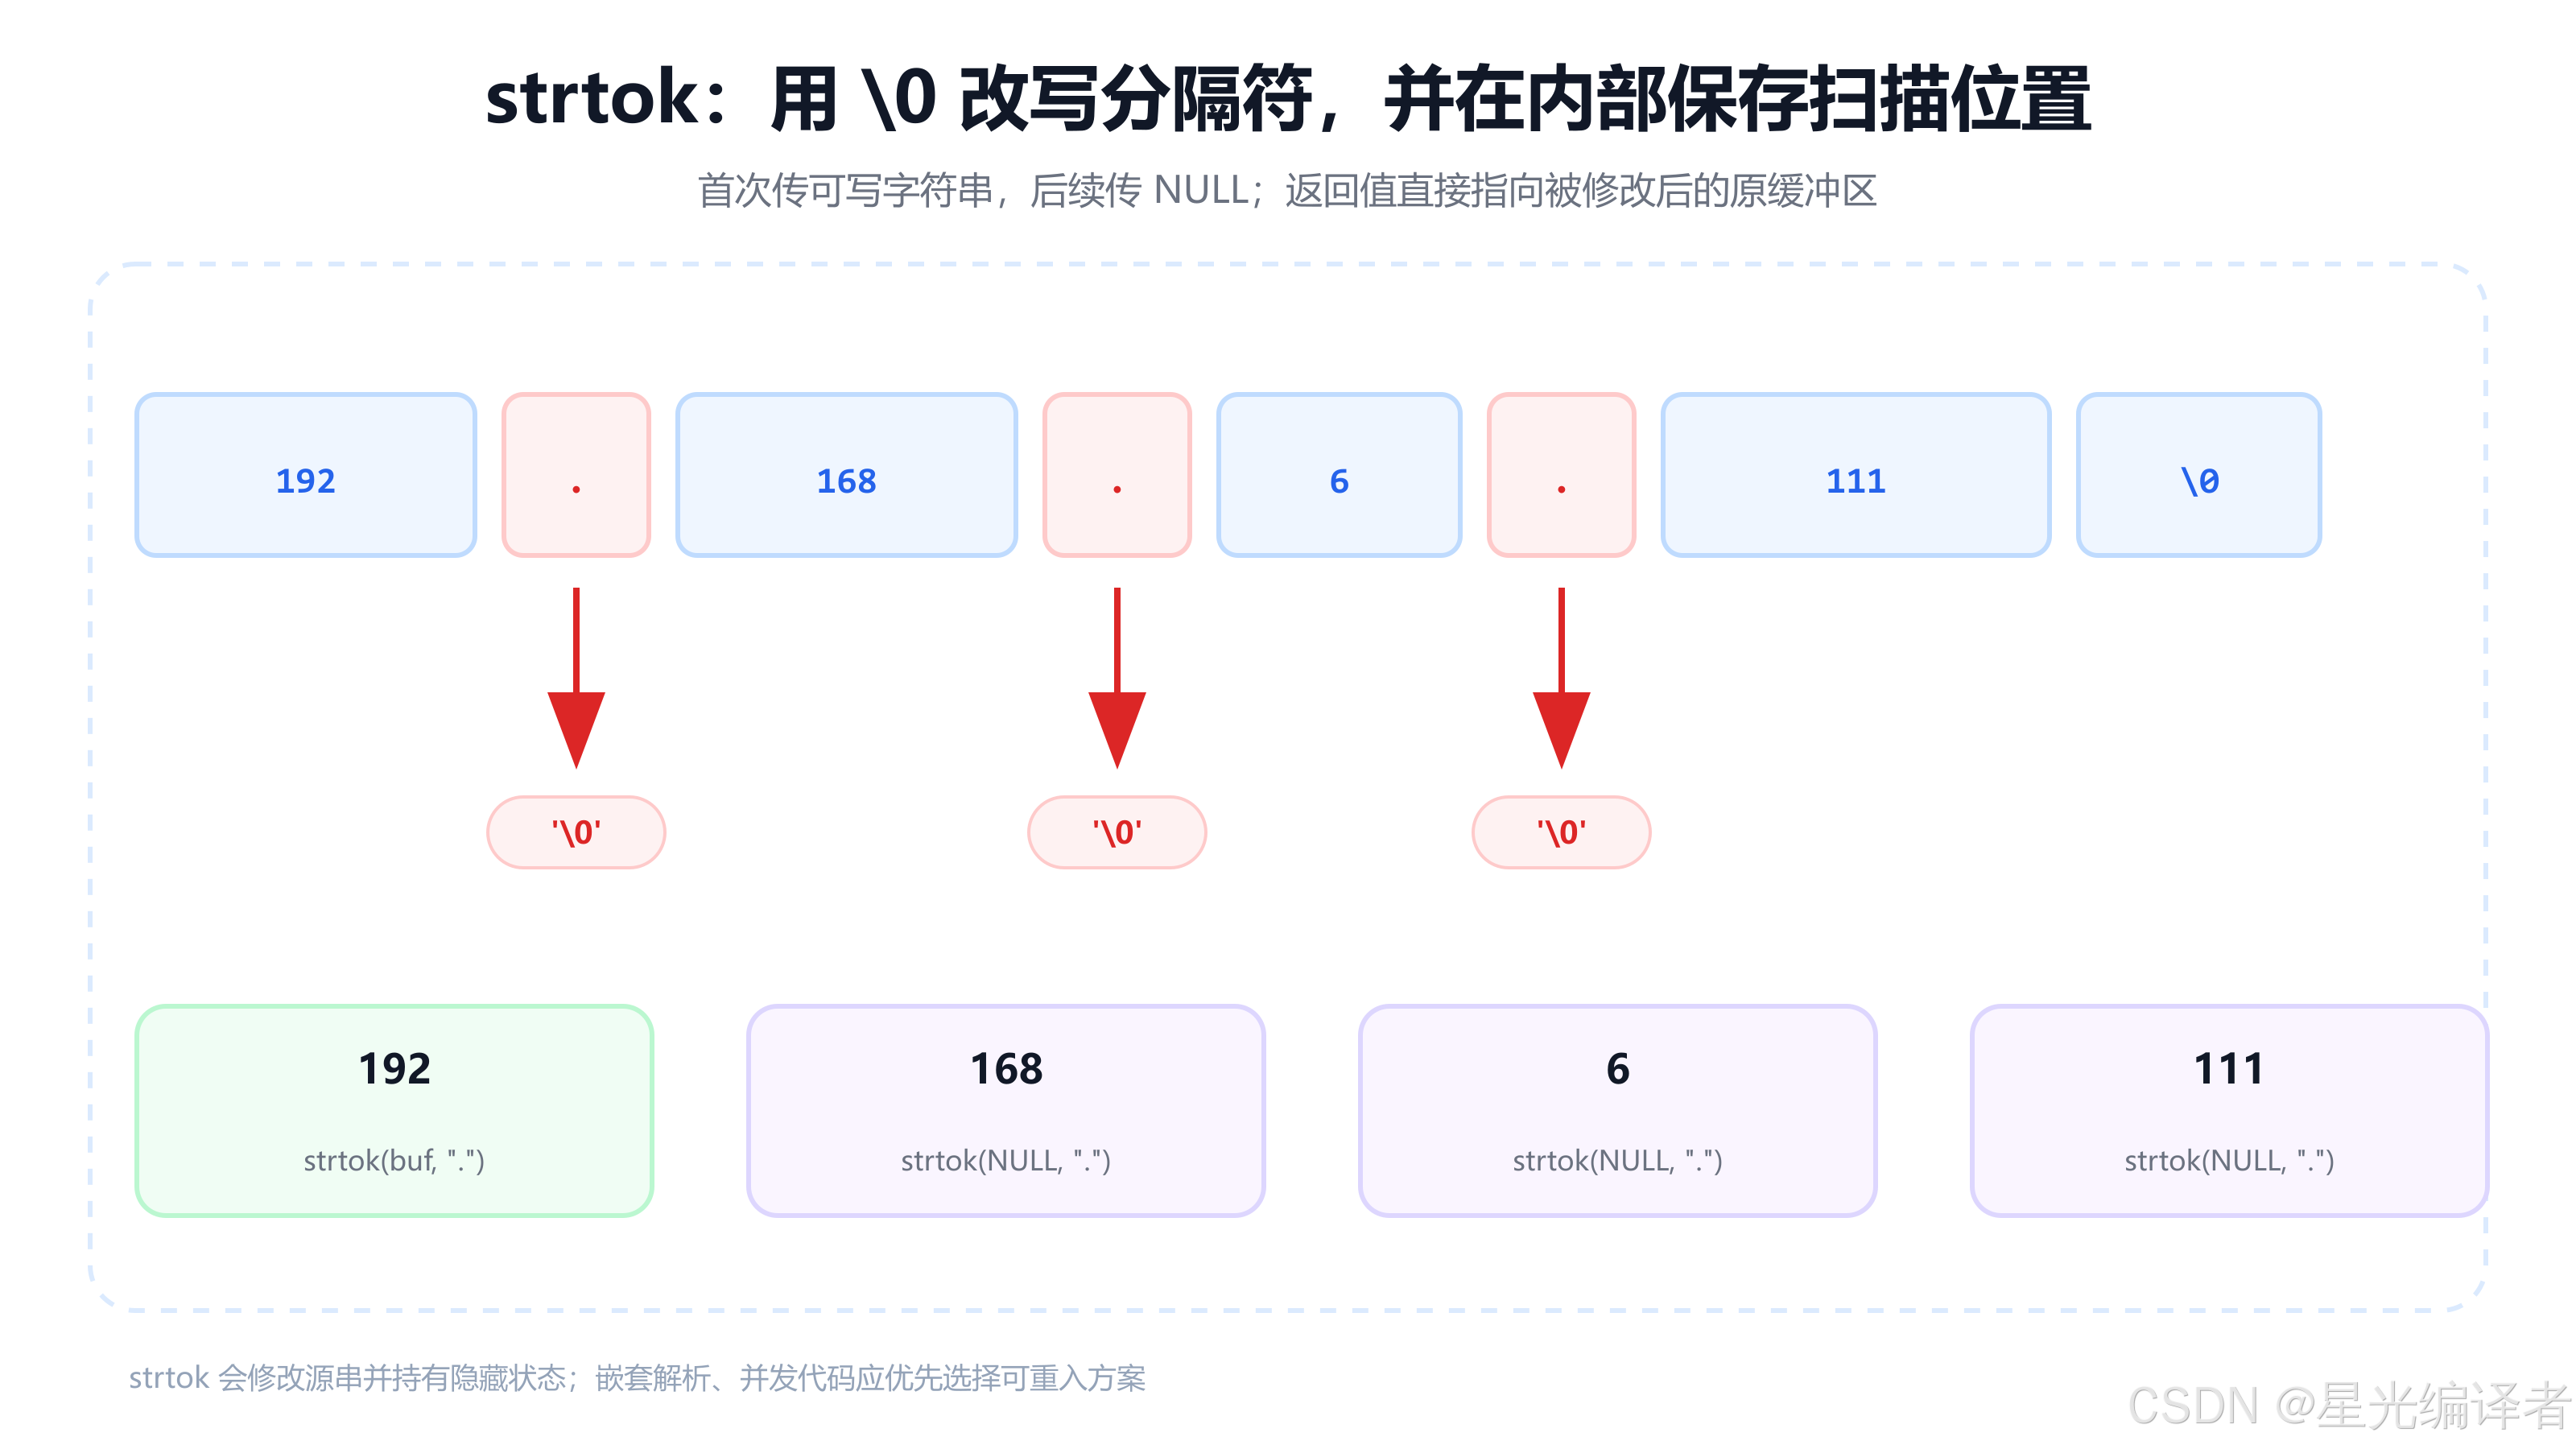
strtok 的工作方式是:
- 首次调用传入可写字符串;
- 跳过开头连续出现的分隔符;
- 找到一个标记,并把标记后的分隔符改写为
\0; - 返回指向标记起点的指针,同时保存下一次扫描位置;
- 后续调用把第一个参数传为
NULL,继续同一字符串。
c
#include <stdio.h>
#include <string.h>

int main(void)
{
    char address[] = "192.168.6.111";

    for (char *token = strtok(address, ".");
         token != NULL;
         token = strtok(NULL, ".")) {
        puts(token);
    }
    return 0;
}
输出:
text
192
168
6
111
10.1 三个必须记住的副作用
第一,strtok 会修改输入,所以不能传字符串字面量:
c
strtok("a,b,c", ","); /* 错误:字面量不可写 */第二,返回的标记并不是新分配的字符串,它直接位于原缓冲区中。原数组失效后,标记指针也失效。
第三,strtok 保存内部扫描状态。两组分词过程交错进行时,后一组调用会覆盖前一组状态;并发场景也不宜依赖这种隐式状态。POSIX 环境可了解 strtok_r,支持相应接口的实现可了解 strtok_s,追求跨平台时也可以编写显式保存当前位置的解析器。
十一、strerror、errno 与 perror:读懂系统错误
许多库函数失败时会通过全局宏 errno 提供错误码。strerror 把错误码转换为人可读文字:
c
char *strerror(int error_number);perror 则直接向标准错误流输出"自定义前缀 + 冒号 + 当前 errno 对应消息"。
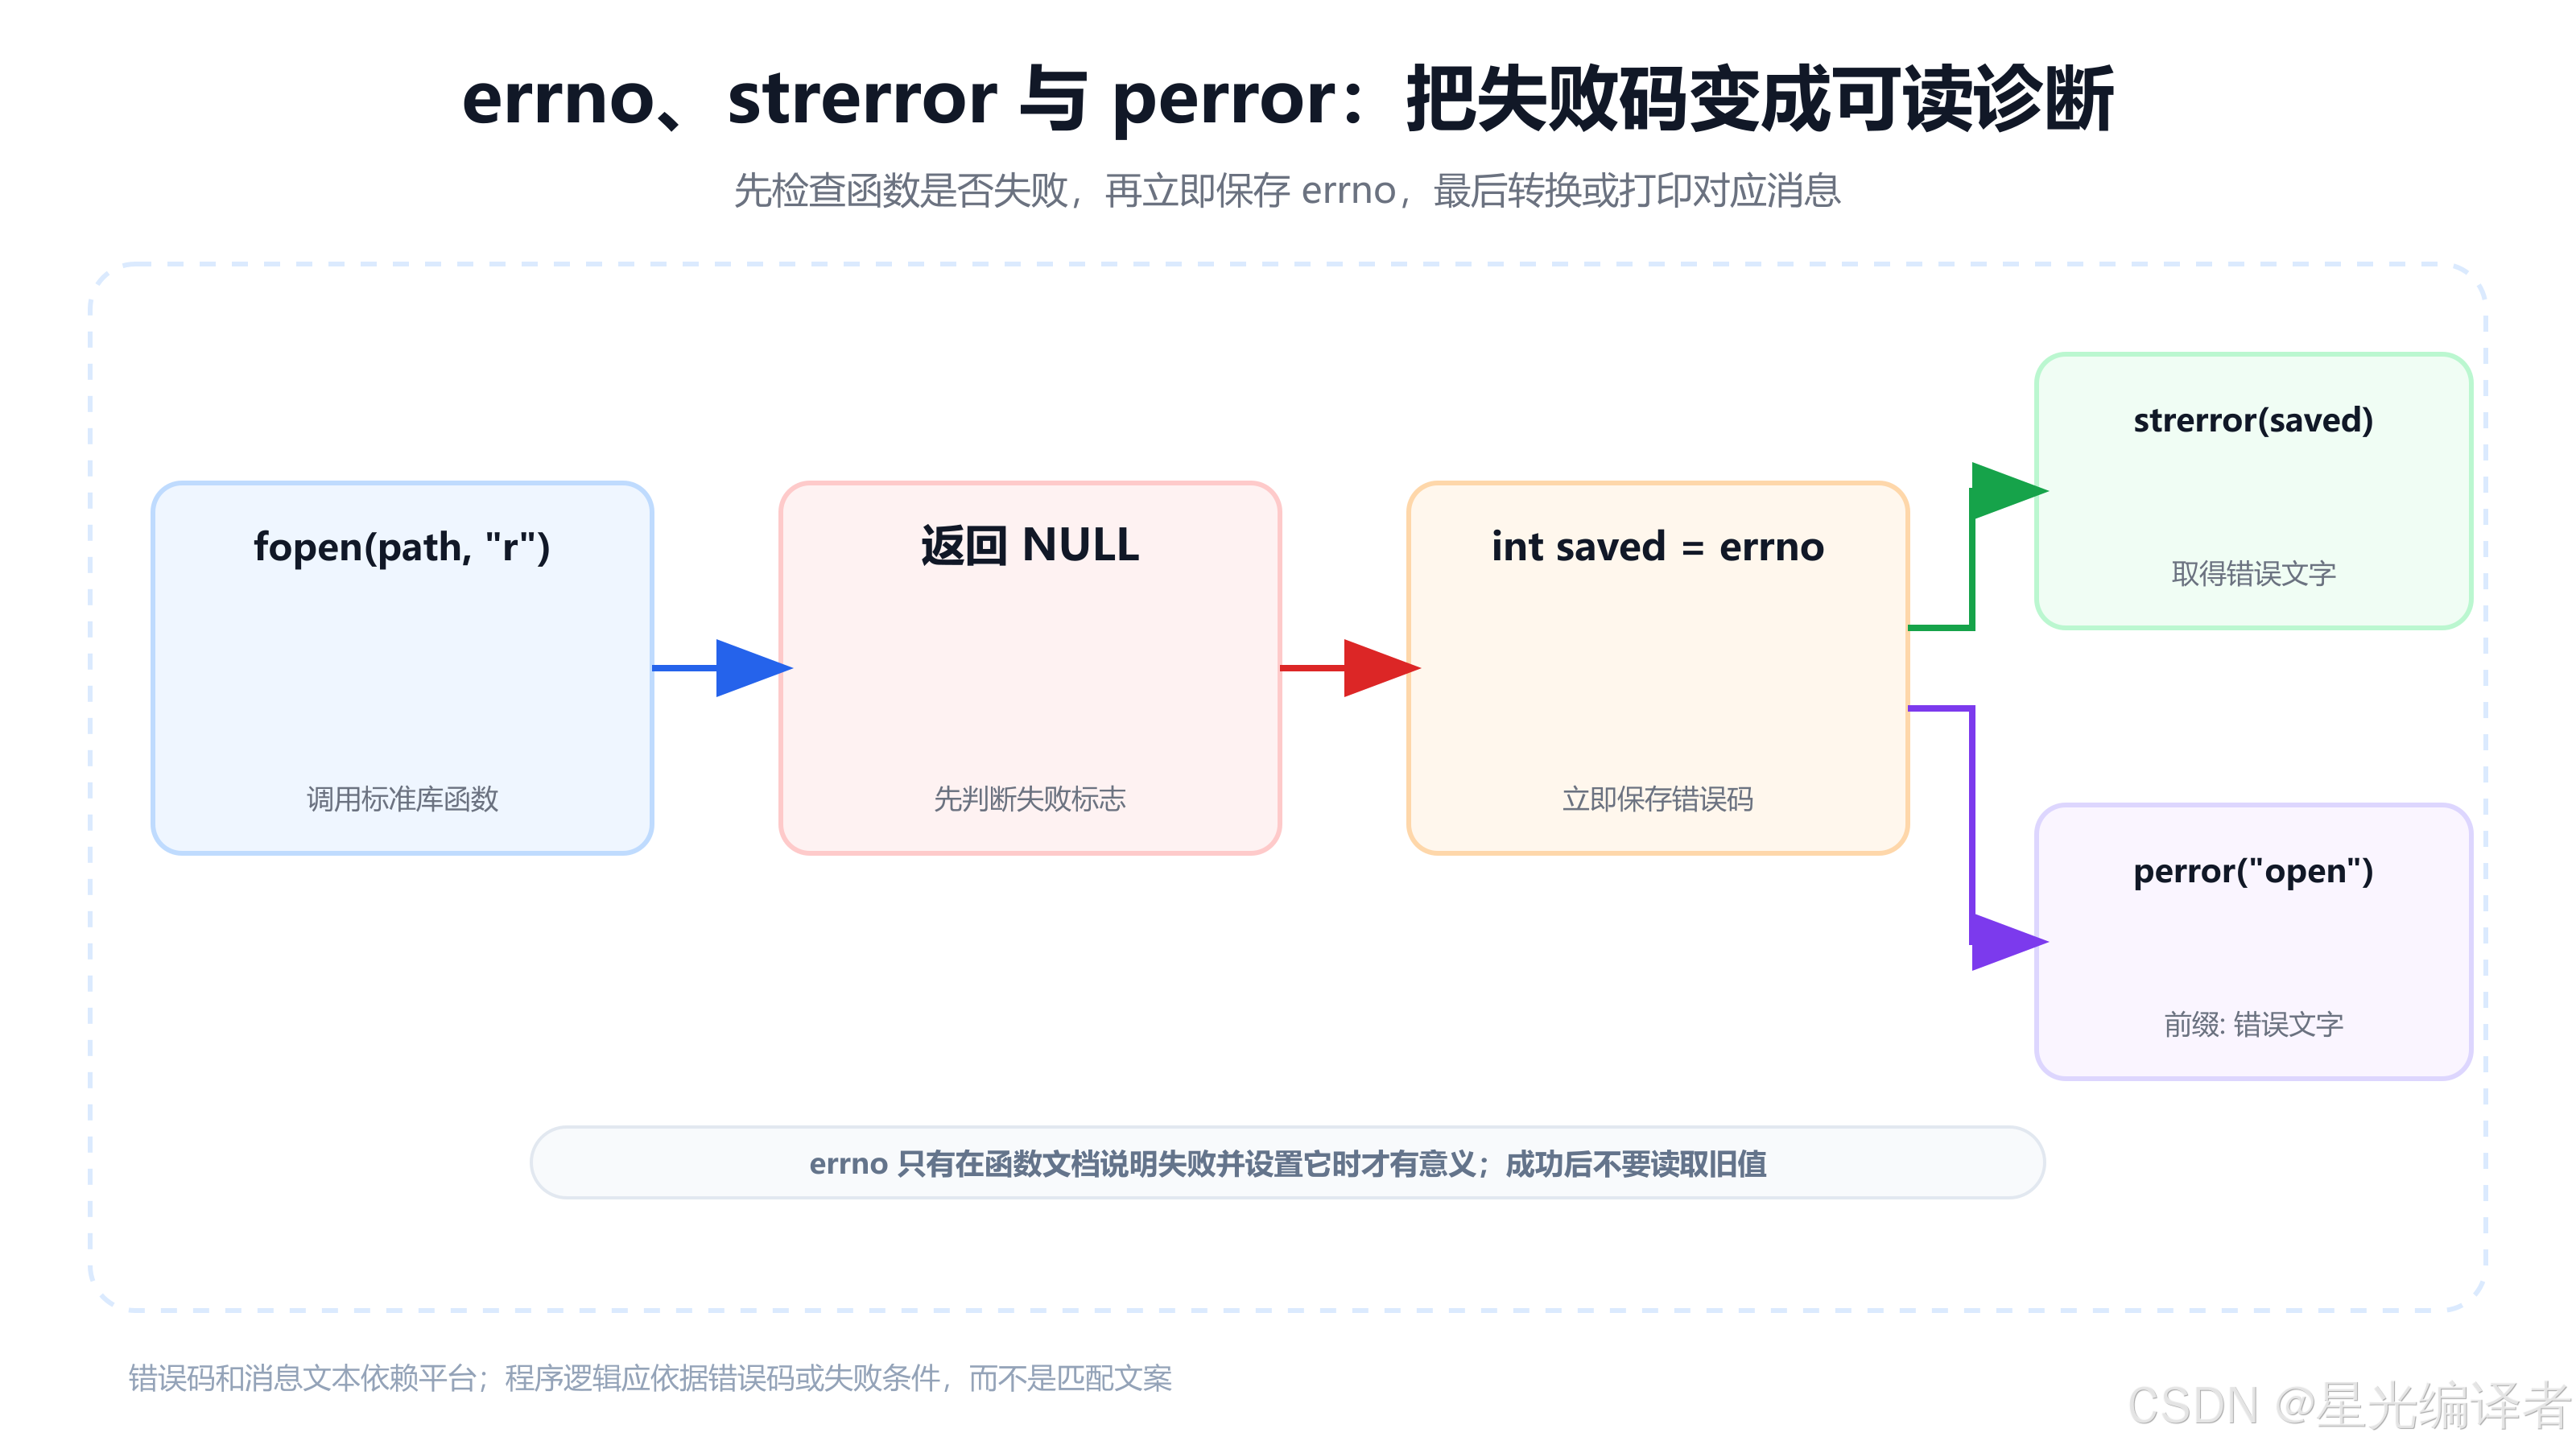
11.1 正确顺序:先判断失败,再保存 errno
c
#include <errno.h>
#include <stdio.h>
#include <string.h>

int main(void)
{
    FILE *file = fopen("unexist.ent", "r");

    if (file == NULL) {
        int saved_errno = errno;
        fprintf(stderr, "open failed: %s\n", strerror(saved_errno));
        return 1;
    }

    fclose(file);
    return 0;
}
为什么要尽快保存?因为后续库调用也可能改变 errno。先把错误码复制到普通变量,再做格式化与日志输出,能避免诊断信息与原始失败脱节。
不要在函数成功后读取 errno 判断"之前有没有错误"。errno 不会在每次成功调用后自动清零,只有当某个函数的文档说明失败并设置它,而且返回值确实表示失败时,该值才有意义。
11.2 perror 的简洁写法
c
#include <stdio.h>

int main(void)
{
    FILE *file = fopen("unexist.ent", "r");

    if (file == NULL) {
        perror("open unexist.ent");
        return 1;
    }

    fclose(file);
    return 0;
}
典型输出类似:
text
open unexist.ent: No such file or directory错误码数字、消息文字和语言都可能随系统与 C 库实现变化。程序逻辑应依据函数返回值和规范化错误码,不能通过匹配某一句英文错误文本来决定流程。
十二、统一检查清单与高频问答
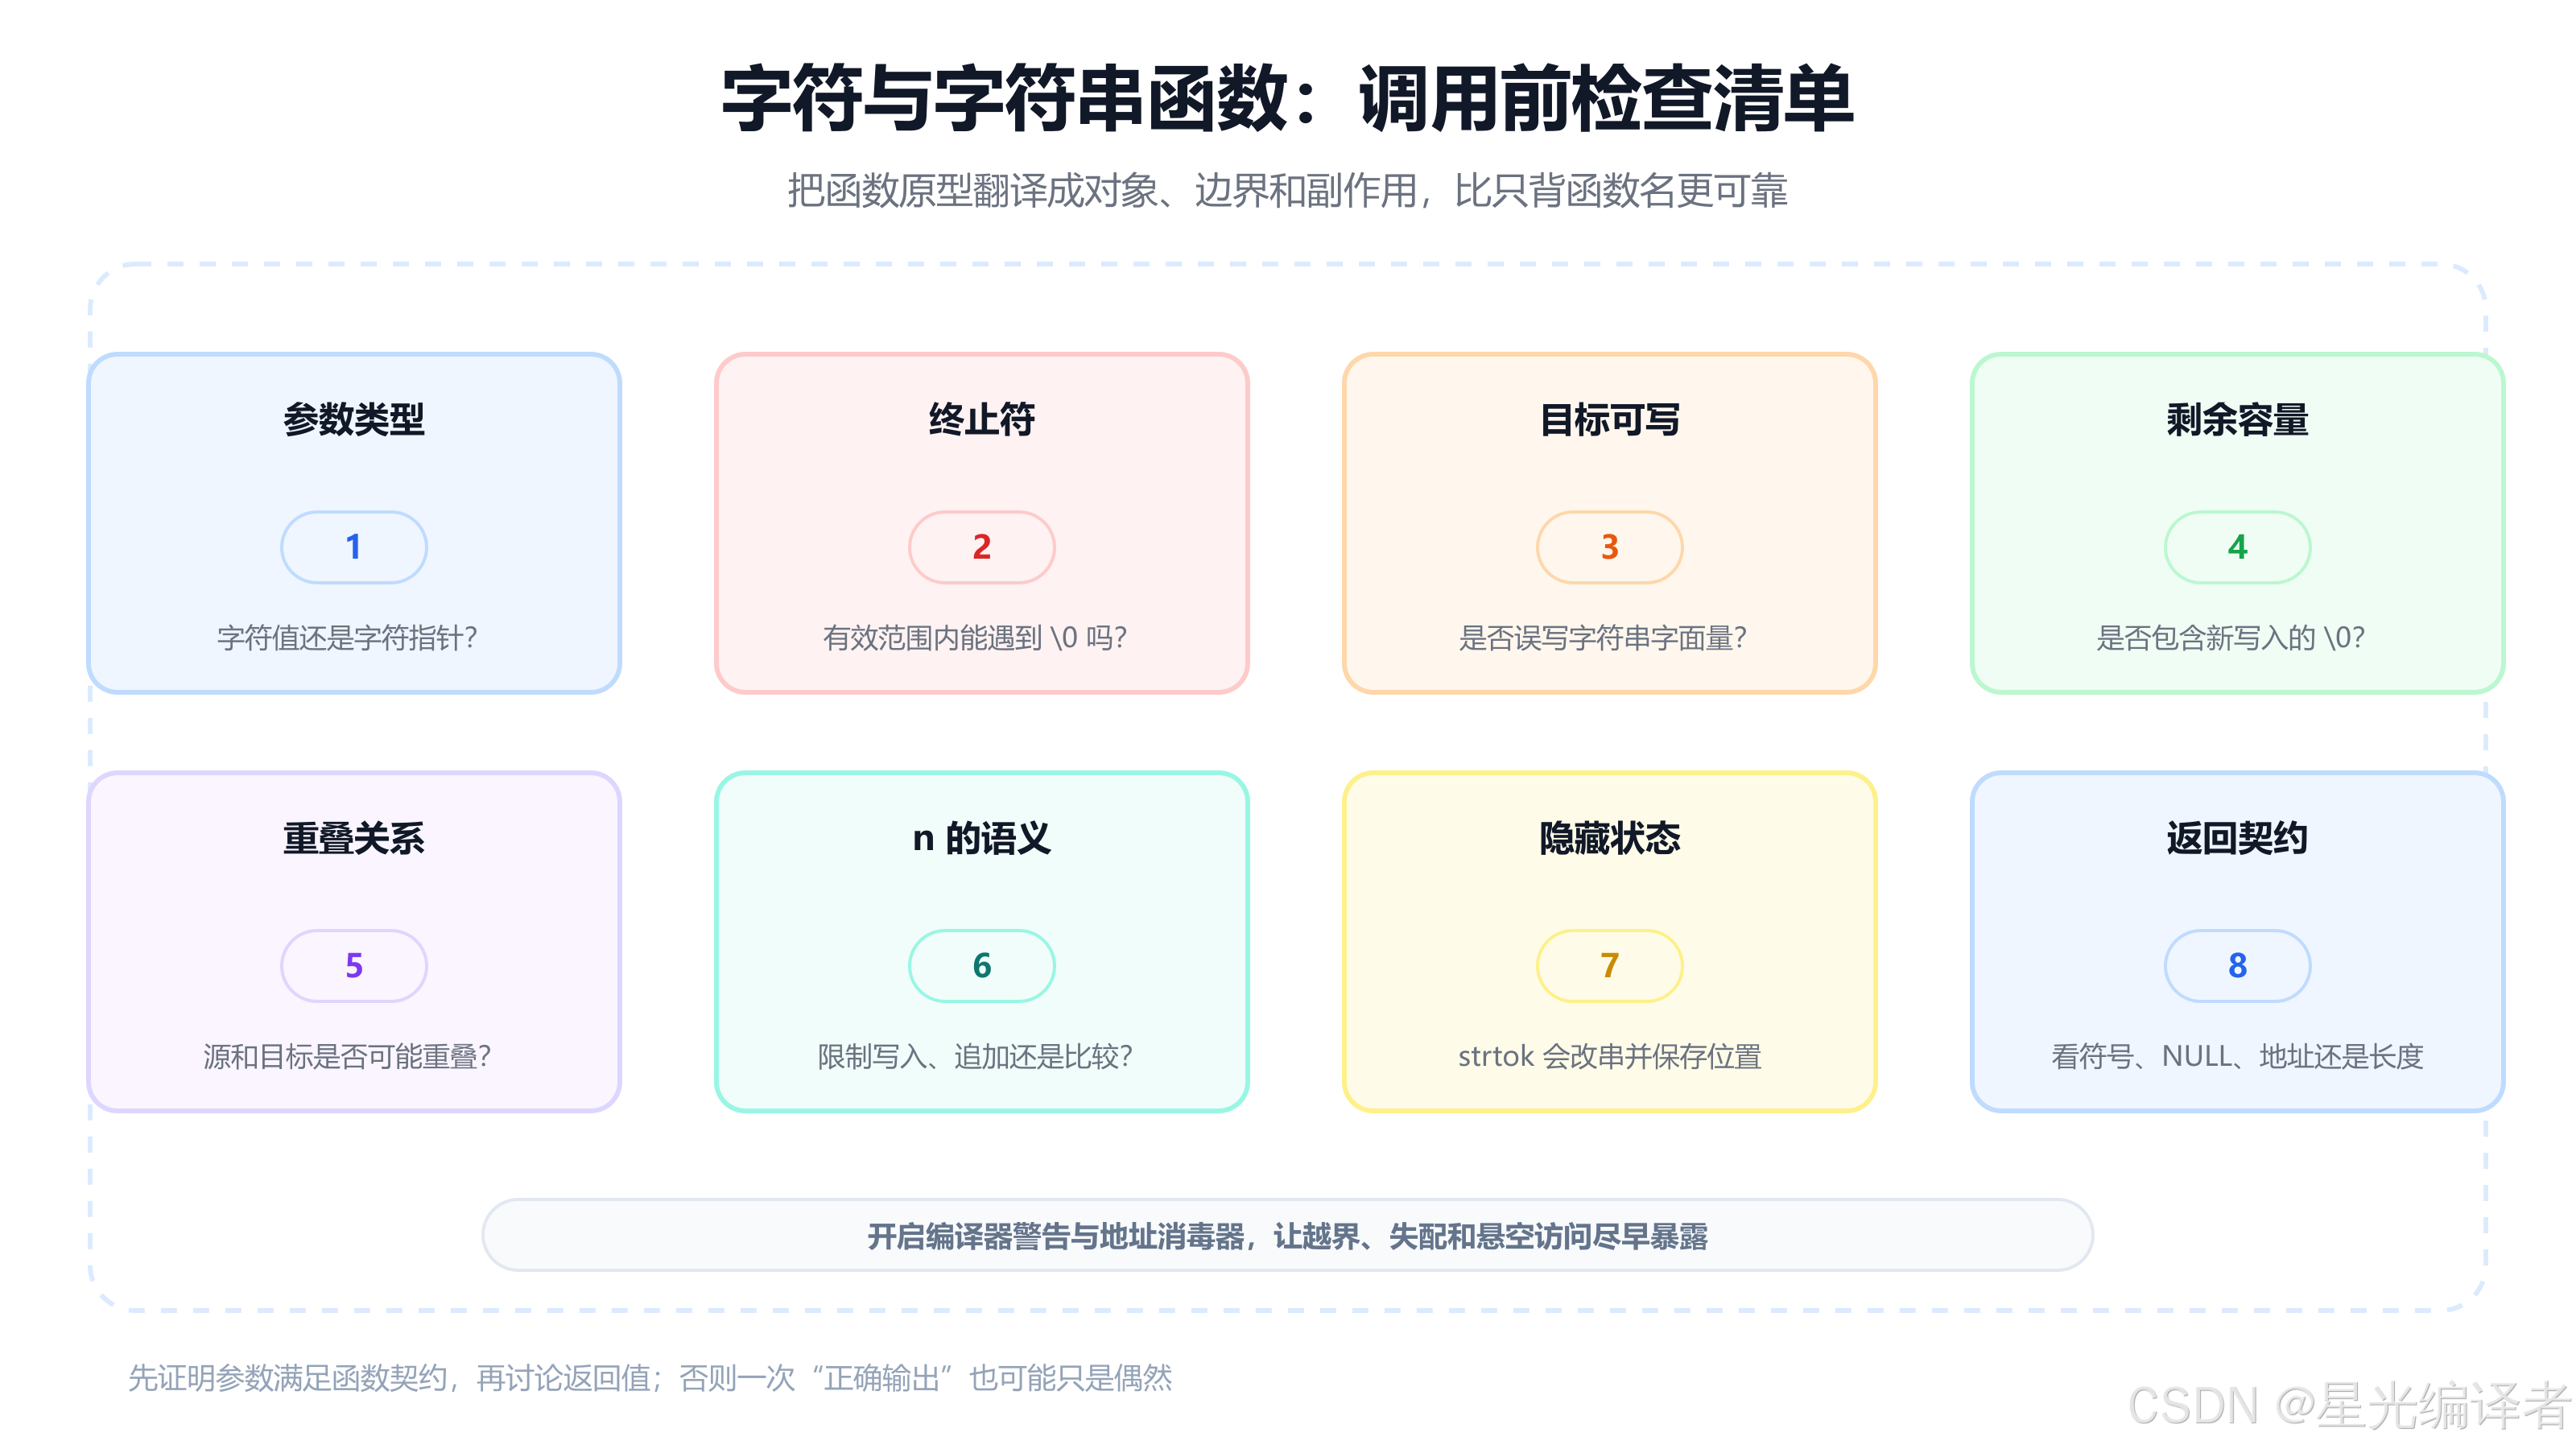
12.1 调用前的八步检查
- 参数类型:传入的是字符值、字符地址,还是数组首地址?
- 终止符 :读字符串的函数能否在有效范围内遇到
\0? - 目标可写:目标是字符数组,还是不可修改的字符串字面量?
- 剩余容量 :计算时是否包含最终
\0,是否扣除了已有内容? - 重叠关系:源与目标是否重叠,当前函数允许重叠吗?
n的语义:它限制复制、追加、比较,还是表示整个缓冲区容量?- 隐藏状态:函数是否修改输入或保存后续调用位置?
- 返回契约 :返回长度、地址、
NULL,还是只看正负号的比较结果?
12.2 高频问答
Q1:字符数组一定是字符串吗?
不一定。只有在有效对象范围内存在可达的 \0,才能把相应字符序列作为 C 字符串交给 strlen、strcpy、strcmp 等函数。
Q2:为什么字符串函数普遍容易越界?
传统接口通常只接收指针,没有同时携带数组容量。函数可以沿 \0 判断字符串结束,却无法知道目标数组还剩多少空间。
Q3:strncpy 是安全版 strcpy 吗?
不是。它确实限制最多写 n 个字符,但源串长度大于等于 n 时不会自动补终止符;源串很短时又会把剩余位置全部填零。是否适合取决于具体需求。
Q4:strcmp 为什么不能写成 == -1?
标准只规定负、零、正三种关系,没有规定具体数值。正确判断方式是 < 0、== 0、> 0。
Q5:strtok 为什么要传 NULL?
第一次调用已经保存了当前缓冲区中的扫描位置。后续传 NULL 表示继续该状态,而不是开始解析新字符串。
Q6:errno 是否需要每次先清零?
多数"返回值明确表示失败"的接口不需要先清零,只需在失败分支立即读取。少数接口的返回值本身可能与正常结果重合,这时应按该接口文档要求先把 errno 设为 0 再调用。
Q7:assert 能防止字符串函数越界吗?
不能。assert(pointer != NULL) 只能排除空指针,并不知道指针后有多少有效字节。容量必须由接口设计或调用上下文另外保证。
Q8:什么时候应该使用 memmove?
当任务本质是已知字节数的数据搬运,并且源与目标可能重叠时,memmove 才是对应工具。它不寻找 \0;下一讲会系统讨论内存函数。
12.3 动手练习
- 编写函数,把字符串中的字母转为大写,数字、空格和标点保持原样,并正确处理
unsigned char。 - 为
my_strlen、my_strcpy、my_strcat分别写出空串、普通字符串和边界容量测试。 - 预测
strncpy(buffer, "abc", 8)对 8 字节目标的全部写入结果。 - 设计一个不依赖隐藏状态的分词接口,让调用者显式保存当前位置。
- 使用
strstr找出一条字符串中某个子串的所有非重叠出现位置。 - 打开编译器警告,并在支持的平台启用 AddressSanitizer,观察缺少
\0、目标溢出和写字面量时的诊断差异。
总结
这一讲看似列出了很多函数,实质上只有几条核心规律。
字符分类与转换函数处理的是单个字符值,返回值只区分零与非零,参数还必须满足 EOF 或 unsigned char 值域约束。strlen、strcpy、strcat、strcmp、strstr 处理的是以 \0 终止的字符序列;只要终止符缺失、目标不可写、容量不足或对象重叠,就可能进入未定义行为。
strncpy、strncat、strncmp 虽然都带 n,含义却分别是"写入字符数""追加源字符数""比较字符数",不能因为函数名相似就套用同一套容量计算。strtok 通过改写分隔符和保存内部位置完成切分,方便的代价是修改源串并带来隐藏状态。strerror 与 perror 则提醒我们:错误信息必须建立在明确的失败返回值和及时保存的 errno 上。
可以把整讲压缩成一句话:先证明参数满足对象、终止符与容量契约,再调用函数;先读懂返回值和副作用,再使用结果。