FlashAttention概览
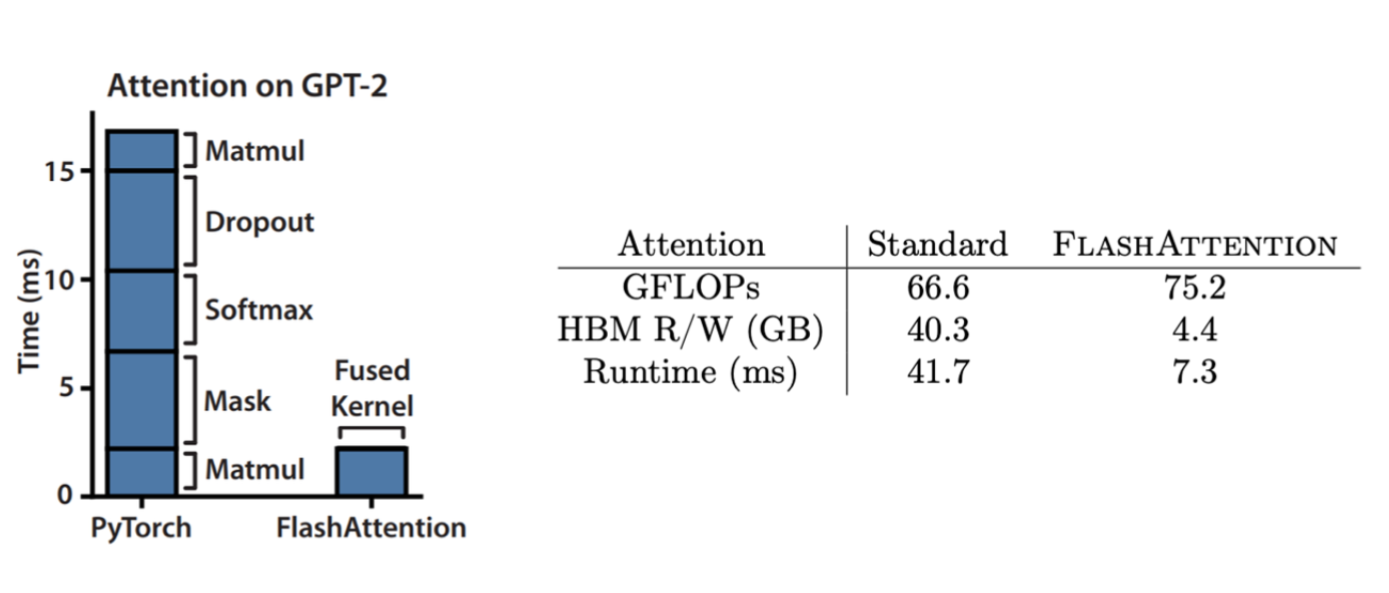
fa是个很经典的优化,和torch的标准注意力实现相比,访存量减少了一个数量级,运行时间也大幅降低,只有运算量稍微增加了一点,但正如我们前面提到的,GPU的运算吞吐远大于内存带宽,因此计算量增加问题不大,只要优化了搬运量就行,而这就是fa的核心思路。
回忆attention
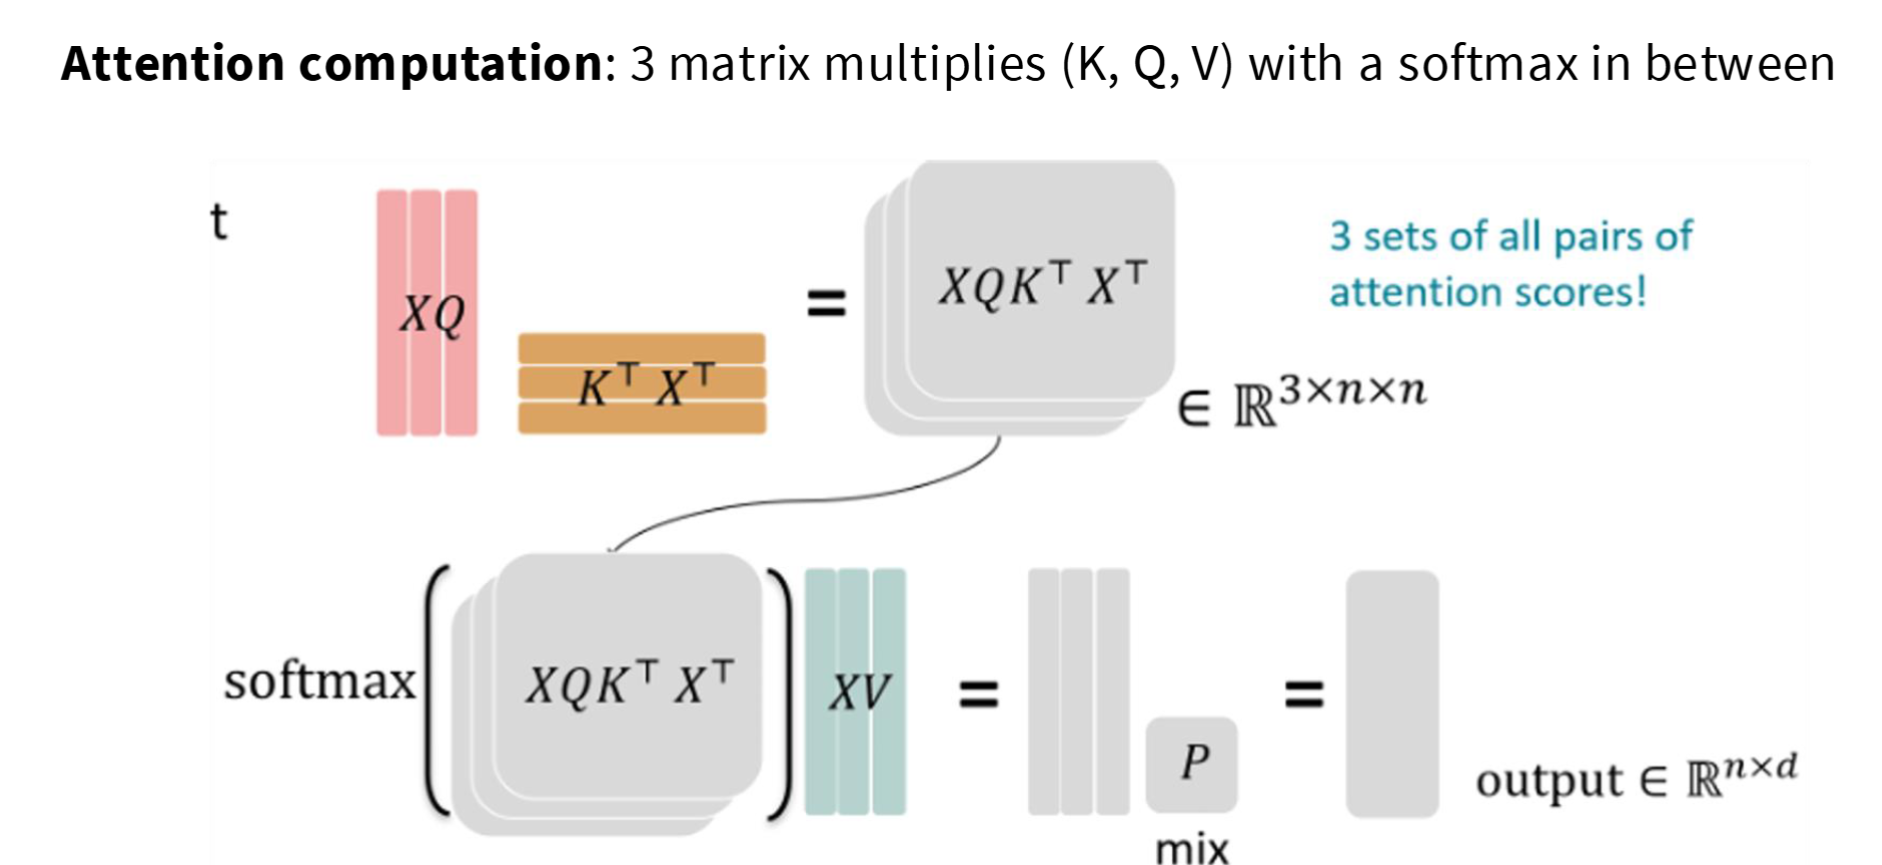
回忆一下attention计算,QK先乘,再做一个逐行的softmax,得到注意力矩阵,再乘上V矩阵,得到注意力输出
tiling
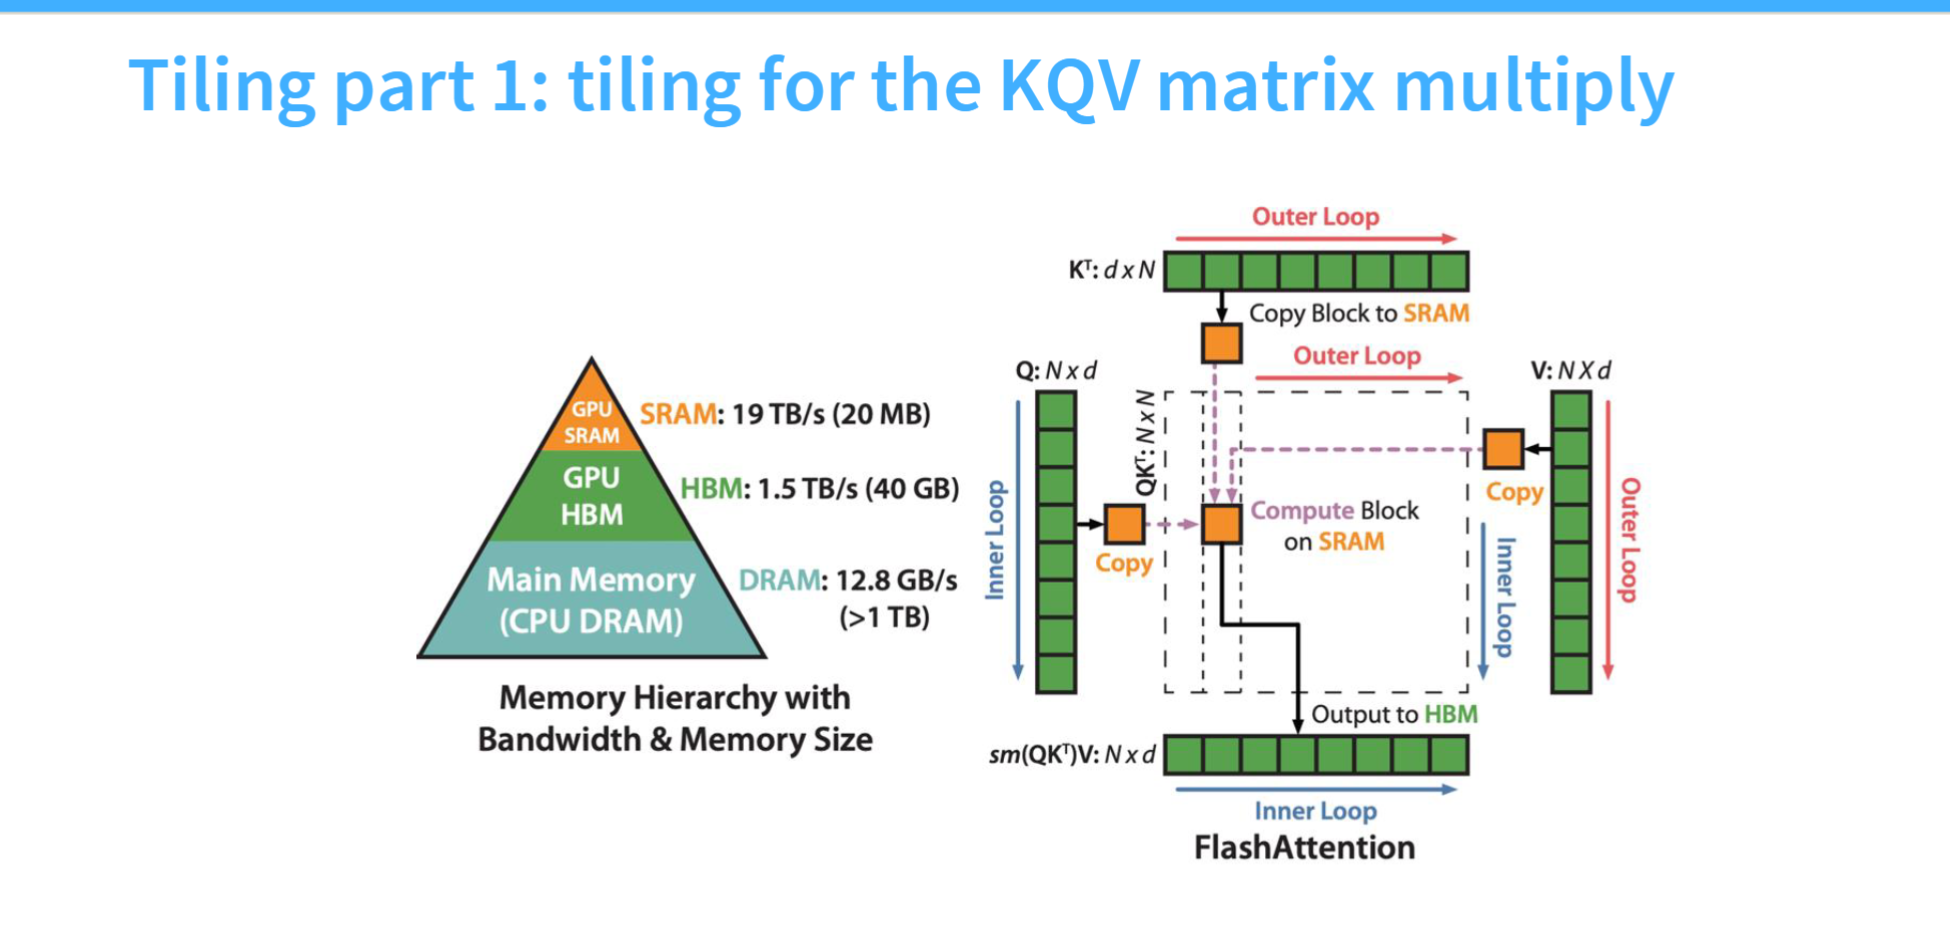 那么和GEMM的优化类似,也可以先做一个QKV矩阵的tiling
朴素softmax
接下来是关键,GEMM已经被充分优化了,fa的创新点主要在于优化了softmax算子。softmax是个逐元素算子,计算强度很低,属于访存瓶颈。
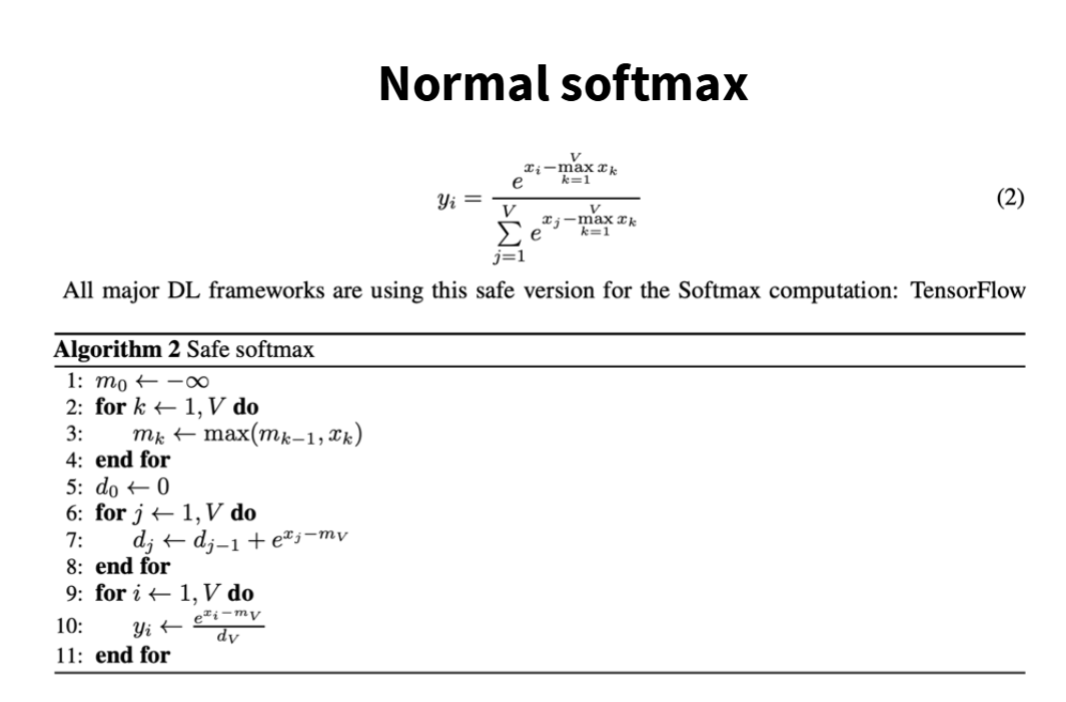
先来看看朴素的softmax怎么实现,这里在实现上采用的是safe softmax,在原始定义的基础上,找到最大指数,所有指数先减去这个最大指数,再求幂。这样的好处是把所有的指数都映射到负数了,计算幂之后值域也在0-1之间,不会出现指数爆炸。
这并不影响答案的正确性,softmax本身是一个幂和所有幂之和的比值,这里对所有指数都减了mx,相当于对所有幂都除以一个常数emxe^{mx}emx,分子分母同除常数,结果不变。
为了实现这个思路,需要三次循环。
- 第一次找到指数最大值mx
- 第二次求所有指数减去mx后,以e为底的幂的和sum
- 第三次利用sum求出每个位置的最终softmax输出
在线softmax
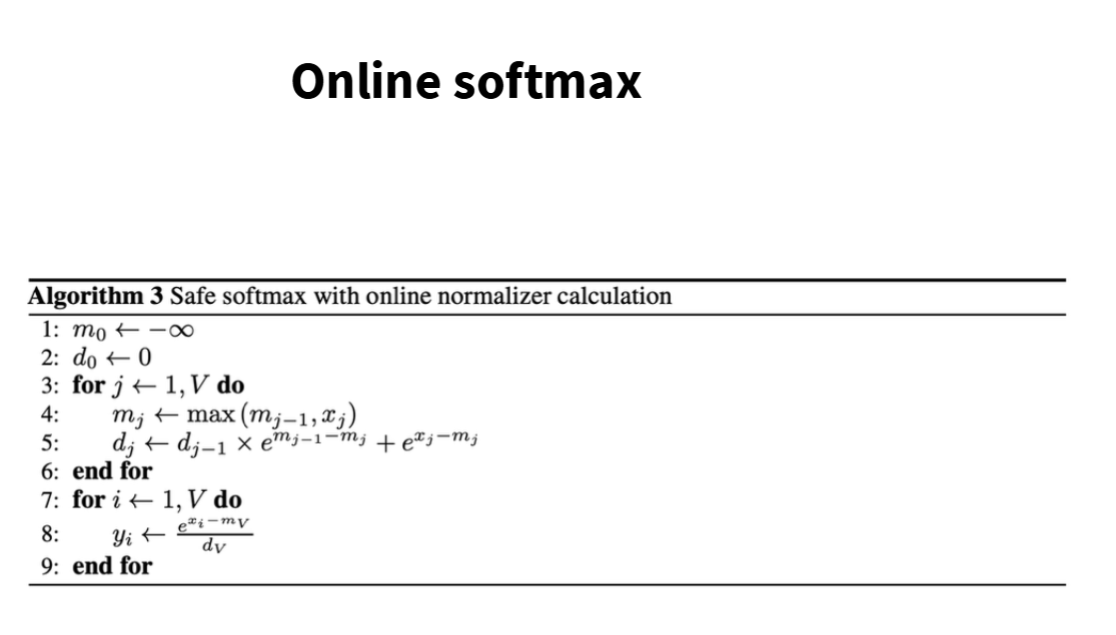
朴素softmax的访存太多了。fa的核心优化点是使用了在线softmax,把循环次数优化到两次
- 第一次在线地求出到目前为止的最大值mx,以及这个最大值对应的sum,如果最大值变化了,就对旧的sum做一下缩放
- 第二次循环利用sum和mx计算最终答案
对于softmax这个计算强度很低,几乎完全是memory bound的算子来说,减少一轮循环的访存可以带来巨大的提升。具体来分析,朴素3pass会3次读,1次写,在线softmax 2pass会2次读,1次写,访存量的比值是4/3=1.33,理论上的极限加速为1.33x
这看起来不多,但softmax在运行时间里占比不少,且之前被认为是不可优化的,现在把他也变成可优化了,开辟了一块以前没探索过的加速空间。
算子融合
当然能实现最开始图中的加速比,最核心的还是算子融合,减少数据的反复搬运,回到最开始这张图
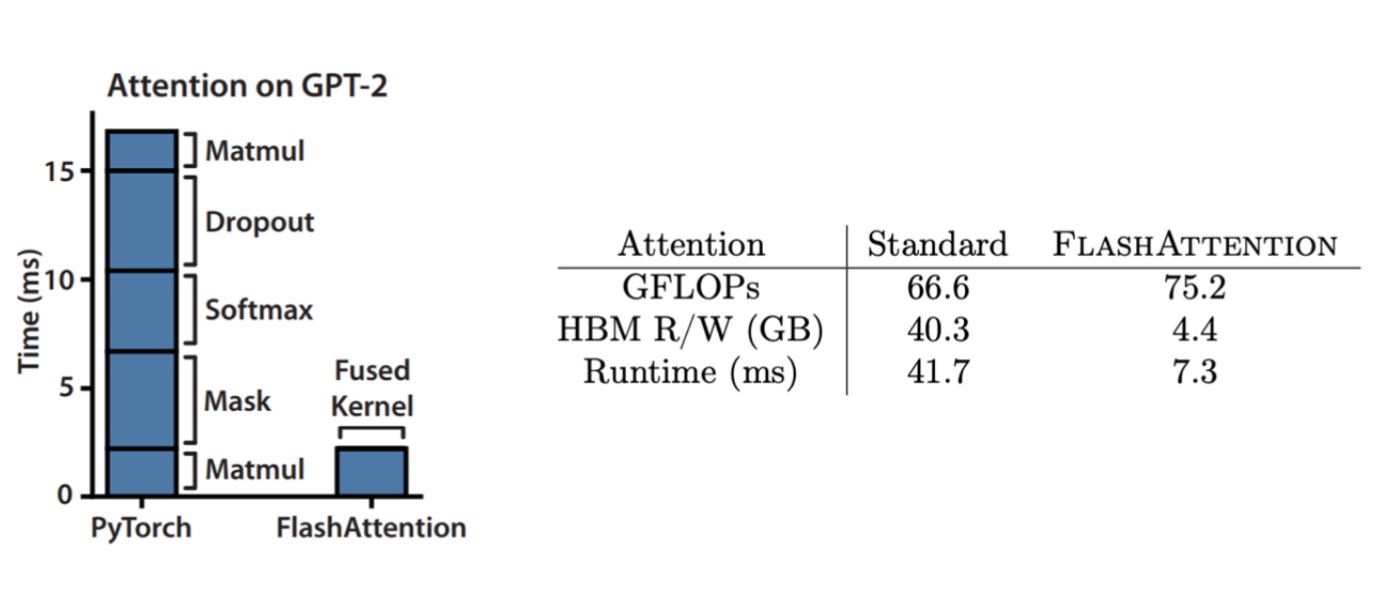
HBM也就是显存的读写量,只有之前的10%,因为把多个算子拼成的attention算子改成完全融合了,这才是能得到5x-6x加速比的核心原因。