大家好,欢迎来到 huangjin007_ 的博客
⭐ 个人主页:huangjin007_
🔥 文章收录专栏:Linux 内功修炼手册(系统篇)
总会有一些坚持
能从冰封的土地里
培育出十万朵怒放的蔷薇
Linux 系统篇(二十六) ------ 一切皆文件、缓冲区
文章目录
- [Linux 系统篇(二十六) ------ 一切皆文件、缓冲区](#Linux 系统篇(二十六) —— 一切皆文件、缓冲区)
-
- [一、洞悉 Linux 的核心哲学------"一切皆文件"](#一、洞悉 Linux 的核心哲学——“一切皆文件”)
-
- [1.1 什么是"一切皆文件"?](#1.1 什么是“一切皆文件”?)
- [1.2 图解 VFS 与 C 语言的多态思想](#1.2 图解 VFS 与 C 语言的多态思想)
-
- [1.2.1 架构分层:VFS 抽象层与驱动开发层](#1.2.1 架构分层:VFS 抽象层与驱动开发层)
- [1.2.2 源码剖析:虚函数表的物理体现](#1.2.2 源码剖析:虚函数表的物理体现)
- [1.2.3 多态的运行机制](#1.2.3 多态的运行机制)
- [1.2.4 为什么这么设计?](#1.2.4 为什么这么设计?)
- 二、为什么需要缓冲区机制?
-
- [2.1 什么是缓冲区?](#2.1 什么是缓冲区?)
- [2.2 为什么要引入缓冲区机制?(提高效率!)](#2.2 为什么要引入缓冲区机制?(提高效率!))
- [2.3 缓冲区的三种类型](#2.3 缓冲区的三种类型)
- [2.4 经典案例](#2.4 经典案例)
- [三、深入 C 标准库------FILE 结构体与用户级缓冲区](#三、深入 C 标准库——FILE 结构体与用户级缓冲区)
-
- [3.1 库函数 vs 系统调用](#3.1 库函数 vs 系统调用)
- [3.2 解剖 FILE 结构体](#3.2 解剖 FILE 结构体)
- [四、实战------手写一个简易的 libc 库(封装缓冲区)](#四、实战——手写一个简易的 libc 库(封装缓冲区))
-
- [4.1 设计头文件 `mystdio.h`](#4.1 设计头文件
mystdio.h) - [4.2 实现 `mystdio.c`](#4.2 实现
mystdio.c) - [4.3 测试代码 `usercode.c`](#4.3 测试代码
usercode.c)
- [4.1 设计头文件 `mystdio.h`](#4.1 设计头文件
- 结语:
一、洞悉 Linux 的核心哲学------"一切皆文件"
1.1 什么是"一切皆文件"?
如果你有 Windows 的使用经验,你会发现"文件"就是硬盘上的 txt、exe、图片。但在 Linux 系统中,这个概念被无限扩大了。
- Windows 中的文件,在 Linux 中当然也是文件。
- Windows 中不是文件的东西 ,比如进程、磁盘、显示器、键盘等硬件设备,在 Linux 中通通被抽象成了文件。
- 甚至在网络编程中使用的 Socket(套接字),以及用于进程间通信的管道(Pipe),本质上也是文件。
这样做的好处是什么?
一句话总结:一套 API 走天下。
开发者仅仅需要使用一套文件操作 API,就可以调取 Linux 系统中绝大部分的资源。
- 几乎所有的读取 操作(读文件、读系统状态、读 PIPE),都可以用
read函数。- 几乎所有的修改 操作(改文件、改系统参数、写 PIPE),都可以用
write函数。
1.2 图解 VFS 与 C 语言的多态思想
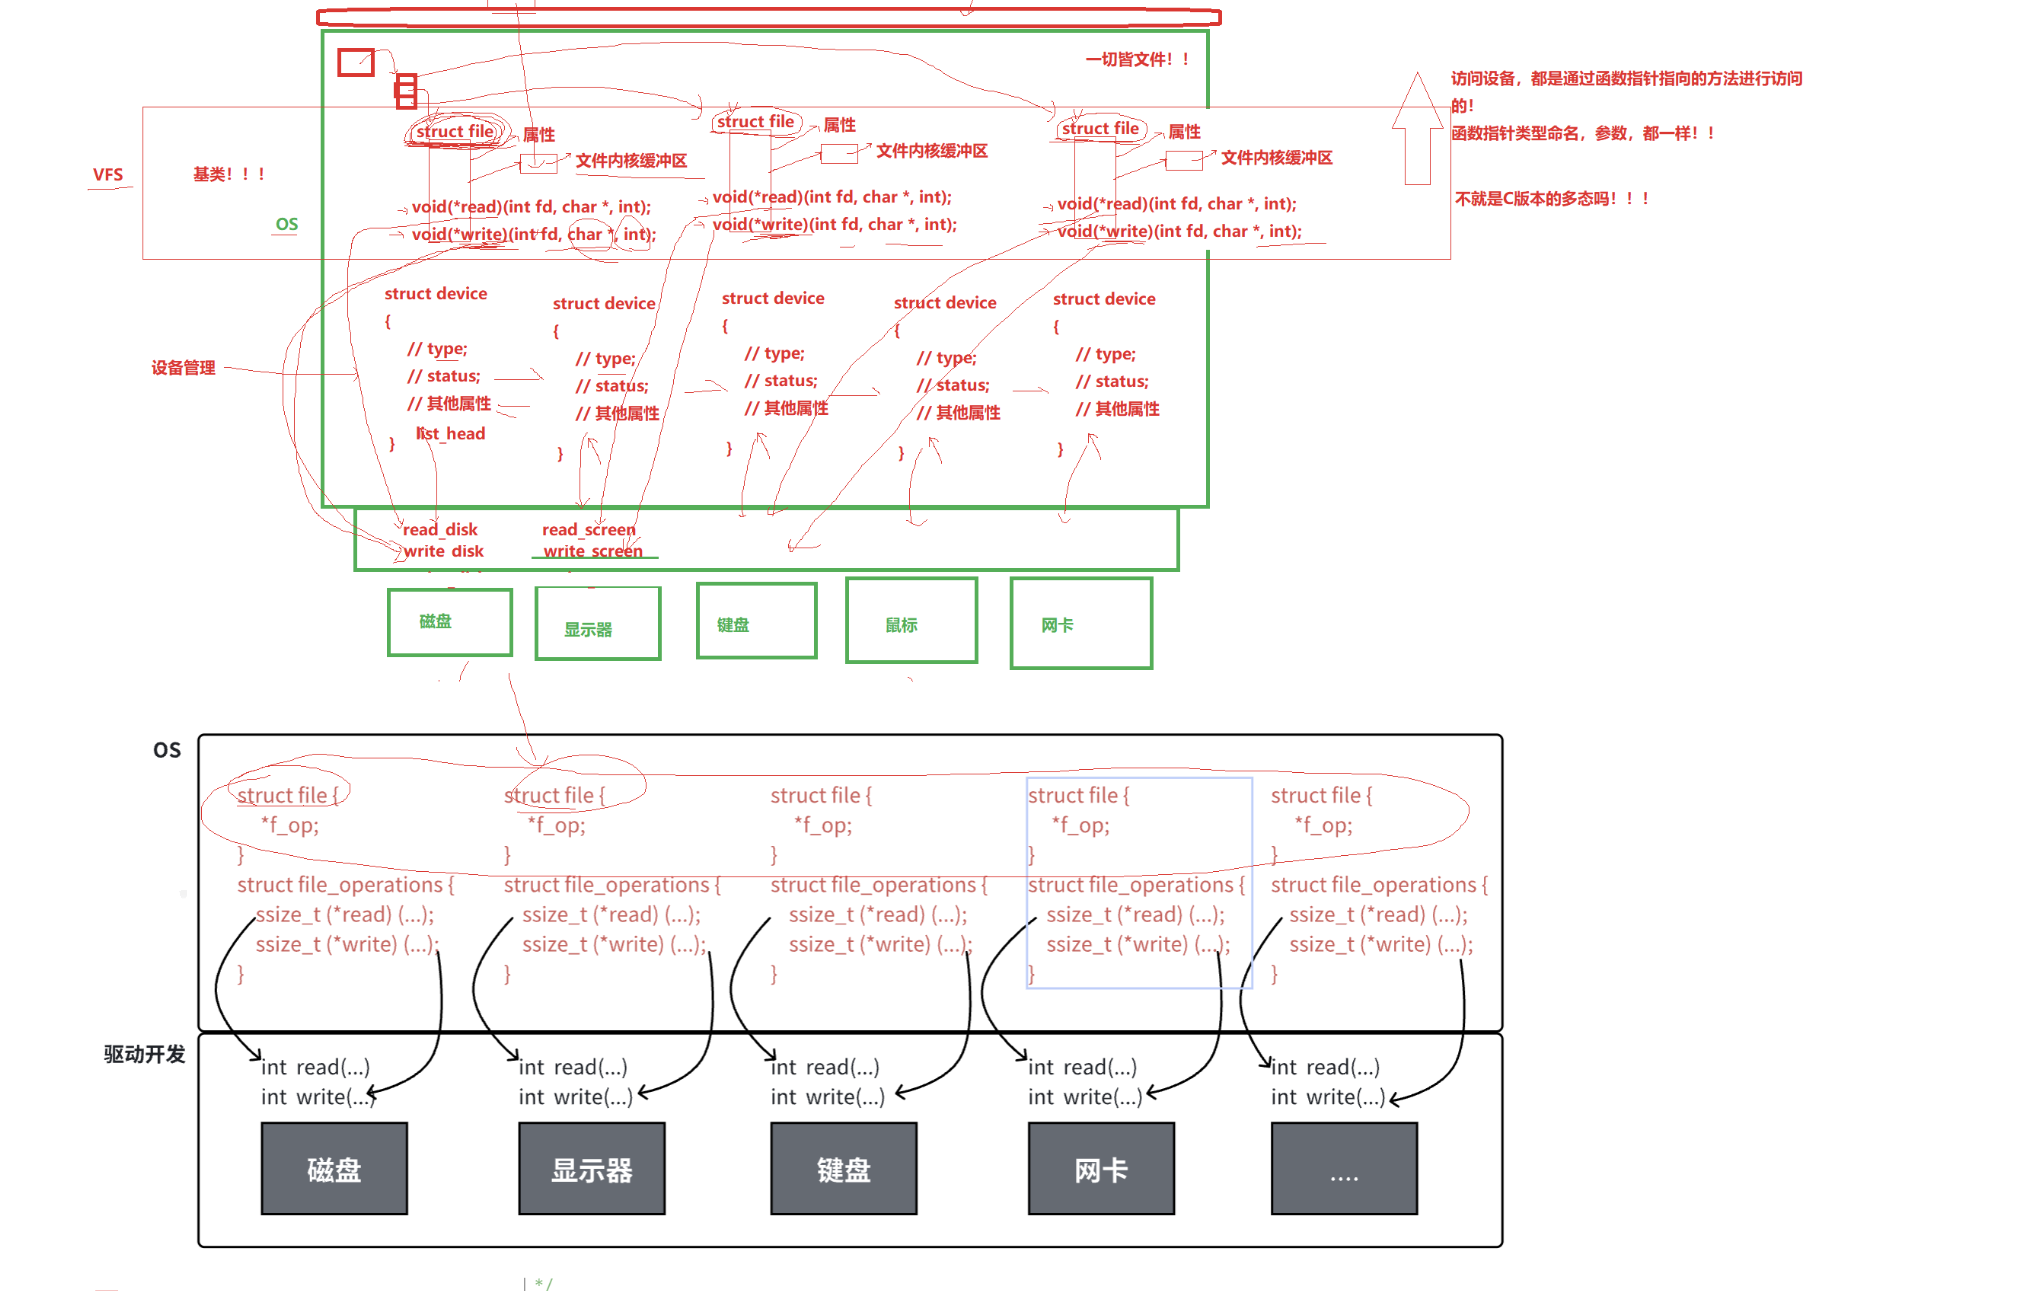
结合下面两张图,我们可以清晰地看到 Linux 架构中极其精妙的"多态"设计。Linux 内核虽然由纯 C 语言编写,缺乏 C++ 的 virtual 关键字,但它通过结构体嵌套函数指针的方式,完美手写了一套"虚函数表(vtable)",实现了面向对象中的多态特性。
1.2.1 架构分层:VFS 抽象层与驱动开发层
从上面的架构图可以看出,Linux 将文件系统划分为上下两层,这正是多态中"基类"与"子类"的体现:
-
OS 层(VFS 抽象层 ------ 基类)
- 一切皆文件:VFS(虚拟文件系统)屏蔽了底层硬件的差异。无论是磁盘、显示器、键盘还是网卡,在 VFS 眼中都被抽象为"文件"。
- 统一接口 :VFS 定义了统一的抽象接口(如
read、write、open、release),采用struct file结构体来描述一个打开的文件。 - 多态的实现机制:在结构体中定义函数指针!VFS 层只认这些统一的函数签名。
-
设备层(驱动开发层 ------ 子类)
- 各个硬件设备拥有自己的
struct device结构体(包含 type、status、其他属性、list_head 等)。 - 它们负责具体实现:磁盘驱动实现
read_disk/write_disk,显示器实现read_screen/write_screen。它们各自处理自己的硬件逻辑(如磁盘寻道、显存刷新)。
- 各个硬件设备拥有自己的
1.2.2 源码剖析:虚函数表的物理体现
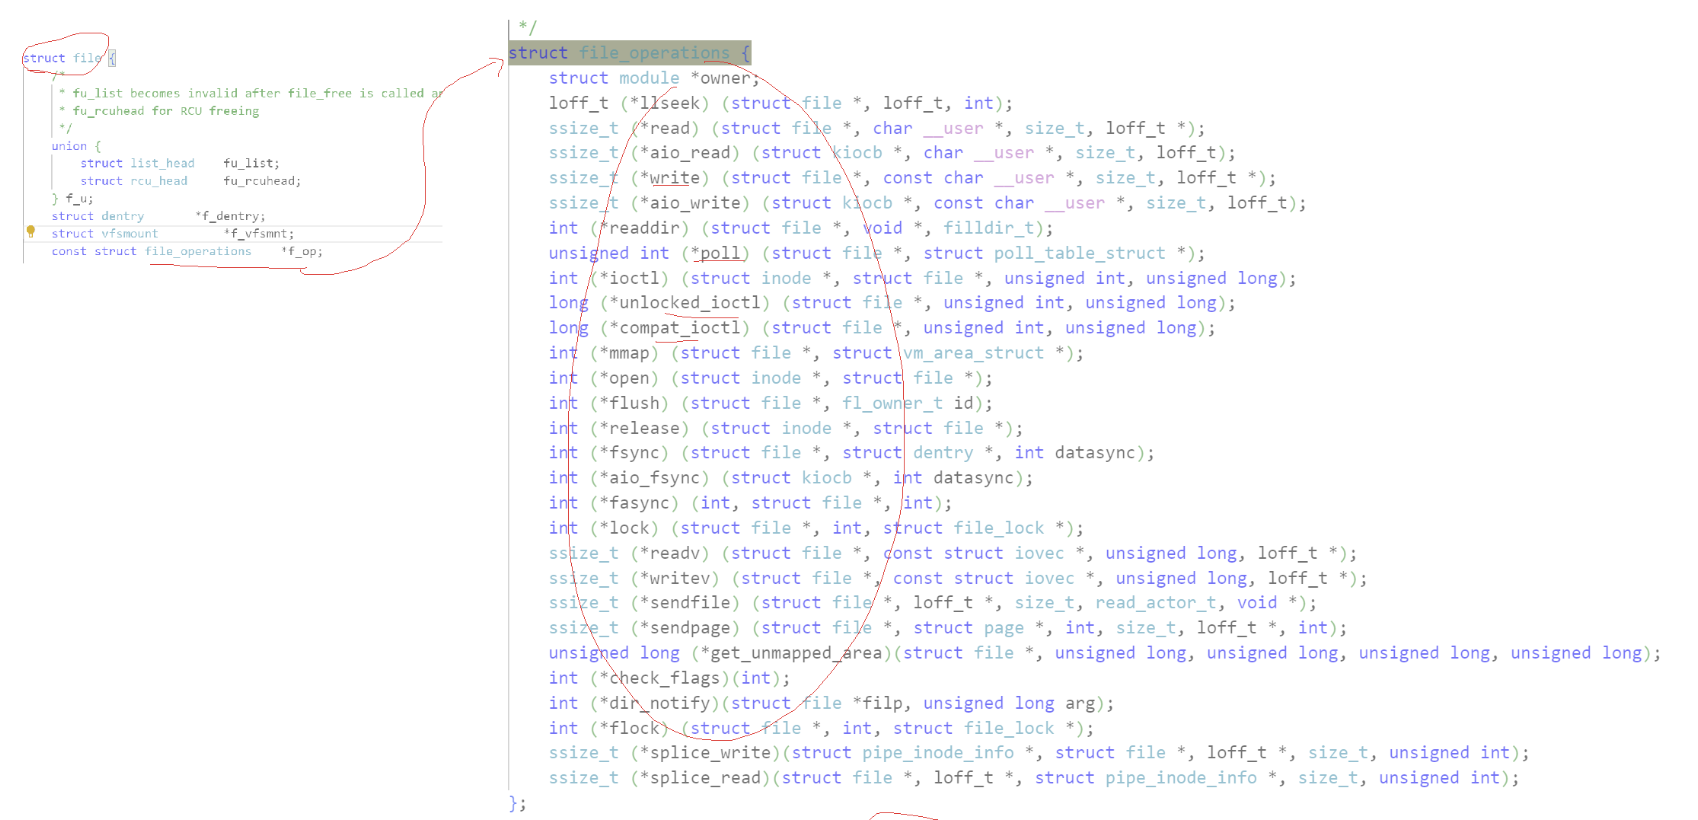
当一个用户在 Linux 中打开一个文件时,操作系统为了管理它,会在内核中创建一个名为 struct file 的结构体(定义在 /usr/src/kernels/.../include/linux/fs.h 下)。这个结构体就是我们操作文件的"通行证"。
我们先来看看这个结构体里几个关键成员:
c
struct file {
    // ...
    struct inode *f_inode;   /* 缓存的值,指向具体的文件实体 */
    const struct file_operations *f_op; /* 指向操作函数的指针集合 */
    atomic_long_t f_count;   /* 引用计数,多个指针指向它时增加 */
    unsigned int f_flags;    /* 打开文件的权限标志,如 O_RDONLY */
    fmode_t f_mode;          /* 访问模式,如只读、只写 */
    loff_t f_pos;            /* 当前读写的偏移量 */
    // ...
} __attribute__((aligned(4)));
重中之重是 f_op 指针! 它指向了一个名为 file_operations 的结构体。这行代码是整个多态机制的核心枢纽------每个打开的文件实例(struct file)都绑定了一个指向 file_operations 的指针,VFS 就是通过 file->f_op 找到具体应该调用哪个驱动的函数。
这个 file_operations 结构体是整个 Linux 设备驱动的灵魂,里面除了 struct module *owner 外,其余全都是函数指针。这就是 C 语言版本的"虚函数表":
c
struct file_operations {
    struct module *owner;
    loff_t (*llseek) (struct file *, loff_t, int);
    ssize_t (*read) (struct file *, char __user *, size_t, loff_t *);
    ssize_t (*write) (struct file *, const char __user *, size_t, loff_t *);
    ssize_t (*aio_read) (struct kiocb *, const struct iovec *, unsigned long, loff_t);
    ssize_t (*aio_write) (struct kiocb *, const struct iovec *, unsigned long, loff_t);
    int (*readdir) (struct file *, void *, filldir_t);
    unsigned int (*poll) (struct file *, struct poll_table_struct *);
    int (*ioctl) (struct inode *, struct file *, unsigned int, unsigned long);
    int (*mmap) (struct file *, struct vm_area_struct *);
    int (*open) (struct inode *, struct file *);
    int (*flush) (struct file *, fl_owner_t id);
    int (*release) (struct inode *, struct file *);
    int (*fsync) (struct file *, struct dentry *, int datasync);
    // ... 还有非常多
};
注意细节 :所有 read 和 write 的第一个参数都是 struct file *。这相当于面向对象里的 this 指针,让底层驱动能够知道自己当前在处理哪个打开的文件实例。
1.2.3 多态的运行机制
假设我们在用户态调用 read(fd, buf, size),看看这套机制是如何动态运转的:
- 用户态 :应用程序发起
read()调用。- 系统调用 :陷入内核,触发
sys_read()。- VFS 层 :根据文件描述符
fd,找到对应的struct file结构体。- 多态分发(核心) :VFS 执行
file->f_op->read(...)。此时,f_op指向的是具体设备在初始化时注册的驱动函数。- 驱动层 :如果是磁盘设备,CPU 跳转到
read_disk();如果是屏幕设备,跳转到write_screen()。- 返回:驱动层操作硬件完成后,将结果原路返回给用户态。
结论:这就是"同一个接口,不同的底层实现"。VFS 不需要关心底层是机械硬盘还是 SSD,它只负责按统一流程调用函数指针。
1.2.4 为什么这么设计?
file_operations 就是把系统调用和驱动程序关联起来的关键数据结构。这种设计带来了巨大的优势:
- 解耦 :VFS 和具体驱动彻底分离,双方只需遵守
file_operations这个"契约"。- 极强的可扩展性 :当你要新增一个设备时,只需写一个驱动,实现对应函数并注册到 VFS 中,不需要修改 VFS 的任何一行代码。
- 统一生态 :开发者可以使用
open,read,write,close这套标准 API 去操作几乎所有设备,大大降低了开发难度。
二、为什么需要缓冲区机制?
了解了文件操作的底层逻辑后,我们把目光转向日常开发中最常见的一个概念:缓冲区(Buffer)。
2.1 什么是缓冲区?
"内存的一段空间!" 缓冲区本质上是内存空间的一部分。我们在内存中预留了一定的存储空间,用来缓冲输入或输出的数据,这部分预留的空间就叫缓冲区。根据对应的是输入设备还是输出设备,分为输入缓冲区和输出缓冲区。
2.2 为什么要引入缓冲区机制?(提高效率!)
提高使用者的效率! 为什么直接操作不行?
如果我们在读写文件时,不设缓冲区,直接通过系统调用(System Call)对磁盘进行操作。
要知道,每一次系统调用都是有成本的! 执行一次系统调用,会涉及到:
- CPU 状态的切换(从用户态
User Mode切换到内核态Kernel Mode)。- 进程上下文的切换。
- 频繁的磁盘物理访问。
这些都会损耗大量的 CPU 时间。计算机对内存的操作速度远快于对磁盘的操作(可能相差几个数量级)。为了减少系统调用的次数,我们采用缓冲机制:一次性从磁盘读出大量数据到缓冲区,以后对这部分的访问直接读缓冲区,等缓冲区取完再去磁盘读。
再比如打印机,打印机速度很慢,我们先把文档输出到打印机的缓冲区,CPU 就可以去干别的事,打印机自己慢慢打印。这样,低速的 IO 设备和高速的 CPU 就能协调工作,解放了 CPU。
2.3 缓冲区的三种类型
标准 I/O 库(C 标准库)提供了 3 种类型的缓冲区:
- 全缓冲区(Full Buffering) :填满整个缓冲区后才进行 I/O 系统调用。对于磁盘文件的操作通常使用全缓冲。 默认大小一般为 4096 字节(内存页大小)或 1024。
- 行缓冲区(Line Buffering) :遇到换行符
\n时,标准 I/O 库函数就会执行系统调用操作。当流涉及一个终端(如标准输入stdin、标准输出stdout)时,使用行缓冲。默认行缓冲区大小为 1024。- 无缓冲区(No Buffering) :标准 I/O 库不对字符进行缓存,直接调用系统调用。标准出错流
stderr通常是不带缓冲区的,这使得出错信息能够尽快地显示出来。
除了上述默认刷新方式,以下情况也会引发缓冲区刷新:
- 缓冲区满时。
- 执行 flush 语句 (如
fflush(stdout))。- 进程结束(exit)。
2.4 经典案例
c
close(1);
int fd = open("log.txt", O_CREAT | O_WRONLY | O_APPEND, 0666);
// 默认向显示器输出
printf("fd: %d\n", fd);
printf("hello world\n");
printf("hello world\n");
printf("hello world\n");
// 系统调用
const char *msg = "hello write\n";
write(fd, msg, strlen(msg));
// 没敢写close
// close(fd);
我们本来想用重定向思维,让本来应该打印在显示器上的内容写到 log.txt 文件中,但运行结束后,会发现文件中并没有被写入内容!
为什么?
因为我们将 1 号描述符(标准输出)重定向到磁盘文件后,缓冲区的刷新方式从行缓冲(显示器)变成了全缓冲(磁盘文件)。而我们写入的内容很少,并没有填满整个缓冲区,导致在进程结束前,内容一直待在用户态的缓冲区里,并没有刷新到磁盘文件中。
解决办法:
- 在代码里手动加上
fflush(stdout);强制刷新。- 或者验证一下
stderr(2号描述符)是无缓冲的:close(2); ... perror("hello world");。因为stderr没有缓冲区,hello world不用fflush就可以直接写入文件。
三、深入 C 标准库------FILE 结构体与用户级缓冲区
3.1 库函数 vs 系统调用
c
printf("hello printf\n");
fprintf(stdout, "hello fprintf\n");
const char *s = "hello fwrite\n";
fwrite(s, strlen(s), 1, stdout);
// 系统调用
const char *ss = "hello write\n";
write(1, ss, strlen(ss));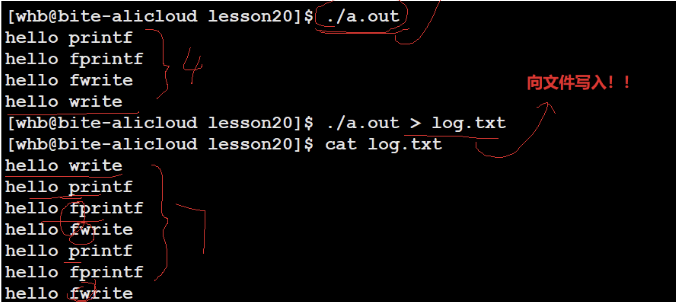
直接运行 ./a.out 输出到显示器时,四行代码正常打印。但如果我们运行 ./a.out > log.txt(重定向到文件),结果变成了:
text
hello write
hello printf
hello fprintf
hello fwrite
hello printf
hello fprintf
hello fwrite
为什么 printf 和 fwrite 输出了 2 次,而 write 只输出了 1 次?
这里有两个核心原因:
- C库函数自带用户级缓冲区,
write系统调用没有。fork()在write之后被调用了!
深度解析 :
一般 C 库函数写入文件时是全缓冲,写入显示器是行缓冲。
当重定向到普通文件时,数据的缓冲方式由行缓冲变成了全缓冲 。我们放在缓冲区中的数据(printf 等),就不会被立即刷新。
此时调用 fork()。fork() 会创建子进程。在 fork 的瞬间,父进程的数据(包括用户态缓冲区里的数据)会发生写时拷贝(Copy-On-Write) 。
当父进程准备刷新(退出时统一刷新)的时候,子进程也就有了同样的一份数据,随即产生了两份数据 写入文件。
而 write 系统调用没有用户缓冲区,数据直接交给了内核,所以 fork 影响不到它,只输出一次。
结论:
printf/fwrite是库函数,在系统调用的"上层",是对系统调用的"封装"。- 库函数在用户态二次加上了缓冲区(由 C 标准库提供)。
write系统调用没有用户级缓冲区,直接进入内核。- 我们平时说的缓冲区,默认指用户级缓冲区。OS 为了提升整机性能,也有内核级缓冲区(如 Page Cache),但不在本次讨论范围内。
3.2 解剖 FILE 结构体
既然库函数有缓冲区,那这个缓冲区在哪?就在 FILE 结构体里。
在 /usr/include/stdio.h 中:typedef struct _IO_FILE FILE;
在 /usr/include/libio.h 中,C 标准库定义了 struct _IO_FILE:
c
struct _IO_FILE {
    int _flags;       /* High-order word is _IO_MAGIC; rest is flags. */
#define _IO_file_flags _flags

    // 缓冲区相关指针 (C++ streambuf protocol)
    char* _IO_read_ptr;   /* Current read pointer */
    char* _IO_read_end;   /* End of get area. */
    char* _IO_read_base;  /* Start of putback+get area. */
    char* _IO_write_base; /* Start of put area. */
    char* _IO_write_ptr;  /* Current put pointer. */
    char* _IO_write_end;  /* End of put area. */
    char* _IO_buf_base;   /* Start of reserve area. */
    char* _IO_buf_end;    /* End of reserve area. */

    // 备份和撤销相关字段
    char *_IO_save_base;
    char *_IO_backup_base;
    char *_IO_save_end;

    struct _IO_marker *_markers;
    struct _IO_FILE *_chain;

    int _fileno; // 核心!封装的文件描述符
    // ...
};
C 语言中的 FILE 是一个结构体。它内部必定封装了文件描述符 fd(即 _fileno) 。因为 IO 相关函数与系统调用接口对应,库函数最终还是要通过 fd 去访问文件。同时,它内部包含了极其复杂的缓冲区指针(_IO_read_ptr、_IO_write_base 等),用于管理用户态缓冲区。
四、实战------手写一个简易的 libc 库(封装缓冲区)
为了彻底弄懂 C 标准库是如何封装系统调用并加上缓冲区的,我们来模拟实现一个简单的 mystdio 库。
4.1 设计头文件 mystdio.h
我们需要定义一个自己的 MyFile 结构体,它应该包含:文件描述符、打开标志、用户态缓冲区、缓冲区当前长度、刷新策略。
c
#pragma once
#include <stdio.h>

// 缓冲区最大容量
#define MAX 1024

// 刷新策略宏定义
#define NONE_FLUSH (1 << 0)
#define LINE_FLUSH (1 << 1)
#define FULL_FLUSH (1 << 2)

typedef struct IO_FILE
{
    int fileno;           // 文件描述符
    int flag;             // open时使用的标志
    char outbuffer[MAX];  // 用户态缓冲区
    int bufferlen;        // 缓冲区当前有效数据的字节数
    int flush_method;     // 刷新策略
} MyFile;

// 函数声明
MyFile* MyFopen(const char* path, const char* mode);
void MyFclose(MyFile* file);
int MyFwrite(MyFile* file, const void* str, int len);
void MyFFlush(MyFile* file);
4.2 实现 mystdio.c
这里是核心逻辑。我们会用到 malloc 分配结构体,用系统调用 open、write、close 来操作底层。
c
#include "mystdio.h"
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <string.h>
#include <stdlib.h>
#include <unistd.h>
#include <errno.h>

// 辅助函数:创建并初始化 MyFile 对象
static MyFile* BuyFile(int fd, int flag)
{
    MyFile* f = (MyFile*)malloc(sizeof(MyFile));
    if (f == NULL) return NULL;

    f->fileno = fd;
    f->flag = flag;
    f->bufferlen = 0;
    f->flush_method = LINE_FLUSH; // 默认行缓冲

    // 将缓冲区清零,保证字符串打印时能正确找到结束符
    memset(f->outbuffer, 0, sizeof(f->outbuffer));
    return f;
}

// 打开文件
MyFile* MyFopen(const char* path, const char* mode)
{
    if (path == NULL || mode == NULL) return NULL;

    int fd = -1;
    int flag = 0;

    if (strcmp(mode, "w") == 0)
    {
        flag = O_CREAT | O_WRONLY | O_TRUNC;
        fd = open(path, flag, 0666);
    }
    else if (strcmp(mode, "a") == 0)
    {
        flag = O_CREAT | O_WRONLY | O_APPEND;
        fd = open(path, flag, 0666);
    }
    else if (strcmp(mode, "r") == 0)
    {
        flag = O_RDONLY;
        fd = open(path, flag);
    }
    else
    {
        return NULL; // 暂不支持其它模式
    }

    if (fd < 0) return NULL;
    return BuyFile(fd, flag);
}

// 强制刷新缓冲区:将用户态缓冲区的数据通过 write 系统调用写入内核
void MyFFlush(MyFile* file)
{
    if (file == NULL || file->bufferlen <= 0) return;

    int written = 0;
    while (written < file->bufferlen)
    {
        ssize_t n = write(file->fileno, file->outbuffer + written,
        				file->bufferlen - written);
        if (n < 0)
        {
            perror("write");
            break;
        }
        written += n;
    }
    // 清空缓冲区有效长度
    file->bufferlen = 0;
}

// 写入数据(核心:先写入用户态缓冲区,根据策略决定是否刷新)
int MyFwrite(MyFile* file, const void* str, int len)
{
    if (file == NULL || str == NULL || len <= 0) return 0;

    const char* p = (const char*)str;
    int total_written = 0;

    while (len > 0)
    {
        // 如果缓冲区满了,必须刷新
        if (file->bufferlen == MAX)
        {
            MyFFlush(file);
        }

        int space = MAX - file->bufferlen;
        int n = (len < space) ? len : space;

        // 拷贝数据到用户态缓冲区
        memcpy(file->outbuffer + file->bufferlen, p, n);
        file->bufferlen += n;
        p += n;
        len -= n;
        total_written += n;

        // 行缓冲策略:遇到换行符立即刷新
        if ((file->flush_method & LINE_FLUSH) && file->bufferlen > 0
            && file->outbuffer[file->bufferlen - 1] == '\n')
        {
            MyFFlush(file);
        }

        // 全缓冲策略:缓冲区满立即刷新
        if ((file->flush_method & FULL_FLUSH) && file->bufferlen == MAX)
        {
            MyFFlush(file);
        }
    }
    return total_written;
}

// 关闭文件:先刷新缓冲区,再关闭 fd,最后释放内存
void MyFclose(MyFile* file)
{
    if (file == NULL) return;
    MyFFlush(file);
    if (file->fileno >= 0)
    {
        close(file->fileno);
    }
    free(file);
}
4.3 测试代码 usercode.c
我们来看看这个简易库是如何运作的:
c
#include "mystdio.h"
#include <string.h>
#include <unistd.h>
#include <stdio.h>

int main()
{
    MyFile* filep = MyFopen("./log.txt", "a");
    if (filep == NULL) {
        perror("MyFopen");
        return 1;
    }

    const char* msg1 = "hello myfile!"; // 没有换行符
    MyFwrite(filep, msg1, strlen(msg1));
    printf("写入不带换行的字符串,缓冲区长度 = %d,内容 = %.*s\n", filep->bufferlen, filep->bufferlen, filep->outbuffer);

    const char* msg2 = "hello line flush\n"; // 带有换行符
    MyFwrite(filep, msg2, strlen(msg2));
    printf("写入带换行的字符串,缓冲区长度 = %d\n", filep->bufferlen);

    const char* msg3 = "manual flush";
    MyFwrite(filep, msg3, strlen(msg3));
    MyFFlush(filep); // 手动刷新
    printf("手动刷新,缓冲区长度 = %d\n", filep->bufferlen);

    MyFclose(filep);
    return 0;
}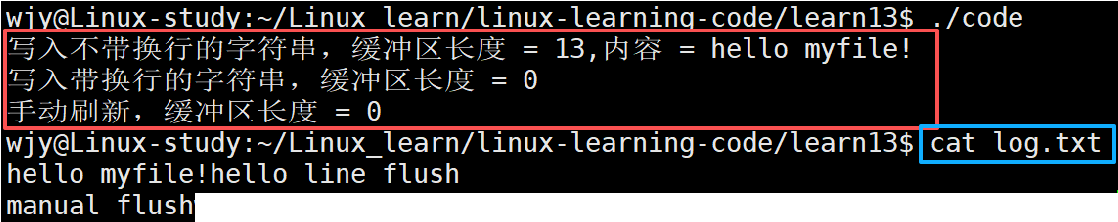
执行流程解析:
- 打开文件,初始化
MyFile。- 写入
msg1(无\n)。数据进入outbuffer,bufferlen增加,但不触发刷新。打印时能看到缓冲区里有数据。- 写入
msg2(有\n)。数据进入outbuffer,因为末尾是\n,触发LINE_FLUSH,调用write系统调用将缓冲区内容写入磁盘文件,并清空缓冲区。所以打印时bufferlen = 0。- 写入
msg3,手动调用MyFFlush,数据写入磁盘,缓冲区清空。MyFclose再次确保刷新并释放资源。
结语:
今天的内容到这里就结束了,希望你能有所收获~
干货整理到手抖,觉得有用的话,赏个三连回回血?__(:ᗤ」ㄥ)_ _