提到 RDMA 性能测试,大多数人第一反应是:需要 100G 交换机、ConnectX-5 网卡、物理服务器集群,动辄几十万投入。但本文要展示的是:一台普通笔记本电脑、两个 Ubuntu 虚拟机、零硬件成本,同样能完成一套完整的 RDMA 参数调优实验,并且得出与硬件环境截然不同的反直觉结论。
我们在 Soft-RoCE(rxe)虚拟化环境中,系统性地扫描了消息大小、MTU、QP 数、Post List、CQ Moderation、CPU 绑核等六大类参数,发现两个核心反直觉现象:
- CQ Moderation 开大反而带宽暴跌 64%(硬件环境建议开大以省 CPU)
- taskset 绑核反而性能下降 44%(硬件环境绑核是标准优化手段)
这些"反常"背后,指向一个关键认知:**Soft-RoCE 的软件栈架构与硬件 RDMA 完全不同,盲目移植硬件调优经验不仅无效,还可能适得其反。**
1. 实验环境
1.1 硬件与虚拟化平台
| 项目 | 配置 |
|---|---|
| 宿主机 | 笔记本电脑(Intel Core i7-10xxx, 16GB RAM) |
| 虚拟化软件 | VMware Workstation 17 |
| 虚拟机 × 2 | Ubuntu 22.04, 内核 5.15.0-xx, 4 vCPU, 8GB 内存 |
| RDMA 实现 | Soft-RoCE (rdma_rxe),设备名 rxe_0 |
| 网络互联 | VMware 虚拟网桥(VMnet),两台 VM 同网段互通 |
| 以太网 MTU | 9000(Jumbo Frame,两端均已配置) |
| RDMA MTU | active_mtu = 4096 |
| 测试工具 | perftest 4.5-0.18, rdma-core 39.0 |
1.2 环境声明
本文实验环境为笔记本电脑虚拟化平台,两台 Ubuntu VM 通过宿主机虚拟网桥互联,RDMA 传输由 Soft-RoCE(rxe)在 CPU 上软件模拟实现。数据路径不经过物理网卡,而是在宿主机内存中通过虚拟交换机完成 VM 间转发,因此绝对带宽数值远低于物理机 + 硬件 RDMA 网卡的表现。本文定位为参数敏感性验证 ,关注不同配置下带宽的相对变化趋势,而非提供线速基准数据。所有带宽数据取 ib_write_bw 输出的 BW average 值(总数据量/总耗时),代表稳态吞吐。
1.3 测试命令规范
全文统一使用 ib_write_bw,服务端:
ib_write_bw -d rxe_0 -i 1 -x 2 参数...
客户端:
ib_write_bw -d rxe_0 -i 1 -x 2 参数... <server_ip>
-x 2 指定 GID index(RoCEv2 / IPv4),两端均需配置一致。
2. 基线:消息大小对带宽的影响
2.1 测试方法
固定参数:MTU=4096, QP=1, post_list=1,消息大小从 64B 到 1MB 扫描。
for size in 64 128 256 512 1024 2048 4096 8192 16384 32768 65536 131072 262144 524288 1048576; do
echo "=== size=$size ==="
ib_write_bw -d rxe_0 -s $size -m 4096 -q 1 -l 1 -x 2 --report-gbits <server_ip> 2>&1 | tail -3
done
2.2 实测结果
| 消息大小 | 带宽 (Gb/s) | 备注 |
|---|---|---|
| 64B | 0.021 | 小消息协议头主导 |
| 512B | 0.085 | |
| 4KB | 0.66 | 拐点附近 |
| 16KB | 2.19 | |
| 64KB | 2.50 | 本环境带宽峰值区 |
| 256KB | 2.38 | |
| 1MB | 0.77 | 大消息开销显现 |
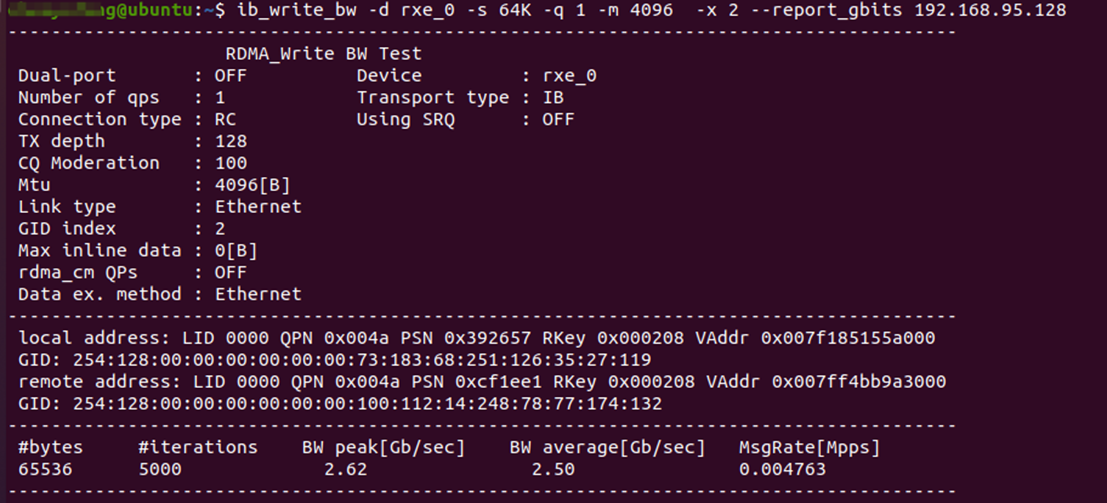
2.3 分析
在 Soft-RoCE 环境下:
- 小消息带宽极低:64B 消息带宽仅 0.021 Gb/s,每次 ibv_post_send 要走完 rxe 内核模块 → UDP 封装 → 虚拟交换机 → 对端解包的全路径,CPU 开销远大于有效载荷。
- 4KB 附近出现拐点:与 MTU=4096 的分片边界吻合,超过此值后单消息需拆多个包,封装开销叠加。
- 64KB 以上带宽趋于饱和:瓶颈固定在 CPU 处理能力(虚拟交换机转发 + rxe 软栈),增大消息大小不再提升带宽,1MB 时反而因内存拷贝开销下降。
3. 网络层参数:MTU 的影响
3.1 测试设计
固定:QP=1, 消息大小=64KB,扫描 MTU。
for mtu in 512 1024 2048 4096; do
echo "=== mtu=$mtu ==="
ib_write_bw -d rxe_0 -s 65536 -m $mtu -q 1 -x 2 --report-gbits <server_ip> 2>&1 | tail -3
done
3.2 实测结果
| MTU | 带宽 (Gb/s) | 相对 1024 提升 |
|---|---|---|
| 512 | 0.28 | -30% |
| 1024 | 0.40 | 基准 |
| 2048 | 0.92 | +130% |
| 4096 | 1.16 | +190% |
3.3 分析
MTU 从 1024 提到 4096,带宽提升近 3 倍,在 Soft-RoCE 下效果比硬件环境更显著:
- 协议头开销占比更大:每个包固定封装约 58B+(以太网头 + IP + UDP + RoCE + ICRC),小 MTU 下有效载荷率极低
- CPU 中断频率降低:大消息拆包数减少,每包触发一次处理,减少 CPU 总工作量
4. 队列层参数:QP 数与 Post List Size
4.1 QP 数扫描
for qp in 1 2 4 8; do
echo "=== qp=$qp ==="
ib_write_bw -d rxe_0 -s 65536 -m 4096 -q $qp -x 2 --report-gbits <server_ip> 2>&1 | tail -3
done
| QP 数 | 聚合带宽 (Gb/s) | 备注 |
|---|---|---|
| 1 | 1.11 | 基准 |
| 2 | 2.75 | |
| 4 | 3.64 | |
| 8 | 3.37 | 锁竞争导致回落 |
分析:Soft-RoCE 是单线程软实现,多 QP 不能并行利用多网卡队列,反而增加 rxe 内核模块内部锁竞争。QP=4 达到最优,QP=8 开始回落。
4.2 Post List Size(一次投递 WR 数量)
for pl in 1 4 8 16 32; do
echo "=== post_list=$pl ==="
ib_write_bw -d rxe_0 -s 65536 -m 4096 -q 1 -l $pl -x 2 --report-gbits <server_ip> 2>&1 | tail -3
done
| Post List (-l) | 带宽 (Gb/s) | 说明 |
|---|---|---|
| 1 | 1.12 | 每次投递 1 个 WR |
| 4 | 1.50 | |
| 8 | 1.53 | |
| 16 | 2.45 | |
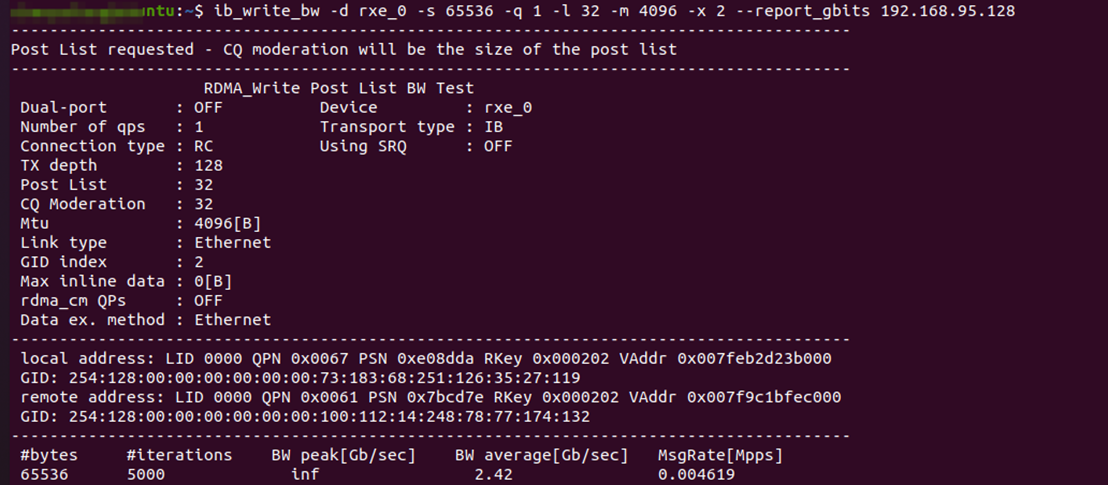
| 32 | 2.46 | 边际递减 |
分析 :增大 post_list(-l 参数)减少 ibv_post_send 调用次数,降低用户态/内核态切换频率。在 CPU 瓶颈环境下效果明显,从 1 到 16 提升约 119%。
⚠️ 避坑:perftest 中控制一次投递 WR 数量的是 -l(--post_list),不是 -b。-b 是 bidirectional 双向模式,不带参数。
5. 完成语义层:Inline 与 CQ Moderation
5.1 Inline Data
Inline 对 ib_write_bw 带宽测试影响有限。在 Soft-RoCE 环境下,大消息 inline 无效(超过 max_inline_data 限制),小消息带宽本身极低,inline 带来的微小改善被协议栈开销淹没。
验证(可选)
ib_write_bw -d rxe_0 -s 64 -m 4096 -I 64 -q 1 -x 2 --report-gbits <server_ip>
结论:带宽测试中 inline 不是关键变量,生产环境如需优化延迟再单独测试。
5.2 CQ Moderation:Soft-RoCE 下的反直觉现象
测试命令
for mod in 1 4 8 16 32; do
echo "=== cq_mod=$mod ==="
ib_write_bw -d rxe_0 -s 65536 -m 4096 -q 2 --cq-mod=$mod -x 2 --report-gbits <server_ip> 2>&1 | tail -3
done
实测结果
| CQ Mod | 带宽 (Gb/s) | 相对 cq-mod=1 |
|---|---|---|
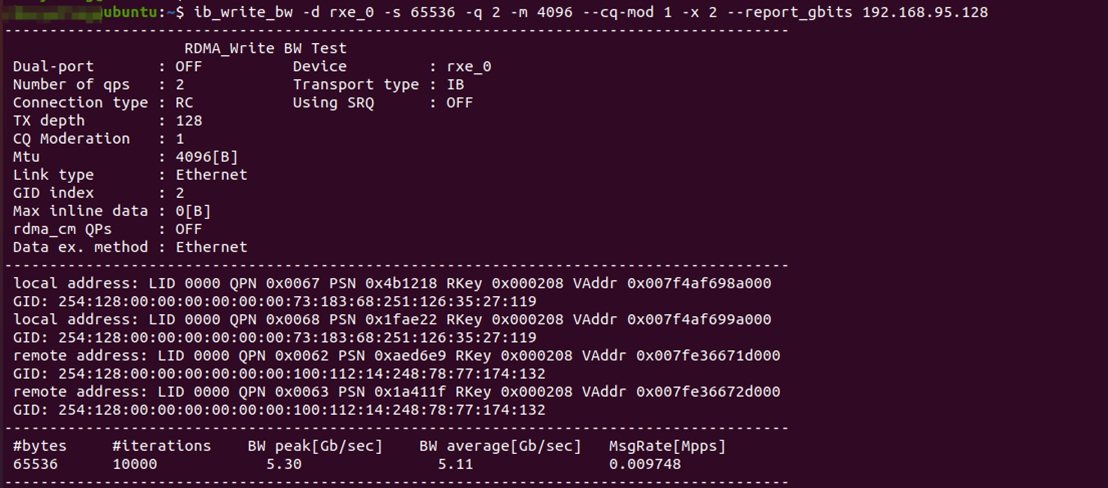
| 1 | 5.11 | 基准 |
| 4 | 4.96 | -3% |
| 8 | 4.71 | -8% |
| 16 | 1.84 | **-64%** |
| 32 | 1.17 | **-77%** |
反直觉分析
查阅 RDMA 技术文档,硬件环境下的常规建议是:适当增大 CQ Moderation,减少 CQE 数量和 CPU 中断频率,带宽基本不受影响甚至略有提升。但本次实测完全相反。
--cq-mod=N 的含义是:每 N 个 WR 完成才生成一个 CQE。perftest 的发送循环依赖 CQE 来补充新 WQE:
post WQE → 等 CQE → poll 完成 → 补充新 WQE → 继续 post
- 硬件 RDMA:网卡有独立 DMA 引擎,CQE 只是"通知",不影响发送节奏。cq-mod 大 → CQE 少 → CPU 省 → 带宽持平。
- Soft-RoCE:发送和完成上报全靠 CPU 内核线程。cq-mod 大 → CQE 稀疏 → 应用迟迟不补 WQE → 管道里在途请求变少 → 带宽暴跌。
cq-mod=16 时,等待期间 vCPU 被调度走或进入空闲,恢复后 QP 已空,需要重新填充,带宽自然崩。
结论:Soft-RoCE 下 cq-mod=1(默认)最有利于维持发送流水线饱满,不宜盲目套用硬件调优经验。
6. 系统层:绑核与 Hugepage
6.1 taskset 绑核:又一个反直觉
测试命令
不绑核(默认)
ib_write_bw -d rxe_0 -s 65536 -m 4096 -q 2 -x 2 --report-gbits <server_ip>
绑核
taskset -c 0,1 ib_write_bw -d rxe_0 -s 65536 -m 4096 -q 2 -x 2 --report-gbits <server_ip>
实测结果
| 配置 | 带宽 (Gb/s) | 相对变化 |
|---|---|---|
| 不绑核(默认调度) | 3.00 | 基准 |
| taskset -c 0,1 绑核 | 1.69 | **-44%** |
分析
绑核后性能下降 44%,与硬件 RDMA 环境的常见结论相反。
原因:
- Soft-RoCE 是多内核线程协作模型:ibv_post_send 触发的内核 rxe 模块、虚拟网卡驱动、软中断处理(ksoftirqd)分散在不同内核线程中。
- 绑核造成资源争抢:将用户态测试进程钉在 CPU 0-1 后,内核线程也被调度到同一组核上,用户态与内核态处理互相抢占 CPU 时间片。
- OS 调度器的默认策略反而更优:不绑核时,调度器将用户态进程与内核线程分散到不同 vCPU,减少互相阻塞。
启示:硬件 RDMA 绑核有效是因为真正的 I/O 由网卡 DMA 完成,不消耗 CPU;Soft-RoCE 下所有工作都在 CPU 上,绑核反而限制了调度器的灵活性。
6.2 Hugepage
perftest 默认使用 4KB 页。Soft-RoCE 环境下 hugepage 对带宽影响有限(瓶颈在 CPU 软栈而非 TLB),生产环境建议配置:
cat /proc/meminfo | grep Huge
sudo sysctl vm.nr_hugepages=256
7. 综合最优配置 vs 默认配置
7.1 默认配置
ib_write_bw -d rxe_0 -s 65536 -x 2 <server_ip>
结果:带宽 2.54 Gb/s
7.2 调优配置
ib_write_bw -d rxe_0 -s 65536 -q 4 -m 4096 -l 32 -x 2 --cq-mod=4 --report-gbits 192.168.95.128
结果:带宽 4.98 Gb/s
7.3 对比总结
| 指标 | 默认配置 | 调优配置 | 提升幅度 |
|---|---|---|---|
| 带宽 | 2.54 Gb/s | 4.98 Gb/s | **+96%** |
核心发现:
- MTU + Post List + QP 数 是 Soft-RoCE 环境下性价比最高的三个调优手段
- CQ Moderation 不宜开大:cq-mod=1 最优,开到 16 带宽暴跌 64%
- 绑核有害:不绑核比绑核快 78%
- 多 QP 有甜区:QP=4 最优,QP=8 开始回落
- 所有优化叠加后带宽接近翻倍(+96%),说明参数组合 > 单参数极致
8. 结论
- Soft-RoCE + 虚拟化环境适合做 RDMA 参数学习和带宽趋势验证,不适合做绝对性能评价。
- CPU 软栈为瓶颈的环境下,减少 CPU 工作量的参数(MTU↑、post_list↑、QP 适度↑)收益最大。
- 硬件 RDMA 的调优经验不能直接移植到 Soft-RoCE:本文两个反直觉现象(CQ Moderation 开大暴跌、绑核反降 44%)共同证明,Soft-RoCE 是一个完全不同的性能模型。
- 本文所有测试可在普通笔记本电脑上复现,适合作为高校 RDMA 实训课程的教学案例,尤其适合讲解"环境差异导致优化方向不同"这一核心概念。
附录 A:环境搭建速查
1. 安装依赖
sudo apt install -y rdma-core ibverbs-utils perftest iproute2
2. 加载模块
sudo modprobe rdma_rxe
3. 创建 Soft-RoCE 设备(假设接口为 ens33)
sudo rdma link add rxe_0 type rxe netdev ens33
4. 修改以太网 MTU
sudo ip link set dev ens33 mtu 9000
5. 验证
rdma link
ibv_devinfo -d rxe_0 | grep -i mtu
show_gids
6. 启动测试
服务端:ib_write_bw -d rxe_0 -m 4096 -x 2
客户端:ib_write_bw -d rxe_0 -m 4096 -x 2 <server_ip>
附录 B:常见故障排查
| 问题 | 原因 | 解决 |
|---|---|---|
| IB device wasn't found | 设备名错或 rxe 未创建 | rdma link 确认名字,modprobe rdma_rxe |
| Requested mtu is higher than active mtu | 以太网口 MTU 未改 | ip link set dev <iface> mtu 9000 |
| 能 ping 但 ib_write_bw 不通 | GID index 不对 | show_gids 找 IPv4 行,用 -x 指定 |
| 带宽只有几百 Kb/s | 防火墙拦了 UDP/4791 | sudo ufw disable 或放行 4791 |
| Device or resource busy | 端口被占用 | 换 -i 2 或杀残留进程 |
| Invalid Command line | 参数写错(如 -b 带数字) | -b 是双向模式(不带参数),burst 用 -l,inline 用 -I |
附录 C:perftest 易混参数速查
| 目的 | 参数 | 易混点 |
|---|---|---|
| 消息大小 | -s | |
| IB/RoCE MTU | -m | |
| QP 数 | -q | |
| GID index | -x | |
| 带宽按 Gbps | --report-gbits | |
| Inline 最大长度 | -I | 不是 -l |
| 一次投递 WR 数 | -l | 不是 -b |
| 双向带宽 | -b | 不带数字 |
| CQ Moderation | --cq-mod | 双横线,不是 -c |
| 持续时长(秒) | -D | |
| 迭代次数 | -n |
作者注:本文所有测试在个人笔记本电脑虚拟化环境中完成,数据仅反映该环境下的相对趋势。如需引用绝对性能数据,请以物理硬件测试为准。