论文题目:MMFSL: A Novel Multimodal Few-Shot Learning Framework for Fault Diagnosis of Industrial Bearings (MMFSL:一种面向工业轴承故障诊断的新型多模态小样本学习框架)
期刊:IEEE Transactions on Instrumentation and Measurement,2023
摘要:实际生产过程中,某些特殊异常工况往往只有极少量样本,并形成明显的数据不平衡,这使得过程状态的准确监测十分困难。本文提出一种用于工业轴承不平衡数据建模的多模态小样本学习方法 MMFSL。MMFSL 同时处理两种数据模态,因此包含两个数据生成通道:第一条通道面向时间序列,第二条通道面向图像。随后分别利用图像评价指标 IEI 和时间序列评价指标 TEI 对生成数据进行质量评估,并对时间序列进行时频域分析,以保证频率分布的一致性。通过扩充原始不平衡且样本不足的数据,使故障诊断模型能够得到更充分的训练。在 CWRU 和 PU 数据集上的实验表明,MMFSL 生成的数据可将故障检测准确率从 80.9% 提升到 97.5%,并将误报率从 4.6% 显著降低到 0.1%;在故障分类中,时间序列扩充后的准确率可由 95.4% 提升至 98.1%,图像数据扩充后可由 96.5% 提升至 99.3%。论文还通过多组可视化对比验证了 MMFSL 框架的可靠性。
一、研究背景与核心问题
工业轴承故障诊断通常从振动信号开始:采集加速度信号,进行时频分析,再利用神经网络或其他分类器识别故障类型。真正困难的地方并不是"有没有分类模型",而是工业现场的故障具有随机性,异常样本天然稀缺,少数故障类型甚至只有很少的有效数据。样本不足和类别不平衡会进一步带来过拟合、欠拟合以及模型鲁棒性下降。
已有 Few-Shot Learning 更多关注"如何从少量样本直接学会分类",但作者指出,这类方法通常没有真正扩充原始数据,因此后续很难充分使用 CNN、Transformer 等依赖数据规模的模型。MMFSL 的思路因此与典型的度量学习式 FSL 不太一样:它不直接把"小样本分类器"作为终点,而是先把 few-shot 数据扩充成可用训练集,再交给传统故障检测和分类模型。
这篇论文主要解决三个问题:第一,如何同时利用一维振动序列和二维图像两种模态扩充少样本;第二,GAN 能生成很多数据,但哪些数据真的可靠,如何建立显式质量门槛;第三,扩充后的数据是否真的能够降低故障检测误报并提升故障分类准确率,而不仅仅是在视觉上"看起来像"。
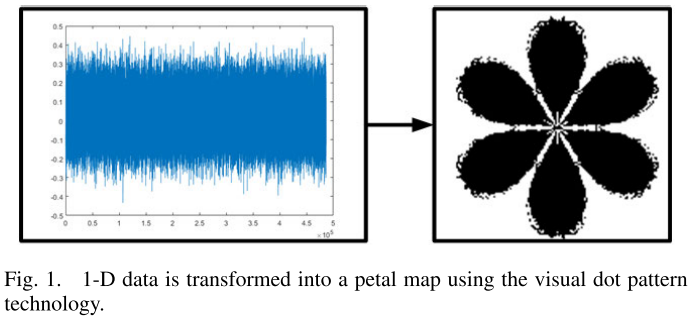
论文 Figure 1:利用 Visual Dot Pattern 将一维振动信号转换为二维花瓣图
Figure 1 给出了论文最关键的跨模态桥梁:原始一维时间序列经过极坐标变换后成为具有对称结构的花瓣图。这样做的目的不是简单"把数据画成图片",而是把振动模式编码到二维几何结构中,使后续图像生成和 CNN 分类成为可能。
二、MMFSL 整体框架
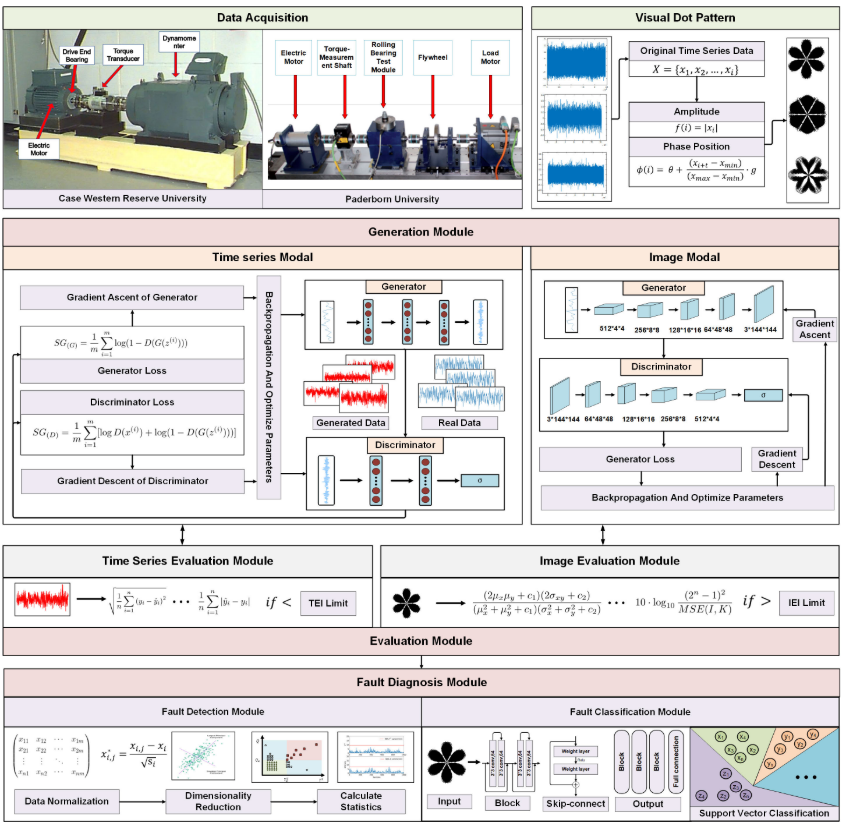
论文 Figure 2:MMFSL 故障诊断整体框架
Figure 2 建议重点看三层结构:Generation Module → Evaluation Module → Fault Diagnosis Module。数据首先从轴承振动信号进入系统,一条路线保留时间序列并通过 TSM 扩充;另一条路线先通过 Visual Dot Pattern 生成二维花瓣图,再通过 IMM 扩充图像。两种生成结果不会直接进入诊断模型,而是先分别经过 TEI 和 IEI 的质量筛选,只有满足评价条件的数据才用于后续训练。
整个流程可以压缩为:
原始振动信号 → TSM / Visual Dot Pattern + IMM → TEI / IEI 质量筛选 → PCA 故障检测 → SVC / ResNet18 故障分类
这也是 MMFSL 最值得记住的设计:它不是单独提出一个生成器,而是把"数据扩充、生成质量控制、诊断验证"串成闭环。对于小样本场景,生成得多并不等于有效;论文真正强调的是生成数据必须先经过质量评价,再证明它能改善下游诊断。
三、双通道数据生成与 Visual Dot Pattern
3.1 TSM:直接扩充时间序列
TSM 面向原始振动序列,本质上采用 GAN 的对抗训练思想:生成器 (G) 从随机噪声中产生与真实振动数据分布相近的序列,判别器 (D) 则尝试区分真实数据和生成数据,两者交替优化。论文的 Algorithm 1 还把 TEI 直接放进训练循环:只要生成结果没有达到时间序列评价要求,就继续更新生成器与判别器;达到阈值后再批量产生扩充样本。
这里的重点不是 GAN 公式本身,而是"生成---评价---继续训练"这一闭环。作者希望避免把训练中间阶段产生的低质量序列直接混入数据集。
3.2 IMM:扩充二维花瓣图
IMM 处理的是 144 × 144 的二维图像。原始振动信号先通过 Visual Dot Pattern 转换为花瓣图,再利用图像生成模型进行扩充。其训练逻辑与 TSM 相同,但评价门槛换成 IEI。Algorithm 2 同样要求生成图像通过评价后,才进行大规模扩充。
Visual Dot Pattern 的核心相位变换为:
其中 () 表示第 (i) 个时刻的振幅,(
) 是偏移 (t) 后的振幅,(
) 与 (
) 用于归一化,(
) 和 (g) 控制花瓣图的角度结构。实验中 (
),(
) 取 ±π/3、±2π/3 和 ±π。直观理解就是:振动幅值和相邻时刻关系被映射到极坐标中的半径与相位,因此不同故障模式最终形成不同的几何花瓣纹理。
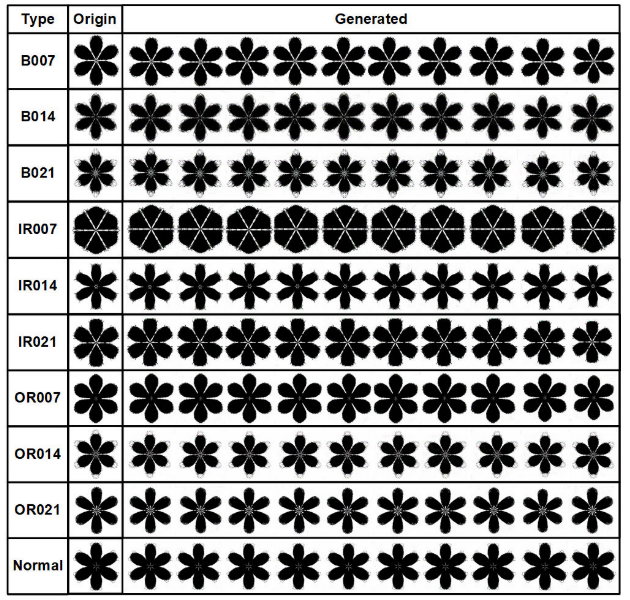
论文 Figure 3:10 类轴承数据的原始 Visual Dot Pattern 与生成图像对比
Figure 3 的作用是做定性检查。第二列是原始花瓣图,第三列是 IMM 生成结果。可以看到不同故障类别保持了各自主要几何结构,同时同一类别内部又存在一定变化,说明生成器不是简单复制单张图像。
四、生成数据质量控制与故障诊断
MMFSL 与"直接用 GAN 做数据增强"的主要区别,在于作者额外设计了两套评价指标。对于图像模态,IEI 包含 aHash、dHash、pHash、SSIM、PSNR 和 Histogram 六类指标;对于时间序列,TEI 使用 MSE、RMSE 和 MAE。图像侧强调生成图与对应真实类别之间的相似性,时间序列侧强调生成序列与真实数据之间的误差。只有时间序列差异低于阈值,或图像相似度达到规定阈值,生成样本才会被接受。
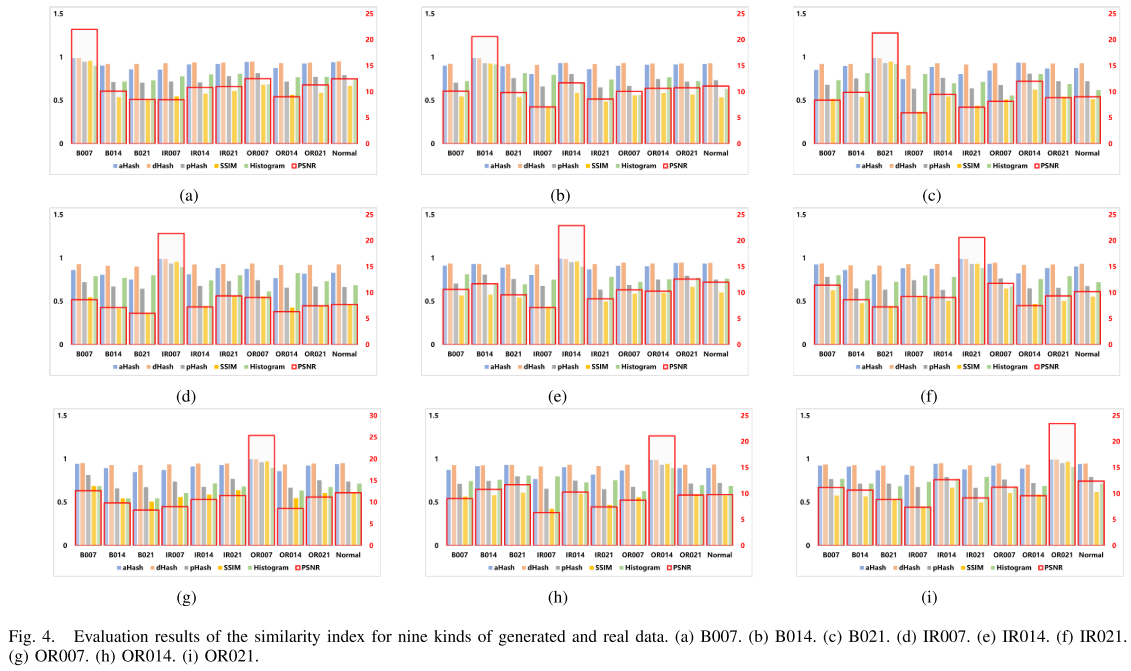
论文 Figure 4:9 类生成故障数据与真实数据的 IEI 相似度结果
Figure 4 用九组柱状图验证图像评价模块。由于 PSNR 的数值尺度明显高于另外五个指标,论文采用双纵轴显示。以 B007 为例,生成的 B007 与真实 B007 在对应列上取得最高的综合相似度,而与其他类别保持区分,这说明评价模块不仅要求"像真实图像",还要求生成样本与目标故障类别匹配。
完成数据扩充后,论文并没有重新设计一个复杂的端到端诊断网络,而是采用相对经典的下游模型来检验数据本身是否有价值。故障检测使用 PCA,并通过 Hotelling () 与 Q/SPE 统计量判断测试样本是否超过正常控制限;故障分类则对时间序列使用 SVC,对花瓣图使用 ResNet18。这样的验证方式反而比较直接:如果只替换训练数据,保持诊断方法不变仍能稳定提升性能,就能够更明确地说明改进来自 MMFSL 的数据扩充。
五、实验结果与消融分析
5.1 数据集与实验设置
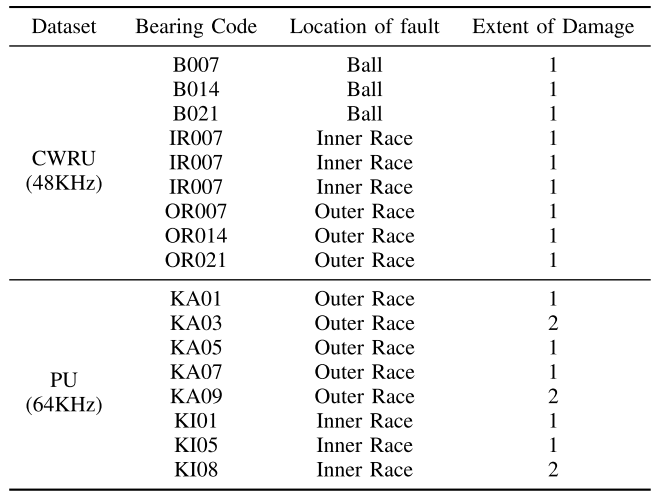
论文 Table I:CWRU 与 PU 轴承数据集的故障类别、故障位置与损伤程度
实验使用 CWRU 和 PU 两套公开轴承数据。CWRU 信号采样率为 48 kHz,包含 9 类故障数据,并在分类时加上 Normal 构成 10 类;PU 采样率为 64 kHz,共使用 8 类轴承状态。Table I 主要用于说明各类别对应的滚动体、内圈或外圈故障以及损伤程度。
在故障检测实验中,作者将 MMFSL 增强数据规模设为原始数据的 10 倍,共设计 8 个 Case,分别比较 CWRU/PU、原始/增强以及混合状态/正常状态下的 PCA 检测性能。
5.2 故障检测:最明显的收益是降低误报
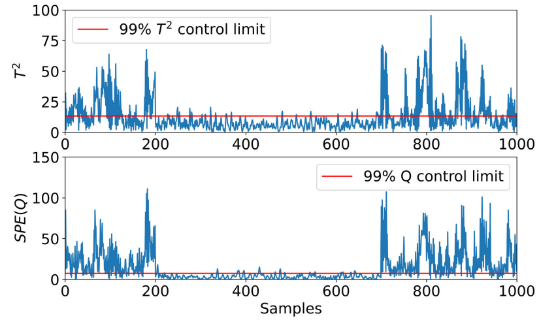
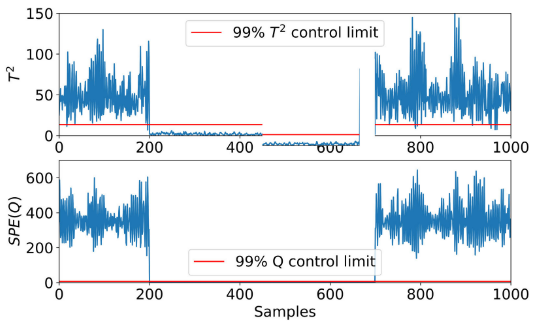
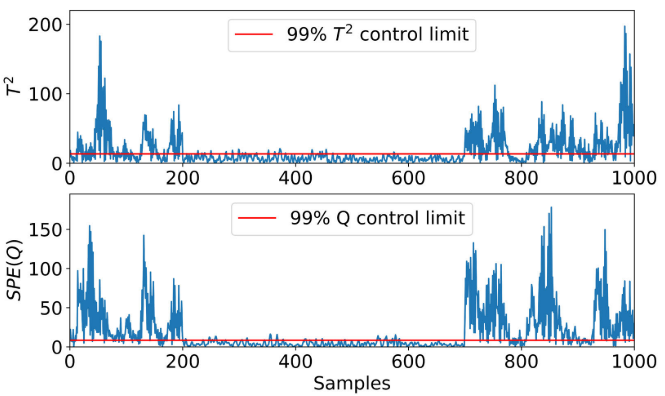
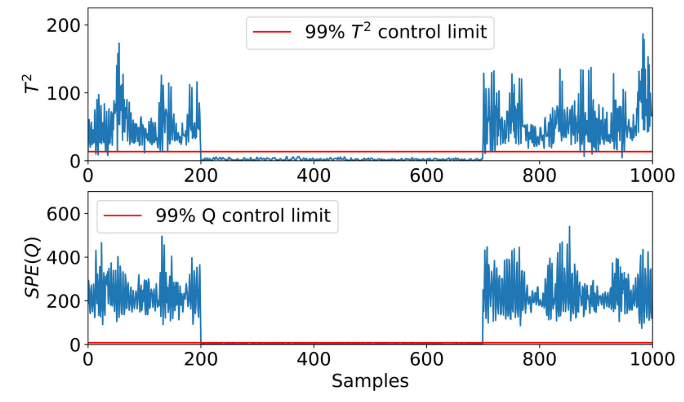
论文 Figure 5--8:CWRU 与 PU 在原始数据和增强数据上的 (T^2)、Q 故障检测结果
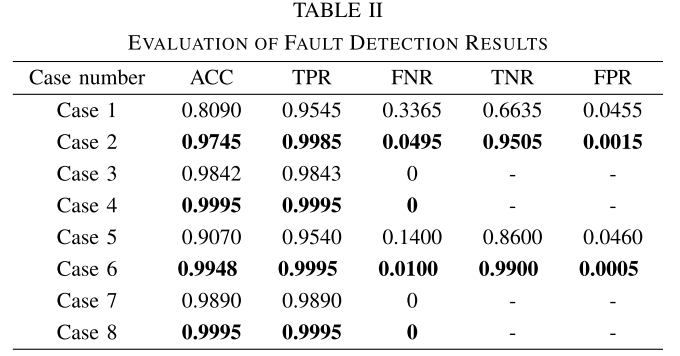
论文 Table II:8 个 Case 的 ACC、TPR、FNR、TNR 与 FPR 对比
Figure 5--8 中,原始数据训练的 PCA 在正常区间仍会出现统计量越过阈值的情况,而使用增强数据后,误报点明显减少。Table II 给出了更直接的定量证据:在 CWRU 的混合故障/正常场景中,ACC 从 80.90% 提升到 97.45% ,FPR 从 4.55% 降到 0.15% ;在 PU 上,ACC 从 90.70% 提升到 99.48% ,FPR 从 4.60% 降到 0.05%。
这组结果说明 MMFSL 的价值不只是"让准确率高一点",而是让正常状态下的统计模型更稳定。对于工业过程监测,误报率往往直接决定系统是否可用,因此这一点比单纯提升几个百分点的分类准确率更有工程意义。
5.3 数据量"消融":生成更多并非无限有效
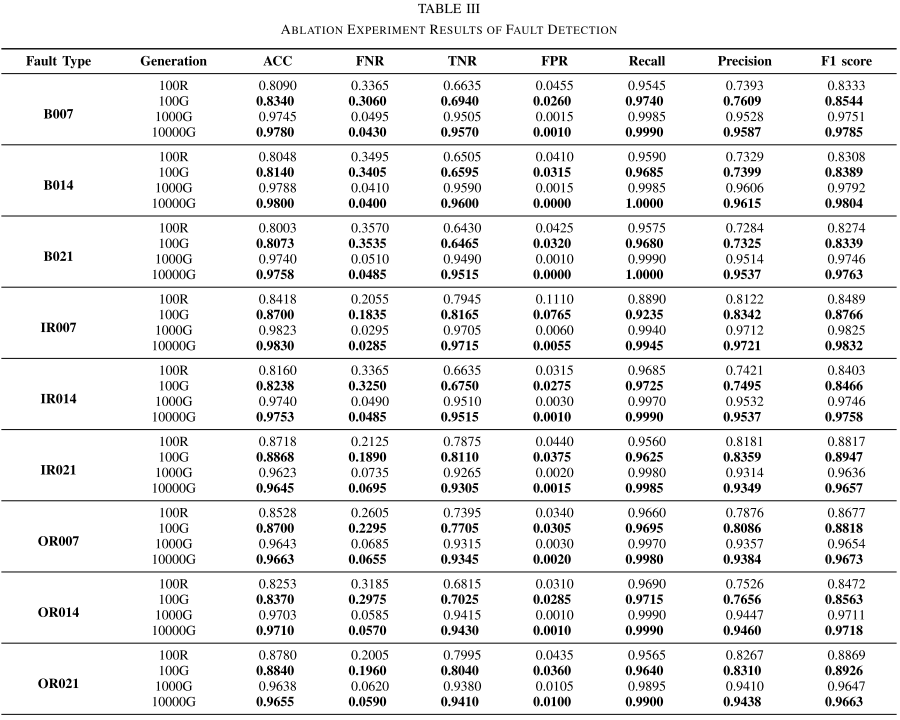
论文 Table III:不同生成样本规模下的故障检测结果
论文将 Table III 称为 ablation experiment,不过严格来说,它更接近"生成数据量消融":对 CWRU 的 9 类故障分别比较 100 个真实样本、100/1000/10000 个生成样本。以 B007 为例,100 个真实样本时 ACC = 80.90% 、F1 = 83.33% ;使用 100 个生成样本时已经提升到 ACC = 83.40% 、F1 = 85.44% ;扩大到 1000 个生成样本后达到 ACC = 97.45% 、F1 = 97.51%。
更重要的是边际收益开始饱和。B007 从 100 个生成样本增加到 1000 个时,ACC 和 F1 分别提升 14.05 和 12.07 个百分点;从 1000 增加到 10000 时,却只再提升 0.35 和 0.34 个百分点。作者据此指出,当生成数据超过原始数据约 10 倍后,继续扩充带来的提升会明显减弱。
5.4 故障分类:时间序列和图像两条路线都受益
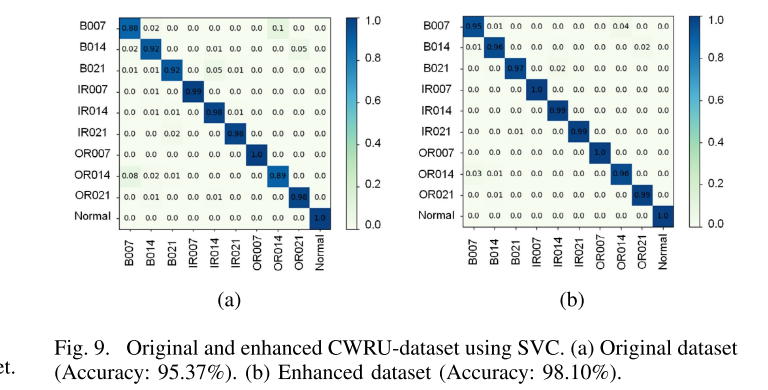
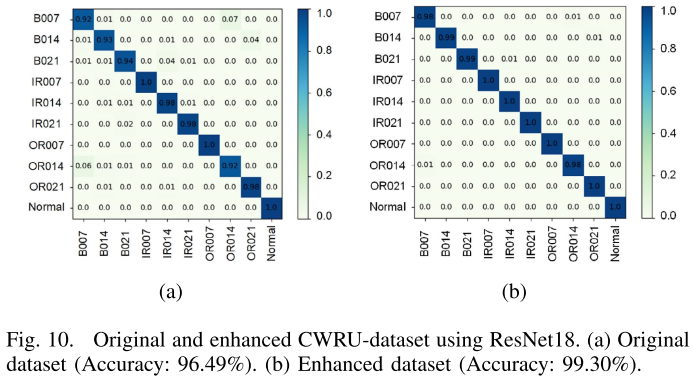
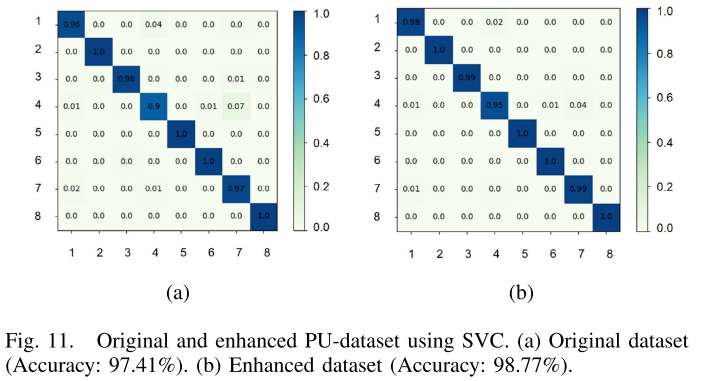
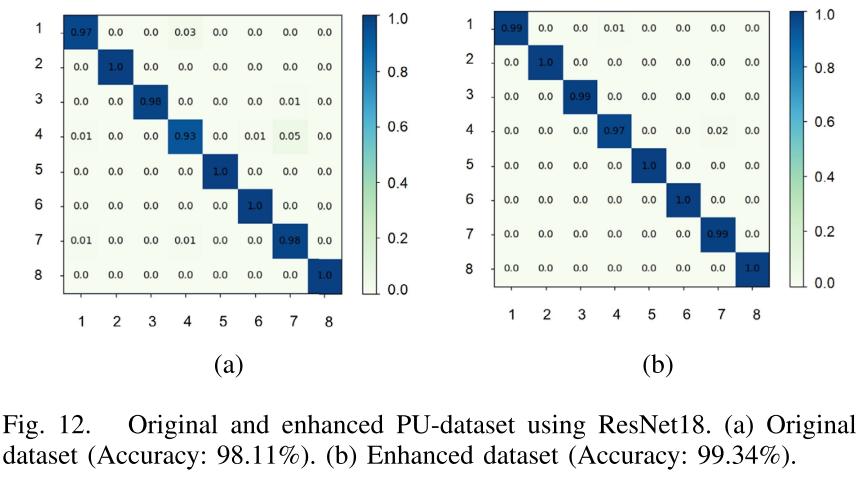
论文 Figure 9--12:CWRU/PU 原始数据与增强数据在 SVC、ResNet18 下的混淆矩阵
CWRU 上,SVC 的分类准确率由 95.37% 提升到 98.10% ,ResNet18 由 96.49% 提升到 99.30%。这说明 TSM 扩充的时间序列和 IMM 扩充的花瓣图都能够改善下游分类。
PU 上,Figure 11 和 Figure 12 图注给出的结果分别是:SVC 从 97.41% 提升到 98.77% ,ResNet18 从 98.11% 提升到 99.34%。需要注意的是,论文正文此处出现了与图注不一致的数字,重复写成了 CWRU 的 98.10% 和 99.30%;这里按照 Figure 11/12 的图中标注解读。
从四组混淆矩阵可以看到,增强数据后的对角线更加集中,说明错误类别之间的混淆减少。论文因此证明了一个较完整的证据链:生成样本在 IEI/TEI 上通过质量筛选,随后又在 PCA 检测、SVC 时间序列分类和 ResNet18 图像分类三个不同下游任务上得到改善。
六、总结与思考
如果把这篇论文压缩成一句话:MMFSL 用 GAN 分别扩充振动时间序列和其二维花瓣图,再用 TEI/IEI 把低质量生成样本挡在诊断模型之外,从而缓解工业轴承少样本和类别不平衡问题。
它最值得借鉴的并不是"GAN + 轴承诊断"这个组合,而是三个层次的闭环设计:首先通过双模态获得更多样的信息表达;其次把生成数据质量评价作为独立模块,而不是默认"生成出来就能用";最后用故障检测与故障分类两个任务验证扩充数据的实际价值。尤其是 Table II 中误报率的大幅下降,说明这种数据增强对过程监测的意义不仅体现在分类精度。
从方法设定上看,MMFSL 更接近 few-shot data augmentation + conventional diagnosis,而不是典型的 meta-learning 式 Few-Shot Learning。它的优势是工程路径清晰、可直接接入已有 PCA/SVC/CNN 模型;代价是效果高度依赖生成数据与真实分布的一致性,而目前的 IEI/TEI 仍主要基于相似度和误差指标。
论文也给出了两个明确的后续方向:一是工业现场可能需要声学、频谱等更多传感器模态,如何把这些异构数据纳入类似的二维表示与生成框架仍待研究;二是本文只覆盖 few-shot 场景,真正没有目标类样本的 zero-shot 情况仍需要借助迁移学习。再结合 Table III 的结果可以看到,生成数据也不是越多越好,超过约 10 倍后边际收益明显下降。因此,MMFSL 最核心的启示不是无限扩充数据,而是在小样本条件下建立"生成质量---数据规模---下游性能"之间可验证的闭环。