目录
文章目录
- 目录
- [一、Strands Agents 概述](#一、Strands Agents 概述)
-
- [strands-agents 开源组织](#strands-agents 开源组织)
- [harness-sdk 代码仓库](#harness-sdk 代码仓库)
- 二、软件架构与核心概念
-
- [2.1 strands-py 子目录的五层结构](#2.1 strands-py 子目录的五层结构)
- [2.2 核心概念清单](#2.2 核心概念清单)
- [2.3 Agent Loop 核心](#2.3 Agent Loop 核心)
- [2.4 支持 4 种能力扩展方式](#2.4 支持 4 种能力扩展方式)
- [三、strands-agents 功能与用法(SDK 层)](#三、strands-agents 功能与用法(SDK 层))
-
- [3.1 环境与安装](#3.1 环境与安装)
- [3.2 最小可运行示例](#3.2 最小可运行示例)
- [3.3 模型 provider](#3.3 模型 provider)
- [3.4 自定义工具与内置工具](#3.4 自定义工具与内置工具)
- [3.5 会话的持久化方式](#3.5 会话的持久化方式)
- [3.6 记忆](#3.6 记忆)
- [3.7 上下文管理](#3.7 上下文管理)
- [3.8 Hook 与 Plugin:单点挂载与能力打包](#3.8 Hook 与 Plugin:单点挂载与能力打包)
- [3.9 多 Agent](#3.9 多 Agent)
- [3.10 可观测性](#3.10 可观测性)
- [四、harness 层](#四、harness 层)
- 五、一次模型调用前发生了什么
-
- [5.1 请求上下文对象](#5.1 请求上下文对象)
- [5.2 观测最终 prompt 的方式](#5.2 观测最终 prompt 的方式)
- [六、自建 RAG](#六、自建 RAG)
-
- [6.1 两个接入点](#6.1 两个接入点)
- 七、一个入门示例
- 参考引用
一、Strands Agents 概述
2025 年 5 月 16 日,AWS 正式开源了 Strands Agents,采用 Apache License 2.0 许可。这个项目在开源之前,Amazon Q Developer、AWS Glue 与 VPC Reachability Analyzer 三个产品线已经在生产环境使用它。
Strands Agents 是一个 SDK 而不是一个平台。用于帮助开发者快速构建属于自己的 Agent Loop 应用程序,提供包括:生命周期控制(轮次上限、token 预算、取消、停止原因)、工具与结构化输出、MCP、多 Agent 模式、记忆与会话、模型可移植性、流式输出、护栏、链路追踪与评测等框架能力。
strands-agents 开源组织
strands-agents 组织下现有 13 个仓库,按活跃状态与星标数列表如下:
-
harness-sdk:项目核心 SDK 仓库。
-
agent-builder:适合作为如何用 SDK 写一个终端 Agent 的读码材料。
| 仓库 | 定位 | 状态 |
|---|---|---|
harness-sdk |
单体仓库:Python SDK、TypeScript SDK、harness、CLI、MCP server、文档站 | 活跃 |
tools |
工具集,发布为 strands-agents-tools |
活跃 |
agent-sop |
自然语言描述的标准作业流程 | 活跃 |
samples |
示例 Agent 集合 | 活跃 |
sdk-typescript |
原 TypeScript SDK 仓库 | 已归档 |
agent-builder |
示例性质的终端 Agent | 已归档 |
mcp-server |
文档 MCP Server | 已归档 |
shell |
Rust 实现的 Agent 虚拟 shell | 活跃 |
evals |
评测框架 | 活跃 |
docs |
原文档仓库 | 已归档 |
devtools |
组织级 CI 工作流 | 活跃 |
extension-template |
扩展发布模板 | 活跃 |
.github |
组织级配置 | 活跃 |
harness-sdk 代码仓库
harness-sdk 仓库内部共十个子目录:
| 子目录 | 语言与工具链 | 职责 | 发布物 |
|---|---|---|---|
strands-py/ |
Python,hatch | Python SDK:Agent 循环、模型 provider、工具 | PyPI strands-agents |
strands-ts/ |
TypeScript,npm | TypeScript SDK,职责与上一行对等 | npm @strands-agents/sdk |
harness-py/ |
Python | 组装层,提供 create_harness() |
PyPI strands-harness |
harness-ts/ |
TypeScript | 组装层,提供 createHarness() |
npm @strands-agents/harness |
strands-cli/ |
TypeScript | 终端命令行,命令名 strands |
npm @strands-agents/cli |
strands-mcp/ |
Python | 文档 MCP Server | PyPI strands-agents-mcp-server |
site/ |
Astro / Starlight | strandsagents.com 文档站源码 | 不发布 |
team/ |
Markdown | 治理与跨 SDK 流程,含 designs/ 提案 |
不发布 |
test-infra/ |
TypeScript,CDK | 集成测试所需的 AWS 资源栈 | 不发布 |
.agents/ |
Markdown | 仓库自带的 agent skills | 不发布 |
前 6 个子目录构成了三层依赖,层与层之间的职责分工与适用场景如下。
注意:在 AWS Agent Infra 的语境中,harness 指的是把 SDK 的各项原语按一套默认值组装成成品 Agent 的那一层,它本身不提供新的原语,只提供装配决策。README 建议先用 harness,需要掌控循环时再下沉到 SDK。
| 层 | 包 | 提供什么 | 何时用它 |
|---|---|---|---|
| SDK 层 | strands-agents、@strands-agents/sdk |
Agent 类、模型 provider、工具系统、钩子、记忆、会话、上下文管理等全部原语 |
需要自己掌握 Agent 循环的装配,或默认值不适用 |
| harness 层 | strands-harness、@strands-agents/harness |
create_harness() 函数:一次调用得到一个已配好模型、工具、记忆、会话与上下文管理的 Agent |
需要一个开箱即用的通用 Agent,不打算自己调默认值 |
| 应用层 | @strands-agents/cli |
strands 命令行工具,在终端里与 harness Agent 对话,需要开箱即用的终端 Agent 时应使用。 |
原型验证与交互式使用 |
二、软件架构与核心概念
2.1 strands-py 子目录的五层结构
strands-py 是 Strands 的 Python SDK 子目录,内部可以分为五层。
| 层 | 子包 | 职责 |
|---|---|---|
| 应用层 | harness-py/(独立包) |
以 create_harness() 一次装好全部默认值 |
| 组件层 | memory/、session/、storage/、_context_manager/、injection/、interventions/、sandbox/、multiagent/、telemetry/、plugins/、vended_plugins/、vended_tools/ |
记忆、会话、存储、窗口管理、注入、干预、沙箱、多 Agent、可观测、插件与内置工具 |
| 循环层 | agent/、event_loop/、hooks/、background_tasks/ |
Agent 循环的推进、事件派发、钩子注册与触发 |
| 装配层 | _middleware/ |
构造并传递一次模型调用的请求上下文。整个上下文装配过程发生在这里。 |
| provider 层 | models/、types/ |
把统一的请求转成各厂商格式,把各厂商的流式块转回统一事件 |
2.2 核心概念清单
下面是 Components 术语表,并给出每个概念在 Python SDK 中的落点。
| 概念 | 职责 | 公开符号或入口 | 所属子包 |
|---|---|---|---|
| Agent loop | 推进 "模型调用、工具执行、回灌结果" 的循环 | Agent |
agent/、event_loop/ |
| Production lifecycle controls | 轮次上限、token 预算、取消、停止原因 | Agent 构造参数 |
agent/ |
| State | 一次会话内的键值状态 | Agent.state |
agent/ |
| Storage | 存储后端抽象 | storage |
storage/ |
| Snapshots | 会话状态的快照 | Snapshot |
types/_snapshot.py |
| Prompts | 系统提示与提示模板 | system_prompt= 构造参数 |
agent/ |
| Hooks、Hook events | 生命周期事件与回调注册 | HookProvider、HookRegistry |
hooks/ |
| Conversation management | 上一代的会话历史管理 | conversation_manager |
agent/conversation_manager/ |
| Context management | 现行的窗口预算与压缩 | ContextManager、Offload |
_context_manager/、experimental/ |
| Retry strategies | 模型调用的重试策略 | ModelRetryStrategy |
event_loop/_retry.py |
| Interrupts | 循环中断与恢复 | handoff_to_user 等 |
vended_tools/ |
| Models | 模型 provider 抽象与实现 | Model、BedrockModel 等 |
models/ |
| Tools | 工具定义、注册与执行 | @tool、ToolContext |
tools/ |
| Memory | 长期记忆的召回与写入 | MemoryStore、MemoryManager |
memory/ |
| Plugins | 把多个扩展点打包成一个组合单位 | Plugin、MultiAgentPlugin |
plugins/、vended_plugins/ |
| Interventions | 在关键动作前介入并决策 | InterventionHandler |
interventions/ |
| Sandbox | 工具执行的隔离环境 | Sandbox、PosixShellSandbox |
sandbox/ |
| Multi-agent | A2A、Agents as Tools、Swarm、Graph、Workflow | MultiAgentPlugin |
multiagent/ |
| Streaming | 流式输出 | Agent.stream_async |
event_loop/ |
| Voice | 语音与双向流式 | 需 bidi 可选依赖 |
bidi/ |
| Experimental | 实验性 API | strands.experimental |
experimental/ |
2.3 Agent Loop 核心
要理解一个 Agent 框架,最有效的切入点是它的循环有几步。
其中,第 4 步到第 9 步构成 Agent Loop 循环。当模型要求调用工具时,Agent 就执行工具并回到第 4 步;模型不再要求时,Agent 则跳到第 11 步结束。
| 顺序 | 事件 | 位置 |
|---|---|---|
| 1 | AgentInitializedEvent |
Agent 构造完成,整个生命周期一次 |
| 2 | BeforeInvocationEvent |
一次 invoke 开始,每个用户回合一次 |
| 3 | MessageAddedEvent |
有消息被追加进历史 |
| 4 | BeforeModelCallEvent |
一次模型调用之前 |
| 5 | AfterModelCallEvent |
一次模型调用之后 |
| 6 | BeforeToolsEvent |
本轮全部工具调用之前 |
| 7 | BeforeToolCallEvent |
单个工具调用之前 |
| 8 | AfterToolCallEvent |
单个工具调用之后 |
| 9 | AfterToolsEvent |
本轮全部工具调用之后 |
| 10 | MessageUpdatedEvent |
已有消息被修改。普通 Agent 不触发该事件,唯一的触发点在双向流式 Agent |
| 11 | AfterInvocationEvent |
一次 invoke 结束 |
2.4 支持 4 种能力扩展方式
Strands 提供了四种能力扩展方式:
| 形态 | 定义 | 谁触发它 | 能改写什么 | 典型实现 |
|---|---|---|---|---|
| 工具(Tool) | 暴露给模型、由模型决定是否调用的函数 | 模型 | 不改写上下文,只产生 toolResult |
@tool 装饰的函数、shell、file_editor |
| 钩子(Hook) | 注册在某个生命周期事件上的回调 | 框架,到达该事件时 | 事件对象上白名单内的字段 | HookProvider 实现 |
| 插件(Plugin) | 把工具、钩子、注入器等多个扩展点打包成一个单位 | 构造 Agent 时装入 | 取决于它内部含哪些扩展点 | AgentSkills、ContextInjector、ContextOffloader |
| 干预(Intervention) | 在关键动作前介入,可阻止或改写该动作 | 框架,到达受控动作时 | 该动作是否执行 | 官方自带两项,HumanInTheLoop 与 CedarAuthorization |
单 Agent 有 11 个生命周期事件,多 Agent 另有 5 个。各事件可写的字段由一张白名单约束,固定了哪个时机能改什么。与上下文工程直接相关的有以下 4 个:
| 事件 | 时机 | 能做什么 |
|---|---|---|
BeforeModelCallEvent |
调用模型之前 | 写 cancel 做预算熔断,可读 projected_input_tokens |
AfterModelCallEvent |
模型返回之后 | 写 retry 做溢出重试,上限 3 次 |
AfterToolCallEvent |
工具返回之后 | 主动把大结果移入转存区,即 ContextOffloader 的挂点 |
InvokeModelStage(中间件,非事件) |
请求装配期 | 注入与记忆召回挂在这里的 Input 相位 |
三、strands-agents 功能与用法(SDK 层)
本章的代码按 Python SDK 直接构造 Agent,不经 create_harness()。
3.1 环境与安装
官方把 harness 作为推荐入口,把 SDK 作为需要掌控细节时才选用的手段。
harness 层,开箱即用的成品 Agent。
bash
pip install strands-harnessSDK 层,定制自己的 Agent。
bash
pip install strands-agents strands-agents-tools3.2 最小可运行示例
先给出 SDK 层的最小示例:
python
from strands import Agent
from strands_tools import calculator

agent = Agent(tools=[calculator])
agent("What is the square root of 1764")agent(...)是同步入口,在异步程序里应当用await agent.invoke_async(...)。- 未指定
model时默认值指向 Bedrock。默认模型 ID 为 global.anthropic.claude-sonnet-4-6。 - tools 接受多种形态,既可以传函数对象,也可以传字符串路径或工具提供者。本示例传的是从
strands_tools导入的函数对象。 - 还有一处默认值须在此指出,
conversation_manager不传时默认为 SlidingWindowConversationManager。也就是说,上面这四行代码虽未作任何上下文配置,框架内部已有一个滑动窗口在裁剪历史。它与ContextManager是两套机制,不可混为一谈。
3.3 模型 provider
Strands 支持的 provider 包括:直接导入的 BedrockModel ,懒加载的AnthropicModel、GeminiModel、LiteLLMModel、LlamaAPIModel、LlamaCppModel、MistralModel、OllamaModel、OpenAIModel、OpenAIResponsesModel、SageMakerAIModel、WriterModel。后者直到真正用到时才加载。
python
from strands import Agent
from strands.models.anthropic import AnthropicModel

model = AnthropicModel(
    client_args={"api_key": "<KEY>"},
    model_id="claude-sonnet-4-5",
    max_tokens=4096,
)
agent = Agent(model=model)- 所有 provider 的构造形态是统一的:
__init__(self, *, client_args=None, **model_config),即厂商客户端参数与框架模型配置分两处传,前者透传给 provider SDK,后者是框架定义的TypedDict。 - 上例中
AnthropicConfig的七个字段里,max_tokens与model_id为必填,其余选填。 - 窗口上限是模型层的配置项,不是 Agent 层的。这意味着:预算管理的分母由 provider 决定,而不是由上下文管理器决定。
provider 的前缀缓存 CacheConfig 是一个五字段的 dataclass。其中 ttl 字段的 docstring 有一句原文:Bedrock 要求缓存检查点的 TTL 在 toolConfig、system、messages 三段之间不得递增,并会拒绝短 TTL 之后出现长 TTL 的请求。
另有一处默认值需注意:system_prompt_ttl 默认为 True,即只要启用了 cache_config,系统提示词这一段会自动加上缓存点,无需手工放置。
而 cache_key 未设时按 strands-<session_id> 派生,前提是 Agent 配了会话管理器。这两条默认值意味着,会话管理器的有无,会间接影响缓存命中率。
python
@dataclass
class CacheConfig:
    strategy: Literal["auto", "anthropic"] = "auto"   # :166
    ttl: str | None = None                            # :167
    system_prompt_ttl: bool | str = True              # :168
    cache_key: str | Literal[False] | None = None     # :169
    tools_ttl: bool | str | None = None               # :170
3.4 自定义工具与内置工具
自定义一个工具只需 @tool 装饰器。框架自带的示例写法如下。
该装饰器会从 docstring 与类型注解中提取名称、描述与参数;生成用于入参校验的 JSON Schema;同时支持普通函数调用与工具调用两种调用形态;错误处理与结果格式化;同时适用于独立函数与类方法。
python
from strands import Agent, tool

@tool
def my_tool(param1: str, param2: int = 42) -> dict:
    """Tool description - explain what it does.

    Args:
        param1: Description of first parameter.
        param2: Description of second parameter (default: 42).

    Returns:
        A dictionary with the results.
    """
    result = do_something(param1, param2)
    return {"status": "success", "content": [{"text": f"Result: {result}"}]}

agent = Agent(tools=[my_tool])
agent.tool.my_tool(param1="hello", param2=123)- 工具的描述与参数说明来自 docstring,而这段文本会随工具定义一起进入每一次模型输入。因此它既是给人读的文档,也是给模型读的指令。
- 示例最后一行
agent.tool.my_tool(...)展示的是绕过模型直接调用了工具,用于测试与程序化调用。
而内置工具在 strands.vended_tools 下,共七组,每组同时提供成品函数与工厂函数:
| 工具 | 成品 | 工厂 | 说明 |
|---|---|---|---|
| 文件编辑 | file_editor |
make_file_editor |
|
| 交还控制权 | handoff_to_user |
make_handoff_to_user |
|
| HTTP 请求 | http_request |
make_http_request |
|
| MCP 路由 | 无 | make_mcp_router |
只提供工厂 |
| 笔记本 | notebook |
make_notebook |
以 Agent.state 为后端,作用域为会话。例如:模型可以主动把中间结论写到窗口外并在后续轮次取回。 |
| Shell | shell |
make_shell |
每次调用都在新 shell 中执行,状态不跨调用保留。意味着凡需要跨调用的环境状态(当前目录、环境变量)都必须由上下文显式携带,不能依赖 shell 自身记住。 |
| 休眠 | sleep |
make_sleep |
另有两项懒加载工具:web_fetch(需 web-fetch 可选依赖)与 make_a2a_client(需 a2a 可选依赖)。
注意,需要再次区分的是:strands.vended_tools 是框架自带的内置工具,strands_tools(包名 strands-agents-tools)是独立的第三方工具包,两者并非同一套实现。
3.5 会话的持久化方式
会话持久化,用于把信息从窗口内移到窗口外,并保留取回的线索。Strands 在同一个 session 子包里提供了两套不同的持久化模型。
| 对照项 | 消息仓库式 RepositorySessionManager |
快照式 SnapshotSessionManager |
|---|---|---|
| 持久化单元 | Session、SessionAgent、SessionMessage 三类记录,一条消息一个 JSON |
整个 Agent 捕获为一个 Snapshot,序列化为 UTF-8 的 JSON 字节 |
| 模式版本 | 无 schema 版本字段,只有时间戳 | 带 schema_version,版本或 scope 不符即抛 SnapshotException |
| 存储后端 | FileSessionManager(默认 ~/.strands/sessions/)与 S3SessionManager,自定义后端须实现 SessionRepository |
统一的 Storage 协议,已有 LocalFileStorage(默认 ./.strands/)、S3Storage、InMemoryStorage |
| 写入时机 | 沿用基类钩子,MessageAddedEvent 与 AfterInvocationEvent,消息写入恒发生,仅 Agent 级写入带变更检测 |
三档策略可调(save_latest_on 取 invocation、message、trigger),另在 snapshot_trigger 返回真时追加一份不可变快照 |
| 恢复内容 | 消息、state、conversation_manager 状态、中断与模型状态,并修复 toolUse 与 toolResult 的配对断裂 |
上述各项之外另含 system_prompt |
| 回到任意历史检查点 | 不支持,接口只有单条消息的增删改查与分页列举 | 支持,list_snapshot_ids 配 restore_snapshot,快照键取 UUIDv7,字典序即创建序,故无须另建索引 |
| 卸载内容是否随会话持久化 | 不持久化。该管理器不使用统一 Storage,检测到 Agent 级 storage 时只给一次告警并建议改用快照式 |
持久化。stash 落在持久存储上时快照内只写一条外部引用,落在易失存储上时整批条目内联进快照 |
| 消息级能力 | 支持按 offset 与 limit 分页读取,每条消息有独立时间戳与 redact_message |
整体覆写,单条消息无独立元数据 |
| 一个会话内多个 Agent | 显式支持,按 agent_id 分目录或分前缀,并强制同会话内唯一 |
按 agent_id 分键,但单个实例只保留一个 stash 槽位,后初始化的 Agent 会覆盖前者 |
| 双向流式 Agent | 无相关代码 | 有专门的保存策略与钩子,处理「先追加占位消息、完成后替换」的情形 |
| 官方定位 | 模块文档称其为较旧的消息日志式实现 | 模块文档称其为新 Agent 的推荐路径 |
据此,选择依据有两条。
- 需要检查点回溯、需要把上下文管理器卸载出去的内容一并持久化、或需要与统一存储及双向流式配合时,宜用快照式。
- 需要按消息分页读取与逐条审计、或需要一个会话内承载多个 Agent 并由框架强制
agent_id唯一时,宜用仓库式。AgentCore 的AgentCoreMemorySessionManager继承的是仓库式,故它同样不处理 stash。
消息仓库式 :以 RepositorySessionManager 配 SessionRepository 抽象。实现了本地文件与 AWS S3 两种:
FileSessionManager(session_id, storage_dir=None)的两个参数都有约束:session_id不得包含路径分隔符;storage_dir不传时默认落在用户私有目录~/.strands/sessions/。
python
from strands import Agent
from strands.session import FileSessionManager

agent = Agent(session_manager=FileSessionManager(session_id="demo-001"))
agent("记住我偏好简洁的回答")
快照式 :SnapshotSessionManager 把整个 Agent 序列化为一个版本化的 Snapshot 二进制块:
- 可变的
snapshot_latest每次保存覆写,用于崩溃或重启后恢复; - 当
snapshot_trigger触发时,追加一份不可变快照(键按时间排序),用于检查点与回到任一历史状态,而不只是最近状态。
SnapshotTrigger 是一个带 **kwargs 的 Protocol(协议类,Python 用于按方法签名而非继承关系判定类型的结构化接口),以便日后追加可选关键字参数而不破坏既有实现。
python
class SnapshotTrigger(Protocol):
def __call__(self, *, agent_data: LocalAgent, **kwargs: Any) -> bool: ...两套模型的下方是同一个存储原语。Storage 是一个最小接口,所有需要持久化的 SDK 子系统都使用这一接口。
- 支持 3 种后端三项:
InMemoryStorage、LocalFileStorage、S3Storage。 - 接口上有五个方法:
write、read、delete、list、search,前四个为抽象声明,第五个带默认实现。 - 两个组合能力:
namespace(prefix)返回带前缀的存储视图且可嵌套,for_sandbox(sandbox)。
python
from strands.storage import LocalFileStorage

storage = LocalFileStorage("./.strands/")
await storage.write("sessions/abc/snapshot.json", data)
存储抽象层的好处是:会话、记忆与上下文转存可以共用一个后端实例。对上下文工程而言,这意味着写入与召回的链路是收敛的,不需要为每个子系统各配一套存储。
3.6 记忆
记忆是 memory 子包,可按职责分三组。
| 组别 | 职责 | 主要符号 |
|---|---|---|
| 管理与配置 | 装入 Agent、读写记忆 | MemoryManager、MemoryManagerConfig、MemoryEntry |
| 抽取 | 决定何时、从哪些消息中提炼出记忆 | Extractor、ModelExtractor、ExtractionConfig、ExtractionTrigger |
| 召回与注入 | 决定何时、以什么形式把记忆放回上下文 | InjectionConfig、InjectionTrigger、IntervalTrigger、InvocationTrigger、MemorySearchOptions、MemoryMessageFilter |
| 存储 | 记忆落到哪里 | MemoryStore、MemoryStoreConfig |
记忆写入
记忆的装入方式与会话类似,走独立参数位。
python
from strands import Agent
from strands.memory import MemoryManager
from strands.vended_memory_stores import FileMemoryStore

agent = Agent(
    memory_manager=MemoryManager(
        stores=[
            FileMemoryStore(name="user-prefs"),                    # 个人材料,可写
            FileMemoryStore(name="product-kb", writable=False),    # 公共材料,只读
        ]
    )
)
第一个参数是列表 stores: listMemoryStore,即框架在接口层面就假定记忆分多个库,库名不得重复、至少一个,且每个库自带 writable 开关(默认 True)。上例中个人偏好库可写,产品知识库只读,模型的写入工具不会污染公共材料。
另外三个配置参数的默认值需要记住:
search_tool_config=True:默认自动注册一个名为search_memory的工具,即记忆召回默认由模型主动发起,而不是框架每轮强制注入。传MemoryToolConfig可改名改描述,传False关闭。add_tool_config=False:写入工具默认关闭。 置True才允许模型向所有可写库写入。这个默认值是保守的,意味着开箱状态下记忆只读不写。injection=True:默认启用记忆注入。召回的记忆注入与上下文注入走的是同一机制,都是 "只进当轮输入、不落历史",每轮变化的内容只能在尾部追加。
开箱可用的记忆后端有 3 项,且其中一项是测试用途:FileMemoryStore、BedrockKnowledgeBaseStore、TestMemoryStore。因此生产可选项实为两项,一项落本地文件,一项接 Bedrock 知识库。要接自建的向量库或图数据库,须自行实现 MemoryStore。
记忆召回
记忆检索开箱支持关键词检索类型,Storage.search(query) -> list[StorageSearchResult] 的返回值 StorageSearchResult 提供了字段: key、score、data。还有检索策略 SearchStrategy 支持两种实现:
KeywordSearchStrategy,该策略按 token 重叠打分;Bm25SearchStrategy基于 SQLite FTS5 维护倒排索引并按 BM25 打分,计入词频、逆文档频率与文档长度归一化。
但向量检索类型需要自行实现,唯一的现成向量检索路径是把后端换成 BedrockKnowledgeBaseStore,由 Bedrock 知识库在服务端完成嵌入与检索。
按检索链路五环节逐一对照:
| 环节 | Strands 的覆盖情况 | 依据 |
|---|---|---|
| 切分 | 未提供抽象 | 全包无对应符号 |
| 索引 | 提供全文索引,未提供向量索引 | Bm25SearchStrategy 维护 SQLite FTS5 倒排索引 |
| 召回 | 提供接口与两种词面实现 | Storage.search:177、SearchStrategy 协议 |
| 重排 | 提供分值口径,未提供重排模型 | StorageSearchResult.score 要求距离转相似度、结果按相关性降序 |
| 组装 | 提供 | ContextInjector 与记忆注入配置,见本篇第五章 |
即五个环节中,Strands 完整覆盖召回与组装两环,部分覆盖索引与重排两环,完全不覆盖切分一环。
记忆存储
MemoryStore 是一个 Protocol,不是基类,因此接入自建的记忆或检索系统无需继承任何父类,只要形状对上即可。
- 方法里只有
search()是必需的 ,add/add_messages/initialize/get_tools都可选; - 五个配置属性全是必需的 :
name/description/max_search_results/writable/extraction。
最小可用的 store 形如下例:
python
class TicketMemoryStore:
    """只实现 search() 的最小 store:五个配置属性是必需的。"""

    name = "ticket-history"
    description = "当前客户的历史工单"
    max_search_results = 5
    writable = False
    extraction = False

    async def search(self, query, options=None):
        return [
            MemoryEntry(content="该用户是 VIP 会员,偏好邮件回复。",
                        store_name=self.name),
        ]


agent = Agent(
    system_prompt="你是一个电商客服助手。",
    plugins=[MemoryManager(stores=[TicketMemoryStore()])],
)
既然方法可选,框架怎么知道某个 store 到底实现了哪些?做法是 _has_method(),它做的是身份比对 :把 store 上的方法与 Protocol 上的默认实现比对,如果是同一个对象,就算未实现。也就是说,若只重写了 search,那些继承下来的默认方法一律被判定为未实现。
就这么一行 MemoryManager(stores=[TicketMemoryStore()]),每个用户回合都会自动召回并注入。格式是 <memory> 包一组 <entry>:
xml
<memory>
<entry source="ticket-history">该用户是 VIP 会员,偏好邮件回复。</entry>
<entry source="ticket-history">3 天前购买了一台咖啡机,尚未拆封。</entry>
</memory>多租户隔离应当如何实现?惯用做法是每个用户一个 store 实例 ,或者由 store 自己在内部按某个 id 分区。无论采用哪一种,隔离责任都落在使用方,不在框架。
3.7 上下文管理
Agent 与上下文窗口管理有关的参数有两个:conversation_manager 与 context_manager。前者是老一代接口,后者是新一代接口,二者并存只是为了兼容。新写的代码宜用后者。
配置
context_manager 支持 2 种方法配置。
- 整体预设方法:只有两个取值,差别只有两处:裁剪阈值相差 5.3 倍,摘要时机一个提前一个等溢出。实践经验:工具密集型负载不宜提前裁剪工具结果,因为后续推理往往还要回看原始输出。
python
from strands import Agent

agent = Agent(context_manager="agentic")| 预设 | 工具结果裁剪 | 摘要时机 | 适用判断 |
|---|---|---|---|
"auto" |
超过 1500 token 裁剪为 750 token 预览 | 利用率达 85% 时整体摘要,保留最近 4 条 | 对话类负载,倾向于提前压缩 |
"agentic" |
超过 8000 token 才裁剪 | 利用率达 1.0 即溢出时才摘要,保留最近 4 条 | 工具密集型负载,倾向于保留原始结果 |
- 策略预设方式 :有 4 个取值(
proactive_summarization、large_tool_offloading、overflow_protection、stale_tool_cleanup),它们不是整体预设的取值,而是可以混进策略列表里的单条策略的简写。策略列表可以与Offload.*实例混排:
python
from strands import Agent
from strands.experimental.context_manager import Offload

agent = Agent(
    context_manager={
        "strategies": [
            "stale_tool_cleanup",                                      # 预设串:丢弃 5 条消息以前的工具结果
            Offload.truncate("tool_results", {"preview_tokens": 1000}).when(threshold=2500),
            Offload.summarize("*").when(utilization=0.7, preserve_recent=0.7),
        ],
        "stash": False,
    }
)
注意,策略预设的名字是固定的,例如 stale_tool_cleanup,但是它的展开(阈值、方法、条件)属于内部默认值,版本间可能会改变。因此,如果你需要固定配置时应直接写 Offload.*。也就是说,预设串适合快速起步,而生产配置宜写成显式形式,避免框架调整默认阈值时行为静默改变。
ContextManager 还默认支持 L1 暂存区(stash)功能,当后端为 InMemoryStorage() 时会自动注册一个名为 retrieve_context 的工具,供模型按引用键取回被裁剪掉的内容。上面示例里的 "stash": False 即关闭该能力。这块暂存区使得超长而被裁剪的内容不是被丢弃,而是被转存到上下文窗口之外,并留一个模型可调用的取回通道。
注入
ContextInjector 让稳定的内容进系统提示,每轮变化的内容追加在当轮输入的尾部。
python
from strands import Agent
from strands.vended_plugins.context_injector import ContextInjector

agent = Agent(
    system_prompt="你是一个电商客服助手。回答必须给出依据。",
    plugins=[
        ContextInjector(
            lambda ctx: "当前时间:2026-10-03 10:00,客服工号 A-17。",
            name="runtime-facts",
        ),
    ],
)
为了充分利用推理服务的前缀缓存能力,注入不改写原文,而是是在最后一条 user 消息的尾部追加独立的文本块,每块使用前缀 \n\n,顺序即注入的顺序。记忆块排在最后,如下:
user:
    '这个咖啡机能退货吗?退货要运费吗?'
    '\n\n当前时间:2026-10-03 10:00,客服工号 A-17。'
    '\n\n<memory>\n<entry source="ticket-history">该用户是 VIP 会员,偏好邮件回复。</entry>\n...</memory>'
另外,一轮结束后 agent.messages 里只有原始的 user 文本,没有任何注入块。也就是说注入是纯临时的(ephemeral),每轮重新生成,不会在历史里越积越多。分隔符是条件性的 "\n\n",只在目标消息已有内容且注入文本不以换行开头时才加。原因是有些 provider 会把相邻的文本块直接拼接,不加分隔就会和用户原话连成一句。
ContextInjector 默认的触发时机是 trigger="userTurn",含义是每个用户回合触发一次(一次问答) 。因为一轮之内 query 没有变化,重复检索既浪费又无益。但若注入内容随运行时状态变化(例如剩余预算、剩余重试次数),就必须显式改成 everyTurn,就是每次调用大模型 API 触发一次。
压缩
ContextManager 是 Plugin 子类,但不用装饰器,而在 init_agent 内注册了三个回调。
| 事件 | 做什么 |
|---|---|
MessageAddedEvent |
把新消息原文写入 stash,只记录不裁剪 |
BeforeModelCallEvent |
主动压缩的实际发生处 ,以 projected_input_tokens 跑整条策略流水线 |
AfterModelCallEvent |
溢出恢复,仅当异常为 ContextWindowOverflowException 时重跑流水线并置 retry = True,上限三次 |
可以看出它们并不平均分布,集中在模型调用前后与工具调用前后这四个位置。
3.8 Hook 与 Plugin:单点挂载与能力打包
Hook
Hook 的用法是实现 HookProvider 协议,在 register_hooks 里把回调注册到具体事件类上。所以 Hook 会在 Agent 的运行期按事件触发。
python
from strands import Agent
from strands.hooks import HookProvider, HookRegistry
from strands.hooks.events import AfterInvocationEvent, BeforeInvocationEvent


class LoggingHooks(HookProvider):
    def register_hooks(self, registry: HookRegistry) -> None:
        registry.add_callback(BeforeInvocationEvent, self.log_start)
        registry.add_callback(AfterInvocationEvent, self.log_end)

    def log_start(self, event: BeforeInvocationEvent) -> None:
        print(f"Request started for {event.agent.name}")

    def log_end(self, event: AfterInvocationEvent) -> None:
        print(f"Request completed for {event.agent.name}")


agent = Agent(hooks=[LoggingHooks()])
Plugin
Plugin 的用法不同。它是抽象基类,约定了 4 件事:
- 抽象属性
name作为稳定标识; hooks属性自动收集类里面被@hook装饰的方法;tools属性自动收集类里面被@tool装饰的方法;init_agent(agent)为可选的初始化钩子。
python
from strands import Agent, tool
from strands.hooks import BeforeModelCallEvent
from strands.plugins import Plugin, hook


class MyPlugin(Plugin):
    name = "my-plugin"

    @hook
    def on_model_call(self, event: BeforeModelCallEvent):
        print(f"Model called: {event}")

    @tool
    def my_tool(self, param: str) -> str:
        """A tool that does something."""
        return f"Result: {param}"


agent = Agent(plugins=[MyPlugin()])
此外有两点使用约定需要交代。
- 基类把
name声明为抽象 property,而框架自带的示例用类属性直接赋值,两种写法都可行,后者更简洁。 - 装饰方法按声明顺序注册,父类先于子类,子类覆盖父类同名方法时只注册子类版本。涉及顺序敏感的改写时,这条约定必须纳入考虑。
Plugin 的生效时机分两步展开。
- 第一步在
Plugin.__init__内扫描自身,把带装饰器的方法与工具分别收进_hooks与_tools两个字典,此时还不与任何 Agent 关联。 - 第二步由
_PluginRegistry.add_and_init挂到 Agent 上,依次执行查重、调用init_agent、注册回调、注册工具。该方法的全部调用点都在Agent.__init__体内,因此 Plugin 带来的工具是在构造期进入工具注册表的,不是首轮才注册。
应用场景
那么,何时选 Hook,何时选 Plugin?判断依据有两条:
- 要挂的回调只有一两个,且不附带工具与状态,用 Hook。
HookProvider的实现成本更低,也不必想一个稳定的name。 - 一项能力由 "若干回调 + 若干工具 + 一份初始化逻辑" 共同构成,用 Plugin。这是 Plugin 的设计意图:把一组协同工作的挂点打包成一个可整体装卸的单位。框架自己的实现也遵循这条标准,
ContextManager就是一个Plugin子类,内部名为strands:context-manager。
框架自带的 Plugin 在 vended_plugins/ 下,共有 5 个子包:
| 子包 | 主要导出 | 用途 |
|---|---|---|
context_injector |
ContextInjector |
每轮向模型输入尾部注入动态内容 |
context_offloader |
ContextOffloader、ShouldOffload |
拦截过大的工具输出并转存 |
goal |
GoalLoop、JudgeConfig、Validator |
目标驱动的循环与结果判定 |
skills |
AgentSkills、Skill |
按需加载的技能包 |
steering |
SteeringHandler、Guide、Interrupt |
运行中对模型与工具调用施加引导 |
3.9 多 Agent
multiagent 子包提供了 2 种编排模式:群体(Swarm)与图( GraphBuilder )。节点类型都是 AgentBase | MultiAgentBase,因此 Swarm 与 Graph 可以互相嵌套。
- 群体模式的构造很简单,传一组
Agent即可。每个节点都被注入了协调工具,即:由模型自己决定是否移交给其他节点。注意构造参数中description的作用,后文即可看到它会进入其他节点的输入。
python
from strands import Agent
from strands.multiagent import Swarm

swarm = Swarm(
    nodes=[
        Agent(name="data_analyst", description="Analyzes data and provides deeper insights"),
        Agent(name="code_reviewer", description="Reviews code for correctness"),
    ],
    max_handoffs=20,
    node_timeout=300.0,
)
result = swarm("My Python script is throwing a KeyError when processing JSON data")- 图模式用建造者式接口,节点间以边连接,边上可带条件函数:
python
from strands import Agent
from strands.multiagent import GraphBuilder

builder = GraphBuilder()
processor = builder.add_node(Agent(name="data_processor"), "data_processor")
validator = builder.add_node(Agent(name="validator"), "validator")
builder.add_edge(processor, validator)
builder.set_entry_point("data_processor")

graph = builder.build()
result = graph("Analyze the quarterly sales data and create a summary report")
本节主要关注一个与上下文工程直接相关的问题:跨节点时,上一个节点的上下文以什么形式传给下一个节点。
群体模式的 _build_node_input() 自带了输出样例,依次包 5 部分:移交说明、原始用户请求、经手过的节点序列、各节点贡献的共享知识、以及其余可协作节点的名称与描述。图模式同理。
共享状态一侧也是结构化的。SharedContext 的类型是 dict[str, dict[str, Any]],按节点 ID 分层,写入时对键作合法性校验、对值作 JSON 可序列化校验。
也就是说,节点之间交换的是结构化键值,不是自由文本。即:multi-agent 上下文隔离的实质不是 "把历史复制一份给下一个节点",而是 "每个节点一个独立窗口,边界上只过一份结构化摘要"。
两种模式都是这样做的。这条结论也给出了使用上的判断依据:若某个节点需要的信息没有出现在上述五部分之内,它就拿不到,必须显式写入共享上下文或移交说明,不能指望它 看得见前面发生了什么""。
3.10 可观测性
StrandsTelemetry 采用 OpenTelemetry 标准,在实例化时即初始化 tracer provider,exporter 需显式配置,支持链式调用:
python
from strands.telemetry import StrandsTelemetry

StrandsTelemetry().setup_console_exporter().setup_otlp_exporter()
OTEL 的 endpoint 通过 OTEL_EXPORTER_OTLP_ENDPOINT、OTEL_EXPORTER_OTLP_HEADERS、OTEL_SERVICE_NAME 三个标准环境变量指定。Metric 指标导出有 2 个开关,默认均为关闭。
框架自建了 10 个 span。
| span 名称 | 创建点 | 承载的内容 |
|---|---|---|
invoke_agent {name} |
agent/agent.py:1891 |
操作名、Agent 名、请求模型、工具名列表、工具定义、系统指令;结束时写入五项 gen_ai.usage.* 与缓存 token |
execute_event_loop_cycle |
event_loop/event_loop.py:279 |
本轮 id 与父轮 id、本轮消息、工具结果 |
chat |
event_loop/event_loop.py:730 |
完整的消息列表与完整的系统提示词,结束时写入 token 用量、缓存读写量与首 token 延迟 |
execute_tool {name} |
tools/executors/_executor.py:106 |
工具名、调用 id、入参、执行状态、返回结果 |
invoke_graph、invoke_swarm |
multiagent/graph.py:670、multiagent/swarm.py:443 |
多 Agent 编排的外层 span,SpanKind 为 CLIENT |
memory.search、memory.add、memory.inject、memory.extract |
记忆子系统内部 | 检索、写入、注入与抽取各自的入参与结果 |
其中,与上下文工程最相关的观测指标是上下文窗口占用情况。Strands 把它做成了一等属性:
python
from strands import Agent

agent = Agent()
result = agent("总结一下这个仓库的目录结构")

print(result.context_size)            # 最近一次模型调用实际处理的 prompt token 数
print(result.projected_context_size)  # 据此推算的下一次调用输入量
print(result.metrics.accumulated_usage)-
context_size:最近一次模型调用实际处理的完整 prompt token 数,含缓存命中部分; -
projected_context_size:在 context_size 之上加本轮生成的输出,用以近似下一次调用的输入量。
完备的观测指标可以用于实现以下功能:
- 用量与延迟。 五项
gen_ai.usage.*加缓存读写 token 与首 token 延迟,可用于核算成本与评估缓存命中率。缓存读取量占输入量的比例是判断提示词前缀是否稳定的直接指标。 - 对话内容。
chatspan 记录完整消息列表与系统提示词,execute_toolspan 记录工具入参与结果,两者合起来可以把任意一轮的上下文原样回放。排查 "模型为何这样回答" 时,这是唯一可靠的依据,因为它记的是请求发出前的实际载荷,而不是程序里的变量。 - 调用结构。 十个 span 构成一棵嵌套树,自
invoke_agent往下是每一轮execute_event_loop_cycle,再往下是本轮的chat与若干execute_tool。这棵树直接回答两个问题:一次请求用了几轮?耗时集中在模型等待还是工具执行?轮次异常膨胀是 Agent 失效的典型表现,在这棵树上一眼可见。 - 进程内指标。
EventLoopMetrics不经 OpenTelemetry 导出,只在进程内可读,提供按工具聚合的调用次数、成功次数、错误次数与累计耗时,以及latest_context_size与projected_context_size两个上下文规模读数。它的用途与前三类不同:前三类是事后分析,它是可以在代码里直接做阈值判断的运行时数据,例如发现某个工具的错误率偏高就临时摘掉它。同一子包内的Trace对象也属此类,记录九项内容并在工具调用处写入toolUseId与工具名,同样不经导出。
四、harness 层
harness 层的入口只有一个函数,提供了 15 个显式关键字参数和 1 个 **agent_kwargs。
agent_kwargs 中显式传入的 Strands SDK 参数优先于 harness 的同类参数。
返回值是一个普通的 strands.Agent,构造后仍可继续修改。
python
from strands_harness import create_harness

agent = create_harness()
agent("Find the slowest test in this repo and explain why it's slow")
可见,harness 不是一层封装,而是一组默认值。
全部 16 个参数位如下。
| 参数名 | 默认值 | 不传时的实际行为 | 何时须显式传 |
|---|---|---|---|
model |
None |
取 bedrock/global.anthropic.claude-opus-5 | 换模型、换供应商,或传 ModelRouter 做按轮路由 |
effort |
"auto" |
对默认模型解析为 high(models.py:316-336) |
需要压低推理开销,或模型不支持推理强度时显式关掉 |
instructions |
None |
只用 harness 自带的系统提示词 | 追加项目级指令。若 agent_kwargs 里已给 system_prompt,本参数被忽略 |
tools |
None |
消费者工具为空,内置工具照常挂载 | 挂业务工具 |
plugins |
None |
只有 harness 自己的插件 | 挂自定义插件。消费者插件排在 harness 插件之前 |
mcp_servers |
None |
不连 MCP | 接入 MCP 工具。默认单个服务器失败不中断装配,工具名按服务器名加前缀 |
builtin_tools |
None |
挂八个内置工具:shell、read、write、edit、web_fetch、web_search、programmatic_tool_caller、subagent(defaults.py:13-26) |
收窄工具面,例如只留只读工具 |
background_tasks |
None |
等价于 True,即 {"agentic": ["*"]},并把 subagent 强制并入 always 名单 |
关闭后台化,或只允许部分工具后台执行 |
caching |
_UNSET |
解析为 "auto" |
供应商不支持提示词缓存时显式关闭 |
context_manager |
"auto" |
展开为先裁工具结果、再摘要历史,另在末尾追加紧急截断 | 自定义策略流水线,或传 False 整体关闭 |
session |
True |
SnapshotSessionManager,随机八位 id,存 ./.agent/sessions,按消息保存 |
续接已有会话须传 {"id": ...};换目录或换存储后端 |
skills |
True |
目录 ./.agent/skills 存在则加载,不存在则静默跳过 |
换技能目录 |
memory |
True |
./.agent/memory 下的文件库,抽取用 haiku 一档的模型,每五轮触发一次,每轮注入,上限五条,开 search_memory 不开 add_memory |
换存储、换抽取模型、改触发间隔,或整体关闭 |
builtin_plugins |
None |
挂 ["todos", "environment"] |
去掉其中之一,或整体置空 |
interventions |
None |
不装干预处理器 | 需要在工具执行前做放行与拒绝判定 |
**agent_kwargs |
无 | 原样透传给 strands.Agent(agent.py:529) |
传 system_prompt、sandbox、hooks、storage 等 harness 没有专用参数位的项 |
其中与上下文工程相关的有 6 项:
| 默认值 | 内容 | 对应的上下文工程环节 |
|---|---|---|
model |
bedrock/global.anthropic.claude-opus-5,推理强度 "auto" |
/ |
context_manager="auto" |
大体积工具结果移出上下文,只留预览与引用,模型用 retrieve_context 读回 |
压缩、写出与取回 |
session=True |
在 ./.agent/sessions 下按随机 id 建快照 |
写出 |
skills=True |
加载 ./.agent/skills,目录不存在即空操作 |
装配(渐进披露) |
memory=True |
./.agent/memory 下的文件库,每轮前检索并把命中结果折入上下文 |
取材、注入 |
builtin_plugins=["todos", "environment"] |
todos 在每一步前重新呈现待办;environment 在每个用户轮前注入平台、日期、工作目录与项目 AGENTS.md |
注入 |
五、一次模型调用前发生了什么
Strands 的主循环在调用模型 API 之前,依次做 4 件事:
- 收集工具规格:从工具注册表取出全部工具的 spec。
- 取 system prompt。
- 构造请求上下文:把消息历史、系统提示、工具规格等打包成一个对象。
- 经过中间件链,再落到终端调用:真正发请求的是链条最内层。
5.1 请求上下文对象
第 3 步打包出来的那个对象叫 InvokeModelContext,是一个 dataclass,九个字段:
| 字段 | 含义 |
|---|---|
agent |
发起本次调用的 Agent |
messages |
本次请求的完整消息列表 |
system_prompt |
系统提示(内容块形态) |
tool_specs |
工具规格列表 |
tool_choice |
工具选择策略 |
invocation_state |
本次调用的状态字典 |
model |
本次使用的模型,可按调用替换 |
projected_input_tokens |
预估的输入 Token 数 |
dynamic_trailing_blocks |
尾部有几个内容块属于本轮临时内容 |
5.2 观测最终 prompt 的方式
子类化 Model,在 stream() 里把入参全部记下来。
python
class PromptSpyModel(MockedModelProvider):
    """记录每一个越过 provider 边界的入参。"""

    async def stream(self, messages, tool_specs=None, system_prompt=None,
                     tool_choice=None, **kwargs):
        CAPTURED.append({
            "messages": messages,
            "system_prompt": system_prompt,
            "system_prompt_content": kwargs.get("system_prompt_content"),
            "tool_specs": [spec["name"] for spec in (tool_specs or [])],
            "extra_kwargs": sorted(kwargs.keys()),
        })
        async for event in super().stream(messages, tool_specs, system_prompt,
                                          tool_choice, **kwargs):
            yield event
六、自建 RAG
6.1 两个接入点
接入点有两个,位于不同层次。
- 实现一个
SearchStrategy并替换某个Storage后端的默认策略。这条路偏底层:它改的是存储层,不负责把召回结果送进模型输入。适用场景是已有的会话或转存数据需要换一种检索方式,而不是接入一个外部知识库。 - 实现
MemoryStore.search,一个search()方法加五个配置属性。建议走这一条。 理由是接上之后无需额外成本即可获得两项能力:一个search_memory工具,使模型可以自行决定何时检索;以及每个用户回合的自动召回与注入,使高频材料不依赖模型的工具调用决策。前一条路两项都不提供。
还有一处须留意:MemoryStore 的方法中只有 search() 是必需的,add、add_messages、initialize、get_tools 均为可选(B1)。因此一个只读的公共知识库可以只实现一个方法,把 writable 与 extraction 置为 False,框架不会尝试向它写入。
python
class PolicyKnowledgeBase:
    """把自建的双路召回 RAG 接成一个只读 store。"""

    name = "policy-kb"
    description = "退换货政策、保修条款与商品参数,回答政策问题时必须查"
    max_search_results = 3
    writable = False
    extraction = False

    async def search(self, query, options=None):
        hits = await my_rag.retrieve(query, top_k=self.max_search_results)
        return [
            MemoryEntry(
                # 出处写进 content,因为注入格式的 source 取的是 store 名
                content=f"[{hit.doc_title} {hit.section}] {hit.text}",
                store_name=self.name,
            )
            for hit in hits
        ]
该实现把切分、索引、召回、重排四个环节全部留在 my_rag 内部,框架只负责最后一个组装环节。
七、一个入门示例
本示例的整体结构如下图。
左侧是七项需求的入口,中间是 strands.Agent 的六个参数位,右侧是三个外部系统。
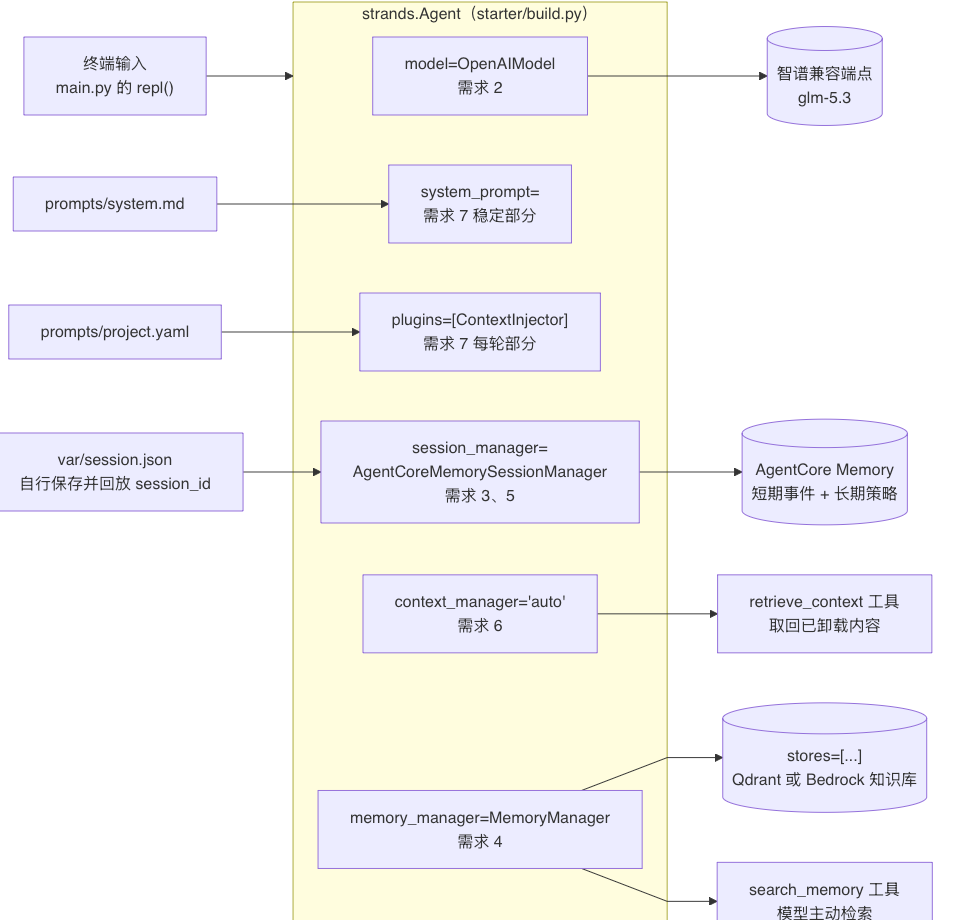
入门需求取最常见的七项,它们在 Strands 里的落点如下表。
| 需求 | 落在哪个参数位 |
|---|---|
| 1 接受提示词输入 | 同步调用 agent(prompt),默认的 PrintingCallbackHandler 负责流式打印 |
| 2 连接大模型 | model=OpenAIModel(...),并显式传 context_window_limit |
| 3 连接 AgentCore Memory | session_manager=AgentCoreMemorySessionManager(...) |
| 4 连接长期事实来源 | memory_manager=MemoryManager(stores=[...]) |
| 5 长短期记忆 | 短期为会话事件,长期为 retrieval_config 加 store 检索 |
| 6 上下文工程 | context_manager="auto" |
| 7 按项目定制注入 | 稳定部分走 system_prompt=,每轮变化的部分走 plugins=[ContextInjector(...)] |
模型侧取智谱开放平台的 OpenAI 兼容端点,base_url 为 https://open.bigmodel.cn/api/paas/v4/,model_id 取 glm-5.3。
需求 4 的长期事实来源准备了两个后端,挂在同一个 stores= 参数位上,切换后端不改动装配结构。
- 本地向量库,取
qdrant/qdrant:v1.19.1镜像,客户端qdrant-client==1.19.1,embedding 复用同一个智谱模型端点。实测embedding-3返回 2048 维,embedding-2返回 1024 维,两者都可用。语料放在kb-docs/下。该后端只依赖本地容器与智谱模型 API。 - Bedrock 知识库
BedrockKnowledgeBaseStore。需要具备账号、知识库与模型调用许可。
需求 3 与 5 的短期记忆侧只需一个 AgentCore Memory 资源。实测用 create_memory(name="strands_starter_stm", eventExpiryDuration=30) 建出,不传 memoryExecutionRoleArn、不传 memoryStrategies,状态经约 130 秒由 CREATING 变为 ACTIVE,建成后 get_memory 查得 strategies: []。
botocore 自带的服务模型也印证了这一点:bedrock-agentcore-control 的 CreateMemory 必填成员只有 name 与 eventExpiryDuration 两项。换言之,短期记忆不需要执行角色、不需要记忆策略,入门阶段不必为它准备 IAM 角色。
长期记忆侧须另建一个带 userPreferenceMemoryStrategy 的资源,命名空间取 /preferences/{actorId}/。实测该资源同样不必传 memoryExecutionRoleArn:不传执行角色建出的资源状态经约 120 秒变为 ACTIVE,策略状态亦为 ACTIVE,抽取与回注全程正常。该项在本示例中是可选的:不配 AGENTCORE_LTM_NAMESPACES 时只保留短期记忆,程序正常运行。
python
from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import AgentCoreMemorySessionManager
参考引用
https://github.com/strands-agents/harness-sdk
https://github.com/strands-agents/sdk-python
https://github.com/strands-agents/agent-builder
https://pypi.org/project/strands-agents/
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0009-mono-repository.md
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0003-context-management.md
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0009-context-offloader.md
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0011-memory-manager.md
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0014-storage.md
https://github.com/strands-agents/harness-sdk/blob/main/team/designs/0015-context-manager.md
https://aws.amazon.com/blogs/opensource/introducing-strands-agents-an-open-source-ai-agents-sdk/
https://aws.amazon.com/cn/blogs/china/agentive-ai-infrastructure-practice-series-1/
https://aws.amazon.com/cn/blogs/china/agentic-ai-infrastructure-practice-series-5/
https://docs.aws.amazon.com/bedrock/latest/userguide/prompt-caching.html
https://docs.anthropic.com/en/docs/build-with-claude/prompt-caching
https://juejin.cn/post/7568471321955041314
https://xie.infoq.cn/article/5fc775ad7a6d93492a9e074bc
https://cloud.tencent.cn/developer/article/2597944
https://github.com/aws/bedrock-agentcore-sdk-python
https://pypi.org/project/bedrock-agentcore/
https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/memory.html
https://aws.amazon.com/bedrock/agentcore/pricing/
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base.html
https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-vectors.html
https://docs.aws.amazon.com/bedrock/latest/userguide/titan-embedding-models.html
https://docs.bigmodel.cn/api-reference/