✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
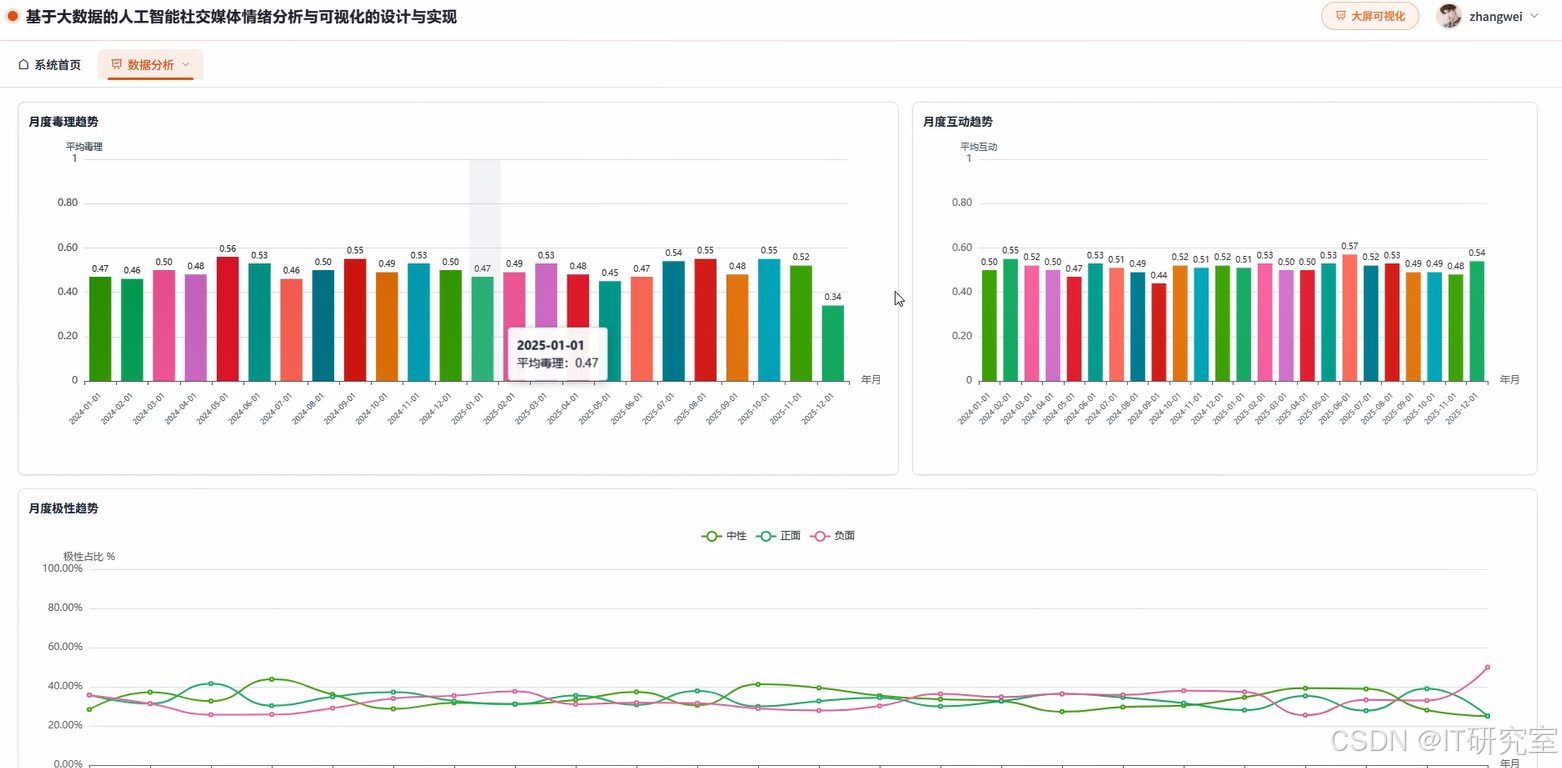
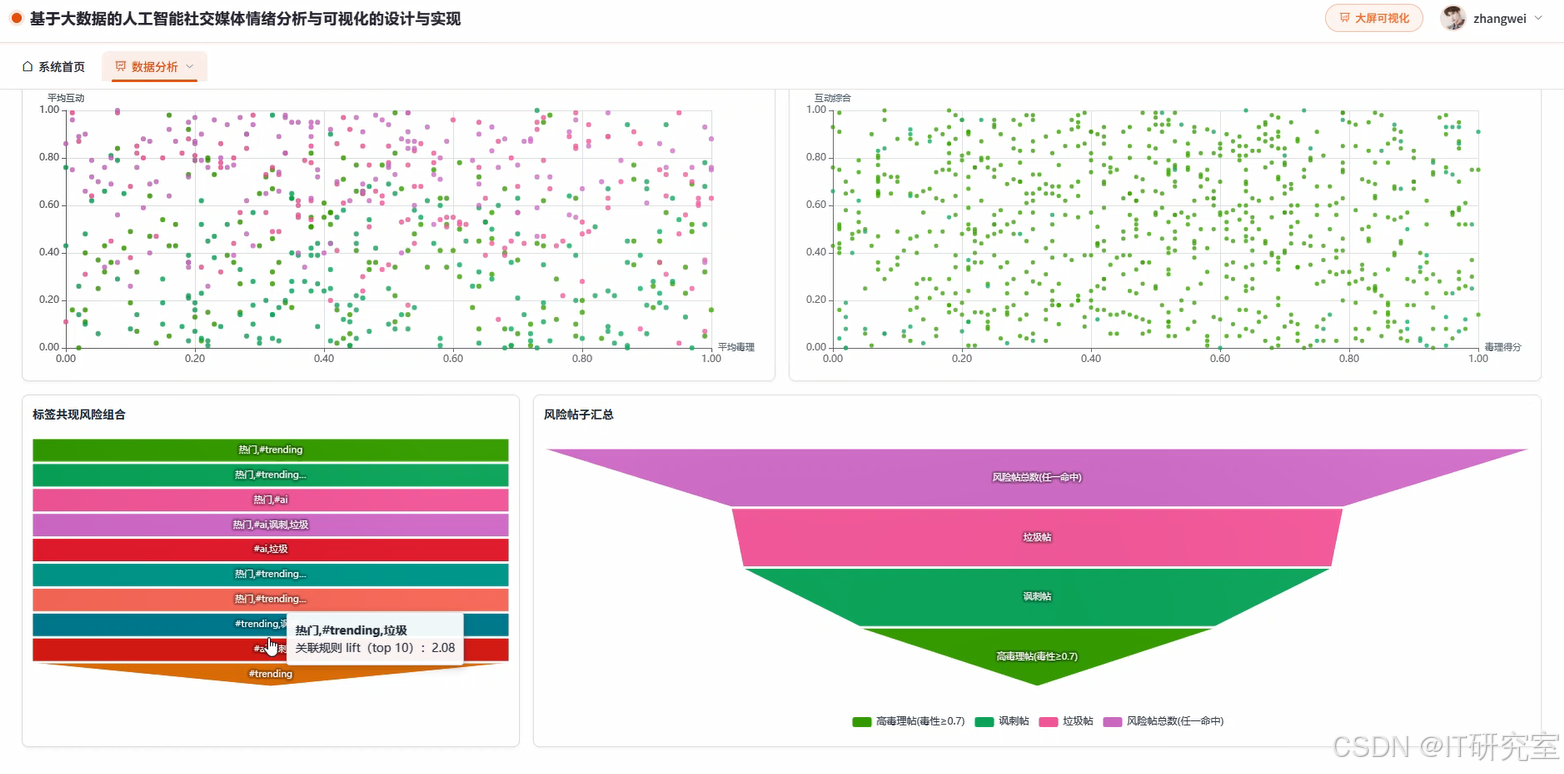
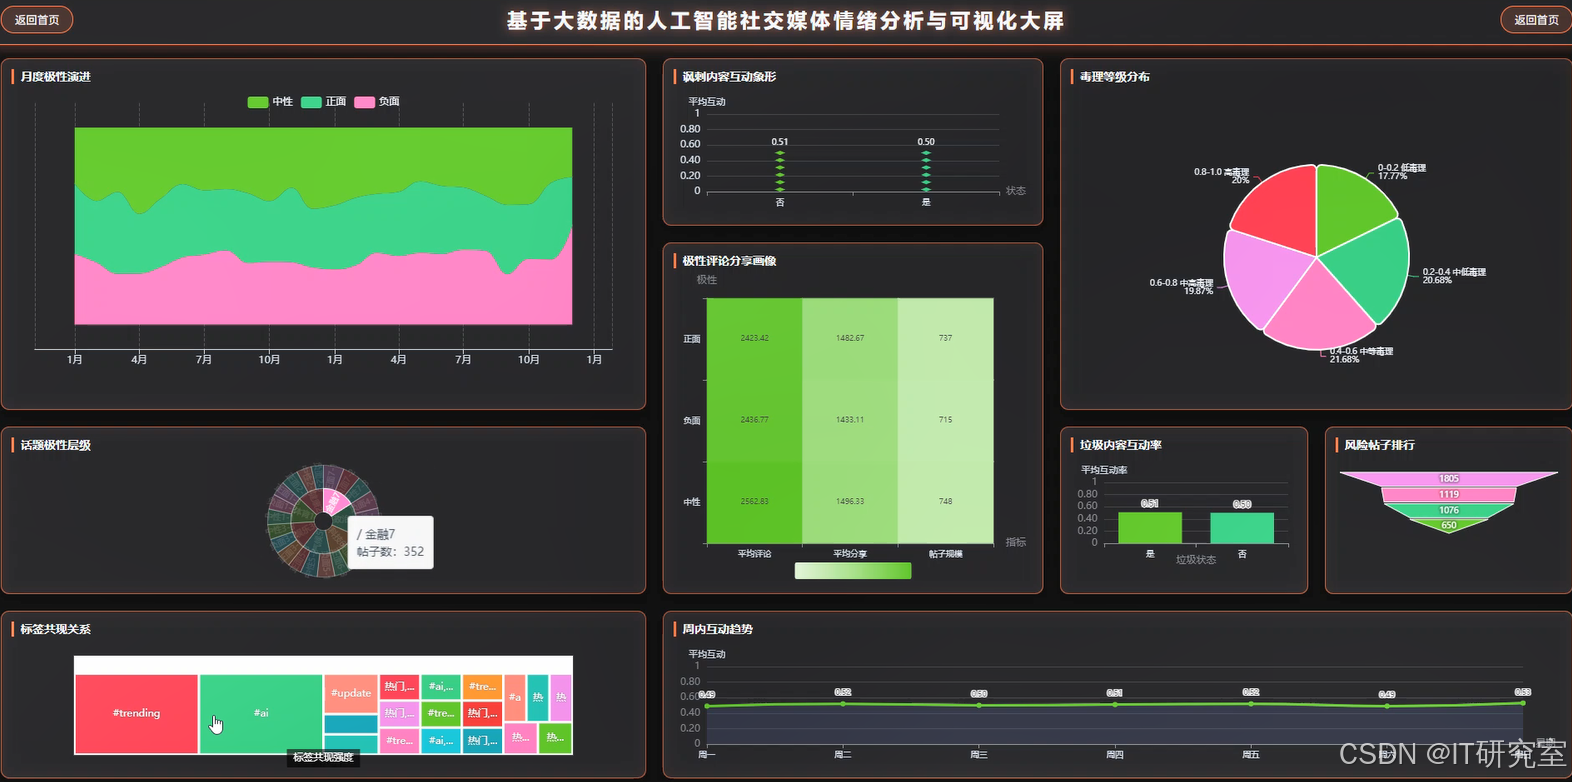
本系统是一个面向社交媒体海量文本数据的情感分析平台,核心定位是帮助计算机专业学生快速掌握大数据开发全流程。系统基于Hadoop分布式文件系统(HDFS)实现原始数据的高效存储与多副本容灾,利用Spark分布式计算引擎对采集到的社交平台文本进行清洗、分词与情感极性判定,其中情感分析模块集成了基于词典的规则匹配方法和基于Pandas、NumPy的轻量级统计模型,能够对每条文本输出正面、负面或中性的情绪标签。在此基础上,系统通过Spark SQL对标签化数据进行多维度聚合计算,分别支撑情绪分布分析、互动影响分析、话题情绪分析、时间趋势分析、平台对比分析、风险洞察分析和用户行为分析等七大功能模块。后端采用Spring Boot框架(亦支持Django版本)提供标准RESTful API接口,前端基于Vue.js与ElementUI搭建管理界面,并利用ECharts生成动态交互式可视化图表,使用户能够直观地观察不同话题、不同时间段、不同平台上的情绪波动规律与异常风险点。整个系统从数据采集、预处理、情感计算到结果展示形成了完整的闭环链条,既可作为毕业设计课题的典型实践案例,也为后续更复杂的社交媒体舆情监控系统奠定了技术基础。
选题背景
近些年社交媒体已经深度嵌入到人们的日常生活中,每天都有数以亿计的用户在微博、微信、抖音等平台上发表观点、分享情绪,这些文本数据背后潜藏着公众对社会事件、产品服务、政策法规的真实态度。然而面对如此庞大且非结构化的信息洪流,传统的关系型数据库和单机处理工具已经很难在可接受的时间内完成有效的情绪提取与趋势分析,这就需要引入分布式存储与并行计算架构来提升数据吞吐量和处理效率。当前大数据技术栈中的Hadoop和Spark凭借其成熟的生态体系和活跃的社区支持,成为高校计算机专业毕业设计选题中极具代表性的技术方向。基于上述考虑,本课题设计并实现一套结合大数据处理能力与人工智能情绪判定算法的社交媒体分析系统,既顺应了时代对复合型数据人才的需求,也为学生提供了一次完整的工程化项目实战机会。
选题意义:
从实际应用价值来看,本系统能够帮助普通用户或小型运营团队快速了解自身账号或话题下的舆论情绪走向,及时发现负面情绪聚集的风险点,从而为内容调整、危机公关提供一定的数据参考。从教学实训角度出发,系统完整覆盖了数据采集、清洗、计算、存储、展示这一标准大数据处理流水线,学生通过本课题可以深入理解HDFS的读写机制、Spark的RDD与DataFrame编程模型、Spark SQL的聚合查询优化等核心知识点,同时也能锻炼前后端联调与可视化图表配置的工程能力。从技术验证层面分析,本系统尝试将规则情感词典与统计分析方法相结合,在不过度依赖深度学习硬件资源的前提下,依然能够达到较为可观的分类准确率,这对于资源受限的毕设环境而言是一种务实且可行的技术选型。总体而言,本课题虽未涉及前沿大模型,但其完整性和可落地性足以支撑一次高质量的毕业设计实践。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
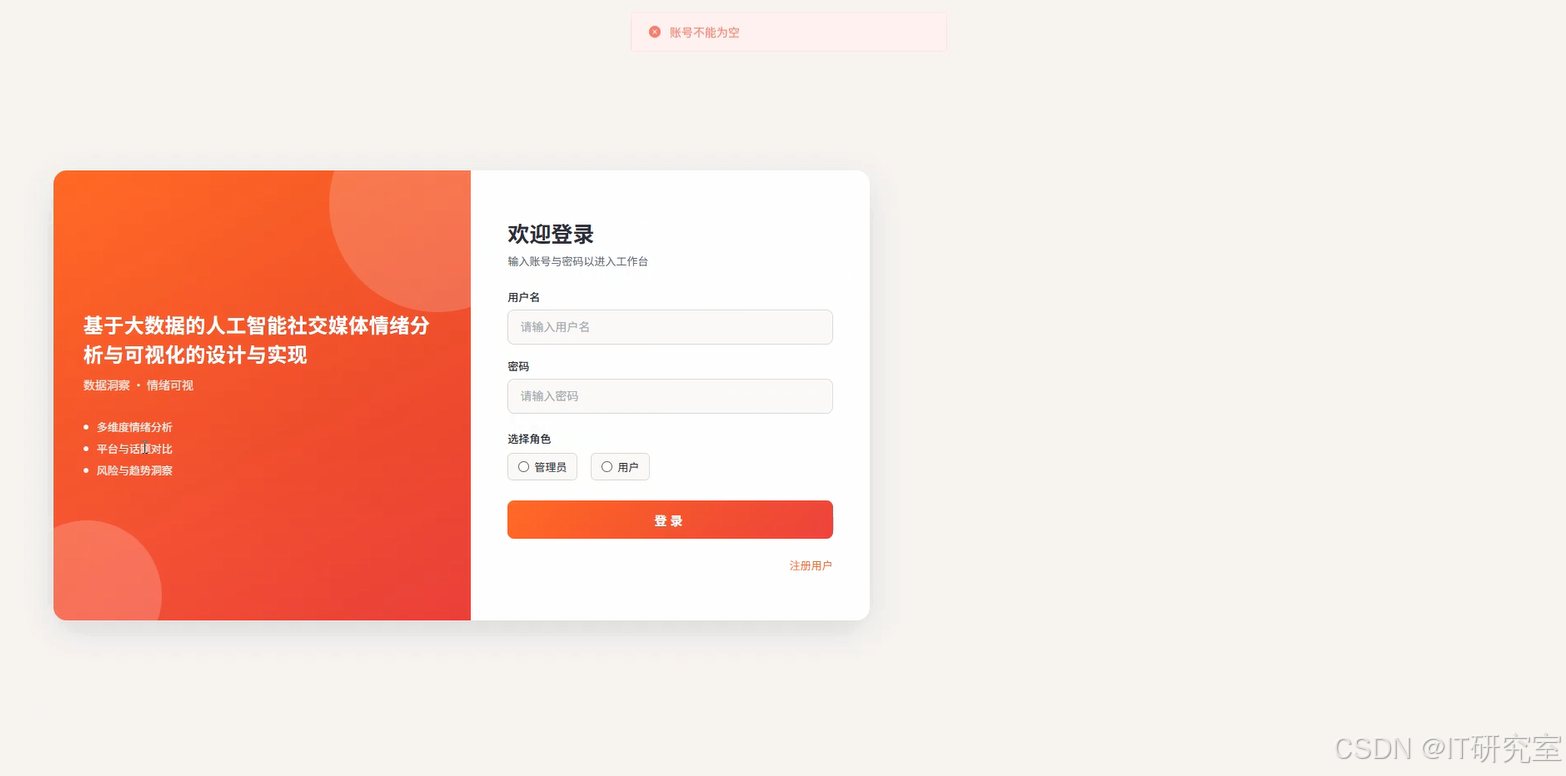
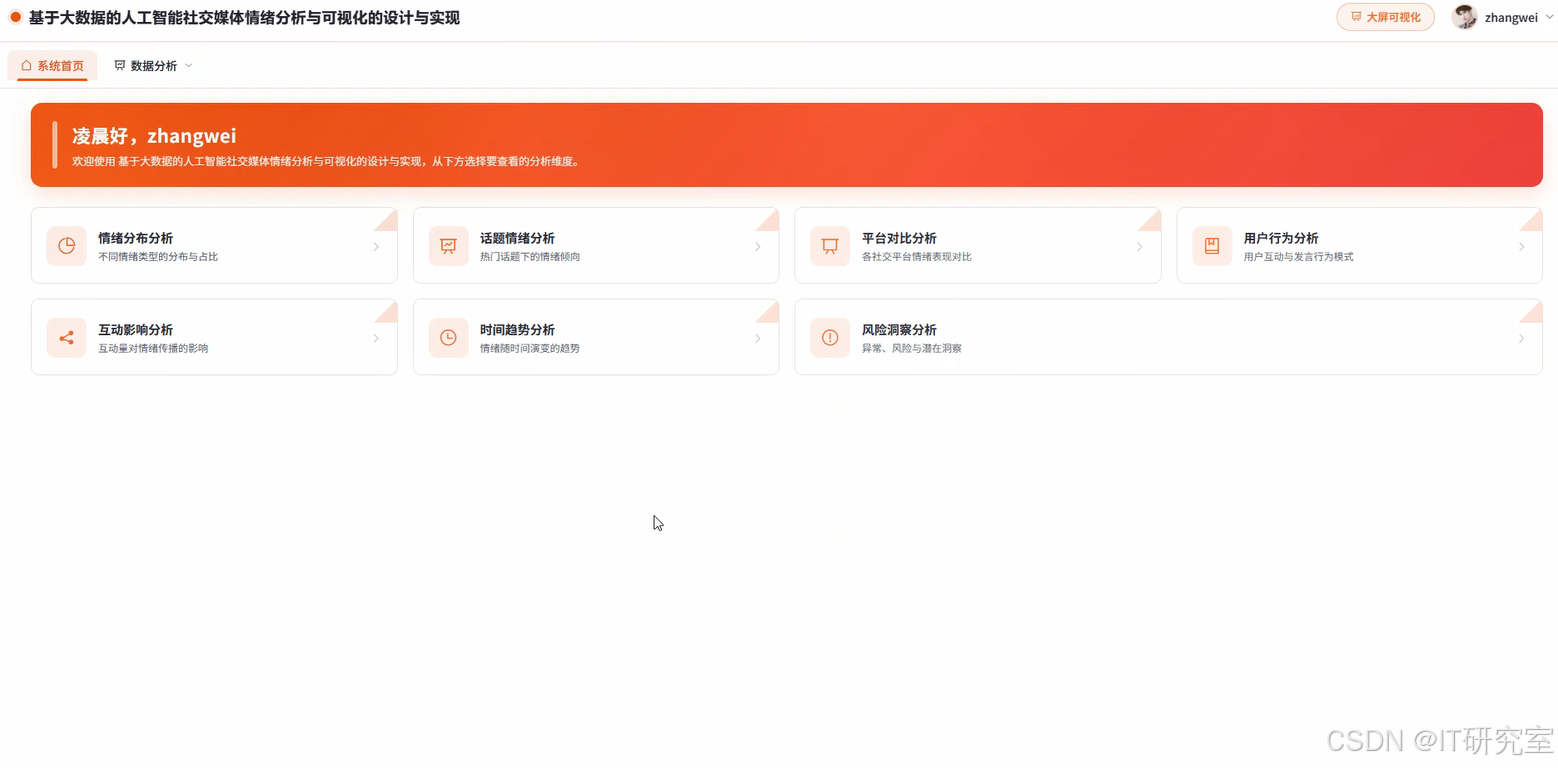
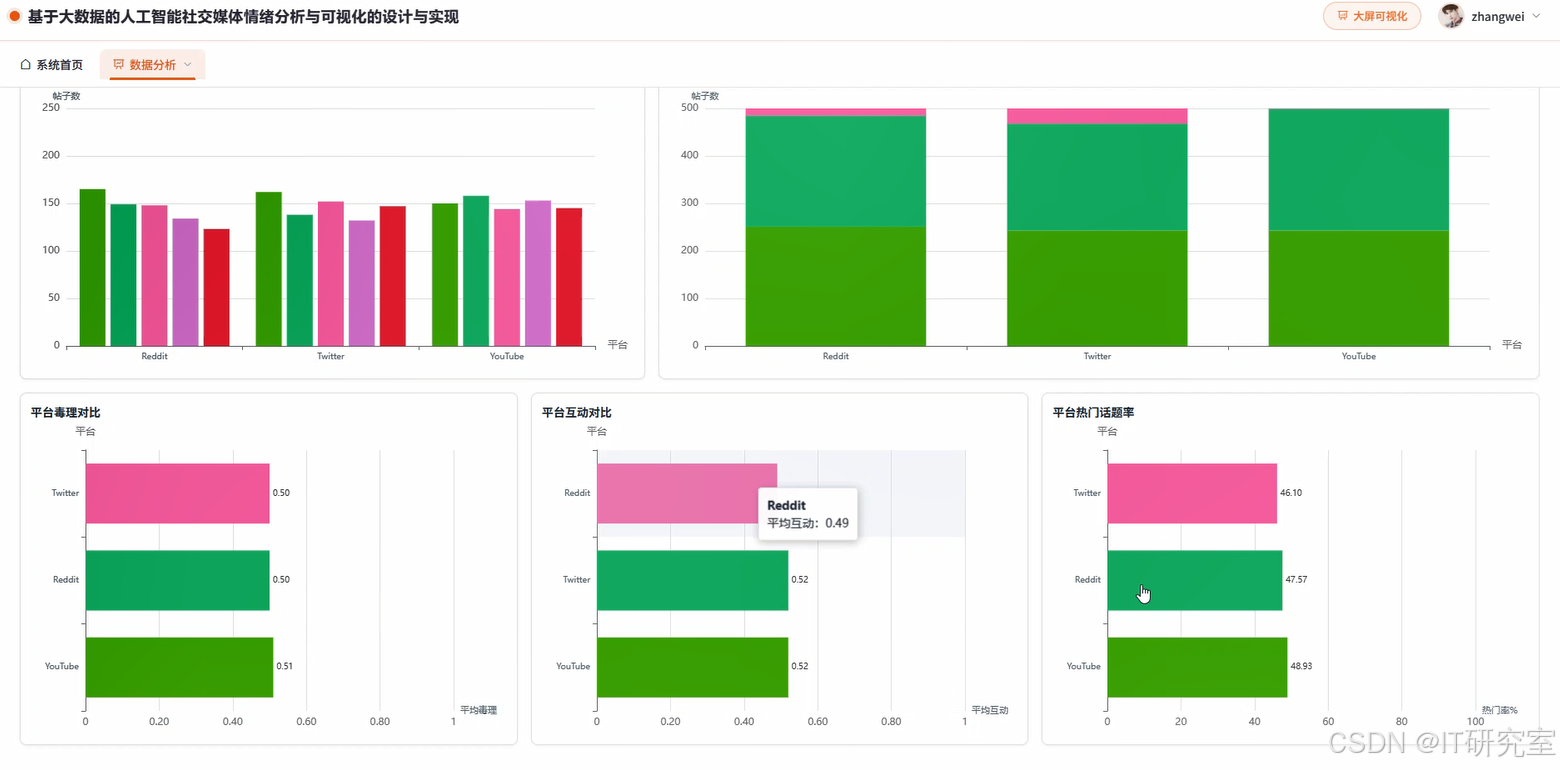
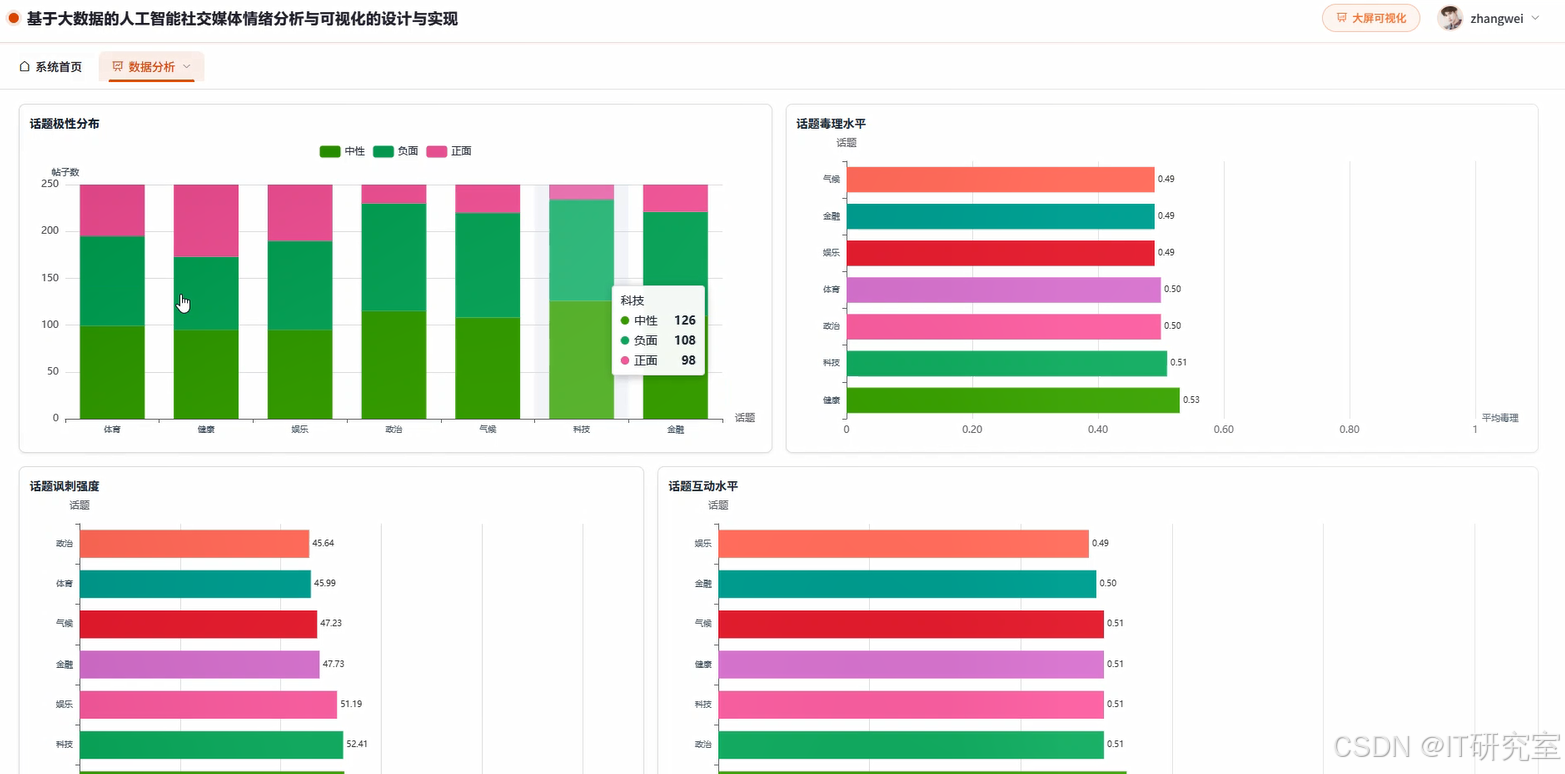
- 基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现界面展示:

四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
package com.demo.analysis;

import org.apache.spark.sql.SparkSession;
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.functions;
import static org.apache.spark.sql.functions.*;
import org.apache.spark.sql.types.StructType;
import org.apache.spark.sql.types.DataTypes;
import java.util.Arrays;
import java.util.List;

public class EmotionAnalysisService {

    private SparkSession spark;

    public EmotionAnalysisService() {
        this.spark = SparkSession.builder()
                .appName("SocialMediaEmotionAnalysis")
                .master("local[*]")
                .config("spark.sql.shuffle.partitions", "4")
                .getOrCreate();
    }

    // ========== 核心功能1:情绪分布与占比统计分析 ==========
    public Dataset<Row> analyzeEmotionDistribution(String hdfsPath) {
        Dataset<Row> df = spark.read().option("header", "true").option("inferSchema", "true").csv(hdfsPath);
        Dataset<Row> emotionDf = df.withColumn("emotion",
                when(col("text").contains("开心"), "positive")
                .when(col("text").contains("喜欢"), "positive")
                .when(col("text").contains("愤怒"), "negative")
                .when(col("text").contains("失望"), "negative")
                .otherwise("neutral"));
        Dataset<Row> distribution = emotionDf.groupBy("emotion").count()
                .withColumn("percentage", col("count").divide(sum("count").over()).multiply(100))
                .withColumn("percentage", functions.format_number(col("percentage"), 2).cast(DataTypes.DoubleType));
        distribution.orderBy(col("percentage").desc()).show(10, false);
        return distribution;
    }

    // ========== 核心功能2:时间趋势演变分析(按天统计情绪占比) ==========
    public Dataset<Row> analyzeTimeTrend(String hdfsPath) {
        Dataset<Row> df = spark.read().option("header", "true").option("inferSchema", "true").csv(hdfsPath);
        Dataset<Row> withDate = df.withColumn("date", col("publish_time").substr(1, 10))
                .withColumn("emotion", when(col("text").contains("好"), "positive")
                        .when(col("text").contains("赞"), "positive")
                        .when(col("text").contains("差"), "negative")
                        .when(col("text").contains("烂"), "negative")
                        .otherwise("neutral"));
        Dataset<Row> dailyTotal = withDate.groupBy("date").agg(count("*").alias("total"));
        Dataset<Row> dailyPositive = withDate.filter(col("emotion").equalTo("positive"))
                .groupBy("date").agg(count("*").alias("pos_count"));
        Dataset<Row> dailyNegative = withDate.filter(col("emotion").equalTo("negative"))
                .groupBy("date").agg(count("*").alias("neg_count"));
        Dataset<Row> joined = dailyTotal.join(dailyPositive, "date", "left")
                .join(dailyNegative, "date", "left")
                .na().fill(0, new String[]{"pos_count", "neg_count"});
        Dataset<Row> trend = joined.withColumn("pos_ratio", col("pos_count").divide(col("total")).multiply(100))
                .withColumn("neg_ratio", col("neg_count").divide(col("total")).multiply(100))
                .withColumn("pos_ratio", functions.format_number(col("pos_ratio"), 2).cast(DataTypes.DoubleType))
                .withColumn("neg_ratio", functions.format_number(col("neg_ratio"), 2).cast(DataTypes.DoubleType));
        trend.orderBy(col("date").asc()).show(30, false);
        return trend;
    }

    // ========== 核心功能3:风险洞察分析(识别高频负面词和异常高负评话题) ==========
    public Dataset<Row> analyzeRiskInsight(String hdfsPath) {
        Dataset<Row> df = spark.read().option("header", "true").option("inferSchema", "true").csv(hdfsPath);
        Dataset<Row> negativeDf = df.filter(col("text").contains("愤怒").or(col("text").contains("失望"))
                .or(col("text").contains("差")).or(col("text").contains("烂")).or(col("text").contains("坑")));
        Dataset<Row> topicRisk = negativeDf.groupBy("topic").agg(count("*").alias("negative_count"))
                .withColumn("risk_level", when(col("negative_count").gt(50), "HIGH")
                        .when(col("negative_count").gt(20), "MEDIUM")
                        .otherwise("LOW"));
        Dataset<Row> wordCount = negativeDf.select(explode(split(col("text"), " ")).alias("word"))
                .filter(col("word").notEqual("")).groupBy("word").count()
                .filter(col("word").isNotNull()).orderBy(col("count").desc()).limit(15);
        Dataset<Row> highRiskTopics = topicRisk.filter(col("risk_level").equalTo("HIGH"));
        highRiskTopics.show(10, false);
        wordCount.show(15, false);
        return highRiskTopics;
    }
}
五、系统视频
基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇