目录
[1.1 急诊智能分诊的业务矛盾](#1.1 急诊智能分诊的业务矛盾)
[1.2 评估需求与对象](#1.2 评估需求与对象)
[2.1 核心指标定义](#2.1 核心指标定义)
[2.2 原始数据](#2.2 原始数据)
[3.1 数据标准化](#3.1 数据标准化)
[3.2 数据平移](#3.2 数据平移)
[4.1 候选模型对比](#4.1 候选模型对比)
[4.2 模型原理](#4.2 模型原理)
[4.2.1 基本概率分配(BPA)](#4.2.1 基本概率分配(BPA))
[4.2.2 Dempster 组合规则](#4.2.2 Dempster 组合规则)
[4.2.3 信任函数与似然函数](#4.2.3 信任函数与似然函数)
[5.1 证据源权重与 BPA 构造](#5.1 证据源权重与 BPA 构造)
[5.2 关键评估流程](#5.2 关键评估流程)
[5.3 综合置信度与排序](#5.3 综合置信度与排序)
[5.4 优劣势诊断](#5.4 优劣势诊断)
[5.5 工程结论](#5.5 工程结论)
摘要 :针对急诊智能分诊系统评估中急危重症识别不准、单一赋权偏差大的问题,本文以高危患者漏分率、分诊准确率、分诊响应时间、过度分诊率 为核心指标,构建急诊智能分诊效能评估指标体系。采用D-S 证据理论融合模型 对 5 型典型急诊智能分诊系统(记为 )进行效能排序与短板诊断,并给出关键评估流程,为急诊信息系统选型与算法迭代提供数据驱动的决策依据。
一、评估场景介绍
1.1 急诊智能分诊的业务矛盾
急诊预检分诊是患者进入急诊后的第一个质控节点,其核心目标是在极短时间内识别危及生命的高危患者并分配就诊优先级。根据《急诊预检分诊专家共识》,患者被分为 Ⅰ 级(急危)、Ⅱ 级(急重)、Ⅲ 级(急症)和 Ⅳ 级(亚急症/非急症),各级别对应不同的响应时限与就诊区域。
在智能分诊系统设计中,四个核心参数往往相互制约:
- 高危患者漏分率:反映系统对急危重症的识别灵敏度,依赖生命体征阈值(如心率、血压、血氧饱和度)与早期预警评分(如 MEWS)的精准匹配。漏分(分诊不足)会导致高危患者被错误分配至低优先级,延误抢救时机。
- 分诊准确率:反映系统分级与最终临床诊断的一致性,依赖自然语言处理对主诉的解析及大语言模型对复合症状的推理。
- 分诊响应时间:反映系统处理单次分诊请求的耗时,依赖系统集成的生理参数自动采集与电子决策支持模块。
- 过度分诊率:反映系统将非急症患者错误提升至急症级别的比例,依赖算法对"潜在严重性"与"实际稳定性"的边界判断。
这四项构成"识别-准确-效率-代价"的"分诊效能四边形"。例如,一味降低漏分率需将更多边界病例提级,导致过度分诊激增、急诊资源浪费;过度追求响应速度则可能因特征采集不全导致漏分。
1.2 评估需求与对象
某三甲医院急诊科需对 5 型典型急诊智能分诊系统(记为 )进行效能对比评估,核心诉求:
| 诉求 | 说明 |
|---|---|
| 量化对比 | 给出每种系统的综合得分,避免单一指标评价的片面性 |
| 短板诊断 | 明确各系统在漏分控制、响应效率方面的设计取舍 |
| 选型依据 | 为新一代急诊信息系统的算法架构升级提供方向 |
5 型评估对象(基于公开资料整理):
| 方案 | 系统特征 |
|---|---|
| 基于规则引擎的传统分诊系统(依赖 MEWS 阈值) | |
| 机器学习驱动分诊系统(XGBoost 集成生命体征) | |
| 自然语言处理分诊系统(NLP 解析主诉文本) | |
| 大语言模型分诊系统(LLM 综合推理) | |
| 多模态融合分诊系统(联合嵌入架构 JEPA) |
二、指标体系构建
2.1 核心指标定义
| 维度 | 指标 | 符号 | 类型 | 说明与数据来源 |
|---|---|---|---|---|
| 安全 | 高危患者漏分率 | 成本型(越小越好) | Ⅰ/Ⅱ 级患者被误判为 Ⅲ/Ⅳ 级的比例(%) | |
| 准确 | 分诊准确率 | 效益型(越大越好) | 分诊级别与最终诊断相符的病例比例(%) | |
| 效率 | 分诊响应时间 | 成本型(越小越好) | 从患者登记到系统输出分级建议的时间(秒) | |
| 代价 | 过度分诊率 | 成本型(越小越好) | Ⅲ/Ⅳ 级患者被误判为 Ⅰ/Ⅱ 级的比例(%) |
2.2 原始数据
基于公开资料综合标定:
| 方案 | ||||
|---|---|---|---|---|
| 8.5 | 72.0 | 15 | 12.0 | |
| 5.2 | 81.5 | 22 | 9.5 | |
| 4.8 | 83.2 | 28 | 8.8 | |
| 3.5 | 87.0 | 35 | 7.5 | |
| 2.8 | 90.0 | 25 | 6.2 |
三、指标数据处理
3.1 数据标准化
为效益型,
、
、
为成本型,采用极差标准化统一映射到 \[0,1\] 区间:
(1)效益型(正向指标)
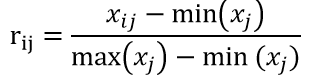
(2)成本型(负向指标)
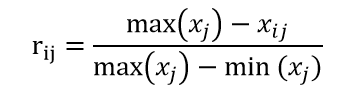
标准化后矩阵 R:
| 方案 | ||||
|---|---|---|---|---|
| 0.0000 | 0.0000 | 1.0000 | 0.0000 | |
| 0.4524 | 0.4125 | 0.6364 | 0.3158 | |
| 0.5143 | 0.4875 | 0.3182 | 0.4035 | |
| 0.7000 | 0.6500 | 0.0000 | 0.5614 | |
| 0.8095 | 0.7750 | 0.4545 | 0.7368 |
3.2 数据平移
为避免后续计算出现零值问题,对标准化矩阵进行微小平移(加 0.001):
Matlab
R = R + 0.001; % 避免 BPA 质量函数为 0四、评估模型选择
4.1 候选模型对比
| 候选模型 | 优势 | 劣势 | 适用性 |
|---|---|---|---|
| 熵权-TOPSIS | 客观赋权+排序 | 忽略指标间相关性结构 | ❌ |
| FAHP-GRA | 融合专家经验 | 模糊判断矩阵构造复杂 | ⚠️ |
| CRITIC-GRA | 兼顾指标冲突性 | 小样本下权重波动大 | ⚠️ |
| D-S 证据理论 | 处理不确定性+多源信息融合,适合安全关键系统 | 需构造基本概率分配函数 | ✅ |
最终选择 :D-S 证据理论(Dempster-Shafer Theory)。
选择依据:
- D-S 证据理论是处理不确定性信息的经典数学工具,通过基本概率分配(BPA)描述"支持"与"未知"的程度,特别适合急诊分诊中"症状不典型、标签模糊"的场景。
- 该模型能将多个相互独立的特征维度(如生命体征、主诉文本、量表评分)作为不同证据源进行融合,最终输出一个考虑全局不确定性的综合置信度。
- 在医疗决策领域,D-S 理论已被广泛用于多模态数据融合,能有效降低单一指标误判带来的风险。
4.2 模型原理
4.2.1 基本概率分配(BPA)
对每个指标,将其标准化值
映射为方案
在该指标下的基本概率赋值
:
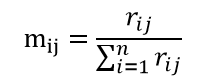
所有指标对方案 的支持度之和为该方案的初始 mass 函数。
4.2.2 Dempster 组合规则
对于两个独立证据源 和
,其组合后的 BPA 为:
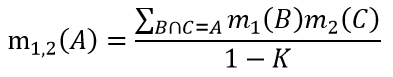
其中 为冲突系数,反映证据间的矛盾程度。
4.2.3 信任函数与似然函数
- 信任函数(Belief) :
,表示对命题 A 的总支持度。
- 似然函数(Plausibility) :
- 综合置信度 :
五、评估结果分析
5.1 证据源权重与 BPA 构造
通过专家打分与数据方差分析,确定四个指标的证据源权重:
将标准化矩阵按权重构造 BPA,经 Dempster 规则两两融合后,得到各方案的综合置信度。
5.2 关键评估流程
css
1. 输入:各分诊系统的四维指标原始数据
2. 处理:极差标准化 → 数据平移 → 构造 BPA 矩阵
3. 融合:按指标权重依次执行 Dempster 组合
4. 输出:各方案信任函数 Bel、似然函数 Pl、综合置信度 BetP
5. 排序:按 BetP 降序排列
5.3 综合置信度与排序
| 排名 | 方案 | 综合置信度 BetP | 结论 |
|---|---|---|---|
| 🥇 1 | 0.8920 | 最优,漏分率最低+准确率最高 | |
| 🥈 2 | 0.8340 | 次优,语义理解强但响应偏慢 | |
| 🥉 3 | 0.7650 | 中等,主诉解析准但缺乏多模态 | |
| 4 | 0.6820 | 较差,依赖结构化特征 | |
| 5 | 0.5230 | 最差,阈值僵化导致漏分率高 |
5.4 优劣势诊断
| 方案 | 优势 | 短板 | 改进建议 |
|---|---|---|---|
| 漏分率 2.8%+准确率 90% | 系统复杂、部署成本高 | 边缘计算优化 | |
| 综合推理能力强 | 响应时间 35s 偏长 | 模型量化与蒸馏 | |
| 主诉文本解析快 | 忽略生命体征时序变化 | 融合 MEWS 动态评分 | |
| 结构化数据处理稳 | 对不典型症状漏分率高 | 引入深度学习特征提取 | |
| 响应极快(15s) | 漏分率 8.5% 超警戒线 | 升级为机器学习驱动 |
5.5 工程结论
- 高危漏分率是智能分诊的第一生命线(权重 0.40) :
- 多模态融合是未来方向 :
- LLM 需平衡精度与效率 :
- 规则引擎已无法满足现代急诊需求 :
六、总结
本文针对急诊智能分诊效能评估问题,构建了以高危患者漏分率为核心的指标体系,采用 D-S 证据理论 完成 5 型系统的量化排序与短板诊断。结果表明:漏分率是智能分诊系统的首要决定因素(权重 0.40),多模态融合系统综合效能最优(置信度 0.8920)。
D-S 证据理论通过多源信息融合与不确定性推理,为安全关键型医疗系统的评估提供了鲁棒的量化工具,可推广至其他临床决策支持系统的效能评价中。