🔥小叶-duck:个人主页
❄️个人专栏:《Data-Structure-Learning》《C++入门到进阶&自我学习过程记录》
《Linux系统从入门到实践》《Linux网络从入门到实践》
✨未择之路,不须回头
已择之路,纵是荆棘遍野,亦作花海遨游
目录
[一、epoll:大规模并发场景下的 IO 多路转接方案](#一、epoll:大规模并发场景下的 IO 多路转接方案)
[1.1 传统多路转接方案的性能缺陷](#1.1 传统多路转接方案的性能缺陷)
[1.2 epoll 的设计目标与底层定位](#1.2 epoll 的设计目标与底层定位)
[二、epoll 接口体系:三大核心系统调用](#二、epoll 接口体系:三大核心系统调用)
[2.1 epoll_create:创建 epoll 实例](#2.1 epoll_create:创建 epoll 实例)
[2.1.1 函数原型](#2.1.1 函数原型)
[2.1.2 参数与返回值](#2.1.2 参数与返回值)
[2.1.3 底层本质](#2.1.3 底层本质)
[2.2 epoll_ctl:管控监听事件(增 / 删 / 改监听 fd)](#2.2 epoll_ctl:管控监听事件(增 / 删 / 改监听 fd))
[2.2.1 函数原型](#2.2.1 函数原型)
[2.2.2 参数详解](#2.2.2 参数详解)
[2.2.3 返回值与功能本质](#2.2.3 返回值与功能本质)
[2.3 epoll_wait:等待就绪事件](#2.3 epoll_wait:等待就绪事件)
[2.3.1 函数原型](#2.3.1 函数原型)
[2.3.2 参数详解](#2.3.2 参数详解)
[2.3.3 返回值与底层逻辑](#2.3.3 返回值与底层逻辑)
[三、epoll 内核工作原理(附详细图分析)](#三、epoll 内核工作原理(附详细图分析))
[3.1 阶段一:示意图原理分析](#3.1 阶段一:示意图原理分析)
[3.1.1 红黑树与就绪队列的基础分工](#3.1.1 红黑树与就绪队列的基础分工)
[3.1.2 事件回调触发逻辑](#3.1.2 事件回调触发逻辑)
[3.1.3 基于内核模型重谈 epoll 三个接口](#3.1.3 基于内核模型重谈 epoll 三个接口)
[问题 1:如何理解就绪队列?](#问题 1:如何理解就绪队列?)
[问题 2:epoll_ctl 和 select/poll 的本质差异](#问题 2:epoll_ctl 和 select/poll 的本质差异)
[问题 3:epoll_create 返回文件描述符的意义](#问题 3:epoll_create 返回文件描述符的意义)
[3.2 阶段二:内核结构详解](#3.2 阶段二:内核结构详解)
[3.2.1 内核核心结构体](#3.2.1 内核核心结构体)
[struct eventpoll:epoll 实例本体](#struct eventpoll:epoll 实例本体)
[struct epitem:单个 fd 对应的内核档案](#struct epitem:单个 fd 对应的内核档案)
[3.2.2 问题 1:如何获取epitem结构体?](#3.2.2 问题 1:如何获取epitem结构体?)
[3.2.2.1 拓展:container_of 宏](#3.2.2.1 拓展:container_of 宏)
[3.2.3 问题 2:重谈 epoll_create 返回值为什么是文件描述符?](#3.2.3 问题 2:重谈 epoll_create 返回值为什么是文件描述符?)
[3.2.4 回调机制深度理解(梳理Epoll整体流程)](#3.2.4 回调机制深度理解(梳理Epoll整体流程))
[1. 入口与分发:ep_insert 的诞生](#1. 入口与分发:ep_insert 的诞生)
[2. 关键中转站:ep_ptable_queue_proc](#2. 关键中转站:ep_ptable_queue_proc)
[1. 底层唤醒:sock_def_readable](#1. 底层唤醒:sock_def_readable)
[2. 遍历执行:__wake_up_common](#2. 遍历执行:__wake_up_common)
[3. 精准制导与节点激活:ep_poll_callback](#3. 精准制导与节点激活:ep_poll_callback)
[问题 1:为什么底层驱动的等待队列不直接存放 eppoll_entry 结构体?](#问题 1:为什么底层驱动的等待队列不直接存放 eppoll_entry 结构体?)
[问题 2:如何通过 wait_queue_t 获取到 eppoll_entry 结构体?进而找到目标节点?](#问题 2:如何通过 wait_queue_t 获取到 eppoll_entry 结构体?进而找到目标节点?)
前言
在前两篇文章中,我们依次学习了 IO 模型的基础概念,以及
select、poll两种 IO 多路复用方案。我们看到,select 受限于固定 1024 个 fd 上限,每次调用都需要重复传递待监听 fd 集合,内核需要对全部 fd 做轮询扫描;poll 虽然解除了 fd 数量上限,但依然没有摆脱全量遍历的性能缺陷,二者在海量并发连接场景下性能都会急剧下降。为了解决传统多路转接的性能短板,Linux 内核引入了 epoll,这是专为大规模高并发场景设计的 IO 多路复用方案。本文将从使用接口入手,逐层深入内核底层,拆解 epoll_create、epoll_ctl、epoll_wait 三大系统调用,结合内核结构体、回调触发逻辑,讲清楚红黑树、就绪队列的分工,同时解析 container_of 这类内核经典编程技巧,搞懂 epoll 事件回调的完整链路。
读完本文,你将理解 epoll 相比 select/poll 的本质优势,不再只停留在 "epoll 性能高" 的表层结论,能够从内核源码视角看懂 epoll 的事件注册、触发、就绪通知全流程,为后续高并发服务端实战开发打下底层理论基础。
一、epoll:大规模并发场景下的 IO 多路转接方案
1.1 传统多路转接方案的性能缺陷
在 epoll 出现之前,Linux 依靠 select、poll 实现单线程监听多个文件描述符,能够实现 IO 多路转接,但二者存在难以规避的性能缺陷,这也是 epoll 诞生的核心动因。
- 内核需要遍历全部被监听 fd: 每次检测 IO 就绪事件,内核都要轮询所有 加入监听集合的文件描述符。当并发连接数上万时,大量连接处于空闲状态,内核依旧执行全量扫描,产生大量无效计算,性能会随着 fd 数量增加线性衰减。
- 用户态与内核态之间重复拷贝 fd 集合: 每次发起系统调用,完整的 fd 监听集合 都要在用户态、内核态之间来回拷贝。连接数量越大,拷贝带来的资源开销就越明显。
- 接口使用存在额外限制: select 有默认 1024 的文件描述符上限,难以支撑高并发场景,并且每次调用前都需要重新初始化 fd 集合;poll 虽然去掉了 fd 数量上限,区分了入参和返回事件,但内核全量遍历、反复拷贝这两个核心性能问题没有得到解决。
1.2 epoll 的设计目标与底层定位
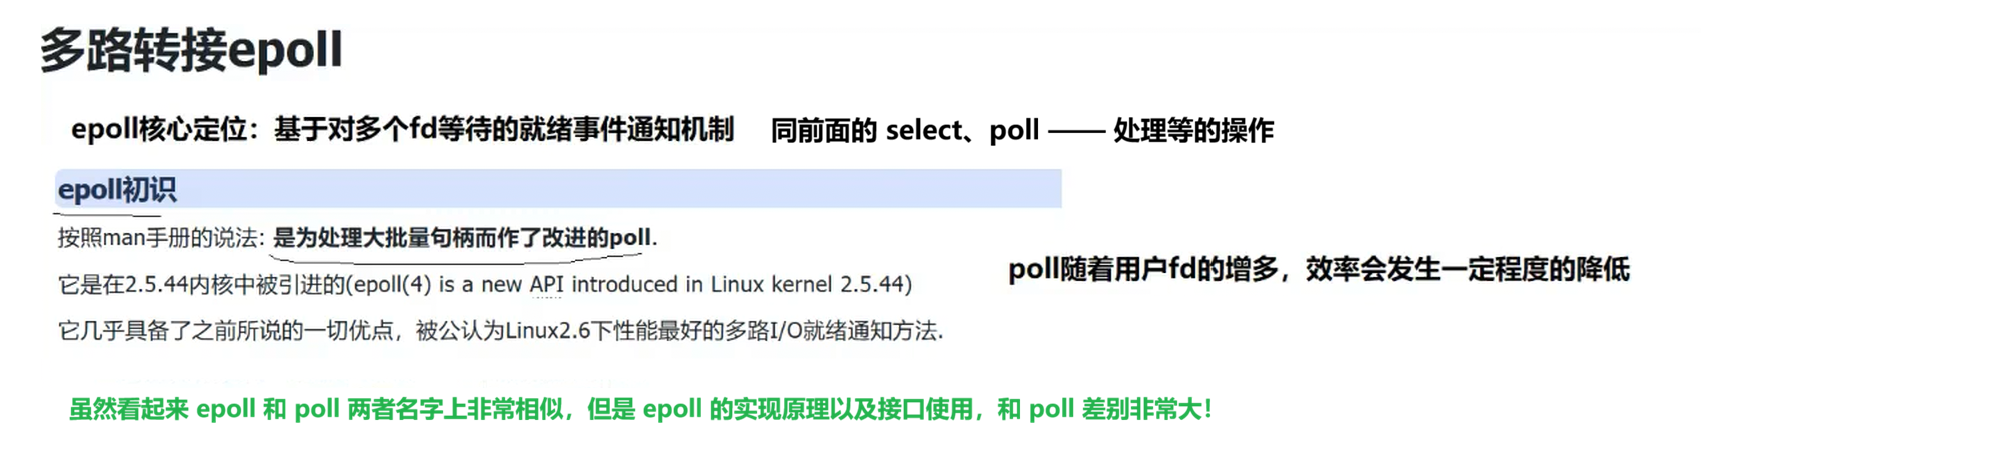
Linux 手册中将 epoll 描述为:专为大批量句柄场景优化改进的 poll。它在内核 2.5.44 版本正式引入,从 Linux2.6 版本开始,成为高性能服务开发的标配,是 Linux 平台综合性能最优的 IO 多路转接实现。
epoll 本质属于IO 就绪事件通知机制,和 select、poll 的职责一致:它不会执行数据读写操作,仅向业务层反馈哪些文件描述符已经就绪可读、可写,实际的数据读取与写入,仍然由业务代码完成。
关键区别: 尽管 epoll 名称和 poll 相近,但它并非对 poll 做小幅修改,而是重构了底层整个数据结构与事件触发逻辑,这也就是为什么 epoll 最终能解决内核全量遍历、反复拷贝这两大核心问题 。
epoll 依靠红黑树维护监听集合、就绪队列存放就绪 fd、回调函数触发事件这套内核机制,epoll 从根源解决了全量遍历、多次拷贝的性能瓶颈。
二、epoll 接口体系:三大核心系统调用
不同于 select、poll 将全部逻辑封装在单个函数中,epoll 把实例创建、监听管理、事件等待 拆分成三个独立系统调用,职责解耦,使用更加灵活 ,接口都需要引入头文件 <sys/epoll.h>。
2.1 epoll_create:创建 epoll 实例
2.1.1 函数原型
cpp
#include <sys/epoll.h>
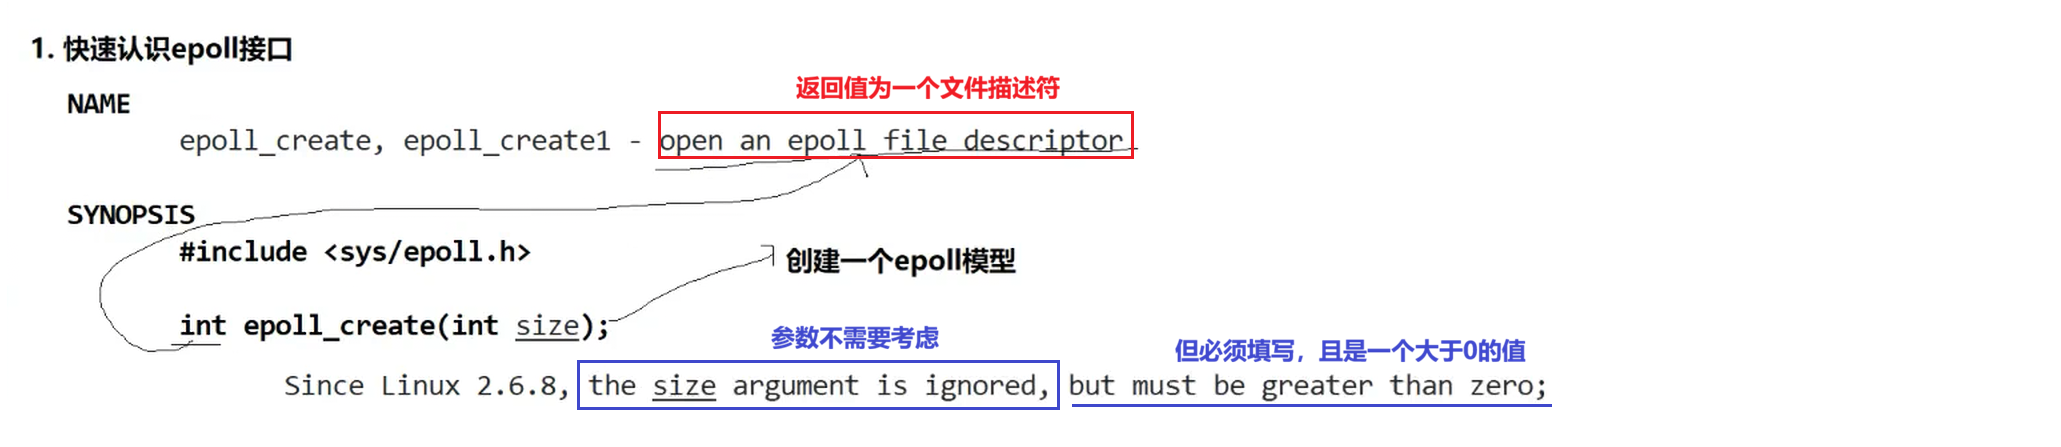
int epoll_create(int size);
2.1.2 参数与返回值
- size 参数 :在内核 2.6.8 版本之前,size 用于告诉内核预期监听的 fd 数量,内核以此预分配内存。从 Linux 2.6.8 开始,该参数会被内核直接忽略,但调用时必须传入大于 0 的整数 ,保证向后兼容。新版本推荐使用
epoll_create1(int flags),直接取消 size 参数,依靠 flags 配置行为。 - 返回值 :成功返回 epoll 实例对应的文件描述符(epoll 句柄);失败返回
-1,并且设置 errno 错误码。
2.1.3 底层本质
遵循 Linux「一切皆文件」的设计思想,调用该函数,内核会在内存中生成独立 epoll 实例,内部维护两组核心结构:
红黑树: 用来保存所有需要监听的文件描述符;
**就绪双向队列:**存放已经触发 IO 事件的 fd 节点。epoll 实例本身抽象成文件,通过返回的 fd,让进程唯一标识访问这个 epoll 对象。
2.2 epoll_ctl:管控监听事件(增 / 删 / 改监听 fd)
2.2.1 函数原型
cpp
#include <sys/epoll.h>
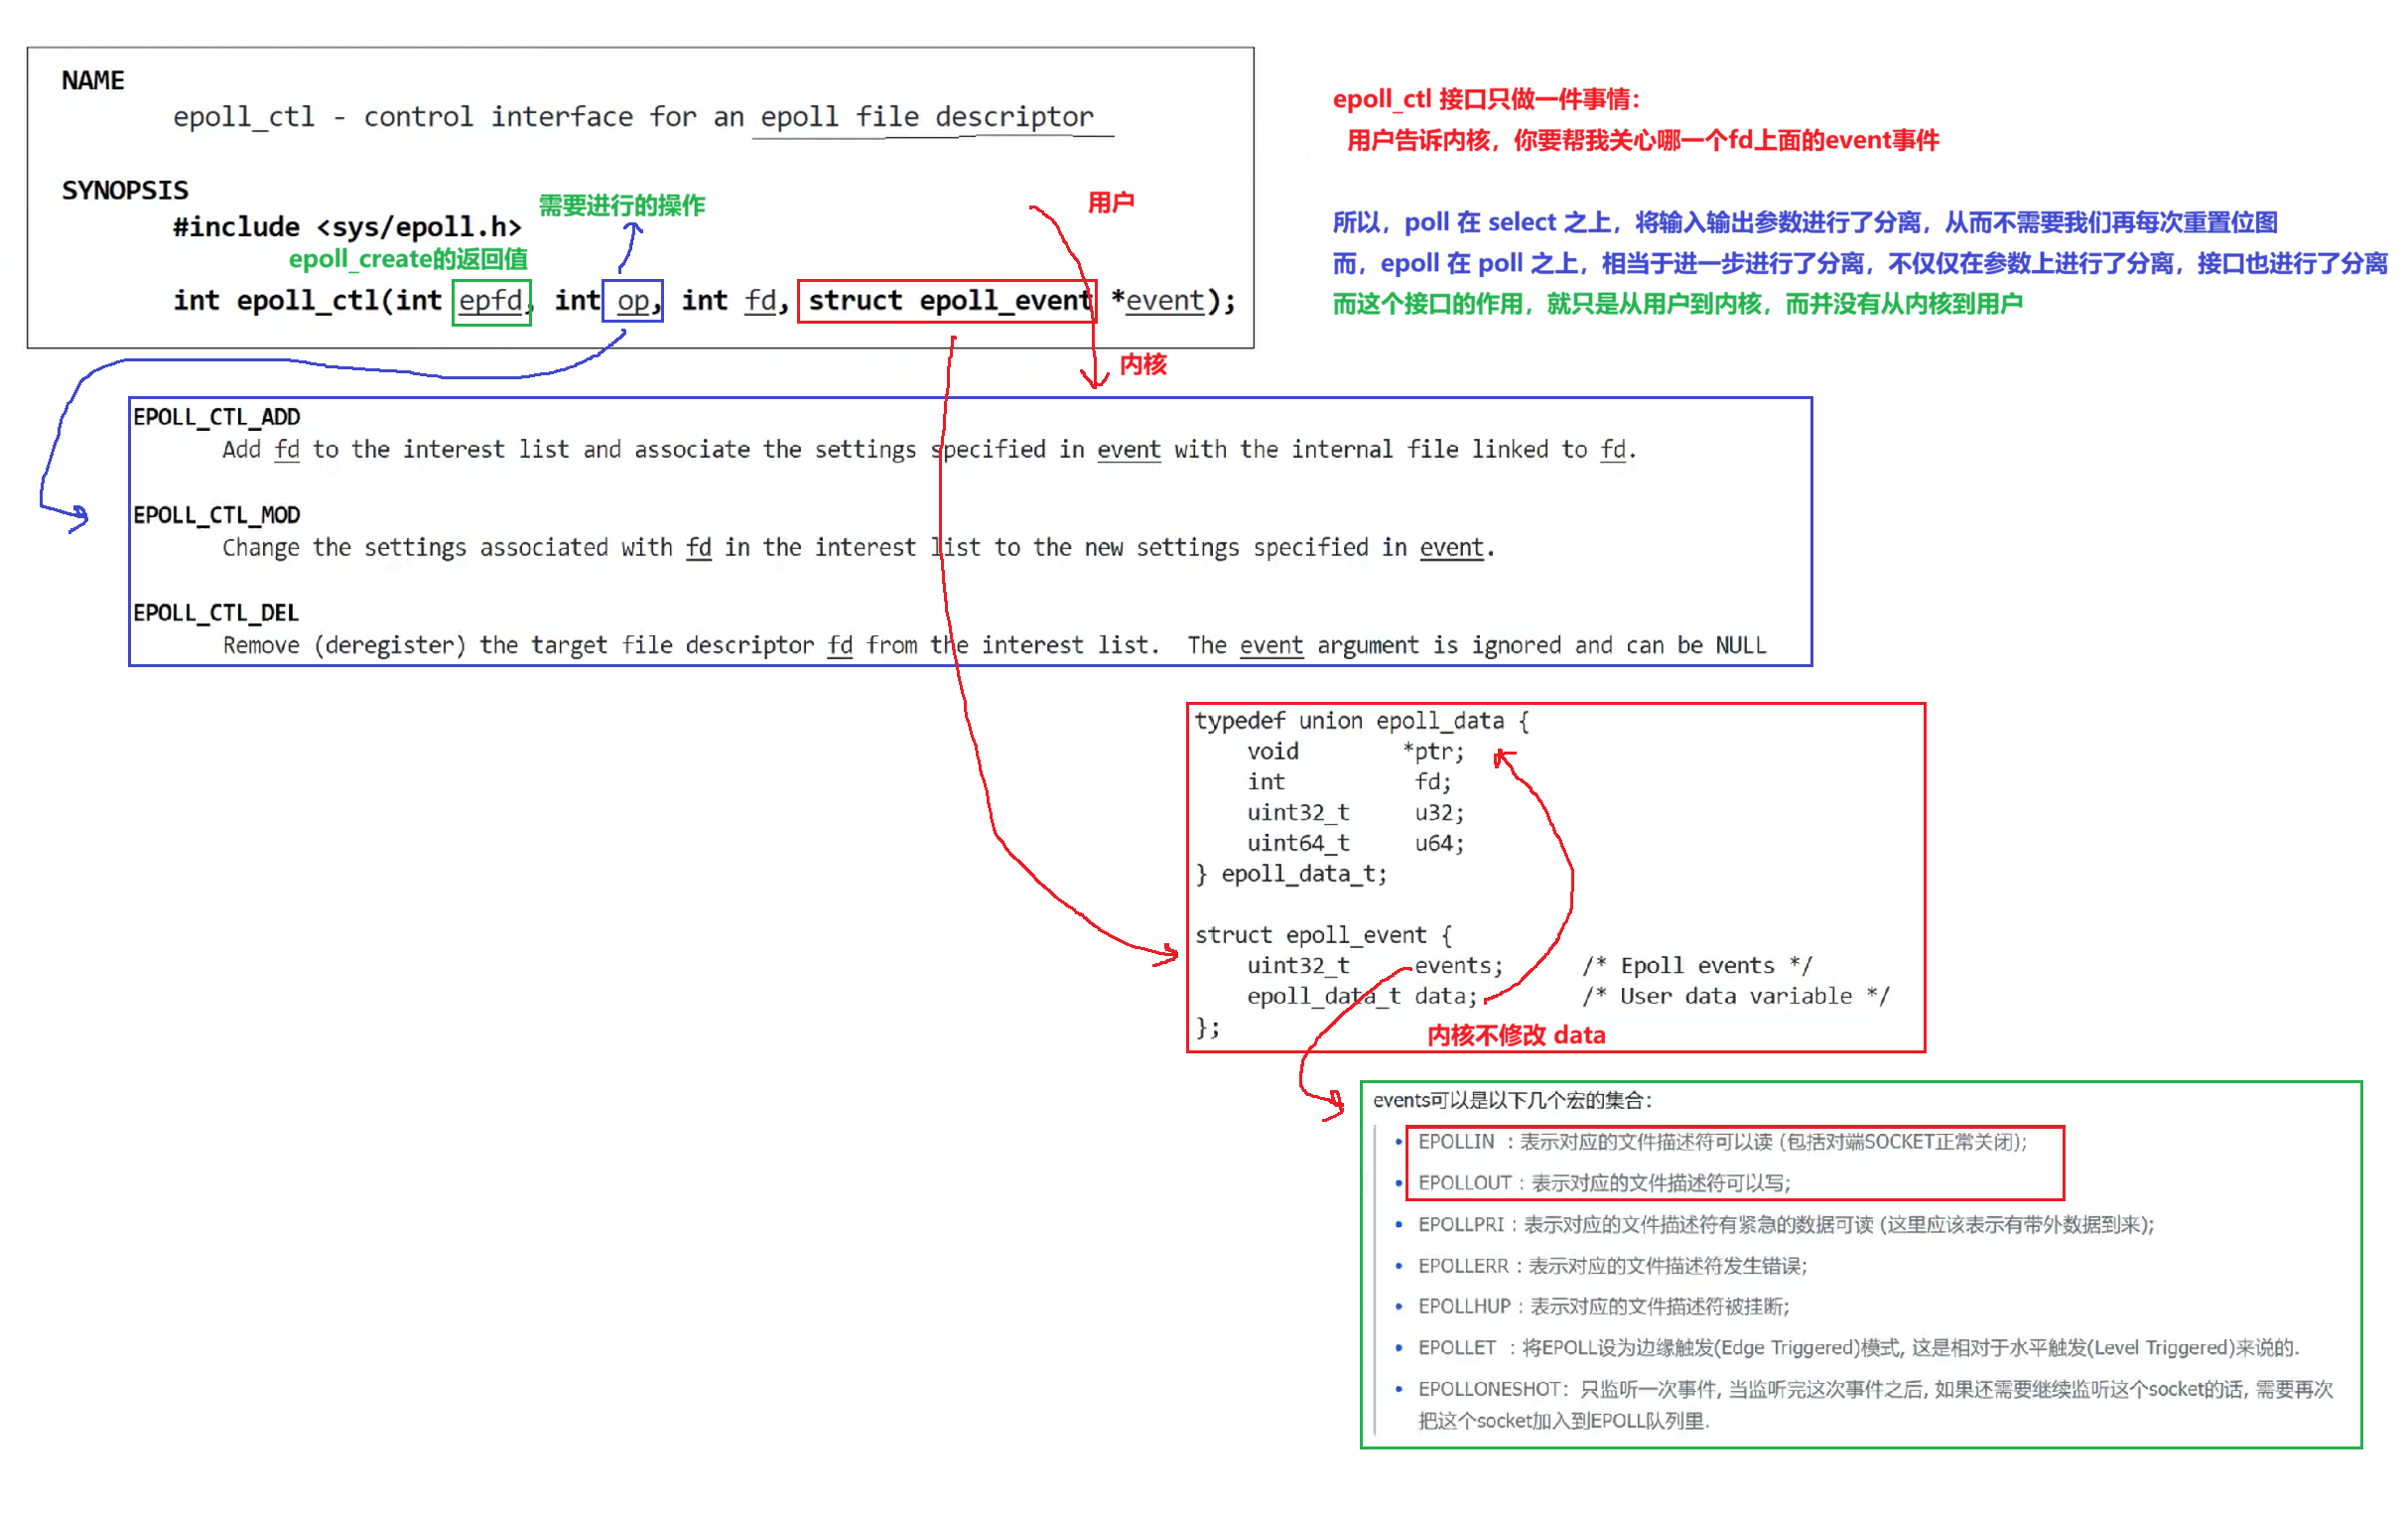
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
2.2.2 参数详解
- **
epfd:**epoll_create 返回的 epoll 实例句柄,指定要操作的 epoll 对象。 op: 操作类型,共 3 种宏:- **
EPOLL_CTL_ADD:**新增 fd,注册到 epoll 监听集合 - **
EPOLL_CTL_MOD:**修改已经注册 fd 的监听事件类型 - **
EPOLL_CTL_DEL:**从 epoll 中移除 fd,停止监听
- **
- **
fd:**目标操作的文件描述符,例如套接字、管道 fd。 event:struct epoll_event结构体指针,告诉内核当前 fd 需要监听哪些事件,同时携带用户自定义数据。
常用事件标志:
- **
EPOLLIN:**fd 可读(包含对端正常关闭连接场景) EPOLLOUT:fd 可写EPOLLERR:fd 发生错误,内核自动上报,无需手动注册EPOLLHUP:fd 连接挂断,内核自动上报EPOLLET:开启边缘触发模式EPOLLONESHOT:只监听一次事件,触发后自动移除,如需继续监听要重新注册
2.2.3 返回值与功能本质
调用成功返回 0,失败返回 - 1 并设置错误码。
epoll_ctl 是用户态和内核红黑树交互的入口 ,本质就是对内核红黑树做增删改操作,同时绑定套接字底层回调函数。当 fd 上产生 IO 事件,内核会通过回调自动把节点加入就绪队列。
对比理解: poll/select 是一次性把全部 fd 集合传给内核;epoll_ctl 是提前注册 fd 到内核,后续不用反复传递全部监听集合。
2.3 epoll_wait:等待就绪事件
2.3.1 函数原型
cpp
#include <sys/epoll.h>
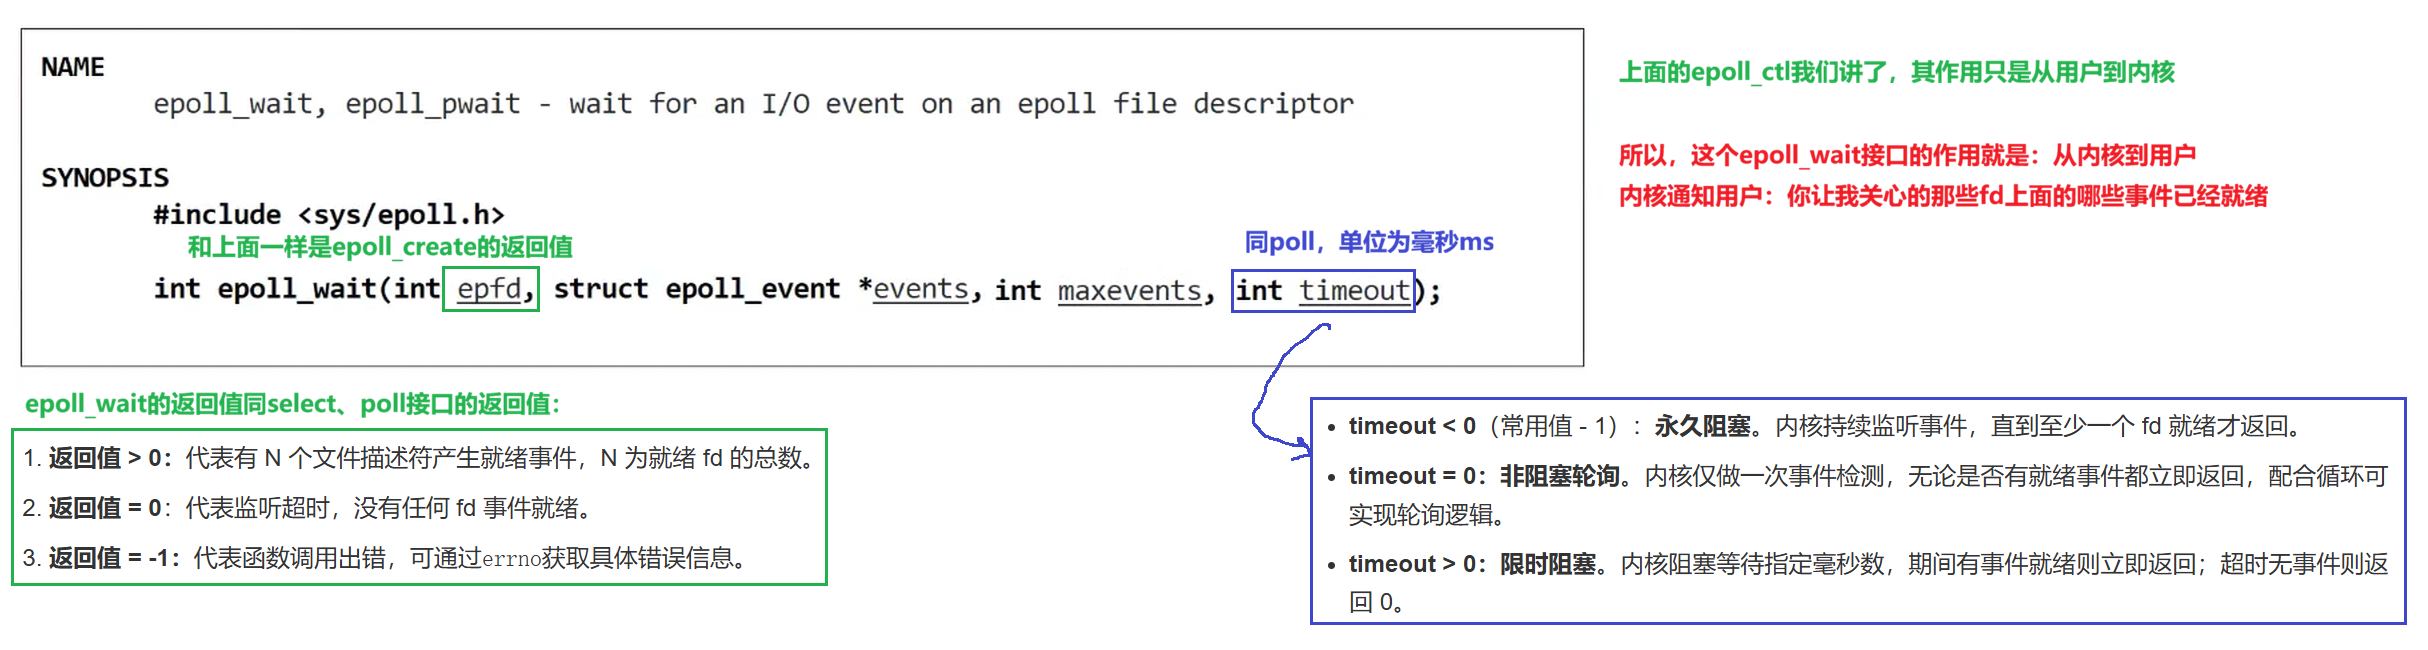
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);
2.3.2 参数详解
epfd:epoll 实例句柄。events:输出型参数,用户预先分配好的数组空间。调用前无需填充内容;事件就绪后,内核会把就绪事件与 fd 信息填充进这个数组,拷贝到用户态。这是和 select 每次重设 fd 集合最核心的区别。maxevents:events 数组最大元素数量,限制单次读取事件上限,防止越界。timeout:超时时间,单位毫秒,规则和 poll 完全一致- 小于 0(常用 - 1) :永久阻塞,直到有事件就绪才返回
- 等于 0 :非阻塞,立刻检测并返回,无就绪事件直接返回 0
- 大于 0 :限时阻塞,最多等待指定毫秒,超时无事件返回 0
2.3.3 返回值与底层逻辑
- 返回 >0: 就绪 fd 的数量,取值范围
[1, maxevents] - **返回 =0:**等待超时,没有事件就绪
- **返回 <0:**系统调用出错,可通过 errno 获取错误信息
epoll_wait 不会扫描全部监听 fd,只会检查内核就绪队列 。就绪队列非空,就说明有事件就绪了,就把队列里的事件拷贝到用户态数组;队列为空,则按照 timeout 规则阻塞进程。
所以,对于 epoll 而言判断是否存在事件就绪的操作复杂度仅为 O (1),而不再需要像 select/poll 那样只能通过全量遍历来进行判断**。**
一句话总结分工:epoll_ctl 负责用户态→内核 ,告诉内核要监听哪些 fd;epoll_wait 负责内核→用户态,把已经就绪的事件通知回业务代码。
三、epoll 内核工作原理(附详细图分析)
想要理解 epoll 高性能的根源,不能只停留在 API 调用层面,需要深入内核的数据结构与事件驱动流程。我们分为两个阶段进行分析:示意图原理分析、内核底层结构详解。
重点看图中内容,文字描述只是帮助理解图中的内容。
3.1 阶段一:示意图原理分析
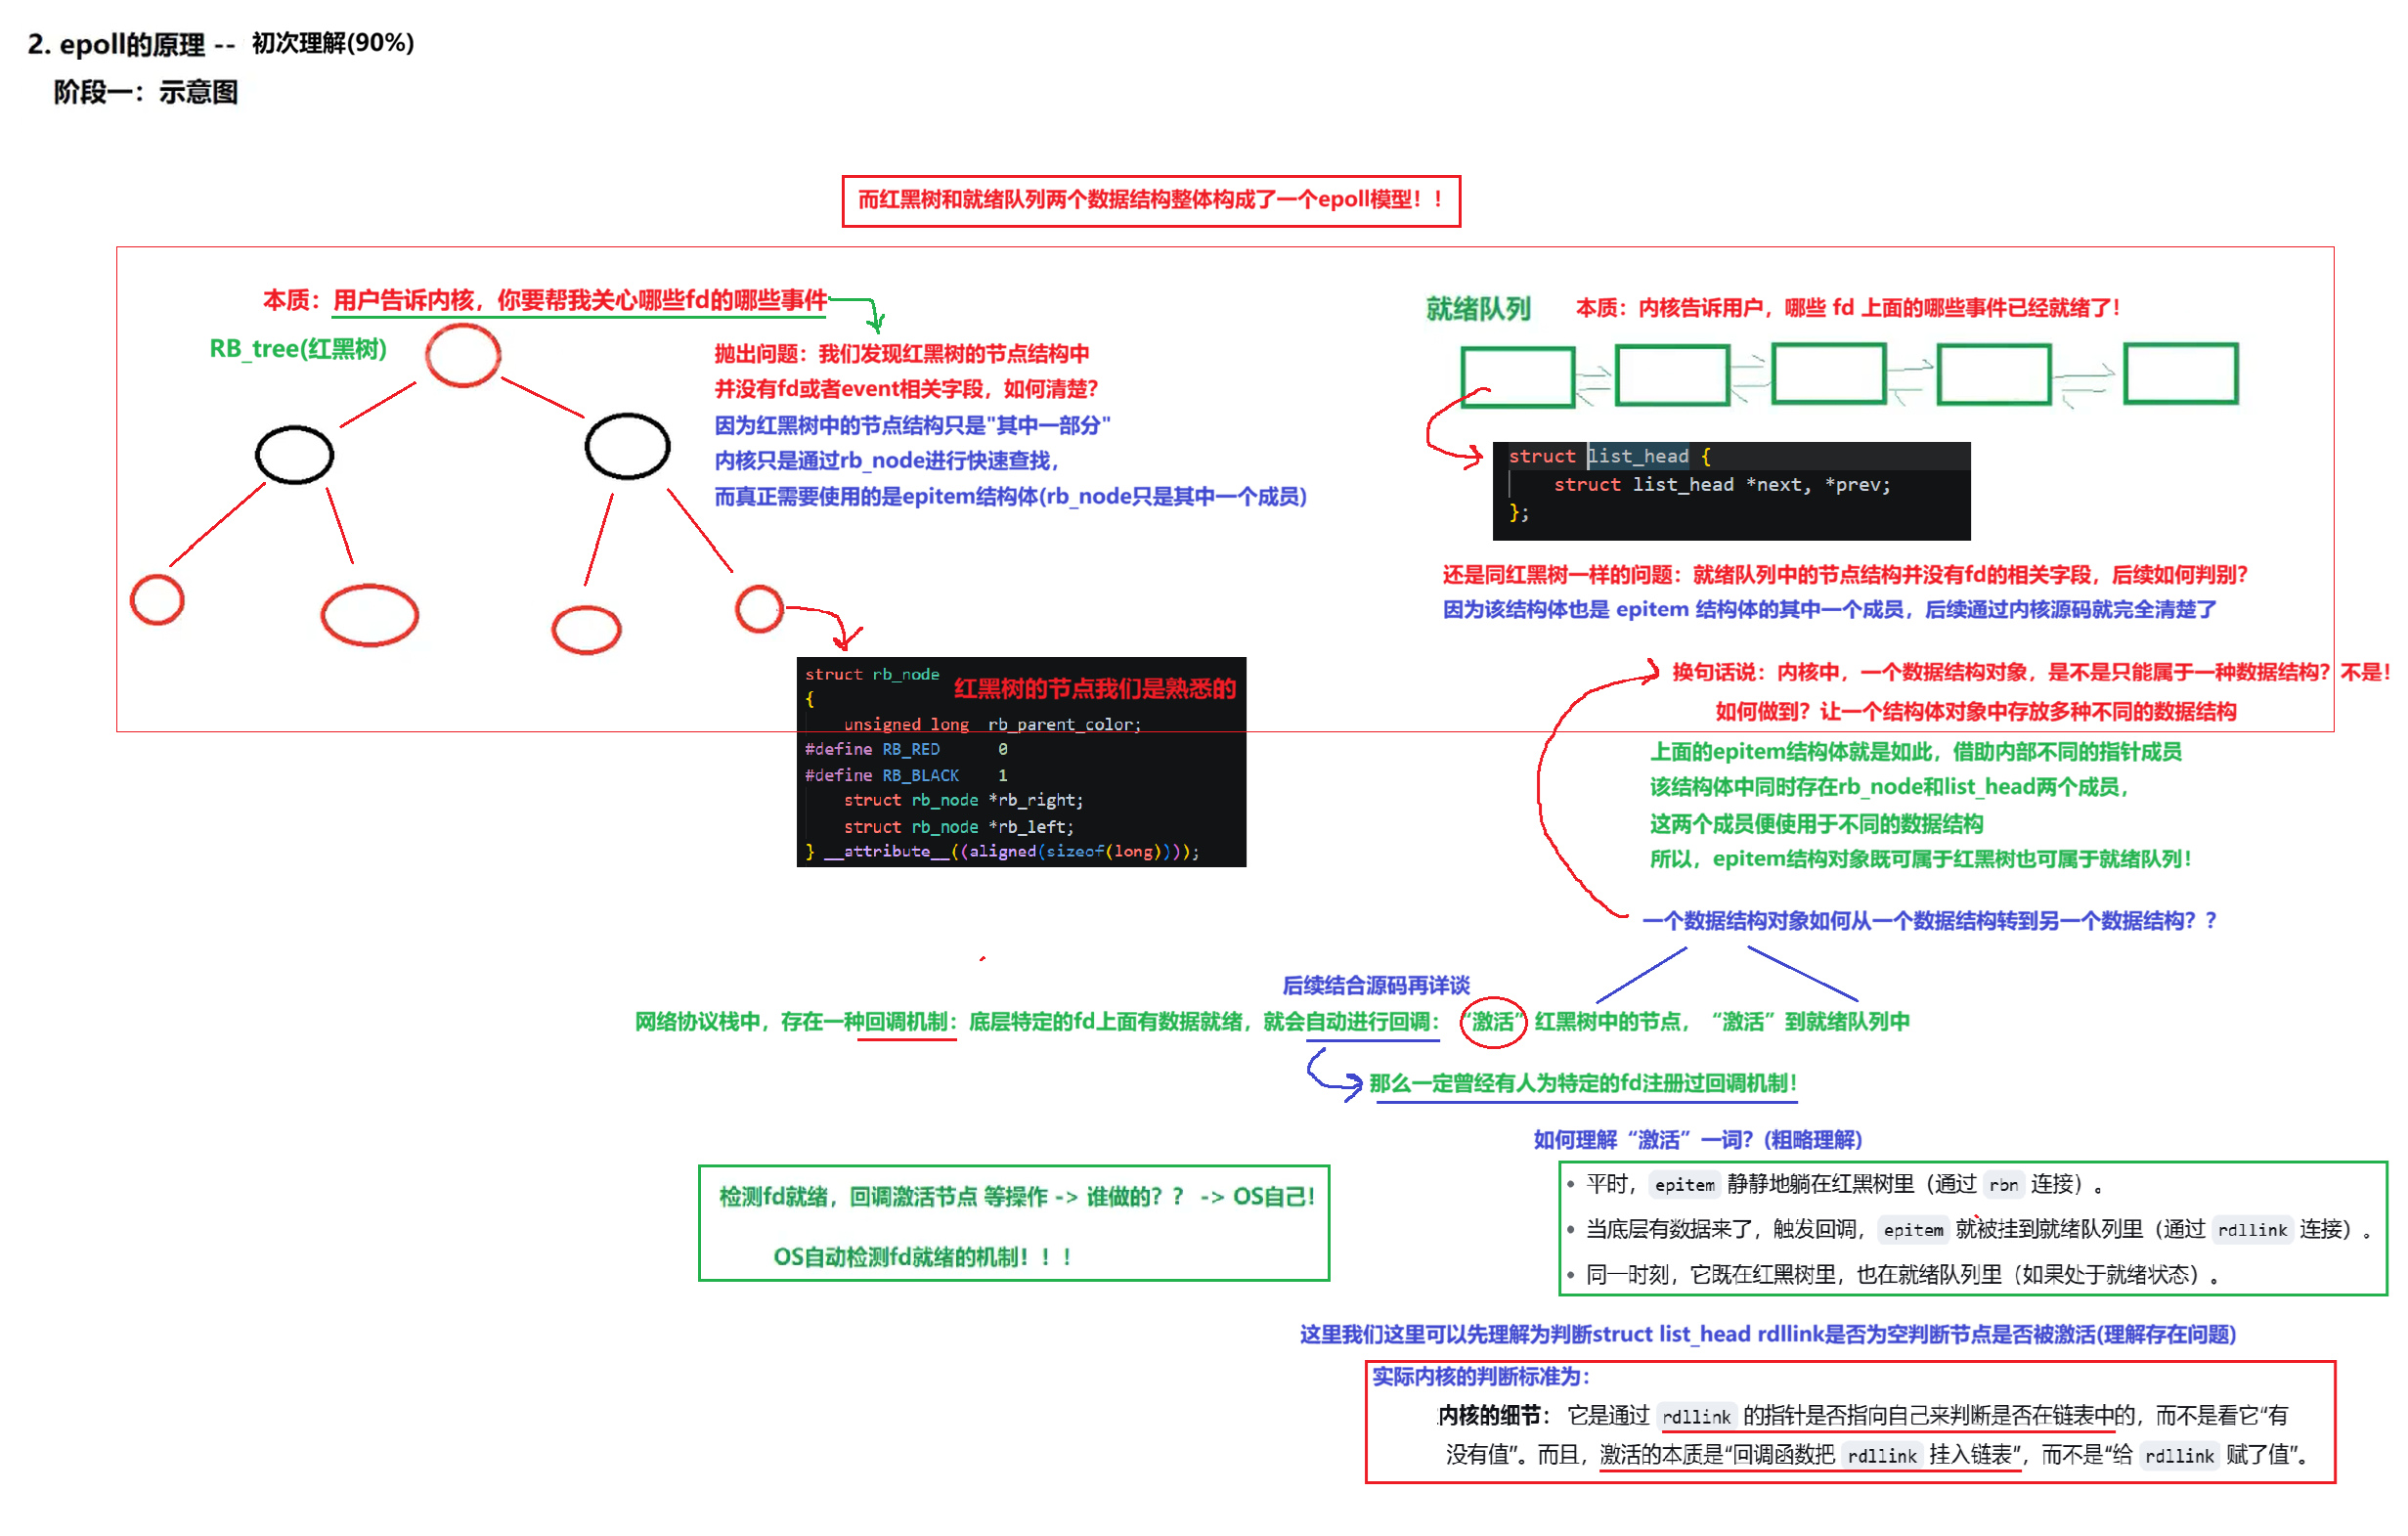
epoll 模型在内核中由红黑树 与就绪双向链表 两套核心数据结构共同构成。
红黑树用来存放所有注册监听的 fd 对应的节点;就绪链表专门存放已经触发 IO 事件的节点。同一个 epitem 节点,会同时挂载在这两套结构中。
3.1.1 红黑树与就绪队列的基础分工
- 红黑树: 保存所有被监听 fd 对应的 epitem 节点,负责对 fd 做增、删、改,查找的时间复杂度 O (logN)。当调用
epoll_ctl执行 ADD、MOD、DEL 操作时,本质就是操作内核红黑树。 - **就绪队列(rdllist 双向链表):**存放已经发生 IO 事件的 epitem 节点。当 fd 上产生可读 / 可写事件,内核通过回调机制,自动把对应节点挂载进就绪队列。
关键知识点:节点 本身不存储 fd、事件等业务信息 ,只是挂载的钩子。内核依靠**
container_of宏** ,通过成员地址反向计算,拿到完整epitem 结构体节点。
3.1.2 事件回调触发逻辑
当网卡收到数据,底层协议栈检测到 fd 有数据就绪,会触发套接字上预先注册的回调函数,把对应 epitem 节点 "激活",插入就绪队列。 epoll_wait不会遍历全部监听 fd,仅检查就绪队列:队列不为空,就把就绪事件拷贝给用户态;队列为空则阻塞进程。这是 epoll 对比 select/poll 性能优势的核心。
3.1.3 基于内核模型重谈 epoll 三个接口
epoll_ctl
cpp
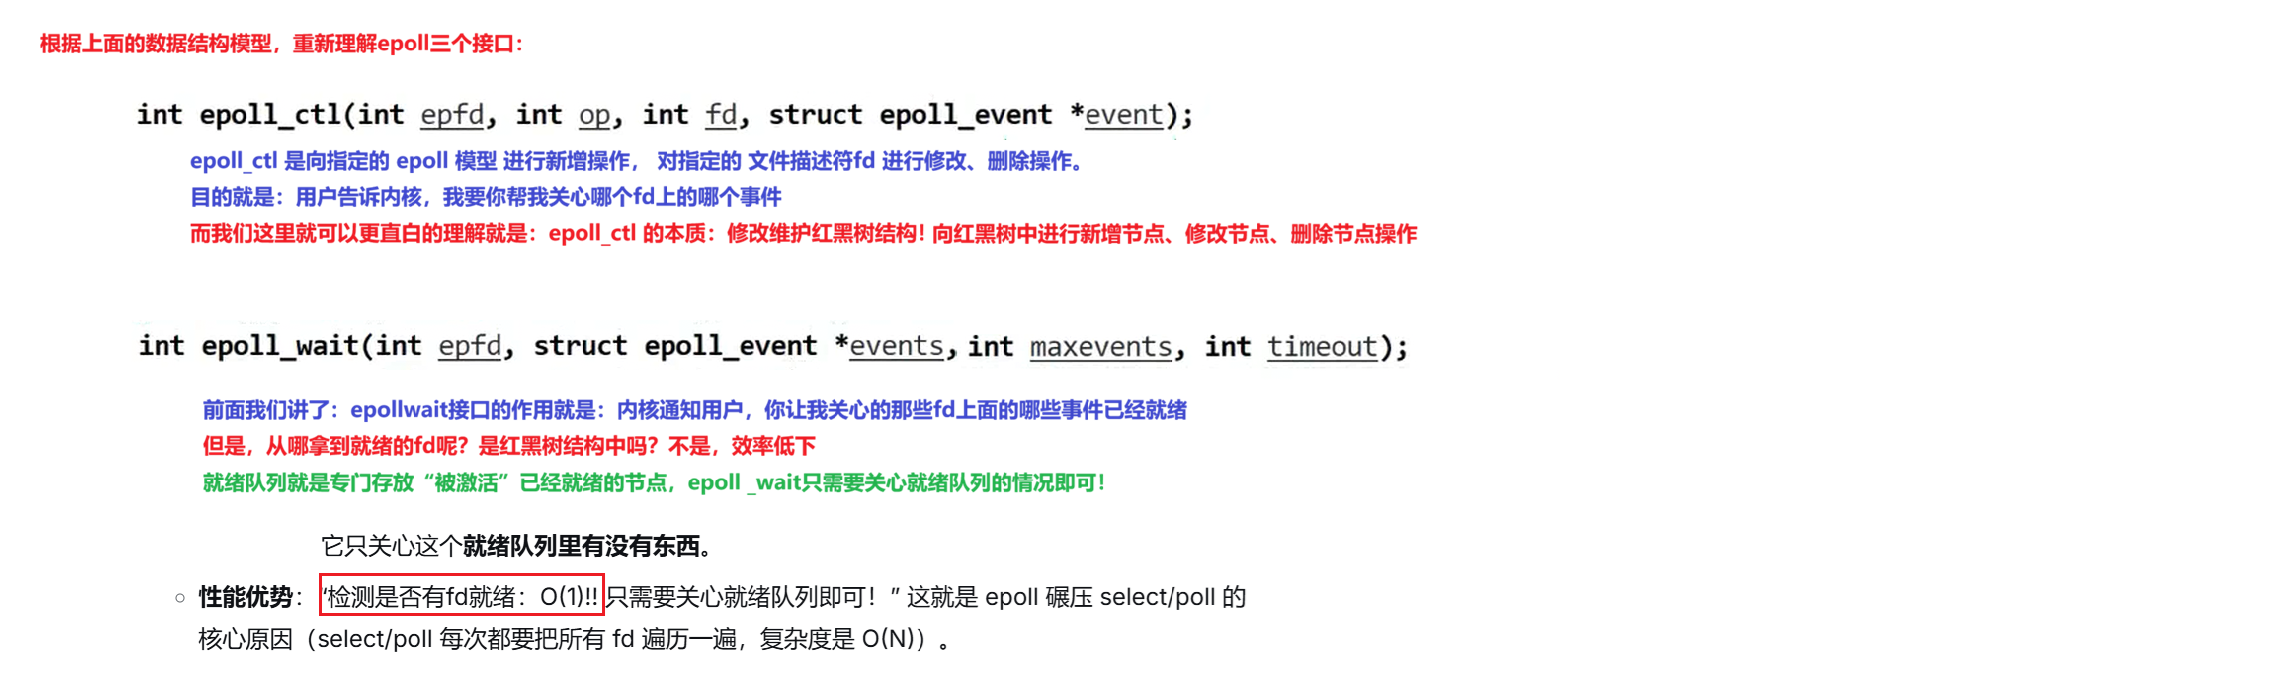
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);epoll_ctl 用于对 epoll 实例执行增、改、删操作,用来注册、修改、移除我们想要监听的文件描述符 fd。
从内核数据结构视角 看,这个接口的本质就是维护、修改红黑树:执行 ADD 时向红黑树新增 epitem 节点,MOD 修改节点内监听的事件类型,DEL 则将对应节点从红黑树中删除。
用户通过这个接口告诉内核:需要监控哪个 fd,以及关心该 fd 上的哪些 IO 事件。
epoll_wait
cpp
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);epoll_wait 的作用是等待事件就绪 ,内核通过这个接口,把已经触发 IO 事件的 fd 信息返回给用户程序。
这里有一个关键点:就绪的 fd不是从红黑树中查找 ,红黑树只是用来存放全部被监听 fd 的集合,遍历红黑树查找就绪节点效率很低。
内核专门维护就绪队列,只存放已经被事件激活的 epitem 节点。epoll_wait 只需要检查就绪队列是否存在数据。
- 性能优势: 判断有无就绪 fd 的时间复杂度为O(1);
- **对比 select/poll:**select、poll 每次调用必须遍历全部监听 fd,复杂度 O (N),这就是 epoll 在高并发场景性能碾压前两者的核心根源。
问题 1:如何理解就绪队列?
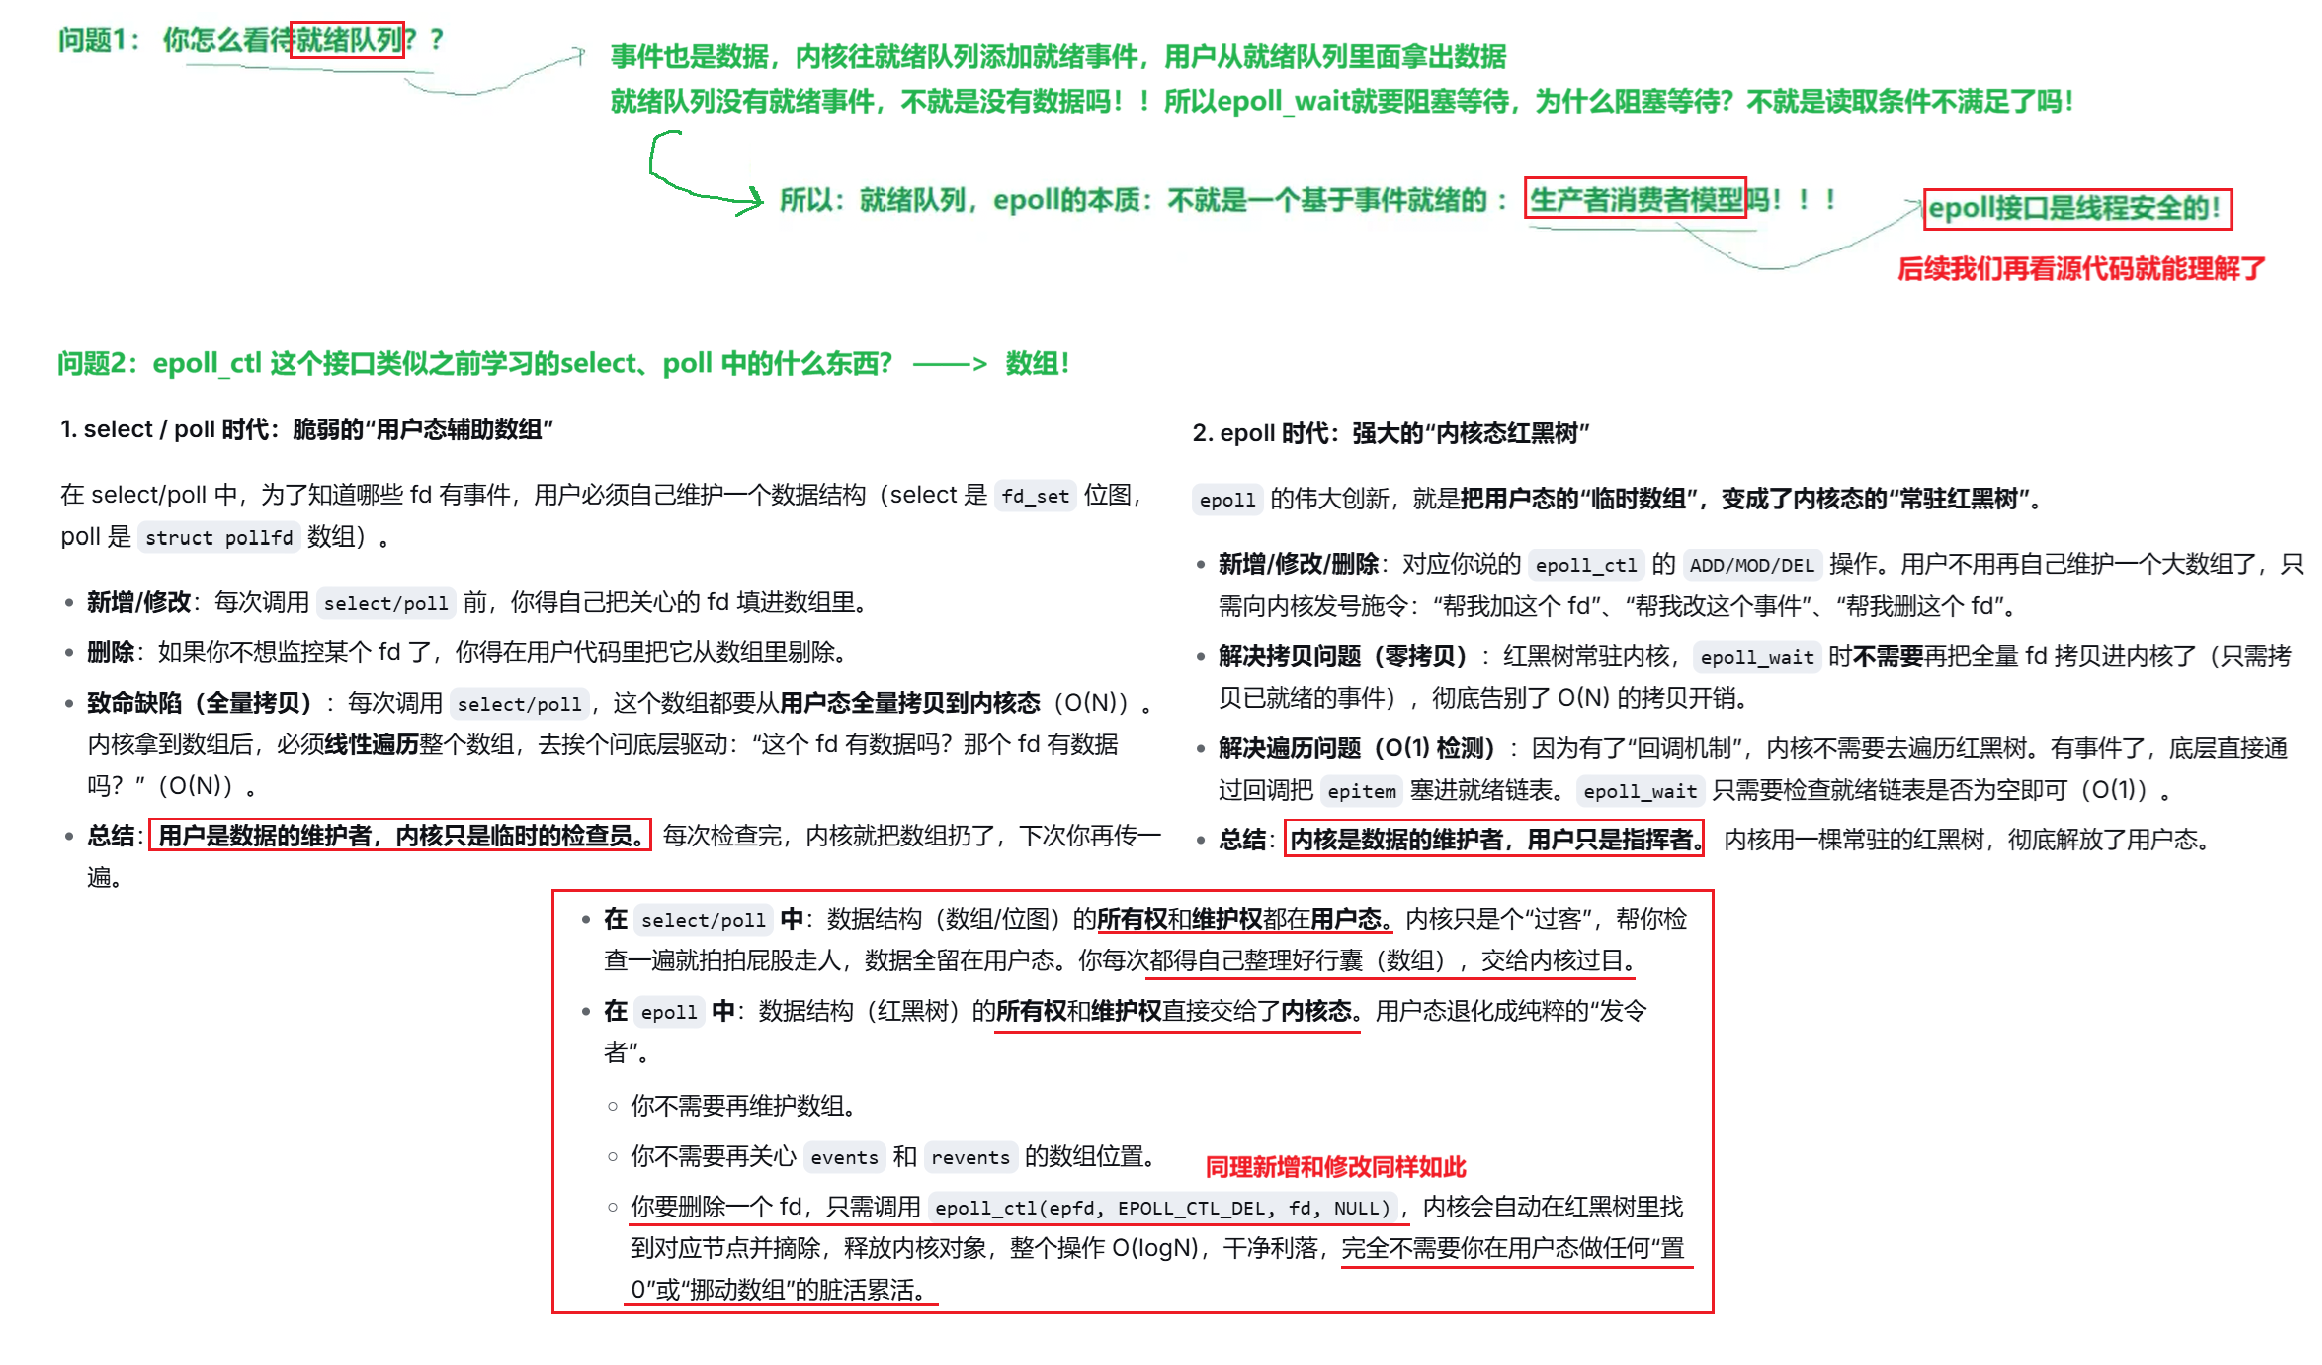
就绪队列本质是存放已经就绪事件节点的链表。没有事件的时候,队列是空;一旦 fd 产生 IO 事件,内核自动把节点加入就绪队列。epoll_wait 只需要读取这个队列,不需要遍历全部 fd。
就绪队列 可以理解为生产者 - 消费者模型 :内核是生产者,事件到来就往队列放入节点;用户进程通过 epoll_wait 作为消费者取出事件。epoll 本身是线程安全的。
问题 2:epoll_ctl 和 select/poll 的本质差异
- select/poll:用户态维护数组 ,每次系统调用,用户态都要把全部 fd 数组拷贝传递给内核;内核只做临时检查,调用结束后内核不会保留 fd 集合,下一次调用需要用户重新组装数组。用户是数据维护者,内核只是临时检查员。
- epoll:内核维护红黑树 。
epoll_ctl一次性把 fd 注册到内核红黑树,后续不需要反复传递全部 fd 集合。内核长期维护监听集合,用户只需要调用 epoll_ctl 做增删改。内核是数据维护者,用户只负责发起指令。
epoll_create
cpp
int epoll_create(int size);调用**epoll_create** 会在内核创建一个eventpoll实例,并且返回一个文件描述符。
问题 3:epoll_create 返回文件描述符的意义
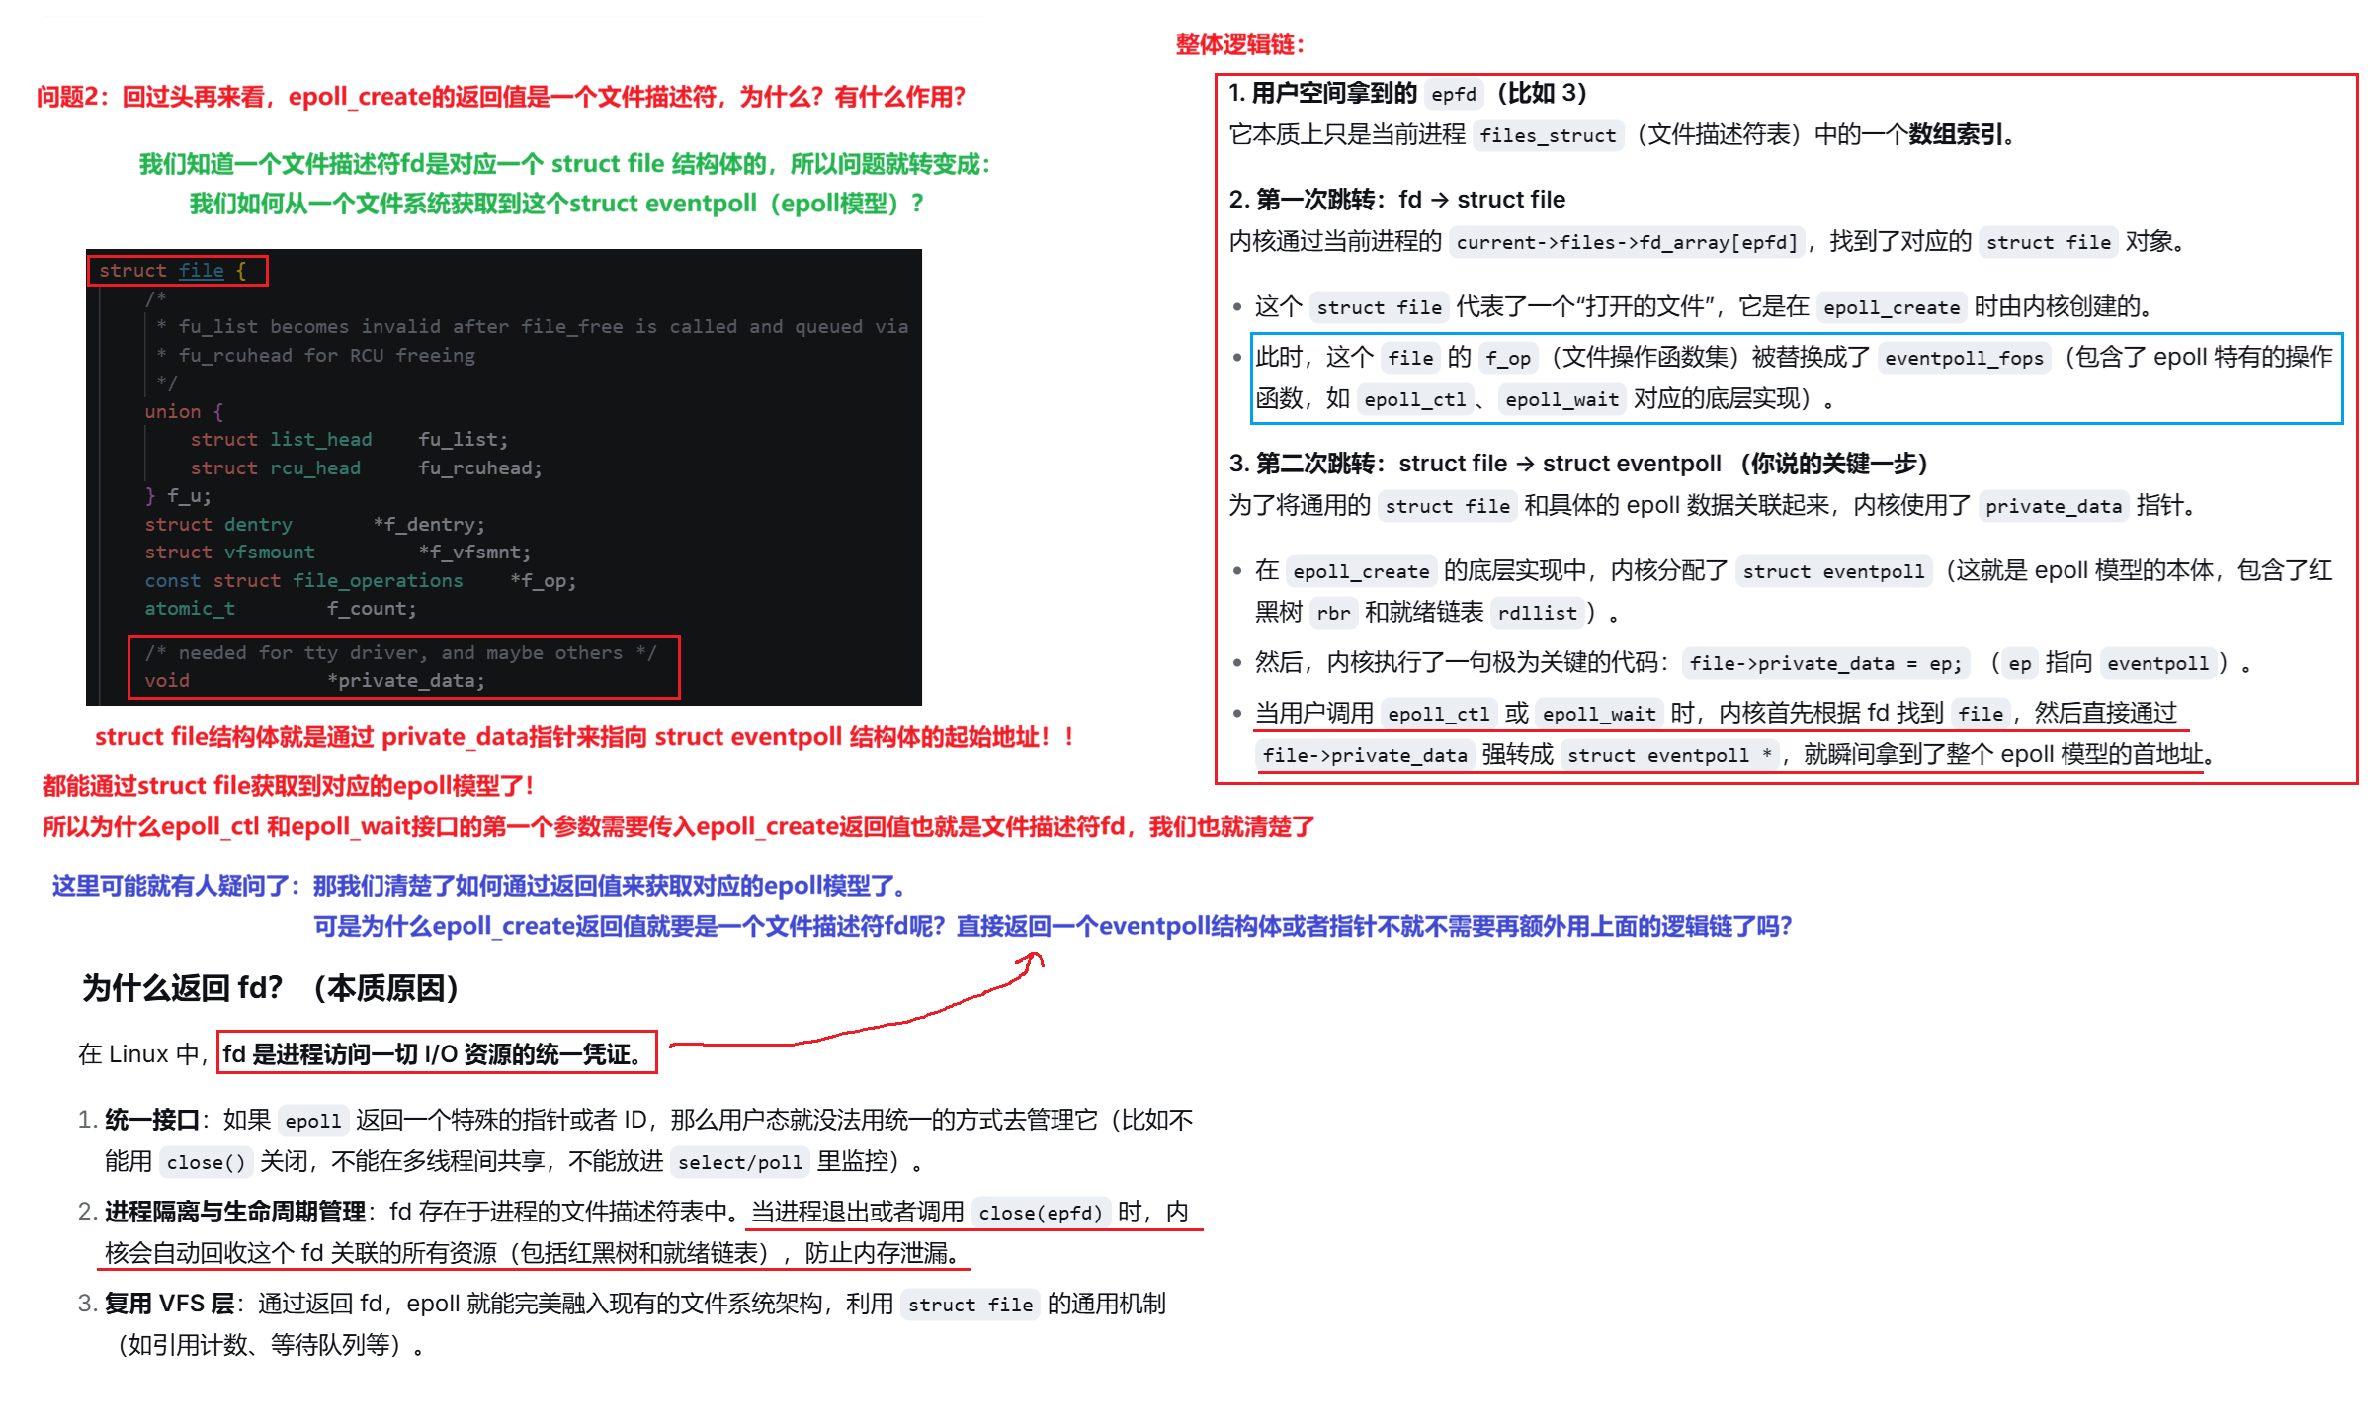
这里引出一个关键问题:epoll_create 为什么返回文件描述符,这个 fd 的作用是什么? Linux 遵循一切皆文件的设计思想,内核把 epoll 实例抽象成文件资源,使用 fd 作为句柄。
- 统一接口: fd 是进程访问 IO 资源的统一凭证,可以使用
close()释放资源; - **生命周期管理:**由进程的文件描述符表统一管理,进程退出或者手动 close 时,内核自动清理红黑树、就绪队列,避免内存泄漏;
- **复用 VFS:**复用 Linux 虚拟文件系统框架,让 epoll 实例可以和系统原有文件机制兼容。
拓展思考: epoll 模型如何和文件系统关联?想要理解底层关联,需要深入阅读内核源码,查看
eventpoll结构体与struct file之间的绑定关系。

3.2 阶段二:内核结构详解
3.2.1 内核核心结构体
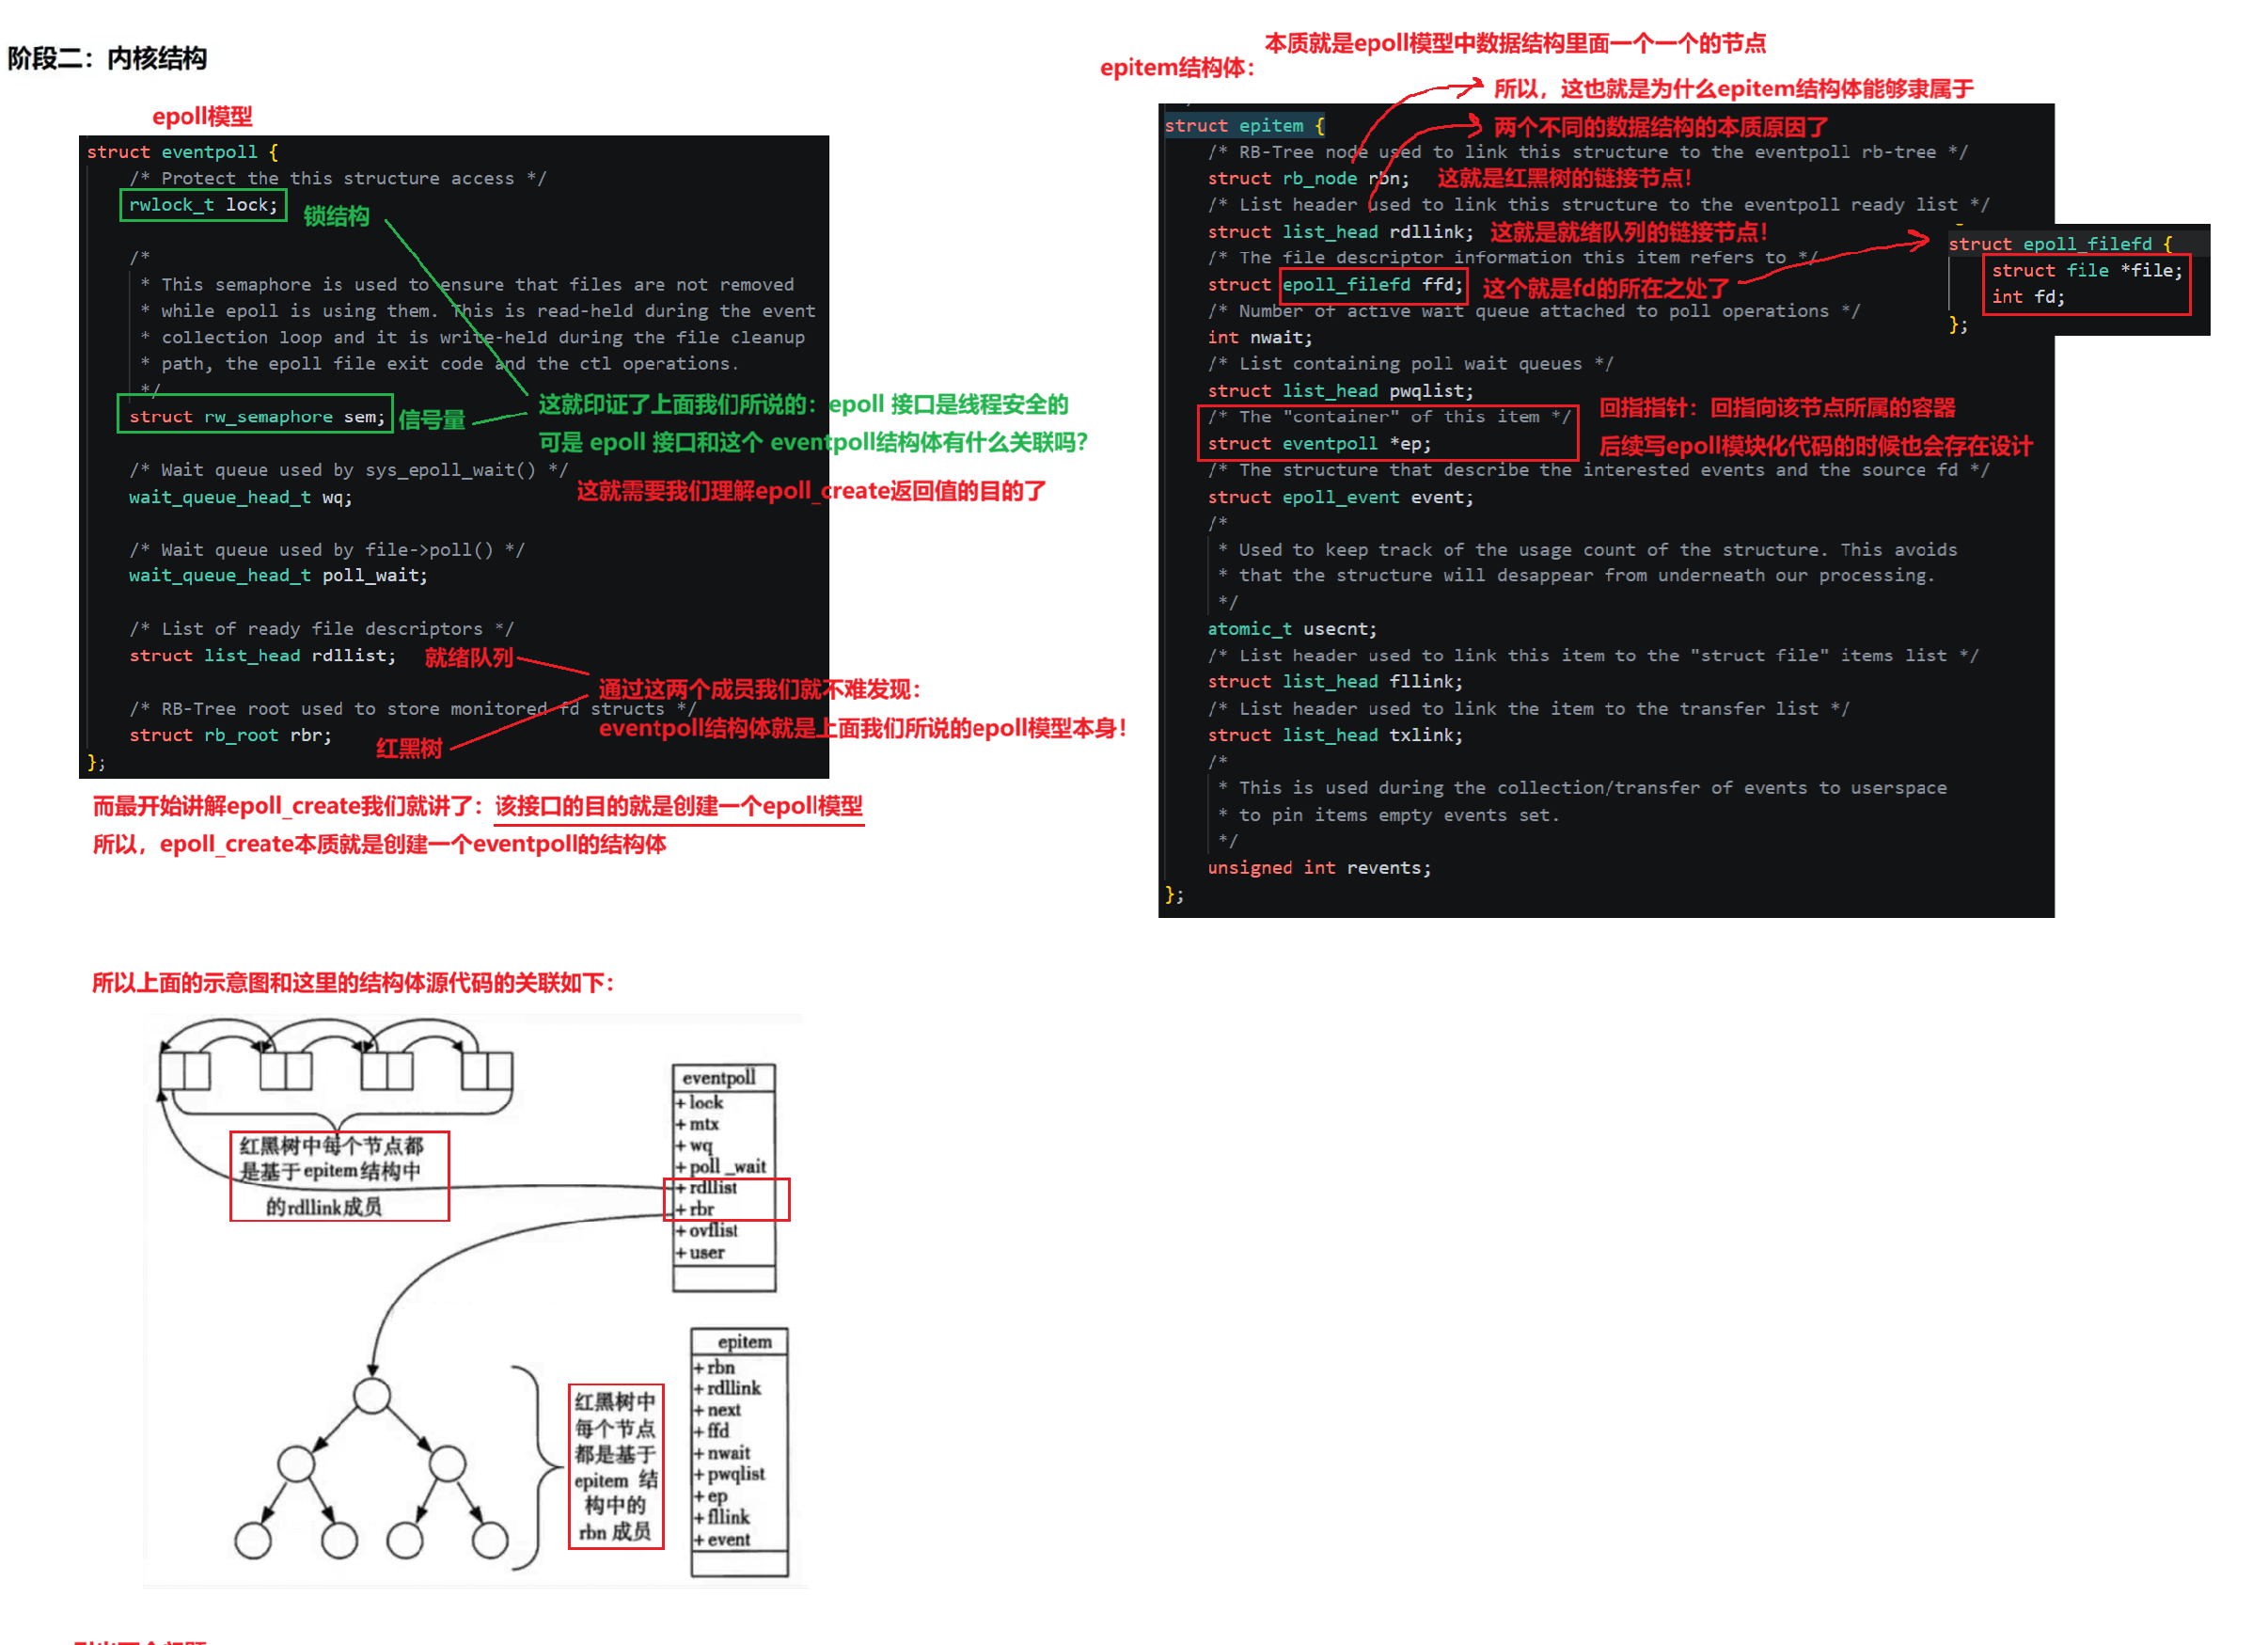
struct eventpoll:epoll 实例本体
每调用一次epoll_create,内核就生成一个eventpoll结构体,代表一个独立 epoll 实例。
cpp
struct eventpoll {
    spinlock_t lock;
    struct mutex mtx;
    wait_queue_head_t wq;        // epoll_wait的等待队列
    struct list_head rdllist;    // 就绪双向链表
    struct rb_root rbr;          // 红黑树根节点
    struct epitem *ovflist;      // 溢出链表
    struct user_struct *user;
};rbr:红黑树根,管理所有被监听 fd 对应的 epitem;rdllist:就绪双向链表,存放事件就绪的 epitem;wq:等待队列,当没有就绪事件时,阻塞 epoll_wait 的进程就挂在此等待队列。
struct epitem:单个 fd 对应的内核档案
每一个注册进 epoll 的 fd,内核都会创建 epitem 结构体作为该 fd 的记录。
epitem 是 epoll 内核中用来描述每一个被监听 fd 的核心结构体。每当调用epoll_ctl 添加一个 fd,本质就是内核生成一个**epitem实例** 。
结构体内部包含:监听的 fd、注册的事件、用于挂载红黑树的rb_node、用于挂载就绪链表的rdllink等成员。
cpp
struct epitem {
    struct rb_node rbn;           // 红黑树节点,挂载到eventpoll红黑树
    struct list_head rdllink;     // 链表节点,挂载到就绪队列
    struct epoll_filefd ffd;      // 目标fd信息
    struct eventpoll *ep;         // 归属的eventpoll实例
    struct epoll_event event;     // 用户注册的监听事件
    unsigned int revents;         // 实际触发的就绪事件
    // ...其他内核字段
};
epitem 同时包含红黑树节点rbn与链表节点rdllink ,所以同一个 epitem 节点,可以同时挂载在红黑树与就绪队列两个数据结构中。
3.2.2 问题 1:如何获取epitem结构体?
引出问题: 红黑树、就绪队列里挂载的仅仅是
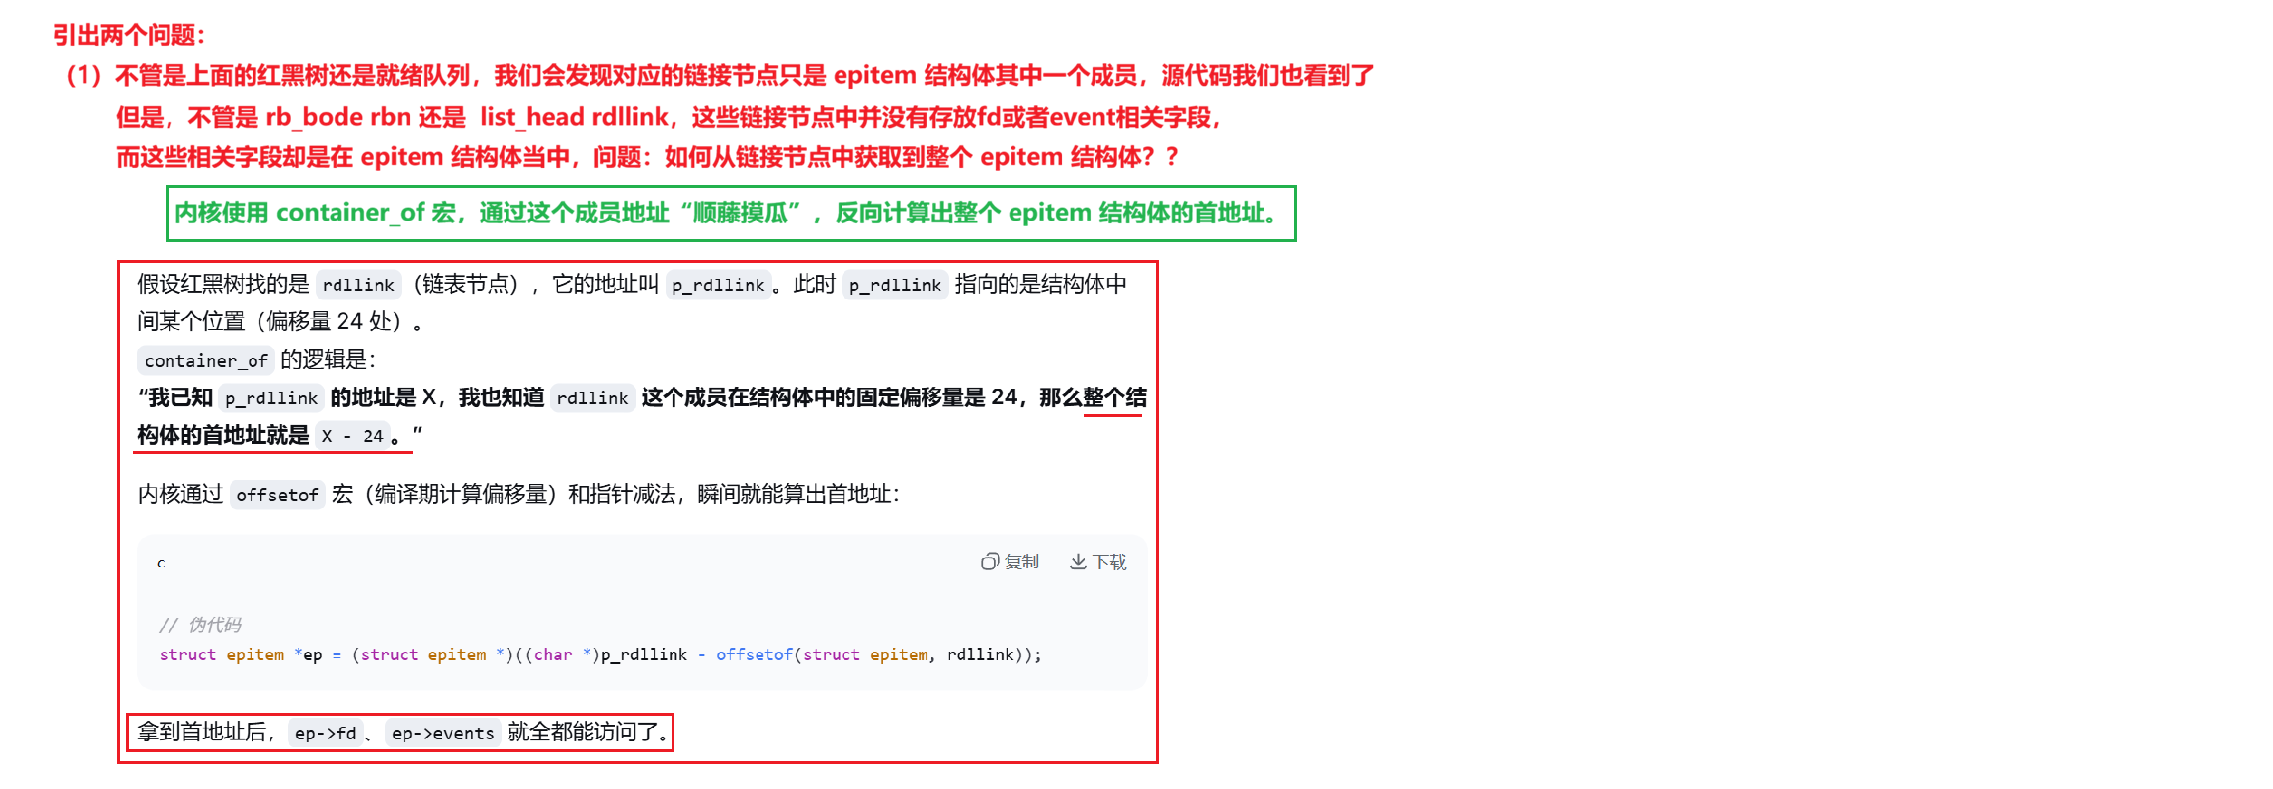
rb_node和rdllink这两个链表节点成员。节点本身并不存储 fd、event 这些业务字段 ,fd 和事件信息全部保存在外层epitem结构体内部。那么内核拿到rb_node或者rdllink成员的指针后,如何反向找到完整的epitem结构体?
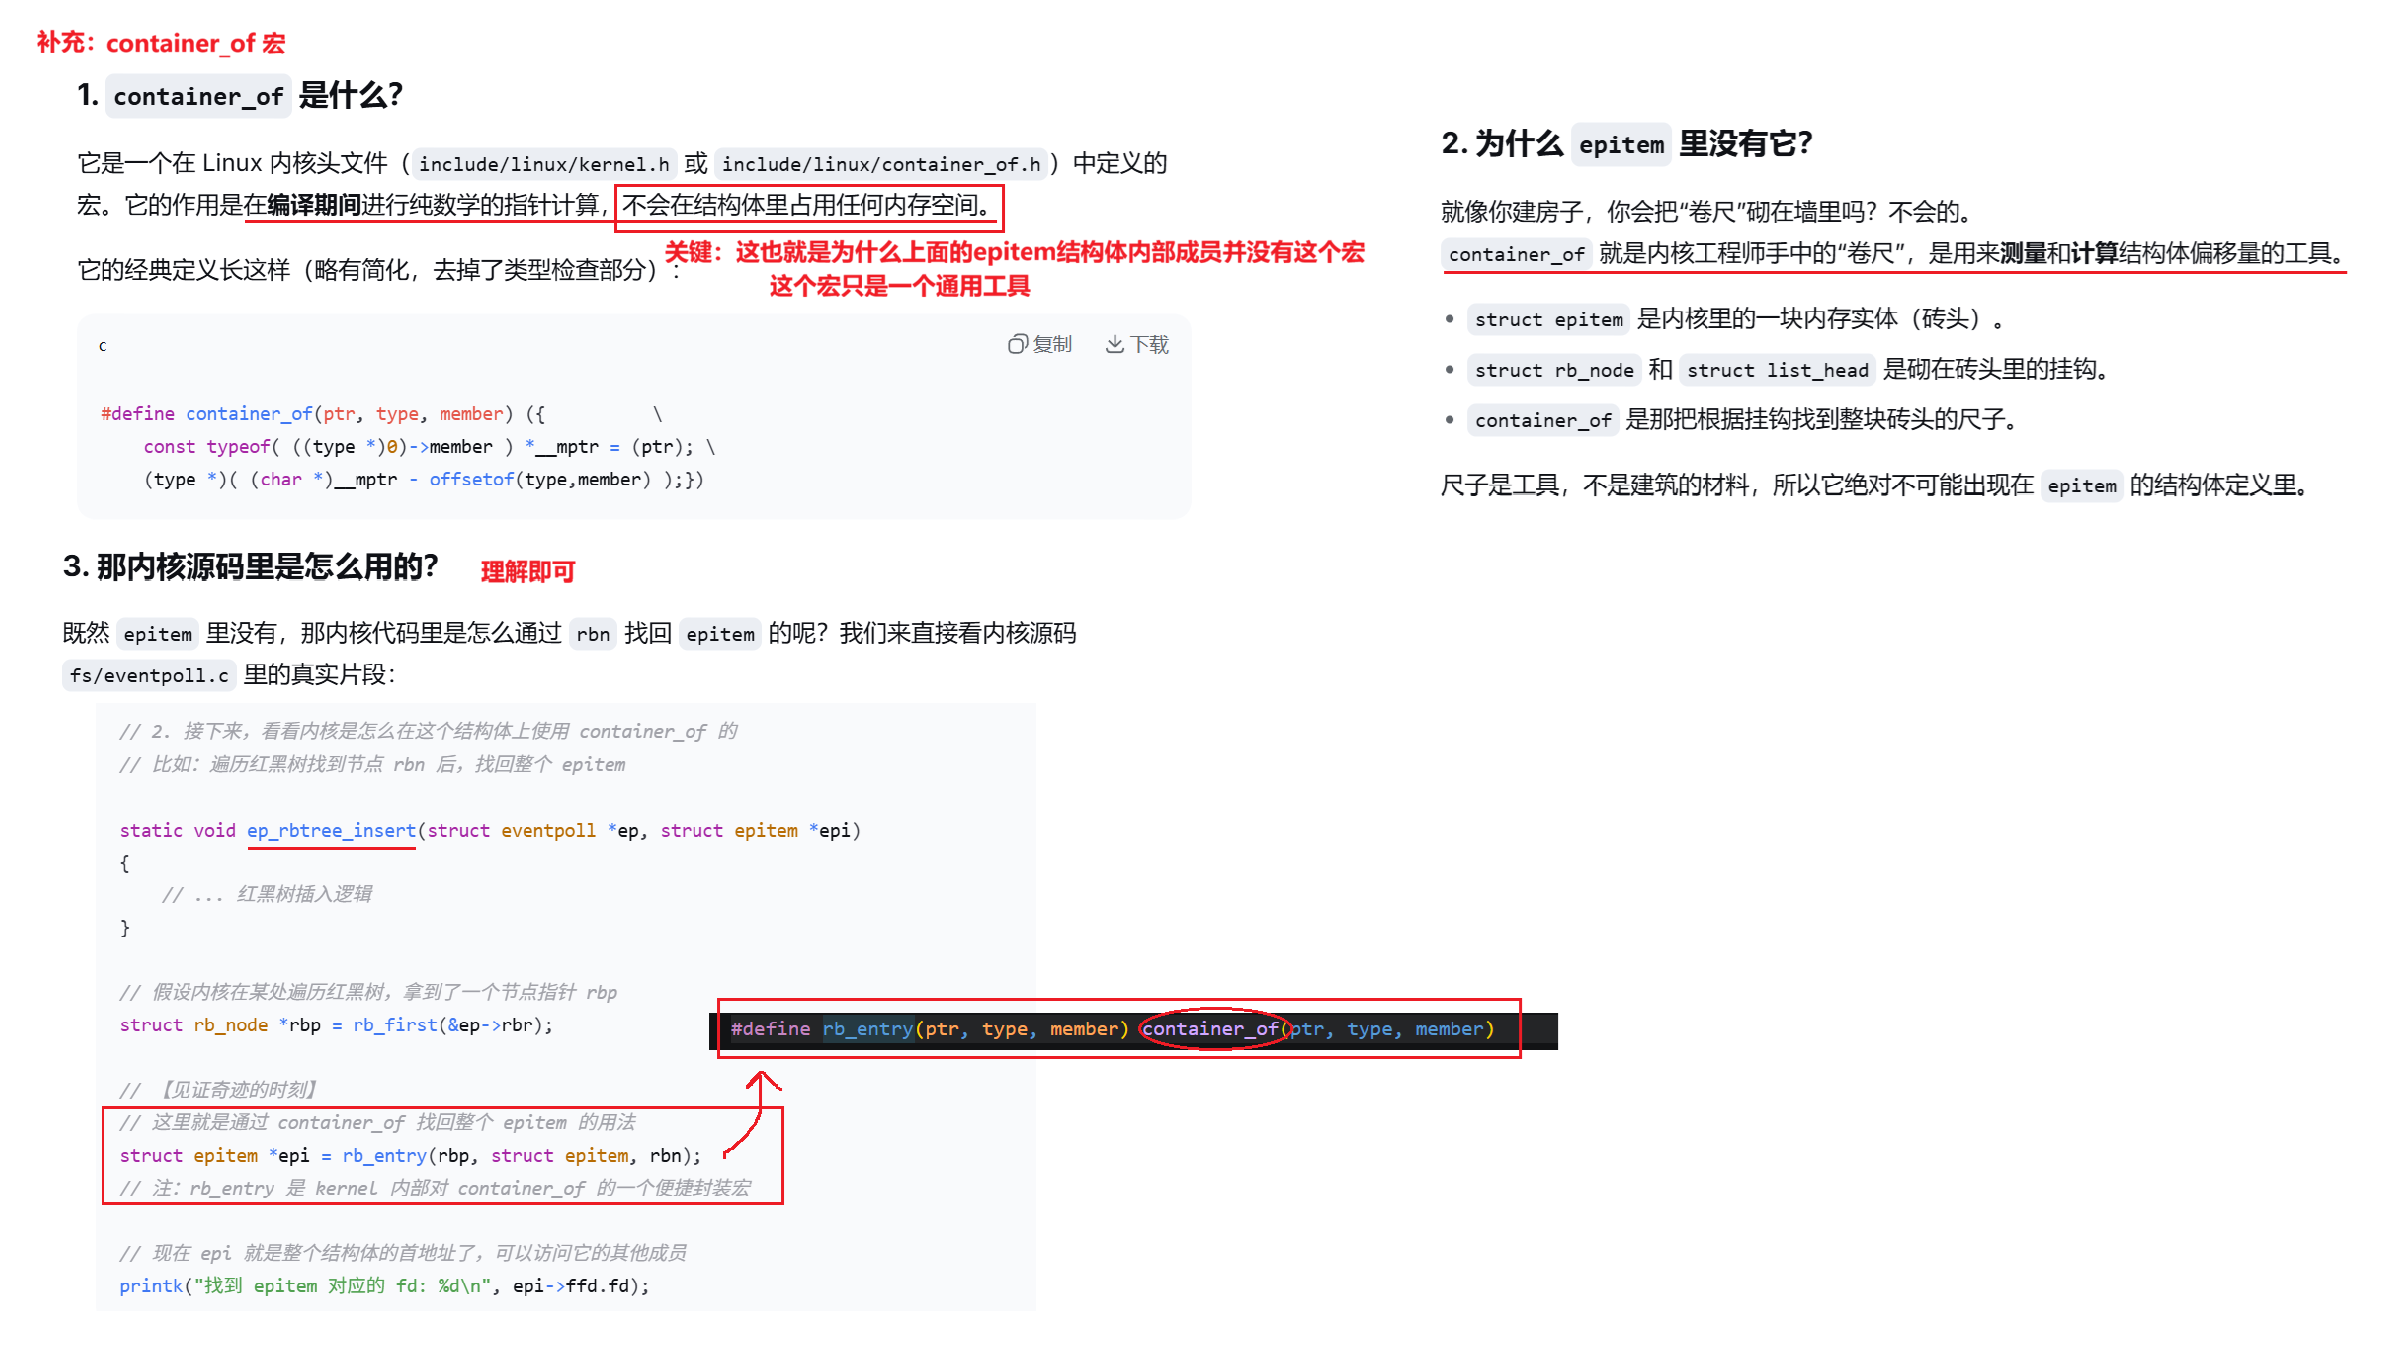
container_of 是 Linux 内核提供的工具宏 ,定义在内核头文件,作用是根据结构体内部某个成员的地址,反向计算出整个外层结构体的首地址,整个计算在编译期完成,不会占用结构体内部存储空间。
核心逻辑:
假设我们拿到 rdllink 成员的指针 p_rdllink,它在 epitem 结构体内部的偏移量固定 。
公式: 结构体首地址 = 成员地址 - 该成员在结构体中的偏移量
伪代码:
cpp
struct epitem *ep = (struct epitem *)((char *)p_rdllink - offsetof(struct epitem, rdllink));计算得到epitem首地址之后,就可以正常访问ep->ffd、ep->event等成员。
3.2.2.1 拓展:container_of 宏
宏简化定义:
cpp
#define container_of(ptr, type, member) ({                      \
    const typeof( ((type *)0)->member ) *__mptr = (ptr);       \
(type *)( (char *)__mptr - offsetof(type,member) );})ptr:结构体成员的指针type:外层结构体类型member:结构体里面的成员名
在epoll内核中的使用方式:
内核会封装rb_entry宏,本质就是container_of的封装:
cpp
#define rb_entry(ptr, type, member) container_of(ptr, type, member)遍历红黑树拿到rb_node节点指针后,使用下面代码找回完整 epitem:
cpp
struct epitem *epi = rb_entry(rbp, struct epitem, rbn);补充理解:
container_of 仅仅是编译期计算地址的工具,不是 epitem 结构体成员 。
类比: epitem相当于一块砖头,rb_node/list_head是砖上预留挂钩。container_of就是一把尺子,通过挂钩的位置反推整块砖头的起始位置,尺子本身不会砌进砖头里面。
3.2.3 问题 2:重谈 epoll_create 返回值为什么是文件描述符?
理解完container_of,我们再回头看前面提出的问题:epoll_create的返回值是一个文件描述符,为什么?有什么作用?
文件描述符 fd,对应内核里的struct file结构体。整个 epoll 实例与 VFS 虚拟文件系统的关联逻辑如下:
- 用户拿到
epfd,它本质是进程文件描述符表files_struct里的数组索引。 - 第一次跳转: 内核根据
epfd,在当前进程文件描述符表找到对应的struct file对象。这个struct file是epoll_create创建,并且挂载了 epoll 专属的文件操作函数集eventpoll_fops。 - 第二次跳转:
struct file中的private_data指针,保存了struct eventpoll的地址。eventpoll就是 epoll 实例本体,包含红黑树、就绪链表。内核通过file->private_data拿到完整 epoll 模型。
3.2.4 回调机制深度理解(梳理Epoll整体流程)
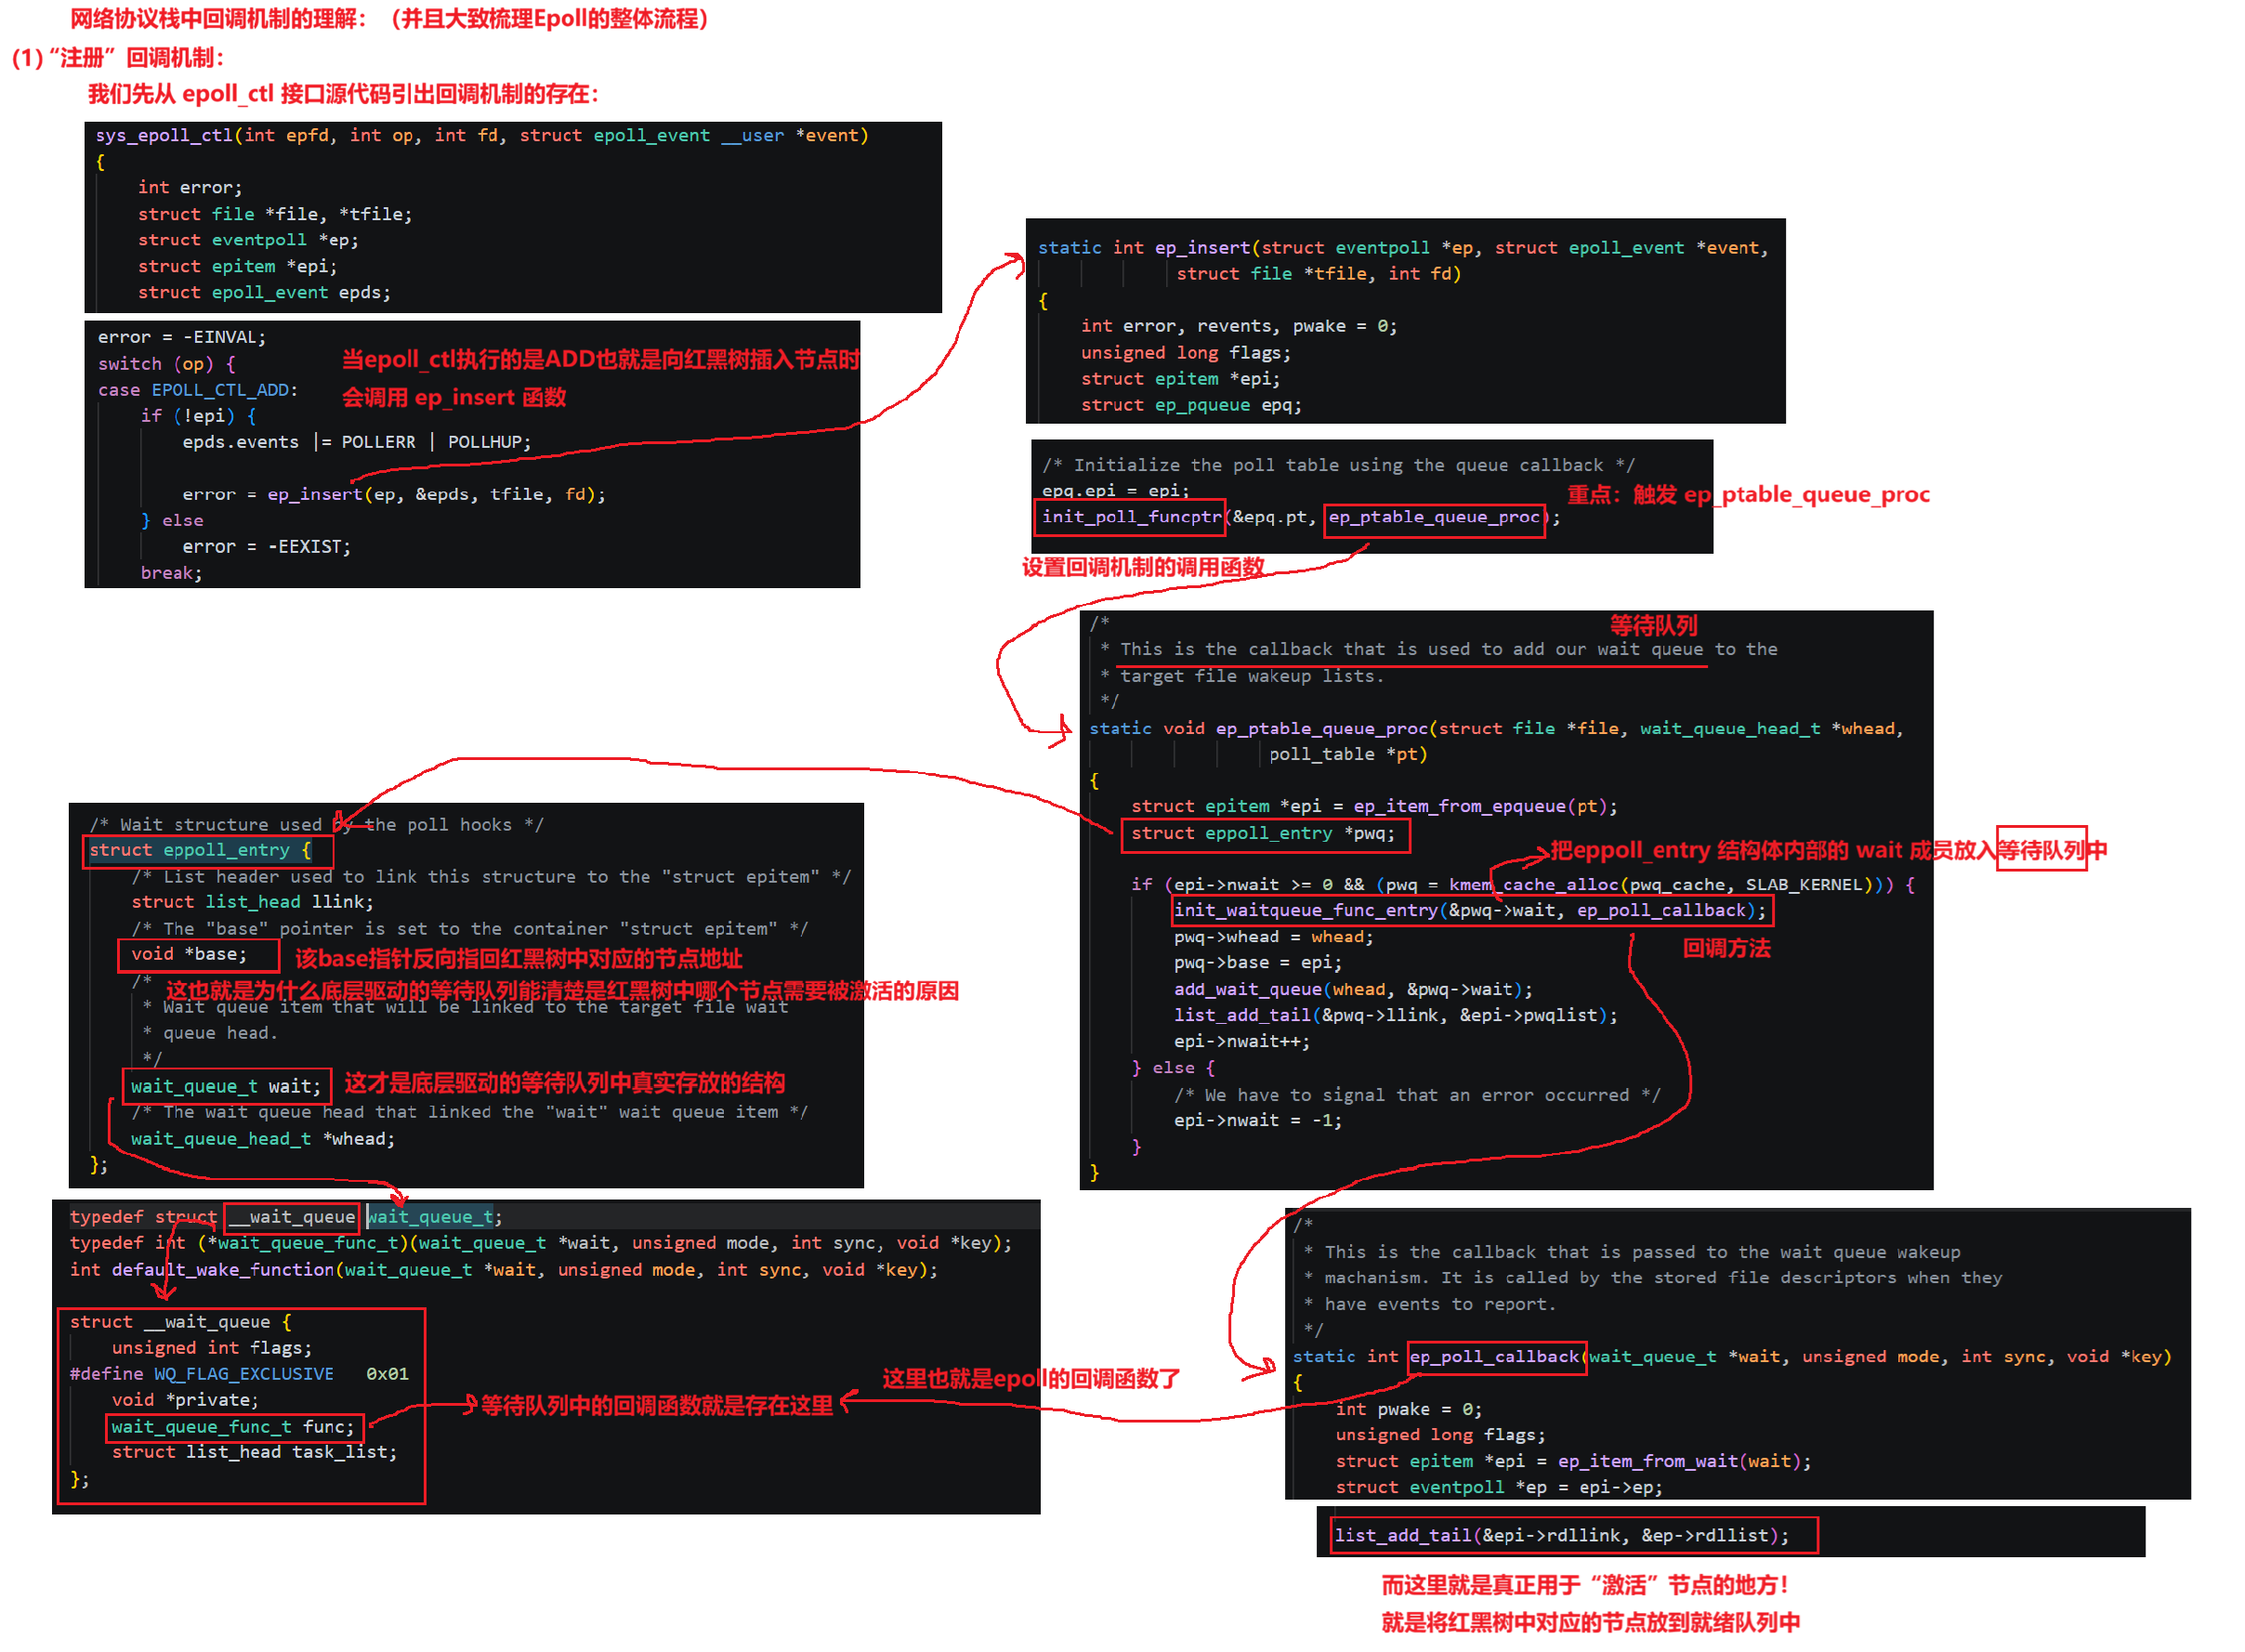
第一阶段:静默注册(将回调机制植入底层驱动)
这一切的起点,来自于用户态调用 epoll_ctl(epfd, EPOLL_CTL_ADD, fd, event)。
1. 入口与分发:ep_insert 的诞生
当 epoll_ctl 接收到 ADD 操作时,内核会调用 ep_insert 函数。
在 ep_insert 中,内核分配并初始化了一个关键的 epitem 对象,并通过 init_poll_funcptr(&epq.pt, ep_ptable_queue_proc); 设置了回调函数为 ep_ptable_queue_proc。
2. 关键中转站:ep_ptable_queue_proc
紧接着 ep_insert 会去调用底层设备(如 socket)的 .poll 接口。这个动作会触发 ep_ptable_queue_proc 函数执行。
该函数的核心逻辑如下:
-
通过 ep_item_from_epqueue(pt) 拿到刚才创建的 epitem。
-
分配了一个全新的结构体:struct eppoll_entry *pwq。这个结构体是连接 epoll 和底层驱动的桥梁。
-
核心动作:
-
pwq->base = epi;:将 pwq 的 base 指针指回刚才的红黑树节点 epitem。
-
init_waitqueue_func_entry(&pwq->wait, ep_poll_callback);:将 pwq 内部的 wait 成员的函数指针,设置为 ep_poll_callback。
-
add_wait_queue(whead, &pwq->wait);:将这根 wait 钩子,挂入到底层设备(socket)的等待队列(whead)中。
-
list_add_tail(&pwq->llink, &epi->pwqlist);:同时也把 pwq 记录在 epitem 的 pwqlist 里,方便后续管理。
-
至此,静默注册完成。此时,底层驱动(网卡)已经知道:"如果有数据,请执行 ep_poll_callback"。
第二阶段:动态触发(底层驱动唤醒与回调执行)
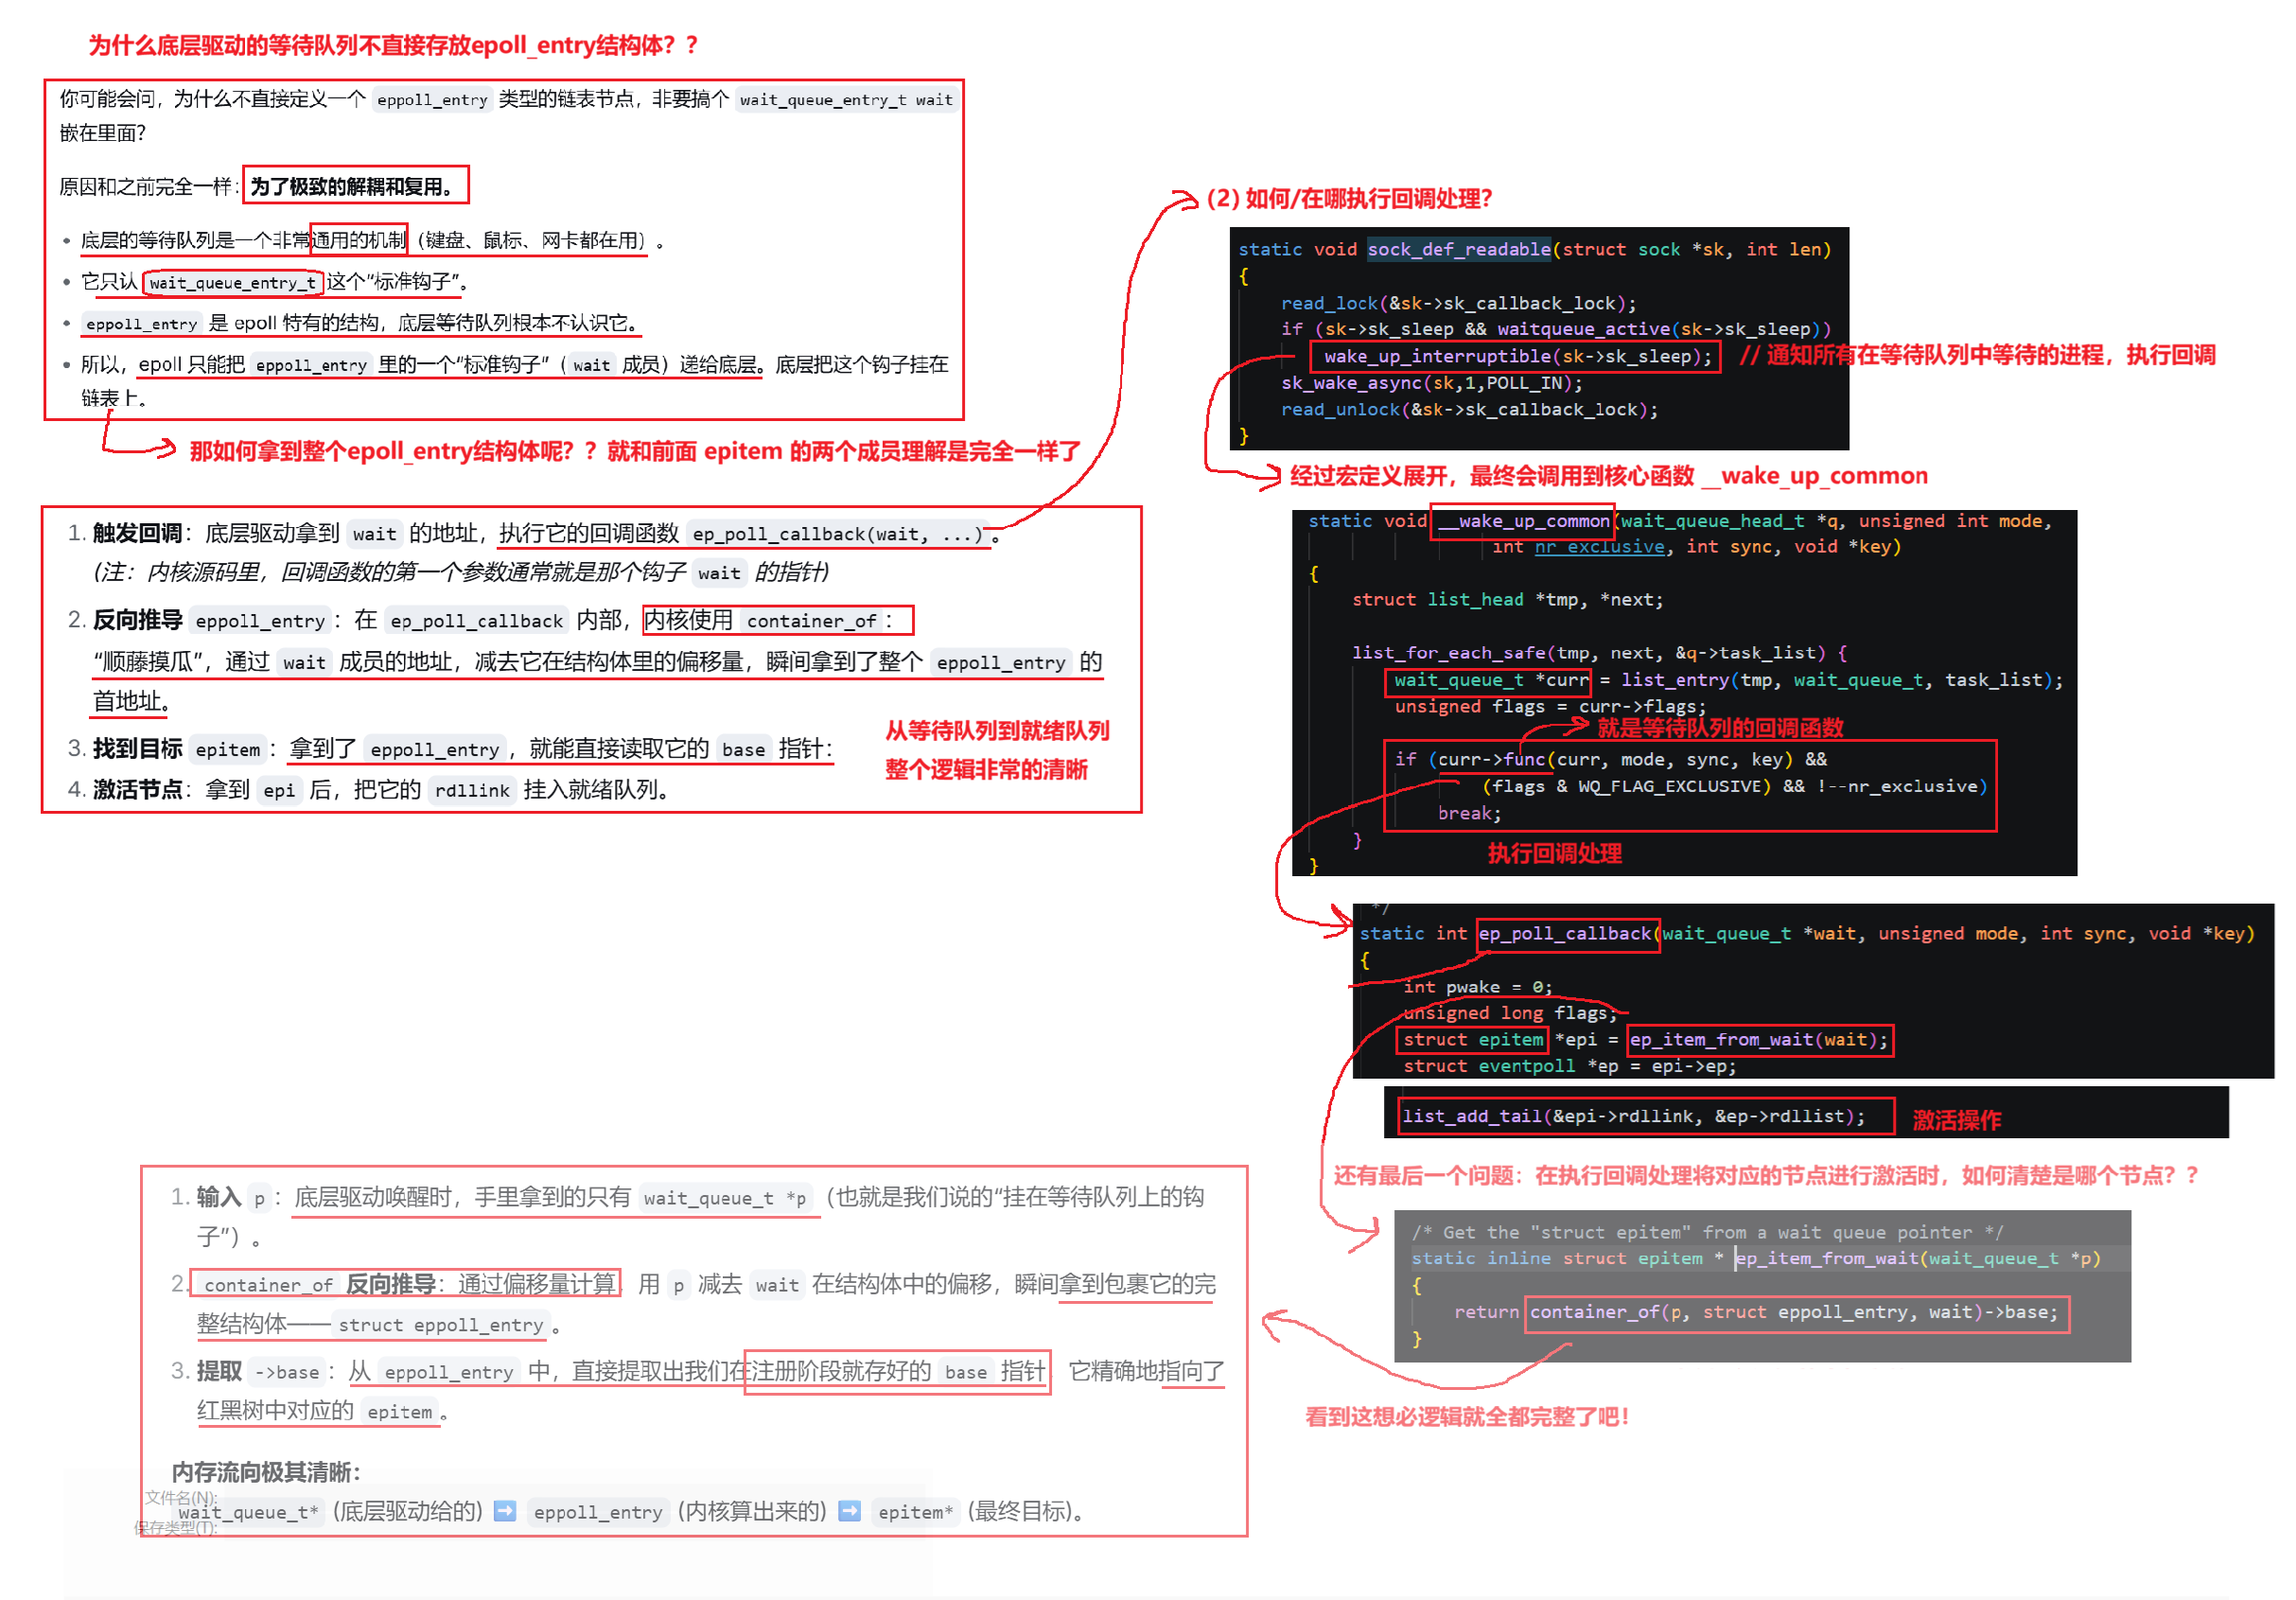
当网卡真正接收到数据时,硬件中断产生,协议栈开始处理,这进入了动态触发逻辑。
1. 底层唤醒:sock_def_readable
当 TCP 收到数据放入接收缓冲区后,会调用 sock_def_readable(sk, len) 。 该函数执行 wake_up_interruptible(sk->sk_sleep); 。
这里的 sk->sk_sleep 就是之前挂载了 pwq->wait 的底层等待队列。
通知所有在等待队列中等待的进程,执行回调。
2. 遍历执行:__wake_up_common
展开 wake_up_interruptible 宏,会进入 __wake_up_common 函数。
核心逻辑如下:
-
**list_for_each_safe(tmp, next, &q->task_list):**底层驱动开始遍历自己的等待队列。
-
**wait_queue_t *curr = list_entry(...):**通过链表节点找出对应的 wait_queue_t 结构体(也就是挂进来的 pwq->wait)。
-
**if (curr->func(curr, mode, sync, key):**这里执行了注册好的回调函数指针 func,也就是 ep_poll_callback。
3. 精准制导与节点激活:ep_poll_callback
现在,程序进入了 epoll 自己的地盘。核心函数 ep_poll_callback 执行以下逻辑:
-
第一步(反向寻址) :
struct epitem *epi = ep_item_from_wait(wait);
这是极为精妙的一步。此时系统手里只有 wait_queue_t *wait 指针,怎么找回对应的 epitem?
cppstatic inline struct epitem *ep_item_from_wait(wait_queue_t *p) { return container_of(p, struct eppoll_entry, wait)->base; }-
它利用container_of 宏 ,通过 wait 成员的地址,反向计算 出包裹它的整个 eppoll_entry 结构体的首地址(即 pwq)。
-
然后直接通过 pwq->base ,顺藤摸瓜 拿到了当初注册的那个epitem 指针。
第二步(获取大管家) :
struct eventpoll *ep = epi->ep; 从 epitem 中找到它所属的全局 eventpoll 结构体。
-
-
第三步(激活) :
list_add_tail(&epi->rdllink, &ep->rdllist); 这就是**"激活节点"** 的动作!
它将 epitem 内部的 rdllink 节点,挂入了 eventpoll 的就绪队列(rdllist)中。
-
第四步(唤醒用户) :
挂入就绪队列后,如果 epoll_wait 有进程在阻塞,就会被唤醒。
深度解惑:两个关键问题的解答
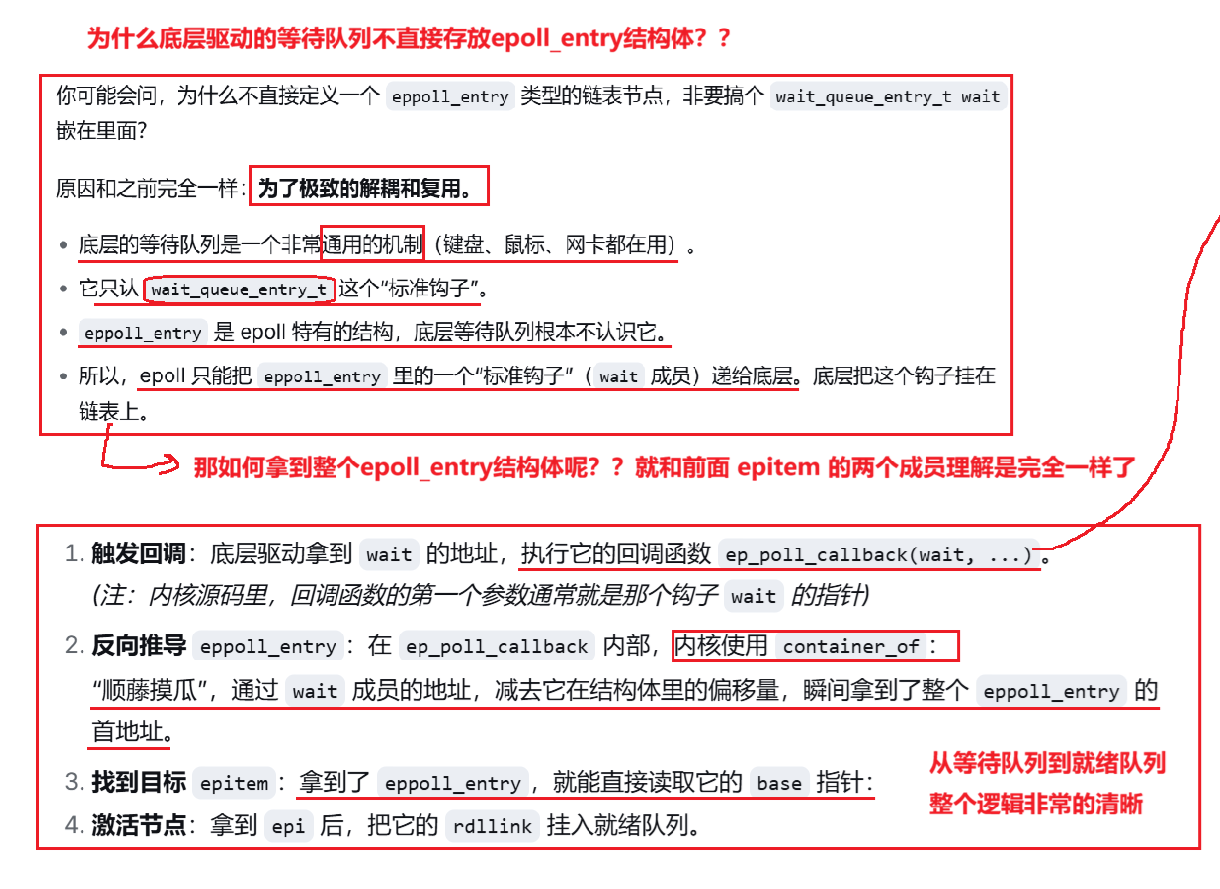
问题 1:为什么底层驱动的等待队列不直接存放 eppoll_entry 结构体?
原因非常纯粹,用四个字概括就是:"解耦和复用" 。
我们可以从内核设计的角度来理解这个决策:
-
底层驱动的"通用性"需求 :
Linux 内核中的等待队列(Wait Queue)是一个极其底层且通用的基础设施。无论是键盘、鼠标、网卡,还是普通的管道(Pipe),当它们需要通知上层"有数据了"或"状态改变了"时,都会使用这套机制。
-
强制的"标准接口" :
正因为通用,底层驱动定下了一个死规矩:挂到我(等待队列)上面的,必须是标准的
wait_queue_entry_t结构(俗称"标准钩子")。驱动不关心、也不允许接入五花八门的自定义结构。 -
eppoll_entry 的"私有性":
eppoll_entry 是 epoll 机制为了自身管理方便 (尤其是为了配合红黑树节点)而专门设计出来的私有结构体。底层的网卡驱动根本就不认识它。
-
"套娃"式的解决方案 :
为了实现兼容,epoll 只能采用一种巧妙的封装策略:把 eppoll_entry 里嵌入一个标准的 wait_queue_entry_t wait 成员,然后把这个
wait成员(而不是整个eppoll_entry)递给底层驱动。底层驱动只管把这个标准的钩子挂到自己的链表上。
问题 2:如何通过 wait_queue_t 获取到 eppoll_entry 结构体?进而找到目标节点?
既然底层驱动只传了一个标准的 wait 钩子进来,当有数据到达并触发回调时,内核手里只有这个 wait 的地址。**怎么由点及面,找回完整的 eppoll_entry,进而找到目标节点呢?**这就用到了内核的经典"绝活"。
整个过程可以分为四步:
-
触发回调:
底层驱动拿到 wait 的地址(即 wait_queue_t *wait),执行回调函数 ep_poll_callback(wait, ...) 。
(注:内核源码里,回调函数的第一个参数,就是那个钩子 wait 的指针)。
-
反向推导 eppoll_entry(container_of 魔法):
在 ep_poll_callback 内部,内核使用 container_of 宏 进行"顺藤摸瓜"。
因为 C 语言结构体在内存中的布局是固定的,知道了内部成员 wait 的地址,又知道 wait 在 eppoll_entry 结构体里的固定偏移量,就能用简单的"减法"算出来整个结构体的首地址。
cppstruct eppoll_entry *pwq = container_of(wait, struct eppoll_entry, wait); -
提取目标 epitem:
拿到了eppoll_entry 结构体,事情就好办了。因为我们在注册阶段,已经把目标红黑树节点的地址 存在了它的 base 成员里。直接读取即可:
cppstruct epitem *epi = pwq->base; -
**激活节点:**拿到 epi 后,把它的 rdllink 成员挂入 epoll 的就绪队列(rdllist),完成从"等待队列"到"就绪队列"的完美接力。
逻辑链总结
通过源码,我们彻底摸清了 epoll 的底层骨架。完整的逻辑链如下:
用户调用 epoll_ctl 添加 fd 时,内核创建一个 epitem 挂在红黑树 上,同时创建一个 eppoll_entry (带着回调函数 ep_poll_callback 和指向 epitem 的 base 指针),将其 wait 成员 挂入底层驱动的等待队列。
当底层硬件有数据到达时,驱动遍历自己的等待队列,触发 ep_poll_callback 。回调函数利用container_of 宏 通过 wait 找回 eppoll_entry,再通过其 base 指针 找回最初挂在红黑树上的 epitem ,最终将其 rdllink 挂入 epoll 的就绪队列(
rdllist),并唤醒 epoll_wait。
这套逻辑不仅适用于 epoll,也是理解整个 Linux 异步 I/O 的基石。
结束语
到这里,epoll 的整套底层原理就全部讲解完毕。我们从 select、poll 存在的性能缺陷出发,认识了 epoll 作为大规模并发场景下 IO 多路转接方案的设计目标;依次学习了epoll_create、epoll_ctl、epoll_wait三大系统调用的使用方式,再深入内核视角拆解eventpoll、epitem等核心结构体,理解红黑树与就绪队列的分工,同时弄懂了container_of宏这个内核经典指针转换技巧,完整梳理了 epoll 事件注册、回调触发、就绪通知的内核执行链路。
epoll 的高性能,根源并不是简单的 "更快",而是事件驱动的设计思想:由底层设备在数据就绪时主动回调通知,避免了 select/poll 每次调用都要全量扫描所有 fd 的开销。当然 epoll 也不是万能的,它有自身适用场景与边界,在后续实战章节中,我们会基于 epoll 实现高并发 Echo 服务端,把本章学到的内核原理落地到代码中。