作者:来自 Elastic David Pilato
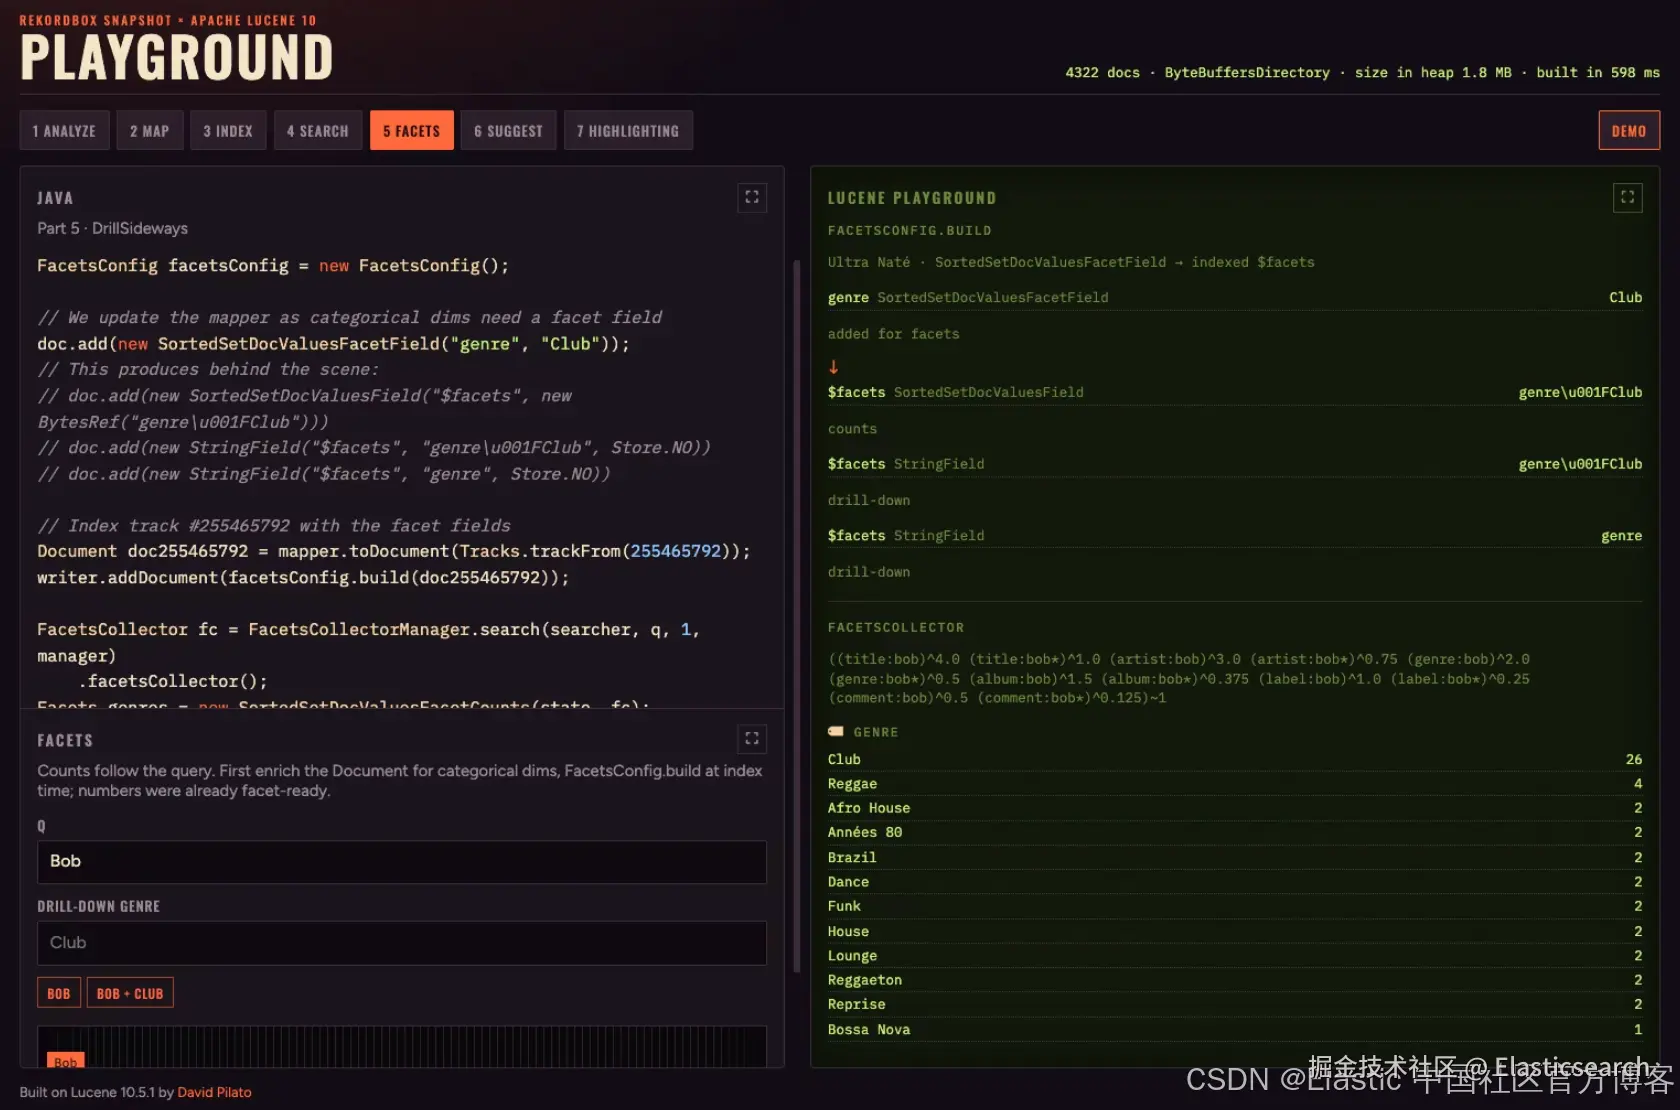
我们已经了解了如何为文档建立索引和搜索文档。这足以进行评分和过滤,但还不足以绘制带复选框的直方图。
本文要介绍的就是这部分差异:当你希望实现分面导航时,需要做哪些改变。
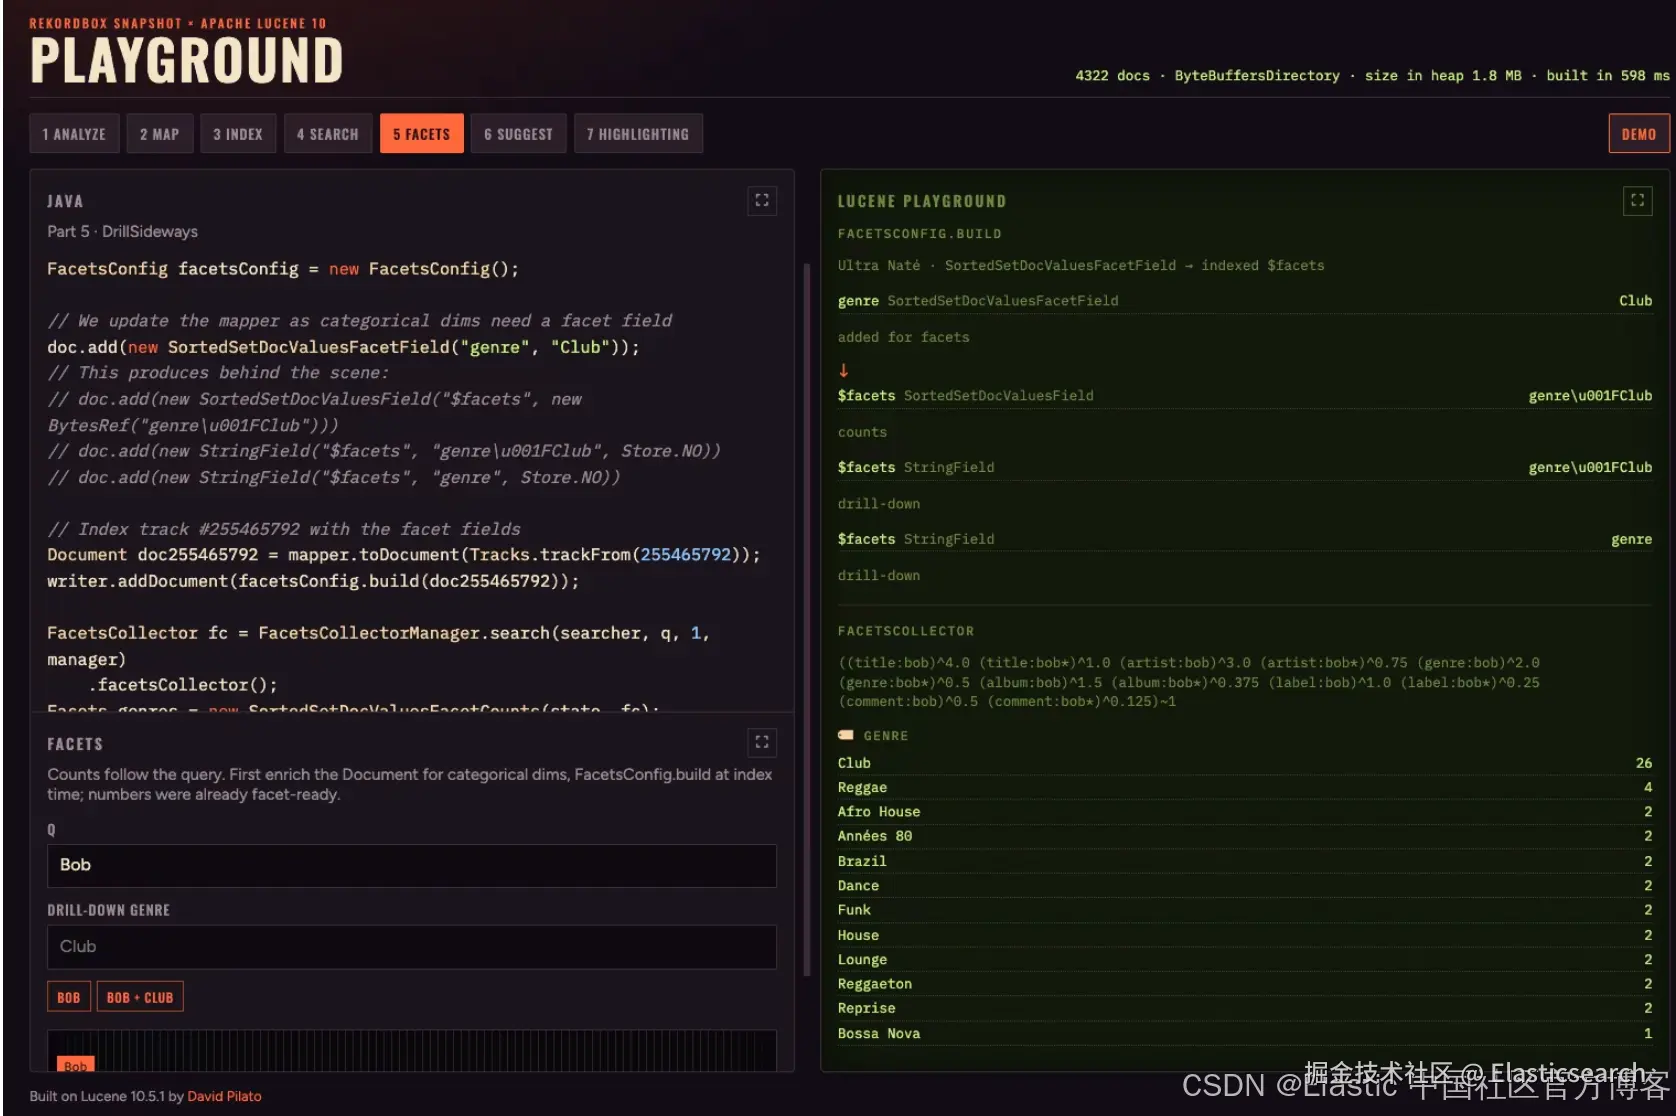
q=Bob 的 Genre / BPM / rating 和 year 分面。
q=Bob 仍然是我们之前看到的自由文本 MUST 查询。这些数字(Club (26)、BPM 区间、星级、年代)是基于同一个查询得到的分面计数。点击 Club 会在 genre 字段上添加一个针对 Club 的过滤器。
向项目中添加分面
计数存储在它们自己的 artifact 中:
将 artefact 翻译成中文补充分面存储方式的说明统一 Genre、BPM 和 rating 的术语
xml
`

1.  <dependency>
2.    <groupId>org.apache.lucene</groupId>
3.    <artifactId>lucene-facet</artifactId>
4.    <version>10.5.1</version>
5.  </dependency>

`AI写代码
Genre 复选框需要在你已经用于 FILTER 的 keyword 旁边添加一个支持 facet 的 标签。不要在 TextField 上进行 facet ------ 因为它产生的 token 并不是复选框标签。例如,"Club House" 会被分词为"club"和"house",但你希望按照"Club House"进行分组,而不是按照"club"或"house"进行分组。
我们需要一个 FacetsConfig 来管理我们的 facet 字段:
ini
`FacetsConfig facetsConfig = new FacetsConfig();`AI写代码如果你还记得我们之前用于为搜索建立文档索引的代码,当时我们生成了以下 Lucene 文档:
csharp
`

1.  Document doc = new Document();

3.  // ... All the other fields as before
4.  doc.add(new TextField("genre", "Club", Store.YES));
5.  doc.add(new StringField("genre.raw", "Club", Store.YES));
6.  doc.add(new StringField("genre.raw.normalized", "club", Store.YES));

`AI写代码
现在,我们需要为 genre 字段添加 facet 字段:
csharp
`doc.add(new SortedSetDocValuesFacetField("genre", "Club"));`AI写代码不再直接将文档写入 writer:
go
`writer.addDocument(doc);`AI写代码现在,你需要通过 FacetsConfig.build 方法传入它:
go
`writer.addDocument(facetsConfig.build(doc));`AI写代码FacetsConfig.build 会将 SortedSetDocValuesFacetField 字段重写为已建立索引的 $facets 字段,并使用 \u001F 作为分隔符字符(DELIM_CHAR):
csharp
`1.  // You don't write this. FacetsConfig.build(doc) does it for you.
2.  doc.add(new SortedSetDocValuesField("$facets", new BytesRef("genre\u001FClub")))  // counts
3.  doc.add(new StringField("$facets", "genre\u001FClub", Store.NO))                  // drill-down
4. doc.add(new StringField("$facets", "genre", Store.NO))` AI写代码bpm、rating 和 year 已经支持 facet。无需额外的 mapper 字段,也无需进行 $facets 重写:
csharp
`

1.  // Nothing changes for those numeric fields
2.  doc.add(new DoubleField("bpm", 121.29, Store.YES));
3.  doc.add(new IntField("rating", 5, Store.YES));
4.  doc.add(new IntField("year", 1997, Store.YES));

`AI写代码
三个不同的任务,三个不同的字段:
| 角色 | UI 中的示例 | 使用的内容 |
|---|---|---|
FILTER |
chip genre = Club | 对 genre.raw.normalized(club)使用 TermQuery |
| Facet 标签(复选框计数) | Club (26) |
SortedSetDocValuesFacetField → $facets + SortedSetDocValuesFacetCounts |
| Numeric range histogram | 120 -- 130 (52) |
DoubleField / IntField DocValues + *RangeFacetCounts |
复选框使用相同的显示字符串 Club;只有精确的 FILTER 使用小写的 club。范围永远不会经过 $facets。
使用 facet 进行查询
与 playground 使用相同的技术栈。你不需要遍历 ScoreDoc 来绘制这些面板 ------ 而是只执行一次搜索,将结果放入 FacetsCollector,然后让每个 facet 实现来获取自己的 bucket。keyword 维度需要先针对 $facets 建立一个 reader state;搜索需要使用 FacetsCollectorManager 来构建(并合并)该 collector:
ini
`

1.  SortedSetDocValuesReaderState state =
2.          new DefaultSortedSetDocValuesReaderState(searcher.getIndexReader());
3.  FacetsCollectorManager manager = new FacetsCollectorManager();

5.  FacetsCollector fc = FacetsCollectorManager.search(searcher, q, 1, manager)
6.          .facetsCollector();
7.  Facets genres = new SortedSetDocValuesFacetCounts(state, fc);
8.  Facets bpm = new DoubleRangeFacetCounts("bpm", fc, bpmRanges());

`AI写代码
topN = 1 是有意这样设置的:这里的重点并不是命中结果表;collector 只需要获取匹配的文档,以便进行计数。每当打开一个新的 reader(在 commit / refresh 之后),都需要重新构建 state。bpmRanges() 是你的 DoubleRange[](例如 120 -- 130)------ 数值范围不使用 state。
返回的结果仍然保持 Lucene 的结构 ------ 每个维度对应一个 FacetResult,其中包含一组 LabelAndValue(标签 → 计数)对:
ini
`

1.  FacetResult genreResult = genres.getTopChildren(10, "genre");
2.  // Club → 26, Dance → 18, ...

4.  FacetResult bpmResult = bpm.getTopChildren(10, "bpm");
5.  // 120 -- 130 → 52, ...

`AI写代码
getTopChildren(n, dim) 会保留该维度中计数最大的 n 个 bucket 。数值范围使用你传递给 DoubleRange / LongRange 的标签;keyword facet 使用原始的 facet 值(Club,而不是 club)。
将这些结果映射为 UI 可以渲染的 beans:
csharp
`
1. public record FacetBucket(String value, int count) {}
3. List<FacetBucket> toBuckets(FacetResult result) {
4. if (result == null || result.labelValues == null) {
5. return List.of();
6. }
7. return Arrays.stream(result.labelValues)
8. .map(lv -> new FacetBucket(lv.label, lv.value.intValue()))
9. .toList();
10. }
11. // Club (26), 120 -- 130 (52), ★★★★★ (13)
`AI写代码rating 或 year 也是相同的思路:在同一个 FacetsCollector 上再使用另一个 *RangeFacetCounts,然后再次调用 toBuckets。
当某个面板已经被选中时,在经过过滤的 q 上直接进行普通计数会隐藏同级的其他值。这时就需要切换到 DrillSideways:
scss
`new DrillSideways(searcher, facetsConfig, state).search(drillDown, 1);`AI写代码使用经过过滤的基础查询
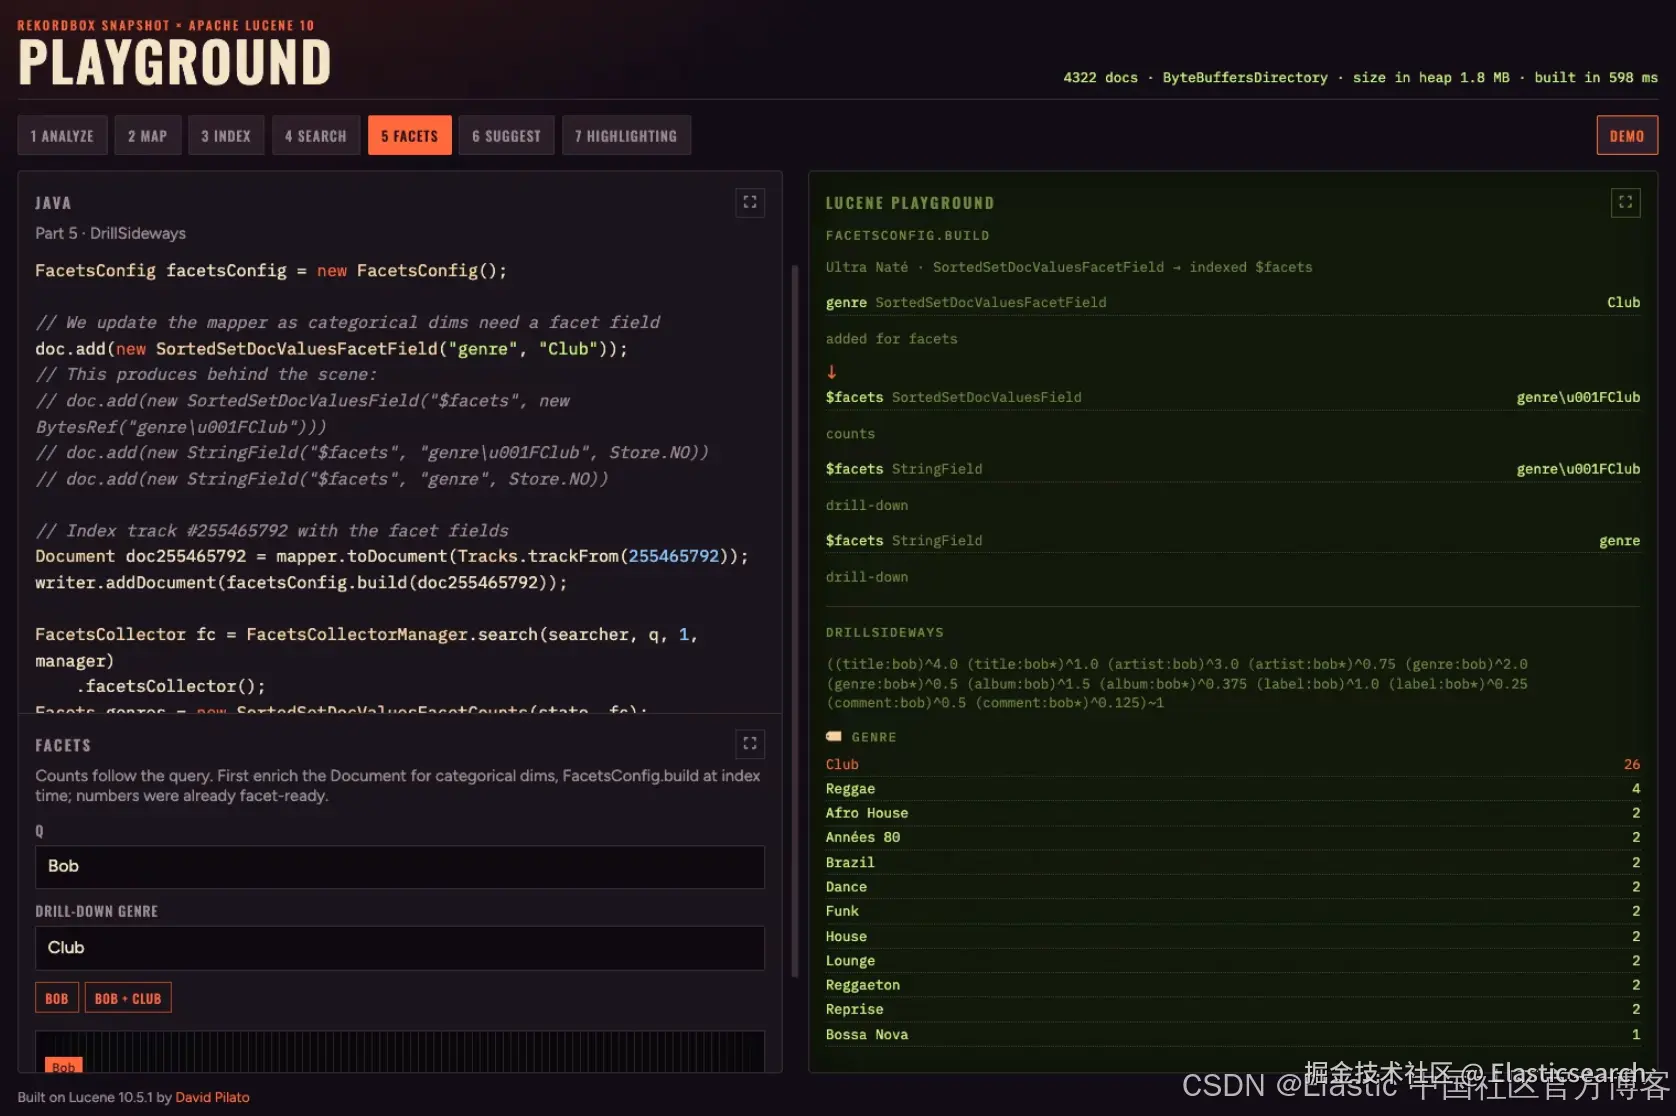
q=Bob + drill-down genre Club ------ BPM 会缩小;其他 genre 仍然可见(DrillSideways)。
在 genre=Club 条件下,BPM 直方图应该缩小。genre 面板仍然应该显示 Dance ------ 否则用户就无法更换 genre,而必须先清除参数。
如果 FILTER genre:Club 已经存在于基础查询中,Lucene 就无法在 genre collector 中将其移除。因此需要拆分请求:
- Base ------ 自由文本
MUST、排除项MUST_NOT,以及针对_其他_维度(bpm、key 等)的FILTER。 - Drill-down ------ 通过
DrillDownQuery.add添加每个已选面板的 dim。
然后,DrillSideways 会为过滤后的结果集运行一个 collector,并针对每个已选维度分别运行一个 collector,同时不包含该维度自身的约束:
scss
`
1. Query base = new BooleanQuery.Builder()
2. // Must match the free text query
3. .add(bob, BooleanClause.Occur.MUST)
4. // Filter out keys:4a, 4b --- other FILTERs (bpm, ...) go here too, not genre
5. .add(keys, BooleanClause.Occur.MUST_NOT)
6. .build();
8. DrillDownQuery drillDown = new DrillDownQuery(facetsConfig, base);
9. // genre was not set as a filter as it's a drilldown dimension
10. drillDown.add("genre", "Club");
12. Facets luceneFacets = new DrillSideways(searcher, facetsConfig, state)
13. .search(drillDown, 1)
14. .facets;
`AI写代码电商场景中常见的技巧:按照品牌缩小结果表,但不要隐藏其他品牌。如果你需要在同一组 collector 上同时使用 keyword 和数值范围,则重写 DrillSideways.buildFacetsResult,并使用 MultiFacets 包装每个 collector。
完整的示例位于 GitHub:lucene-search-tracks。