深入理解 C 语言:结构体从声明到内存对齐与位段实战
结构体(Structure)是 C 语言中极为重要的自定义数据类型。它允许我们将不同类型的数据组合成一个整体,既能抽象现实世界中的复杂对象,又能直接映射计算机底层的字节布局。本文将从结构体的声明、初始化、成员访问,一路深入到底层的内存对齐、传参机制以及位段的使用。所有代码均保证可以直接编译运行,带你彻底吃透结构体在内存中的处理逻辑。
目录
一、结构体类型的声明
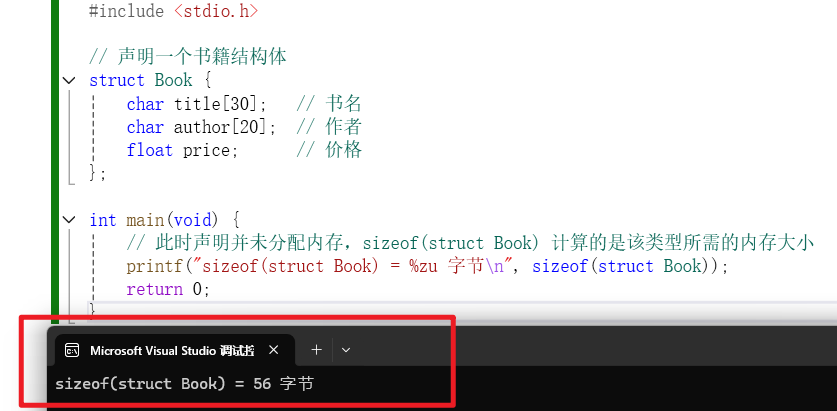
结构体是 C 语言中组织复杂数据的核心工具。学习结构体,首先要建立的一个核心认知是:结构体的声明仅仅是告诉编译器"这是一个什么样的类型,由哪些成员组成",此时编译器并不会为其分配实际的内存空间,它相当于一张建筑的"蓝图",而非实体房屋。
编译器在编译期依靠这张"蓝图"推导所需大小(sizeof)和成员偏移量(offsetof);而只有当真正定义变量时,系统才会在栈、堆或静态区分配实体空间。因此,严格区分"声明类型"与"定义变量",是吃透结构体的第一课。本文将从声明、初始化、成员访问出发,一路深入到底层的内存对齐、传参机制与位段实战,带你彻底掌握结构体在内存中的底层逻辑。
1. 基本声明语法
使用 struct 关键字即可声明一个结构体类型。声明末尾的分号不能省略。
c
#include <stdio.h>

// 声明一个书籍结构体
struct Book {
    char title[30];   // 书名
    char author[20];  // 作者
    float price;      // 价格
};

int main(void) {
    // 此时声明并未分配内存,sizeof(struct Book) 计算的是该类型所需的内存大小
    printf("sizeof(struct Book) = %zu 字节\n", sizeof(struct Book));
    return 0;
}
深入理解以下几点,有助于避开常见坑:
- 标签与类型名 :
struct后面的名字(如Book)称为结构体标签(Tag) 。在 C 语言中,struct Book才是完整的类型名。除非配合typedef,否则不能直接用Book定义变量(C++ 可以,但 C 不行)。 - 结尾分号的致命陷阱 :
struct Book { ... };中,右大括号}后面的分号必不可少。这个分号表示结构体类型声明语句的结束。如果漏掉,编译器会报错,或者在后续代码中引发难以排查的语法错误。 - 成员列表规则 :大括号内是标准的变量声明列表,不能对成员赋初值(如
int x = 0;是错的),成员类型可以是基本类型、其他结构体,也可以是指针。 - 作用域:如果结构体声明在函数外部,它就是全局类型,所有函数都能使用;如果声明在函数内部,则只能在该函数内部使用。
避坑提示:
- 漏掉
}后的分号,是新手最容易犯的语法错误之一。 - 结构体类型声明本身不占用运行时的内存,它只是编译器在编译阶段计算大小和偏移量的"蓝图",只有定义了变量,才会真正在栈、堆或静态区分配内存。
2. 使用 typedef 简化类型名
每次定义变量都写 struct Book b; 略显繁琐,在 C 语言中,我们通常使用 typedef 为其起一个别名,这也是工程中最常见的写法。
c
#include <stdio.h>

typedef struct {
    int x;
    int y;
} Point;

int main(void) {
    Point p = {3, 4}; // 直接使用别名定义变量
    printf("p = (%d, %d)\n", p.x, p.y);
    return 0;
}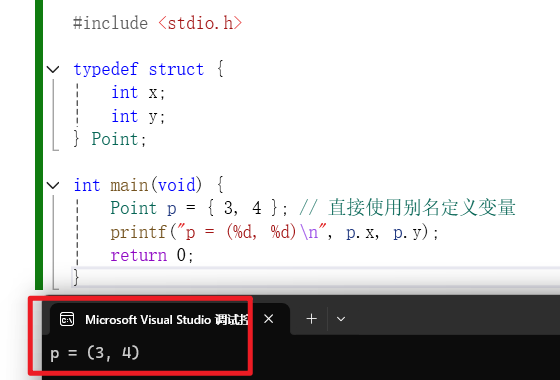
说明 :typedef 并没有创建新类型,它只是为现有的类型创建了一个易于使用的别名。需要区分 typedef struct Point { ... } Point; 和匿名结构体 typedef struct { ... } Point;,后者无法在声明后再次通过 struct Point 的方式使用。
3. 匿名结构体
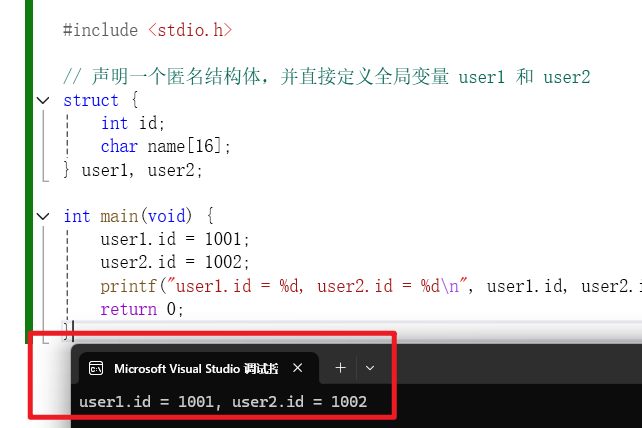
匿名结构体通常只用于一次性定义变量,之后无法再用该类型定义新变量。它适合临时封装数据,但复用性极差。
c
#include <stdio.h>

struct {
    int id;
    char name[16];
} user1, user2; // 声明时直接定义全局变量

int main(void) {
    user1.id = 1001;
    user2.id = 1002;
    printf("user1.id = %d, user2.id = %d\n", user1.id, user2.id);
    return 0;
}
要点说明:
- 类型没有名字 :因为没有结构体标签(
struct后面的名字),编译器只会为声明末尾的user1和user2分配内存。在后续代码中,你无法再定义第三个该类型的变量,因为无名字可引用。 - 内存分配时机 :
user1和user2定义在函数外部,属于全局变量,它们存放在静态存储区(数据段),在程序加载时就已经分配好内存,生命周期贯穿整个程序运行期间。 - 使用场景 :通常用于只在一处使用的"一次性"数据封装。例如,某些硬件寄存器映射、临时测试配置,或者配合
typedef使用(虽然此时通常不叫匿名结构体,而是匿名结构体+类型别名)。
避坑提示(非常关键):
-
无法二次复用 :如果你在
main函数里写struct user3;,编译器会直接报错,因为匿名结构体没有名字。 -
类型兼容性问题 :即使两个匿名结构体包含的成员完全相同,它们在 C 语言中也属于完全不同的类型 ,不能互相赋值。如下面这段代码会报错:
cstruct { int x; } a; struct { int x; } b; // a = b; // 错误:类型不兼容 -
无法自引用:匿名结构体内部无法包含指向自己类型的指针(因为名字未知),因此无法用来构建链表或树。
-
全局变量的作用域 :虽然类型是匿名的,但变量
user1和user2是全局的,只要在本文件内,任何函数都可以访问它们。建议给全局变量起具有辨识度的名字,避免命名冲突。
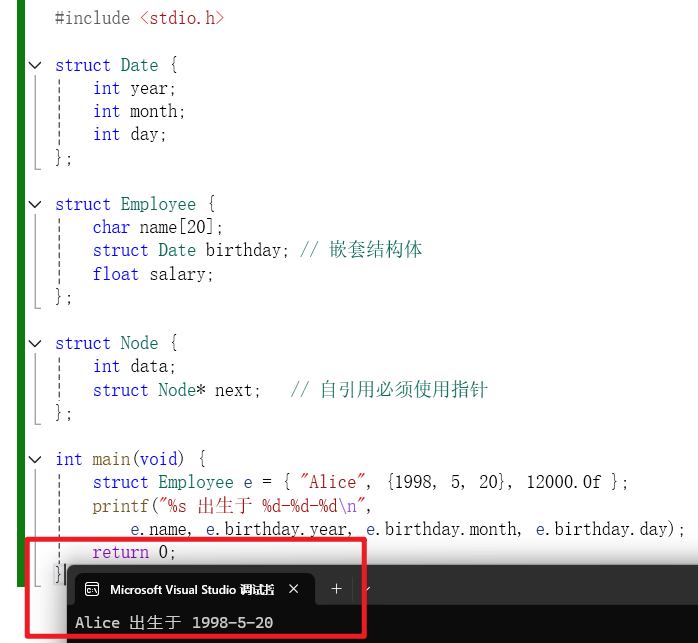
4. 嵌套结构体与自引用
结构体内部可以包含另一个结构体。而结构体自引用(如链表节点)时,必须使用指针,否则会导致编译器无法计算结构体大小(无限递归)。
c
#include <stdio.h>

struct Date {
    int year;
    int month;
    int day;
};

struct Employee {
    char name[20];
    struct Date birthday; // 嵌套结构体
    float salary;
};

struct Node {
    int data;
    struct Node *next;   // 自引用必须使用指针
};

int main(void) {
    struct Employee e = {"Alice", {1998, 5, 20}, 12000.0f};
    printf("%s 出生于 %d-%d-%d\n",
           e.name, e.birthday.year, e.birthday.month, e.birthday.day);
    return 0;
}
值得注意的核心点:
-
声明不占空间:类型与变量的本质区分
结构体声明(
struct Book { ... };)只是在编译期告诉编译器"这个类型长什么样",编译器据此计算大小与偏移量,但不会分配任何实际内存。只有定义变量(如struct Book b1;)时,才会在运行期分配空间(全局变量在静态区,局部变量在栈区,malloc在堆区)。因此,sizeof(struct Book)合法,但只是编译期推导;未定义变量前直接访问成员(如struct Book.price)会报错。 -
自引用的陷阱:指针与标签的硬性要求
结构体自引用时,成员绝不能是自身类型的变量(如
struct Node next;),否则会导致无限递归,编译器无法计算出sizeof(struct Node)。必须使用指针(如struct Node *next;),因为指针大小固定(4 或 8 字节)。拓展 :在
typedef简写时极易踩坑------typedef struct Node { Node *next; } Node;是错误 的,因为别名Node在结构体定义结束前尚未生效;正确写法是保留标签名struct Node *next。自引用是链表、树、图等动态数据结构的基石。 -
匿名结构体的局限性:一次性与不兼容
匿名结构体省略了标签,必须在声明的同时定义变量,否则后续无法再定义该类型的新变量。
拓展:
- 类型不兼容 :即使两个匿名结构体成员完全相同,C 语言也视其为完全不同的类型,不能互相赋值。
- 无法自引用:内部不能包含指向自身类型的指针,因此无法构建动态数据结构。
- 适用场景 :仅适合"一次性"数据封装,如临时的硬件寄存器映射或测试配置。若需复用或传递,应使用命名结构体或配合
typedef。
二、结构体变量的创建和初始化
理解了声明之后,我们来看如何创建变量并赋予初值。结构体的初始化方式经历了从传统到 C99 指定初始化器的演进。
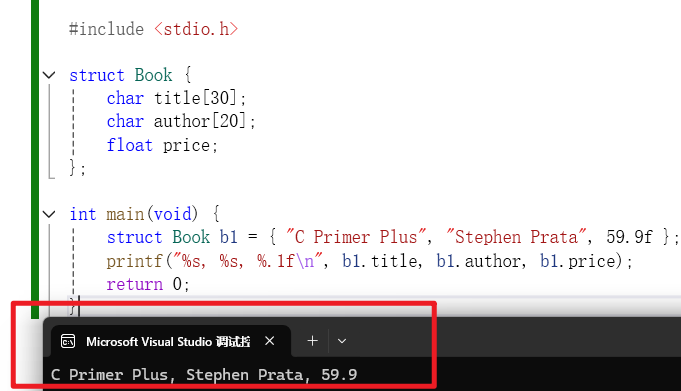
1. 定义时初始化
按照成员的声明顺序,用大括号 {} 依次为成员赋值,这是最基础、最直观的初始化方式。语法格式为:
c
struct 结构体名 变量名 = { 值1, 值2, ... };
c
#include <stdio.h>

struct Book {
    char title[30];
    char author[20];
    float price;
};

int main(void) {
    struct Book b1 = {"C Primer Plus", "Stephen Prata", 59.9f};
    printf("%s, %s, %.1f\n", b1.title, b1.author, b1.price);
    return 0;
}
要点总结:
-
顺序严格对应
大括号内的值必须与成员声明顺序一致,类型要匹配。顺序错乱可能导致隐式类型转换、数据错位,甚至编译警告或错误。
-
允许部分初始化
若提供的值少于成员个数,剩余成员自动初始化为 0(指针为
NULL,字符数组为'\0',数值为0)。例如:cstruct Book b2 = {"C Primer Plus"}; // author 为空字符串,price 为 0.0 -
字符数组可直接用字符串字面量
char title[30]可以用"C Primer Plus"初始化,编译器会自动填充'\0'并补零。数组长度必须足够容纳字符串及结尾的'\0'。 -
不能先定义后整体赋值
struct Book b1; b1 = {"...", "...", 59.9f};是错误 的。大括号初始化只能用于定义时;定义后只能逐成员赋值,或用另一个同类型变量整体赋值(b1 = b2;)。 -
嵌套结构体需嵌套大括号
若成员本身是结构体,应使用嵌套的
{}初始化,否则可能发生类型错位(后续会单独讲解)。
拓展:C99 指定初始化器
如果不想按顺序,或只想初始化特定成员,可以使用指定初始化器:
c
struct Book b3 = { .price = 59.9f, .title = "C Primer Plus" };未指定的成员自动置 0。这种方式可读性更好,推荐在成员较多时使用。
2. 指定初始化器(C99新特性)
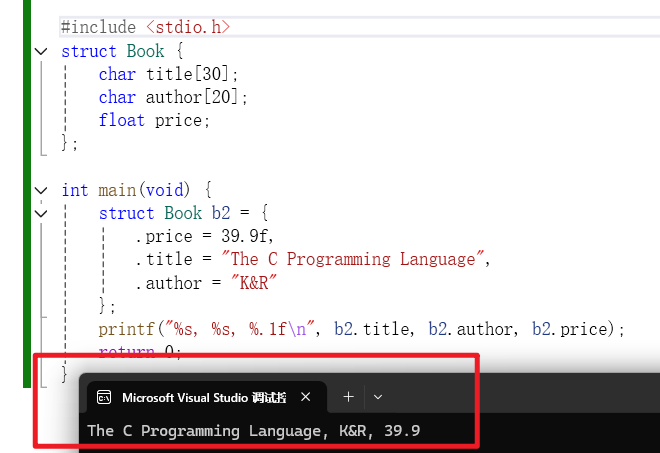
如果不按顺序赋值,或者只想给特定成员赋值,可以使用 .成员名 = 值 的方式。极大提高了代码的可读性和可维护性。
c
#include <stdio.h>

struct Book {
    char title[30];
    char author[20];
    float price;
};

int main(void) {
    struct Book b2 = {
        .price = 39.9f,
        .title = "The C Programming Language",
        .author = "K&R"
    };
    printf("%s, %s, %.1f\n", b2.title, b2.author, b2.price);
    return 0;
}
要点总结:
-
顺序无关
指定初始化器的顺序可以与成员声明顺序不同,编译器会根据成员名精确匹配。上例中先初始化
price,再初始化title,完全合法。 -
未指定成员自动置 0
未被指定的成员会被自动初始化为 0(指针为
NULL,字符数组为'\0',数值为0)。例如:cstruct Book b3 = { .title = "C Primer Plus" }; // author 为空字符串,price 为 0.0 -
可读性与可维护性
当结构体成员较多、或初始化值容易混淆时,指定初始化器能清晰表达"哪个值赋给哪个成员",减少因顺序错误引发的 bug。尤其在结构体成员增删时,不易出错。
-
嵌套结构体也可指定
对于嵌套结构体,可以逐层使用指定初始化器:
cstruct Employee e = { .name = "Alice", .birthday = { .year = 1998, .month = 5, .day = 20 }, .salary = 12000.0f }; -
可与位置初始化混合,但需谨慎
C99 允许混合使用,但位置初始化必须出现在指定初始化之前。例如:
cstruct Book b4 = { "C Primer Plus", .price = 59.9f }; // title 用位置初始化,author 未指定自动为 0,price 用指定初始化为保持清晰,建议要么全用位置,要么全用指定。
避坑提示:
- C99 及以上才支持:老编译器(如 C89/ANSI C)不支持此语法,可能报错或警告。跨平台时需确认编译器标准。
- 只能用于初始化,不能用于赋值 :定义变量后,不能用
b2 = { .price = 39.9f };整体赋值,只能逐成员赋值或整体拷贝。 - C++ 兼容性有限:C++20 才正式引入指定初始化器,且要求顺序必须与声明顺序一致,不能随意调换。若代码需在 C 和 C++ 间共享,建议慎用。
- 成员名拼写错误:若写错成员名,编译器会报错(未声明成员),这是好事;但若成员名与局部变量重名,需注意作用域。
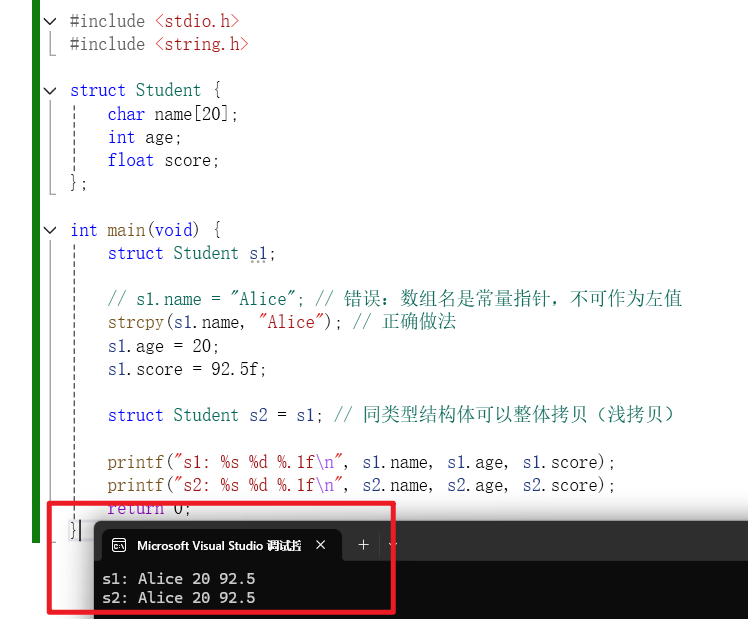
3. 先定义后赋值
如果变量已经定义,就不能再用大括号整体赋值了,必须对其成员逐个赋值。特别注意:字符数组不能用 = 直接赋值,必须用 strcpy 等字符串函数。
c
#include <stdio.h>
#include <string.h>

struct Student {
    char name[20];
    int age;
    float score;
};

int main(void) {
    struct Student s1;

    // s1.name = "Alice"; // 错误:数组名是常量指针,不可作为左值
    strcpy(s1.name, "Alice"); // 正确做法
    s1.age = 20;
    s1.score = 92.5f;

    struct Student s2 = s1; // 同类型结构体可以整体拷贝(浅拷贝)

    printf("s1: %s %d %.1f\n", s1.name, s1.age, s1.score);
    printf("s2: %s %d %.1f\n", s2.name, s2.age, s2.score);
    return 0;
}
要点总结:
-
初始化 vs 赋值
- 大括号
{}初始化只能用在定义变量时。 - 定义之后,只能逐成员赋值,或使用同类型结构体变量整体赋值(
s2 = s1;)。 - 不能写
s1 = {"Alice", 20, 92.5f};,这是语法错误。
- 大括号
-
字符数组的特殊性
- 数组名是常量指针,不能作为左值,因此
s1.name = "Alice";非法。 - 必须使用
strcpy、strncpy或memcpy将字符串内容复制到数组中。 - 使用
strcpy时要确保目标数组足够大,否则会缓冲区溢出。
- 数组名是常量指针,不能作为左值,因此
-
结构体整体拷贝是浅拷贝
s2 = s1;合法,编译器会按字节复制整个结构体。- 若成员中包含指针,拷贝后两个结构体的指针指向同一块内存,释放时可能造成重复释放(double free)或悬空指针,需谨慎。
-
嵌套结构体的赋值
嵌套结构体同样遵循逐成员赋值原则,但可以整体拷贝外层结构体,内层也会被逐字节复制。
避坑提示:
- strcpy 的安全隐患 :建议使用
strncpy并手动补'\0',或使用更安全的strcpy_s(C11 附录 K,非标准)。 - 浅拷贝陷阱 :如果结构体成员有指针,且指向动态分配的内存,整体拷贝后两个结构体共享同一内存。正确做法是实现深拷贝,为指针成员重新分配内存并复制内容。
- 不要混淆初始化和赋值 :
struct Student s1 = {"Alice", 20, 92.5f};是初始化;s1 = (struct Student){"Alice", 20, 92.5f};是复合字面量赋值(C99),虽然可行,但较少用,且同样受浅拷贝限制。
拓展:复合字面量(C99)
C99 允许在赋值时使用复合字面量,例如:
c
s1 = (struct Student){"Alice", 20, 92.5f};这本质上创建了一个临时结构体,再整体拷贝给 s1,同样是浅拷贝。若成员有指针,依然要注意内存管理。
三、结构成员访问操作符
要操作结构体的成员,C 语言提供了两个操作符:点操作符 . 和箭头操作符 ->。理解它们的区别是操作结构体的基础。
1. 点操作符 .(可以参考前面几篇操作符详解文章有详细介绍)
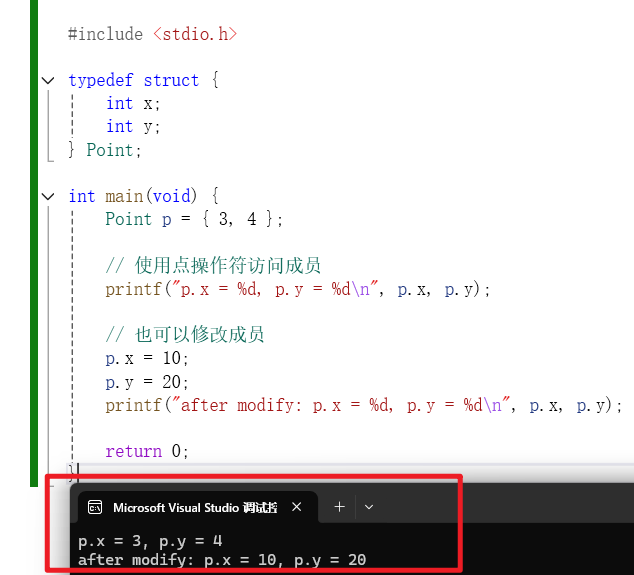
适用于结构体变量 本身,通过 变量名.成员名 访问成员。这是最基础、最常用的成员访问方式。
c
#include <stdio.h>

typedef struct {
    int x;
    int y;
} Point;

int main(void) {
    Point p = {3, 4};

    // 使用点操作符访问成员
    printf("p.x = %d, p.y = %d\n", p.x, p.y);

    // 也可以修改成员
    p.x = 10;
    p.y = 20;
    printf("after modify: p.x = %d, p.y = %d\n", p.x, p.y);

    return 0;
}
要点总结:
- 适用对象 :点操作符左边必须是结构体变量(或结构体数组元素、嵌套结构体成员等实体),不能是结构体指针。
- 语法形式 :
变量名.成员名,其中.的优先级很高,与()、[]同级,从左向右结合。 - 可读可写:点操作符既可以读取成员的值,也可以作为左值修改成员。
- 嵌套访问 :若成员本身是结构体,可逐层使用点操作符,如
e.birthday.year。 - 数组元素访问 :结构体数组的每个元素也是结构体变量,同样用点操作符,如
arr[0].x。
2. 箭头操作符 ->
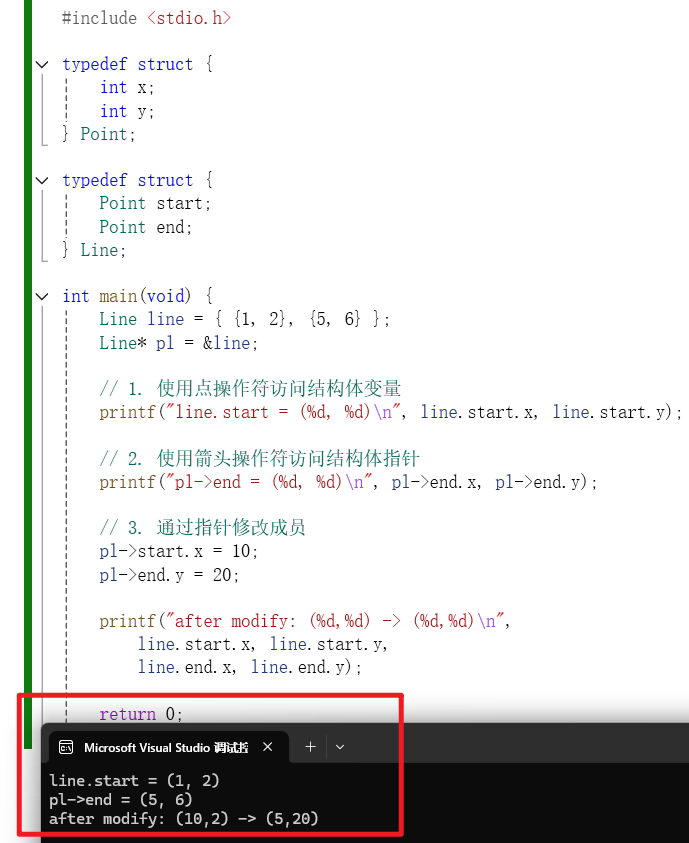
适用于结构体指针 。通过 指针->成员名 访问。它等价于 (*指针).成员名。
c
#include <stdio.h>

typedef struct {
    int x;
    int y;
} Point;

typedef struct {
    Point start;
    Point end;
} Line;

int main(void) {
    Line line = {{1, 2}, {5, 6}};
    Line *pl = &line;

    // 1. 使用点操作符访问结构体变量
    printf("line.start = (%d, %d)\n", line.start.x, line.start.y);

    // 2. 使用箭头操作符访问结构体指针
    printf("pl->end = (%d, %d)\n", pl->end.x, pl->end.y);

    // 3. 通过指针修改成员
    pl->start.x = 10;
    pl->end.y = 20;

    printf("after modify: (%d,%d) -> (%d,%d)\n",
           line.start.x, line.start.y,
           line.end.x, line.end.y);

    return 0;
}
要点总结:
- 适用对象 :
->左边必须是结构体指针(或联合体指针),不能是结构体变量。 - 等价关系 :
p->member完全等价于(*p).member,但->更直观,且无需担心优先级问题。 - 优先级与结合性 :
->与.、()、[]同级,从左向右结合。因此pl->end.x先取pl->end,再取.x。 - 可读可写 :既可读取成员值,也可作为左值修改成员,如
pl->start.x = 10;。 - 嵌套访问 :若成员本身是结构体,
->与.可混合使用,如pl->end.x、p->birthday.year。
避坑提示:
- 空指针 :
pl未初始化或为NULL时使用->会导致程序崩溃,使用前必须确保指针有效。 - 与
.混用错误 :pl.start.x是错误 的,因为pl是指针,必须用->或(*pl).start.x。 - 括号陷阱 :
(*pl).start.x正确,*pl.start.x错误,因为.优先级高于*。 - const 指针 :
const Line *pl时,pl->start.x不可修改,只能读取;若Line * const pl,指针本身不可改,但成员可改。
拓展:(后续会详细介绍,此处了解即可)
- 函数传参 :结构体指针作为参数时,函数内用
->访问,避免拷贝,提高效率;加const可保护只读语义。 - 链表/树 :自引用结构体中,
node->next是遍历动态数据结构的核心。 - 指向结构体数组的指针 :
Line *p = lines;则p->start.x访问第一个元素,(p+1)->start.x访问第二个元素。 - 复合字面量 :C99 中可用
(&(Line){...})->start.x,但可读性较差,不推荐日常使用。
3. 嵌套访问的优先级
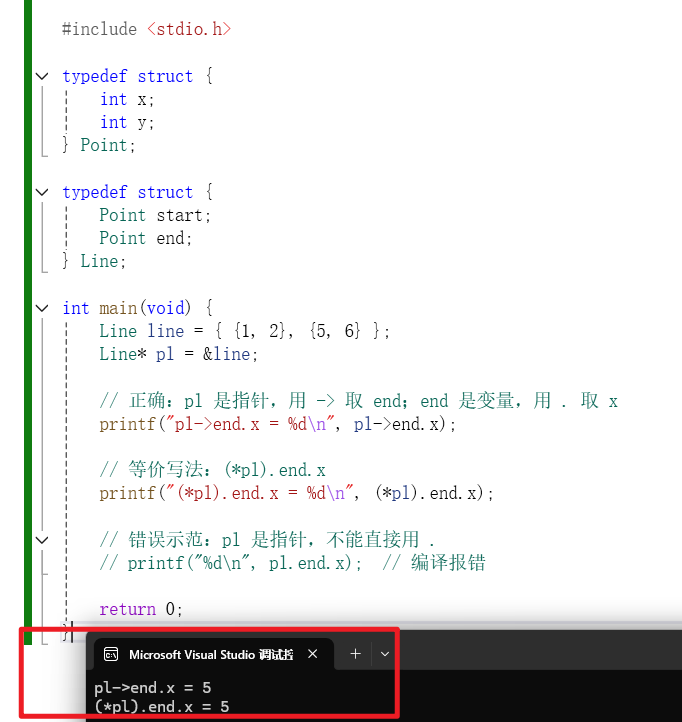
当结构体嵌套时,需要逐层访问成员。-> 和 . 的优先级相同 ,且都是从左向右结合 。因此 pl->end.x 会被解析为 (pl->end).x:先通过 pl 找到它所指向对象的 end 成员,再访问 end 的 x 成员。
c
#include <stdio.h>

typedef struct {
    int x;
    int y;
} Point;

typedef struct {
    Point start;
    Point end;
} Line;

int main(void) {
    Line line = {{1, 2}, {5, 6}};
    Line *pl = &line;

    // 正确:pl 是指针,用 -> 取 end;end 是变量,用 . 取 x
    printf("pl->end.x = %d\n", pl->end.x);

    // 等价写法:(*pl).end.x
    printf("(*pl).end.x = %d\n", (*pl).end.x);

    // 错误示范:pl 是指针,不能直接用 .
    // printf("%d\n", pl.end.x);  // 编译报错

    return 0;
}
要点总结:
- 结合方向 :
->和.均从左向右结合,因此a->b.c->d依次解析为(((a->b).c)->d)。 - 优先级相同 :
->和.优先级相同,高于*(解引用)和&(取地址)。 - 混用规则 :左边是实体(变量、数组元素、结构体成员)用
.;左边是指针用->。pl->end.x:pl是指针 →->;end是实体 →.。p->next->data:p->next是指针 → 继续用->。
- 括号的必要性 :
(*ptr).member中的括号不可省略,因为*优先级低于.。若写*ptr.member,会被解析为*(ptr.member),通常语义错误。
四、结构体内存对齐
这是结构体中最核心、最容易在面试中考察、也最容易在跨平台通信中踩坑的部分。结构体的大小往往不等于其内部成员大小之和。
1. 为什么需要内存对齐?
CPU 访问内存时,并不是按字节读取的,而是按字长(比如 4 字节或 8 字节)成块读取的。如果数据没有对齐,一个 4 字节的 int 跨越了两个内存块,CPU 就需要读取两次并进行拼接,这会大大降低效率,甚至在某些 ARM 平台上直接触发硬件异常。因此,编译器会自动在成员之间插入"填充字节"(Padding),用空间换时间。
2. 对齐规则
- 成员对齐 :每个成员的起始偏移量必须是
min(成员自身大小, 编译器默认对齐数)的整数倍。 - 整体对齐 :结构体的总大小必须是
max(所有成员的对齐数)的整数倍。 - 嵌套对齐:如果结构体嵌套了结构体,嵌套的结构体对齐到自己的最大对齐数。
- 默认对齐数在 VS 中通常是 8,在 GCC 中通常是 4 或 8。
3. 用 offsetof 验证内存布局
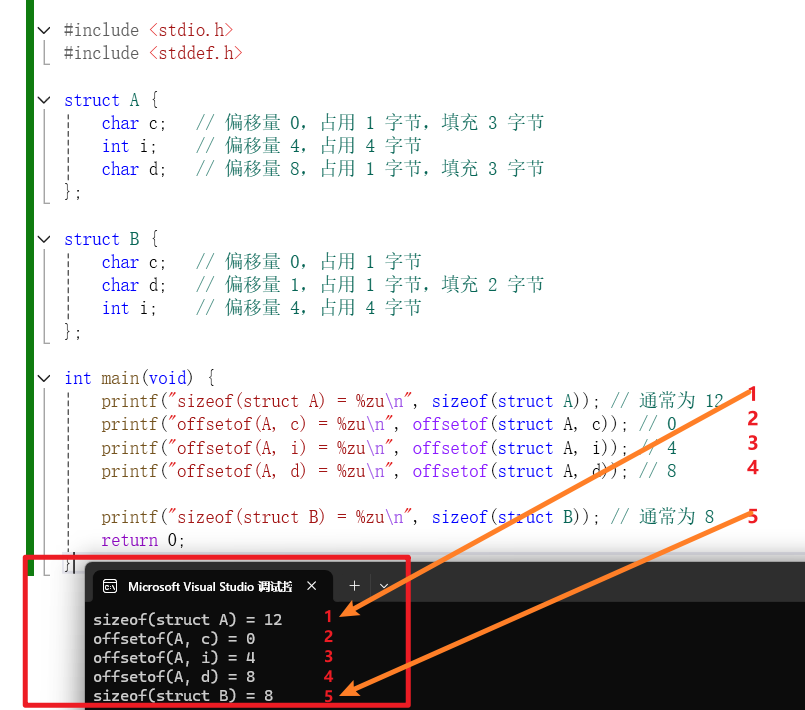
我们可以使用 <stddef.h> 中的 offsetof 宏来查看成员在内存中的实际偏移量。
c
#include <stdio.h>
#include <stddef.h>

struct A {
    char c;   // 偏移量 0,占用 1 字节,填充 3 字节
    int i;    // 偏移量 4,占用 4 字节
    char d;   // 偏移量 8,占用 1 字节,填充 3 字节
};

struct B {
    char c;   // 偏移量 0,占用 1 字节
    char d;   // 偏移量 1,占用 1 字节,填充 2 字节
    int i;    // 偏移量 4,占用 4 字节
};

int main(void) {
    printf("sizeof(struct A) = %zu\n", sizeof(struct A)); // 通常为 12
    printf("offsetof(A, c) = %zu\n", offsetof(struct A, c)); // 0
    printf("offsetof(A, i) = %zu\n", offsetof(struct A, i)); // 4
    printf("offsetof(A, d) = %zu\n", offsetof(struct A, d)); // 8

    printf("sizeof(struct B) = %zu\n", sizeof(struct B)); // 通常为 8
    return 0;
}
要点说明:
以文中 struct A 和 struct B 为例,逐步拆解对齐过程:
struct A 的内存布局(通常 12 字节):
c
struct A {
    char c;   // 偏移 0,占 1 字节
    int  i;   // 偏移 4,占 4 字节(c 后填充 3 字节)
    char d;   // 偏移 8,占 1 字节(末尾填充 3 字节)
};- 第一个成员
c:放在偏移 0 处,占 1 字节。 - 第二个成员
i:int需要 4 字节对齐,起始地址必须是 4 的倍数。当前偏移为 1,不满足,因此编译器在c之后插入 3 字节填充,使i从偏移 4 开始,占 4 字节。 - 第三个成员
d:char对齐要求为 1,偏移 8 满足,占 1 字节。 - 整体对齐 :结构体的总大小必须是其最大对齐数(此处为 4,来自
int)的整数倍。当前累计为 9 字节,不是 4 的倍数,因此在d之后补充 3 字节填充,使总大小变为 12。 - 最终大小 :
1 + 3(填充) + 4 + 1 + 3(填充) = 12字节。
struct B 的内存布局(通常 8 字节):
c
struct B {
    char c;   // 偏移 0,占 1 字节
    char d;   // 偏移 1,占 1 字节
    int  i;   // 偏移 4,占 4 字节(d 后填充 2 字节)
};- 前两个
char:c放在偏移 0,d放在偏移 1,都满足 1 字节对齐要求,无需填充。 - 成员
i:int需要 4 字节对齐,当前偏移为 2,不满足,因此在d之后插入 2 字节填充,使i从偏移 4 开始,占 4 字节。 - 整体对齐:当前累计 8 字节,恰好是最大对齐数(4)的整数倍,末尾无需额外填充。
- 最终大小 :
1 + 1 + 2(填充) + 4 = 8字节。
对比与结论:
| 结构体 | 成员 | 大小 | 填充字节 | 总大小 |
|---|---|---|---|---|
struct A |
char, int, char | 6 | 6 | 12 |
struct B |
char, char, int | 6 | 2 | 8 |
两个结构体成员完全相同,仅顺序不同,大小却相差 4 字节。核心规律:将占用空间小的成员集中放在一起,可以减少填充,节省内存。反之,大小交替排列(小-大-小)会引入更多填充。
拓展思考:
- 成员顺序不仅影响大小,也影响缓存友好性。频繁一起访问的成员放在相邻位置,可以提升缓存命中率。
- 若结构体需要跨平台传输,除了考虑对齐,还要关注字节序;通常建议逐字段序列化为字节流,而不是直接传输结构体内存映像。
- 使用
offsetof宏可以精确验证每个成员的实际偏移,比凭直觉猜测更可靠。
4. 修改默认对齐数
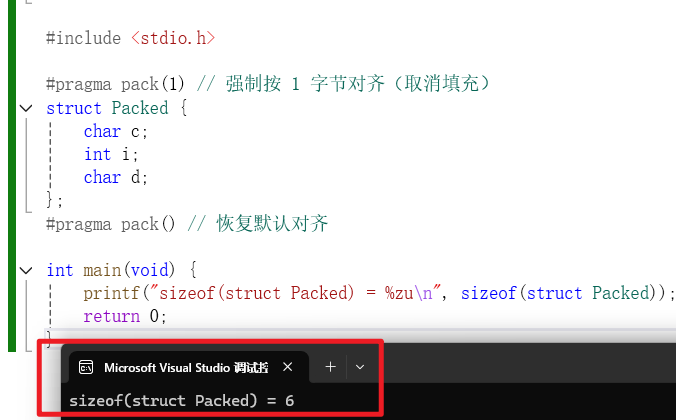
可以使用 #pragma pack(n) 强制修改对齐数(通常用于网络协议或硬件寄存器映射)。
c
#include <stdio.h>

#pragma pack(1) // 强制按 1 字节对齐(取消填充)
struct Packed {
    char c;
    int i;
    char d;
};
#pragma pack() // 恢复默认对齐

int main(void) {
    printf("sizeof(struct Packed) = %zu\n", sizeof(struct Packed)); // 输出 6
    return 0;
}
值得注意的核心点
-
不要假设
sizeof(struct)等于成员大小之和编译器会插入填充字节,导致结构体实际大小往往大于成员大小之和。用
offsetof宏精确查看每个成员的偏移,用sizeof获取真实大小,不要凭直觉手算。 -
将占用空间小的成员集中放在一起,可以减小结构体整体大小
成员顺序直接影响填充数量。小-大-小交替排列会产生更多填充;将同类型或小尺寸成员集中排列,能显著节省内存。例如
char, char, int通常比char, int, char小 4 字节。 -
#pragma pack虽然能节省空间,但会降低访问效率,且存在平台移植问题,非必要不使用强制取消对齐可减小体积,但可能引发未对齐访问,降低性能甚至触发硬件异常。仅在网络协议、硬件寄存器映射等必须精确控制字节布局的场景下使用,并注意跨平台兼容性。
-
嵌套结构体同样遵循对齐规则,且可能引发双重填充
内部结构体的最大对齐数会成为外层结构体对齐要求的候选之一。若内部结构体末尾已有填充,外层还可能再次填充以保证整体对齐。设计嵌套结构体时,成员顺序和大小需一并考虑。
-
跨平台通信慎传结构体二进制
不同平台的对齐规则、字节序、基本类型大小可能不同,直接传输结构体内存映像极易出错。推荐逐字段序列化为字节流,或使用明确的协议格式(如 TLV),避免依赖编译器布局。
五、结构体传参
函数传参时,结构体可以作为值传递,也可以传指针。这两种方式在底层有着本质的区别。
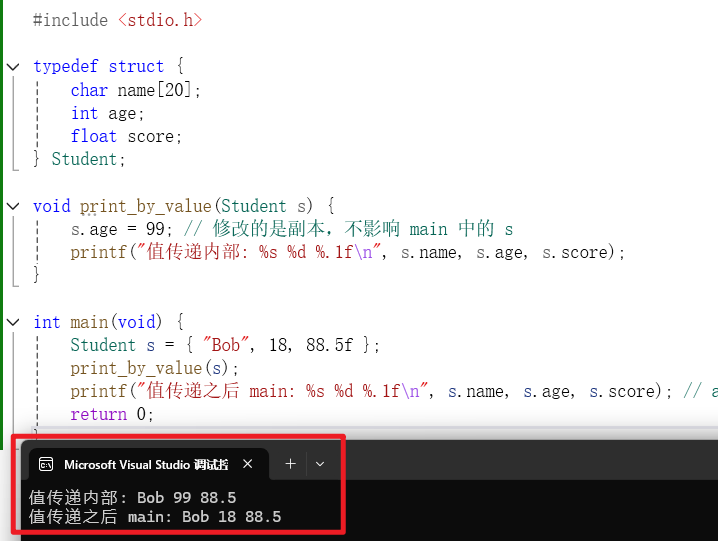
1. 值传递(传结构体本身)
值传递时,函数会在栈上拷贝一份完整的结构体。如果结构体很大,拷贝开销极大,且函数内修改形参不会影响实参。
c
#include <stdio.h>

typedef struct {
    char name[20];
    int age;
    float score;
} Student;

void print_by_value(Student s) {
    s.age = 99; // 修改的是副本,不影响 main 中的 s
    printf("值传递内部: %s %d %.1f\n", s.name, s.age, s.score);
}

int main(void) {
    Student s = {"Bob", 18, 88.5f};
    print_by_value(s);
    printf("值传递之后 main: %s %d %.1f\n", s.name, s.age, s.score); // age 依然是 18
    return 0;
}
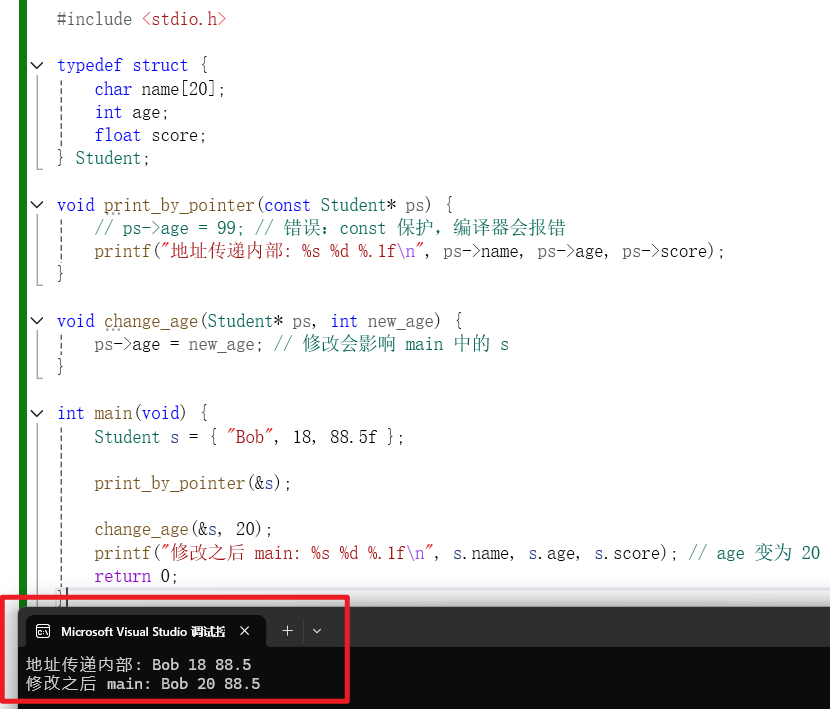
2. 地址传递(传结构体指针)
地址传递时,只拷贝一个指针(4 或 8 字节),效率极高。如果不想让函数修改原结构体,可以加上 const 保护。
c
#include <stdio.h>

typedef struct {
    char name[20];
    int age;
    float score;
} Student;

void print_by_pointer(const Student *ps) {
    // ps->age = 99; // 错误:const 保护,编译器会报错
    printf("地址传递内部: %s %d %.1f\n", ps->name, ps->age, ps->score);
}

void change_age(Student *ps, int new_age) {
    ps->age = new_age; // 修改会影响 main 中的 s
}

int main(void) {
    Student s = {"Bob", 18, 88.5f};

    print_by_pointer(&s);

    change_age(&s, 20);
    printf("修改之后 main: %s %d %.1f\n", s.name, s.age, s.score); // age 变为 20
    return 0;
}
值得注意的核心点
-
效率优先:结构体较大时,首选传地址(指针),并加
const防止误修改。-
值传递会拷贝整个结构体。若结构体包含大数组或多个成员,拷贝开销大,消耗栈空间,甚至可能栈溢出。
-
传指针只拷贝一个地址(4 或 8 字节),效率高。加
const表示函数内部不修改原结构体,既保护数据又明确接口。 -
示例:
cvoid print_student(const Student *ps); // 只读,用 const void change_age(Student *ps, int age); // 需要修改,不加 const
-
-
值传递的隔离性:值传递天然具有数据保护作用,但代价是拷贝开销。
- 值传递时,函数得到的是原结构体的副本,内部修改不影响外部。适合结构体很小(如几个
int)且不希望外部被修改的场景。 - 若结构体较大,拷贝开销和栈消耗不可忽视,此时应改用指针。
- 注意:值传递无法将修改结果带回调用者;若需要修改原结构体,必须传指针。
- 值传递时,函数得到的是原结构体的副本,内部修改不影响外部。适合结构体很小(如几个
-
空指针检查:如果传指针,在函数内部使用前应检查
ps != NULL。-
调用者可能误传
NULL,解引用会导致程序崩溃。使用前判空是防御性编程的基本要求。 -
调试期可用
assert(ps != NULL);,但发布版(定义NDEBUG)会移除断言,不能仅依赖它。生产代码必须显式判空并处理。 -
示例:
cvoid print_student(const Student *ps) { if (ps == NULL) { fprintf(stderr, "错误:空指针\n"); return; } printf("%s\n", ps->name); }
-
补充提示:
- 不要返回局部结构体的地址。函数内局部结构体在栈上,函数返回后内存失效。若需返回结构体,小结构体可直接返回值,大结构体可由调用者传入指针填充,或返回动态分配指针(记得释放)。
const的位置 :const Student *ps表示不能通过ps修改成员;Student * const ps表示指针本身不能改,但成员可改;const Student * const ps表示两者都不可改。- 传指针时建议先判空再使用,这是接口健壮性的重要体现。
避坑口诀 :大结构传指针,只读加 const;小结构可传值,隔离但费拷贝;指针用前先判空,断言不能当护身。
六、结构体实现位段
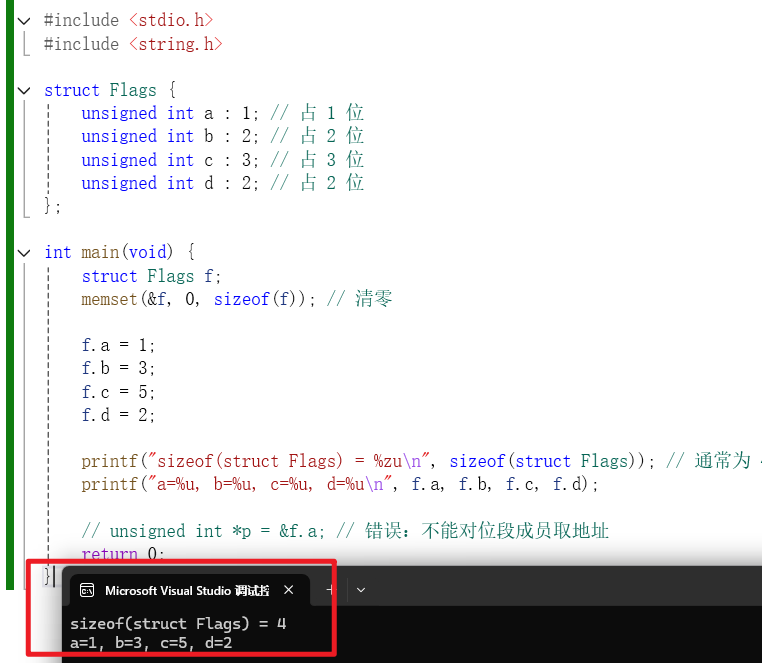
位段(Bit-field)是结构体的一种特殊用法,允许我们以"位"为单位指定成员占用的空间。这在底层硬件编程、网络协议封包中非常常见。
位段的声明与使用
位段成员必须是整型(int、unsigned int、signed int、char 等)。冒号后面的数字表示该成员占用的位数。
c
#include <stdio.h>
#include <string.h>

struct Flags {
    unsigned int a : 1; // 占 1 位
    unsigned int b : 2; // 占 2 位
    unsigned int c : 3; // 占 3 位
    unsigned int d : 2; // 占 2 位
};

int main(void) {
    struct Flags f;
    memset(&f, 0, sizeof(f)); // 清零

    f.a = 1;
    f.b = 3;
    f.c = 5;
    f.d = 2;

    printf("sizeof(struct Flags) = %zu\n", sizeof(struct Flags)); // 通常为 4 字节
    printf("a=%u, b=%u, c=%u, d=%u\n", f.a, f.b, f.c, f.d);

    // unsigned int *p = &f.a; // 错误:不能对位段成员取地址
    return 0;
}
要点总结:
- 类型限制 :位段成员必须是整型,包括
int、signed int、unsigned int、char、_Bool等,不能是浮点、数组、指针或结构体。 - 位宽限制 :冒号后的数字表示占用的位数,不能超过该类型的总位宽。例如
unsigned int通常是 32 位,位宽不能大于 32。 - 内存分配不确定 :位段在内存中的具体布局(从右向左还是从左向右、是否跨存储单元)由编译器和平台决定。
sizeof(struct Flags)可能是 4 字节,也可能是其他值,不能假设。 - 不能取地址 :位段成员可能不位于字节边界,无法用
&取地址,因此不能用于scanf等需要地址的场合。 - 赋值截断 :若赋值超出位宽范围,高位会被截断。例如给
a : 1赋2,实际存入的是0。 - 无名位段与零位段 :
- 无名位段(如
unsigned int : 3;)用于占位填充,跳过指定位数,不可访问。 - 零位段(如
unsigned int : 0;)强制下一个位段从新的存储单元开始,常用于对齐。
- 无名位段(如
- 可移植性差 :不同编译器对位段的分配方向、对齐方式、是否允许跨字节等规则不同,因此严禁在跨平台通信中直接使用位段。若需精确控制字节,应使用位运算手动组装。
避坑提示:
- 不要依赖位段的内存布局,不同平台结果可能不同。
- 不要对位段取地址,编译会报错。
- 不要用位段存储需要精确范围的数值,除非你能确保位宽足够且截断行为符合预期。
- 跨平台协议中改用位运算 :例如用
#define FLAG_A (1 << 0)配合unsigned int,通过|、&、~操作,可移植性更好。 memset清零是良好习惯 ,但注意位段结构体的大小仍受对齐影响,memset会覆盖整个结构体,包括填充字节。
七、总结
结合内存与指针的底层视角,我们可以提炼出结构体使用的通关心法:
- 声明与定义分离:声明是图纸,定义才分配内存;自引用必须用指针。
- 初始化要规范 :C99 指定初始化器可读性最佳;字符数组赋值必须用
strcpy。 - 访问要分清 :变量用
.,指针用->,嵌套访问从左向右结合。 - 对齐是核心 :内存对齐是空间换时间的权衡;调整成员顺序可优化内存;
#pragma pack慎用。 - 传参看效率 :大结构体传指针,加
const保护;小结构体可传值。 - 位段虽好,可移植性差:适合底层位操作,但跨平台通信必须用位运算替代。
核心心法:指针决定步长,对齐决定布局。
各位大佬,留个关注支持一下吧!!