HyperNetworks
论文地址:https://arxiv.org/abs/1609.09106
学术交流群:922230617
目录
[1. 引言](#1. 引言)
[2. 动机与相关工作](#2. 动机与相关工作)
[3. 方法](#3. 方法)
[3.1 静态超网络:为卷积网络生成权重](#3.1 静态超网络:为卷积网络生成权重)
[3.2 动态超网络:为循环网络自适应生成权重](#3.2 动态超网络:为循环网络自适应生成权重)
[4. 实验](#4. 实验)
[4.1 静态超网络用于 MNIST 卷积网络](#4.1 静态超网络用于 MNIST 卷积网络)
[4.2 静态超网络用于 CIFAR-10 残差网络(ResNet)](#4.2 静态超网络用于 CIFAR-10 残差网络(ResNet))
[4.3 HyperLSTM 用于字符级 Penn Treebank 语言建模](#4.3 HyperLSTM 用于字符级 Penn Treebank 语言建模)
[4.4 HyperLSTM 用于 Hutter Prize Wikipedia(enwik8)](#4.4 HyperLSTM 用于 Hutter Prize Wikipedia(enwik8))
[4.5 HyperLSTM 用于手写序列生成(IAM)](#4.5 HyperLSTM 用于手写序列生成(IAM))
[4.6 HyperLSTM 用于神经机器翻译(WMT'14 En→Fr)](#4.6 HyperLSTM 用于神经机器翻译(WMT'14 En→Fr))
1. 引言
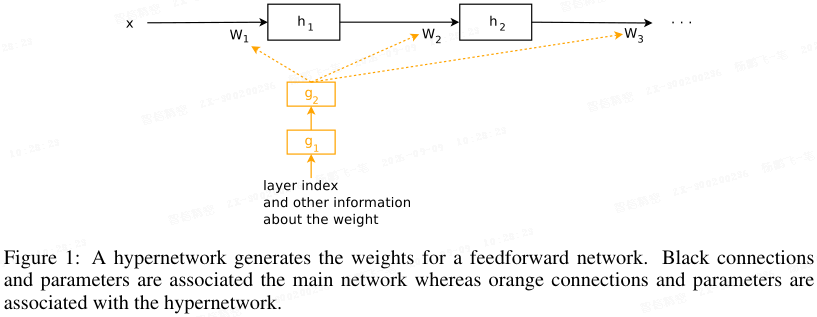
在深度学习中,通常直接训练网络的权重参数。论文提出一种新思路:使用一个小型网络(称为超网络 )来生成另一个更大网络(称为主网络)的权重。主网络的行为与普通神经网络无异------学习将输入映射到目标输出;而超网络则接收包含层结构信息的输入(如层 embedding 向量),并生成该层的权重。
这种设计受进化计算中的 HyperNEAT 启发,但论文的超网络完全通过反向传播端到端训练,因此更高效、可扩展。超网络可以看作一种 "基因型-表型" 关系:超网络编码了主网络的结构。
论文聚焦两个应用方向:
-
静态超网络:为卷积网络生成滤波器。
-
动态超网络:为循环网络(RNN/LSTM)动态生成每时间步的权重。
主要贡献: 超网络生成的非共享权重的 LSTM,在字符级语言建模、手写生成、神经机器翻译上取得接近或超越 SOTA 的结果,挑战了循环网络"权重共享"的固有范式。同时,超网络在卷积网络上用更少参数取得了有竞争力的图像识别精度。
【
(2026|CVPR Oral|NITR,模型压缩,权重调制,参数映射)映射网络
映射网络的作者在论文中指出,其研究是一种超网络。区别在于,
- 超网络联合训练超网络与主网络(目标网络),而映射网络冻结正交初始化的映射矩阵,只训练一维的潜在向量。
- 因此产生了第二个差异:由于潜在向量通常是低维的(远小于目标网络的参数量),因此映射网络实现了大幅度参数压缩。
】
2. 动机与相关工作
传统进化方法(如 HyperNEAT)通过演化 CPPN 来定义大网络权重,但训练慢且依赖启发式。压缩权重搜索(DCT) 使用固定变换,过于简单。DPPN 可微但规模有限。
论文与上述方法的关键区别:端到端梯度下降,训练效率高。
论文也受到 快速权重(fast weights) 概念的启发(Schmidhuber, 1992),其中网络可产生上下文依赖的权重变化。早期实验限于前馈网络,而论文首次将此类方法成功应用于大规模循环网络(LSTM)。
此外,论文采用层 embedding 向量 作为超网络输入,而非 HyperNEAT 中的坐标输入,这使得超网络能适用于卷积和循环架构,且能实现层内和层间近似权重共享。
3. 方法
3.1 静态超网络:为卷积网络生成权重
每个卷积核包含 N_in × N_out 个 filters,每个 filters 的尺寸为 f_size × f_size。假设这些参数存储在矩阵 K_j ∈ R^{N_in · f_size × N_out · f_size} 中,其中 j = 1, ..., D 是主卷积网络的深度。
超网络接收一个可学习的层 embedding 向量z^j ∈ R^{N_z},通过超网络 g 生成该层全部权重:
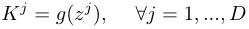
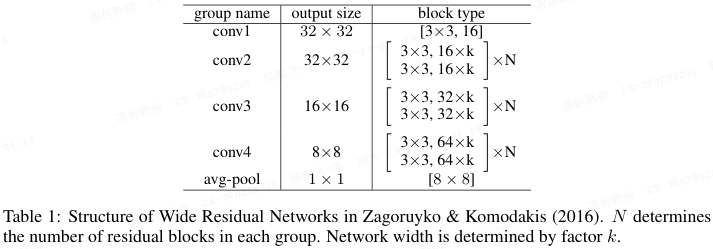
处理不同尺寸的核 :实际网络中(如 ResNet),各层通道数不同(16、32、64 等)。论文设定一个基础尺寸(如 16),若需要 32×64 的核,则通过拼接 8 个基础核(每个由独立的embedding生成)组成:
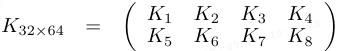
大核需要更多 embedding 向量,参数量成比例增加。
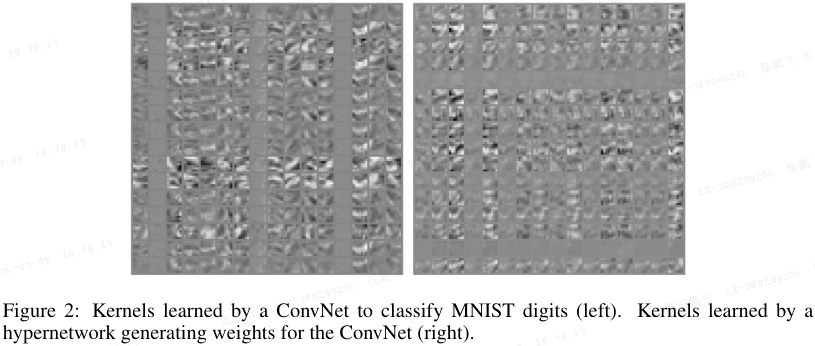
实验显示,超网络生成的卷积核在 MNIST 上与传统学习的核结构相似(见图 2),证明了其有效性。
3.2 动态超网络:为循环网络自适应生成权重
标准 RNN:
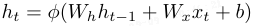
其中,权重 W 和偏置 b 在任意时刻 t 固定不变。
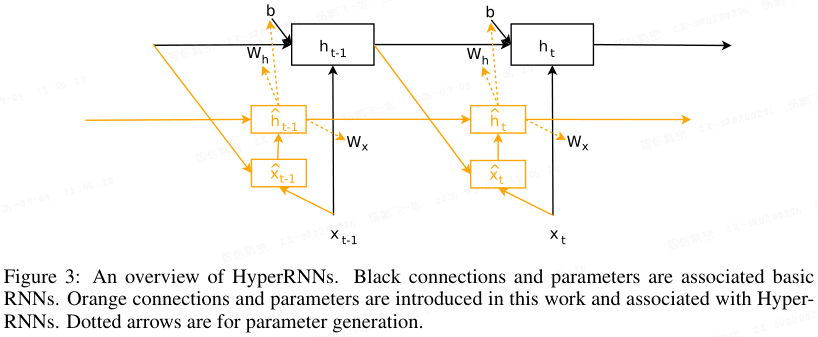
动态超网络允许权重随时间步变化:
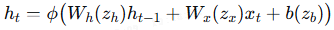
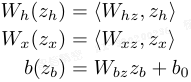
其中,z_h,z_x,z_b 由一个小型循环超网络根据当前输入 x_t 和上一时刻隐状态 h_{t−1} 生成。
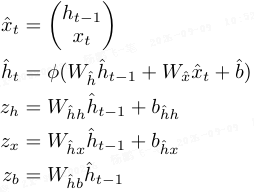
内存优化 :直接生成完整矩阵需要 N_z 倍内存,不实际。论文采用行缩放 策略:不重新生成整个矩阵,而是生成一个缩放向量 d(z),用它来缩放一个固定的基础矩阵的每一行:
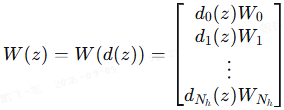
内存需求从 N_z × N_h × N_h 降为 N_z × N_h,且计算为逐元素乘法,十分高效。
该操作与 Layer Normalization、Multiplicative RNN 有相似性,但论文的缩放向量是数据依赖且随时间变化的。
将此思想扩展至 LSTM,得到 HyperLSTM。每个门(输入、遗忘、输出、细胞更新)的权重矩阵都由超网络生成的缩放向量调整。超网络本身也是一个 LSTM(带 Layer Norm),其隐状态通过线性投影生成各个门的embedding。
4. 实验
4.1 静态超网络用于 MNIST 卷积网络
主网络:两层卷积,第二层核为 7×7×16×16(12,544 参数)
超网络:embedding大小 N_z = 4,超网络参数 4,240
结果:测试精度 99.24% vs 传统 99.28%,参数量大幅减少。
4.2 静态超网络用于 CIFAR-10 残差网络(ResNet)
使用 Wide ResNet(WRN-40-1 和 WRN-40-2),超网络生成 conv2、conv3、conv4 共 36 层卷积核。
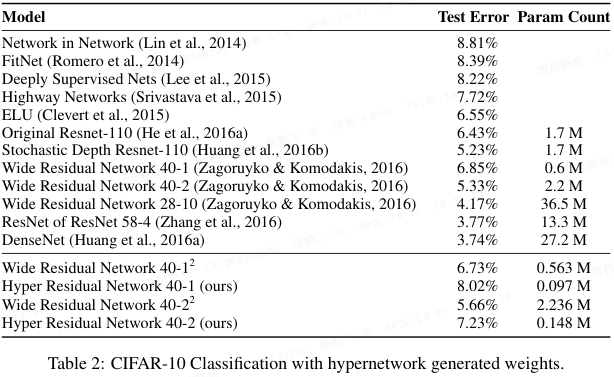
精度损失约 1.25~1.5%,但参数量减少为原来的 1/6~1/15,说明超网络提供了良好的权衡。
4.3 HyperLSTM 用于字符级 Penn Treebank 语言建模
任务:预测下一个字符,评价指标 BPC(bits-per-character)
主 LSTM:1000 或 1800 单元;超网络 128 单元,embedding 大小 4
对比:普通 LSTM、Layer Norm LSTM、堆叠 LSTM
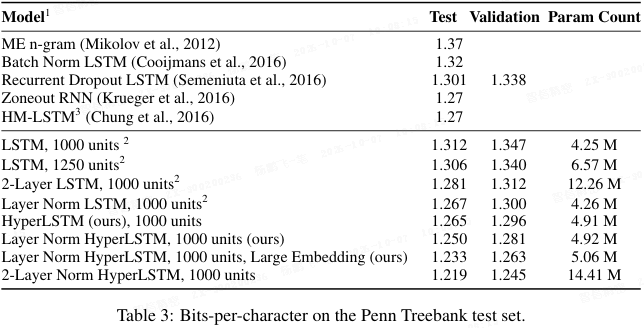
HyperLSTM 优于普通 LSTM,与 Layer Norm 结合达接近 SOTA,且收敛更快。
4.4 HyperLSTM 用于 Hutter Prize Wikipedia(enwik8)
数据集:100M 字符,205 个唯一字符,更复杂
主 LSTM:1800/2048 单元;超网络 256/512 单元
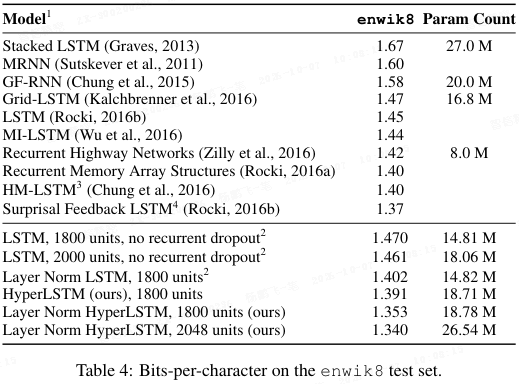
接近当时 SOTA。
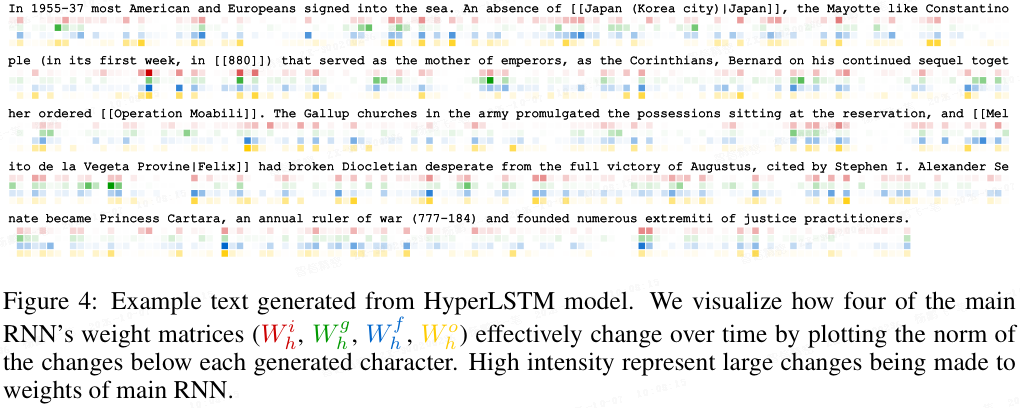
生成样本分析:权重变化强度显示,在确定性词语(如 "Europeans")中变化小,在单词间或括号处变化大,说明超网络在动态切换模型。
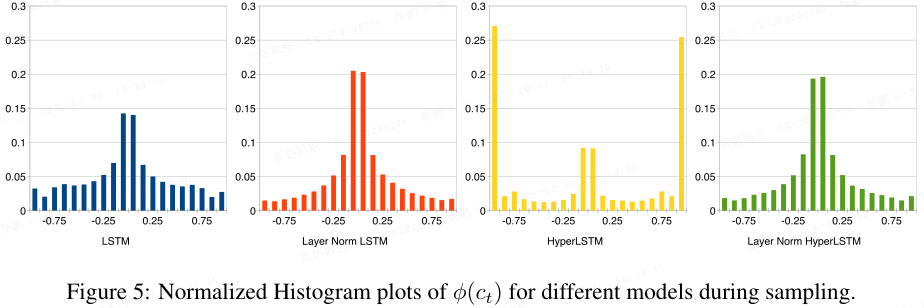
隐藏状态直方图:HyperLSTM 的细胞状态常处于饱和区,与 Layer Norm 的去饱和策略不同,但两者性能相近,说明超网络学到的策略并非简单归一化。
4.5 HyperLSTM 用于手写序列生成(IAM)
任务:预测笔迹 (x,y) 坐标和提笔/落笔状态,使用 MDN(混合密度网络)
序列长度:平均 700 步,最长 1900 步
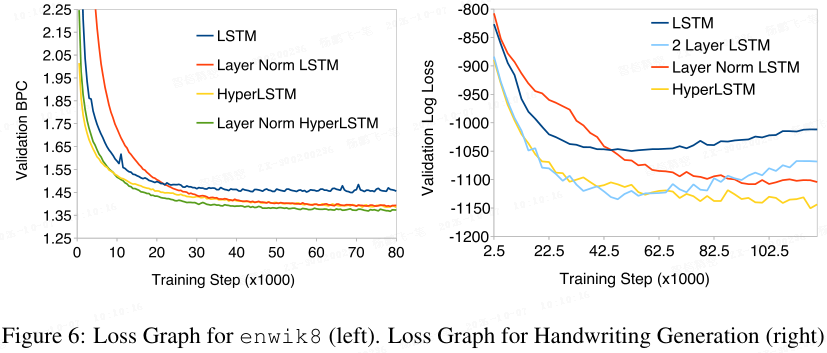
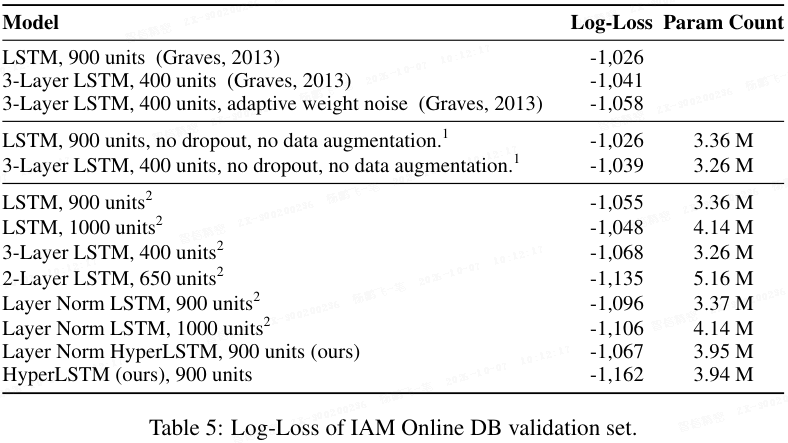
HyperLSTM 显著优于基线,收敛速度与 2 层 LSTM 相当。生成样本更连贯,权重变化集中在单词或字符之间,呈现"跳变"模式。
4.6 HyperLSTM 用于神经机器翻译(WMT'14 En→Fr)
模型:Google GNMT 架构,将 LSTM 替换为 HyperLSTM
结果:
HyperLSTM 达到当时单模型 SOTA,且 log 困惑度降低,证明了超网络在大规模生产级任务中的实用性。