文章目录
- [1. 协程池](#1. 协程池)
- [2. 监控当前协程池运行指标](#2. 监控当前协程池运行指标)
- [3. 小结](#3. 小结)
1. 协程池
go 里面都是用的协程,由于协程创建比较轻量,所以一般在业务里面要用就直接开一个协程,很少有用协程池的,但是有一些项目需要处理高并发问题,QPS 能打到 10000 以上,这种情况下就会考虑用协程池。
go 里面用的比较多的就是 ants,需要在 go.mod 里面引入 ants 包:github.com/panjf2000/ants/v2 v2.12.0。
接下来就是初始化,初始化比较简单。
go
func New(cfg Config) (*Pool, error) {
	p, err := ants.NewPool(
		cfg.WorkerCount,
		ants.WithMaxBlockingTasks(cfg.MaxBlockingTasks),
		ants.WithNonblocking(cfg.Nonblocking),
		ants.WithPreAlloc(cfg.PreAlloc),
	)
	if err != nil {
		return nil, err
	}

	return &Pool{pool: p}, nil
}
我们主要看下里面几个参数,原理就先不看了。
- WorkerCount: 协程池子的大小,也就是协程数,相当于线程池的最大线程数。
- MaxBlockingTasks: 最多允许多少个调用方阻塞在
pool.Submit()上等待,0 默认表示不限制。 - Nonblocking: 是否非阻塞提交,如果开启就是
Submit()不等待,池满了立刻返回 ErrPoolOverload ,如果不开启就是池子满了就阻塞等待,当Nonblocking = false的时候上面的 MaxBlockingTasks 才有用。 - PanicHandler: worker 执行任务发生 panic 时的处理函数,可以统一打印日志,上报指标等。
- Logger: 自定义日志器,如果不设置,就用标准库 log,通常用来接入自己的日志框架。
- DisablePurge: 是否禁用空闲 worker 清理,如果是 true 就不清理,worker 常驻,如果是 false 就允许根据 ExpiryDuration 回收空闲 worker。
- ExpiryDuration: 空闲 worker 的过期时间,协程池会有一个清理协程,周期性扫描 worker,如果某个 worker 超过这个时间没被使用,就会被回收。
上面是几个核心参数,用法也很简单,调用 Submit 添加任务。
go
func (p *Pool) Submit(task func()) error {
	if p.IsClosed() {
		return ErrPoolClosed
	}

	w, err := p.retrieveWorker()
	if w != nil {
		w.inputFunc(task)
	}
	return err
}
可以看到任务就是一个 func() 无参无返回值函数。
2. 监控当前协程池运行指标
ants 协程池提供下面几个方法来监控协程池运行时候的协程数,监控协程数可以看到这个协程池协程的利用率,然后监控阻塞数,就能看到是不是协程参数配置有问题导致一些协程阻塞住,这下就要考虑调大协程数了。
go
package pool

import (
	"github.com/panjf2000/ants/v2"
)

type Task func()

type Config struct {
	// WorkerCount 表示协程池最大并发 worker 数
	WorkerCount int
	// MaxBlockingTasks 表示最多允许多少个提交方阻塞等待
	MaxBlockingTasks int
	// Nonblocking 为 true 时,池满后直接返回错误,不阻塞等待
	Nonblocking bool
	// PreAlloc 为 true 时,预分配内部 worker 队列
	PreAlloc bool
}

type Pool struct {
	pool *ants.Pool
}

func New(cfg Config) (*Pool, error) {
	p, err := ants.NewPool(
		cfg.WorkerCount,
		ants.WithMaxBlockingTasks(cfg.MaxBlockingTasks),
		ants.WithNonblocking(cfg.Nonblocking),
		ants.WithPreAlloc(cfg.PreAlloc),
	)
	if err != nil {
		return nil, err
	}

	return &Pool{pool: p}, nil
}

func (p *Pool) Submit(task Task) error {
	return p.pool.Submit(task)
}

// Running 返回正在运行的 worker 协程数
func (p *Pool) Running() int {
	return p.pool.Running()
}

// Free 返回当前空闲的 worker 数
func (p *Pool) Free() int {
	return p.pool.Free()
}

// Cap 返回当前协程池容量上限
func (p *Pool) Cap() int {
	return p.pool.Cap()
}

// Waiting 有多少阻塞等待提交的任务, 类似阻塞队列
func (p *Pool) Waiting() int {
	return p.pool.Waiting()
}

func (p *Pool) Close() {
	p.pool.Release()
}
然后我们可以启动一个定时任务,每秒定时上报里面的指标,下面就是 metrics 文件的内容。
go
package metrics

import (
	"fmt"
	"net/http"
	"time"

	"example.com/prometheus-2/pool"
	"github.com/prometheus/client_golang/prometheus"
	"github.com/prometheus/client_golang/prometheus/promhttp"
)

type Registry struct {
	registry     *prometheus.Registry
	running      prometheus.Gauge
	free         prometheus.Gauge
	capacity     prometheus.Gauge
	waiting      prometheus.Gauge
	taskDuration prometheus.Histogram
}

func NewRegistry() *Registry {
	reg := prometheus.NewRegistry()

	r := &Registry{
		registry: reg,
		running: prometheus.NewGauge(prometheus.GaugeOpts{
			Name: "pool_running_workers",
			Help: "Current running workers.",
		}),
		free: prometheus.NewGauge(prometheus.GaugeOpts{
			Name: "pool_free_workers",
			Help: "Current free workers.",
		}),
		capacity: prometheus.NewGauge(prometheus.GaugeOpts{
			Name: "pool_capacity",
			Help: "Current pool capacity.",
		}),
		waiting: prometheus.NewGauge(prometheus.GaugeOpts{
			Name: "pool_waiting_tasks",
			Help: "Current pool waiting tasks.",
		}),
		taskDuration: prometheus.NewHistogram(prometheus.HistogramOpts{
			Name:    "pool_task_duration_seconds",
			Help:    "Duration of tasks executed inside workerPool.Submit.",
			Buckets: prometheus.DefBuckets,
		}),
	}

	reg.MustRegister(r.running, r.free, r.capacity, r.waiting, r.taskDuration)
	return r
}

func (r *Registry) Handler() http.Handler {
	return promhttp.HandlerFor(r.registry, promhttp.HandlerOpts{})
}

func (r *Registry) WrapTaskDuration(task func()) func() {
	return func() {
		start := time.Now()
		defer func() {
			r.taskDuration.Observe(time.Since(start).Seconds())
		}()
		task()
	}
}

func (r *Registry) RunTicker(pool *pool.Pool) {
	ticker := time.NewTicker(1 * time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ticker.C:
			fmt.Println(Now() + " 上报指标")
			r.running.Set(float64(pool.Running()))
			r.free.Set(float64(pool.Free()))
			r.capacity.Set(float64(pool.Cap()))
			r.waiting.Set(float64(pool.Waiting()))
		}
	}
}

func Now() string {
	return time.Now().Format("2006-01-02 15:04:05.000")
}
最后就是 main 方法启动,main 方法中我们启动一个定时任务每秒上报协程池的几个指标,然后启动一个定时任务,每秒添加 50 个任务到协程池里面。
go
package main

import (
	"fmt"
	"log"
	"math/rand"
	"net/http"
	"time"

	"example.com/prometheus-2/metrics"
	"example.com/prometheus-2/pool"
)

const submitBatchSize = 50

func main() {
	reg := metrics.NewRegistry()

	workerPool, err := pool.New(pool.Config{
		WorkerCount:      50,
		MaxBlockingTasks: 128,
		Nonblocking:      true,
		PreAlloc:         false,
	})
	if err != nil {
		log.Fatalf("create worker pool failed: %v", err)
	}

	go reg.RunTicker(workerPool)
	go startSubmitTicker(workerPool, reg)
	defer workerPool.Close()

	http.HandleFunc("/", func(w http.ResponseWriter, req *http.Request) {
		_, _ = fmt.Fprintln(w, "hello prometheus-2")
	})

	http.HandleFunc("/healthz", func(w http.ResponseWriter, req *http.Request) {
		_, _ = w.Write([]byte("ok"))
	})

	http.Handle("/metrics", reg.Handler())

	addr := ":8088"
	log.Printf("prometheus-2 listening on %s", addr)
	log.Printf("metrics endpoint: http://127.0.0.1%s/metrics", addr)
	log.Fatal(http.ListenAndServe(addr, nil))
}

func startSubmitTicker(workerPool *pool.Pool, reg *metrics.Registry) {
	ticker := time.NewTicker(1000 * time.Millisecond)
	defer ticker.Stop()

	for range ticker.C {
		for i := 0; i < submitBatchSize; i++ {
			taskID := i + 1
			task := reg.WrapTaskDuration(func() {
				cost := 1 + rand.Intn(100)
				time.Sleep(time.Duration(cost) * time.Millisecond)
				log.Printf("task %d finished, cost=%dms", taskID, cost)
			})

			if err := workerPool.Submit(task); err != nil {
				log.Printf("submit task %d failed: %v", taskID, err)
				break
			}
		}
	}
}

func init() {
	rand.Seed(time.Now().UnixNano())
}
最后来看下输出结果,打开 prometheus 输入 promql 查看监控指标。
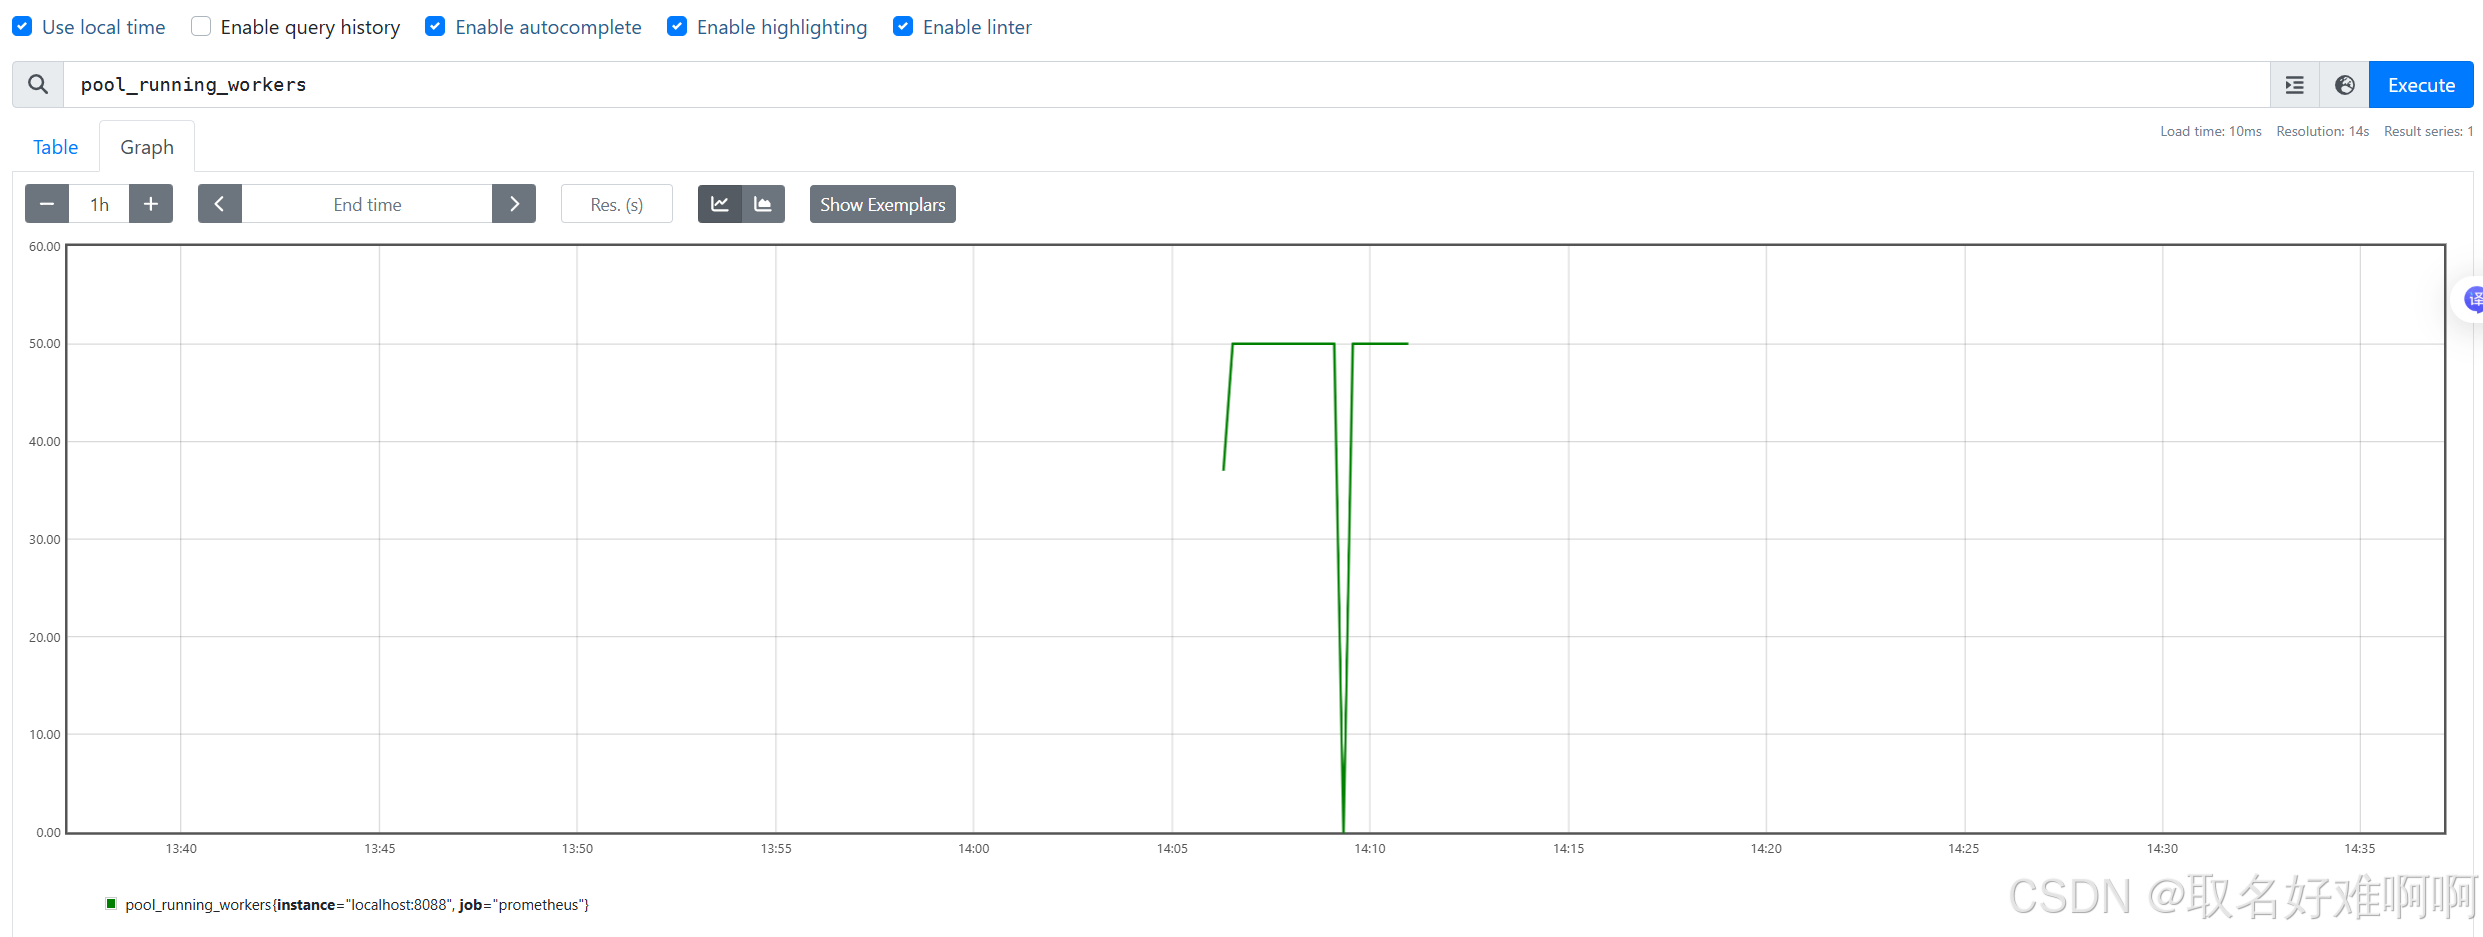
当前协程池的当前运行协程数。
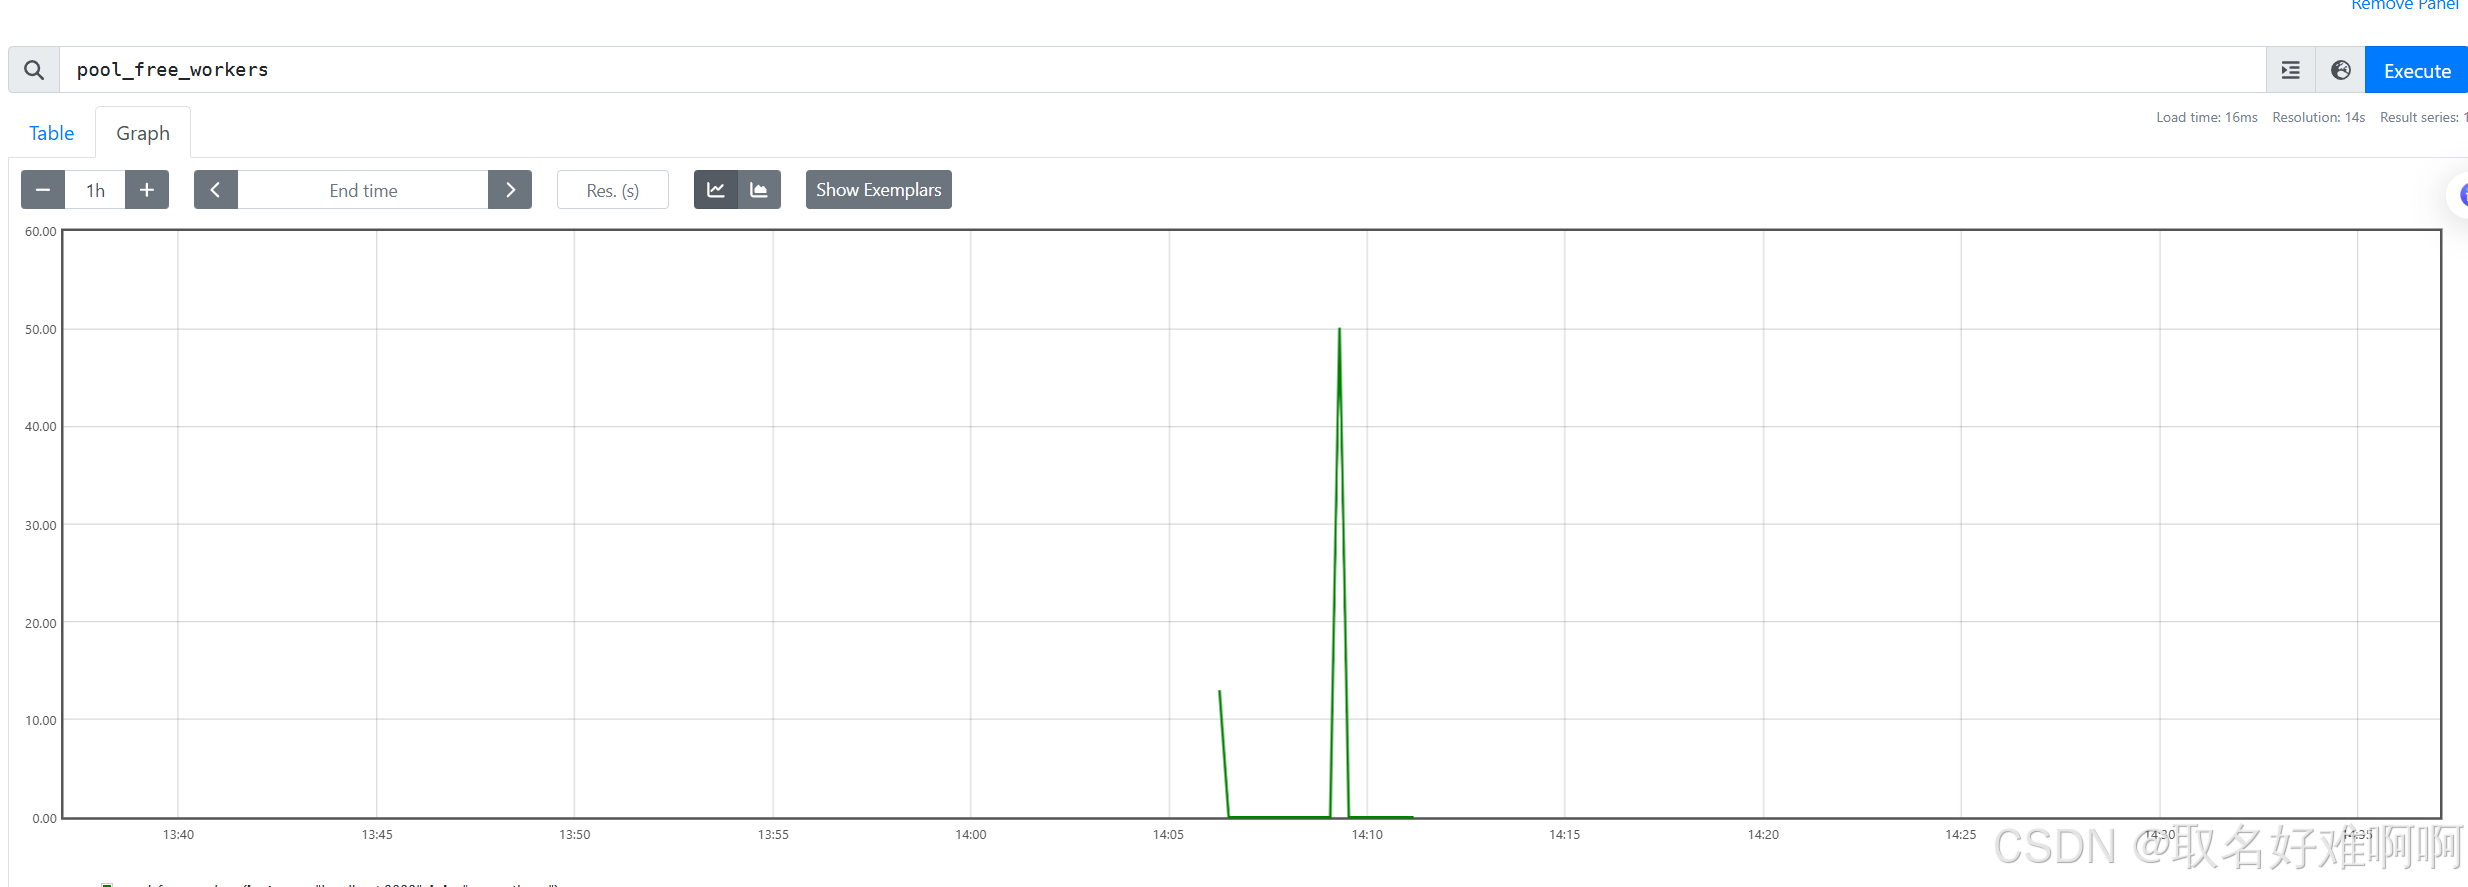
当前协程池里面的空闲协程数。
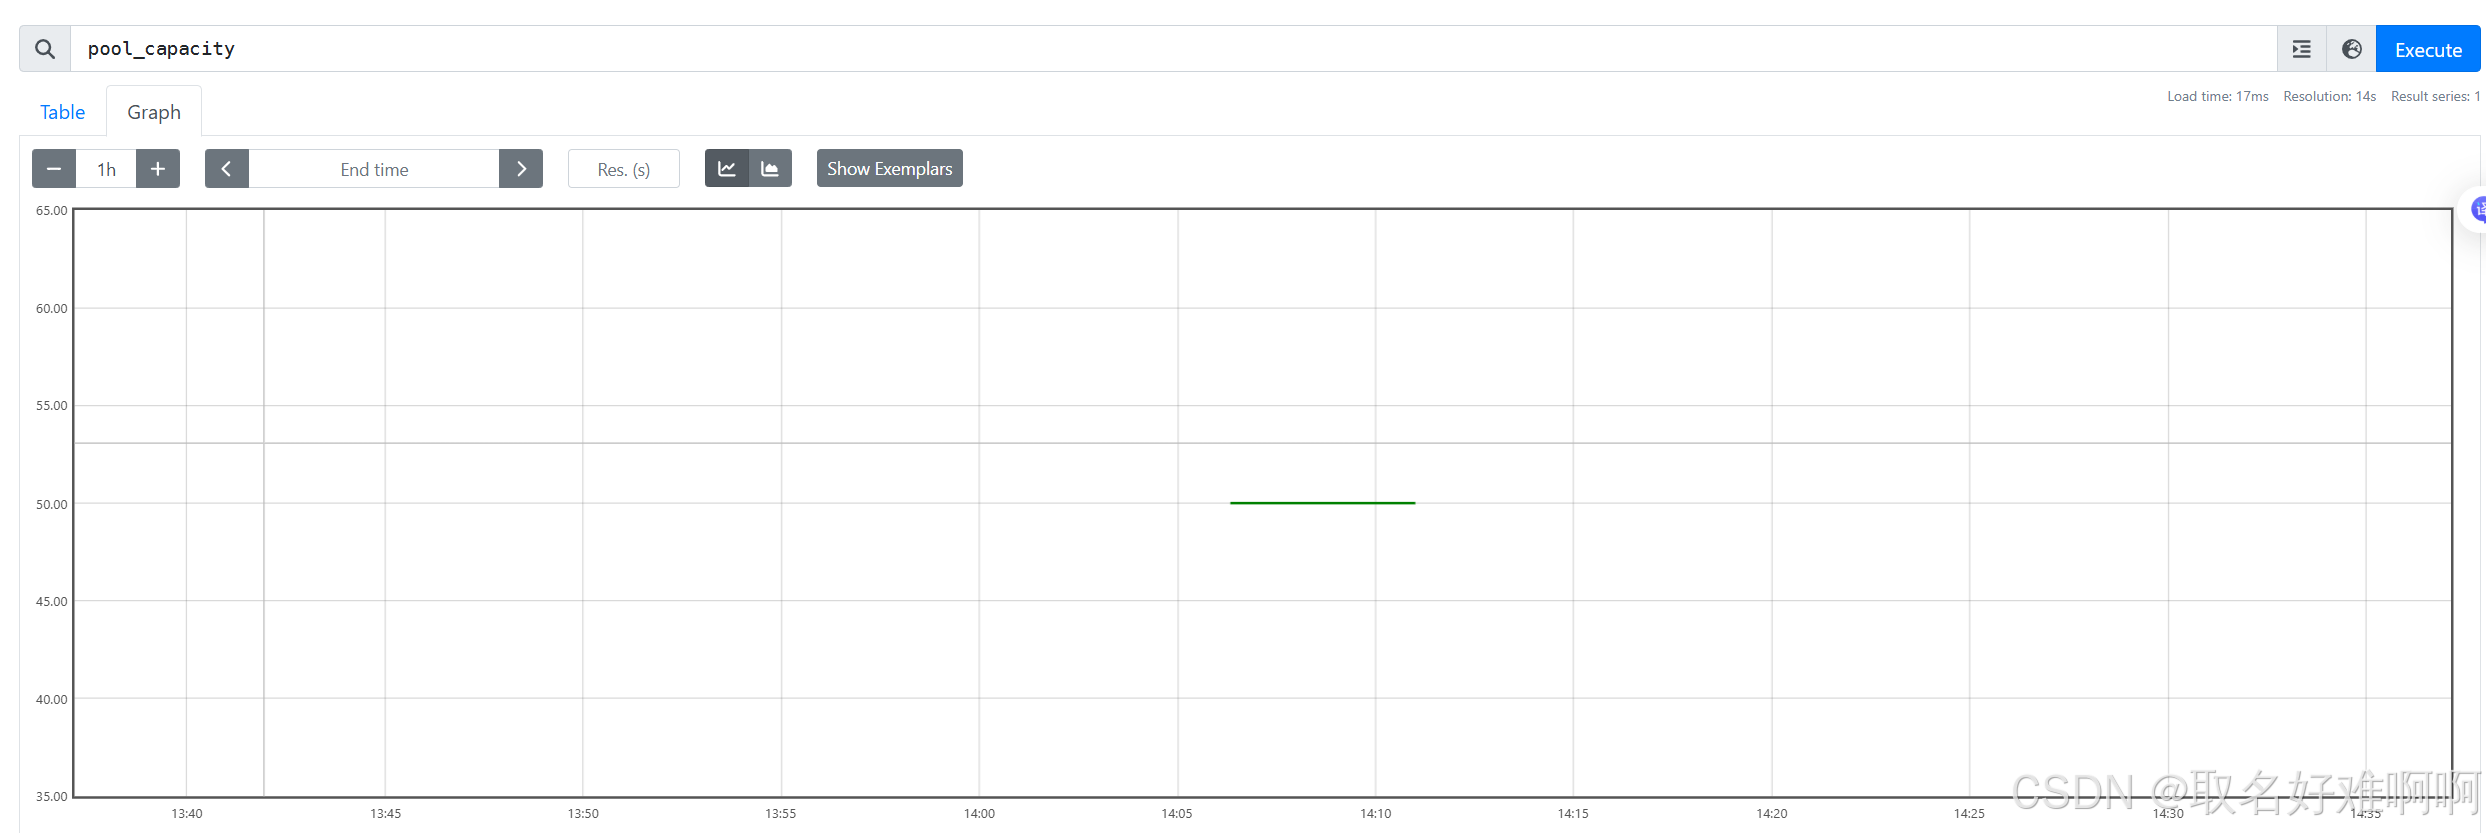
当前协程池的协程容量大小。
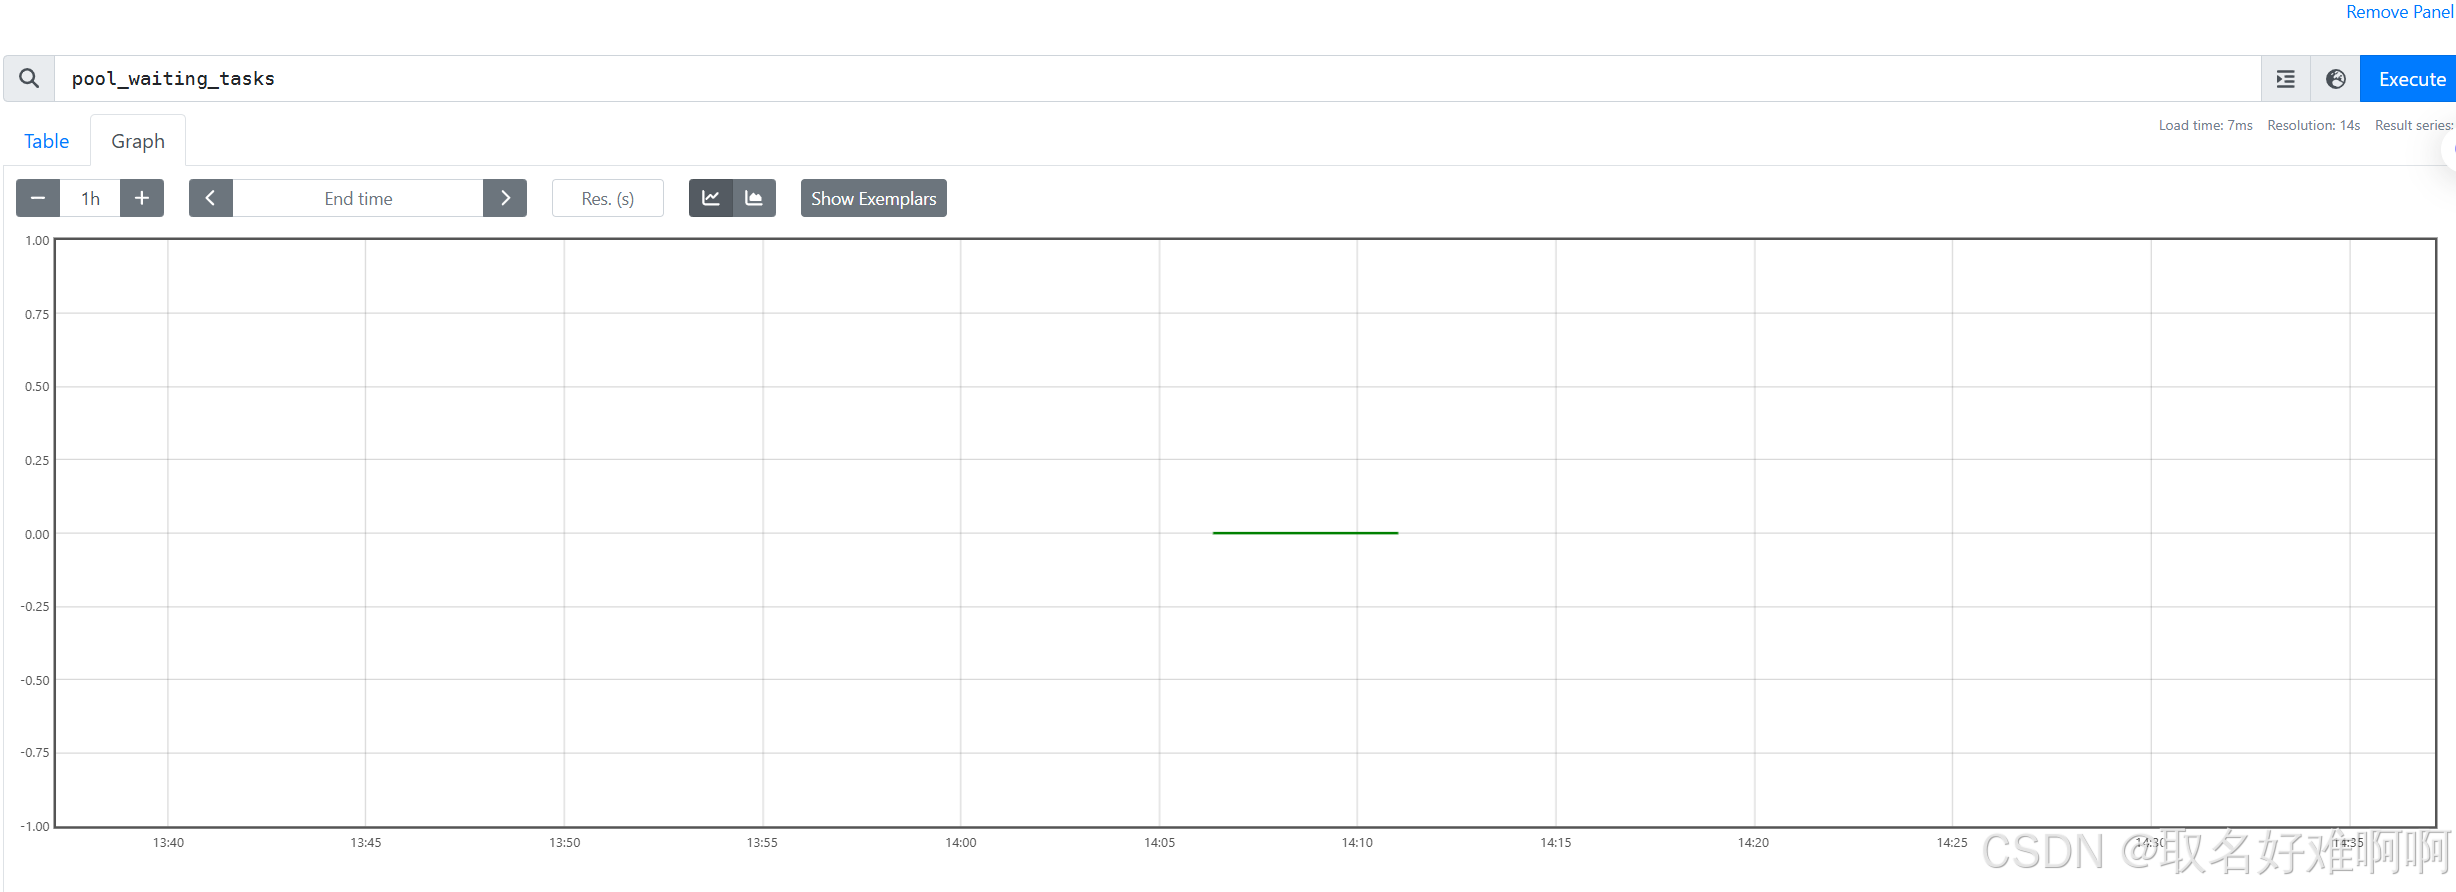
阻塞等待提交的任务数。
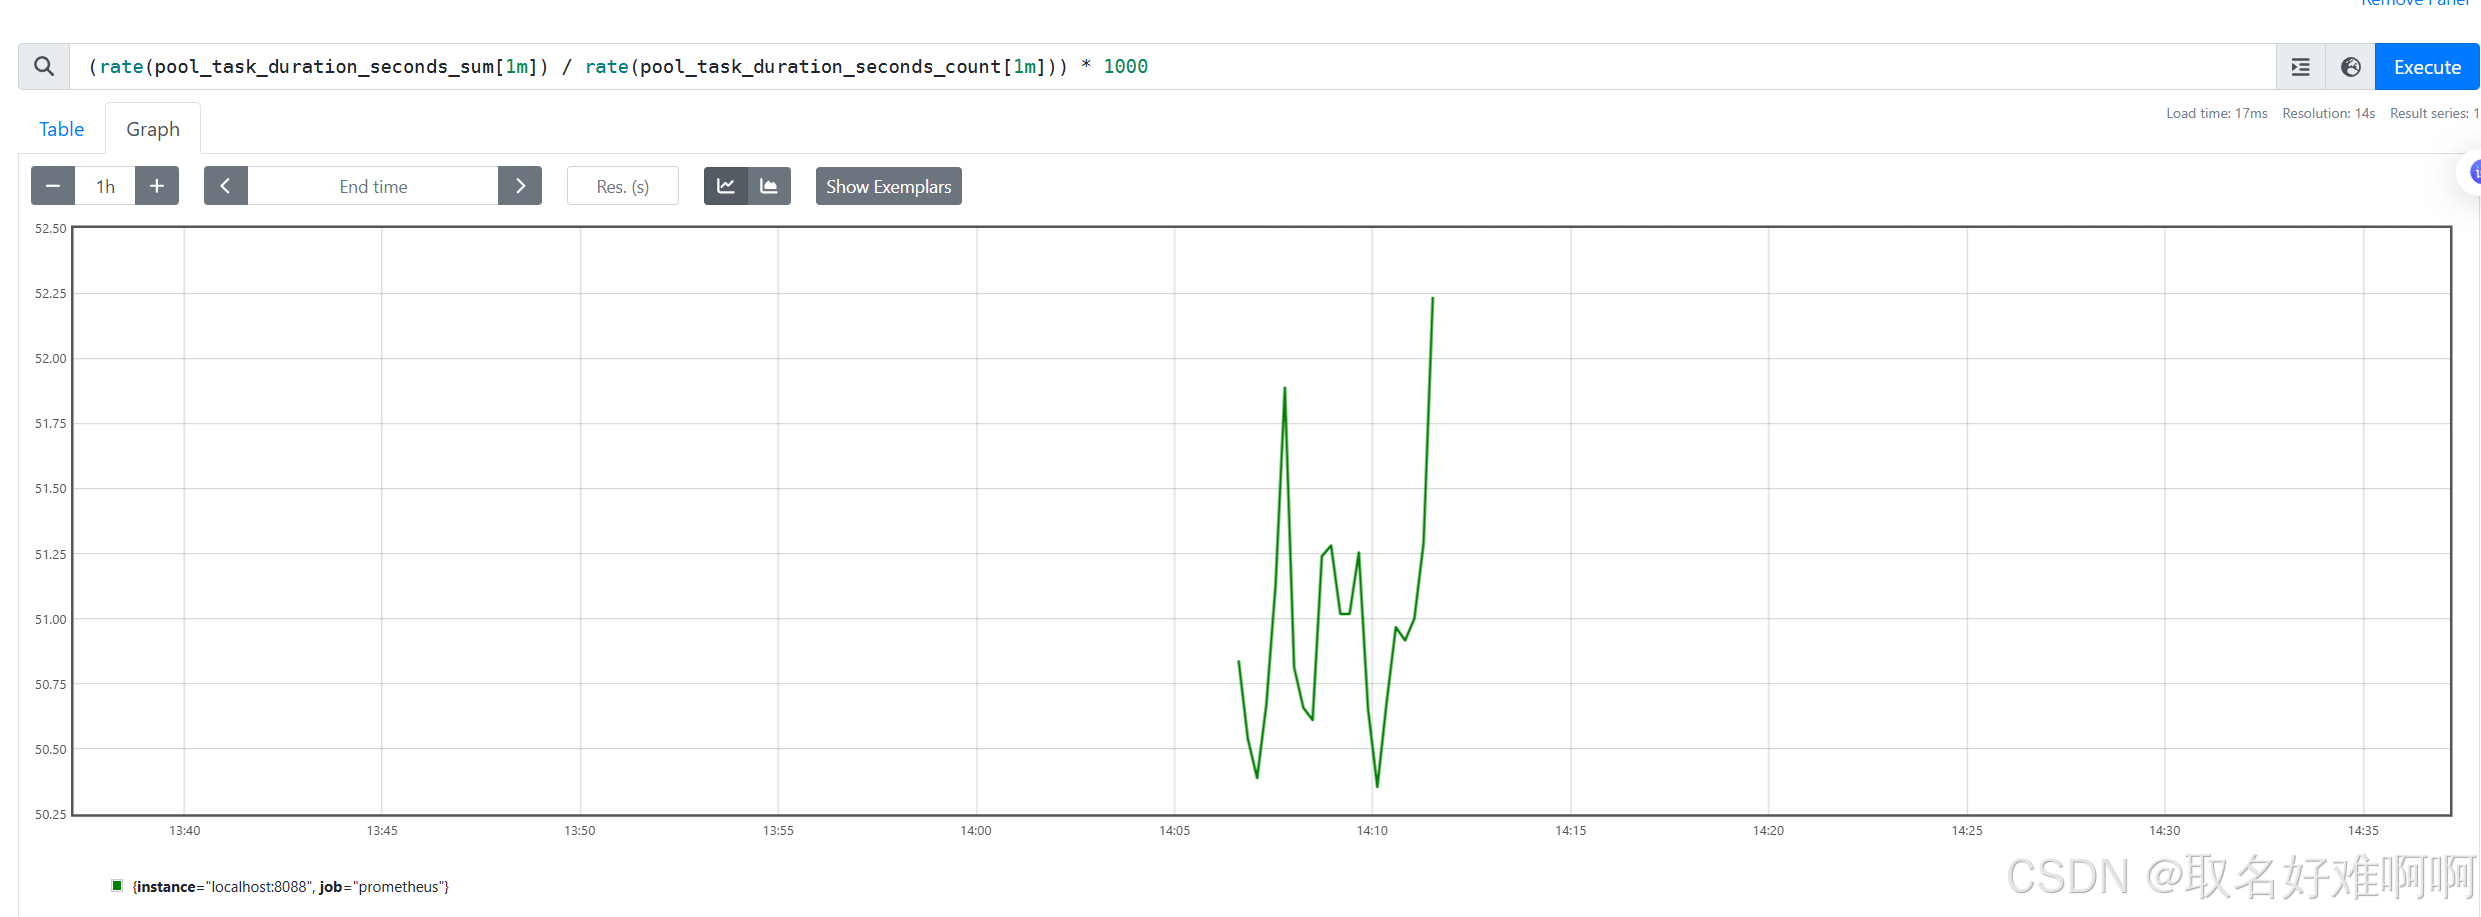
请求平均耗时:(rate(pool_task_duration_seconds_sum1m) / rate(pool_task_duration_seconds_count1m)) * 1000。
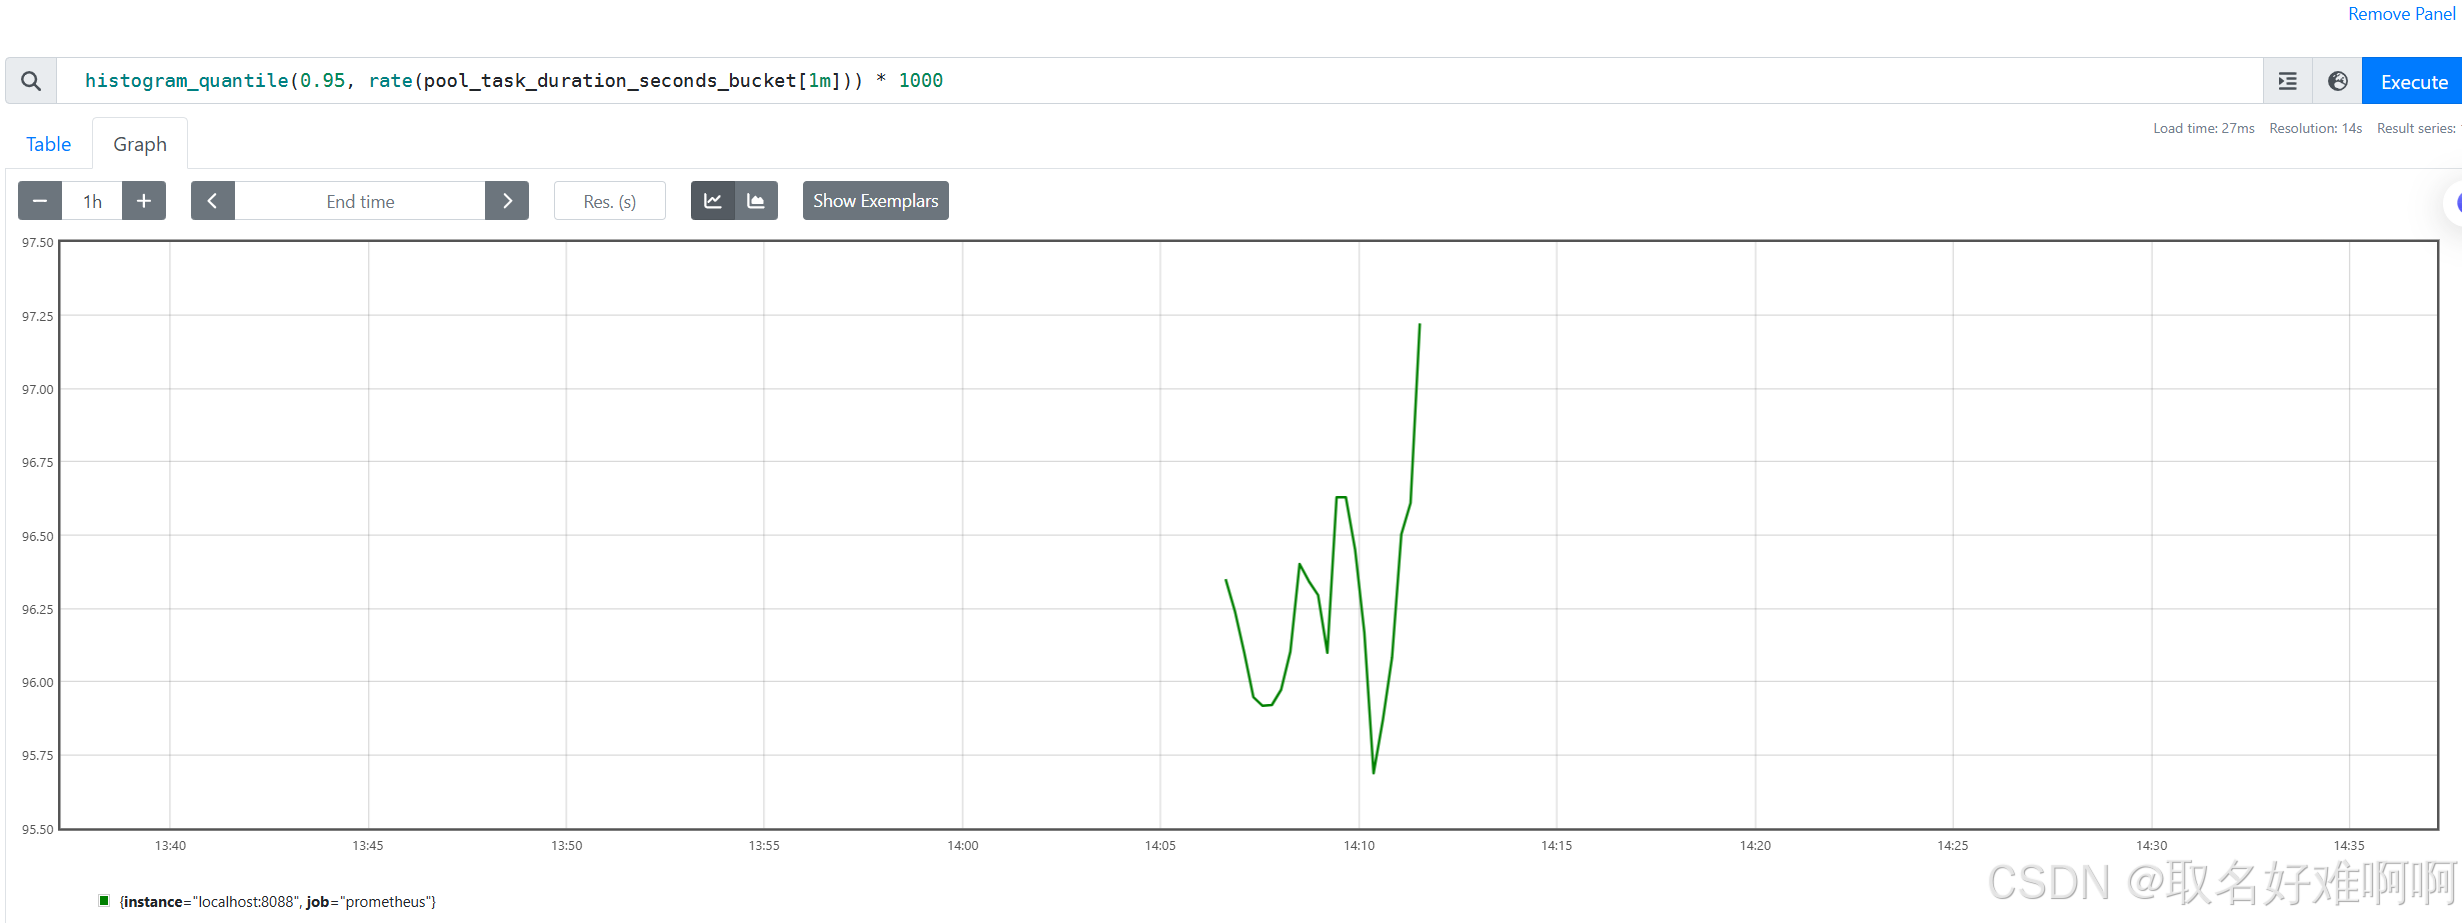
请求 p95 耗时:** histogram_quantile(0.95, rate(pool_task_duration_seconds_bucket1m)) * 1000**。
3. 小结
这篇文章简单学习下 prometheus 协程池监控的时候,核心就是希望通过监控协程池发现运行过程中的性能问题。
如有错误,欢迎指出!!!