摘要
前面我们已经掌握了模型训练、保存最优模型的方法。在训练过程中,学习率是控制模型参数更新幅度最核心的超参数,学习率选择不当,会出现模型收敛慢、震荡不收敛、陷入局部最优等一系列问题。本节我们从梯度与参数更新原理入手,讲解 SGD、Adam 优化器,理解学习率的作用,再介绍 PyTorch 里各类学习率调整策略,并结合实战代码演示如何动态调整学习率。
一、参数怎么更新
**1.**认识梯度
在多元函数中,偏导数 代表固定其他变量,只对其中一个变量求导。举个例子函数 :
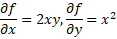
梯度 是由函数全部偏导数组合而成的向量,梯度指向函数值增长最快的方向。我们做优化任务时,需要沿着梯度反方向更新参数,来降低损失函数。
**2.**优化器与梯度下降: SGD 和 Adam
梯度下降是一阶优化算法,也叫最速下降法,目标是找到损失函数的极小值。
学习率(步长):梯度决定更新方向,学习率决定每一步参数更新的幅度。学习率太大,参数更新步子过大,容易在最低点附近来回震荡,无法收敛,甚至损失爆炸;学习率太小,参数更新缓慢,训练耗时极长,很容易困在局部极小值。
|--------------------------------------------|
| 想要找到全局最优解,常用思路:设置多个随机初始点,分别做梯度下降,对比得到的最小值。 |
常用优化器:
SGD (随机梯度下降):每次用单个 batch 数据计算梯度,沿梯度反方向更新权重,收敛稳定,但对学习率敏感,容易卡在局部最优。
Adam:在 SGD 基础上增加动量与自适应学习,能根据梯度变化自动调节更新幅度,收敛速度更快,日常深度学习项目使用最多。
**3.**参数更新公式

 :模型权重参数;
 :学习率;
 :损失函数对权重的偏导(梯度)。
**4.**为什么要调整学习率?
固定不变的学习率很难兼顾训练全过程:
训练初期:参数离最优解很远,大学习率可以快速下降,加快收敛速度。
训练后期:参数靠近最优值,小学习率精细微调权重,避免震荡,收敛到更优的结果。
动态调整学习率,可以帮助模型跳出局部最优,拿到更好的泛化效果。
二、怎么调整学习率
在 PyTorch 中,学习率调度器通过 torch.optim.lr_scheduler 实现,一共分为三大类:有序调整、自适应调整、自定义调整。
**1.**有序调整(按 epoch 预设规则变化)
预先设定好学习率衰减规则,随训练轮数 epoch 自动修改学习率:
StepLR:等间隔衰减,每经过指定轮数乘以衰减系数 gamma。
MultiStepLR:多节点衰减,到达预设 epoch 节点才衰减。
ExponentialLR:指数衰减,每一轮学习率都乘 gamma,即
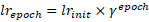
CosineAnnealingLR:余弦退火,学习率按余弦曲线周期性升降,帮助跳出局部极小。
四种有序调度策略的 学习率 曲线对比:
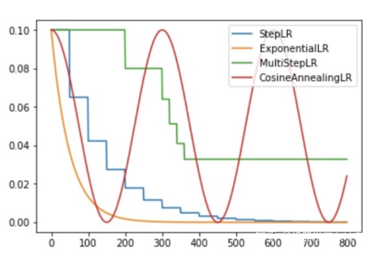
StepLR、MultiStepLR、ExponentialLR、CosineAnnealingLR 学习率随迭代步数的变化曲线
**2.**自适应调整(根据训练指标动态判断)
ReduceLROnPlateau:监测 loss 或者 accuracy 这类指标,当指标长时间不再改善时,自动降低学习率。适合不知道该设置什么衰减周期的场景。
**3.**自定义调整
LambdaLR:自定义 lambda 函数,自己编写学习率随 epoch 变化的逻辑,灵活性最高。
三、各调度器核心代码
|--------------------------------------------------------|
| 下面片段均以已经定义好 optimizer 为前提,只保留调度器定义与调用部分,不含数据集、模型与训练循环。 |
1. StepLR****等间隔调整
python
#每 3 个 epoch,学习率 × 0.5
# 每3个epoch,学习率 × 0.5
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=3, gamma=0.5)
# 每个epoch训练结束后执行
scheduler.step()
参数说明:
step_size:每隔多少轮 epoch 学习率衰减一次。
gamma:衰减系数,每 step_size 轮学习率乘以 gamma。
last_epoch:起始 epoch 编号,默认 -1(训练前初始阶段)。
2. MultiStepLR****多节点衰减
python
#在指定 epoch 节点衰减
# 在第3、7轮epoch时,学习率 ×0.5
scheduler = torch.optim.lr_scheduler.MultiStepLR(optimizer, milestones=[3,7], gamma=0.5)
# 每个epoch训练结束后执行
参数说明:
milestones:衰减发生的 epoch 节点列表,只有到达这些轮次才触发衰减。
gamma:衰减系数,到达里程碑节点时学习率乘以 gamma。
3. ExponentialLR****指数衰减
python
#每一轮学习率都乘以 gamma
# 每1个epoch,学习率 ×0.9
scheduler = torch.optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.9)
# 每个epoch训练结束后执行
参数说明:
gamma:衰减系数,每一轮 epoch 学习率都会乘以 gamma(指数级衰减)。
4. CosineAnnealingLR****余弦退火
python
#按余弦曲线周期性调整学习率
# T_max:余弦周期,这里设置10轮为一个周期
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=10)
# 每个epoch训练结束后执行
scheduler.step()
参数说明:
T_max:一个余弦周期包含的 epoch 数,学习率在一个周期内从初始值降到 eta_min 再回升。
eta_min:学习率的最小值,默认 0。
last_epoch:起始 epoch,默认 -1。
5. ReduceLROnPlateau****自适应调整
python
#监控 loss,长时间不下降再衰减
# loss连续3轮不下降,学习率乘以0.5
scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(optimizer, mode='min', factor=0.5, patience=3)
# 传入验证集loss,放在epoch末尾
参数说明:
mode :监控指标的最优方向,min 表示指标越小越好(如 loss),max 表示越大越好(如 accuracy)。
factor:触发衰减时学习率乘以的系数。
patience:指标连续多少轮不再改善才触发衰减。
cooldown:衰减后等待多少轮才能再次触发衰减。
min_lr:学习率的下限,防止降到过低。
threshold:判断指标是否「改善」的阈值,改善幅度小于它视为未改善。
附:早停****Early Stopping
早停 (Early Stopping)是一种防止过拟合的训练技巧:训练过程中持续监控验证集指标,当指标连续多轮不再改善时,提前终止训练,并保留此前指标最好的模型权重。
它与 ReduceLROnPlateau 的区别:ReduceLROnPlateau 指标停滞时只是降低学习率继续训练 ,而早停是直接停止训练,避免模型在训练集上继续过拟合。
python
#早停实现示例
best_acc = 0
patience = 5          # 连续5轮无改善就停止
no_improve = 0

for epoch in range(epochs):
    train(model, train_dataloader)
    acc = test(model, test_dataloader)

    if acc > best_acc:          # 指标刷新,重置计数并保存最优模型
        best_acc = acc
        torch.save(model.state_dict(), "./best.pth")
        no_improve = 0
    else:                       # 指标未改善,计数 +1
        no_improve += 1
        if no_improve >= patience:
            print("触发早停,停止训练")
6. LambdaLR****自定义学习率
python
#前 5 轮不变,之后线性衰减
# 自定义函数:前5轮lr不变,之后线性衰减
def lr_lambda(epoch):
    if epoch < 5:
        return 1.0
    else:
        return 1.0 * (10 - epoch) / 5

scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda=lr_lambda)
# 每个epoch训练结束后执行
scheduler.step()
参数说明:
lr_lambda:自定义函数,输入当前 epoch,返回该轮学习率的倍率(乘数),控制学习率随 epoch 变化。
总结
- 学习率控制参数更新幅度,固定学习率很难适配训练全周期,动态调度是提升模型效果的常用手段。
- StepLR、MultiStepLR、ExponentialLR、CosineAnnealingLR 属于预设规则调度,适合提前规划好训练轮次的场景;ReduceLROnPlateau 根据验证指标自动调整,更灵活。
- 余弦退火可以周期性重启学习率,帮助模型跳出局部极小;指数衰减下降速度快,适合短周期训练。
- 早停(Early Stopping)和 ReduceLROnPlateau 经常搭配使用,一个控制是否停止训练,一个动态调整学习率,共同抑制过拟合,拿到最优模型