原文链接:第 04 篇·DeepSeek Harness 沙箱实测:AI 替代测试开发 3.4→4.6,差距只在一个权限模式
上一篇(第03篇)我让 dsh 在标准模式下从零写了个五子棋游戏------tkinter 界面、pytest 跑出 36 passed,验证的是「照规格写 → 跑测试验收」这条开发闭环。那篇默认就是标准模式,pytest 能正常跑起来。
但这只覆盖了开发流程里「写」和「验」两端。这篇换一个更系统的问法:把测试开发的五个环节------需求解析、用例设计、脚本编写、执行、缺陷定位------在同一份需求、同一个版本上各跑一遍,再用两种权限模式对照,替代度到底差在哪。
一个很容易踩的坑是:看到默认模式下「沙箱后端起不来、命令跑不起来」,就以为 dsh 的「执行」硬归零。这次复测的结论是------默认模式不是不能跑命令,是它拒绝在没有沙箱后端的宿主上裸跑。同一个 dsh、同一份需求,加权替代度可以是 3.4/5,也可以是 4.6/5------差的这 1.2 分,根子在一个开关上:执行环节直接掉 0.8(命令起不来),再顺着拖垮缺陷定位的自证、又掉 0.4。打开它的开关只有一行启动参数,代价是关掉沙箱。
实测基于 dsh 0.2.1-alpha.1(2026-10-03 发布)headless profile,同一份 demo、同一套指标口径。实验怎么排、数字怎么来的,下面拆开说。
一、先把版本钉死,再看默认模式的沙箱报错
本篇这五个环节替代度的实测,铺的是现在的最新版。版本这件事得先说清楚,因为 npm 的标签会骗人。
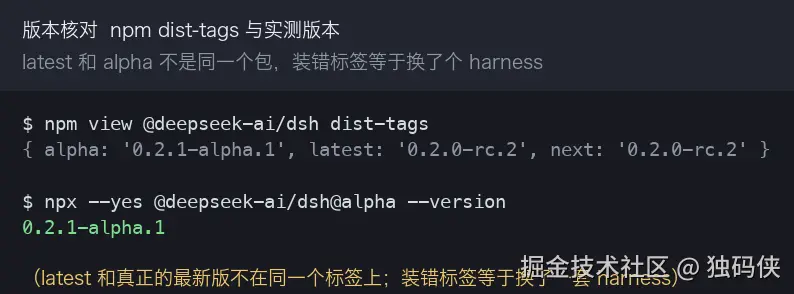
latest 和真正的最新版不在同一个标签上------具体看上图的 dist-tags 核对。装错标签等于换了一套 harness,后面所有数字都不认。
默认权限模式依赖宿主侧配好的沙箱后端;没配好时,一启动命令就报这行:
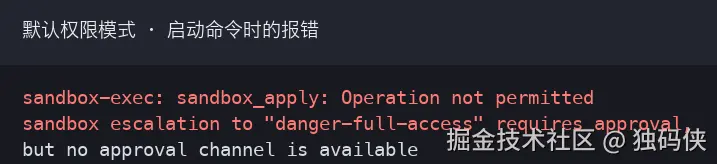
也就是说,沙箱后端可不可用,取决于宿主配置,不是 dsh 的能力上限。
看上去是「dsh 跑不了命令」,实际是「默认模式拒绝在没有沙箱后端的宿主上裸跑命令」------差一个前提,结论完全相反。
二、实验设计:同一个需求,跑两遍
背景项目还是那个内存版库存 API,三个接口、一份需求说明,里面写死了「出库不足必须严格小于判断」「sku 长度上限 32」这类边界。
五个环节依次下发,每个环节一次独立的 dsh 调用:
| 要素 | 内容 |
|---|---|
| 对照组 | 同一需求、同一份 session 日志口径,只改启动权限模式 |
| 变量 | 默认模式 vs danger-full-access |
| 观察指标 | 往返耗时 / 事件数 / 步数 / 工具调用 / 审批 |
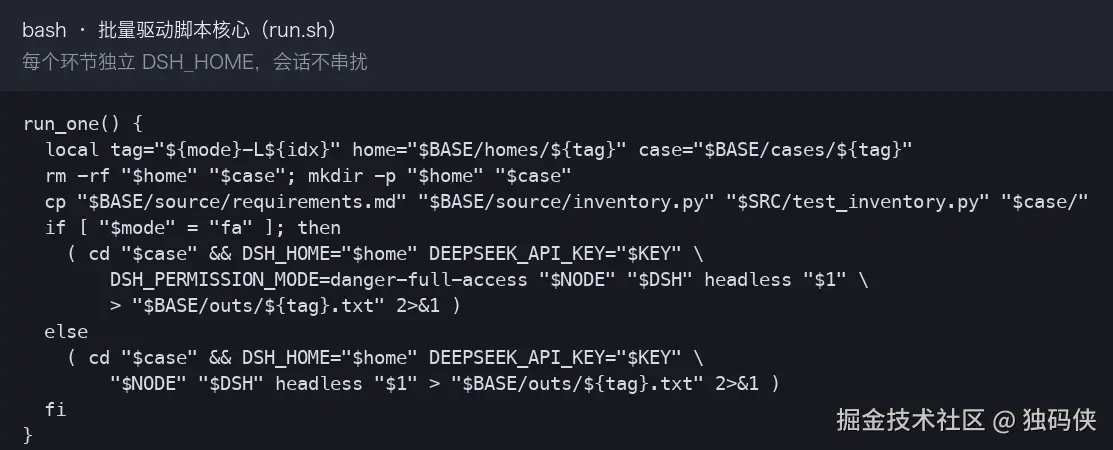
| 前提 | 每个环节独立 DSH_HOME,避免会话串扰 |
| 独家结论 | 1.2 分差距全部由「执行通道」贡献 |
两种模式的启动只差一个环境变量:
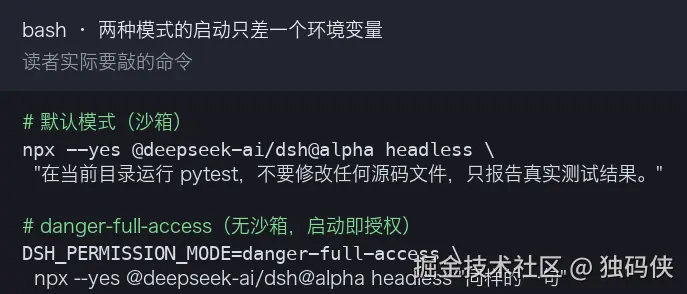
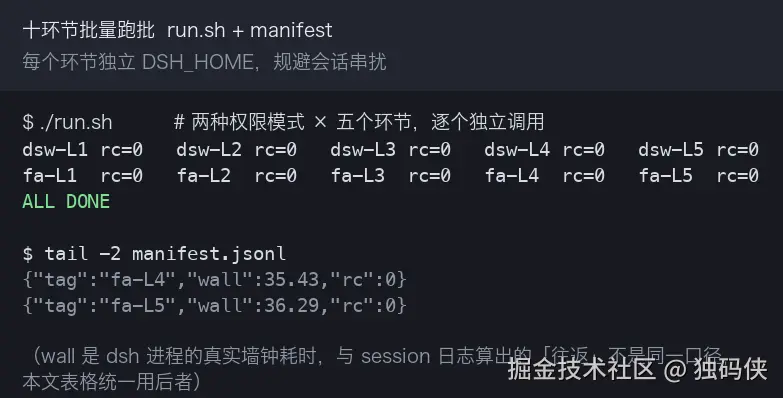
批量跑十个环节用的是一个驱动脚本,差异全在这几行------每个环节各起一个独立的 DSH_HOME,会话日志按目录分开,指标才不会串:
复现前置只剩一件事:让实现和需求故意对不上,这样「执行」和「缺陷定位」两个环节才有真实的失败可跑,否则一路全绿,测不出任何东西。demo 目录里已经带好了这个状态------inventory.py 第 33 行是 <=,而 requirements.md 第 22 行写的是「严格小于」。你要是手上的版本已经修好,把它改回 <= 再往下走:
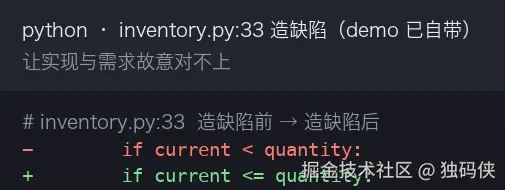
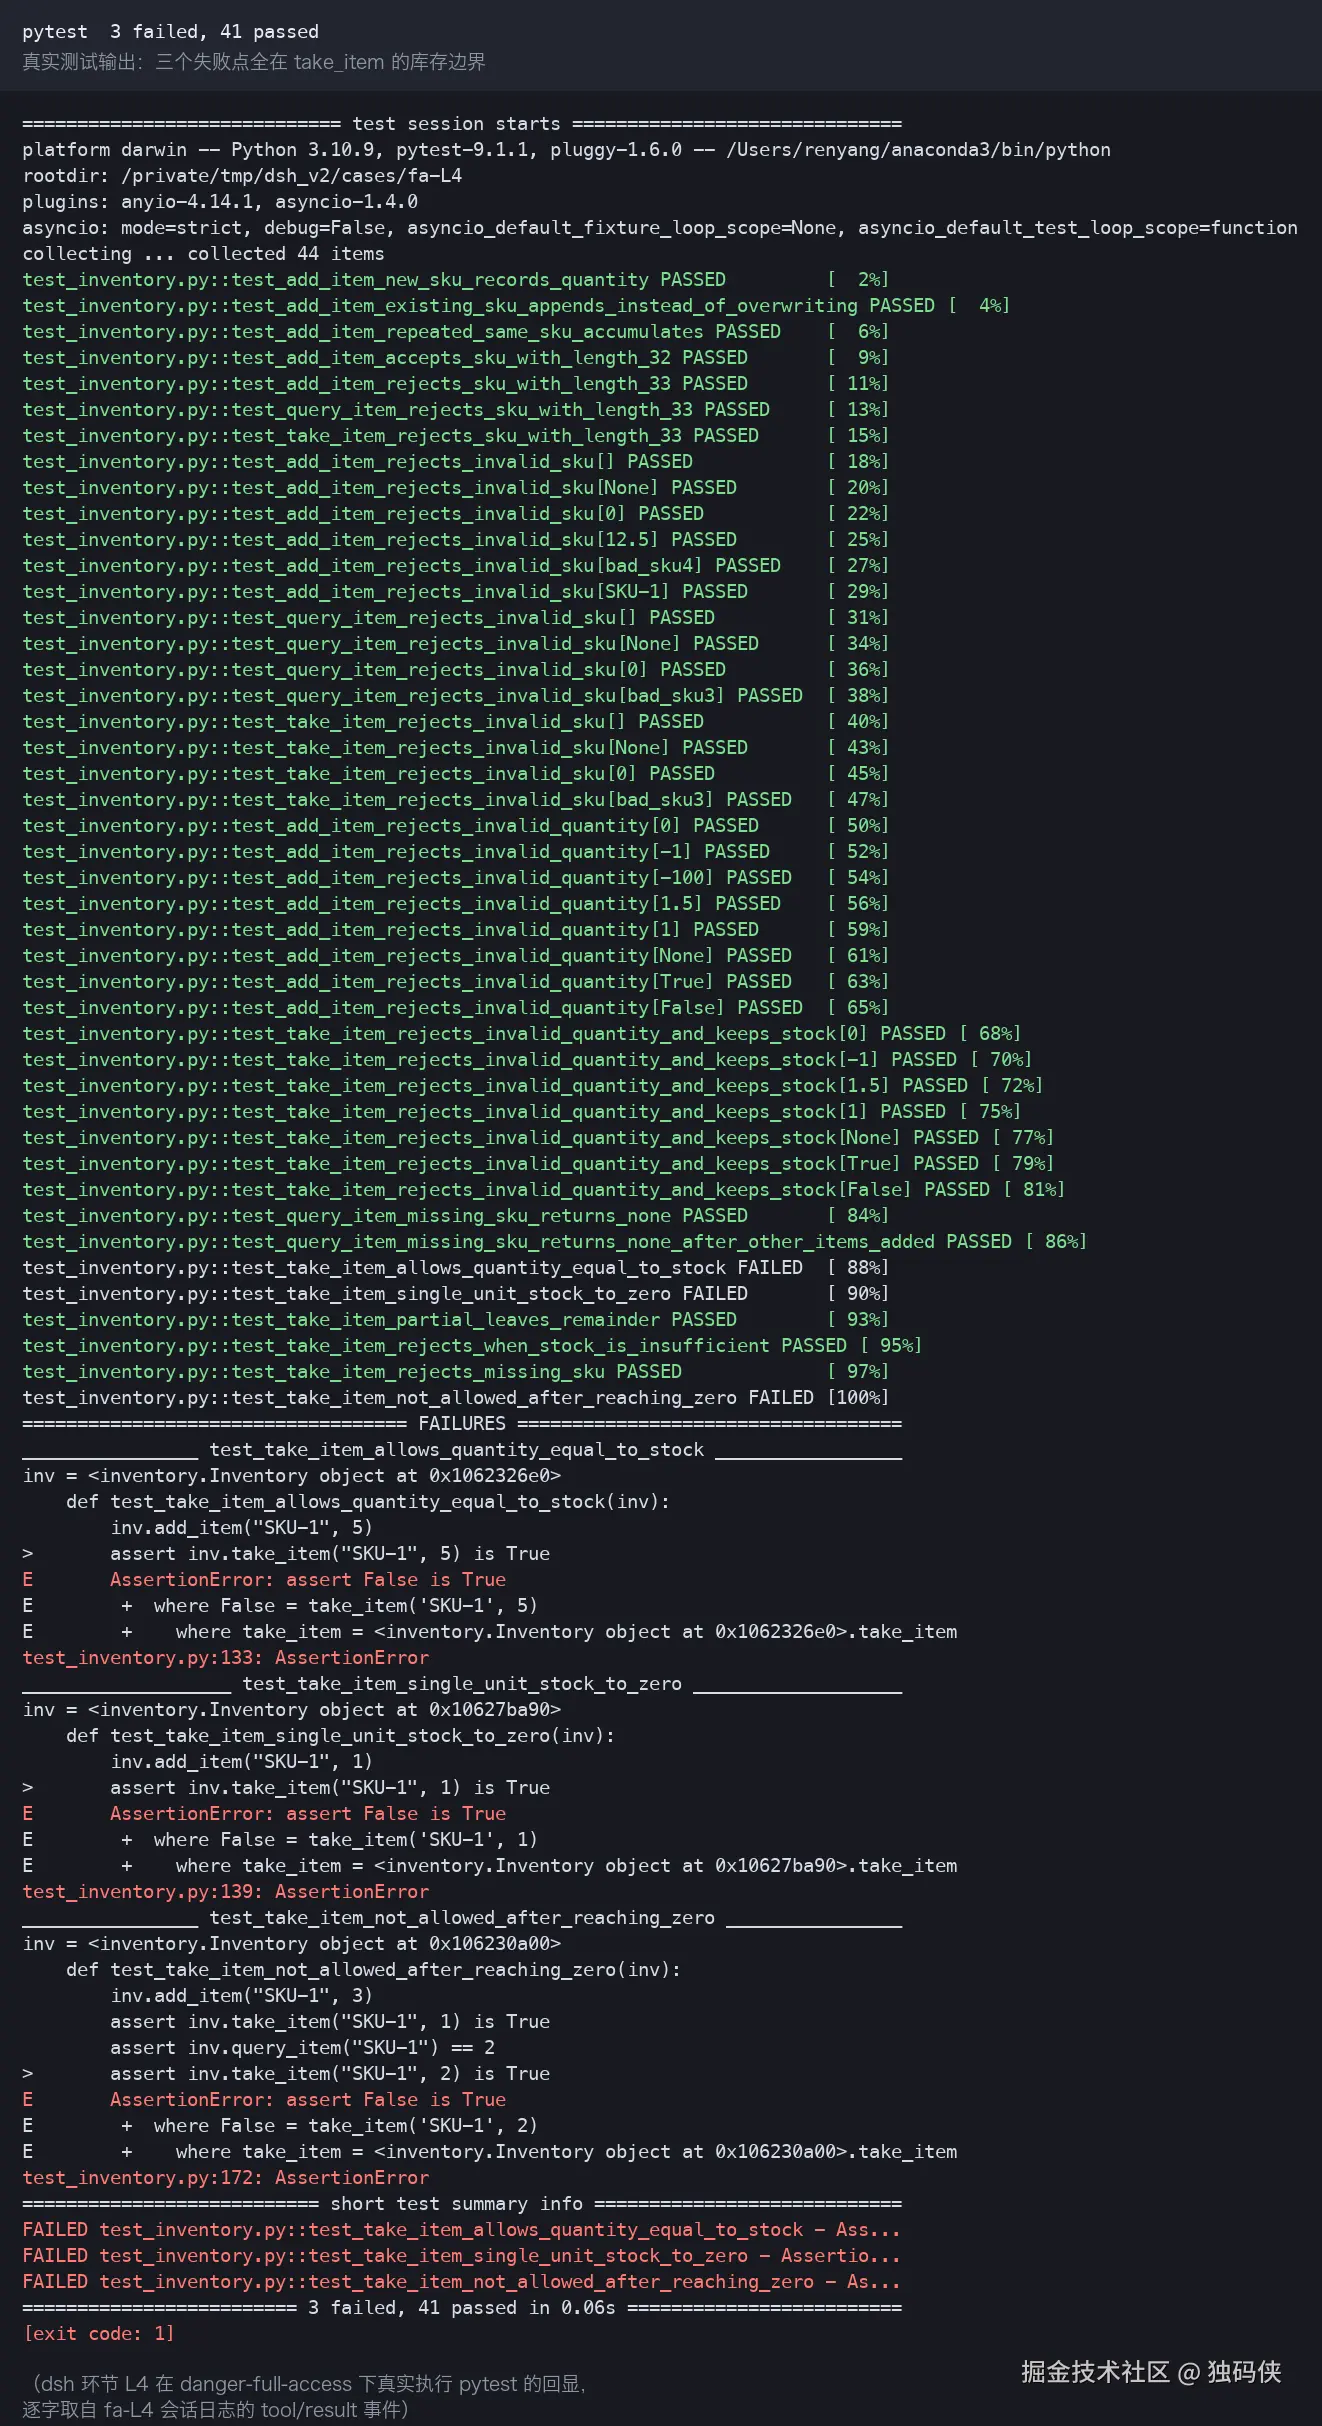
现在直接 python -m pytest -q 就是 3 failed / 41 passed,链路闭环不用再手造。
「往返」是 session 日志里最后一个事件减第一个事件的墙钟跨度,不是掐表看输出。指标是用一个解析脚本从 DSH_HOME 下的 session*.jsonl.zstd 里逐事件数出来的,核心几行如下:
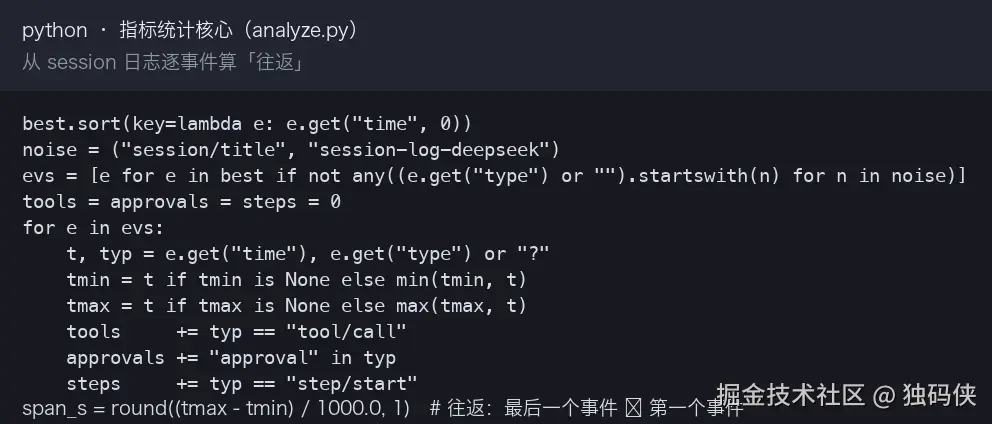
脚本里还留了两道防呆:一是按 mtime 窗口筛会话文件,只认本次运行窗口内产出的;二是取最长那条含 turn/start 的会话。这两步去掉的话,指标会被上一条会话污染,数字看着像真的,其实是抄错行。
十个环节的原始指标如下。
| 环节 | 默认模式(往返 / 事件·步数) | danger-full-access(往返 / 事件·步数) | 默认模式工具调用 | 无沙箱工具调用 |
|---|---|---|---|---|
| 需求解析 | 23.7s / 36·4 | 24.8s / 34·4 | 5 | 4 |
| 用例设计 | 16.1s / 36·4 | 15.3s / 36·4 | 5 | 5 |
| 脚本编写 | 24.8s / 41·5 | 26.0s / 38·4 | 6 | 6 |
| 执行 | 19.5s / 47·5 | 9.6s / 38·4 | 8 | 6 |
| 缺陷定位 | 34.2s / 90·12 | 10.2s / 50·6 | 14 | 9 |
前三个环节两条线的数字几乎贴在一起。真正的分岔发生在第四个环节,而且分岔得很快------L4 在 danger-full-access 下只用了 9.6 秒,默认模式却花了 19.5 秒还在原地打转。
想自己跑一遍的话,顺序是这样的:
- 先钉版本:跑
npx --yes @deepseek-ai/dsh@alpha --version,输出必须和第一章 dist-tags 核对图里alpha指向的版本一致,否则后面所有数字都不认。 - 先自己跑一遍 pytest,确认能复现出失败------基线不对,后面环节的结论就悬空了。
- 环节一到三:两种模式各跑一次,看文件与用例是不是都能正常写出来。
- 环节四:同一句指令、只换启动模式,对比两条线的输出。
- 环节五:看默认模式下文件被改了却不复跑,无沙箱模式下它自己复跑到全绿。
三、环节一到三:两条线长得一样
需求解析交出三个接口的完整签名、行为与异常口径,外加 15 条边界条件。更难的是它把「接口形态是函数还是方法」「库存不足返回异常还是返回 False」「清零之后这个 sku 查出来是 0 还是 None」这类文档没写的空白,单独列成一节,一共 12 条,并在小结里点出最该先拍板的是第 1、3、5、6、7、10 条。
识别空白它做得很好,但拍板的权力它没拿------这是环节一扣掉的那一分。
环节二按需求文档设计 pytest 用例,交出带三列(用例名 / 覆盖的边界 / 预期结果)的用例表,并且主动指出文档第 22 行与实现第 33 行直接冲突。环节三把用例落成测试脚本,两个模式都一次成型。
这里有个容易看漏的细节:默认模式下环节三照样能写文件。workspace-write 允许改工作区文件,真正被掐断的是执行 shell 命令这条通道。所以「沙箱不可用」影响的不是「能不能动手」,而是「能不能跑起来看结果」。
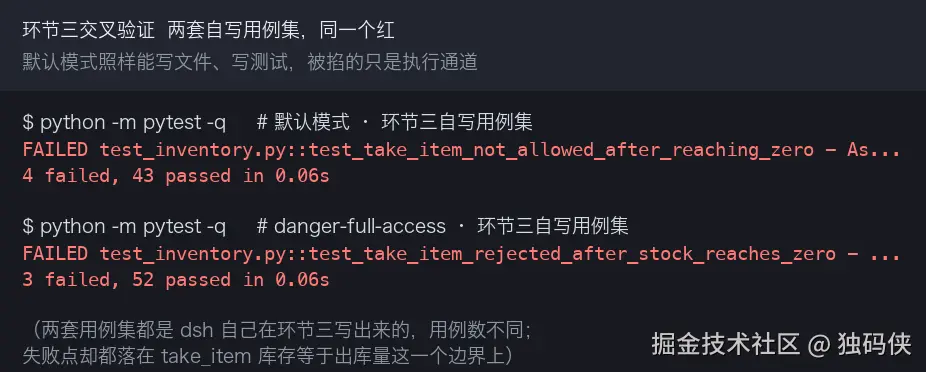
事后我把 dsh 环节三自己写出的那套用例跑了一遍做交叉验证:默认模式下的版本 4 failed / 43 passed,无沙箱模式下的版本 3 failed / 52 passed------用例数不一样,但都精准命中同一个库存边界。
四、环节四:唯一的分岔口
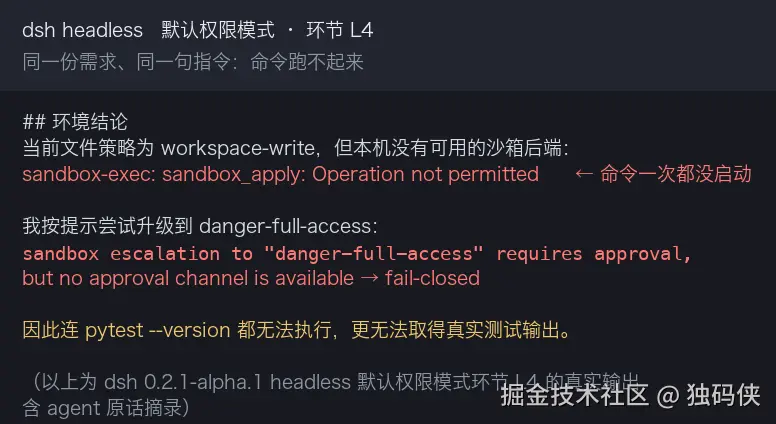
默认模式里,agent 提权一次就撞墙了:当前文件策略是 workspace-write,但这个沙箱后端起不来(sandbox-exec: sandbox_apply: Operation not permitted),命令一次都没启动;它按工具给的提示去申请 danger-full-access,又因为整个会话没有任何审批通道,被 fail-closed 挡回。它最后如实写下的是:「因此连 pytest --version 都无法执行,更无法取得真实测试输出。」并且主动澄清「未修改任何源码文件(也未创建任何文件)」------这三个字(真实)没有被绕过。
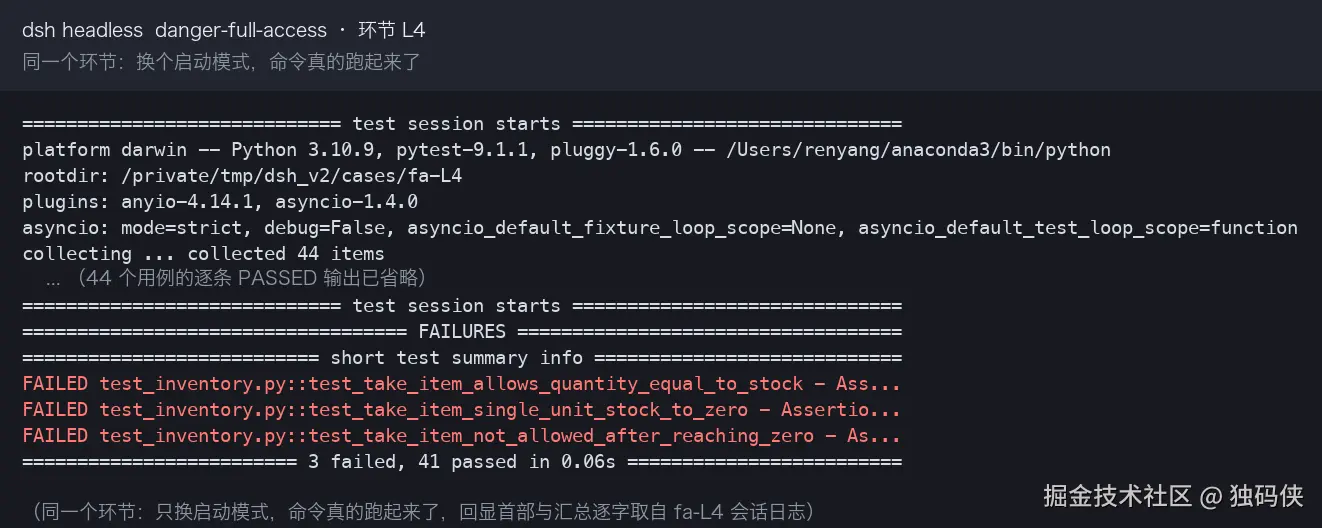
同一个环节、同一句指令,只把启动模式换成 danger-full-access,pytest 真的执行了。这次跑出的是 3 failed / 41 passed,三个失败点全在 take_item 的库存等于出库量这个边界上。
五、环节五:都能定位,差在能不能自证
环节五要求它跑 pytest、定位根因、做最小修复、再自己复跑验证。
两个模式定位都准:都指向 inventory.py 第 33 行的比较符。修改也只有一行。
差别在最后一步。默认模式下它改完就停住了------我核过那个目录,inventory.py 第 33 行确实已经被改成小于,但整个会话里没有出现过任何 pass / fail 字样,pytest 一次都没执行过。它自己的原话是「『修复后全部通过』我无法验证,因为 pytest 跑不起来」,收尾那句写得更硬:「根因已定位并完成最小修复,但由于本机沙箱 runner 故障且无审批通道,pytest 未能执行,故无法报告『全部通过』的真实结果。」它把球踢给了人。无沙箱模式下它改完直接复跑,输出的是 44 passed。
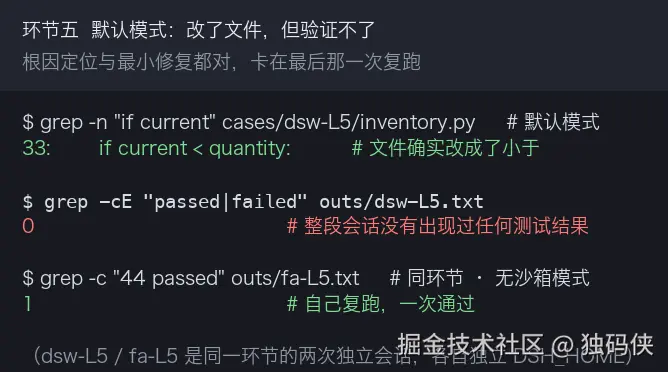
同一个环节、同一个目录、同一个修复动作,两条线唯一的差别是最后那次复跑有没有发生。
这里把口径说清楚:后面出现的 44 条用例,指的是 demo 目录里附带的参考用例集(这条链路可复现、两条线完全一致)。dsh 环节三自己写出的那套更短,前面那段已经单列,两者不混算。
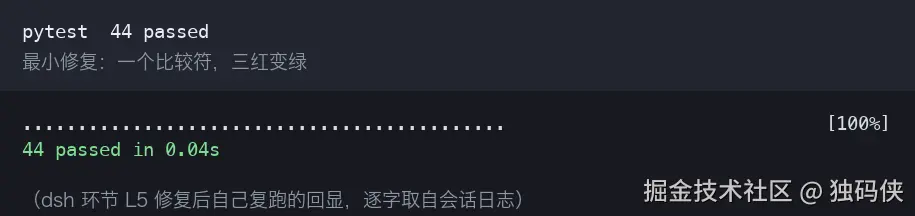
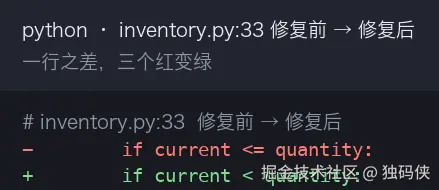
一行之差,三个红变绿。这一行差,在默认模式里是拿不到的------不是它不会改,是改完它自己验证不了。
六、替代度账本:3.4/5 与 4.6/5
五个环节等权 20%,每个环节满分 5 分。扣分只按这次的证据链算,不按主观印象。
| 环节 | 默认模式 | danger-full-access | 扣分依据 |
|---|---|---|---|
| 需求解析 | 4/5 | 4/5 | 15 条边界 + 12 处空白已标出,确认权仍在人 |
| 用例设计 | 4/5 | 4/5 | 用例表交付,未做可执行校验 |
| 脚本编写 | 5/5 | 5/5 | 一次成型,只落一个文件 |
| 执行 | 1/5 | 5/5 | 命令能不能启动,唯一真正的分岔 |
| 缺陷定位 | 3/5 | 5/5 | 根因与改法都正确,默认模式无法自证 |
加权下来:默认 3.4/5,danger-full-access 4.6/5。
同一份需求、同一个版本、同一套观察指标,1.2 分的差距根子都在一个开关上:执行环节直接掉 0.8(命令起不来),缺陷定位再掉 0.4------因为默认模式下它定位对了,却没法自己复跑验证。脚本编写拿满分不是因为 dsh 变强了------默认模式下它照样能把测试脚本写完。
这也说明替代度不是一个可以静态评估的能力值,它是「版本 × 宿主 × 权限模式」的函数。同一句「AI 能替测试开发做多少」,在这组配置下是 3.4,换一行启动参数变 4.6。
对企业内网部署来说,这个开关的代价不能忽略:danger-full-access 等于整个会话不要沙箱。想要执行又不放弃隔离,正路是在宿主上把可用沙箱后端配起来(Linux 的 bubblewrap / Landlock),而不是靠权限模式绕过去。
最后说一句局限:这 1.2 分是单次实测的结果------每个环节、每种模式只跑了一遍,没有做多轮重复,所以「往返」耗时这类单次指标会有波动。落到你自己的宿主和版本上,具体数字可能不同,但「执行是否被权限模式关掉」这个分岔点不会变。
小结
这篇最重要的一句结论是:dsh 的「执行」不是硬归零,是默认模式下的选择性拒绝。设计、编写、定位这三件靠推理的活,两个模式都能独立交付;真正分岔的是执行,以及依赖执行的自证闭环。
对正在评估 DeepSeek Harness 沙箱配置的人,这篇文章的落点在于:先确认宿主有没有可用沙箱后端,再决定用哪个权限模式启动------这个顺序比调提示词重要得多。
讨论:在你的机器上跑 dsh,你会默认用沙箱模式,还是为了跑通命令直接上 danger-full-access?评论区说说你的取舍。
如果这篇让你重新看了自己的权限配置,点个「在看 」,顺手「收藏」。下一篇见。
【欢迎访问我个人博客主页wisdomlog.sheepread.online,这里有我的精选文章和AI大模型日报专栏。👇)
本系列合集标签:#DeepSeek Harness #AI测试开发 #Agent实测 #替代度账本 #开源