我不会起名字322 · 后端 / 算法 / 数据库
文章目录
- [RAG 召回不准到底该改哪一环?切片、检索器、重排的 25 题实测与 6 步排查表](#RAG 召回不准到底该改哪一环?切片、检索器、重排的 25 题实测与 6 步排查表)
-
- [一、先看 3 条结论与 2 个反直觉数字](#一、先看 3 条结论与 2 个反直觉数字)
- [二、实测设置:13 篇语料、25 道题、1 条判分规则](#二、实测设置:13 篇语料、25 道题、1 条判分规则)
- [三、主结果:切片大小 × 检索器 × 召回率(向量用中文模型 bge-m3)](#三、主结果:切片大小 × 检索器 × 召回率(向量用中文模型 bge-m3))
- [四、成本那一栏比召回率更要紧:3.9 倍差距](#四、成本那一栏比召回率更要紧:3.9 倍差距)
- [五、两个 embedding 模型的对照:0.28 vs 0.72](#五、两个 embedding 模型的对照:0.28 vs 0.72)
- 六、向量检索塌缩:现象、已排除的原因、以及我还没证实的猜测
- [七、6 步排查表:召回不准时按顺序查](#七、6 步排查表:召回不准时按顺序查)
- [八、3 段可直接复现的脚本](#八、3 段可直接复现的脚本)
- [九、让评测结果可信的 3 件小事](#九、让评测结果可信的 3 件小事)
- [十、25 道评测题长什么样(节选 12 题)](#十、25 道评测题长什么样(节选 12 题))
- [十一、把这套评测接进发版流程:3 条红线](#十一、把这套评测接进发版流程:3 条红线)
RAG 召回不准到底该改哪一环?切片、检索器、重排的 25 题实测与 6 步排查表
我先给结论:90% 的"召回不准"不是模型不行,是切片大小和评测口径的问题。 我在本地用 13 篇技术笔记、25 道中文问题做了一整轮对照,结论有三条:① 512 字符切片是拐点 ------中文向量 + 关键词融合能到 recall@1 = 0.84,比纯 BM25 的 0.76 高 8 个点;② 切片调到 1024 时,中文向量模型塌缩到 0.08 (25 个问题只剩 4~6 个不同的 top-1,我原以为是输入被截断,实验把它否掉了,见第六节);③ 拿到同一个答案要喂进模型的字符数从 1,243 涨到 4,902,召回率的提升是拿上下文成本换的。
下面每个数字都能复现:语料、25 道评测题、两套检索脚本都在文中给出,换成你自己的文档就能重跑一遍。
一、先看 3 条结论与 2 个反直觉数字
- 切片选 512 字符:融合检索 recall@1 = 0.84、recall@5 = 0.92,前 5 个切片只喂 2,516 字符;换到 1024,纯 BM25 的 recall@1 虽涨到 0.88,但成本翻倍到 4,902 字符,而且向量那一路彻底失效。
- 换 embedding 之前先看"不同 top-1 数":它比相似度可靠得多------相似度高可能是整个空间饱和了。同一个中文模型,切片 512 时 recall@1 = 0.72、切片 1024 时 = 0.08。
- 反直觉 1:我最初用的英文 embedding 召回只有 0.28,换成中文模型直接到 0.72 ------ 差 2.5 倍,很多人卡在这一步却以为"向量检索就这样"。
- 反直觉 2 :相似度的绝对值会骗人。英文模型的平均相似度是 0.738,中文模型是 0.665,看着"更自信",但召回率只有人家的一半。别拿相似度当检索质量。
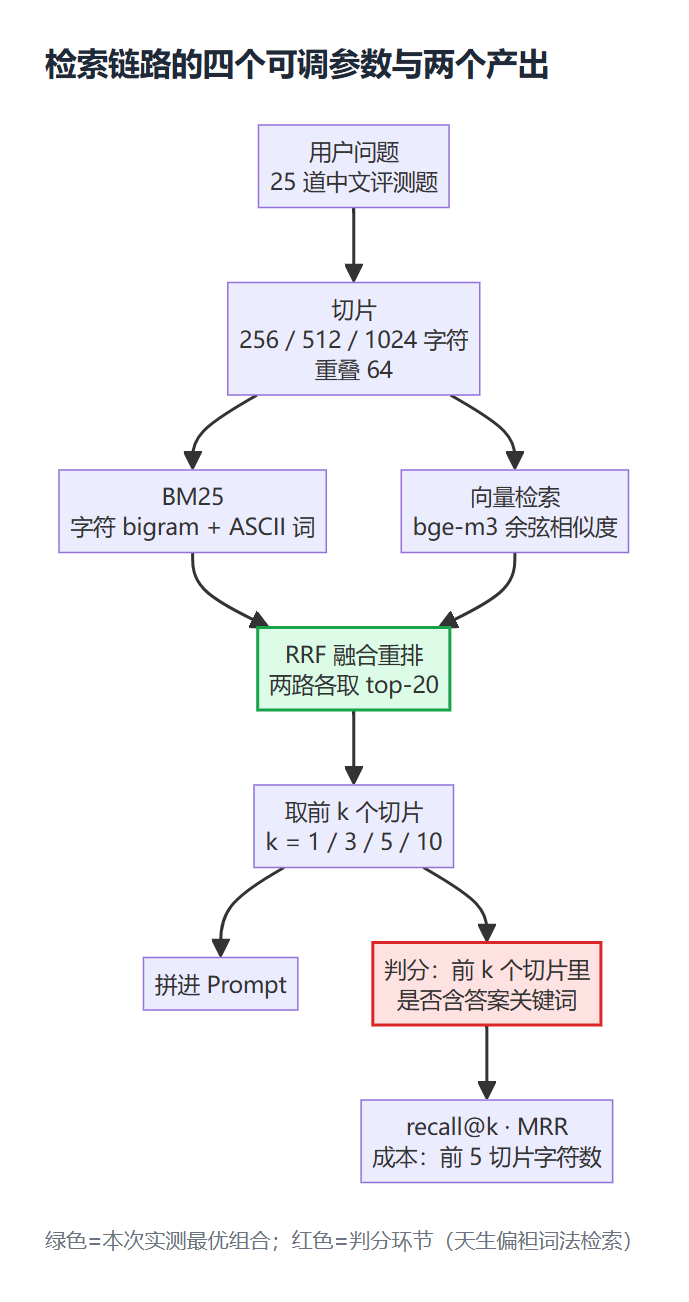
图 1:整条链路里只有四个地方可调(切片、检索器、融合、k),而判分口径决定了你会得出什么结论。绿色是本次实测的最优组合。
二、实测设置:13 篇语料、25 道题、1 条判分规则
一句话:13 篇笔记、59,147 字符、25 道题,每题一个"答案关键词"做判分锚点。
语料是我自己写的 13 篇技术笔记(Redis / MySQL / Docker / 云原生),去掉代码块与 front-matter 后 59,147 字符 ------写这篇文章时用到的那两篇新稿被主动排除在语料之外 ,否则就是拿文章自己考自己。评测集 25 道中文技术问题 ,每题指定一个"答案关键词",例如「RedisTemplate 存进去的 key 为什么在客户端里是乱码?」对应关键词 StringRedisSerializer。
判分规则只有一条:检索结果的前 k 个切片里,只要有一个包含该关键词,就算命中。这个方法便宜、可复现,但它有两个必须承认的偏差:
- 关键词命中天生偏袒词法检索(BM25),对向量检索不公平;
- 切片越大,含关键词的切片越少,"题目"就越简单------所以我把每题正确答案的切片数也一起统计了,它就是下面表里的第 3 列:256 字符时是 5.92 个,1024 时只剩 2.76 个。
看到"大切片召回更高"时,请同时看这一列:提升里有一部分只是题目变简单了。
三、主结果:切片大小 × 检索器 × 召回率(向量用中文模型 bge-m3)
| 切片大小 | 切片数 | 每题正确答案切片数 | 检索器 | recall@1 | recall@3 | recall@5 | recall@10 | MRR | 前 5 切片喂入字符 |
|---|---|---|---|---|---|---|---|---|---|
| 256 | 308 | 5.92 | BM25 | 0.56 | 0.72 | 0.84 | 0.92 | 0.671 | 1,243 |
| 256 | 308 | 5.92 | 向量 | 0.64 | 0.80 | 0.88 | 0.96 | 0.731 | 1,264 |
| 256 | 308 | 5.92 | 融合 | 0.48 | 0.76 | 0.88 | 0.92 | 0.634 | 1,257 |
| 512 | 131 | 3.80 | BM25 | 0.76 | 0.80 | 0.92 | 0.96 | 0.809 | 2,495 |
| 512 | 131 | 3.80 | 向量 | 0.72 | 0.80 | 0.88 | 0.92 | 0.787 | 2,539 |
| 512 | 131 | 3.80 | 融合 | 0.84 | 0.88 | 0.92 | 0.96 | 0.874 | 2,516 |
| 1024 | 63 | 2.76 | BM25 | 0.88 | 0.96 | 1.00 | 1.00 | 0.923 | 4,902 |
| 1024 | 63 | 2.76 | 向量 | 0.08 | 0.16 | 0.32 | 0.60 | 0.181 | 3,298 |
| 1024 | 63 | 2.76 | 融合 | 0.52 | 0.68 | 0.84 | 0.96 | 0.646 | 4,647 |
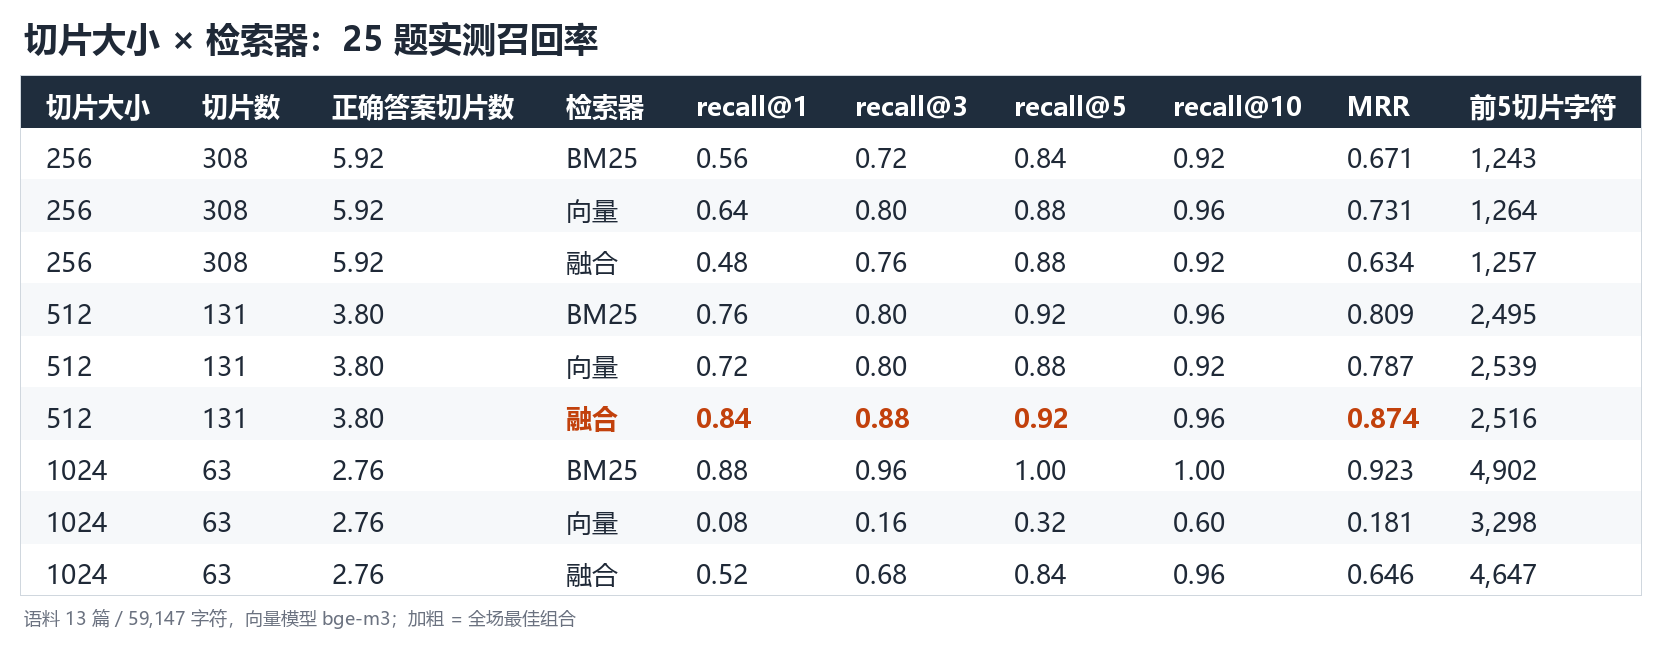
图 2:同一份语料、同一套题,只换切片大小与检索器。加粗那一行(512 切片 + 融合)是全场最佳组合。
四个可以直接用的读数:
- 最佳组合是 512 切片 + 关键词与向量融合(RRF):recall@1 = 0.84、MRR = 0.874,两项都是全场最高。单看一个检索器你会漏掉它------纯 BM25 是 0.76,纯向量是 0.72。
- 256 切片上向量反超 BM25(0.64 vs 0.56)。碎片化切片里词法匹配容易丢上下文,向量反而更能抓住语义。
- 1024 切片上向量塌缩到 0.08,而 BM25 不受影响(0.88)------模型和语料都没变,只有切片长度变了。
- 融合不是万能的:256 切片上融合(0.48)反而比纯向量(0.64)差,因为两路都是"碎片级"证据,融合只是互相拖后腿。
四、成本那一栏比召回率更要紧:3.9 倍差距
同样是"命中答案",不同切片喂给大模型的上下文差了 3.9 倍:1,243 字符 vs 4,902 字符。按"每千 token 计价"的模型算,这是直接的钱;按上下文窗口算,这是能塞进去的文档数。
所以我的建议是把这一列当成第二指标:先把 recall@5 做到 0.9 以上,再在同等召回下挑成本最低的那档切片。这次的结论是 512(recall@5 = 0.92,2,516 字符),而不是指标最漂亮的 1024。
五、两个 embedding 模型的对照:0.28 vs 0.72
同一份语料、同一套题、同一套判分,只换 embedding 模型:
| 模型 | 语言倾向 | 参数量 | recall@1(256) | recall@1(512) | recall@1(1024) | 平均相似度(512) |
|---|---|---|---|---|---|---|
nomic-embed-text |
英文为主 | 137M | 0.28 | 0.28 | 0.24 | 0.738 |
bge-m3 |
中英多语 | 568M | 0.64 | 0.72 | 0.08 | 0.665 |
两件事值得记下来:
- 中文语料配中文模型,召回直接翻倍以上。这不是"调参",是选错工具;
- 相似度和召回率不是一回事 :英文模型平均相似度更高(0.738 > 0.665),召回却只有一半。它的表示空间饱和了------所有切片都挤在 0.65~0.85 之间,排序没有区分度。我写了个体检脚本专门看这个(见下节)。
六、向量检索塌缩:现象、已排除的原因、以及我还没证实的猜测
现象(可复现):模型、语料、问题一个字都没变,只把切片从 512 换成 1024,中文向量的 recall@1 从 0.72 掉到 0.08,25 道题里不同的 top-1 切片数从 24 掉到 4~6 ------ 也就是说,几乎所有问题都在抢同几个切片。
已排除:不是输入被截断。 我做过一个直接实验:拿一个 1024 字符的切片,分别用它的前 200 / 400 / 600 / 800 字符去算向量,再和整段向量比余弦:
| 前缀长度 | 200 | 400 | 600 | 800 |
|---|---|---|---|---|
| 与整段向量的余弦 | 0.438 | 0.432 | 0.467 | 0.485 |
如果模型把长输入截断了,前缀向量会和整段向量几乎相同 (余弦接近 1)。实测只有 0.43~0.49,说明它确实读进了整段内容,"静默截断"这个解释不成立。
还没证实的猜测(我倾向于"长切片质心化") :一片 1024 字符里通常混着两三个主题,算出来的向量更像这几个主题的"平均值";同时候选切片数从 131 降到 63,于是少数泛化切片成了"万能命中"。部分证据支持它------1024 下最泛化的 6 个切片里有 4 个确实当了某一题的 top-1,它们的平均相似度(0.486)明显高于最"专一"的切片(0.271)。但我没有把机制证死,所以下面的排查建议只依赖现象,不依赖这个猜测。
三个诊断指标 (vector_sanity.py,判断"排序不行"还是"检索塌缩"):
| 指标 | bge-m3 @ 512 | bge-m3 @ 1024 | 怎么读 |
|---|---|---|---|
| 25 题里不同的 top-1 切片数 | 24/25 | 4~6/25 | 接近 1 就是塌缩:所有问题指向同一批切片 |
| 平均相似度 | 0.665 | 0.541 | 全都挤在 0.7 以上 = 表示空间饱和、没区分度 |
| top1 与 top2 的相似度差 | 0.0314 | 0.0301 | 越小越排不出顺序(两个档位都只有 0.03 左右,天生很薄) |
| top10 全没命中的题数 | 1 | 11 | 塌缩的直接后果 |
判断口径:recall 掉的同时"不同 top-1 数"也掉了一半以上 → 这是塌缩,改切片或换模型;如果 top-1 数正常、只是命中不多 → 那才是重排该解决的问题。
七、6 步排查表:召回不准时按顺序查
| 症状 | 最可能的原因 | 怎么验证 | 修法 |
|---|---|---|---|
| 答案就在文档里,却从来没被检索到 | 切片切碎了关键句(边界问题) | 打印关键词在文档里的位置,看是否跨了两个切片 | 切片带重叠(我用 64 字符),或按标题/段落切 |
| 首条结果总是不对,但前 5 条里有 | 排序问题,不是召回问题 | 对比 recall@1 与 recall@5 | 加融合重排(RRF),或上交叉编码器重排 |
| 切片调大后向量检索突然变差 | 长切片"质心化"(待验证的猜测)+ 候选池变小 | 看"不同 top-1 切片数"是否骤降、前缀对比是否排除了截断 | 缩小切片;用 BM25 或融合检索兜底(它们不受影响) |
| 换了向量库还是一样差 | embedding 与语料语言不匹配 | 拿 5 个近义问题看相似度排序 | 换中文 embedding;同时保留 BM25 做基线 |
| 有些问题永远答不出 | 评测集本身有问题(答案不在语料里) | 校验每题的关键词是否存在于语料 | 修题或补语料,别改检索器 |
| 召回看着挺好,答案还是错 | 噪声挤掉了答案(上下文被占满) | 统计前 k 个切片的总字符数 | 降低 k 或换小切片,把位置留给正文 |
八、3 段可直接复现的脚本
python
# 切片:固定长度 + 重叠(最容易做错的一步)
def chunk(text, size=512, overlap=64):
    step = max(size - overlap, 1)
    return [text[i:i + size] for i in range(0, len(text), step)
            if len(text[i:i + size]) >= size * 0.4]
python
# 判分:前 k 个切片里有没有答案关键词(简单、可复现、但偏袒词法检索)
def evaluate(rank_fn, questions, truth, ks=(1, 3, 5, 10)):
    hit = {k: 0 for k in ks}
    for qid, q in questions.items():
        order = rank_fn(q)
        for k in ks:
            if set(order[:k]) & truth[qid]:
                hit[k] += 1
    return {f"recall@{k}": hit[k] / len(questions) for k in ks}
python
# 融合重排:RRF 是最省事的"重排",两路召回排名取倒数加权
def rrf(*rankings, k=60):
    score = {}
    for ranking in rankings:
        for rank, idx in enumerate(ranking, 1):
            score[idx] = score.get(idx, 0) + 1 / (k + rank)
    return [i for i, _ in sorted(score.items(), key=lambda x: -x[1])]
九、让评测结果可信的 3 件小事
- 关键词先校验存在性。我第一版有 1 道题的关键词在语料里根本不存在(「范式」),这种题会被当成"永远检索失败",悄悄把所有人的分数拉低。脚本现在会把它打印出来,而不是静默跳过。
- 别让文章自己进语料。写这篇时我把新稿从评测语料里排除了------否则就是拿文章考自己,数字好看但没有意义。
- 别用一次结果下结论。25 道题里差 1~2 题就是 4~8 个百分点,这个量级的差距没有统计意义。
十、25 道评测题长什么样(节选 12 题)
| 问题 | 判分关键词 |
|---|---|
| Redis 为什么用单线程还能这么快? | 单线程 |
| RDB 和 AOF 应该怎么选,混合持久化是什么? | appendfsync |
| 缓存穿透、缓存击穿、缓存雪崩有什么区别? | 布隆过滤器 |
| 先删缓存还是先更新数据库? | 延迟双删 |
| RedisTemplate 存进去的 key 为什么在客户端里是乱码? | StringRedisSerializer |
| 为什么要用多阶段构建,它解决了什么问题? | 多阶段构建 |
| MySQL 建了索引为什么还是不走索引? | 最左前缀 |
| 什么是回表,覆盖索引怎么避免它? | 回表 |
| MVCC 的快照读为什么读不到刚提交的数据? | ReadView |
| InnoDB 的间隙锁到底锁住了哪些范围? | 间隙锁 |
| MySQL 表设计里主键该用自增还是 UUID? | 页分裂 |
| 插入意向锁和唯一索引冲突是怎么互相阻塞的? | 插入意向锁 |
出题的经验就两条:一个问题的答案必须能定位到语料里的某一处 (否则它永远检索不到,只会拉低所有检索器的分数);答案关键词要够稀有(像"索引"这种词会在几十个切片里出现,判分就失去意义)。
十一、把这套评测接进发版流程:3 条红线
- 融合检索的 recall@1 < 0.80 不许上线:本次 512 切片 + bge-m3 的基线是 0.84;
- recall 掉的时候先看"不同 top-1 数":它掉了一半以上就别换重排了,那是塌缩,得改切片或换模型;
- 前 5 切片总字符数 > 3,000 要重新评估:召回靠堆上下文换来的提升,要按 token 成本折算后再决定值不值。
相关阅读(同一套语料里的其它实测笔记):