论文:
Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail
地址: https://arxiv.org/pdf/2511.00088
开源链接:https://huggingface.co/datasets/nvidia/PhysicalAI-Autonomous-Vehicles
个人简单总结此文章:
-
结构化因果链的数据集构建过程,标注关键场景因素、驾驶决策、因果推理和轨迹,包含其中的一些定义,配比的过程,对实战有一定参考意义。Cot不是自由发挥, 而是"八股文"格式。
-
VLA + Flow Matching 双轨架构,特别是训练时候用离散的轨迹token监督,提高一致性。具体来说训练时引入 128 个离散 action tokens,使 reasoning 与 action 可以统一进行 SFT/RL;推理时则直接用 Flow Matching 生成连续轨迹。
创新点
① Chain of Causation(CoC)它不是简单给 VLM 加普通 Chain-of-Thought,而是设计了针对自动驾驶的 因果链推理数据。
CoC dataset 是通过自动标注+人工在环的方式产生。
② VLA + Diffusion/Flow Matching Trajectory Decoder,AR1 并不是让 LLM/VLM 直接 autoregressive 地生成 (x,y) waypoint。主要强调高效生成连续、多模态的轨迹规划方案,既能与语言推理输出对齐,又能满足实时推理需求。
③ 第三个创新:多阶段训练 + RL训练策略,这种主要是实战上训练策略的创新。
一、Coc数据集构建:
总体总结:先人工定义一套结构化的因果标注协议 ,用少量高质量人工数据做评测集;然后利用规则 + VLM 自动扩展到大规模数据,再用人工数据做校验。
之前的大部分数据集,行为描述模糊,关联性弱所以需要结构化的标注协议,或者推理流于表面,与自车行为缺乏直接因果关联,或者由于没有区分历史未来片段产生因果混淆。
实施:
- 结构化的一些定义
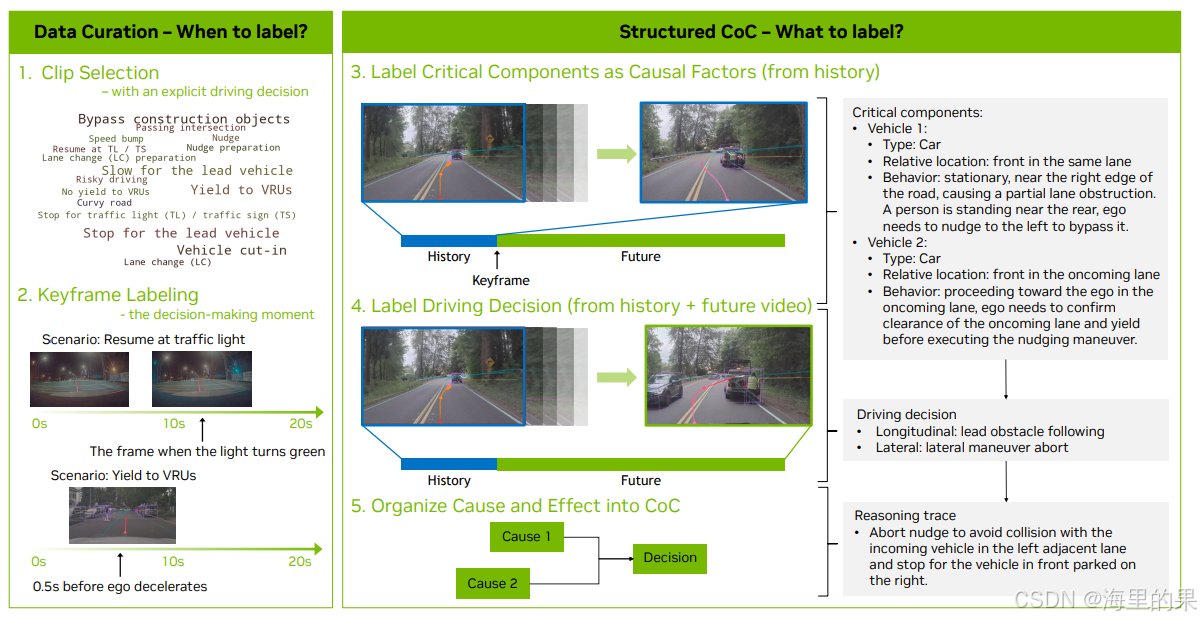
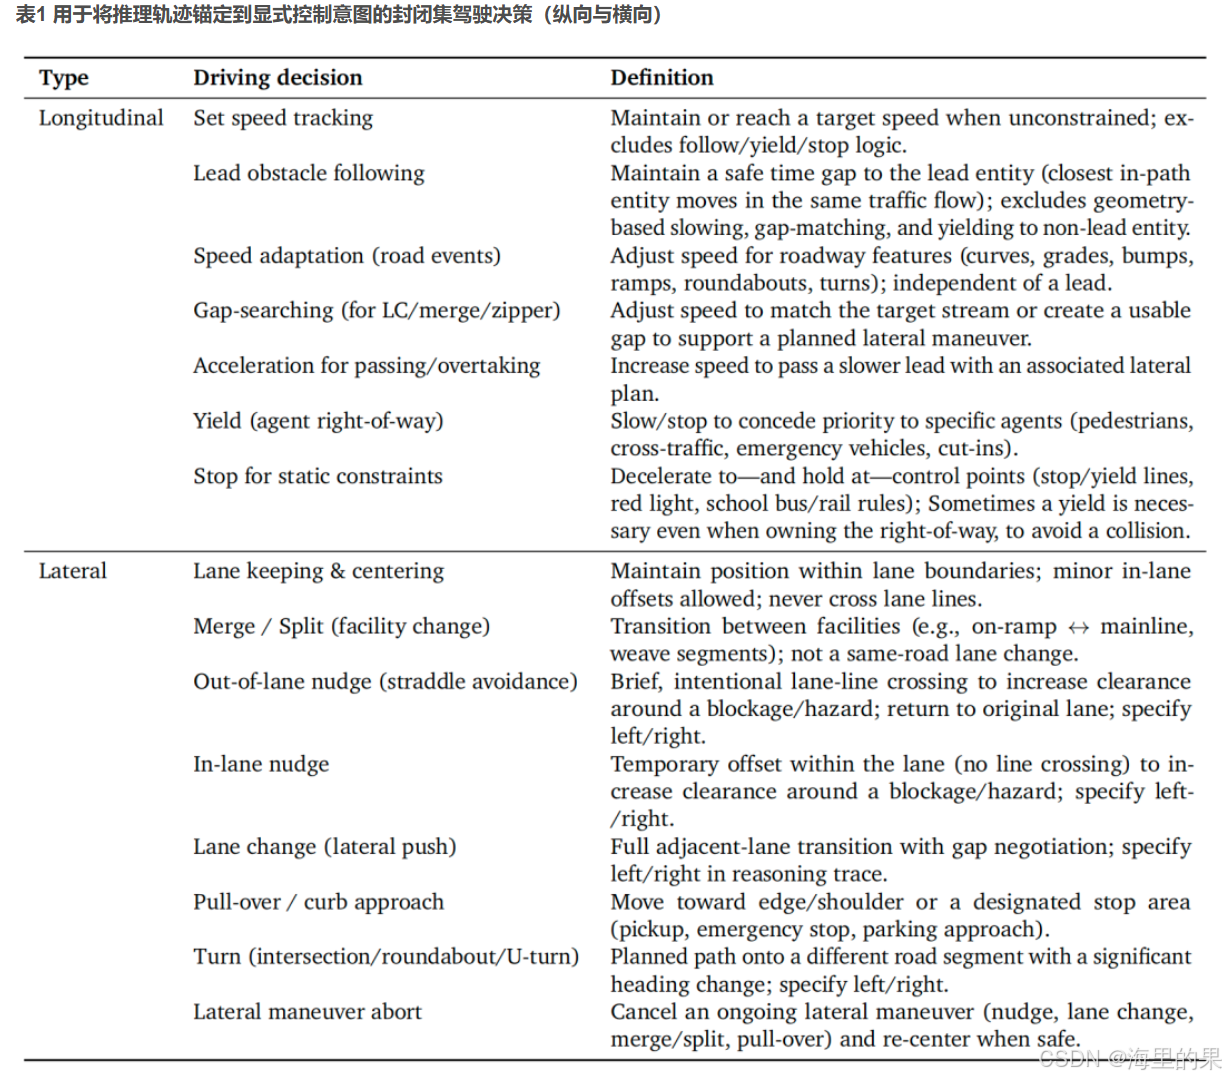
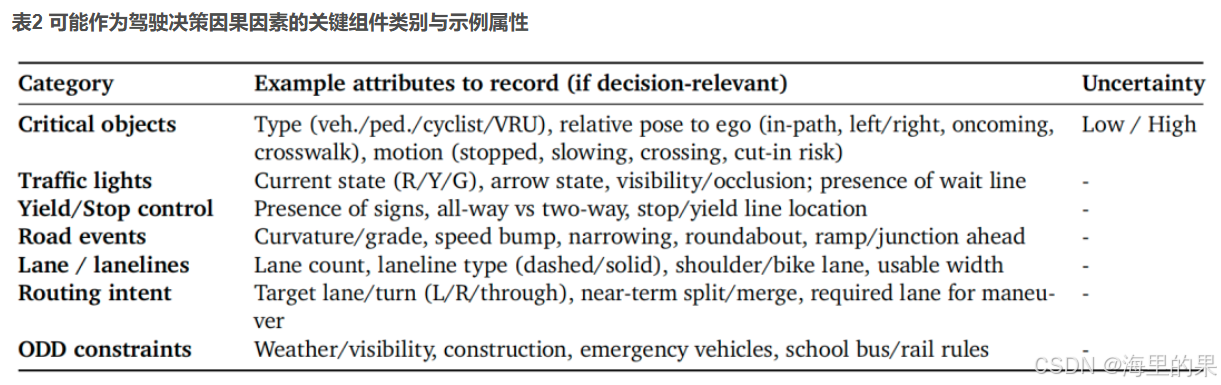 2. 选择片段和关键帧标注定义
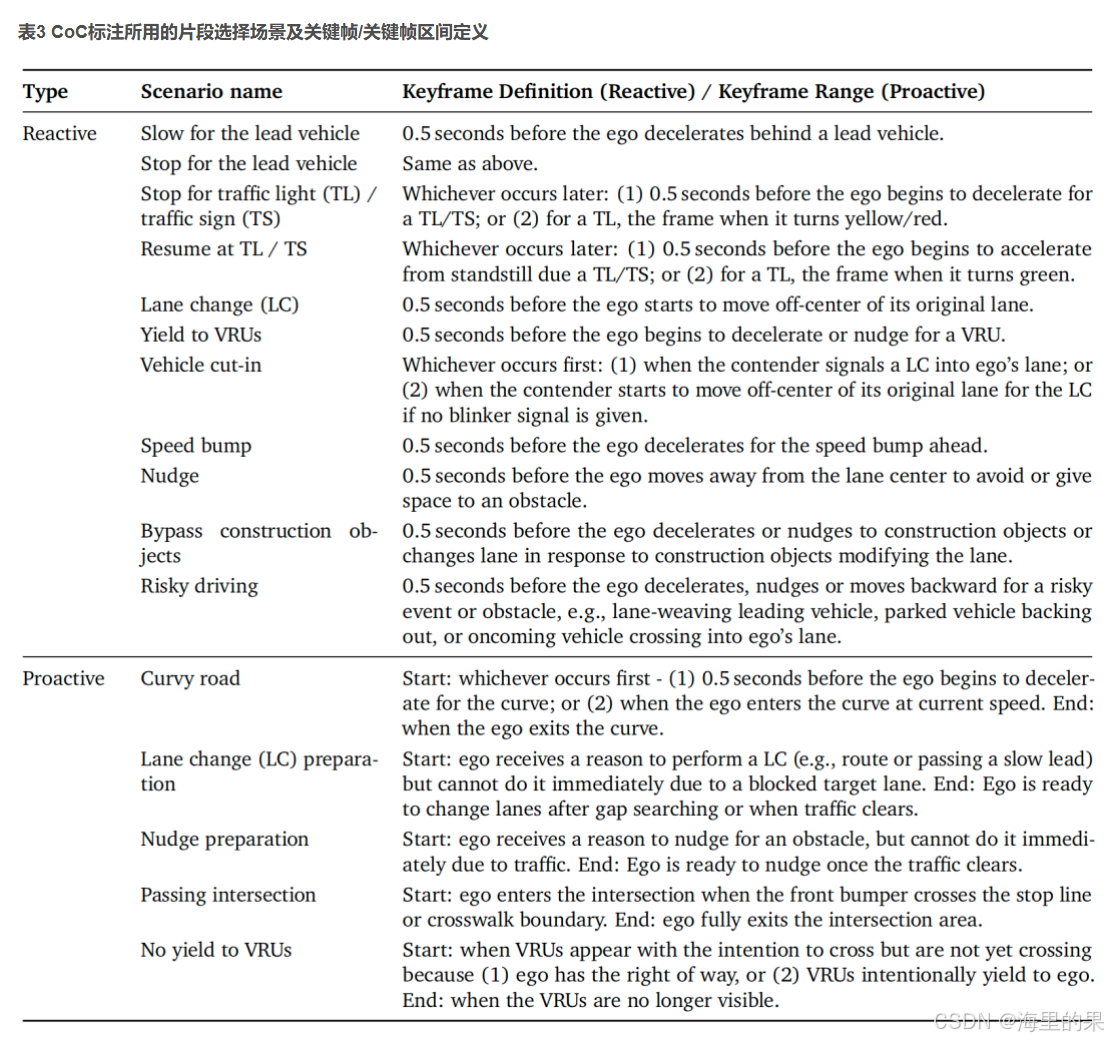
选择片段:规则方式,选择高价值片段。包括反应型场景和主动型场景。按一定比例组合。
**关键帧标注:**反应型场景,关键帧通常选择在自车启动与驾驶决策对应的行为变化前约0.5秒。主动型场景,本文标注关键帧区间------即自车主动评估或准备潜在操作调整的时间窗口。
大部分是规则标记,从自车加速或者减速的关键时点前推。其实就是各种规则的堆积吧。
仅对关键帧时间戳或关键帧区间内采样的关键帧样本标注CoC推理轨迹
 3. 人工标注 两阶段标注流程
标关键元素(原因,历史0-2s),如object traffic light lane 等等。
标记 Driving Decision Reasoning (结果, 未来6s)
一个 20s raw clip 可以切出多个 8s training samples;每个 sample 都对应自己的 keyframe;只有落在 keyframe / keyframe range 上的 sample 才做 CoC 标注!
实际上一个20s的clip 产生几个sample,取决于里面到底有几个 reasoning moment。
反应型场景:一般是一个离散 keyframe
Proactive 场景:如变道,决策过程可能持续一段时间,keyframe range。可以从这个 range 中采样多个 keyframe
"一个训练 sample 只回答一个局部 decision:为什么在这个时刻做这个纵向/横向动作?"
- 自动标注实践
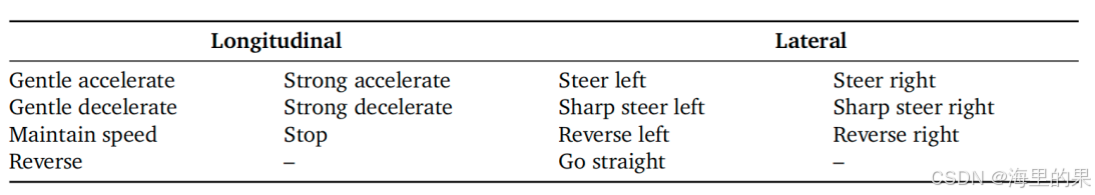
规则打出元动作,元动作发生变化的帧视为决策时刻。元动作则以10Hz的频率自动标注,最多标注一个纵向与一个横向高阶驾驶决策。视频片段中的一个高阶驾驶决策通常由纵向与横向两个维度的一系列原子元动作构成。
例如,"左变道"决策可能包含"左转向"、短暂"右转向"(以稳定车头方向)、随后"直行"的序列,通常还伴随轻微"加速"与"维持速度"
自问自答:
a. 整个数据构建的pipeline?
自动标注数据负责大规模 SFT ;人工数据主要负责高质量监督、auto-labeler 评估和模型评估。
bash
                         原始驾驶数据
                              │
                              ▼
                    ┌──────────────────┐
                    │ 20s raw video    │
                    │ + ego trajectory │
                    │ + vehicle states │
                    └────────┬─────────┘
                             │
                             ▼
                 ┌───────────────────────┐
                 │ ① Clip Selection      │
                 │ Rule-based filtering  │
                 └───────────┬───────────┘
                             │
                    找有明确 driving
                       decision 的 clip
                             │
              ┌──────────────┴──────────────┐
              │                             │
          Reactive                       Proactive
              │                             │
       一个明确 keyframe              一个 keyframe range
              │                             │
              └──────────────┬──────────────┘
                             ▼
                 ┌───────────────────────┐
                 │ ② Keyframe Selection │
                 └───────────┬───────────┘
                             │
                             ▼
                  每个 sample = 8 sec
                    2s history + 6s future
                             │
             ┌───────────────┴────────────────┐
             │                                │
             ▼                                ▼
      ┌──────────────┐                 ┌──────────────┐
      │ Human Label  │                 │ Auto Label   │
      │   ~10%       │                 │   ~90%       │
      └──────┬───────┘                 └──────┬───────┘
             │                                │
             │                                │
       Stage I: 2s history              Rule-based
       Critical Components              meta-action
             │                                │
             ▼                                ▼
       Stage II: 8s window               VLM / GPT-5
       Driving Decision                     │
       + CoC reasoning                     │
             │                                │
             └───────────────┬────────────────┘
                             ▼
                     ┌─────────────────┐
                     │   CoC Dataset   │
                     │                 │
                     │ Decision        │
                     │ Critical Factor │
                     │ Reasoning Trace │
                     └────────┬────────┘
                              │
                              ▼
                     大规模 SFT / Training
                              │
                              ▼
                       Alpamayo-R1
二、网络结构设计部分:
π0/π0.5 风格的 dual action representation + Flow Matching Action Expert。
1.网络结构:
Cosmos-Reason 负责理解场景 + reasoning ;Action Expert 负责把 VLM 的语义条件转化成连续 trajectory。
bash
                 Multi-camera images
                         │
                         ▼
                  Vision Encoder
                         │
                         ▼
                 Image Tokens
                         │
                         │
Ego-motion ──────────────┤
                         ▼
                 ┌────────────────┐
                 │  Cosmos-Reason │
                 │      VLM       │
                 │                │
                 │ Vision Encoder │
                 │      +         │
                 │ Transformer    │
                 └───────┬────────┘
                         │
                 Reasoning tokens
                         │
                    KV Cache
                         │
                         │
              ┌──────────▼──────────┐
              │   Action Expert     │
              │   Transformer       │
              │                     │
              │  Flow Matching      │
              └──────────┬──────────┘
                         │
                  control sequence
                    (a, κ) × 64
                         │
                         ▼
                Unicycle dynamics
                         │
                         ▼
                64-point trajectory
                    (x,y,θ,v)
因为 问题 1:position 有 sensor noise 问题 2:下游 controller 本身还会 smoothing,所以论文选择输出 acceleration , curvature 推理时候通过动力学方程,把dynamics 把 control sequence 映射回 trajectory。
- 轨迹有两种表示:
Discrete tokens ,每条 trajectory 对应 128 个 discrete tokens。
用于VLM training + SFT + RL。为了推理与轨迹共享同一token空间,将因果解释与车辆行为紧密关联,离散表示便于强化学习优化,正是因为放在了一起,所以才是 reasoning-action alignment 的。比如会把acc 离散-10~+10离散成256个bin,用来预测。
inference 时**不使用这 128 个 token 来生成 trajectory,而是用 action expert 网络,**Sinusoidal Positional Encoding→MLP 用flow matching直接生成整个control sequence,主要是能生成的更加的快。
- Action Expert
目前公开的 10B 模型中:
- Backbone:约 8.2B
- Action Expert:约 2.3B。
输入主要有三个:VLM KV-cache (包含环境,ego, reason所有信息);Noisy action(flow macting 噪声),Flow time t。
实际就是 network(xt,t,condition)
三、训练策略部分:
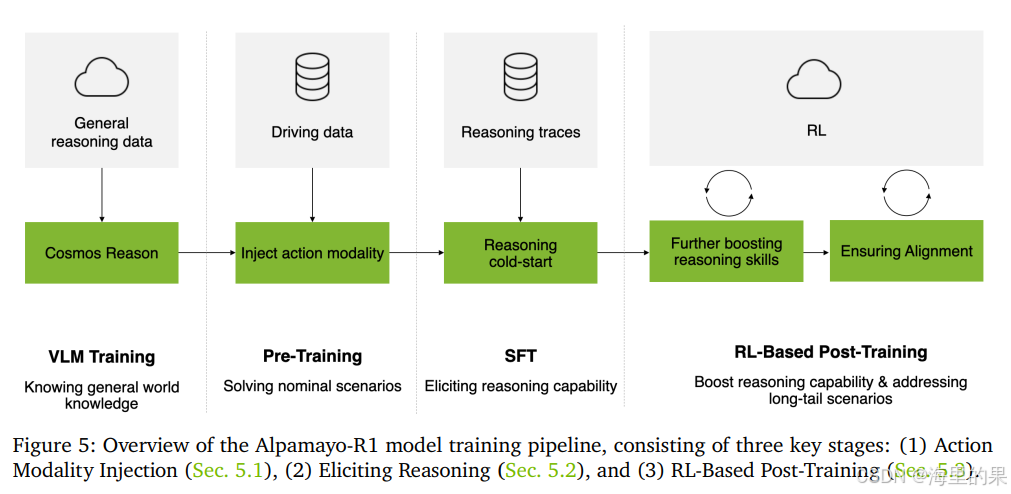
分别是,先学会开,在学会解释为啥这么开,最后RL保证说和做的一致。
Stage 1 同时完成 action modality injection 和 flow-matching action expert 的训练
Stage 2:CoC SFT ------ 教模型"因果推理",用之前的因果数据集,
Q: Stage 1 已经有 action 了,Stage 2 为什么还要再训练 action?
A: Stage 1 把 action modality 注入 VLM。Stage 2 让 reasoning 和 action 建立联系, 提高其一致性。
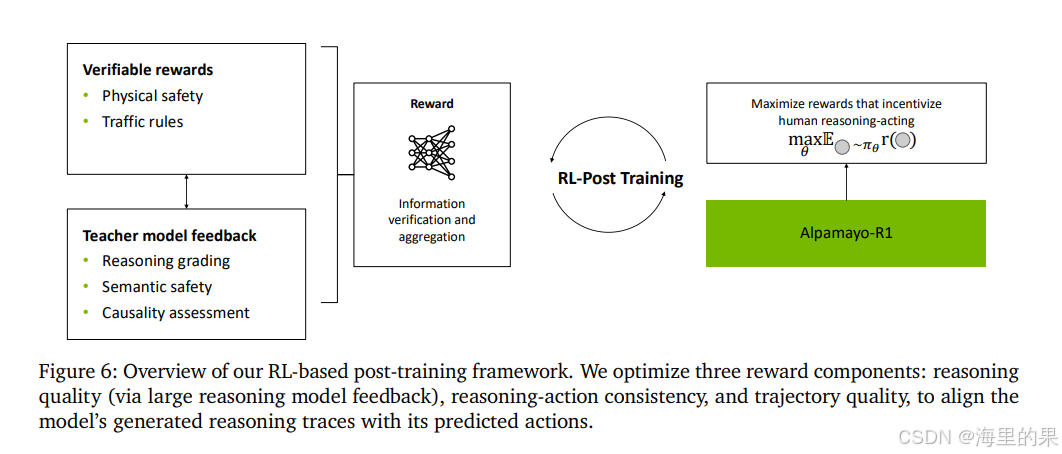
Stage 3 :RL Post-training, 让模型自己 rollout,然后评价"你说的和你做的是不是一回事"。
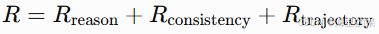
reasoning Reward: 让一个大型 reasoning model 当 judge。
它主要评价:
- reasoning 是否正确
- 是否真的理解场景
- causal relationship 是否合理
- 是否与交通环境对应
- 是否存在错误/幻觉的 causal factor
CoC-Action Consistency Reward: 把预测 trajectory 转换成 MetaActions,再解析 reasoning,然后比较这两个输出的一致性。
最后一个 Trajectory Quality / Safety Reward 就是比较常见的碰撞等合集
trajectory
│
├── imitation
├── collision
├── traffic rules
├── comfort
└── physical safety
3阶段示意: