相机的眼睛再灵,也绕不开三道坎:怕黑、怕白墙、算不出真实尺度。本篇换一种"看"法------让激光雷达主动发光测距,在无结构的点云里重新回答"提取什么、如何关联"两个老问题。读完你会理解 LOAM 的粗糙度选点、KD-tree 就近关联与点到线面残差的设计逻辑,横向认识 ICP/GICP/NDT 一族,还能带走一段可运行的 PCL 配准代码与实战避坑清单。
一、缘起:当视觉那双眼睛"瞎掉"的时候
上一篇文章里,我们给相机配了一双眼睛:提取角点(找茬)、发身份证(ORB 描述子)、对暗号(汉明匹配 + 比率检验)、开派对投票(RANSAC)、再签几何契约(对极几何)。链路是通的,但这双眼睛有三个明明白白的短板:
-
怕黑:被动成像,夜里、隧道里,它什么也看不见。
-
怕无纹理:白墙、天空,它找不到任何"独一无二"的点,直接罢工。
-
天生没有尺度感:花了好大力气解出来的平移 t,只是个方向,真实走了几米它不知道。
这三个短板,指向同一个解药:换一种"看"法------不是等着接收光,而是主动发光、还顺带量距离。
激光雷达(LiDAR,Light Detection And Ranging)干的就是这件事:它自己打出一束激光,收到回波,用"光走了多久"直接算出这个点离我几米。上一篇文章里单目视觉求而不得的"尺度",对激光来说,出生就带着。
但代价是:激光给你的,不再是一张规整的、铺满像素的图像,而是一团无结构的散点------点云(point cloud)。你要在这团点里,重新回答那两个老问题:
-
提取:哪些点"值得记住"?
-
关联:两团点里,哪些点"是同一个东西"?
骨架没变,但血肉全换了。如果说视觉是"用眼睛看",激光就是"在黑暗里摸形状"------这正是本文要讲的内容。
二、浅水区:在点云里找茬------什么样的点值得被记住?
2.1 点云不是图像,先抛弃一个幻觉
先纠正一个最容易犯的错:别把点云当"像素"来处理。
图像是一个规则的二维网格:每个格子(像素)都有确定的位置和灰度,邻域关系清清楚楚。点云完全不是这么回事------它是一堆 (x, y, z) 坐标的无序集合,点的位置是连续的、稀疏的、不均匀的。近处密密麻麻,远处稀稀拉拉;扫描线之间还有缝隙。
更要命的是:点云没有"灰度"这个概念 。你没法像 ORB 那样在像素上比较"谁亮谁暗"。激光给你的是每个点的三维坐标,以及从坐标里能算出来的几何形状。
所以激光前端的"找茬",找到的不是"纹理的独特",而是"形状的独特"。
2.2 两种"好形状":边缘点与平面点
把上一篇文章那张"角点/边缘/平面"的表搬过来,看看在激光眼里它变成了什么:
| 区域类型 | 视觉眼里的评价 | 激光眼里的评价 | 为什么 |
|---|---|---|---|
| 角点(尖锐拐角) | 完美特征 | 边缘点:好 | 角度突变,位置稳定 |
| 边缘(棱、脊) | 会"滑动",不靠谱 | 边缘点:好 | 激光直接量到棱,不像灰度会滑动 |
| 平面(白墙、地面) | 完全没用 | 平面点:宝! | 见下文 |
注意到一个惊人反转了吗?视觉里最没用的"白墙",在激光眼里成了宝贝。
为什么?因为它反过来了:
-
视觉的难点是"平面上没有可区分的信息"------灰度处处一样。
-
激光量的是"距离",一片平整的墙,恰恰意味着每个点到墙面的距离关系是高度一致的------你用它来对齐两帧点云,约束强得可怕。
而且更重要的是:现实世界主要由平面构成 ------地面、墙壁、天花板、桌面。点云里绝大多数点都落在平面上。平面点数量庞大、处处都是、还能互相印证,是激光 SLAM 绝对的主力。 边缘点虽然"独特",但数量少、还容易被噪声和遮挡污染,只当配角。
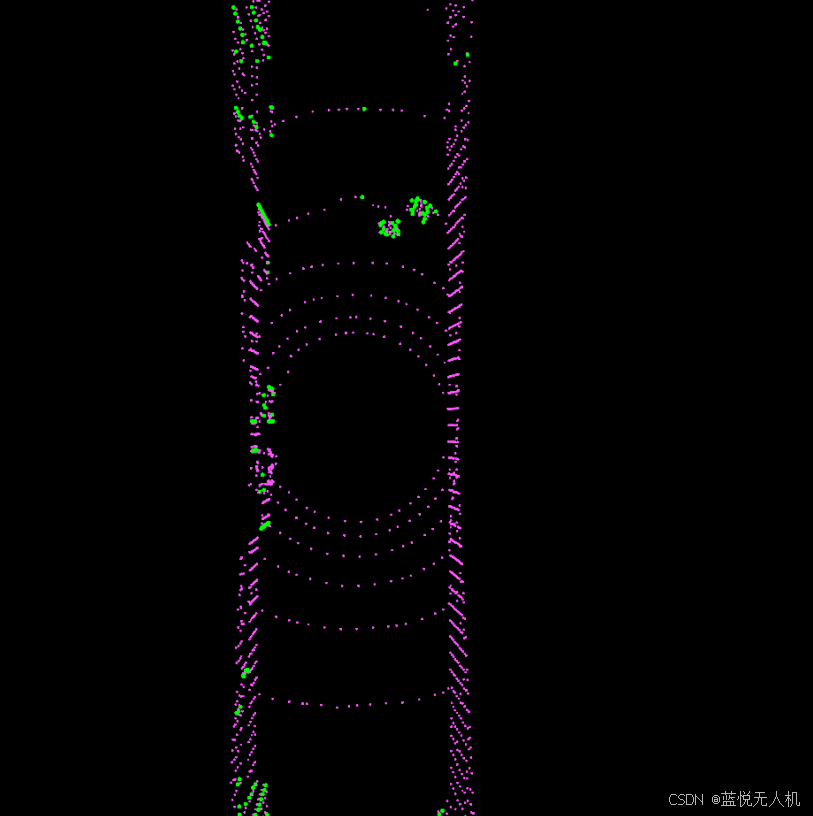
所以,视觉找的是"少数派"(角点),而激光的主力反而是"多数派"(平面点)。这就是两种传感器最根本的气质差异。如下图所示紫色点云为墙面和地面的平面点,绿色则为边缘点。
2.3 用"平滑度"挑点:LOAM 的粗糙度公式
怎么在点云里挑出"边缘点"和"平面点"?经典做法来自 LOAM(Lidar Odometry And Mapping)------它不看灰度,看的是局部几何的光滑程度。
对某条扫描线上的一个点 i,取它前后同一圈上一串相邻点 S,定义它的"粗糙度" c:
             ||  Σ (Xⱼ - Xᵢ)  ||
        c = ────────────────────   ( j ∈ S, j ≠ i )
|S| · || Xᵢ ||直观理解这个公式:分子是"周围点相对于我的位置的向量和"。如果周围点像平面一样均匀分布 ,正负向量互相抵消,这个和会很小;如果我在一条棱上,某一侧的点突然拐了个弯,向量和就会很大。
于是就有了一个朴素的判据:
c 大  →  边缘点    (周围点"不平",我正好卡在棱上)
c 小  →  平面点    (周围点"平",我躺在一片平面上)
就这么简单。它和视觉里的"角点响应"是一对表兄弟:视觉用灰度梯度判断"这里变化剧烈",激光用几何粗糙度判断"这里形状突变"。
工程忠告 :真正落地时,点不能随便取。LOAM 会把每条扫描线分成若干段,每段里按 c 的大小取前几个边缘点、后几个平面点。这样能保证各种朝向的点都有、不至于墙面点把棱上的点淹没了;同时远距离点(点稀疏、噪声大)会被特殊对待。挑点的艺术,一半在公式,一半在"怎么撒网"。
三、深水区:数据关联------谁和谁在同一个物体上
3.1 没有身份证,怎么认亲?
视觉那套"发身份证 + 对暗号"的流程,激光里不存在。点云没有描述子,没有汉明距离,只有一堆坐标。
那怎么把两帧点云里"同一个物体"的点对上?答案朴素得有点粗暴:靠位置就近。
具体做法是:把上一帧(或地图)的点塞进一个 KD-tree,对当前帧的每个特征点,去问 KD-tree:"离我最近的几个点是谁?"
当前帧点 X → KD-tree 最近邻搜索 → 上一帧里最近的几个点听起来很像视觉里的"暴力匹配",但有一个本质区别:"就近"成立的前提,是两帧位姿已经大致对齐。 所以要先用里程计、IMU 或上一时刻的位姿,把当前点云粗略地"挪"到上一帧的坐标系下,再找最近邻。这就是激光前端里常说的"有了初值,关联才成立"。
3.2 点到线、点到面的距离,才是真正的"残差"
找到最近邻之后,最反直觉的一步来了:不要用"点对点"的距离,要用"点到几何元素"的距离。
原因在于扫描的物理过程。激光的扫描线是分层的(比如 16 线、64 线),相邻两圈扫描线的间隔,远大于同一圈里相邻点的间隔。也就是说:你在当前帧里看到的一个点,几乎不可能正好落在上一帧某个点上------它更可能落在上一帧某个点"所在的直线或平面"上。
于是 LOAM 的关联规则是这样的:
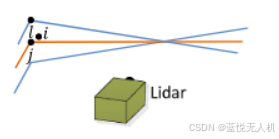
对于边缘点 :先用 KD-tree 在上一帧特征点云中找到离当前点最近的点,再在相邻的前后两条扫描线中各补一个最近的点。如下图中,i 是当前帧中的一个边缘点,j、l 是上一帧中找到的两个边缘点------它们连成的直线,就是 i 应该落上去的那条"棱"。算的是点到直线的距离:
              |(X - Xⱼ) × (X - Xₗ)|
        d_边 = ────────────────────────────
               |Xⱼ - Xₗ|
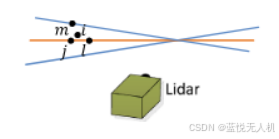
对于平面点 :套路相同,只是要多凑一个点------KD-tree 找到最近点后,再在相邻扫描线中补齐三个不共线的点。如下图中,i 是当前帧中的一个平面点,m、j、l 是上一帧中找到的三个平面点------它们张成一个平面,就是 i 应该落上去的那片"面"。算的是点到平面的距离:
               |(X - Xⱼ) · ( (Xⱼ - Xₗ) × (Xⱼ - Xₘ) )|
        d_面 = ────────────────────────────────────────────
                 |(Xⱼ - Xₗ) × (Xⱼ - Xₘ)|
注意这里的 j、l(以及 m)必须落在不同的扫描线上------同一圈扫描上的点挤在一起,张不出可靠的直线或平面。
把两帧点云里所有"边缘点→线"和"平面点→面"的距离加起来,就是我们要最小化的总误差;再用高斯牛顿法求解旋转 R 和平移 t。这一步,就是激光版的对极几何------"几何验证"在这里的化身。
3.3 扫描匹配全家桶:ICP / GICP / NDT
上一节讲的"点到线面",是 LOAM 这套框架的精髓。但它不是唯一的玩法。把"两帧点云怎么对齐"这件事抽象出来,业界有几代通用解法,一并认识一下:
| 算法 | 对应关系 | 误差定义 | 是否需要特征 | 特点 |
|---|---|---|---|---|
| ICP | 点对点 | 点到点的欧氏距离 | 否(用全部点) | 最经典,但很吃初值 |
| GICP | 点到分布 | 点到"高斯分布"的马氏距离 | 否 | 考虑局部协方差,更鲁棒 |
| NDT | 点到体素 | 点到正态分布的似然 | 否 | 栅格化统计,不挑特征点 |
| LOAM 系 | 点到线/面 | 点到几何元素的距离 | 是(边缘/平面点) | 轻量高效,激光 SLAM 主流 |
一个总的心法是:ICP 系把对应关系当成"最近点对点",而 LOAM/NDT 把对应关系当成"点对局部形状"。前者简单直接,后者更贴合激光扫描的物理结构,所以精度和速度都更优。这也是为什么今天做激光里程计,几乎人人都在 LOAM 这条祖传路线上打补丁(LeGO-LOAM、LIO-SAM、FAST-LIO......)。
3.4 上代码:完整可运行的两帧点云配准
和视觉篇对仗,这里给一段最小闭环:读两帧点云 → 降采样 → ICP 配准 → 得到 R、t。用 PCL 写,可编译:
#include <pcl/point_types.h>
#include <pcl/io/pcd_io.h>
#include <pcl/filters/voxel_grid.h>
#include <pcl/registration/icp.h>
#include <iostream>
int main() {
pcl::PointCloud<pcl::PointXYZ>::Ptr src(new pcl::PointCloud<pcl::PointXYZ>);
pcl::PointCloud<pcl::PointXYZ>::Ptr tgt(new pcl::PointCloud<pcl::PointXYZ>);
pcl::io::loadPCDFile("cloud1.pcd", *src); // 当前帧
pcl::io::loadPCDFile("cloud2.pcd", *tgt); // 目标帧/地图
// ---- 步骤1:体素降采样 ----
// 激光一帧几十万点,全拿去配准太慢;用 0.1m 的体素把点匀一匀
pcl::VoxelGrid<pcl::PointXYZ> vg;
vg.setLeafSize(0.1f, 0.1f, 0.1f);
pcl::PointCloud<pcl::PointXYZ>::Ptr src_ds(new pcl::PointCloud<pcl::PointXYZ>);
pcl::PointCloud<pcl::PointXYZ>::Ptr tgt_ds(new pcl::PointCloud<pcl::PointXYZ>);
vg.setInputCloud(src); vg.filter(*src_ds);
vg.setInputCloud(tgt); vg.filter(*tgt_ds);
// ---- 步骤2:ICP 配准,估计 src -> tgt 的旋转平移 ----
pcl::IterativeClosestPoint<pcl::PointXYZ, pcl::PointXYZ> icp;
icp.setInputSource(src_ds);
icp.setInputTarget(tgt_ds);
icp.setMaxCorrespondenceDistance(0.5); // 对应点最远 0.5m
icp.setMaximumIterations(50); // 最多迭代 50 次
pcl::PointCloud<pcl::PointXYZ> aligned;
icp.align(aligned);
// ---- 步骤3:取出 R 和 t ----
Eigen::Matrix4f T = icp.getFinalTransformation(); // 4x4 齐次变换
std::cout << "是否收敛: " << (icp.hasConverged() ? "是" : "否") << std::endl;
std::cout << "配准得分(越小越好): " << icp.getFitnessScore() << std::endl;
std::cout << "T = \n" << T << std::endl;
// T 左上 3x3 是旋转 R,右上 3x1 是平移 t ------ 单位是真实的"米"!
return 0;
}请对比视觉篇最后那句"t 是单位长度的": 这里解出来的 t,直接就是真实平移了多少米。同样是前端,激光天生带尺子,单目视觉那根"命门"在这里不复存在。 上一篇文章埋下的伏笔,就此解开。
3.5 避坑忠告
这段 ICP 代码在"两帧已经挨得很近"时很顺滑,但真实激光前端一样有它的四大死法:
-
运动畸变 。激光扫一圈要花 0.1 秒(10Hz),这期间雷达本身在动:一圈扫完,起点和终点的坐标已经不在同一个坐标系里了,整团点云被"拧"了一下。速度快时尤其明显,直线墙会被扫成弯的。工程对策:用 IMU 或匀速模型,按每个点的接收时间给它"倒推补偿",把这 0.1 秒的位移抹平------这叫运动补偿/去畸变(deskew)。
-
几何退化 。长直的隧道、空旷的走廊里,四面八方不是墙就是地面,平面几乎都平行------这时"横向平移"几乎没有约束,配准会在某个方向上漂。这是激光版的"视差太小/纯旋转",本质都是某个自由度解不出来。对策:靠 IMU 把退化方向钳住(这正是激光惯导系统 LIO 存在的意义)。
-
稀疏与盲区 。远处点稀、近处有盲区、细杆子可能只扫到一两个点。特征提取时如果只挑"最尖锐"的点,可能全挤在一个方向,配准照样塌。对策:分区域、分方向撒网取点,别让某一种几何独占。
-
动态物体。还是那句老话------路过的人、开走的车,它们是"会动的点云"。ICP 会把它们硬当成静态对应,被拖着跑。动态剔除在激光里更棘手,因为激光看不出"这是车还是墙",往往要靠多次观测的一致性或语义分割来筛。
四、最深彩蛋:从前端到建图,以及"合体"的必然
4.1 前端之后:把点云缝成一张地图
视觉篇我们只讲了"两帧",激光这里补上它独有的后半程:建图(mapping)。
激光前端的输出不只是"这一帧和上一帧差了多少",它还会把这些点云不断对齐、缝合、累积成一张越来越密的三维地图;新来的帧不光和上一帧比,还会和这张地图比(这就是 LOAM 里 "odometry" 与 "mapping" 两个线程的分工)。里程计负责快,建图负责准。
这套"提取 + 关联 + 累积"的循环,把激光从"两帧对齐"推向了"持续定位与建模"。它又是后面**回环检测(loop closure)**的原料:当你转了一圈回到原点,把新地图和旧地图对齐,闭环的误差就能在整个位姿图上摊平------这正好接回我们聊过的 GTSAM 因子图。
4.2 为什么相机和激光"终将合二为一"
上一篇文章结尾我埋了个钩子:激光如何破解尺度、"为什么它和相机终将合二为一"。现在可以摊牌了。把两者摆在一起看:
| 对比项 | 相机 | 激光雷达 |
|---|---|---|
| 靠什么 | 纹理、颜色 | 几何形状、距离 |
| 强项 | 纹理丰富、语义清晰、便宜 | 黑暗照常工作、有真实尺度 |
| 弱项 | 怕黑、怕无纹理、无尺度 | 无颜色语义、稀疏、贵 |
| 前端方式 | 特征点+描述子+对极几何 | 边缘/平面点+最近邻+点到线面距离 |
看懂了吗?它们的强项和弱项几乎完美互补。
-
相机怕无纹理的白墙 → 激光摸白墙摸得最起劲。
-
相机没有尺度 → 激光一量就是米。
-
激光分不清"车还是墙" → 相机一眼看出语义。
-
激光远距离稀疏 → 相机能把远处的纹理细节补进去。
所以趋势不是"谁取代谁",而是合体:视觉提供纹理和语义,激光提供尺度和几何,IMU 提供高频运动。这三者捆在一起(视觉-激光-惯性融合,VIO / LIO 乃至 LVIO),才是今天自动驾驶、机器人定位最主流的形制。
骨架(提取 + 关联 + 几何验证)是永恒的,传感器是血肉;融合的终点,是让这具骨架同时长出眼睛、手和神经。
五、总结:两个传感器,同一副骨架
两篇文章看下来,"前端"其实只有一副骨架,换了两次血肉:
| 环节 | 视觉前端 | 激光前端 |
|---|---|---|
| 提取什么 | 灰度剧变的角点(FAST/Harris) | 几何突变的边缘点/平面点(粗糙度 c) |
| 怎么描述 | ORB 二进制"身份证" | 无描述子,靠坐标就近 |
| 怎么关联 | 汉明匹配 + 比率检验 | KD-tree 最近邻 |
| 怎么验证 | RANSAC + 对极几何 | ICP/LOAM 点到线面距离 |
| 输出 | R,t(但 t 无尺度)+ 3D 点 | R,t(真实米)+ 累积点云地图 |
| 命门 | 黑、无纹理、无尺度 | 运动畸变、几何退化、稀疏、无语义 |
你要做的:
-
摸清气质:视觉靠纹理挑"少数派",激光靠形状吃"多数派",选传感器先看场景里有什么
-
守住关联:激光没有比率检验兜底,位姿初值和最近邻阈值就是命,务必给好初值
-
补上运动补偿:不去畸变,一切配准都是白搭
-
盯住退化方向:隧道、走廊里靠 IMU 兜底
你不需要做的:
-
手撕 KD-tree、手推点到线面距离的雅可比------PCL、LOAM 系开源库都给你封装好了
-
担心尺度不确定------激光出生就带米,这是它最不客气的地方
视觉让我们"看得见",激光让我们"摸得着"。看得见,才知道该往哪走;摸得着,才知道走了多远。
回头看,前端骨架始终是"提取、关联、几何验证"三步:视觉靠纹理挑角点,激光靠形状吃平面,殊途同归解出运动。点到线面残差加上天生的真实尺度,让 LOAM 系方案成为自动驾驶与机器人定位的主力;对运动畸变、几何退化的工程化解,也正推动视觉、激光、IMU 深度融合。掌握这副骨架,任何新传感器到你手里,都只是换一副血肉。
下一篇,我们不再纠结单个传感器,而是把它们揉进一具身体里------聊一聊多传感器融合,看看眼睛和手,是如何配合着把这个世界一点点重建出来的。