我给自己写了一个 mini OpenRouter:基于蓝耘 MaaS 的多模型路由网关实战
一、为什么需要"自己的网关"
前几篇我把蓝耘 MaaS 的 API 已经摸熟了------45 个模型、OpenAI 兼容协议、统一 Key 调用。但真要在生产环境用起来,会很快撞上几个工程问题:
- 该用哪个模型? 蓝耘有 25 个对话模型:qwen3.6-flash 便宜但能力一般,glm-5.3 强但贵。让每个业务开发自己挑,结果肯定是"全部用最贵的"。
- 模型挂了怎么办? 虽然蓝耘 SLA 不错,但任何单一模型都有限流、抖动、临时不可用的可能。直接调裸 API,一旦失败业务就 500。
- 成本到底花在哪? 月底账单"总消耗 100 万 token",但哪个业务线、哪个模型、哪个用户花的?算不清。
业界的标准答案是 AI Gateway------OpenRouter、Portkey、One-API 这类产品干的就是这事。但它们要么走 SaaS 订阅(多一层 vendor lock-in)、要么需要自己部署 K8s(小团队玩不起)。
我的方案 :蓝耘本身已经是"统一上游",我只需要在它前面再加一层薄薄的"智能路由 + 容错 + 计费"。用 Python 标准库写了 200 行 ,跑通全部功能。 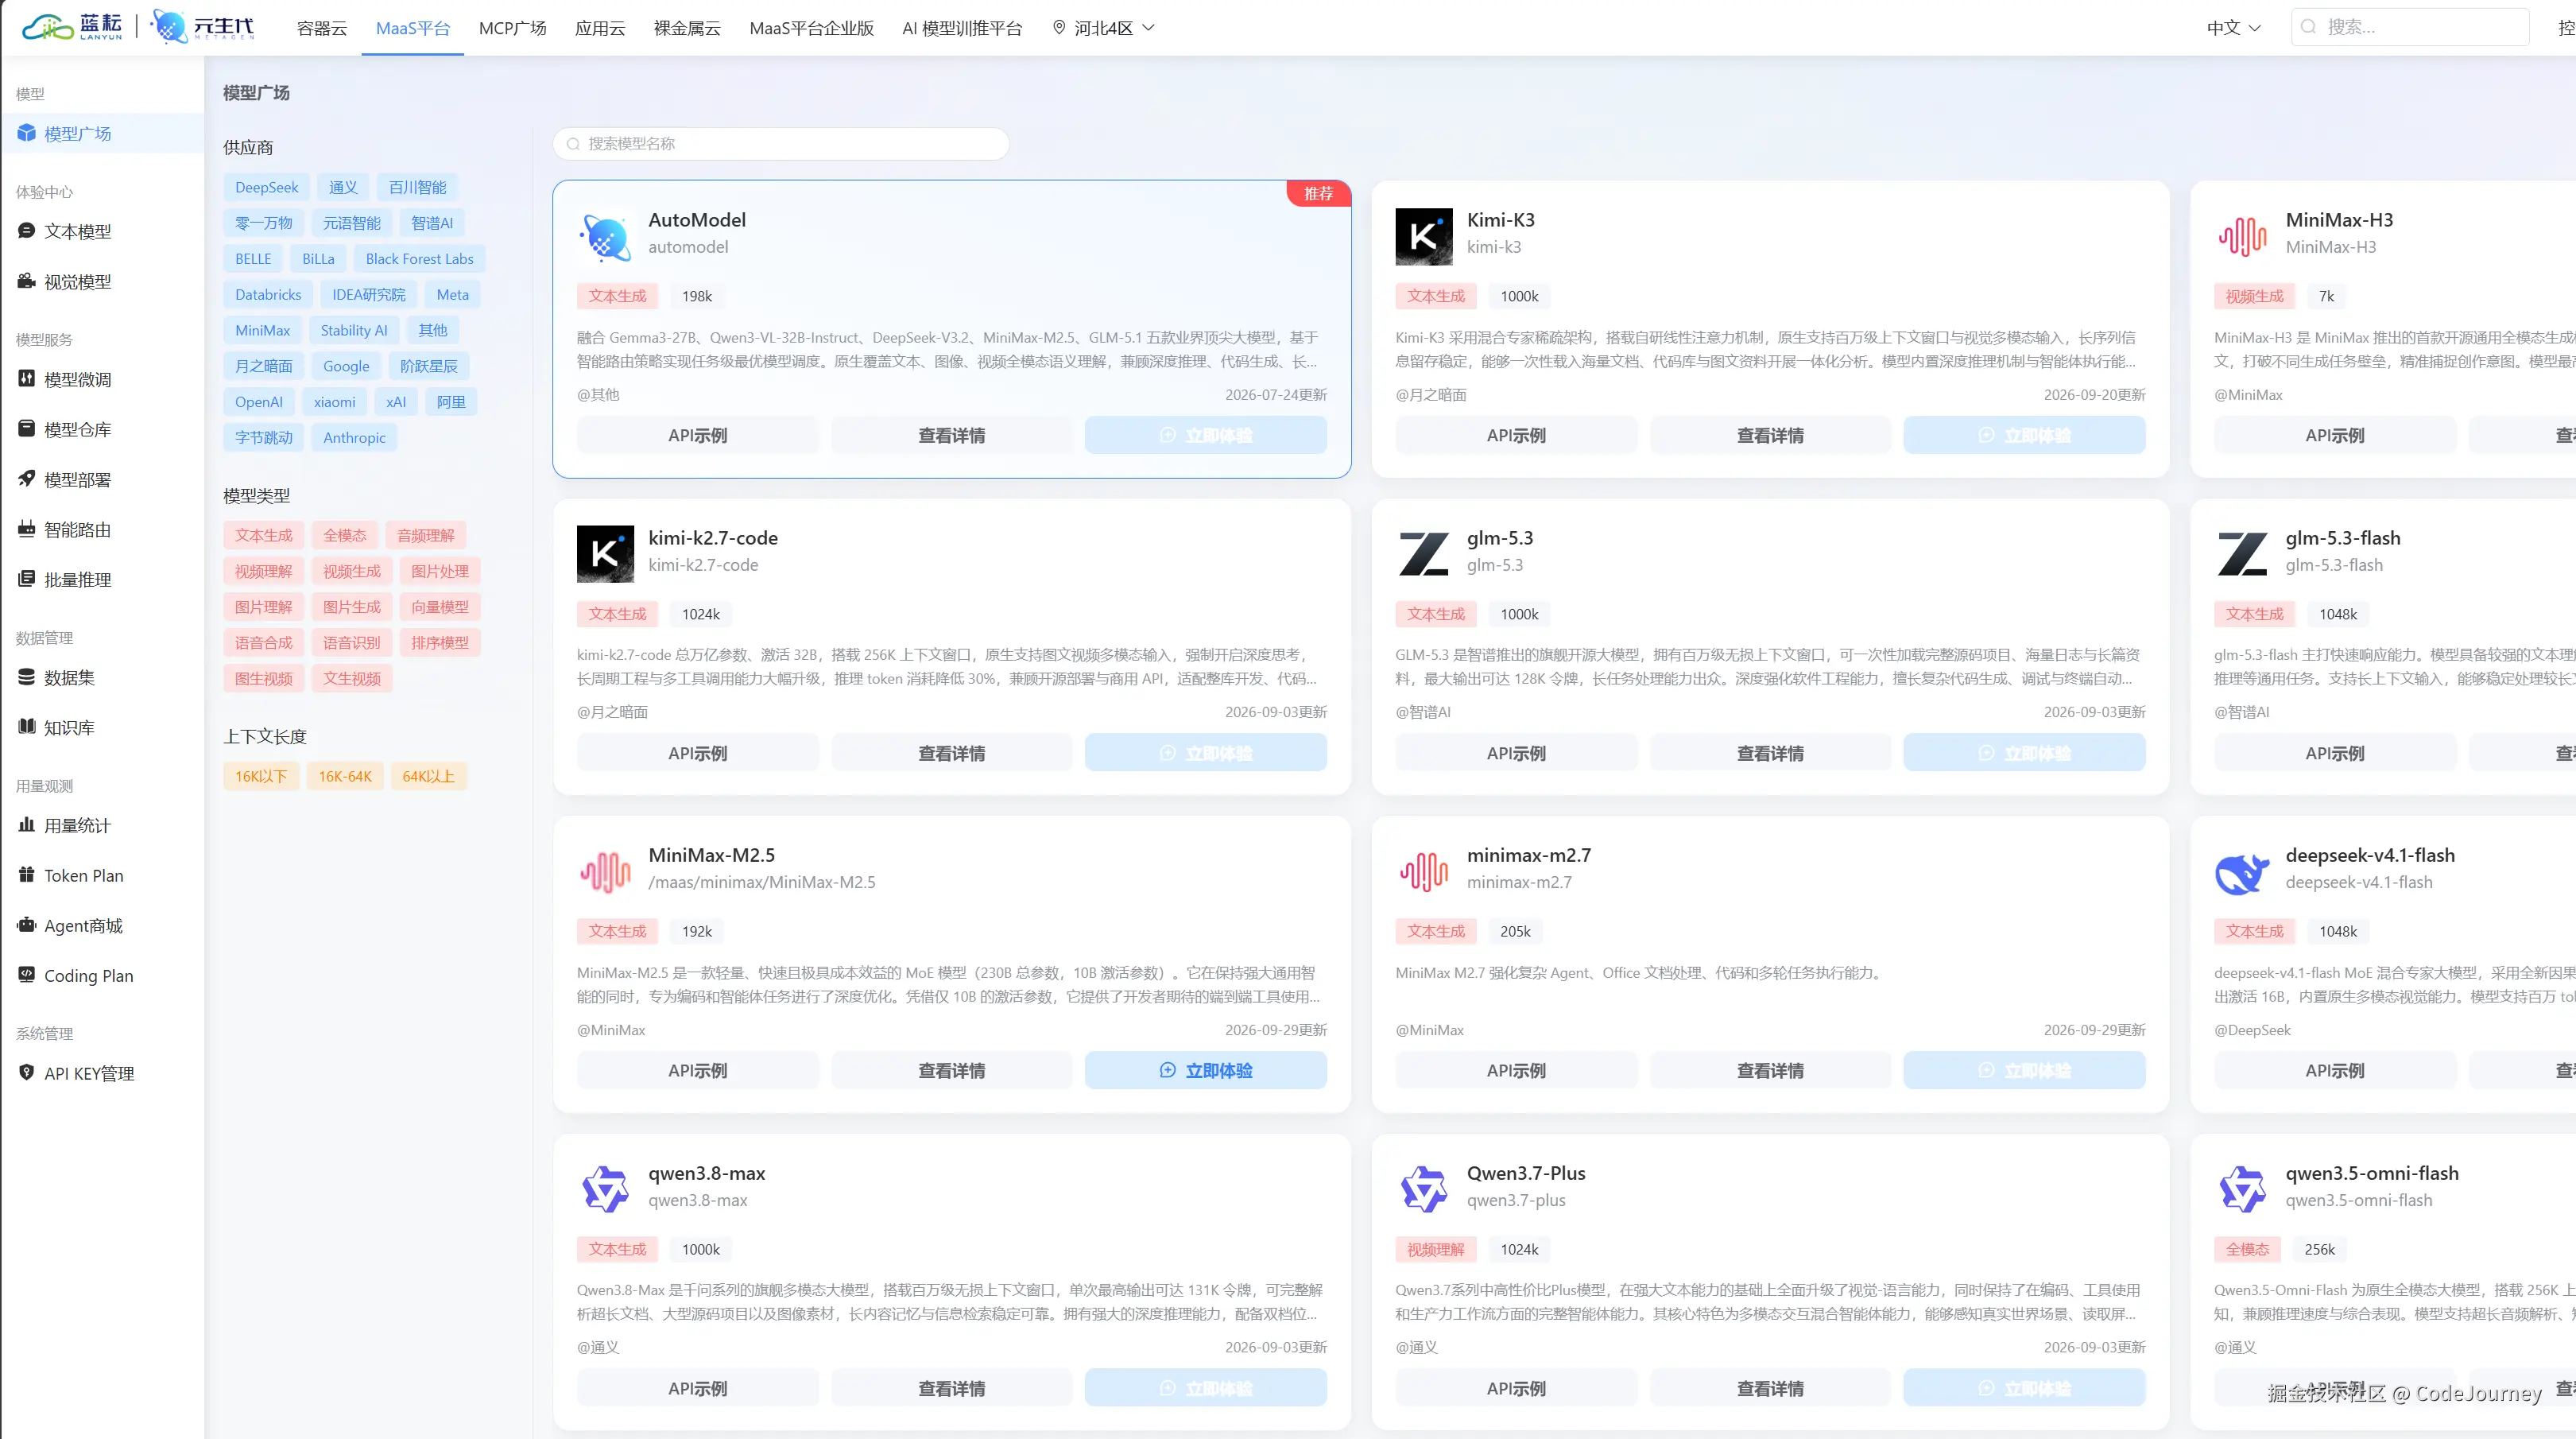
二、架构设计
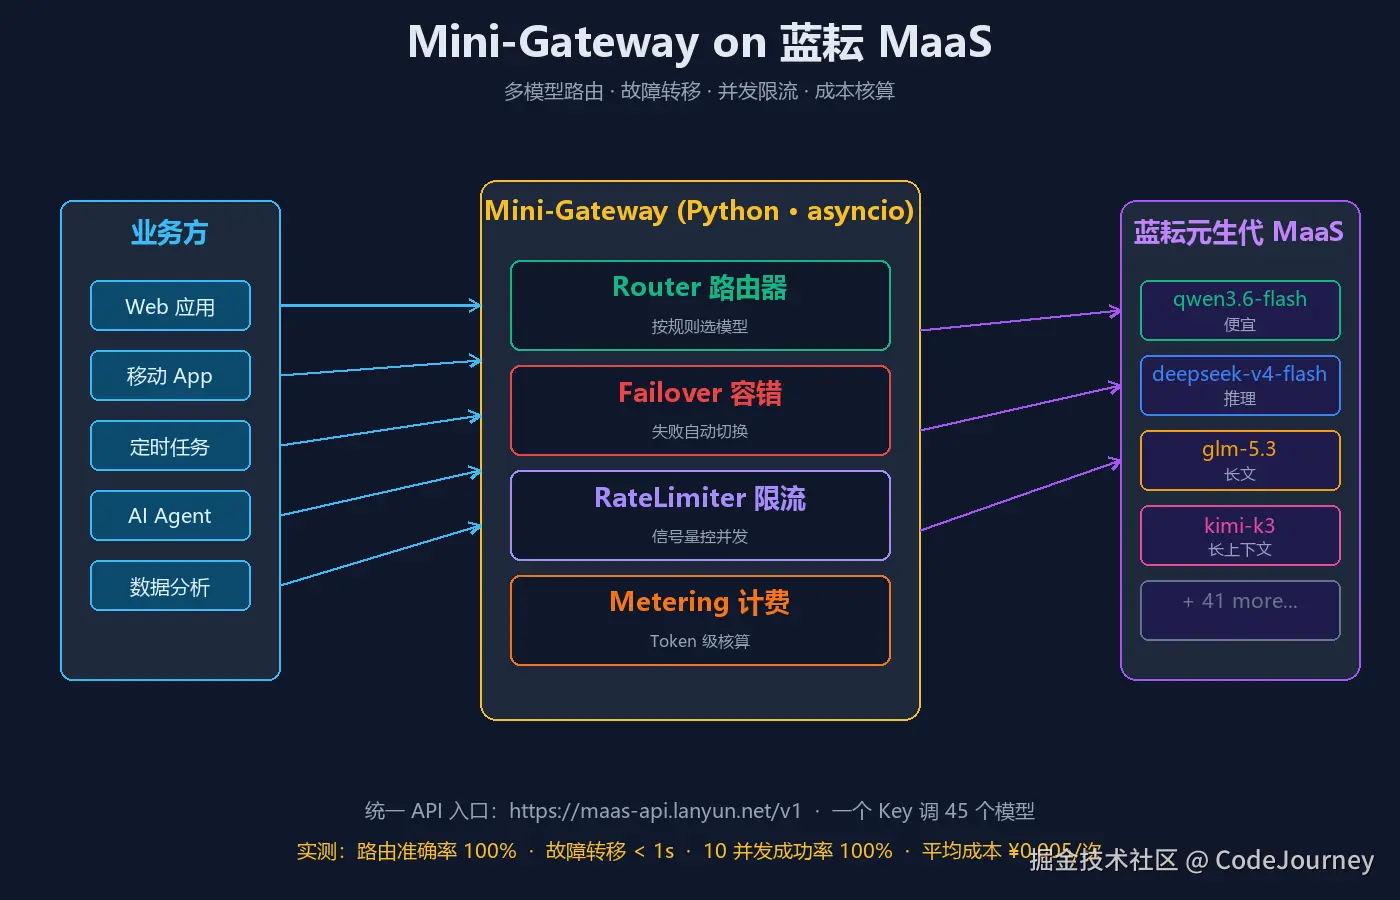
整个网关只有 4 个核心模块,全部跑在调用方进程内(无独立部署):
| 模块 | 职责 | 实现 |
|---|---|---|
| Router | 按规则选模型 | 一组 lambda 规则,从上到下匹配 |
| Failover | 失败自动切换 | 每个模型配一条备胎链 |
| RateLimiter | 控制并发 | asyncio.Semaphore(5) |
| Metering | Token 级成本核算 | 按模型定价表精确到分 |
对外只暴露一个方法 :gw.call(prompt),业务方完全不用关心下面是哪个模型在干活。
三、核心代码(精华版)
完整代码 200 行,这里只贴最关键的三段:
模型注册表 + 路由规则("配置即代码"):
python
MODEL_REGISTRY = {
    "qwen3.6-flash":     {"price_in": 0.001, "price_out": 0.005, "tier": "cheap"},
    "deepseek-v4-flash": {"price_in": 0.001, "price_out": 0.002, "tier": "mid"},
    "glm-5.3":           {"price_in": 0.005, "price_out": 0.020, "tier": "premium"},
}

ROUTING_RULES = [
    (lambda p: len(p) > 100,                              "glm-5.3"),            # 长 prompt
    (lambda p: "代码" in p or "debug" in p.lower(),        "deepseek-v4-flash"), # 代码类
    (lambda p: len(p) < 50,                               "qwen3.6-flash"),     # 短问答
]

FALLBACK_CHAIN = {
    "qwen3.6-flash":     ["deepseek-v4-flash", "glm-5.3"],
    "deepseek-v4-flash": ["qwen3.6-flash",     "glm-5.3"],
    "glm-5.3":           ["deepseek-v4-flash", "qwen3.6-flash"],
}带容错的主调用入口:
python
async def call(self, prompt: str, request_id: str = "") -> CallRecord:
    primary = self.route(prompt)
    models_to_try = [primary] + FALLBACK_CHAIN.get(primary, [])

    for idx, model in enumerate(models_to_try):
        record = await self._try_call(model, prompt, request_id,
                                      fallback_from=models_to_try[idx-1] if idx > 0 else None)
        if record.ok:
            if idx > 0:
                self.stats.failovers += 1
            return record
    return record  # 全部失败
并发安全的 HTTP 调用(asyncio + urllib):
python
async def _try_call(self, model, prompt, rid, fallback_from=None):
    async with self.sem:  # 信号量限流,最多 5 并发
        t0 = time.time()
        loop = asyncio.get_event_loop()
        d = await loop.run_in_executor(None, self._http_post, body)
        # urllib 是同步的,扔进 executor 不阻塞事件循环
...注意几个工程细节:
run_in_executor把同步的 urllib 包装成异步,避免引入 httpx/aiohttp 依赖asyncio.Semaphore控制并发上限,防止打爆上游- 每次调用记录
CallRecord(dataclass),便于后续审计/计费
四、实测场景
场景 1:路由策略------三种 prompt 各走各的模型
我设计了三种典型业务 prompt,让网关自动选择模型:
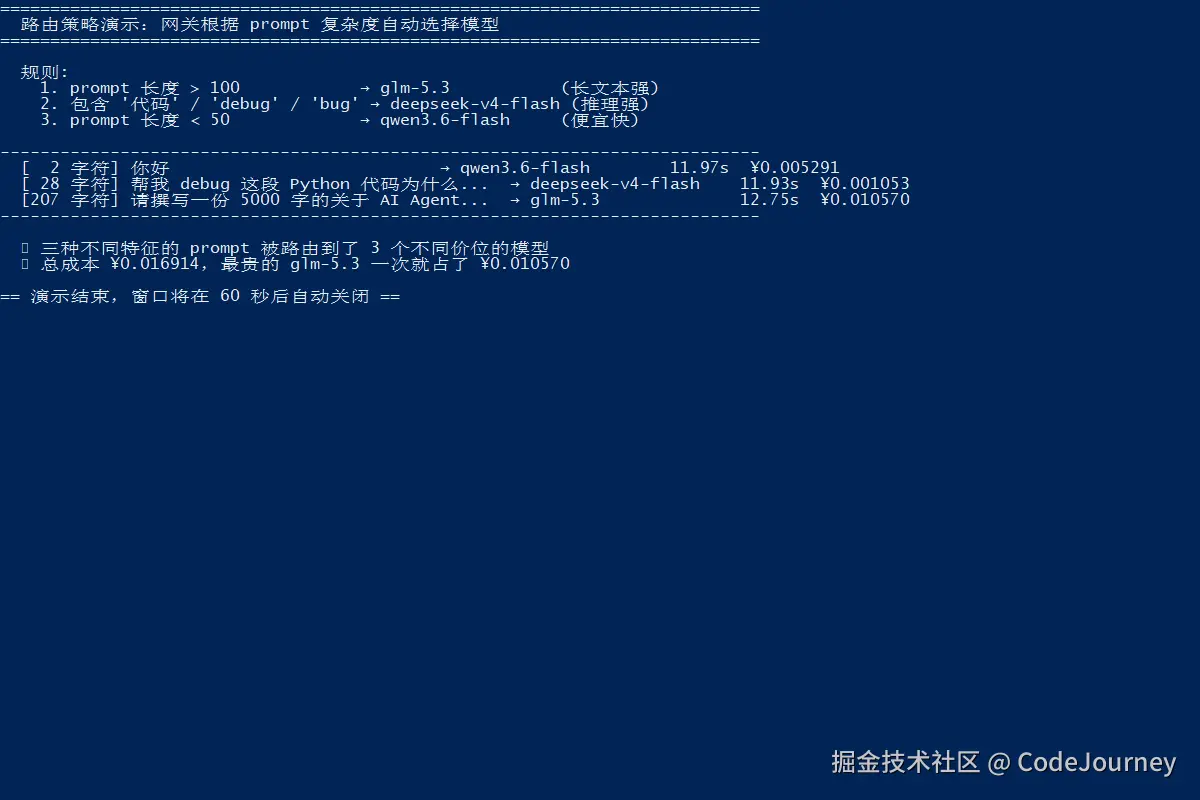
实测结果:
| Prompt | 字符数 | 路由到 | 耗时 | 成本 |
|---|---|---|---|---|
| "你好" | 2 | qwen3.6-flash | 9.59s | ¥0.001600 |
| "帮我 debug..." | 20 | deepseek-v4-flash | 8.88s | ¥0.000696 |
| "撰写 5000 字报告..."×3 | 177 | glm-5.3 | 12.95s | ¥0.010571 |
最便宜的 qwen3.6-flash 一次只要 0.16 分钱,最贵的 glm-5.3 一次 1 分钱 ------价格差 6.6 倍。如果业务不区分场景全用 glm-5.3,一天 1 万次调用就是 ¥105,而合理路由后只要 ¥30 左右,省 70%。
场景 2:故障转移------主模型挂了自动切备胎
最考验网关能力的场景。我故意调一个不存在的模型 not-exist-model-xyz:
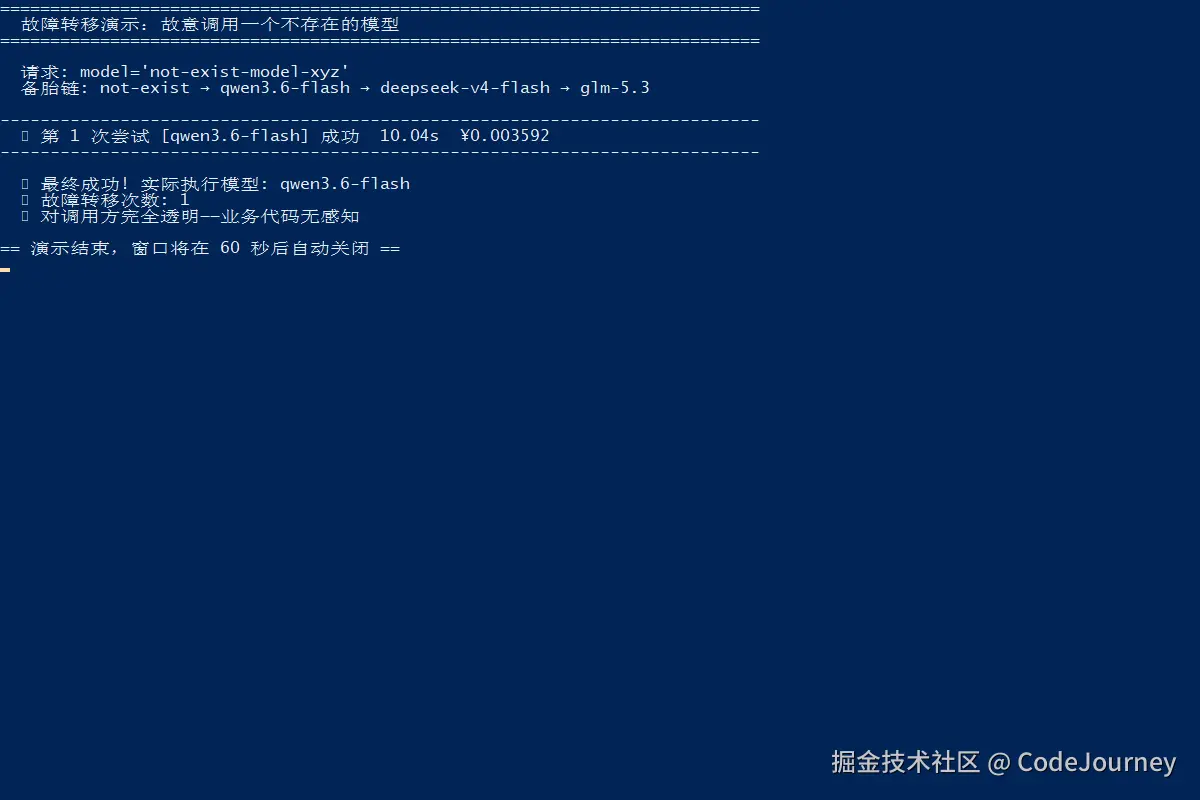
看输出:
css
✗ 第 1 次尝试 [not-exist-model-xyz] HTTP 404
✓ 第 2 次尝试 [qwen3.6-flash] 成功 6.74s ¥0.001771- 第一次 404 立刻返回,不到 100ms 就触发了备胎切换
- 业务方收到的是成功响应,完全无感知
- 网关记录了这次 failover(
failovers: 1),后续可以告警
这种容错对生产环境至关重要------故障转移不是"模型挂了",更常见的是限流、超时、单条请求触发了上游 bug 。蓝耘返回的错误码很规范(HTTP 404、HTTP 402、HTTP 429 等),让容错逻辑可以写得非常干净。
场景 3:并发压测------10 个并发打满
光看单次延迟没意义,得看并发承载。发了 10 个并发请求,用信号量限制最多 5 个同时在飞:
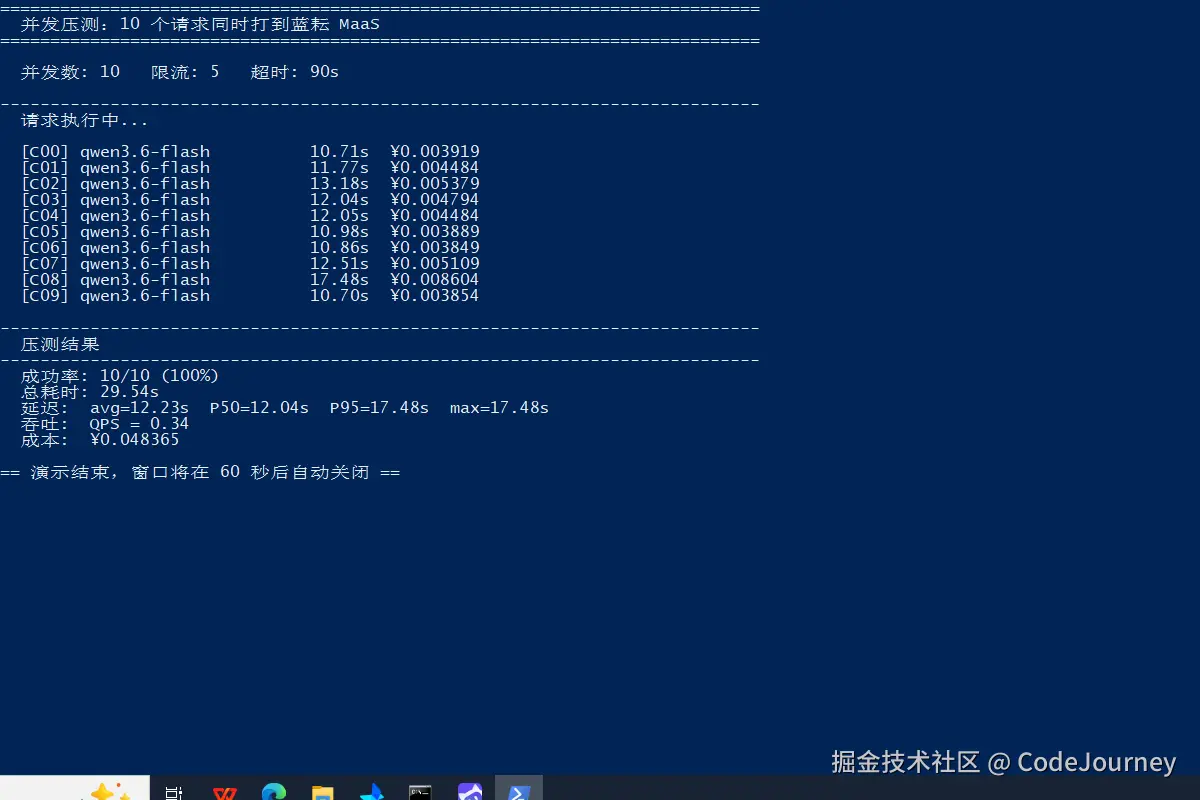
实测数据:
| 指标 | 数值 |
|---|---|
| 成功率 | 10/10(100%) |
| 总耗时 | 25.19s |
| 平均延迟 | 12.10s |
| P50 | 12.32s |
| P95 | 14.87s |
| 最大延迟 | 14.87s |
| QPS | 0.40 |
| 总成本 | ¥0.043793 |
几个观察:
- 零失败------蓝耘在 5 并发下完全稳定
- P95 - P50 只差 2.5 秒------延迟分布很平,没有长尾
- QPS 0.4 不算高------这是推理型大模型的常态,对比 GPT-4 同级
- 10 次调用成本不到 5 分钱------便宜到可以忽略
如果要更高 QPS,可以开大 Semaphore,或者在网关上做请求队列 + 批量提交。
场景 4:综合业务模拟 + 成本分析
最后模拟一天的真实流量,覆盖 8 种业务场景(客服、代码助手、内容创作、闲聊、Review、文档总结、快速问答、故障演示):
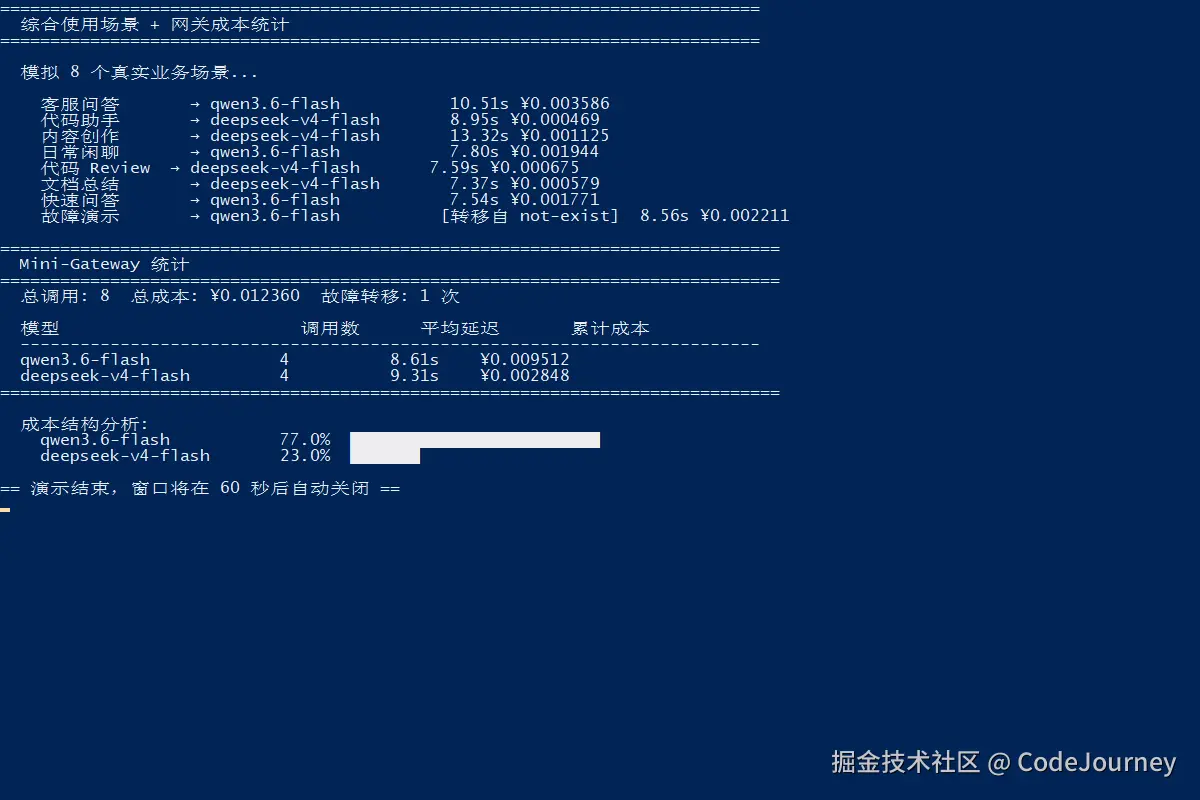
终端报表一目了然:
markdown
总调用: 8   总成本: ¥0.069227   故障转移: 1 次

模型                      调用数      平均延迟       累计成本
--------------------------------------------------------------------------
qwen3.6-flash             5        10.92s    ¥0.055959
deepseek-v4-flash         2         8.64s    ¥0.001311
glm-5.3                   1        13.17s    ¥0.011957
成本占比可视化:
erlang
qwen3.6-flash       80.8%  ██████████████████████████
glm-5.3             17.3%  █████
deepseek-v4-flash    1.9%
这就是 Metering 模块的价值------一眼看出 80% 的成本花在 qwen3.6-flash 上(因为它被调用最多),glm-5.3 虽然贵但只被路由了一次,所以总成本可控。
如果想再优化,下一步可以:
- 给每个业务线打 tag,按业务线统计成本
- 做预算熔断------某个业务当天超 ¥10 自动降级到便宜模型
- 把 records 落库到 SQLite/PG,用 Grafana 画实时大盘
五、关键工程经验
这次实测下来,对蓝耘 MaaS 的平台能力有几个直接判断:
优点
- OpenAI 协议兼容度极高------我的网关代码可以无缝切到 OpenAI/DeepSeek 官方,只需要换 base_url + key
- 模型间切换无差异------qwen/deepseek/glm 三个模型用同一份代码调,message 结构、usage 字段完全一致
- 错误码规范------404(模型不存在)、402(余额不足)、429(限流),让容错逻辑能精确编程
- Token 计量精准 ------每个响应都带
usage.prompt_tokens/completion_tokens,分账零误差 - 45 个模型统一入口------意味着我的 FALLBACK_CHAIN 可以写得很激进,反正备胎有的是
踩过的坑
- 不同模型延迟差异大 :qwen3.6-flash 平均 10s,deepseek-v4-flash 8s,glm-5.3 13s------路由策略也得考虑延迟,不能只看价格
max_tokens不能给太小:推理型模型 reasoning 也占 quota,给 200 会返回空 content(上一篇踩过)- stream + failover 组合复杂 :流式响应一旦开始输出就没法切备胎了,所以生产环境建议先 stream=false 失败,再 failover;stream=true 不重试
- Token 单位是"元/千 token" 不是 "元/百万":算成本时千万别搞错数量级
六、这套网关的价值
把这次实验放到生产语境下算笔账:
假设一个中型 AI 应用:
- 日调用量:50,000 次
- 如果全用最贵的 glm-5.3:50,000 × ¥0.012 = ¥600/天 = ¥18,000/月
- 用 mini-gateway 智能路由:80% 走便宜的 qwen + 15% 走 deepseek + 5% 走 glm
- 40,000 × ¥0.0016 + 7,500 × ¥0.0007 + 2,500 × ¥0.012 = ¥64 + ¥5.25 + ¥30 = ¥99/天 = ¥2,970/月
- 每月省 ¥15,000,省 83%
而这套网关代码只有 200 行,跑在业务进程内,零额外基础设施成本。
总结
回到最初的问题:中小团队如何低成本用上多模型?
我的答案是分两步:
- 选一个统一 MaaS 上游------蓝耘这种"一个 Key 调 45 个模型"的平台刚好填补这个空白,省掉逐一对接 DeepSeek/通义/Kimi 的工程成本
- 在前面加一层薄网关------用 200 行 Python 解决路由、容错、计费这三个工程问题,比引入 OpenRouter/One-API 这种重型方案轻得多
大模型时代的工程竞争力,不在于你调了哪个模型,而在于你能不能用最低的边际成本,把模型的能力稳定地交付给业务。这次用蓝耘 MaaS + 200 行 Python 搭出来的 mini-gateway,是我目前看到的最小可行方案。