一、MySQL、文件系统与磁盘
在Linux文件系统的学习中已磁盘相关内容,其中提到如何在硬件层面上定位到一个数据块(磁盘扇区)
文件系统要读取磁盘,是以块为单位的,基本单位是 4KB。而MySQL和文件系统是以16KB为单位交互的,MySQL也以16KB(page)进行数据读取。间接地,MySQL实质上每次从磁盘上读取16KB的数据。
拓展:局部性原理
以page为单位读取,有概率page后半部分已经不是需要的数据了,为什么不缩小读取的数据块大小呢?因为这个概率是很小的(因为16KB相对于大部分文件而言都是小的),同时以16KB而非更小的数据块读取,能大大减少IO次数,从而提高效率。M
Buffer Pool
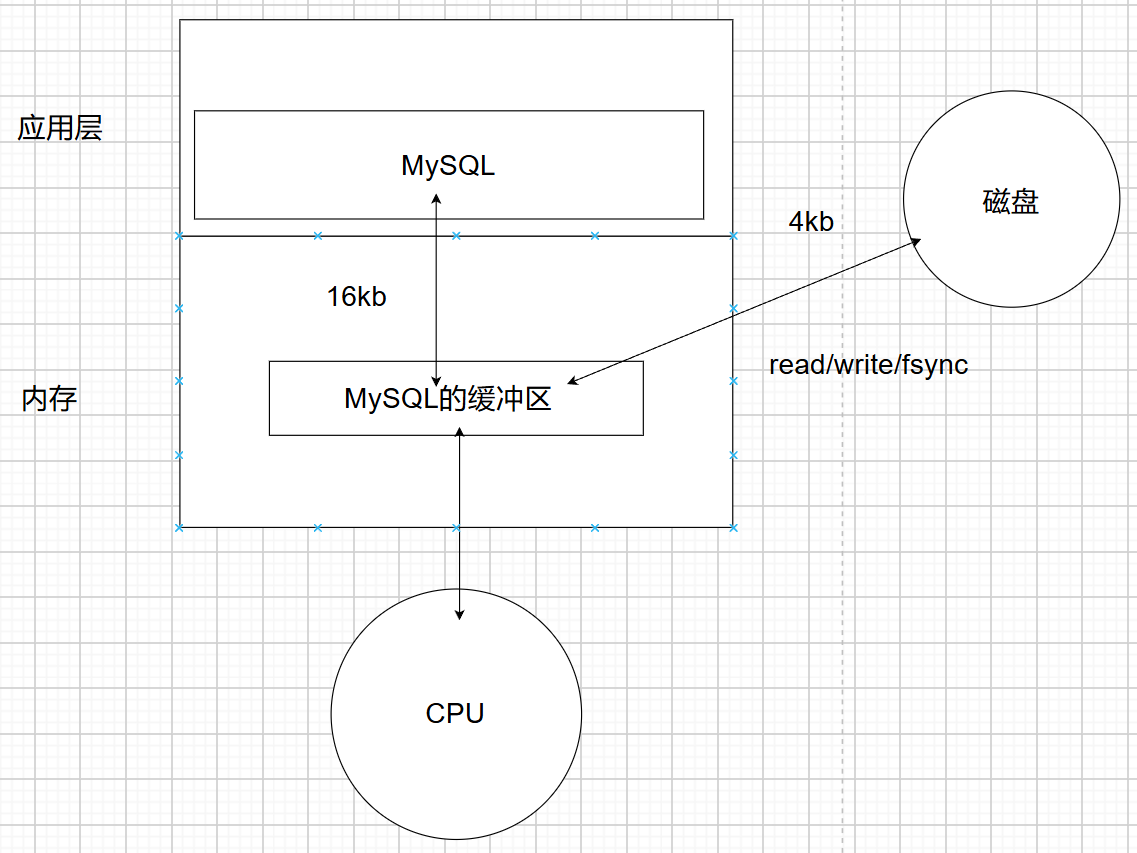
MySQL 服务器执行 CRUD 操作必然涉及计算,但要让 CPU 处理数据,MySQL需要先将数据接收到内存中,CPU 处理完后再写回内存,最后通过文件系统调用write写入+fsync刷新到磁盘。可见在同一时间,内存和磁盘当中都会存在数据,而内存与磁盘设备之间的数据搬运就称为磁盘 IO。
磁盘IO的成本是高的,要提高效率就要减少IO的磁盘IO的次数,结合前文不难想到,MySQL启动时会先向内存申请一大块空间(Buffer Pool),以page为单位存储数据,此后每次CRUD都尽量和内存打交道而非磁盘:
当执行一条
SELECT查询时,MySQL先去检查内存中的Buffer Pool:
缓存命中:如果需要的数据页已经在Buffer Pool里,CPU 会直接从内存中读取并返回结果,整个过程完全不需要访问磁盘,速度极快。
缓存未命中:如果内存中没有,MySQL 才会去磁盘把包含该数据页加载到 Buffer Pool 中,然后再返回给客户端。下次再查同样的数据,就直接从内存拿了。
当执行INSERT、UPDATE或DELETE时,MySQL 同样不会直接去改磁盘上的文件:修改内存页:CPU 会直接在 Buffer Pool 中找到对应的数据页并进行修改。修改后,这个数据页在内存中就会和磁盘上的不一致,此时它会被标记为"脏页(Dirty Page)"。
写重做日志:为了保证数据不丢失,InnoDB会先把这次修改操作记录到日志缓冲区,然后写入磁盘的Redo Log 中。
后台异步刷盘:被标记为脏页的数据,不会立刻写回磁盘。InnoDB 会在后台通过专门的线程,定期或批量地将这些脏页刷新到磁盘上。
内存的读写速度比磁盘快几个数量级,因此这种模式大幅减少了磁盘IO的次数,提高了效率。
二、索引
MySQL还通过索引减少磁盘IO次数,下面讲解索引原理。
1.单page
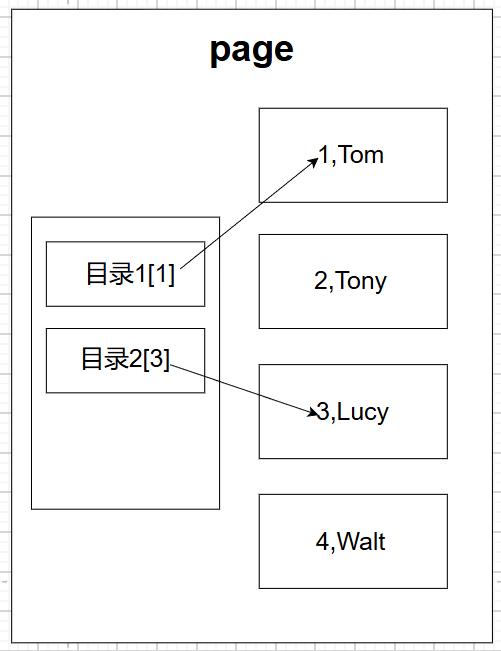
page内的数据是以链式结构存储的,通过引入页目录可快速查找page内的数据,所谓"目录",就是按顺序查找,比如目录1指向的是主键为1的数据,目录2指向主键为3的数据,因此每次插入数据时会自动按照主键排好序,就是为了方便排序。
2.多page
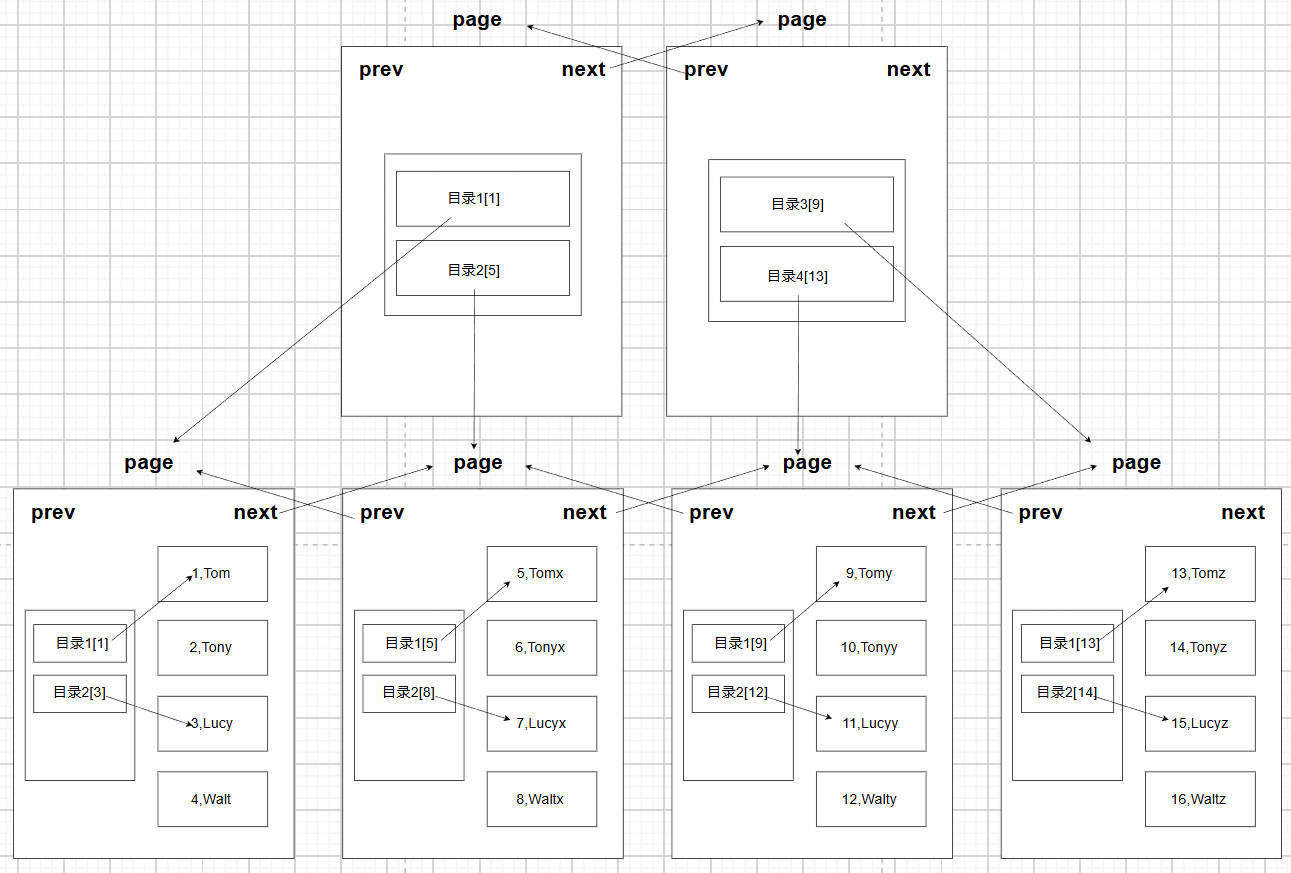
同样采用链式结构对多个page进行管理,因此同样可以引入page间目录,page间目录指向的是每个page存放数据的最小主键。快速寻找目标数据在哪个page上。当page目录数量太多时,又可以再引入目录对这些目录做管理,以此类推。
虽然目录作为page需要占用空间资源,但显而易见要到磁盘中查找每个数据时不是线性遍历,而是从顶层开始从左到右定位需要的范围,找到下层对应位置后从该处位置继续左向右定位,以此类推,实际上这种结构的实际查找次数是非常少的,因此是非常划算的,这种结构就叫做索引。
不难看出,这套结构本质就是B+树,那其它数据结构能否实现这样的效果呢?
使用B+树,可以使得除叶子节点以外的上层路径节点不带数据,只有指向下一层page的目录,正好符合我们的预期。
如果用二叉搜索树或红黑树,层数肯定会很多(毕竟上层每个page只能指向下层的两个page)因此遍历次数也比B+树多,意味着更多的磁盘IO次数。其它数据结构在这方面多少有不足,这里不详述。
3.为其它列建立索引
MySQL默认用主键创建索引,也就是目录中按主键查找(如果用户没有为表指定主键,MySQL也会默认生成隐藏主键用于维持B+树结构)下面是主键索引的特点:
- 一个表中,最多有一个主键索
- 主键索引的效率高(主键不可重复)
- 创建主键索引的列,它的值不能为null,且不能重复
- 主键索引的列基本上是int
如果其它列也需高频查询,也可以为其创建索引,如果该列数据具有唯一性,则在建表时使用唯一键约束,MySQL也会为其创建唯一索引。下面是唯一索引的特点:
- 一个表中,可以有多个唯一索引
- 查询效率高(唯一键不可重复)
- 如果在某一列建立唯一索引,必须保证这列不能有重复数据
- 如果一个唯一索引上指定not null,等价于主键索引
如果不具有唯一性,也可使用index(列名)为其创建普通索引。下面是普通索引的特点:
- 普通索引的特点: 一个表中可以有多个普通索引,普通索引在实际开发中用的比较多
- 如果某列需要创建索引,但是该列有重复的值,那么我们就应该使用普通索引
4.聚簇索引与非聚簇索引
前文种叶子节点存放数据的索引称为聚簇索引,如果叶节点的data域存放的是数据记录的地址,也就是数据和数据结构本身分离,这种索引就叫做非聚簇索引。在前面的学习中,我们提到数据库可以采用不同的存储引擎,InnoDB采用的就是聚簇索引,而MyISAM采用的就是非聚簇索引。
在聚簇索引机制下,如果为其他列创建索引,称为二级索引,相应的会新建一个按照该列查找的B+树,但叶子节点就没有必要再放整行数据了(主键索引B+树已经存好了)所以叶子节点存的是该列某行对应的值以及该行主键值。比如某表有ID,姓名,和住址,为姓名创建的二级索引B+树的叶子节点存放姓名+ID。如果通过姓名来查询住址,查到姓名后再用一起存放的ID回到主键索引找到对应的完整数据,进而得到住址,这就叫做回表。
在MyISAM中,无论是主键索引还是普通辅助索引,它们的结构逻辑是完全一样的,叶子节点都只存物理地址。查询时,数据库先通过索引找到物理地址,然后再去数据文件中读取完整记录即可。