文章目录
- 前言
- 零、论文基本信息
- 一、背景:为什么"把记忆放进上下文"仍然不够
-
- [1. 参数记忆:记住了经验,也可能改坏原来的模型](#1. 参数记忆:记住了经验,也可能改坏原来的模型)
- [2. 检索式记忆:能读到过去,却未必能消化过去](#2. 检索式记忆:能读到过去,却未必能消化过去)
- [3. 潜在记忆:从"人类可读文本"转向"机器原生表示"](#3. 潜在记忆:从“人类可读文本”转向“机器原生表示”)
- [二、相关工作:MemGen 与哪些方向最接近](#二、相关工作:MemGen 与哪些方向最接近)
-
- [1. Agent Memory](#1. Agent Memory)
- [2. Latent Computation](#2. Latent Computation)
- [3. 与 Pause Token 的区别](#3. 与 Pause Token 的区别)
- 三、问题形式化:记忆系统到底在优化什么
- [四、MemGen 方法总览](#四、MemGen 方法总览)
- [五、Memory Trigger:学习何时想起](#五、Memory Trigger:学习何时想起)
-
- [1. 为什么不能在每个 token 后都调用记忆](#1. 为什么不能在每个 token 后都调用记忆)
- [2. 用隐藏状态而不是文本判断认知状态](#2. 用隐藏状态而不是文本判断认知状态)
- [3. 只在语义边界激活](#3. 只在语义边界激活)
- [4. Trigger 的稀疏奖励](#4. Trigger 的稀疏奖励)
- [六、Memory Weaver:把经验重构成潜在记忆](#六、Memory Weaver:把经验重构成潜在记忆)
-
- [1. Weaver 生成的不是可读摘要](#1. Weaver 生成的不是可读摘要)
- [2. 为什么称为"生成式记忆"](#2. 为什么称为“生成式记忆”)
- [3. Weaver 如何吸收经验](#3. Weaver 如何吸收经验)
- [4. 两阶段训练顺序](#4. 两阶段训练顺序)
- 七、与外部检索记忆的结合
- 八、实验设置
-
- [1. 数据集与任务](#1. 数据集与任务)
- [2. Backbone 与 Baseline](#2. Backbone 与 Baseline)
- [3. 关键训练配置](#3. 关键训练配置)
- [九、主实验:MemGen 是否真的优于参数记忆和检索式记忆](#九、主实验:MemGen 是否真的优于参数记忆和检索式记忆)
-
- [1. SmolLM3-3B 结果](#1. SmolLM3-3B 结果)
- [2. Qwen3-8B 结果](#2. Qwen3-8B 结果)
- [3. 一个需要纠正的正文数字](#3. 一个需要纠正的正文数字)
- [十、跨域泛化:Trigger 是否真的会避开不熟悉的任务](#十、跨域泛化:Trigger 是否真的会避开不熟悉的任务)
- [十一、持续学习:冻结 Reasoner 是否减少遗忘](#十一、持续学习:冻结 Reasoner 是否减少遗忘)
- 十二、潜在记忆到底学到了什么
-
- [1. 潜在记忆会按领域形成不同分布](#1. 潜在记忆会按领域形成不同分布)
- [2. 通过删除记忆簇观察功能](#2. 通过删除记忆簇观察功能)
- 十三、消融实验
-
- [1. Trigger 是否必要](#1. Trigger 是否必要)
- [2. Weaver 容量](#2. Weaver 容量)
- [3. Weaver 是否只是让模型"多想几步"](#3. Weaver 是否只是让模型“多想几步”)
- [4. 潜在记忆长度](#4. 潜在记忆长度)
- 十四、外部检索融合实验
- 十五、效率分析
- [十六、与 Agent Memory 系列方法的横向比较](#十六、与 Agent Memory 系列方法的横向比较)
- [十七、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十七、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:在错误发生点调用程序性记忆](#1. Coding Agent:在错误发生点调用程序性记忆)
- [2. Tool Agent:把记忆调用与异常边界绑定](#2. Tool Agent:把记忆调用与异常边界绑定)
- [3. Multi-Agent:让记忆成为私有的协作接口](#3. Multi-Agent:让记忆成为私有的协作接口)
- [4. 混合记忆架构可能比纯潜在记忆更现实](#4. 混合记忆架构可能比纯潜在记忆更现实)
- 十八、局限性与证据边界
-
- [1. "不修改模型"并不准确](#1. “不修改模型”并不准确)
- [2. 潜在记忆难以审计](#2. 潜在记忆难以审计)
- [3. "人类式记忆层级"主要来自事后解释](#3. “人类式记忆层级”主要来自事后解释)
- [4. 泛化实验仍可能受到长度与格式影响](#4. 泛化实验仍可能受到长度与格式影响)
- [5. Baseline 的训练预算不完全透明](#5. Baseline 的训练预算不完全透明)
- [6. 缺少统计显著性](#6. 缺少统计显著性)
- [7. 代码发布仍不完整](#7. 代码发布仍不完整)
- [8. 表述和数字存在若干不一致](#8. 表述和数字存在若干不一致)
- 十九、我的理解与启发
-
- [1. MemGen 真正改变的是记忆的"接口"](#1. MemGen 真正改变的是记忆的“接口”)
- [2. Trigger 可能比 Weaver 更具有长期价值](#2. Trigger 可能比 Weaver 更具有长期价值)
- [3. 不可读并不自动等于更高级](#3. 不可读并不自动等于更高级)
- [4. 最有前景的是"双记忆系统"](#4. 最有前景的是“双记忆系统”)
- 二十、总结
- 参考资料
前言
一个 Agent 做错任务之后,应该怎样把这次经历变成下一次可用的记忆?
现有方法通常有两条路线。
第一条路线是把经验写进模型参数。SFT、GRPO、DPO 等训练方法都属于这一类。它的好处是经验真正进入了模型,但代价也明显:更新整个推理模型成本高,新任务还可能覆盖旧能力,造成灾难性遗忘。
第二条路线是把经验保存在模型外部。Mem0、A-MEM、ExpeL、AWM 等系统把对话、轨迹、总结或技能写入数据库,需要时再检索并拼进上下文。这条路线不需要改动基础模型,却很依赖检索质量与 Prompt 组织,而且记忆通常只在任务开始或每个环境步骤开始时注入,难以参与一句推理内部的动态修正。
MemGen 选择了第三条路:冻结负责推理的 Reasoner,只训练一个 Memory Trigger 和一个 Memory Weaver;前者在生成过程中决定何时需要记忆,后者根据当前隐藏状态生成一小段潜在向量,并把它直接织入后续推理。
这也是本文相对于已有方法的唯一核心增量:
MemGen 把 Agent Memory 从"任务开始前检索一次的外部上下文",改造成"在 token 生成过程中按需触发、即时重构并回注的潜在认知过程"。
这篇论文值得关注,不只是因为它在多个基准上取得了较高分数,更因为它重新回答了一个基础问题:记忆到底应该是被读取的数据,还是推理过程中可以随当前认知状态不断重构的计算?
零、论文基本信息
- 论文名称: MemGen: Weaving Generative Latent Memory for Self-Evolving Agents
- 发表平台: ICLR 2026 Conference Paper
- 代码仓库: https://github.com/bingreeky/MemGen
- 作者: Guibin Zhang、Muxin Fu、Shuicheng Yan
一、背景:为什么"把记忆放进上下文"仍然不够
1. 参数记忆:记住了经验,也可能改坏原来的模型
参数记忆把历史经验编译进模型权重。假设 Agent 在一批 Web、代码或具身任务上获得成功轨迹,就可以使用 SFT 或 RL 更新策略:
θ ← Optimize ( θ , H ) \theta \leftarrow \operatorname{Optimize}(\theta,\mathcal{H}) θ←Optimize(θ,H)
其中, θ \theta θ 是 Agent 的模型参数, H \mathcal{H} H 是历史经验。
这种方式的优势是推理时不需要额外检索,经验已成为模型的一部分。但它同时有三个问题:
- 每次吸收新经验都要更新 Reasoner;
- 新数据可能覆盖旧知识;
- 经验被分散进权重后,很难控制它何时参与推理。
因此,参数记忆更像"重新塑造大脑",而不是为模型增加一个可调用的记忆器官。
2. 检索式记忆:能读到过去,却未必能消化过去
检索式系统通常执行如下流程:
q → Retrieve ( q , M e x t ) → c → π θ ( a ∣ q , c ) q \rightarrow \operatorname{Retrieve}(q,\mathcal{M}{ext}) \rightarrow c \rightarrow \pi\theta(a\mid q,c) q→Retrieve(q,Mext)→c→πθ(a∣q,c)
q q q 是当前任务, M e x t \mathcal{M}_{ext} Mext 是外部记忆库, c c c 是检索结果。
这种方法避免了频繁修改模型参数,但检索出来的内容依旧是文本。Agent 需要在有限上下文中自行辨别哪些内容有用、如何组合以及何时使用。检索结果如果过长、冲突或与当前推理阶段不匹配,就会从帮助变成干扰。
更重要的是,许多系统只在任务开始时检索一次。可是 Agent 真正需要记忆的时机,可能出现在推理中途:
- 搜索 API 失败后,需要回想另一种搜索策略;
- 代码已经写到一半,才发现某个边界条件;
- 多步数学推理中间,需要恢复之前总结的约束;
- 工具返回异常格式后,需要调用关于解析规则的程序性经验。
静态的一次性检索很难精确覆盖这些时刻。
3. 潜在记忆:从"人类可读文本"转向"机器原生表示"
论文把 Agent Memory 分为三种范式:参数记忆、检索式记忆和潜在记忆。
为了理解 MemGen 的位置,需要先看论文对三类方法的整体比较。
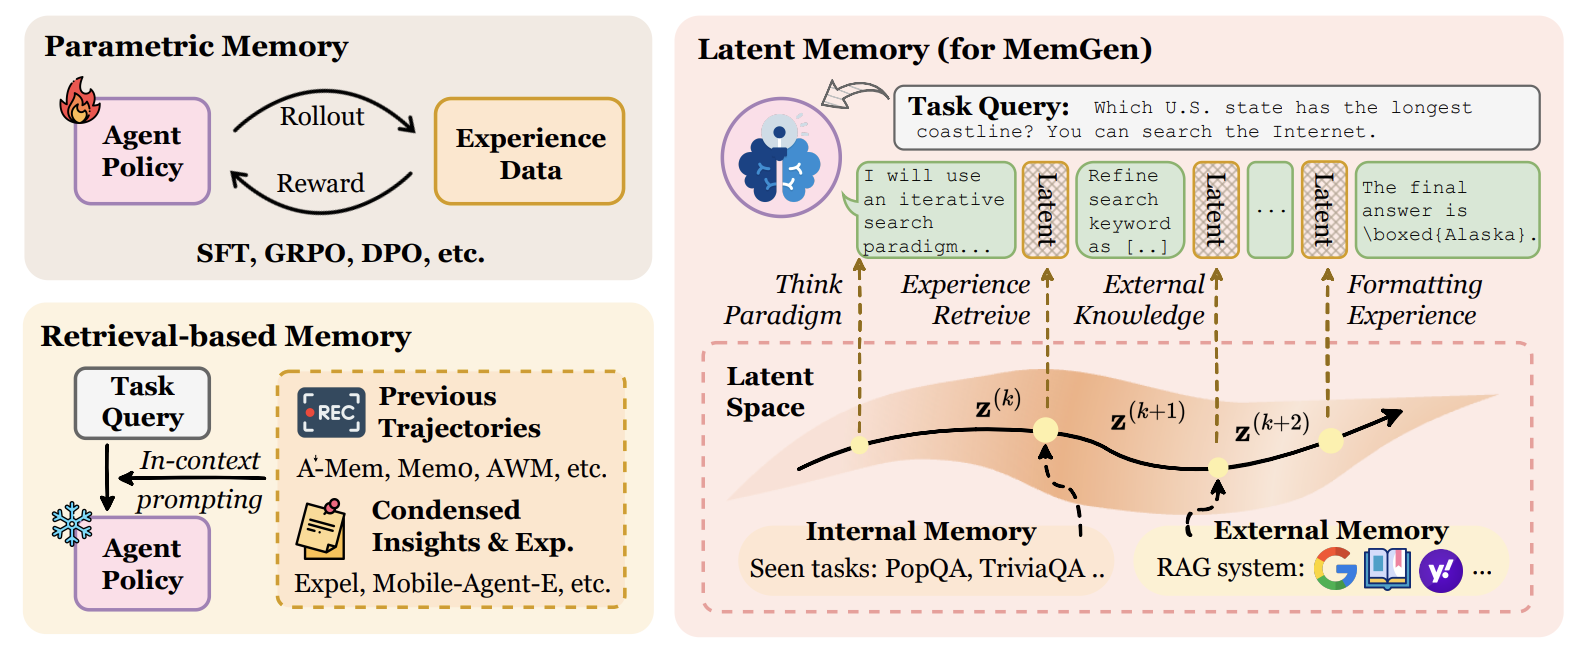
Figure 1:参数记忆、检索式记忆与 MemGen。 左侧展示参数更新和外部检索两类传统范式,右侧展示 MemGen 如何在推理流中同时吸收内部经验与外部知识,并将其重构为潜在记忆。
传统外部记忆保存的是人类可读的文本、轨迹或技能;MemGen 生成的则是 K K K 个隐藏向量。它不要求这些向量能够被解码成人类语言,只要求它们能够改变冻结 Reasoner 的后续计算。
这带来一个关键转变:
外部记忆强调"找到哪段历史",MemGen 强调"当前推理状态需要怎样的内部干预"。
二、相关工作:MemGen 与哪些方向最接近
1. Agent Memory
论文将面向 Agent 自我提升的记忆进一步分成三类:
- 参数记忆: FireAct、AgentLumos 等把轨迹写入模型参数;
- 检索式记忆: ExpeL、AWM、MemoryBank 等保存可检索经验或技能;
- 潜在记忆: 用隐藏表示编码和调用经验。
MemGen 属于第三类,但与已有潜在记忆的区别是:它不只存储潜在表示,还把"何时生成记忆"和"如何根据当前状态重构记忆"放进同一个在线推理循环。
2. Latent Computation
Coconut、CODI、LatentR3 等方法让模型直接在连续空间中推理;SoftCoT、LatentSeek、Coprocessor 等则通过潜在表示调节文本生成。
MemGen 与这些工作共享"隐藏状态可以承担计算"的假设,但目标不同:它不是单纯延长思考,也不是把 Chain-of-Thought 压缩成向量,而是把过去经验变成一个可在推理中多次调用的潜在记忆模块。
3. 与 Pause Token 的区别
Pause Token 让模型在不输出文本的情况下多做几步内部计算。它能够增加计算预算,却使用固定、与上下文无关的特殊 token。
MemGen 的 Weaver 则根据当前隐藏状态生成不同向量:
M t = W weaver ( H t , < j ) M_t=W_{\text{weaver}}(H_{t,<j}) Mt=Wweaver(Ht,<j)
因此二者的根本区别不是"是否暂停输出",而是暂停之后得到的是固定计算槽位,还是上下文相关的重构记忆。论文在 Table 9 中专门验证了这一点。
三、问题形式化:记忆系统到底在优化什么
设环境为 E \mathcal{E} E,LLM Agent 的策略为 π θ \pi_\theta πθ。给定任务 x x x,Agent 与环境产生轨迹:
τ = ( s 0 , a 0 , s 1 , a 1 , ... , s T ) \tau=(s_0,a_0,s_1,a_1,\dots,s_T) τ=(s0,a0,s1,a1,...,sT)
s t s_t st 是环境状态, a t a_t at 是 Agent 在第 t t t 步采取的高层动作。每个动作本身又是一串自回归生成的 token:
a t = ( z t , 1 , z t , 2 , ... , z t , L t ) a_t=(z_{t,1},z_{t,2},\dots,z_{t,L_t}) at=(zt,1,zt,2,...,zt,Lt)
第 j j j 个 token 的基础生成过程为:
z t , j ∼ π θ ( ⋅ ∣ s t , z t , < j ) z_{t,j}\sim \pi_\theta(\cdot\mid s_t,z_{t,<j}) zt,j∼πθ(⋅∣st,zt,<j)
给定历史经验:
H = { ( x i , τ i ) } i = 1 N \mathcal{H}=\{(x_i,\tau_i)\}_{i=1}^{N} H={(xi,τi)}i=1N
论文希望联合策略和记忆系统,最大化新任务上的期望回报:
max θ , M E x ∼ D , τ ∼ π θ , M R ( τ ) \max_{\theta,\mathcal{M}} \mathbb{E}{x\sim\mathcal{D},\tau\sim\pi{\theta,\mathcal{M}}} R(\\tau) θ,MmaxEx∼D,τ∼πθ,MR(τ)
记忆系统产生表示 m t m_t mt,并参与动作生成:
a t ∼ π θ ( ⋅ ∣ s t , m t ) a_t\sim \pi_\theta(\cdot\mid s_t,m_t) at∼πθ(⋅∣st,mt)
所有记忆范式的差异,都可以写成记忆生成函数:
m t = f M ( s t , H , m < t ) m_t=f_\mathcal{M}(s_t,\mathcal{H},m_{<t}) mt=fM(st,H,m<t)
- 任务级记忆只在 t = 0 t=0 t=0 调用一次;
- 步骤级记忆在每次环境交互后更新;
- 参数记忆把 H \mathcal{H} H 隐式编译到 θ \theta θ;
- MemGen 进一步把调用粒度细化到 token 生成过程,由系统自行判断何时重构记忆。
四、MemGen 方法总览
下面这张图是理解全文的核心。它把系统拆成 Reasoner、Trigger 和 Weaver 三部分,并展示了普通生成与记忆插入两条路径。
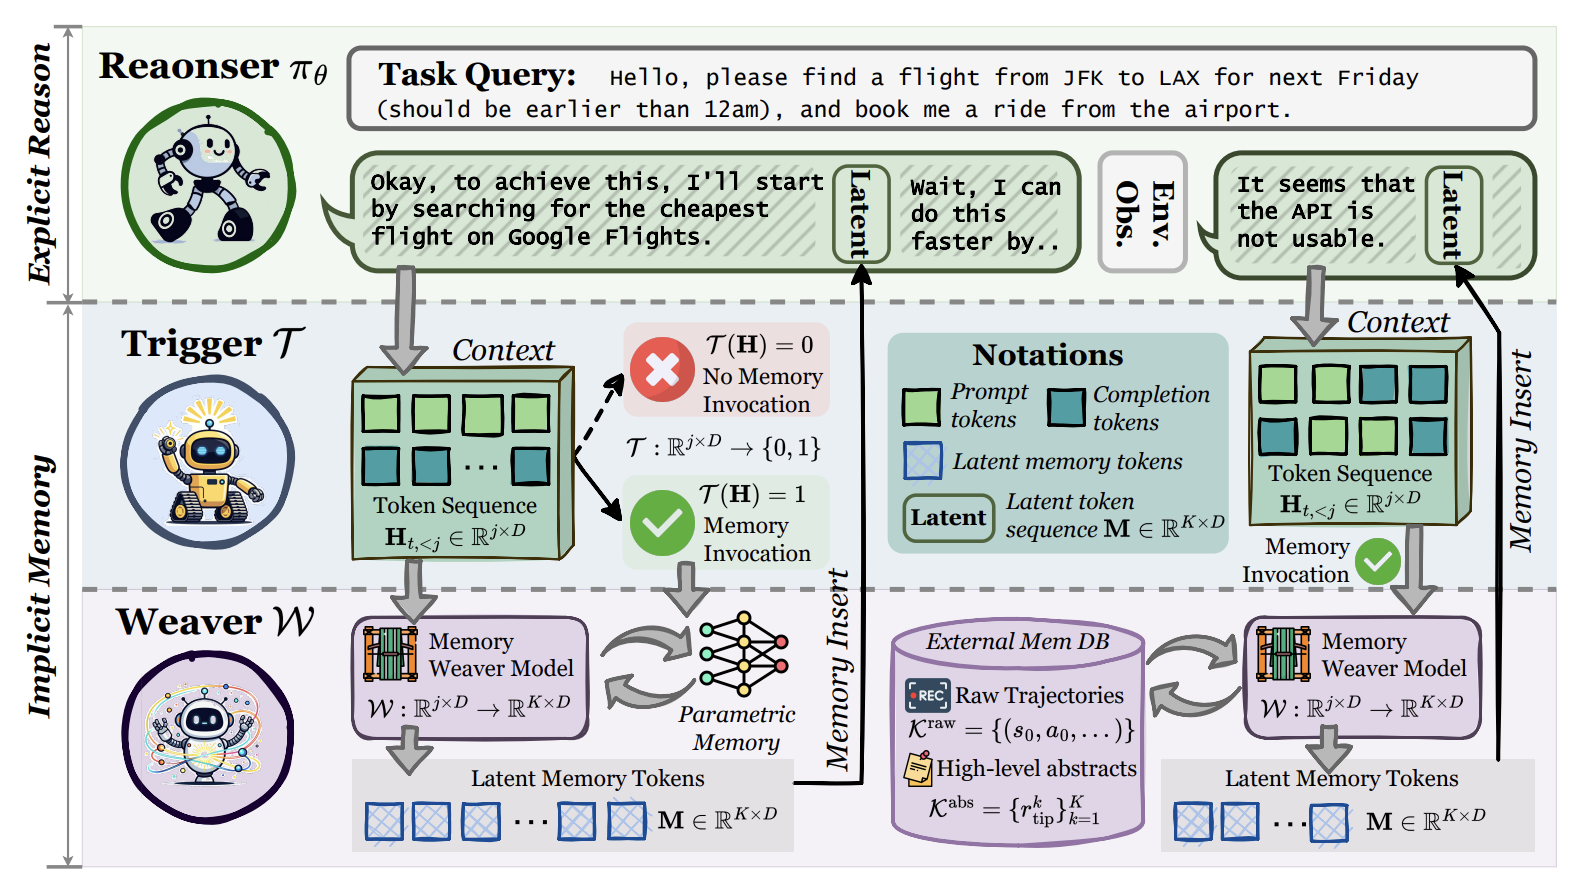
Figure 2:MemGen 方法总览。 冻结的 Reasoner 持续生成 token;Trigger 在语义边界判断是否调用记忆;Weaver 根据当前隐藏状态以及可选的外部检索结果生成潜在记忆,再将其插回推理流。
三个组件分别承担不同职责:
- Reasoner π θ \pi_\theta πθ: 负责正常推理和行动,训练 MemGen 时保持冻结;
- Memory Trigger T trigger T_{\text{trigger}} Ttrigger: 判断当前是否到了需要记忆的关键节点;
- Memory Weaver W weaver W_{\text{weaver}} Wweaver: 根据当前认知状态生成 K K K 个潜在记忆 token。
整体循环是:
- Reasoner 生成文本;
- 到达候选语义边界;
- Trigger 输出 INVOKE 或 SKIP;
- 若为 INVOKE,暂停 Reasoner;
- Weaver 读取当前隐藏状态并生成潜在记忆;
- 将记忆向量拼入隐藏序列;
- Reasoner 在增强后的状态上继续生成。
与 RAG 的"检索---拼接---一次生成"不同,这个循环可以在同一条轨迹中发生多次。
五、Memory Trigger:学习何时想起
1. 为什么不能在每个 token 后都调用记忆
如果每一步都调用 Weaver,系统不仅计算成本高,还会让无关记忆持续扰动推理。如果完全依赖随机调用,则可能错过真正需要回忆的节点。
因此,Trigger 的目标不是"尽可能多地调用",而是寻找少量关键时刻。
2. 用隐藏状态而不是文本判断认知状态
Reasoner 在生成第 j j j 个 token 前,已有隐藏状态序列:
H t , < j = ( h t , 1 , h t , 2 , ... , h t , j − 1 ) H_{t,<j}=(h_{t,1},h_{t,2},\dots,h_{t,j-1}) Ht,<j=(ht,1,ht,2,...,ht,j−1)
其中 h t , k ∈ R d m o d e l h_{t,k}\in\mathbb{R}^{d_{model}} ht,k∈Rdmodel。
Trigger 计算调用概率:
p j = σ ( T trigger ( H t , < j ) ) p_j=\sigma\left(T_{\text{trigger}}(H_{t,<j})\right) pj=σ(Ttrigger(Ht,<j))
再采样二元决策:
d j ∼ Bernoulli ( p j ) , d j ∈ { INVOKE , SKIP } d_j\sim\operatorname{Bernoulli}(p_j),\qquad d_j\in\{\text{INVOKE},\text{SKIP}\} dj∼Bernoulli(pj),dj∈{INVOKE,SKIP}
论文选择隐藏状态,是因为它包含 softmax 解码之前更丰富的上下文信号。换句话说,Trigger 观察的不是"模型刚才说了什么",而是"模型当前内部正在怎样表示问题"。
3. 只在语义边界激活
为了控制成本,Trigger 不在每个 token 上运行,而只在标点符号等分隔符处做决策。设分隔符集合为 D \mathcal{D} D:
p j = { 0 , z j ∉ D T trigger ( H t , < j ) , z j ∈ D p_j= \begin{cases} 0,&z_j\notin\mathcal{D}\\ T_{\text{trigger}}(H_{t,<j}),&z_j\in\mathcal{D} \end{cases} pj={0,Ttrigger(Ht,<j),zj∈/Dzj∈D
直觉上,句号、逗号或一个推理片段结束的位置更适合干预:此时语义单元相对完整,插入记忆不容易破坏正在形成的局部结构。
4. Trigger 的稀疏奖励
Trigger 使用强化学习训练。只奖励最终任务成功,会诱导它频繁调用 Weaver;完全禁止高频调用,又可能错过必要记忆。论文用高回报轨迹中的平均调用率作为自适应参考。
先取一组中回报不低于中位数的轨迹:
H h i g h = { i : R ( τ i ) ≥ median k R ( τ k ) } \mathcal{H}_{high}=\{i:R(\tau_i)\geq \operatorname{median}_k R(\tau_k)\} Hhigh={i:R(τi)≥mediankR(τk)}
再计算这些成功轨迹的平均调用率:
p ˉ = 1 ∣ H h i g h ∣ ∑ i ∈ H h i g h 1 ∣ τ i ∣ ∑ j d ~ i , j \bar p= \frac{1}{|\mathcal{H}{high}|} \sum{i\in\mathcal{H}{high}} \frac{1}{|\tau_i|}\sum_j \tilde d{i,j} pˉ=∣Hhigh∣1i∈Hhigh∑∣τi∣1j∑d~i,j
最终优化目标为:
max ϕ E R ( τ i ) − λ ∑ i , j max ( 0 , d \~ i , j − p ˉ ) \max_\phi \mathbb{E} \left R(\\tau_i)-\\lambda\\sum_{i,j}\\max(0,\\tilde d_{i,j}-\\bar p) \\right ϕmaxER(τi)−λi,j∑max(0,d\~i,j−pˉ)
ϕ \phi ϕ 是 Trigger 的 LoRA 参数, λ \lambda λ 控制稀疏惩罚。
由于 d i , j d_{i,j} di,j 是二元值,这个惩罚可以理解为:当调用频率超过成功轨迹体现出的必要水平时,对额外调用收费。
论文实际使用 GRPO 风格的组内相对优势训练 Trigger,每个任务采样 G = 8 G=8 G=8 条轨迹:
A i ( g ) = R ( τ i ( g ) ) − μ i σ i A_i^{(g)}= \frac{R(\tau_i^{(g)})-\mu_i}{\sigma_i} Ai(g)=σiR(τi(g))−μi
这让 Trigger 学习"同一个任务上哪些调用决策带来了更好的相对结果",而不是依赖跨任务不可比的绝对奖励。
六、Memory Weaver:把经验重构成潜在记忆
1. Weaver 生成的不是可读摘要
当 Trigger 输出 INVOKE,Weaver 接收当前隐藏状态,并生成固定长度为 K K K 的潜在记忆矩阵:
M t = m t , 1 , m t , 2 , ... , m t , K = W weaver ( H t , < j ) M_t=m_{t,1},m_{t,2},\\dots,m_{t,K} =W_{\text{weaver}}(H_{t,<j}) Mt=mt,1,mt,2,...,mt,K=Wweaver(Ht,<j)
其中:
M t ∈ R K × d m o d e l M_t\in\mathbb{R}^{K\times d_{model}} Mt∈RK×dmodel
这些向量经线性层对齐到 Reasoner 的 token embedding 空间,然后被前置到当前隐藏状态中。Reasoner 随后生成:
z t , j ∼ π θ ( ⋅ ∣ s t , z t , < j , M t ) z_{t,j}\sim \pi_\theta(\cdot\mid s_t,z_{t,<j},M_t) zt,j∼πθ(⋅∣st,zt,<j,Mt)
因此,Weaver 不是先生成一段文字再让 Reasoner 阅读,而是直接改变下一步计算所看到的隐藏上下文。
2. 为什么称为"生成式记忆"
检索系统从数据库中选出已有条目;Weaver 则把当前认知状态作为刺激,从自身训练过的参数中重构一个新表示。即使面对相同任务经验,不同推理位置也可以得到不同的 M t M_t Mt。
更准确地说,它学习的是一个条件记忆生成器:
P ( M t ∣ H t , < j ) P(M_t\mid H_{t,<j}) P(Mt∣Ht,<j)
这并不意味着它能凭空获得历史中没有的信息,而是意味着经验不再以固定文本片段的形式被原样回放。
3. Weaver 如何吸收经验
Weaver 同样由挂载在 Reasoner 上的 LoRA 实例化,但与 Trigger 使用独立参数。训练时 Reasoner 保持冻结,只更新 Weaver 的参数 θ ′ \theta' θ′:
max θ ′ E ( x i , τ i ) ∼ H E τ ∼ Π θ W θ ′ , T ( ⋅ ∣ x i ) R ( x i , τ ) \max_{\theta'} \mathbb{E}{(x_i,\tau_i)\sim\mathcal{H}} \mathbb{E}{\tau\sim\Pi_\theta^{W_{\theta'},T}(\cdot\mid x_i)} R(x_i,\\tau) θ′maxE(xi,τi)∼HEτ∼ΠθWθ′,T(⋅∣xi)R(xi,τ)
论文实现了两种版本。
MemGen-SFT
给定专家轨迹 τ i ∗ \tau_i^* τi∗,Weaver 学习生成能让冻结 Reasoner 复现正确 token 的潜在记忆:
L S F T ( θ ′ ) = − E ( x i , τ i ∗ ) ∼ H ∑ t ∑ j log π θ ( z i , t , j ∗ ∣ s i , t , z i , t , \< j ∗ , M i , t , j ) \mathcal{L}{SFT}(\theta')=- \mathbb{E}{(x_i,\tau_i^*)\sim\mathcal{H}} \left \\sum_t\\sum_j \\log\\pi_\\theta(z_{i,t,j}\^\*\\mid s_{i,t},z_{i,t,\
梯度虽然经过冻结 Reasoner 的生成结果计算,但只更新 Weaver。
MemGen-GRPO
对于每个任务采样一组轨迹 G i \mathcal{G}_i Gi,先计算组内平均回报:
R ˉ ( G i ) = 1 K ∑ k = 1 K R ( τ i , k ) \bar R(\mathcal{G}i)=\frac{1}{K}\sum{k=1}^{K}R(\tau_{i,k}) Rˉ(Gi)=K1k=1∑KR(τi,k)
轨迹优势为:
A ( τ i , k ) = R ( τ i , k ) − R ˉ ( G i ) A(\tau_{i,k})=R(\tau_{i,k})-\bar R(\mathcal{G}_i) A(τi,k)=R(τi,k)−Rˉ(Gi)
再优化带 KL 约束的组相对目标。这里真正被优化的仍然只是 Weaver,而不是 Reasoner。
4. 两阶段训练顺序
MemGen 不是同时从零训练 Trigger 与 Weaver,而是采用两阶段流程:
- 先训练 Weaver: 此时 Trigger 尚不可用,于是在标点位置随机插入潜在记忆;
- 再训练 Trigger: 冻结已经训练好的 Weaver,让 Trigger 学习哪些时刻调用它最有价值。
这个顺序很重要。如果 Weaver 还不会生成有用记忆,Trigger 就无法从最终回报中判断调用是否有效;反过来,先让 Weaver 具备基本能力,再训练调用策略,奖励信号会更稳定。
但它也带来训练---推理分布差异:Weaver 在随机插入位置上学习,最终却由已训练 Trigger 选择位置。论文没有给出联合微调两者是否能进一步改善这一差距。
七、与外部检索记忆的结合
MemGen 并不排斥外部数据库。当 Trigger 决定调用记忆时,系统可以把当前已生成文本解码成查询:
q t , j = Decode ( z t , < j ) q_{t,j}=\operatorname{Decode}(z_{t,<j}) qt,j=Decode(zt,<j)
然后从外部记忆库检索:
C t = R ( q t , j ; M e x t ) C_t=\mathcal{R}(q_{t,j};\mathcal{M}_{ext}) Ct=R(qt,j;Mext)
把检索文本编码为 E t E_t Et 后,与当前隐藏状态一起输入 Weaver:
M t = W weaver ( H t , \< j ; E t ) M_t=W_{\text{weaver}}(H_{t,\
这里 Weaver 承担了一个很有价值的角色:它不是把检索结果原样塞给 Reasoner,而是把外部文本和当前认知状态压缩、融合成一组潜在记忆。
换句话说,MemGen 可以位于 RAG 与 Reasoner 之间,充当"记忆消化器"。
八、实验设置
1. 数据集与任务
论文覆盖五类任务:
- Web 搜索: TriviaQA、PopQA;
- 具身行动: ALFWorld;
- 数学推理: AQuA、GSM8K、MATH;
- 科学推理: GPQA;
- 代码生成: KodCode、BigCodeBench。
主结果表覆盖除 AQuA 外的八个基准,AQuA 出现在持续学习实验中,因此正文按九个基准表述。会议网页摘要写的是八个基准,正式 PDF 摘要和实验正文之间存在口径差异;笔记以正式 PDF 的实验章节为准。
训练与测试规模如下:
| 数据集 | 训练规模 | 测试规模 | 备注 |
|---|---|---|---|
| ALFWorld | 3.32K | 134 | AgentBank-ALFWorld |
| TriviaQA | 4.13K | 7.9K | AgentBank-TriviaQA |
| PopQA | - | 14.3K | 直接迁移 TriviaQA 模型 |
| KodCode | 8K | 2K | KodCode-Light-RL-10K |
| BigCodeBench | 912 | 228 | - |
| GPQA | 448 | 198 | 测试使用 GPQA-Diamond |
| GSM8K | 7.47K | 1K | - |
| MATH | 1.6K | 500 | - |
Table 2:数据集统计。 展示主实验使用的训练集、测试集规模以及数据来源。
PopQA 没有独立训练集,论文直接使用 TriviaQA 上训练的模型评估,这一点实际上同时构成一次跨数据集迁移测试。
2. Backbone 与 Baseline
论文使用三种规模的基础模型:
- Qwen2.5-1.5B;
- SmolLM3-3B;
- Qwen3-8B。
Baseline 分为四组:
- Prompt:Vanilla、CoT;
- 参数记忆:SFT、GRPO、REINFORCE、REINFORCE++、Agent-FLAN;
- 检索式记忆:MemoryBank、ExpeL、AWM;
- 潜在计算:SoftCoT、Coprocessor。
3. 关键训练配置
Weaver 和 Trigger 的 LoRA 默认设置为:
- rank r = 16 r=16 r=16;
- α = 32 \alpha=32 α=32;
- target modules 为 q_proj、v_proj;
- dropout 为 0.1;
- 学习率 10 − 5 10^{-5} 10−5;
- 训练 2 个 epoch。
GRPO 的 rollout batch size 与 train batch size 都为 8,论文表中 β = 0 \beta=0 β=0,意味着该配置实际上没有启用参考策略 KL 惩罚。
九、主实验:MemGen 是否真的优于参数记忆和检索式记忆
1. SmolLM3-3B 结果
| 方法 | ALFWorld | TriviaQA | PopQA | KodCode | BigCodeBench | GPQA | GSM8K | MATH |
|---|---|---|---|---|---|---|---|---|
| Vanilla | 18.96 | 10.47 | 8.23 | 37.05 | 35.96 | 9.35 | 47.63 | 16.22 |
| SFT | 32.36 | 55.25 | 37.22 | 59.25 | 40.79 | 19.70 | 63.48 | 45.65 |
| GRPO | 55.35 | 65.88 | 45.16 | 68.48 | 72.44 | 22.73 | 80.03 | 61.23 |
| REINFORCE++ | 53.95 | 63.20 | 44.10 | 65.90 | 68.80 | 22.73 | 81.50 | 59.89 |
| ExpeL | 36.18 | 46.20 | 28.16 | 51.14 | 40.22 | 15.15 | 56.23 | 38.11 |
| MemoryBank | 32.80 | 43.30 | 25.81 | 44.50 | 31.80 | 10.20 | 58.30 | 43.53 |
| AWM | 40.50 | 49.80 | 29.60 | - | - | - | - | - |
| SoftCoT | 35.03 | 50.38 | 34.90 | 59.20 | 39.10 | 17.22 | 56.34 | 44.62 |
| Coprocessor | 38.36 | 53.28 | 38.96 | 56.25 | 45.40 | 20.10 | 57.60 | 38.81 |
| MemGen-SFT | 50.60 | 68.13 | 42.34 | 62.65 | 42.99 | 26.75 | 70.42 | 57.44 |
| MemGen-GRPO | 63.60 | 79.30 | 58.60 | 72.85 | 74.24 | 25.20 | 83.47 | 63.65 |
Table 1(SmolLM3-3B):八个主基准结果。 MemGen-GRPO 在七项中取得表内最高值,GPQA 则由 MemGen-SFT 取得最高值。
最明显的提升出现在 ALFWorld:MemGen-GRPO 从 Vanilla 的 18.96 提升到 63.60,增加 44.64 个百分点;相对最强非 MemGen baseline GRPO 也提高 8.25 个百分点。
TriviaQA 和 PopQA 上也有较大增益,说明潜在记忆不只适用于封闭式数学题,还能帮助搜索型 Agent 调整查询和利用工具返回。
不过需要注意,MemGen-SFT 并非处处优于直接 SFT。例如 PopQA 上它是 42.34,低于 GRPO 的 45.16,也只比 SFT 高 5.12;BigCodeBench 上 MemGen-SFT 为 42.99,远低于 GRPO 的 72.44。真正稳定领先的是 MemGen-GRPO,而不只是架构本身。
2. Qwen3-8B 结果
| 方法 | ALFWorld | TriviaQA | PopQA | KodCode | BigCodeBench | GPQA | GSM8K | MATH |
|---|---|---|---|---|---|---|---|---|
| Vanilla | 58.93 | 52.18 | 34.13 | 49.10 | 33.33 | 38.18 | 89.48 | 79.82 |
| SFT | 83.59 | 74.55 | 51.12 | 64.75 | 41.33 | 40.33 | 90.76 | 81.35 |
| GRPO | 85.60 | 76.15 | 58.90 | 73.35 | 70.24 | 39.54 | 92.30 | 83.54 |
| REINFORCE++ | 84.80 | 75.90 | 58.30 | 72.90 | 71.88 | 37.68 | 91.90 | 85.24 |
| ExpeL | 78.97 | 65.54 | 40.33 | 57.20 | 34.23 | 35.15 | 86.20 | 77.40 |
| MemoryBank | 70.41 | 60.56 | 41.60 | 56.39 | 40.61 | 35.66 | 90.35 | 80.35 |
| AWM | 80.33 | 69.30 | 43.69 | - | - | - | - | - |
| SoftCoT | 75.60 | 59.42 | 39.42 | 63.28 | 38.27 | 39.60 | 86.30 | 76.23 |
| Coprocessor | 73.28 | 61.42 | 45.55 | 64.90 | 42.19 | 39.15 | 76.23 | 79.20 |
| MemGen-SFT | 85.82 | 77.22 | 54.65 | 66.15 | 40.35 | 43.23 | 91.25 | 83.30 |
| MemGen-GRPO | 90.60 | 80.65 | 62.30 | 76.16 | 75.56 | 40.24 | 93.20 | 88.24 |
Table 1(Qwen3-8B):八个主基准结果。 MemGen-GRPO 在七项中领先,MemGen-SFT 在 GPQA 上取得最高值。
随着 Backbone 变强,MemGen 依然有效,但绝对提升有所收缩。例如 ALFWorld 从 Vanilla 到 MemGen-GRPO提升 31.67 个百分点,仍然显著,却低于 3B 模型上的 44.64 个百分点。
这符合直觉:强模型本身已具有更好的规划和工具使用能力,额外记忆的边际收益会降低。但 Qwen3-8B 的 KodCode 仍从 49.10 提升到 76.16,说明潜在记忆并非只是在补偿小模型能力不足。
3. 一个需要纠正的正文数字
论文主文解释 Table 1 时写道:AWM 在 SmolLM3-3B 的 ALFWorld 上达到 36.18,并比 SFT 高 3.15。
但正式表格中:
- AWM 是 40.50;
- 36.18 属于 ExpeL;
- SFT 是 32.36;
- AWM 相对 SFT 应高 8.14,而不是 3.15。
这不改变 MemGen 的总体领先结论,但说明分析正文存在一次方法名与差值对应错误,引用数字时应以表格为准。
十、跨域泛化:Trigger 是否真的会避开不熟悉的任务
论文在单一数据集上训练 MemGen-SFT,再到不同域测试。下面的 Figure 3 展示在 ALFWorld 或 TriviaQA 上训练后,模型在四个任务上的迁移情况。
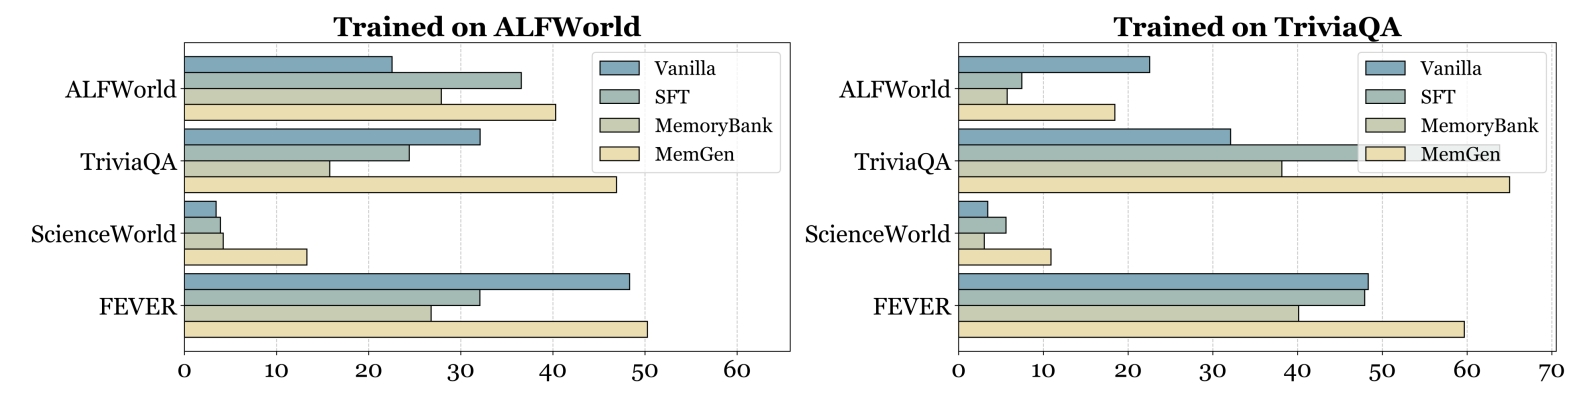
Figure 3:MemGen 跨域泛化。 分别在 ALFWorld 和 TriviaQA 上训练,然后测试 TriviaQA、ALFWorld、ScienceWorld 与 FEVER;MemGen 在训练域和部分未见域上都表现出更稳定的迁移。
论文还报告:在 KodCode 上训练时,KodCode 从 24.55 提升到 58.16,MATH 从 36.6 提升到 54.2;在 GSM8K 上训练时,GPQA 与 KodCode 也有不同程度增益。
作者给出的机制解释是 Trigger 会根据任务熟悉度调整调用频率。Figure 4 显示,同一个在 GSM8K 上训练的模型,在三个测试域上产生了不同的调用模式。
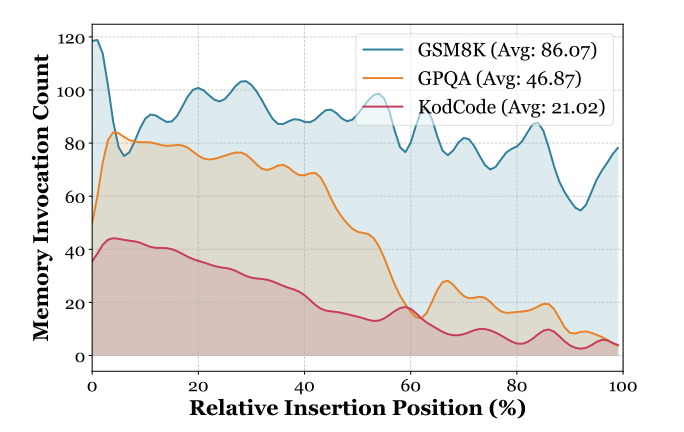
Figure 4:记忆调用频率。 使用 Qwen3-8B、在 GSM8K 上训练后,GSM8K 的平均调用次数最高,GPQA 居中,KodCode 最低。
在 150 个样本的子集上:
- GSM8K 平均调用 86.07 次,性能提升 19.64%;
- GPQA 平均调用 46.87 次,性能提升 6.06%;
- KodCode 平均调用 21.02 次,性能提升 3.1%。
这组相关性支持"Trigger 会在陌生域少调用"的解释,但尚不能证明因果关系。性能较高的任务也可能产生更长、更规则的推理,从而提供更多标点候选位置;论文没有把调用次数按输出长度或候选分隔符数量归一化。
因此,更稳妥的结论是:Trigger 的行为会随任务域发生变化,并与收益大小相关;是否真正学习到了域冲突规避,还需要长度控制和强制调用干预实验。
十一、持续学习:冻结 Reasoner 是否减少遗忘
论文按 AQuA → GPQA → GSM8K → KodCode 顺序训练,并在每个阶段评估四个任务。
| 训练到的阶段 | 方法 | AQuA | GPQA | GSM8K | KodCode |
|---|---|---|---|---|---|
| 初始 | Vanilla | 41.34 | 11.62 | 39.51 | 24.55 |
| AQuA | SFT | 42.52 | 16.67 | 42.10 | 18.20 |
| ExpeL | 41.73 | 12.67 | 40.16 | 16.30 | |
| MemGen-SFT | 43.31 | 19.70 | 39.80 | 19.55 | |
| GPQA | SFT | 38.55 | 17.17 | 45.74 | 18.50 |
| ExpeL | 37.24 | 14.35 | 42.67 | 15.20 | |
| MemGen-SFT | 39.85 | 20.72 | 47.96 | 28.80 | |
| GSM8K | SFT | 33.46 | 13.13 | 52.31 | 19.45 |
| ExpeL | 34.89 | 12.42 | 48.78 | 13.65 | |
| MemGen-SFT | 38.43 | 21.72 | 55.67 | 19.75 | |
| KodCode | SFT | 28.61 | 2.53 | 24.14 | 54.10 |
| ExpeL | 27.14 | 6.23 | 31.44 | 48.35 | |
| MemGen-SFT | 40.34 | 20.09 | 53.72 | 52.95 |
Table 5:持续学习结果。 Qwen2.5-1.5B 依次学习四个数据集,MemGen 在最后阶段明显保留了更多早期任务能力。
最有说服力的是最后一阶段:直接 SFT 到 KodCode 后,GPQA 从 11.62 降到 2.53,GSM8K 降到 24.14;MemGen 则保留 20.09 和 53.72。
这说明把新经验写进独立 Weaver,确实比直接更新 Reasoner 更能保护原能力。
但"无灾难性遗忘"仍然说得太满。Weaver 自身在连续训练时也可能遗忘,只是测试结果表明四个任务序列中的遗忘更小。论文没有与 rehearsal、adapter isolation、EWC 等专门持续学习方法比较,也没有给出更长任务序列。
十二、潜在记忆到底学到了什么
1. 潜在记忆会按领域形成不同分布
论文对生成的潜在记忆序列取平均表示,再用 t-SNE 降维,并用 K-means 聚类。
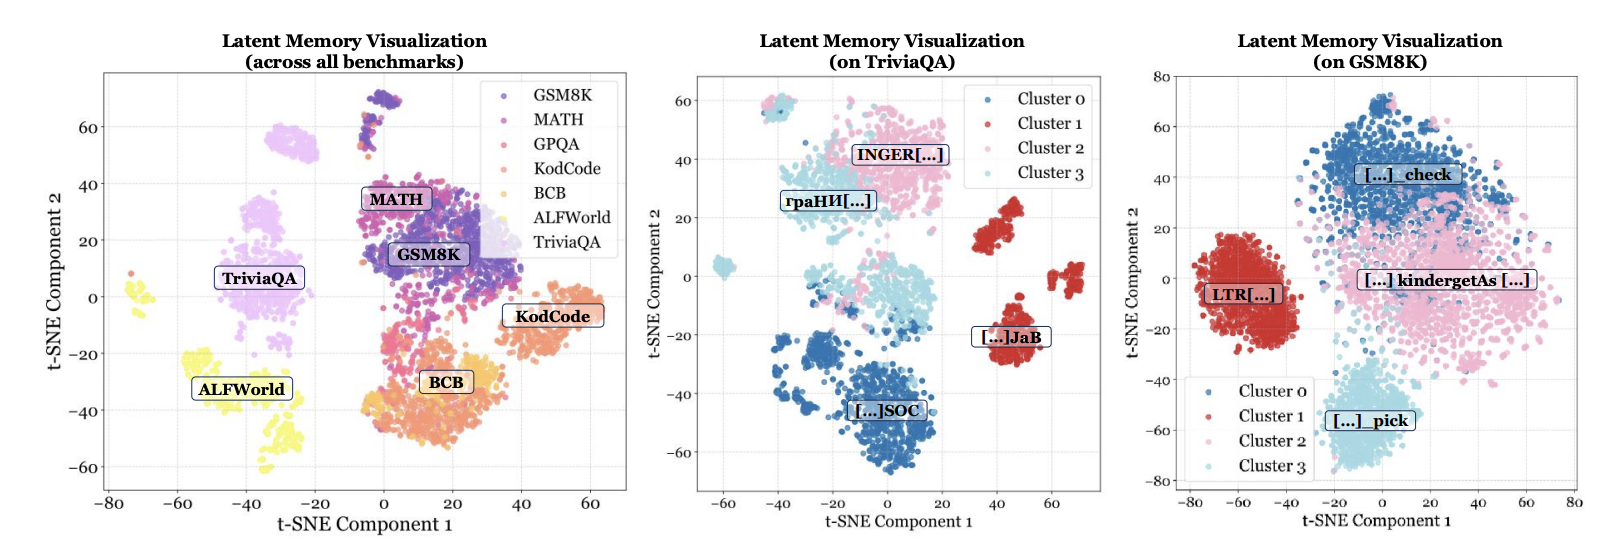
Figure 5:潜在记忆可视化。 左侧展示不同基准在隐藏空间中的分布;中间和右侧分别展示 TriviaQA、GSM8K 内部的潜在记忆聚类及强制解码后的共同 token 模式。
相关任务会靠得更近,例如 KodCode 与 BigCodeBench、GSM8K 与 MATH。强制把潜在向量解码为 token 后,得到的文本大多不可读,但同一簇会反复出现相似片段,如 _check、_pick。
这说明潜在记忆不是普通自然语言摘要,但 t-SNE 分簇本身不能证明它拥有明确语义。降维图容易放大局部结构,而强制解码得到相似字符串也可能只是向量邻近同一 vocabulary embedding。
2. 通过删除记忆簇观察功能
论文在 TriviaQA 上人工标注八类失败:规划失败、组合推理、工具解析、工具响应、答案格式、需求误解、思考---行动不一致和错误信念。
然后在推理时选择性过滤某一潜在记忆簇,观察哪些错误增加。
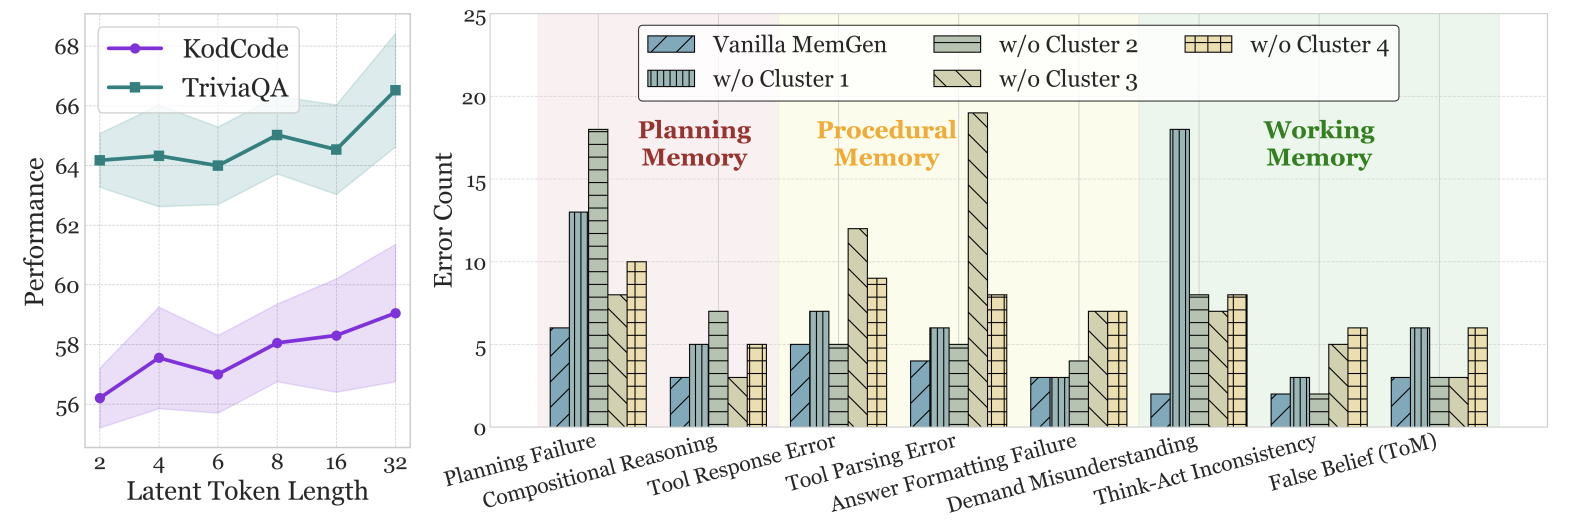
Figure 6:潜在记忆长度与功能消融。 左侧展示 K K K 从 2 增加到 32 时的性能变化;右侧展示删除不同潜在记忆簇后八类 Agent 错误数量的变化。
作者据此给出三类解释:
- 规划记忆: 删除 Cluster 2 后,规划和组合推理错误明显增加;
- 程序性记忆: 删除 Cluster 3 后,工具响应、解析和答案格式错误增多;
- 工作记忆: 删除 Cluster 1 或 4 后,需求误解和思考---行动不一致增多。
这里最重要的证据不是簇的名字,而是干预:删除某簇确实改变了特定错误类型。它比只看 t-SNE 更接近因果解释。
不过"自发形成了人类式记忆层级"仍应谨慎理解:
- 这些名称由研究者根据错误模式事后赋予;
- 各簇并不独立,删除 Cluster 1 也会影响规划;
- 失败标签来自人工标注,论文未报告标注人数、一致性或样本总量;
- 实验主要在 TriviaQA 上进行,不能直接外推到所有任务。
所以更准确的说法是:不同潜在记忆簇呈现出可区分但相互重叠的功能关联。
十三、消融实验
1. Trigger 是否必要
| 调用策略 | GPQA | KodCode | TriviaQA |
|---|---|---|---|
| Random, p = 0.2 p=0.2 p=0.2 | 15.66 | 54.55 | 63.55 |
| Random, p = 0.5 p=0.5 p=0.5 | 16.66 | 52.95 | 57.28 |
| Random, p = 0.8 p=0.8 p=0.8 | 12.63 | 53.60 | 62.22 |
| 所有分隔符都调用 | 17.34 | 56.20 | 64.15 |
| MemGen 专用 Trigger | 18.28 | 58.16 | 65.02 |
Table 6:不同记忆调用策略。 语义边界优于随机位置,学习得到的 Trigger 又优于在每个分隔符处无条件调用。
这个消融支持两点:
- 在语义边界插入,比随机插入更稳定;
- 记忆不是越多越好,选择性调用优于全部调用。
但 Trigger 相对"所有分隔符调用"的增益并不巨大:GPQA +0.94、KodCode +1.96、TriviaQA +0.87。它的主要价值可能不只是准确率,还包括减少 Weaver 调用次数;遗憾的是 Table 6 没有同时报告每种策略的调用量和延迟。
2. Weaver 容量
| Weaver 参数化 | GPQA | KodCode | TriviaQA |
|---|---|---|---|
| LoRA, r = 4 r=4 r=4 | 17.16 | 54.85 | 63.04 |
| LoRA, r = 8 r=8 r=8 | 17.67 | 55.75 | 64.10 |
| LoRA, r = 16 r=16 r=16 | 18.28 | 56.16 | 65.02 |
| LoRA, r = 32 r=32 r=32 | 19.26 | 57.95 | 65.85 |
| Full SFT | 21.21 | 60.00 | 67.10 |
Table 7:Weaver 参数量消融。 更大的 LoRA rank 整体更好,全参数训练 Weaver 达到最高性能,但参数效率下降。
这张表揭示了一个重要事实:MemGen 的优势并不完全来自结构,Weaver 的容量同样决定上限。论文默认使用 r = 16 r=16 r=16 是效率与性能的折中,而不是最优性能配置。
3. Weaver 是否只是让模型"多想几步"
| 方法 | KodCode | TriviaQA | GPQA |
|---|---|---|---|
| Trigger + Pause Token | 49.50 | 56.30 | 13.80 |
| Trigger + Weaver | 58.16 | 65.02 | 18.28 |
Table 9:Pause Token 对比。 在相同潜在 token 数量下,上下文相关的 Weaver 明显优于固定 Pause Token。
三项分别提升 8.66、8.72 和 4.48 个百分点。这说明收益不能只解释为增加了隐藏计算步数;Weaver 生成的内容确实包含与当前状态相关的信息。
4. 潜在记忆长度
Figure 6 左侧显示,当 K K K 从 2 增加到 32,KodCode 与 TriviaQA 整体上升,但并非严格单调。例如 KodCode 在 K = 6 K=6 K=6 时低于 K = 4 K=4 K=4,TriviaQA 在 K = 8 K=8 K=8 后也出现回落。
因此,更长记忆提高了容量上限,却并不保证每一点都提升。论文没有报告显存、KV cache 和延迟随 K K K 的变化,也没有解释为何主实验只从 { 2 , 4 , 8 } \{2,4,8\} {2,4,8} 中选值,而敏感性分析延伸到了 32。
十四、外部检索融合实验
| 方法 | ALFWorld | TriviaQA | PopQA |
|---|---|---|---|
| Vanilla LLM | 18.96 | 10.47 | 8.23 |
| ExpeL | 36.18 | 46.20 | 28.16 |
| MemGen + ExpeL,不用 Weaver 参数记忆 | 45.60 | 53.20 | 39.50 |
| MemGen + ExpeL,使用 Weaver 参数记忆 | 75.90 | 76.40 | 60.23 |
Table 10:MemGen 与 ExpeL 融合。 即使关闭 Weaver 内部参数记忆,只让它重构 ExpeL 检索结果,也能明显提高表现;同时使用内部经验和外部检索时增益最大。
这可能是全文最有工程价值的一组结果。
仅把 ExpeL 的文本交给 Weaver 重构,就把 ALFWorld 从 36.18 提升到 45.60、PopQA 从 28.16 提升到 39.50。这说明潜在 Weaver 可以作为现有记忆库的下游消费层,不必推翻已有存储与检索设施。
当内部参数记忆与外部检索同时启用,ALFWorld 达到 75.90,甚至高于主表中 MemGen-GRPO 的 63.60。但论文没有说明这一融合设置是否使用完全相同的训练预算,也没有提供更多检索 baseline,因此它更适合作为可行性证据,而不是全面的 SOTA 比较。
十五、效率分析
| Backbone | 方法 | KodCode 时间/准确率 | ALFWorld 时间/准确率 | TriviaQA 时间/准确率 |
|---|---|---|---|---|
| Qwen2.5-1.5B | Vanilla | 11.96s / 24.55 | 21.17s / 22.54 | 2.18s / 32.10 |
| SFT | 2.01s / 55.83 | 10.79s / 36.57 | 1.98s / 63.84 | |
| MemGen-SFT | 2.94s / 58.16 | 12.94s / 40.30 | 2.05s / 65.02 | |
| SmolLM3-3B | Vanilla | 13.12s / 37.05 | 34.82s / 18.96 | 4.26s / 10.47 |
| SFT | 3.04s / 59.25 | 12.88s / 32.36 | 3.05s / 55.25 | |
| MemGen-SFT | 3.48s / 62.65 | 14.69s / 50.60 | 3.16s / 68.13 | |
| Qwen3-8B | Vanilla | 16.99s / 49.10 | 55.42s / 58.93 | 8.70s / 52.18 |
| SFT | 7.24s / 64.75 | 19.76s / 83.59 | 5.98s / 74.55 | |
| MemGen-SFT | 7.56s / 66.15 | 20.08s / 85.82 | 6.25s / 77.22 |
Table 8:平均单任务推理时间与准确率。 MemGen 比直接 SFT 稍慢,但因为更快得到正确答案、生成 token 更少,端到端时间仍低于 Vanilla。
论文将"低于 Vanilla 延迟"作为 MemGen 没有明显开销的证据,但这个结论需要正确解读:
- MemGen 相比 SFT 始终更慢,例如 Qwen2.5-1.5B 的 KodCode 为 2.94s 对 2.01s;
- 它之所以比 Vanilla 快,主要是经过训练后用更短轨迹完成任务;
- 论文没有把每 token 延迟、Trigger 额外前向、Weaver 调用次数和序列长度单独拆开。
因此,证据支持的是"端到端任务耗时可控",而不是"记忆插入本身没有额外成本"。
十六、与 Agent Memory 系列方法的横向比较
| 方法 | 记忆载体 | 主要写入方式 | 调用粒度 | 核心关注点 |
|---|---|---|---|---|
| Mem0 | 结构化文本记忆 | 对对话事实抽取、更新 | 查询/对话级 | 可部署的长期个性化记忆 |
| A-MEM | 动态链接的文本 note | 新记忆触发属性和关系更新 | 查询级 | 记忆组织与关联演化 |
| MemoryOS | 分层外部记忆 | 短期、长期与用户画像迁移 | 会话/查询级 | 长期对话记忆管理 |
| MAGMA | 多图协同记忆 | 从多种关系视角组织历史 | 查询级 | 多关系检索与证据整合 |
| CoM | 压缩后的上下文记忆 | 学习保留与压缩历史 | 长上下文处理级 | 降低上下文冗余 |
| ReMemR1 | 可回访外部记忆 | 阅读时主动回调历史 | 阅读/推理阶段 | 修复顺序阅读的信息损失 |
| Mem²Evolve | 可演化经验记忆 | 根据反馈更新经验结构 | 任务迭代级 | 记忆随实践持续演化 |
| MemGen | 潜在向量序列 | Weaver 从经验中学习生成记忆 | 句内 token 生成级 | 让记忆按需介入并重塑当前推理 |
MemGen 与这些方法不是简单替代关系。
- 它没有解决 Mem0、A-MEM 擅长的可编辑事实管理;
- 它不提供 MAGMA 式可追溯关系图;
- 它无法像文本记忆那样让用户检查和删除某条事实;
- 但它把记忆利用从"Prompt 里读一段信息"推进到"隐藏空间中改变后续计算"。
如果把记忆生命周期拆成写入、组织、检索、利用四个环节,MemGen 的主要创新集中在最后一个环节,并顺带学习了动态调用时机。
十七、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已经完成的实验结论。
1. Coding Agent:在错误发生点调用程序性记忆
Coding Agent 不一定要在任务开始时检索一大批历史补丁。更合理的方式可能是:
- 测试失败后触发一次记忆;
- 读取当前代码、错误栈和已尝试方案;
- Weaver 生成与当前失败相关的潜在提示;
- Agent 再决定修改哪个文件或调用哪个工具。
这样可以减少无关仓库经验长期占用上下文。
2. Tool Agent:把记忆调用与异常边界绑定
Trigger 可重点观察:
- 工具调用前;
- 工具返回后;
- 解析失败后;
- 权限或参数错误后;
- 即将给出最终答案前。
论文中程序性记忆簇与工具解析、格式错误存在关联,说明潜在记忆可能适合保存难以用一条规则覆盖的调用习惯。
3. Multi-Agent:让记忆成为私有的协作接口
不同 Agent 可以共享外部事实库,但拥有各自的 Weaver。检索到同一份协作轨迹后,规划 Agent、执行 Agent 和审查 Agent 可以生成不同的潜在记忆表示。
这种设计把"共享事实"和"角色化吸收"分开。不过潜在向量不可解释,如果多个 Agent 的表示空间不同,还需要额外的对齐或蒸馏机制。
4. 混合记忆架构可能比纯潜在记忆更现实
在生产系统中,更可行的组合是:
可审计外部记忆 + 结构化检索 + 潜在 Weaver + 冻结 Reasoner \text{可审计外部记忆} +\text{结构化检索} +\text{潜在 Weaver} +\text{冻结 Reasoner} 可审计外部记忆+结构化检索+潜在 Weaver+冻结 Reasoner
外部层负责事实、权限、删除和溯源;潜在层负责根据当前推理阶段压缩与利用证据。Table 10 已为这种组合提供初步实验支持。
十八、局限性与证据边界
1. "不修改模型"并不准确
MemGen 冻结的是 Reasoner 主体,但 Trigger 和 Weaver 都由 LoRA 参数实现,并且必须训练。因此它避免的是反复改动核心 Reasoner,不是完全无参数更新。
2. 潜在记忆难以审计
潜在 token 对人类不可读,带来明显治理问题:
- 无法直接确认某条记忆来自哪里;
- 难以删除某个用户或某段数据的影响;
- 无法像文本证据一样做事实核查;
- 一旦 Weaver 学入错误经验,定位污染源会很困难。
3. "人类式记忆层级"主要来自事后解释
规划、程序性和工作记忆是根据簇删除后的错误变化赋予的标签。实验表明簇具有不同功能影响,但并没有证明系统真的形成了与人类认知同构的记忆系统。
4. 泛化实验仍可能受到长度与格式影响
Trigger 只在标点处决策,不同任务的输出长度和标点密度会直接影响可调用次数。论文没有报告归一化调用率,也没有控制输出长度。
5. Baseline 的训练预算不完全透明
MemGen 同时引入两阶段训练、LoRA 模块、随机插入预训练和 Trigger RL。论文没有完整列出所有 baseline 的数据、步数、采样成本与计算预算是否严格相等。
6. 缺少统计显著性
表格报告单点结果,没有标准差、置信区间或多随机种子。部分增益只有不到 1 个百分点,例如 Trigger 相对全分隔符策略在 TriviaQA 上的 +0.87,其稳定性无法判断。
7. 代码发布仍不完整
官方仓库已提供部分 SFT/GRPO checkpoint 和脚本,但 README 明确说明多轮 GRPO(例如 ALFWorld、TriviaQA)的训练与评估脚本仍计划后续发布。仓库还记录了 ChatML 模板和 \boxed{} 后换行会显著影响 1.5B 模型结果,说明部分实验对 Prompt 格式较敏感。
8. 表述和数字存在若干不一致
- 会议页面摘要写八个 benchmark,PDF 正文写九个;
- 正文把 ExpeL 的 36.18 误写成 AWM,并给出错误差值;
- Table 7 的 KodCode 在正文主表 MemGen-SFT 为 58.16,但 LoRA r = 16 r=16 r=16 行为 56.16,论文未解释设置差异。
这些问题不推翻核心实验,但降低了部分细节的可复核性。
十九、我的理解与启发
1. MemGen 真正改变的是记忆的"接口"
过去大部分 Agent Memory 工作都在优化记忆内容:存哪些事实、怎样压缩、如何连边、如何检索。MemGen 把注意力转向 Reasoner 与 Memory 之间的接口。
传统接口是文本:
Memory → Prompt → Reasoner \text{Memory}\rightarrow\text{Prompt}\rightarrow\text{Reasoner} Memory→Prompt→Reasoner
MemGen 的接口是隐藏状态:
Cognitive State → Latent Memory → Hidden-State Intervention \text{Cognitive State}\rightarrow\text{Latent Memory}\rightarrow\text{Hidden-State Intervention} Cognitive State→Latent Memory→Hidden-State Intervention
这使记忆更接近计算模块,而不只是上下文数据。
2. Trigger 可能比 Weaver 更具有长期价值
Weaver 的实现会随模型架构和隐藏维度改变,但"什么时候应该停下来调用记忆"是各种 Agent 都需要解决的问题。
在复杂 Agent 系统中,Trigger 可以继续扩展为:
- 何时检索历史;
- 何时总结当前轨迹;
- 何时调用反思模型;
- 何时切换工具;
- 何时请求其他 Agent 协助。
因此,MemGen 的 Trigger 可以被理解成一种元认知控制器。
3. 不可读并不自动等于更高级
潜在表示与自然语言不同,确实可能更紧凑,也可以保留解码前的信息。但"人类读不懂"不是能力证据。
评价潜在记忆更可靠的标准应该是:
- 是否提供了文本记忆无法提供的收益;
- 是否能在控制变量后降低延迟或 token;
- 是否能通过干预稳定定位功能;
- 是否可迁移、删除、约束和审计。
Pause Token 消融与簇删除实验分别回答了前两个机制问题的一部分,但可审计性仍然开放。
4. 最有前景的是"双记忆系统"
我的判断是,潜在记忆不会取代外部记忆,而会成为外部记忆与推理模型之间的新层。
外部数据库擅长持久化、检索、权限和溯源;潜在 Weaver 擅长把当前状态与取回证据融合成机器易用的内部表示。Table 10 中 MemGen + ExpeL 的结果正好体现这种互补关系。
二十、总结
MemGen 提出了一种动态生成式潜在记忆框架:冻结核心 Reasoner,用 Memory Trigger 在推理的语义边界判断是否需要回忆,再由 Memory Weaver 根据当前隐藏状态生成一组潜在记忆 token,并把它们织回后续生成。
实验表明,它在搜索、具身行动、数学、科学推理和代码任务上普遍优于多类参数记忆、检索式记忆与潜在计算 baseline;在持续学习中也比直接 SFT 更能保留旧任务能力。Trigger 消融说明选择调用时机优于随机或全量调用,Pause Token 对比则说明收益不只是"多算几步"。
不过,论文仍存在不可解释、难审计、训练成本对齐不足、缺少显著性检验和部分数字不一致等问题。"自发形成类人记忆层级"更适合作为启发性解释,而不是已经被完全证实的认知结论。
一句话总结:
MemGen 的关键不是把更多历史塞给 Agent,而是训练一个系统,在推理最需要帮助的时刻,把经验重构成机器原生的潜在记忆并直接参与后续计算。
参考资料
- Guibin Zhang, Muxin Fu, Shuicheng Yan. MemGen: Weaving Generative Latent Memory for Self-Evolving Agents. ICLR 2026.
- ICLR 正式论文页面:https://proceedings.iclr.cc/paper_files/paper/2026/hash/26407588dfb08e48c459c074ab6adb7d-Abstract-Conference.html
- 官方代码仓库:https://github.com/bingreeky/MemGen