STM32H733 MPU、AXI、FMC学习
一、什么是MPU
MPU (Memory Protection Unit,内存保护单元):
它是Cortex-M7内核内部的一个可选组件,用于 " 定义内存的访问权限和属性 "。MPU可以将整个内存映射划分为最多16个区域,并为每个区域独立设置:
- 访问权限:例如只读、只写、禁止执行 (XN) 等。
- 内存类型:普通内存 (Normal) 或设备内存 (Device)或Strongly ordered。
- 缓存策略:可缓存/不可缓存,以及回写 (Write-Back) 或透写 (Write-Through) 等。
二、MPU的三种内存类型
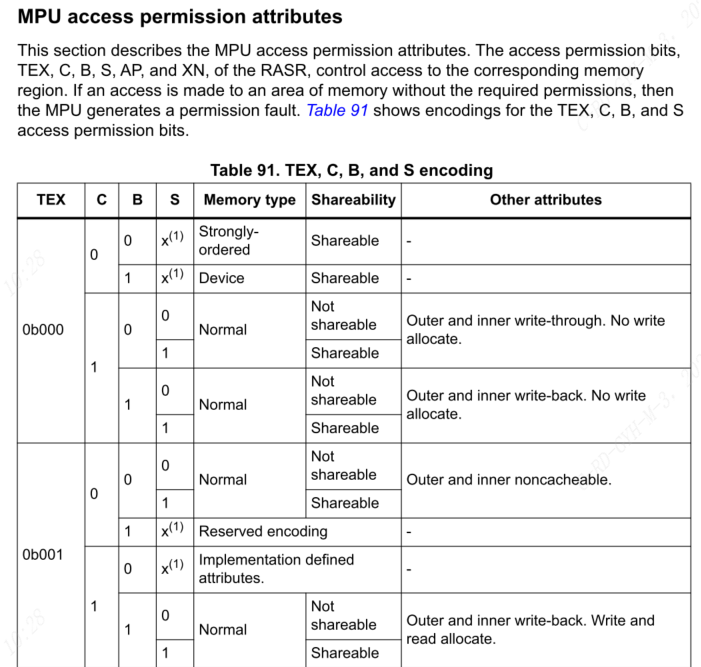
图1.通过寄存器配置内存模式 MPU 可以配置的三种内存类型如下:
1. Normal memory
Normal 内存就是"正常的内存",用来存放代码和数据。CPU 认为这段地址背后是普通的存储单元,读写它不会产生副作用。
行为特点
允许缓存:可以配置为可缓存或不可缓存。
允许推测访问:CPU 可以提前读取,即使程序不一定用到。
允许重排和合并:多个访问可以合并、乱序执行,以提高总线效率。
弱排序:不保证严格的程序顺序,只要数据依赖正确即可。
子类型Non-cacheable(禁用Cache):每次访问都直接到内存,但 CPU 仍可能重排、合并。
Write-through(写透):写操作同时更新缓存和内存,读可缓存。
Write-back(写回):写操作只更新缓存,稍后再写回内存。性能最高,但需手动维护一致性。
Write allocate / No write allocate:写未命中时是否分配缓存行。
2. Device memory
它的核心设计目标是在保证外设访问顺序正确的前提下,尽可能地提升访问效率。与追求极致性能的 Normal 内存和追求绝对顺序的 Strongly-ordered 内存不同,Device 内存通过 G、R、E 三个子属性,在"顺序安全"与"性能"之间提供了多档可调的平衡点。
行为特点
- 禁止缓存(禁用Cache):访问直接到外设。
- 禁止推测访问:CPU 不会提前读取,避免误触发外设。
- 顺序受限:访问顺序不能随意重排,但可以通过子属性放松。
- 允许一定优化:通过 G、R、E 三个子属性控制。
内存的行为完全由三个子属性决定,每个属性都可以开启或关闭(前缀 n 表示禁止)子类型
- G (Gathering,合并):是否允许将多个访问合并为一个总线事务。禁止时(nG),每次读写都会作为独立事务发送到外设,保证外设能感知到每一次独立的访问。
- R (Reordering,重排):是否允许对同一设备的访问进行顺序重排。禁止时(nR),访问将严格按照程序代码的顺序执行。
- E (Early Write Acknowledgement,提前写确认):是否允许写操作在真正到达外设之前就向 CPU 返回"完成"信号。允许时(E),写操作进入处理器的存储缓冲器(Store Buffer)后即可返回,CPU 无需等待其真正写入外设,从而提高了指令流水线效率。这也就是"可缓冲"特性的来源。
| 类型 | 合并 (G) | 重排 ® | 提前写确认 (E) | 核心特点与典型用途 |
|---|---|---|---|---|
| Device-nGnRnE | 禁止 | 禁止 | 禁止 | 最严格。所有访问严格按程序顺序,且必须真正完成。相当于旧架构的 Strongly-ordered 内存。适用于对时序有绝对要求的关键外设寄存器(如中断控制器、DMA 寄存器)。 |
| Device-nGnRE | 禁止 | 禁止 | 允许 | 最常用。顺序严格保证,但写操作可被缓冲以提升性能。这正是 Cortex-M7 外设区域(0x40000000 - 0x5FFFFFFF)的默认类型。 |
| Device-nGRE | 禁止 | 允许 | 允许 | 允许重排,在保证无合并的前提下,为一些对顺序要求不高的外设提供更高效率。 |
| Device-GRE | 允许 | 允许 | 允许 | 最宽松。允许合并、重排和提前确认,限制最少,性能最高,但顺序保证最弱。 |
Strongly ordered memory
trongly-ordered 是最严格的内存类型,用于对顺序和时序要求极高的系统控制寄存器。它相当于 Device-nGnRnE 且总是非共享、非缓存。
行为特点
- 严格按程序顺序访问:前面的访问不完成,后面的访问不会开始。
- 禁止推测访问:绝不提前读取。
- 禁止重排、合并:每个访问独立、按序。
- 禁止早期写确认:写操作必须真正到达设备后才返回。
- 非缓存、非共享。
三、CPU附近总线
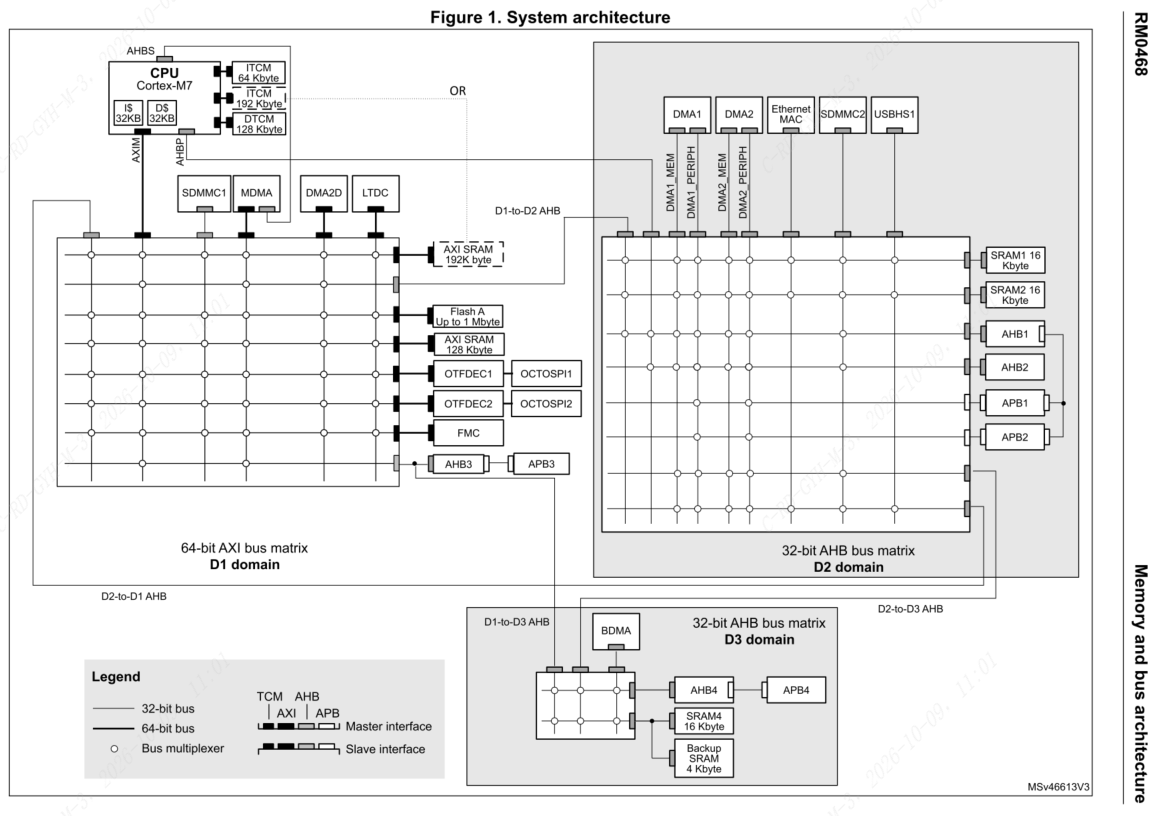
图2.系统总线
由图中可以看到官方把系统的总线框架分成了3个域:D1(高性能核心区)、D2(通用外设区)、D3(低功耗备份区)。本次了解D1域中的部分内容
1. 多个接口
- AHBS(AXI High-Speed Slave):用于高速外设访问(如 DMA、LCD 控制器等),是 AXI 总线的从端口。
- AXIM(AXI Master Interface):作为 AXI 主设备发起对内存/外设的读写请求。
- AHPB(AHB Peripheral Bus):连接低速外设或桥接器(连接到D2区域)。
2. 紧耦合存储器
| 名称 | 容量 | 用途说明 |
|---|---|---|
| ITCM | 64 KByte | 指令紧耦合内存 ------ 存放最关键的中断服务程序、实时任务和性能敏感的算法 |
| DTCM | 192 KByte + 128 KByte = 320KB | 数据紧耦合内存 ------ 存放高频变量、堆栈、DMA缓冲区等 |
| I-Cache | 32 KB | 指令专用SRAM(可选配置) |
| D-Cache | 32 KB | 数据专用SRAM(可选配置) |
3. AXI矩阵
图中D1下方那个大网格就是 AXI矩阵,它允许任意主设备(Master)访问任意从设备(Slave),实现并行通信,可以说是神经系统。
6 个主接口(ASIB):连接发起访问的主设备。
- Cortex-M7 内核的 AXI 总线(AXIM)
- D2 域到 D1 域的 AHB 互连总线(D2-to-D1 AHB)
- SDMMC1(32位 AHB)
- MDMA(主 DMA,64位 AXI)
- LCD-TFT 控制器(LTDC,64位 AXI)
- DMA2D 图形加速器(Chrom-ART,64位 AXI)
7 个从接口(AMIB):连接被访问的从设备。- AHB3 总线(进一步连接 APB3 外设)
- Flash 存储器接口 A 和 B
- FMC 外部存储器控制器
- QSPI 接口
- AXI SRAM
- 其他内部存储器或外设
这种设计运行多个主设备同时访问不同的从设备,比如:
- 内核从Flash取指
- DMA2D从AXI SRAM读取图像数据
- SDMMC向QSPI Flash写入数据
三者可并行发生,互不阻塞。我在一个视频处理项目中实测,合理利用这种并行性可使整体吞吐量提升40%。
AXI核心机制
当多个主设备同时请求访问同一个从设备时,AXI 矩阵内置的仲裁器会依据 QoS(服务质量) 机制来解决冲突。
- QoS 寄存器:每个主接口(ASIB)都有独立的读通道和写通道 QoS 寄存器(如 AXI_INIx_READ_QOS 和 AXI_INIx_WRITE_QOS),可配置 0 到 15 的优先级值,数值越大优先级越高。
- 仲裁规则:优先级高的主设备请求会优先得到处理。如果两个请求的 QoS 值相同,则采用 LRU(最近最少使用) 策略进行仲裁。
- 典型应用:在图形显示场景中,可以为 LTDC 和 DMA2D 分配更高的 QoS 值,以确保屏幕刷新流畅,避免出现撕裂或卡顿。
AXI内存映射与关键地址
AXI SRAM 是 D1 域中最重要的高性能内存,直接挂载在 AXI 矩阵上,通常映射在 0x2400 0000 地址。其数据带宽为 64 位,可进行字节、半字、字或双字访问。除了 D3 域的 BDMA,系统内其他主设备均可访问该区域。相比之下,ITCM/DTCM 是紧耦合内存,直连内核,能以 CPU 全速运行,但不受 AXI 矩阵管理,且通常仅 CPU 和 MDMA(通过专用 AHB 端口)可访问。
四、本次FMC延迟问题判断
问题现象:在FMC通信的过程中偶发的延时现象,同时在开启的D1区域的设备有ETH(D2-to-D1 AHB) 和 OctoSPI
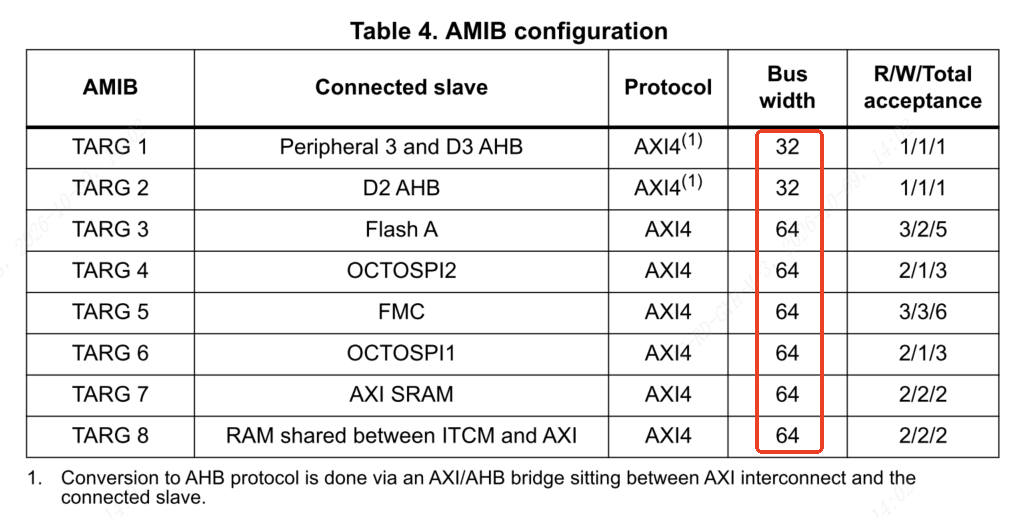
其实对于每个从接口都有各自的总线带宽。MPU 把 FMC 区域配成 Strongly-ordered 后,CPU 的写操作被禁止缓冲,必须同步等待 每一次写真正到达外部 RAM 并完成.在此期间,若是在此等待期间ETH(D2-to-D1 AHB) 和 OctoSPI 同时争用总线时,这个等待时间会被放大。
而配置为而 Device memory 允许写缓冲,CPU 写完即可继续。
Strongly-ordered模式的整体数据链条是这样的:
- CPU发出写操作 → 数据进入CPU的Store Buffer(被强制排空,无缓冲优势)。
- 写事务穿过AXI矩阵 → 到达FMC从接口的输出缓冲(有资料提到这个缓冲深度约为"3 writes")。
- FMC控制器将64位写事务拆分为多个窄位宽写操作,按外部RAM时序逐个发出。(每个接口的宽度不一致,则必须面临着数据宽度转换)
- CPU必须等到所有这些拆分后的写操作全部完成,才能继续执行。
若是此时在第2步到第4步有其他接口需要处理发送 那么整体执行发送或接受的时间就会被拉长。
配置为Device-nGnRE,允许放在缓冲区之后CPU直接返回,此时数据的传输CPU不再参与,由硬件完成。
引发的几个小疑问
- 配置为Device-nGnRE内存模式之后,虽然从代码层面上来说确实会快了,因为不需要等待所有执行完毕才返回,直接放在缓冲就返回,那么数据在下面真实的传输是否是有加快了?
答:
其实感官上的变快了是因为CPU的执行效率变高了,代码上的执行返回速度变快了。但是真实的数据其实在物理层面还和几个要素有关:
- 外部 RAM 的时序:你配置的等待周期(Wait States)、建立/保持时间等。
- FMC 控制器的时钟:HCLK 频率和分频系数。
- 总线宽度转换:如前所述,FMC控制器将64位写事务拆分为多个窄位宽写操作,按外部RAM时序逐个发出。
- AXI 矩阵的仲裁:ETH、OSPI 等主设备争用总线时的排队顺序(也就是上述数据链路的第1步)。
- 继续优化方向:建议适当调整QoS的优先级
- 总线宽度转换:如前所述,FMC控制器将64位写事务拆分为多个窄位宽写操作,按外部RAM时序逐个发出。
- AXI 矩阵的仲裁:ETH、OSPI 等主设备争用总线时的排队顺序(也就是上述数据链路的第1步)。
-
继续优化方向:建议适当调整QoS的优先级
-
继续优化方向:优化总线宽度转换的过程