前言
在上期中我们自己简单的实现封装红黑树,主要实现了insert和迭代器。实现过程中需要注意哪些,以及实现逻辑。在这期来讲解unordered_map和unordered_set的使用。主要来介绍其与map和set之年的区别。
unordered_set系列的使用
unordered_set和unordered_multiset参考⽂档
https://legacy.cplusplus.com/reference/unordered_set/
unordered_set类的介绍
1、unordered_set的声明如下,Key就是unordered_set底层关键字的类型
2、unordered_set默认要求Key⽀持转换为整形 ,如果不⽀持或者想按⾃⼰的需求⾛可以⾃⾏实现⽀持将Key转成整形的仿函数传给第⼆个模板参数
3、unordered_set默认要求Key⽀持⽐较相等 ,如果不⽀持或者想按⾃⼰的需求⾛可以⾃⾏实现⽀持将Key⽐较相等的仿函数传给第三个模板参数
4、unordered_set底层存储数据的内存是从空间配置器申请的,如果需要可以⾃⼰实现内存池,传给第四个参数。
5、⼀般情况下,我们都不需要传后三个模板参数
6、unordered_set底层是⽤哈希桶实现,增删查平均效率是O(1) ,迭代器遍历不再有序,为了跟set区分,所以取名unordered_set。
bash
template < class Key, //
	unordered_set::key_type / value_type
	class Hash = hash<Key>, // unordered_set::hasher
	class Pred = equal_to<Key>, // unordered_set::key_equal
	class Alloc = allocator<Key> // unordered_set::allocator_type
> class unordered_set;
7、前⾯部分我们已经学习了set容器的使⽤,set和unordered_set的**功能⾼度相似,**只是底层结构不同,有⼀些性能和使⽤的差异,这⾥我们只讲他们的差异部分。
set和unordered_set的使用差异
1、查看⽂档我们会发现unordered_set的⽀持增删查且跟set的使⽤⼀模⼀样,关于使⽤我们这⾥就不再赘述和演⽰了。
2、unordered_set和set的第**⼀个差异** 是对key的要求不同 ,**set要求Key⽀持⼩于⽐较,⽽unordered_set要求Key⽀持转成整形且⽀持等于⽐较,**要理解unordered_set的这个两点要求得后续我们结合哈希表底层实现才能真正理解,也就是说这本质是哈希表的要求。
3、unordered_set和set的第二个差异是迭代器的差异 ,set的iterator是双向迭代器,unordered_set是单向迭代器,其次set底层是红⿊树,红⿊树是⼆叉搜索树,⾛中序遍历是有序的,所以set迭代器遍历是有序+去重。⽽unordered_set底层是哈希表,迭代器遍历是⽆序+去重。
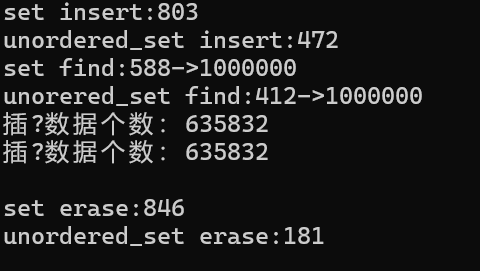
4、unordered_set和set的第三个差异是性能的差异 ,整体⽽⾔⼤多数场景下,unordered_set的增删查改更快⼀些,因为红⿊树增删查改效率是O(logN) ,⽽哈希表增删查平均效率是 O(1),具体可以参看下⾯代码的演⽰的对⽐差异。
bash
#include<unordered_set>
#include<unordered_map>
#include<set>
#include<iostream>
using namespace std;
int test_set2()
{
	const size_t N = 1000000;
	unordered_set<int> us;
	set<int> s;
	vector<int> v;
	v.reserve(N);
	srand(time(0));
	for (size_t i = 0; i < N; ++i)
	{
		//v.push_back(rand()); // N⽐较⼤时,重复值⽐较多
		v.push_back(rand() + i); // 重复值相对少
		//v.push_back(i); // 没有重复,有序
	}
	// 21:15
	size_t begin1 = clock();
	for (auto e : v)
	{
		s.insert(e);
	}
	size_t end1 = clock();
	cout << "set insert:" << end1 - begin1 << endl;
		size_t begin2 = clock();
	us.reserve(N);
	for (auto e : v)
	{
		us.insert(e);
	}
	size_t end2 = clock();
	cout << "unordered_set insert:" << end2 - begin2 << endl;
	int m1 = 0;
	size_t begin3 = clock();
	for (auto e : v)
	{
		auto ret = s.find(e);
		if (ret != s.end())
		{
			++m1;
		}
	}
	size_t end3 = clock();
	cout << "set find:" << end3 - begin3 << "->" << m1 << endl;
	int m2 = 0;
	size_t begin4 = clock();
	for (auto e : v)
	{
		auto ret = us.find(e);
		if (ret != us.end())
		{
			++m2;
		}
	}
	size_t end4 = clock();
	cout << "unorered_set find:" << end4 - begin4 << "->" << m2 << endl;
	cout << "插⼊数据个数:" << s.size() << endl;
	cout << "插⼊数据个数:" << us.size() << endl << endl;
	size_t begin5 = clock();
	for (auto e : v)
	{
		s.erase(e);
	}
	size_t end5 = clock();
	cout << "set erase:" << end5 - begin5 << endl;
	size_t begin6 = clock();
		for (auto e : v)
		{
			us.erase(e);
		}
	size_t end6 = clock();
	cout << "unordered_set erase:" << end6 - begin6 << endl << endl;
	return 0;
}
int main()
{
	test_set2();
	return 0;
}
unordered_map和map的使用差异
1、查看⽂档我们会发现unordered_map的⽀**持增删查改且跟map的使⽤⼀模⼀样,**关于使⽤我们这⾥就不再赘述和演⽰了。
2、unordered_map和map的第**⼀个差异是对key的要求不同** ,map要求Key⽀持⼩于⽐较,⽽unordered_map要求Key⽀持转成整形且⽀持等于⽐较,要理解unordered_map的这个两点要求得后续我们结合哈希表底层实现才能真正理解,也就是说这本质是哈希表的要求。
3、unordered_map和map的第**⼆个差异是迭代器的差异,map的iterator是双向迭代器,unordered_map是单向迭代器,其次map底层是红⿊树,红⿊树是⼆叉搜索树,⾛中序遍历是有序的,所以map迭代器遍历是Key有序+去重。⽽unordered_map底层是哈希表,迭代器遍历是Key⽆序+去重。**
4、unordered_map和map的第三个差异是性能的差异,整体⽽⾔⼤多数场景下,unordered_map的增删查改更快⼀些,因为红⿊树增删查改效率是 ,⽽哈希表增删查平均效率是 。
这里就不展示代码了,操作与上述set的类似。
unordered_multimap/unordered_multiset
1、unordered_multimap/unordered_multiset跟multimap/multiset功能完全类似,⽀持Key冗余。
2、unordered_multimap/unordered_multiset跟multimap/multiset的差异也是三个⽅⾯的差异,key的要求的差异,iterator及遍历顺序的差异,性能的差异。
unordered_xxx的哈希相关接⼝
Buckets和Hash policy系列的接⼝分别是跟哈希桶和负载因⼦相关的接⼝,⽇常使⽤的⻆度我们不需要太关注,后⾯学习了哈希表底层,我们再来看这个系列的接⼝,⼀⽬了然。
这一期主要俩介绍这些。下一期来讲解其底层原理以及哈希相关的知识点。
感谢支持!!!