文章目录
一、引言
光谱数据包含了物质的丰富特征信息,广泛应用于物质识别与定量分析。然而,原始光谱往往伴随高频噪声、基线漂移和冗余波段,直接输入机器学习模型会导致计算开销大且易过拟合。
本文将介绍一种结合预处理、PCA降维与SVM分类的光谱定性分析流水线。SVM作为一种监督学习算法,其算法流程为:读入光谱数据→数据预处理(截断、平滑、归一化)→PCA降维→划分数据集→训练→测试。本文将重点解读SVM在光谱数据处理中的实际影响。
二、数据介绍
- 样本构成:4种不同物质,每种物质包含4个浓度梯度,每个浓度重复测量15次,共计240条光谱。
- 波长范围:400--1800 nm。
- 原始数据格式 :每条光谱由波长和强度两列组成,存储为
.txt或.csv文件。 - 目录结构:按物质名称 → 浓度文件夹 → 光谱文件的层级组织。
三、光谱分析流水线构建
整套流水线的核心步骤如下:
- 数据加载:从文件夹递归加载不同物质和浓度的光谱文件。
- 预处理 :
- 波段截取:保留有效波长范围。
- SG平滑:消除高频噪声。
- 归一化:统一幅值尺度。
- 基线校正:采用改进的多项式基线校正(ModPoly)消除偏移。
- PCA降维:压缩维度,剔除冗余信息。
- SVM分类:划分训练/测试集,进行交叉验证与测试。
- 可视化:绘制决策边界与混淆矩阵。
四、预处理对SVM的影响
- 波段截取与SG平滑:限制了有效区域并消除了噪声,使光谱曲线更光滑,有助于SVM捕捉稳定特征。
- 基线校正与归一化:消除了因散射或仪器引起的基线偏移,统一了幅值尺度,防止某些强吸收峰主导距离度量,保证SVM的RBF核函数能公平对待每个波长点。
实测中,经过完备的预处理,SVM的分类鲁棒性得到显著提升。
预处理详细介绍见如下连接:
五、PCA降维:为SVM减负
光谱数据变量众多,直接输入SVM易导致维度灾难。采用PCA将高维空间压缩后,带来以下影响:
- 加速训练:大幅降低了SVM的计算开销。
- 降低过拟合风险:剔除噪声主成分,使SVM学到的模式更具泛化能力。
- 可视化可行性:降维后的数据可直接绘制决策边界。
需要注意的是,降维维度需结合累计解释方差进行选择。若方差保留不足,可能会丢失关键判别信息。
六、SVM训练与交叉验证
采用RBF核的SVM,设置C=10、gamma='scale'。
- 数据划分:按比例划分训练/测试集,测试集全程隔离。
- 交叉验证:在训练集上进行多折交叉验证,稳定评估模型性能,避免数据泄露。
- 网格搜索:可通过交叉验证进一步筛选最优超参数。
七、实验结果与分析
运行流水线后,得到以下核心结果:
-
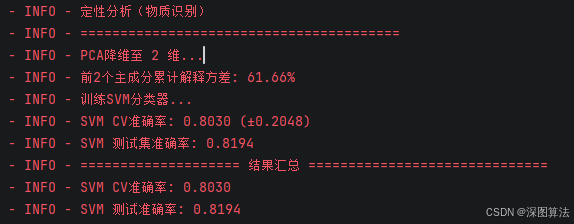
指标输出 :PCA降维至2维时,前2个主成分累计解释方差为61.66%。SVM交叉验证准确率为80.30%(±20.48%),测试集准确率为81.94%。如下图:
-
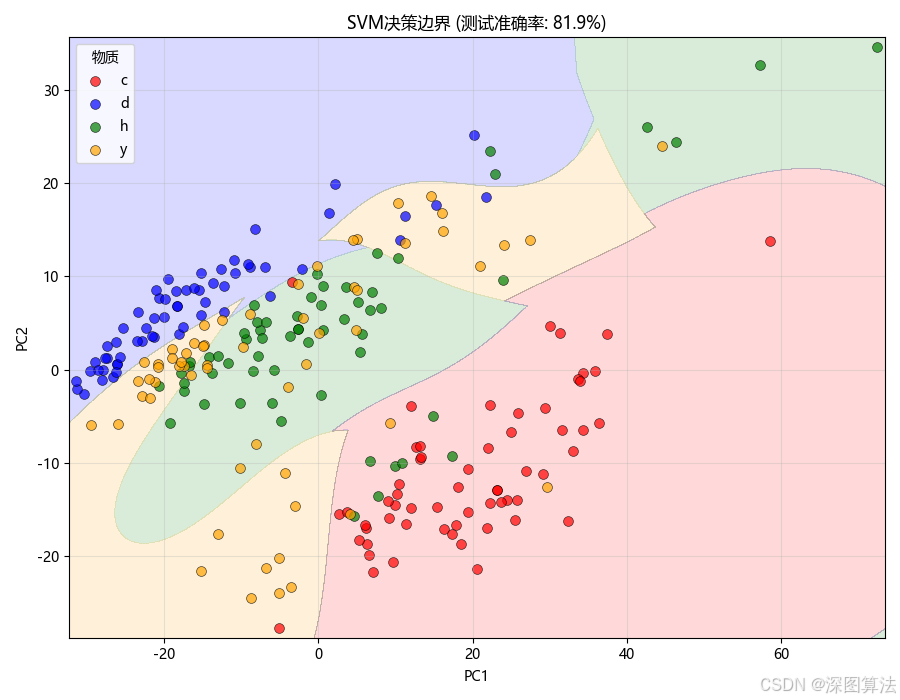
决策边界 :测试准确率为81.9%。物质c聚类较为独立,而物质h和y在中心区域存在明显重叠。
-
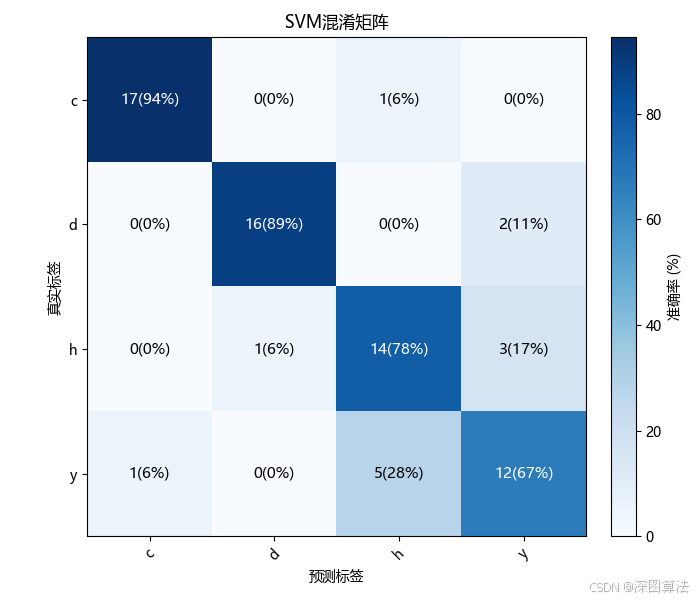
混淆矩阵 :物质c和d的识别率较高(分别为94%和89%),物质h为78%。物质y的识别率最低(67%),且有5个样本被误判为h,这与决策边界图中的重叠区域完全对应。
-
不同特征对结果的影响:采用全光谱、峰特征、一阶导数、波段比值,四种不同的特征提取方式,来对比对结果的影响。
|----------------------------------------------------------------------------|----------------------------------------------------------------------------|
| 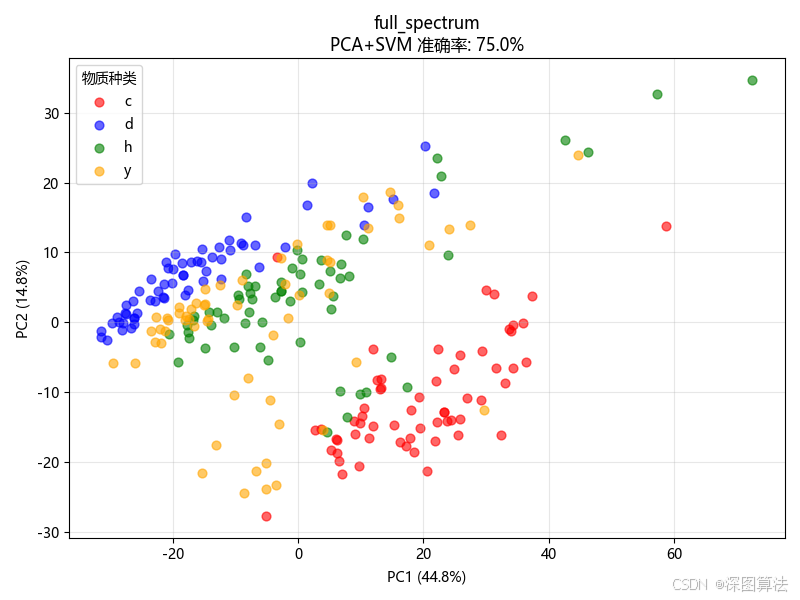 |
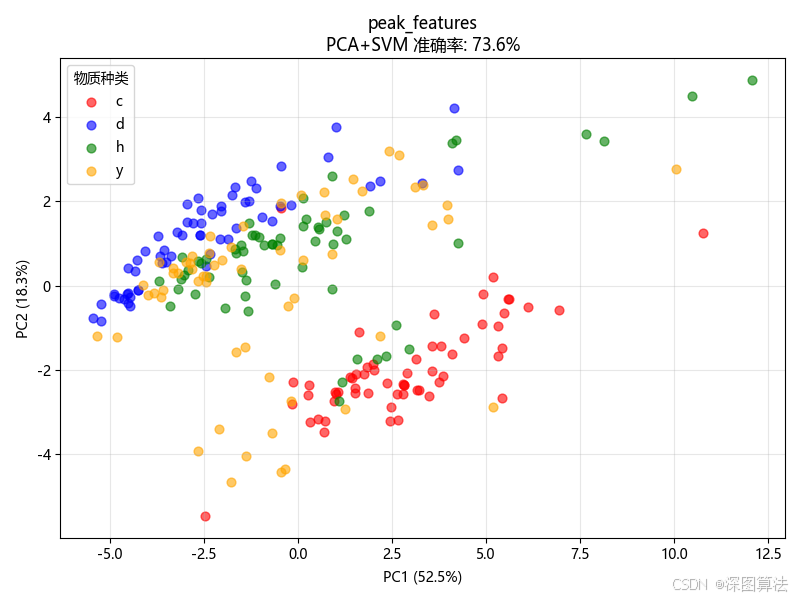 |
| 全光谱 | 峰特征 |
| 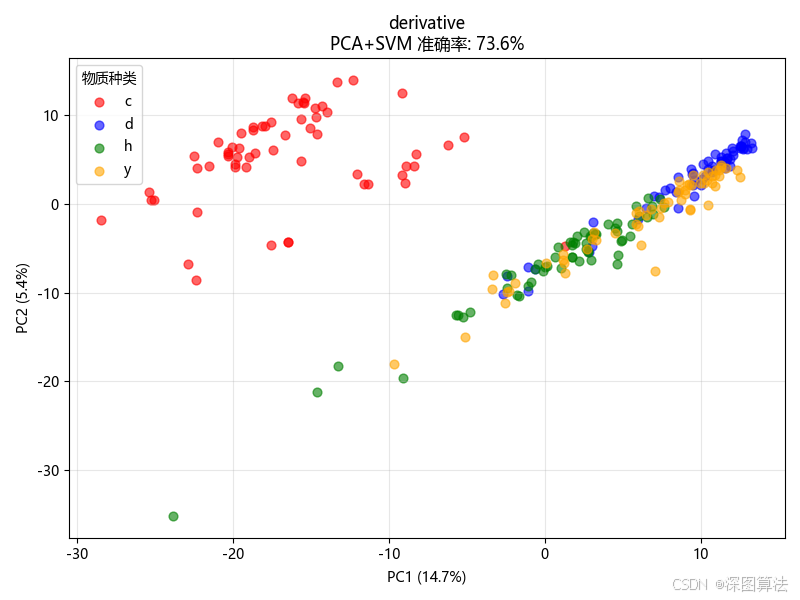 |
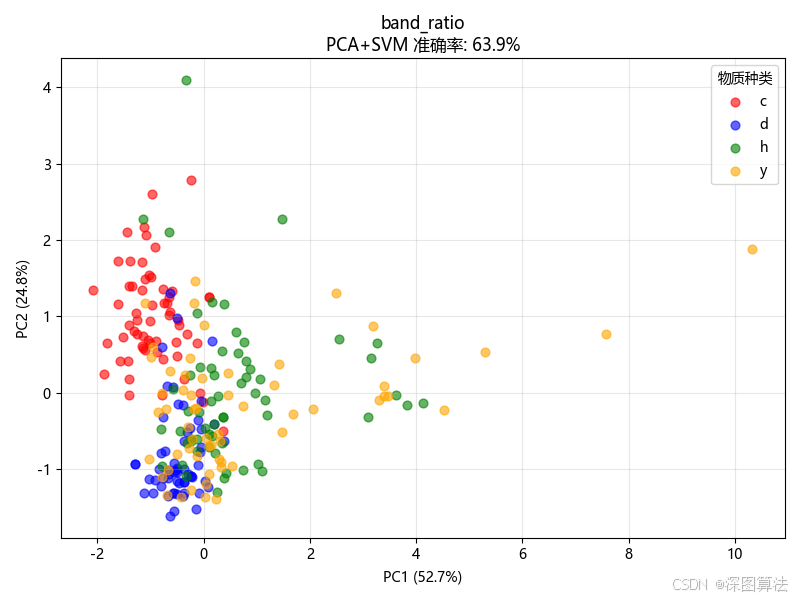 |
| 一阶导数 | 波段比值 |
结果解读 :
测试准确率(81.94%)与交叉验证均值(80.30%)接近,说明模型整体泛化能力尚可。但CV标准差高达20.48%,说明模型在不同子集上的表现波动较大。结合PCA累计解释方差仅为61.66%,说明降维至2维可能丢失了部分对分类有用的关键信息,加之物质h和y的光谱特征本身较为相似,导致了互相误判。
八、总结
通过PCA与SVM结合的流水线,光谱定性分析实现了自动化与较高的识别准确率。SVM自动学习了光谱间的非线性边界,提供了直观的决策依据。
针对当前结果,未来可进一步优化:
- 调整PCA降维维度,保留更多解释方差(如提升至95%以上)。
- 引入网格搜索,精细调整SVM的C和gamma参数。
- 针对易混淆物质(h和y)提取特定波段比值或一阶导数特征,进一步提升分类鲁棒性。