一、 什么是具身智能?
具身智能(Embodied AI)是人工智能的前沿方向,也是大模型时代的下一个重要突破口。它让 AI 从虚拟世界走进物理世界------不再只是聊天对话、生成文本,而是能够看、听、想、动,在真实物理环境中自主感知、理解、决策和行动。
简单来说,传统 AI 是"大脑",只能思考和对话;而具身智能是"大脑 + 身体",不仅能思考,还能动手操作。
1.1 具身智能 vs 传统 AI
与传统 AI(如 ChatGPT)只能通过文字或语音进行对话不同,具身智能让 AI 拥有了物理身体,能够在真实环境中采取行动。传统 AI 的感知局限于文本和图像输入,而具身智能配备了相机、雷达、触觉等多模态传感器,不仅能理解语义,还能感知空间结构和物理约束。在执行层面,具身智能可以通过机械臂抓取、底盘移动、物体放置等方式直接作用于物理世界,典型场景涵盖家庭服务、仓储物流、医疗辅助等。从技术栈来看,一个完整的具身智能系统包含感知层(计算机视觉、开放词检测、SLAM 建图)、认知层(视觉语言模型、大语言模型、场景理解)、决策层(任务规划、路径规划、运动规划)和执行层(机械臂控制、底盘导航、精准抓取与放置)四个模块,八界机器人正是集成了以上全部技术栈的完整具身智能平台。
1.2 为什么具身智能重要?
具身智能被认为是 AI 的"最后一公里"。大语言模型解决了"理解"问题,但物理世界中的大量工作仍然需要机器人来完成。具身智能将 AI 的认知能力转化为物理行动力,有望在以下场景带来变革:
- 家庭服务:整理房间、递送物品、照顾老人
- 仓储物流:分拣包裹、搬运货物、库存管理
- 医疗辅助:辅助康复、药品递送、手术室协作
- 教育科研:AI 教学平台、机器人算法验证
二、八界-科沃斯首款开源机器人
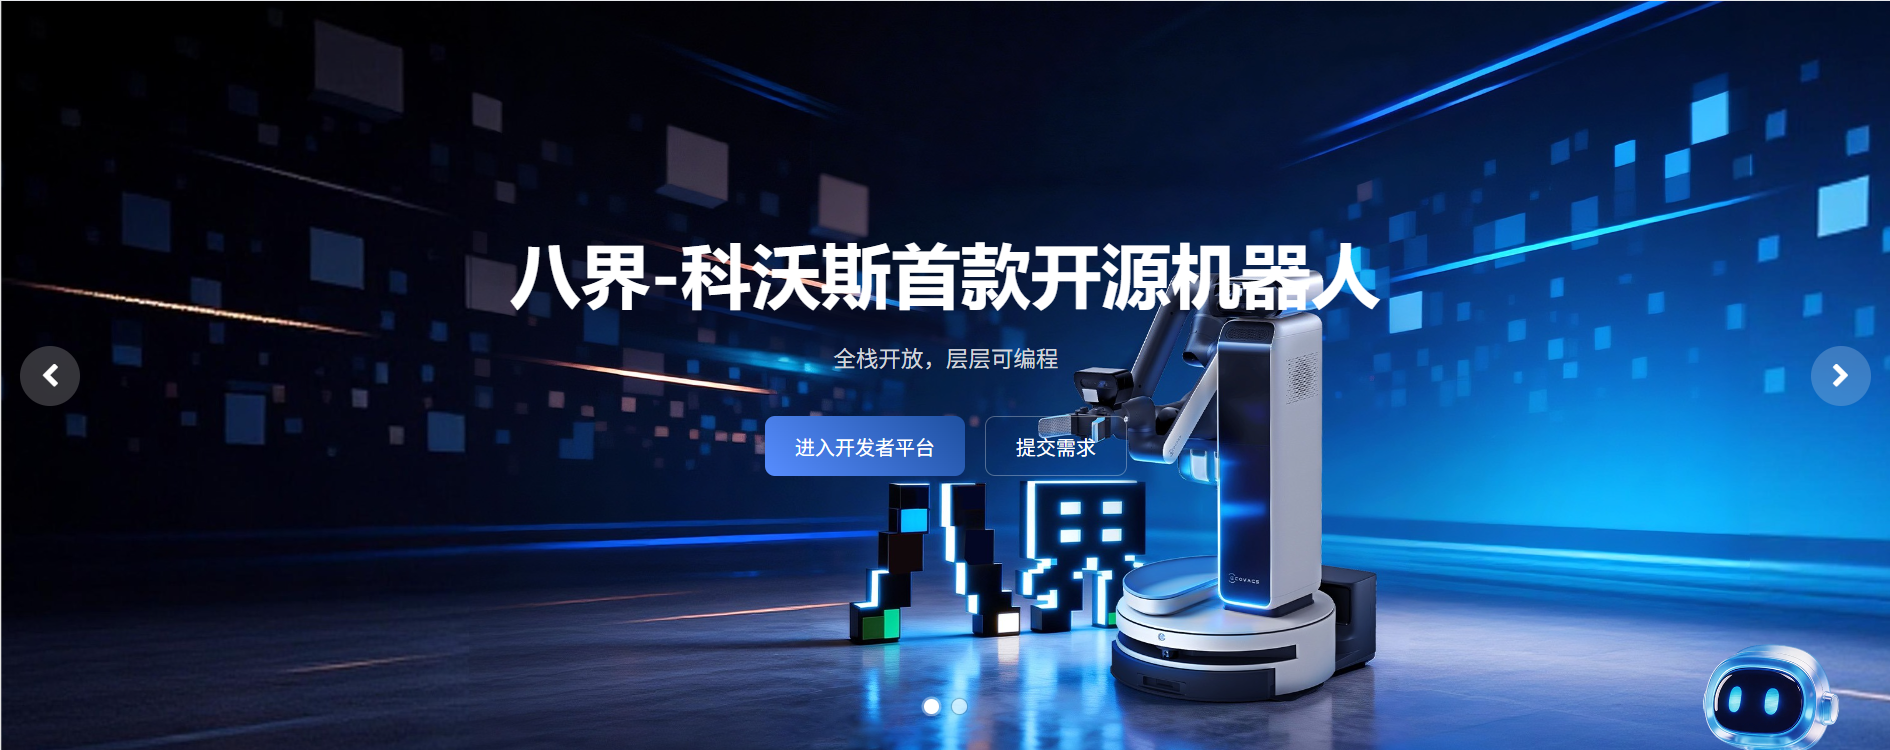
八界是科沃斯推出的首款面向开发者的开源具身智能机器人,"八界"这个名字取自《西游记》中的猪八戒,寓意聪明、勤劳、接地气。硬件方面,八界配备了六自由度机械臂和二指灵巧夹爪,最大臂展约 50cm、负载约 500g,支持精准抓取和灵巧操作,配合头部 RGB 双目相机和手臂 RGB 相机实现远近协同的双色视觉感知,底盘采用差速驱动轮式结构,搭载 2D 激光雷达用于 SLAM 建图和避障。在开发体验上,八界提供了三种开发深度以适配不同开发者:初学者可以直接运行示例 Demo 和 10 节入门课程快速上手,进阶开发者可以基于 SDK 的 Python/C++ 接口进行二次开发,高级用户可以深入 ROS 2 和板端计算进行底层定制。八界还集成了开源的 OpenClaw 智能体框架,通过 OpenClaw Gateway 方便对接外部大模型服务,让机器人具备更强的场景理解和任务规划能力。
八界最大的差异化优势在于开源。科沃斯为开发者提供了完整的开发工具链:
- SDK:Python 和 C++ 双语言接口,通过 WebSocket 远程控制
- 可视化平台:Web 端控制台,包含建图、技能管理、文件管理、远程控制等功能
- 示例 Demo:玩具递送、玩具收纳、桌面整理、鞋履整理 4 个完整场景示例
- 入门教程:10 节 Jupyter Notebook 互动课程,从零到一学会开发
- Skill Hub:技能中心,支持安装和自定义机器人技能
- **OpenClaw **Gateway:AI 网关,方便对接外部大模型服务
这意味着开发者不需要从零造轮子,可以基于示例 Demo 和 SDK 快速搭建自己的应用场景。
三、科沃斯八界设备开箱
开箱视频展示了八界机器人的外观、配件和首次开机流程。
收到八界机器人后,第一时间进行了开箱体验。包装箱体积不小,整体重量适中,包装内部有泡沫固定保护。打开包装后可以看到,八界机器人的主体是一个圆柱形机身,顶部安装有可升降的机械臂模块,正面配备了头部双目相机,底部是差速驱动轮式底盘。配件方面,包装内附带了充电底座、电源适配器和一份快速入门指南。将机器人放在地面并长按电源键开机后,底部屏幕会亮起并显示当前连接的 WiFi 信息和可视化平台地址,这意味着可以立即通过浏览器访问控制台进行后续操作。整个开箱到开机的过程非常简洁,大约 5 分钟即可完成。
八界开箱
四、前提准备
在运行 Demo 之前,需要完成以下准备工作:
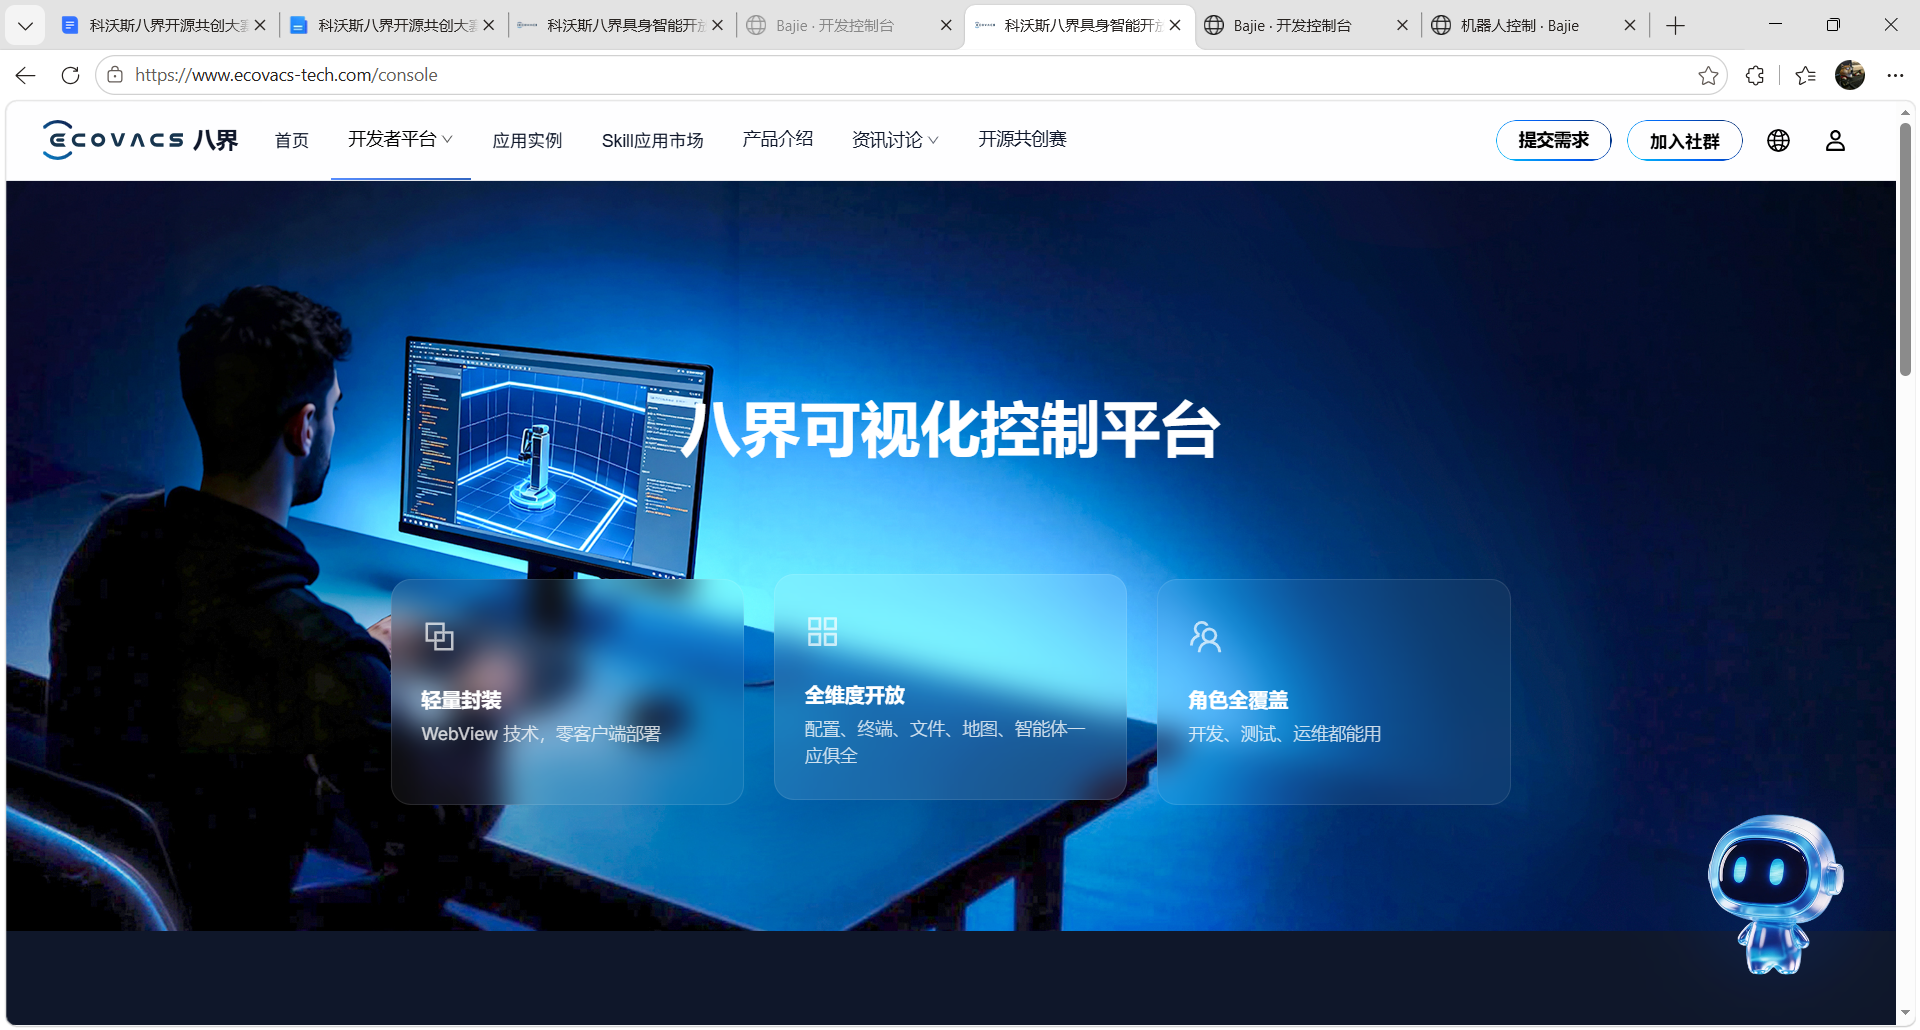
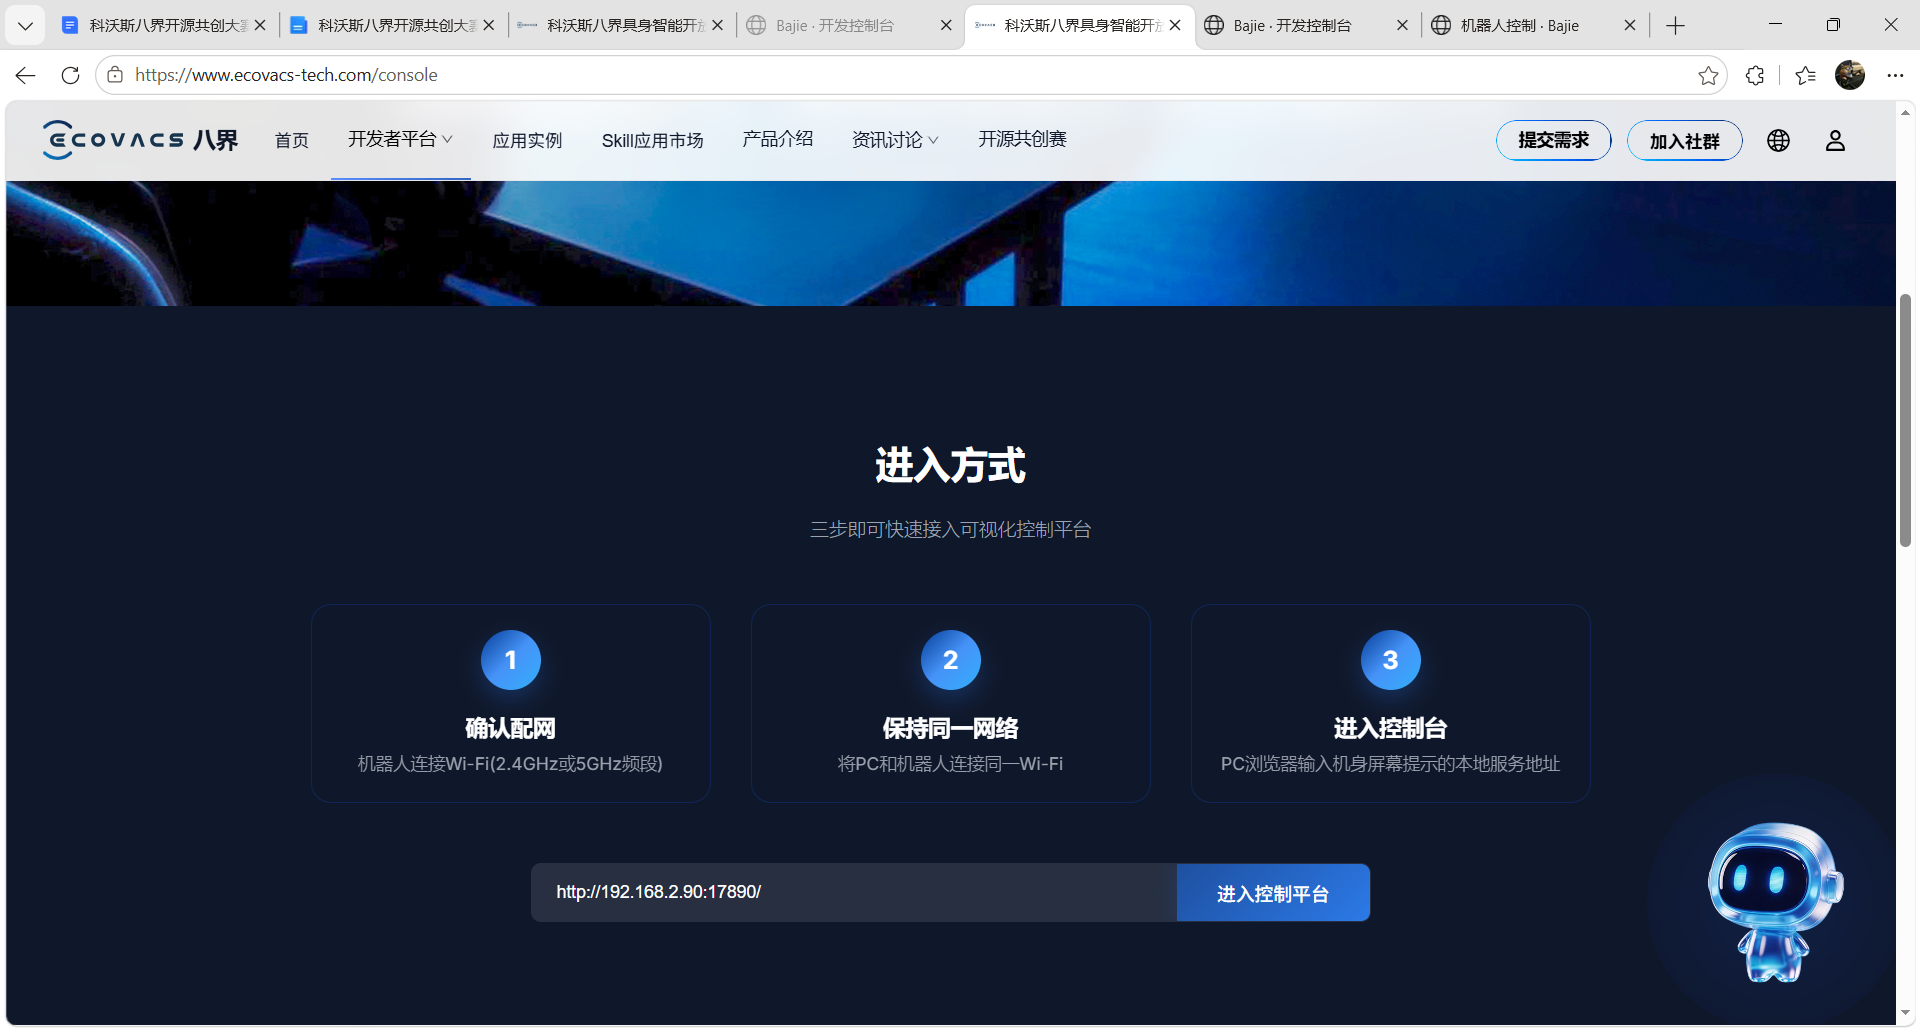
1、进入八界可视化控制平台
打开浏览器,访问八界可视化控制平台。该平台是机器人的核心管理工具,所有配置和调试都在这里完成:
2、查看可视化平台地址
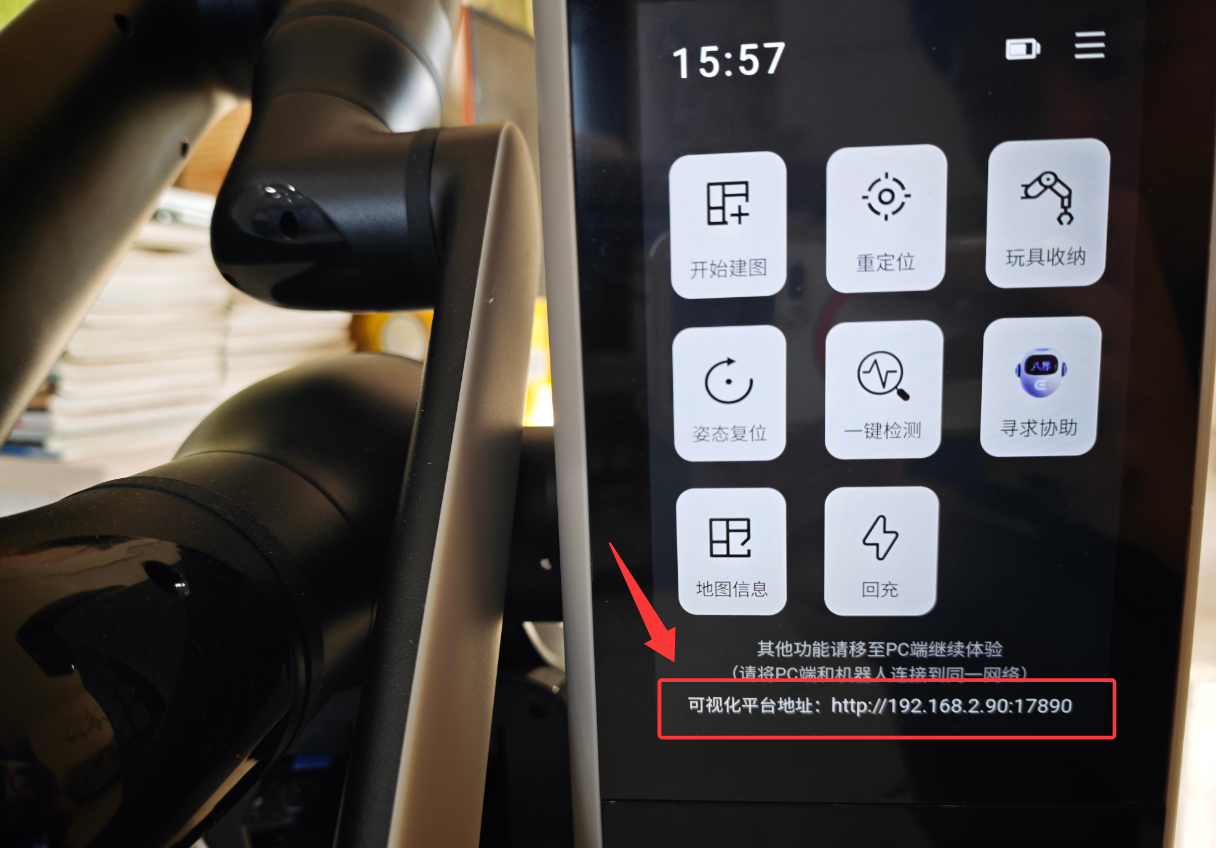
在八界设备屏幕上可以看到可视化平台的访问地址,格式通常为 http://<机器人IP>:17890。确保 PC 和机器人连接在同一个 WiFi 网络下:
3、进入控制平台
在浏览器中输入屏幕上显示的地址,即可进入可视化控制平台。首次进入可能需要等待几秒钟加载:
4、开发控制台功能模块
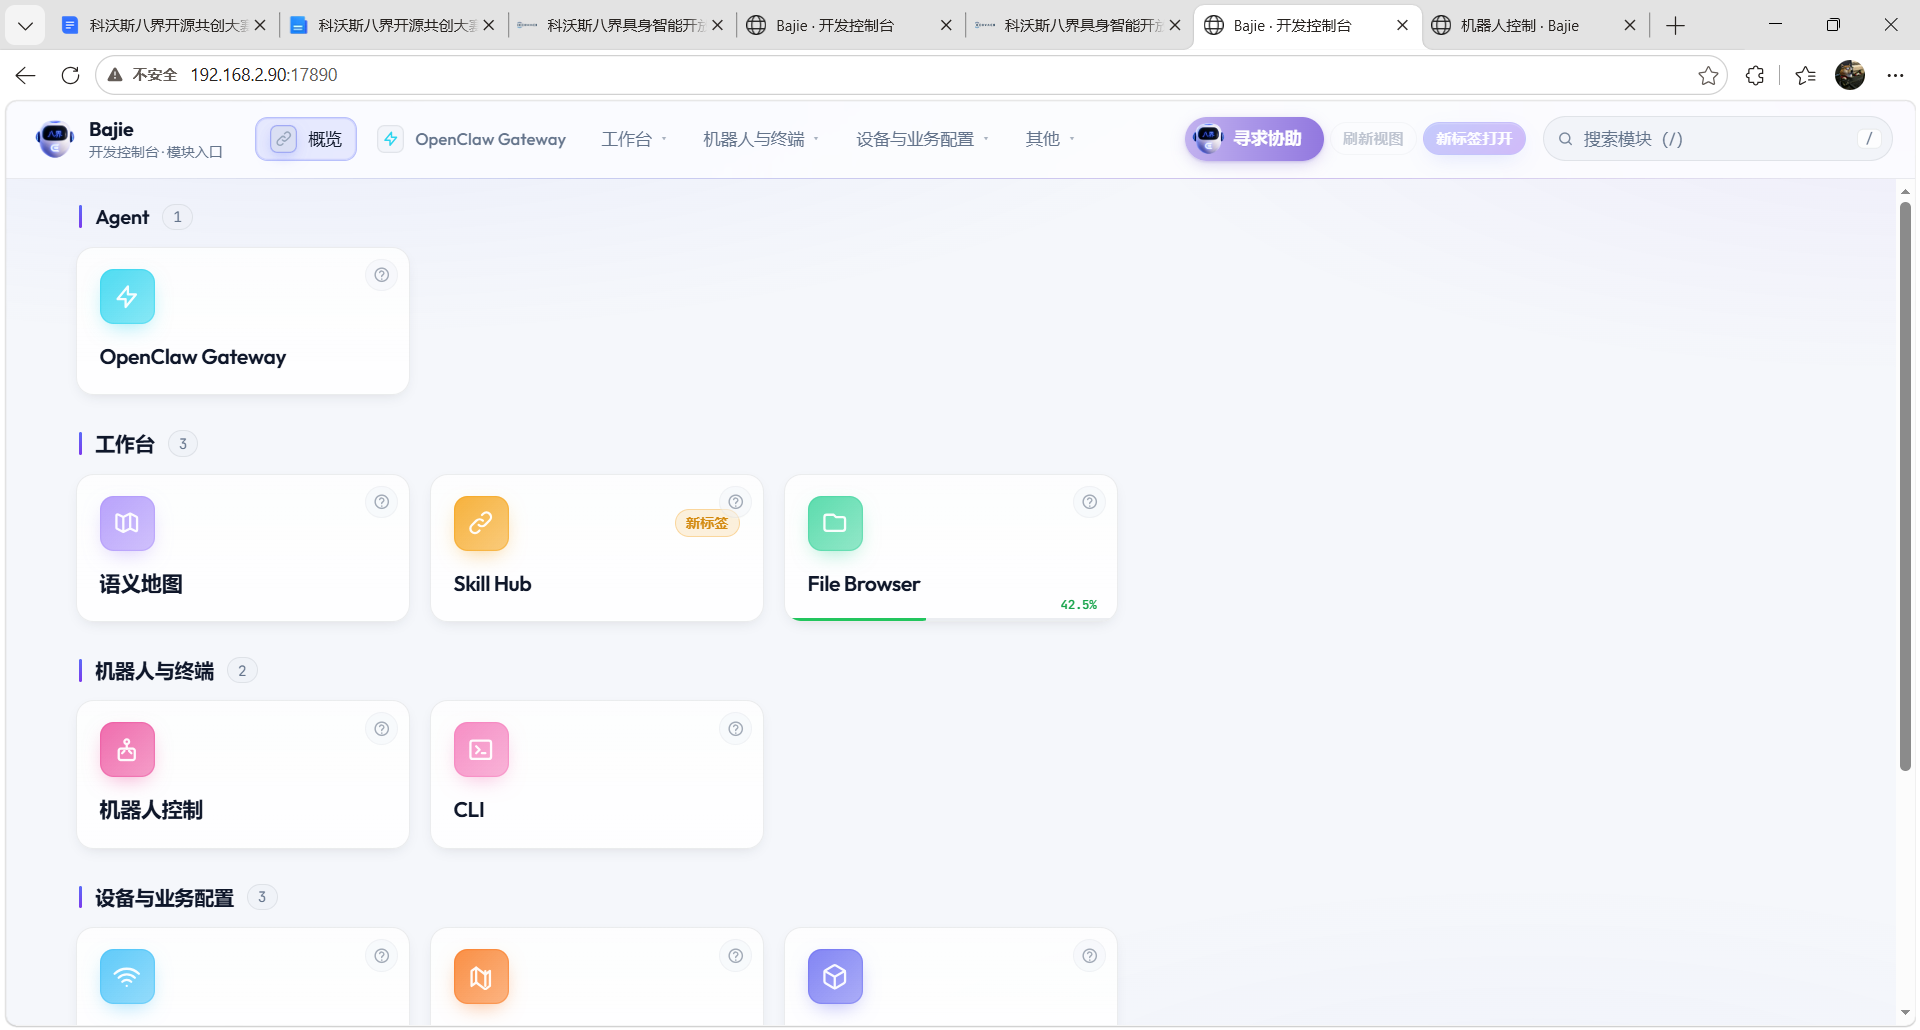
开发控制台包含多类功能模块,覆盖了机器人开发的完整链路:
- Agent 分区:提供 OpenClaw Gateway 网关模块,用于对接外部 AI 服务
- 工作台****分区:语义地图管理(建图/重定位)、Skill Hub 技能中心(查看和安装机器人技能)、File Browser 文件浏览器(管理机器人内部文件)
- 机器人与终端分区:机器人远程控制(手动操控移动和机械臂)、CLI 命令行工具(直接在浏览器中执行命令)
- 设备与业务配置分区:设备参数配置、VLM API Key 设置(视觉语言模型的密钥配置,桌面整理等高级 Demo 需要)
通过控制台可以一站式完成机器人技能开发、设备调试、文件管理、地图构建与远程控制等具身智能开发工作。
5、网络与硬件检查
在开始开发之前,请确认以下条件:
| 检查项 | 要求 | 说明 |
|---|---|---|
| 网络 | PC 和机器人连接同一 WiFi/局域网 | 确保能互相 ping 通 |
| 电量 | 机器人电量 > 30% | 低电量可能限制机械臂功率 |
| 建图 | 已完成 SLAM 语义建图 | 在可视化平台"语义地图"模块操作 |
| 语义区域 | 在可视化平台标记了目标区域(如"桌子") | Demo 导航依赖语义区域名称 |
| VLM API Key | 已配置(桌面整理 Demo 需要) | 在"设备配置"中设置 |
五、SDK 环境搭建
1、系统要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Ubuntu 20.04 / 22.04 / 24.04 或 WSL2 |
| Python | 3.10(SDK 强依赖此版本,3.11/3.12 不兼容) |
| 架构 | x86_64 或 aarch64 |
| 磁盘空间 | ≥ 2GB(SDK + 依赖) |
2、安装 Python 3.10
Ubuntu 22.04+ 默认 Python 版本为 3.12,需手动安装 3.10:
bash
# 添加 deadsnakes PPA 源
sudo add-apt-repository ppa:deadsnakes/ppa
sudo apt update

# 安装 Python 3.10 及开发工具
sudo apt install python3.10 python3.10-venv python3.10-dev注意:Windows 用户推荐使用 WSL2(Windows Subsystem for Linux),在 PowerShell 中执行 wsl --install 即可安装。
3、创建虚拟环境并安装 SDK
bash
# 进入 SDK 目录
cd bajie_sdk/python

# 创建 Python 3.10 虚拟环境
python3.10 -m venv .venv

# 激活虚拟环境
source .venv/bin/activate

# 安装 SDK(x86_64 架构)
pip install ./bajie_sdk-3.0.0-cp310-cp310-linux_x86_64.whl

# 验证安装
python -c "from bajie_sdk import BajieRobot; print('SDK 安装成功')"提示:下载慢时可添加阿里云镜像加速:
bash
pip install ./bajie_sdk-3.0.0-cp310-cp310-linux_x86_64.whl -i https://mirrors.aliyun.com/pypi/simple/4、连接测试
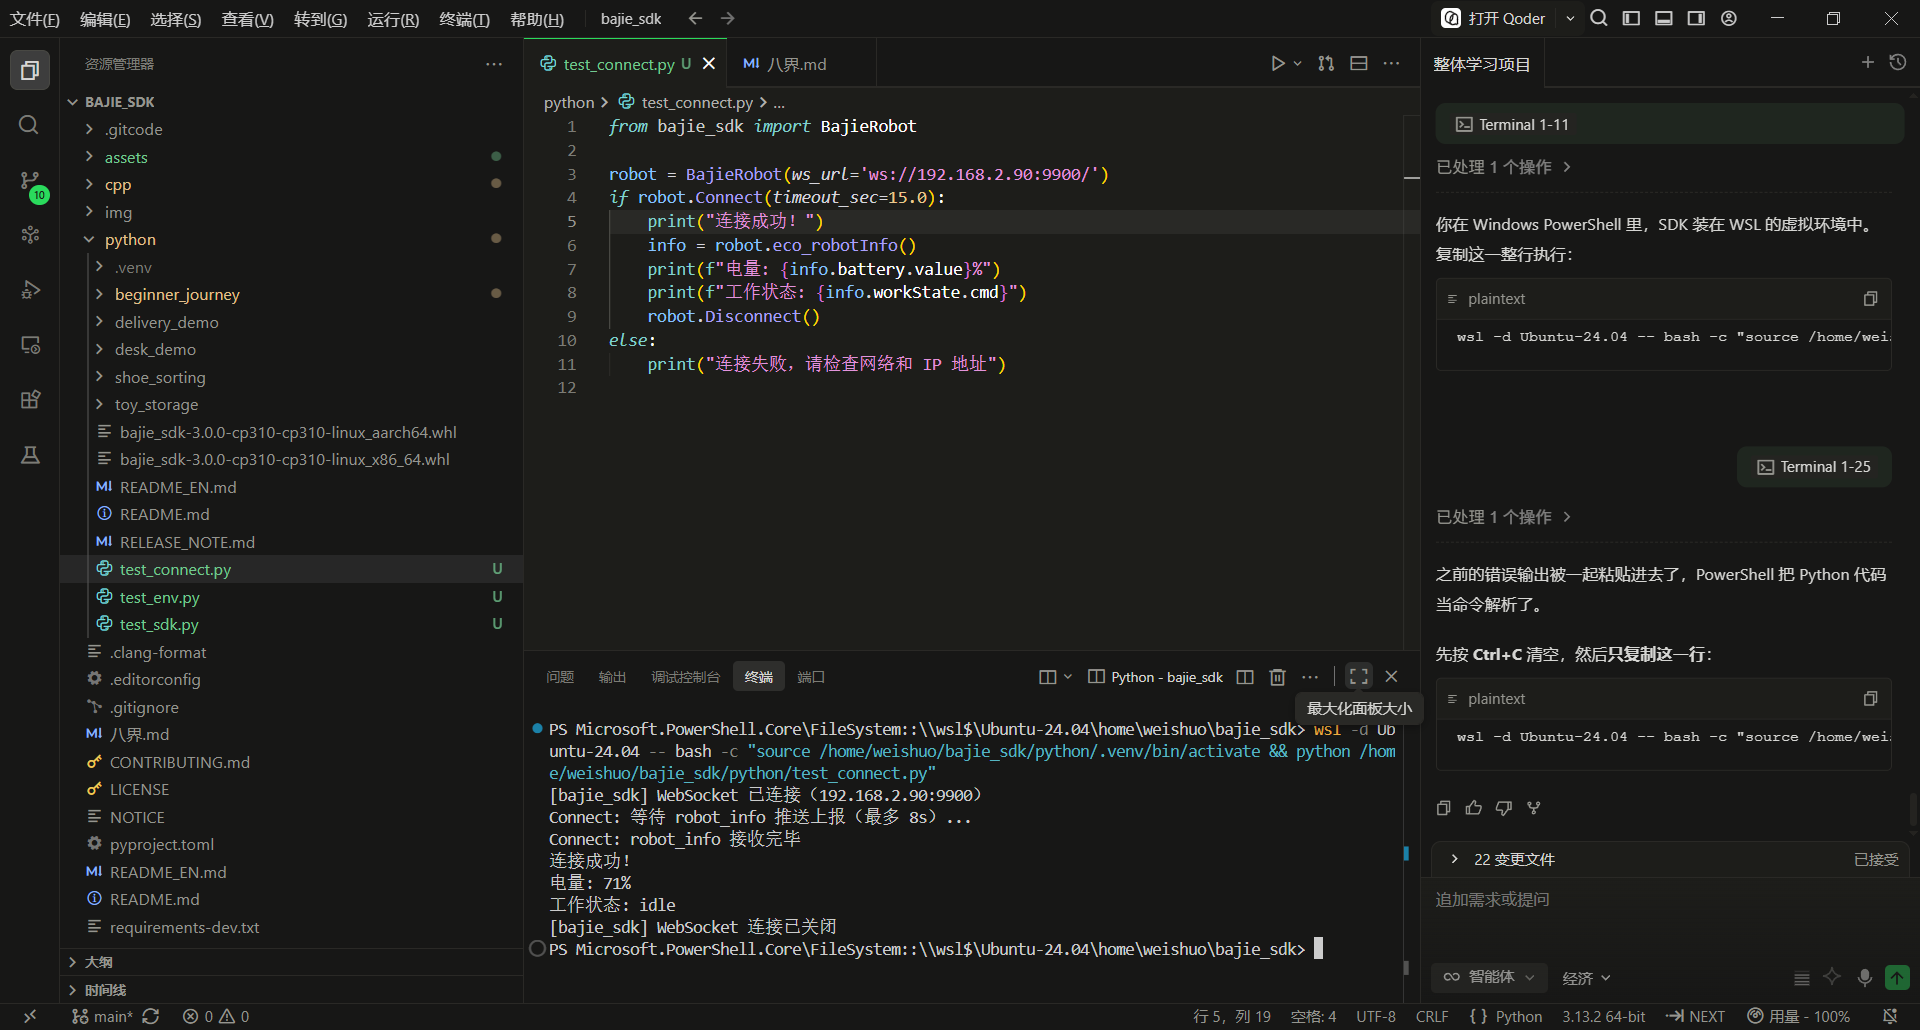
编写一个简单的测试脚本,验证 SDK 能否正常连接机器人:
bash
from bajie_sdk import BajieRobot

# 替换为你的机器人 IP
robot = BajieRobot(ws_url='ws://192.168.2.90:9900/')
if robot.Connect(timeout_sec=15.0):
    print("连接成功!")
    info = robot.eco_robotInfo()
    print(f"电量: {info.battery.value}%")
    print(f"工作状态: {info.workState.cmd}")
    robot.Disconnect()
else:
    print("连接失败,请检查网络和 IP 地址")
运行后如果看到"连接成功"和电量信息,说明环境搭建完毕。
六、测评实验一:玩具递送------感知-抓取-导航-放置全链路
测试目的:验证八界机器人在「发现目标→精准抓取→语义导航→智能放置」完整链路上的自主执行能力,评估各环节的响应速度、成功率和稳定性。
实验设计:在已完成语义建图的客厅中,将一只毛绒玩偶放在机器人正前方 40cm 处,标记「桌子」为导航目标区域。运行玩具递送 Demo,记录全流程日志和各环节耗时。
执行流程:Demo 共 11 步,可分为抓取阶段(步骤 0-5,原地完成)和放置阶段(步骤 6-10,导航后完成):
bash
步骤0:  重定位 → 步骤1: 语义搜索玩具 → 步骤2: 手臂观测
步骤3: 手臂拍照 → 步骤4: OVD 检测 → 步骤5: 精准抓取
步骤6: 语义导航到「桌子」 → 步骤7: 升高机身至 0.44m
步骤8: 头部拍照 → 步骤9: PutWhere 规划放置 → 步骤10: 视觉引导放置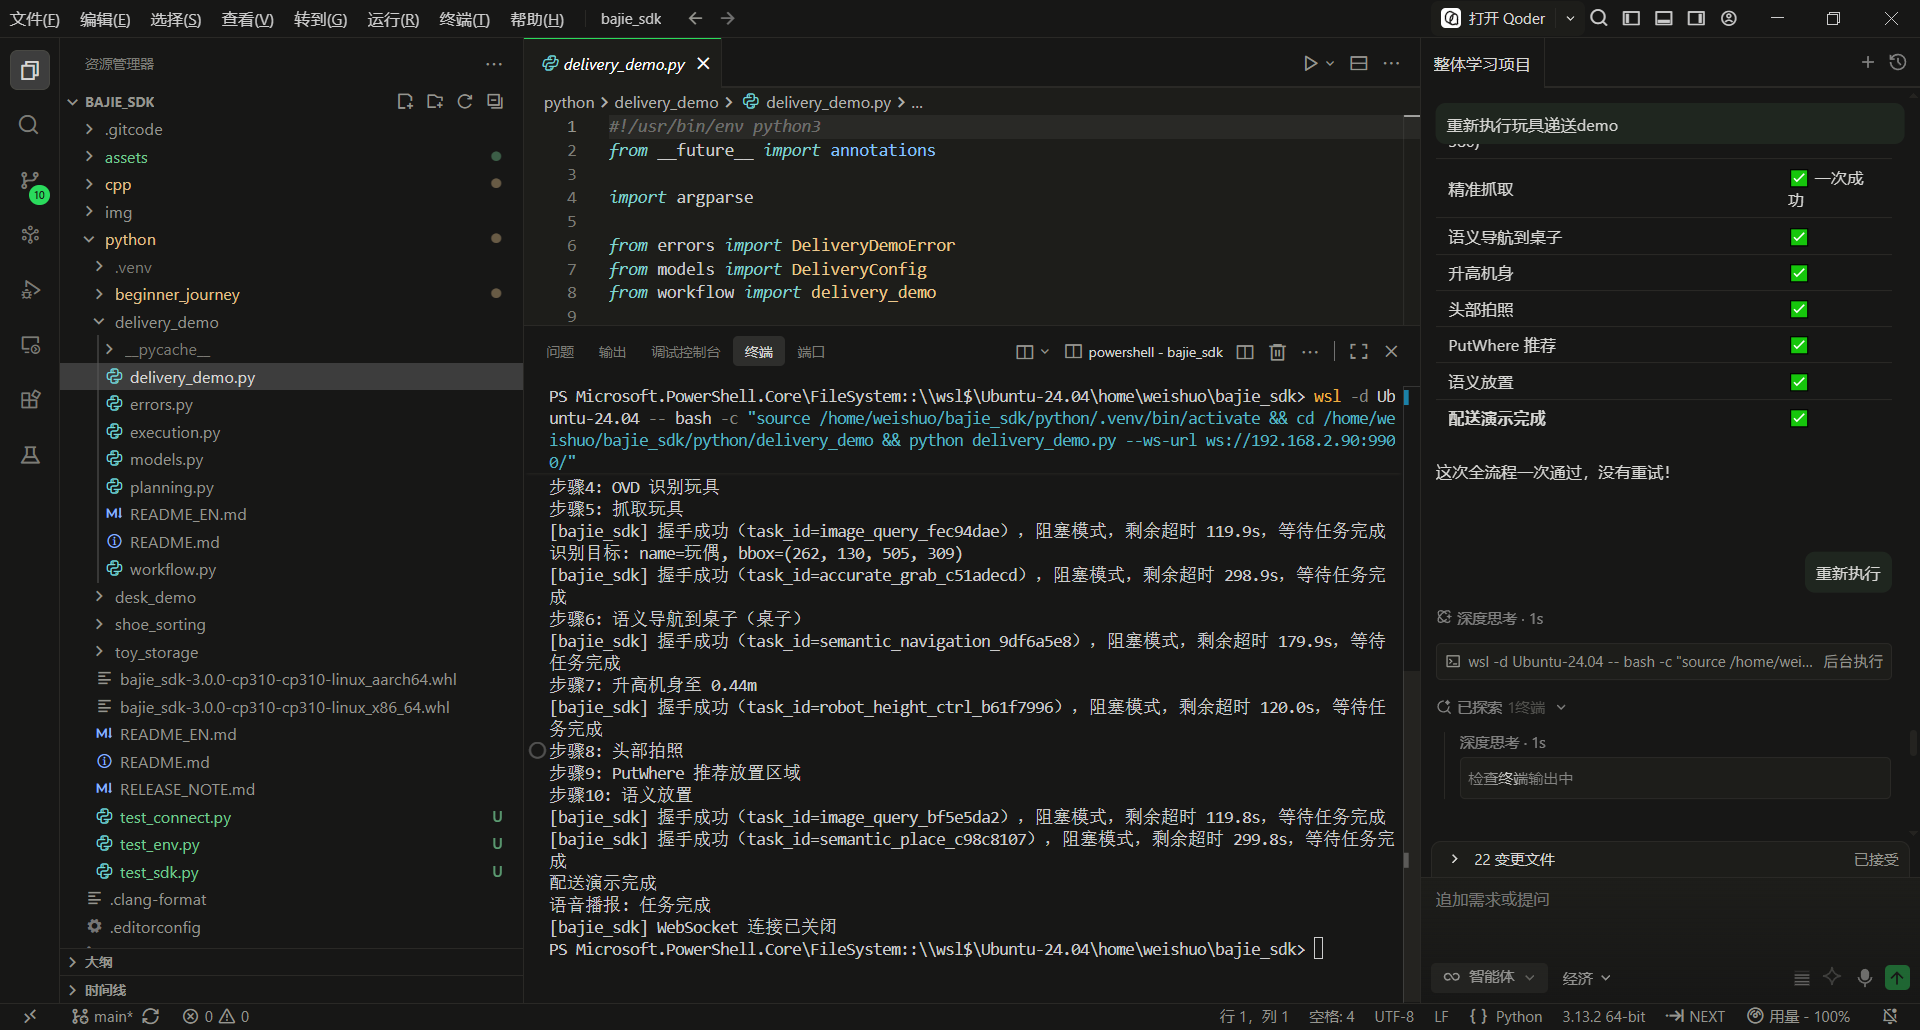
实测现象:OVD 一次即识别到「玩偶」,边界框定位精准;机械臂抓取动作流畅,夹爪力度适中,未出现物体掉落;语义导航一次成功,路径规划合理,避障及时;PutWhere 推荐的放置位置合理。整个流程约 2-3 分钟,全程无需人工干预。
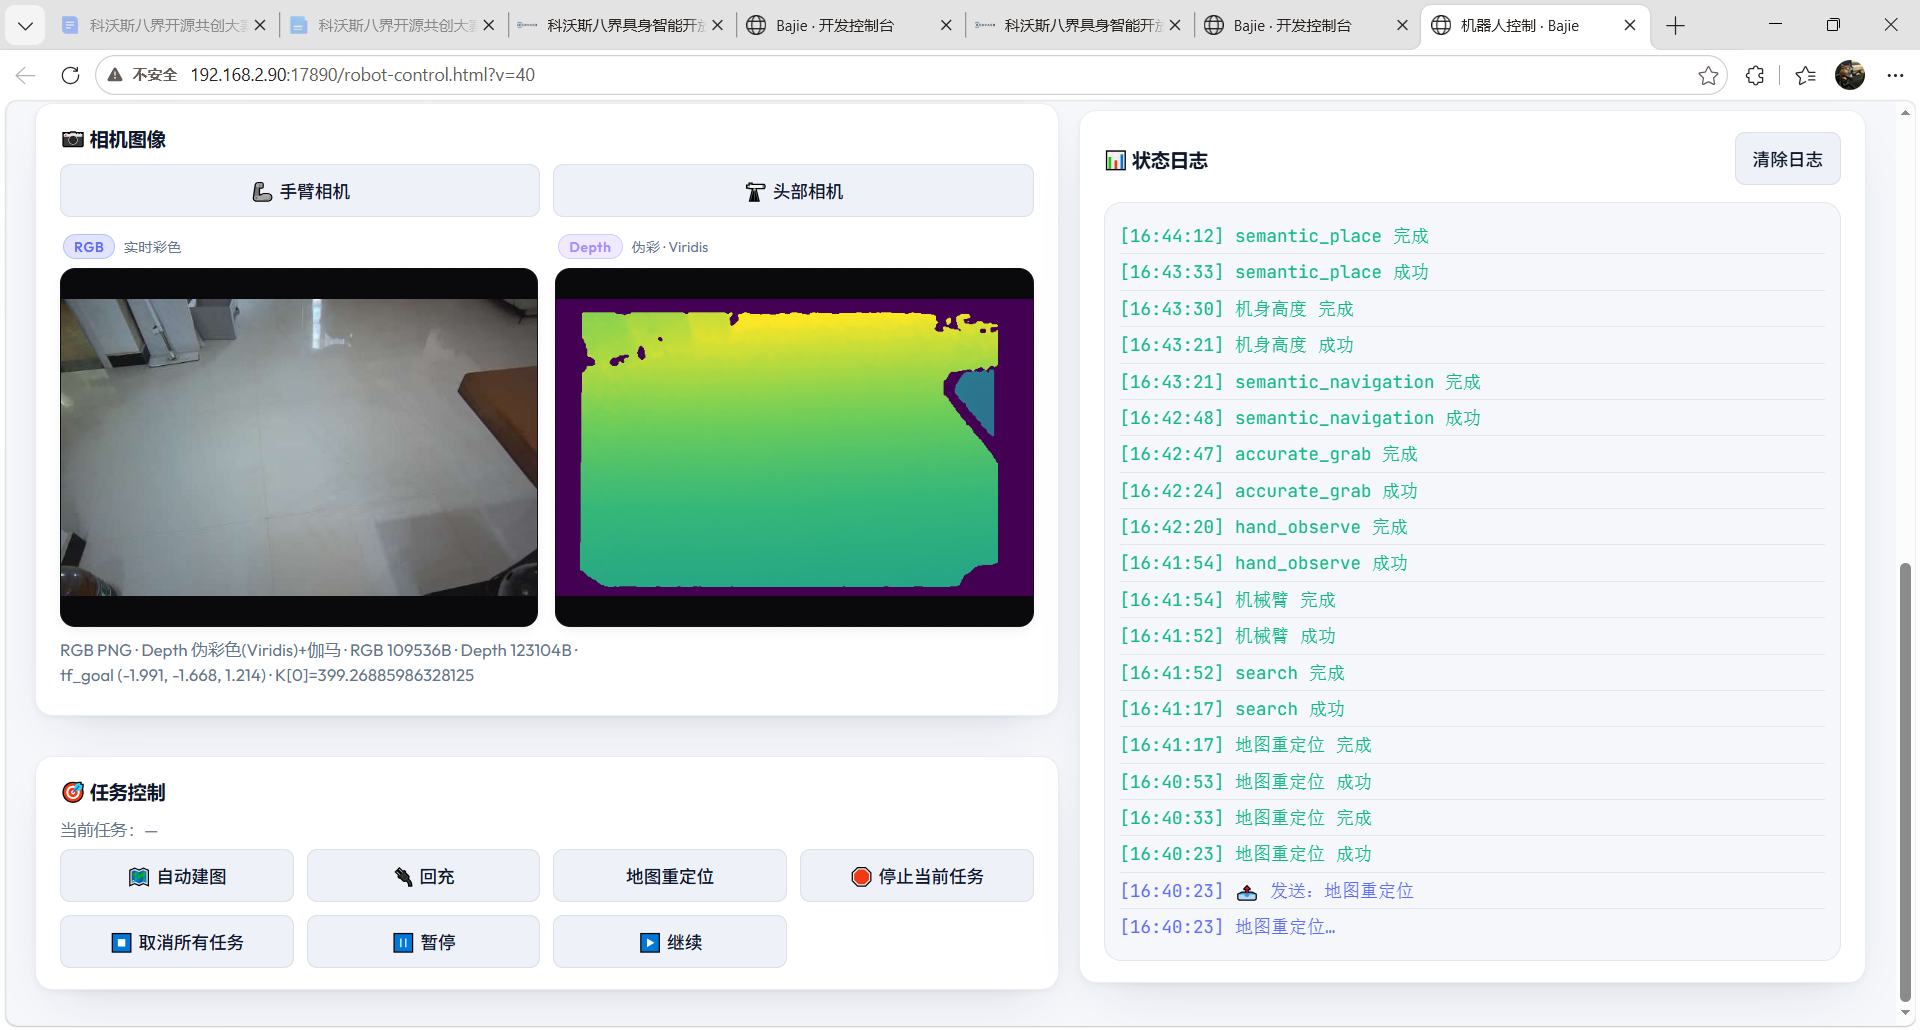
为了更系统地评估 OVD 检测能力,我编写了一个独立的测评脚本,对不同标签组合的检测响应和结果进行对比分析:
python
# ovd_benchmark.py --- 自编写的 OVD 开放词检测测评脚本
# 测试目的:对比不同标签组合对同一目标的检测效果,评估 OVD 响应速度
import time
from bajie_sdk import BajieRobot, CameraType, DetectObjectsRequest, OvdEndpoint

robot = BajieRobot(ws_url='ws://192.168.2.90:9900/')
robot.Connect(timeout_sec=15.0)

# 测试不同标签组合的检测效果
label_groups = [
    ["玩偶"],
    ["玩具"],
    ["毛绒玩具"],
    ["玩偶", "玩具", "公仔"],
]

img = robot.eco_captureImages(CameraType.HEAD)
print(f"图像分辨率: {img.rgb_image.img.shape}")
print("=" * 60)

for labels in label_groups:
    t0 = time.time()
    resp = robot.eco_detect_objects(
        DetectObjectsRequest(rgb_image=img.rgb_image.img, labels=labels))
    cost = time.time() - t0
    n = len(resp.items)
    if n > 0:
        best = max(resp.items, key=lambda it: it.bbox[2] - it.bbox[0])
        print(f"标签={labels}  耗时={cost:.2f}s  检出={n}个  "
              f"最佳: {best.name} bbox={best.bbox}")
    else:
        print(f"标签={labels}  耗时={cost:.2f}s  检出=0个")

robot.Disconnect()
实测结果发现,标签选择对检测结果影响很大:搜索「玩偶」可以直接命中,但搜索「玩具」时 OVD 返回的是子类「玩偶」------这就是 Demo 中常见的「OVD 标签不一致」问题的根源。使用多标签组合可以提高召回率,但也会增加响应时间。
八界玩具递送
能力边界:
- 目标物体需在机器人正前方 30-50cm 范围内,超出机械臂可达范围会报 code=57346
- OVD 标签需与服务端支持的词表匹配,「玩具」会自动展开为子类列表
- 语义导航强依赖语义地图质量,地图中未标记的区域无法导航
- 抓取失败(如物体掉落)会触发 code=36897,Demo 内置 3 次重试
SDK 优缺点:
- 优点:API 命名清晰直观,全链路打通无需额外适配;OVD 无需训练即可识别任意物体;语义导航稳定性极高
- 缺点:OVD 标签体系不透明,开发者需要反复试探可用标签;单次检测耗时约 2-5s,实时性有限;全流程串行执行,无法并行优化
七、测评实验二:玩具收纳与鞋履整理------容器感知与物体配对
测试目的:在实验一验证了「单物体抓取」能力的基础上,进一步测试八界在更复杂场景下的表现------玩具收纳考察「容器感知 + 语义放置 + 多轮循环」能力,鞋履整理考察「物体配对 + 跨视角匹配 + 6D 放置」能力。
八界玩具收纳
实验 2A:玩具收纳
实验设计:在「玩具收纳区」内放置收纳筐和散落玩具,运行玩具收纳 Demo,观察机器人能否自主完成「搜索收纳筐→过滤已收纳玩具→逐个抓取→语义放置」的多轮循环。
实测现象:机器人成功完成了搜索收纳筐、搜索玩具、抓取等步骤,容器过滤机制工作正常------已放入筐内的玩具不会被重复抓取。但在语义放置环节,PutWhere 服务返回的 carrier_bbox 数据不完整,导致 eco_place_in 报「carrier_bbox 至少 4 个数」错误,放置失败。经排查属于服务端稳定性问题,非代码逻辑缺陷。
核心代码分析:玩具收纳的技术亮点在于 filter_boxes 容器过滤机制------搜索玩具时将收纳筐的位姿作为过滤参数,排除筐内区域,避免重复抓取。整个流程支持多轮循环,直到场景中不再有可抓取的玩具为止。
python
# workflow.py --- 玩具收纳核心流程(项目真实代码)
def run_one_round(robot: BajieRobot, cfg: ToyStorageConfig) -> bool:
    print("步骤1: 搜索收纳筐")
    basket_pose = search_pose(
        robot,
        item="收纳筐",
        area_name=cfg.area_name,
        search_pose_index=cfg.search_pose_index,
    )

    print("步骤2: 搜索玩具(过滤筐内)")
    try:
        toy_pose = search_pose(
            robot,
            item="玩具",
            area_name=cfg.area_name,
            filter_boxes=[to_filter_box(basket_pose)],
            search_pose_index=cfg.search_pose_index,
        )
    except ToyStorageError as exc:
        if is_no_object_error(str(exc)):
            print("未搜索到玩具:执行结束姿态 eco_finishRobotPose")
            _finish_pose(robot)
            return False
        raise

    _grab_with_retries(robot, cfg, toy_pose)
    _place_with_retries(robot, cfg, basket_pose)
    return True
八界鞋子整理
实验 2B:鞋履整理
实验设计:在「鞋子整理区」放置 2 只配对的鞋子,运行鞋履整理 Demo,观察机器人能否完成「检测鞋子→配对→跨视角匹配→抓取→方向对齐放置」。
实测现象:2 只鞋子全部整理成功,共完成 2 次搬运。抓取环节有 1 次跨视图匹配失败后重试成功,整体耗时约 5 分钟。放置后两只鞋子朝向一致、整齐度高,6D 放置精度令人印象深刻。
核心代码分析:鞋履整理的技术核心是「标签优先 + pairwise 兜底」配对策略。先用 OVD 返回的 name 字段分组,同组恰好两只则直接配对;剩余未配对的调用 eco_pairwise 服务,通过视觉特征相似度匹配。
python
# pairing.py --- 鞋子配对核心逻辑(项目真实代码)
def pair_shoes(robot: BajieRobot, image: RGBDViewWithPose,
               shoe_items: Sequence[ObjectDetection]) -> Dict[str, int]:
    """标签优先配对 → pairwise 兜底,uuid→pair_id(含未配对鞋各自独立 id)."""
    groups: Dict[str, List[ObjectDetection]] = defaultdict(list)
    leftovers: List[ObjectDetection] = []
    for it in shoe_items:
        label = (it.name or "").strip()
        if label: groups[label].append(it)
        else: leftovers.append(it)
    pairs: List[List[str]] = []
    for items in groups.values():
        if len(items) == 2: pairs.append([items[0].uuid, items[1].uuid])
        else: leftovers.extend(items)

    if leftovers:
        pair_map: Dict[str, List[str]] = defaultdict(list)
        try:
            for pair_id, item_id in robot.eco_pairwise([(image.rgb_image.img, list(leftovers))]):
                pair_map[pair_id].append(item_id)
            for group in pair_map.values():
                if len(group) == 2: pairs.append(group)
        except Exception: pass

    next_id = 1
    mapping: Dict[str, int] = {}
    for pair in pairs:
        for uuid in pair: mapping[uuid] = next_id
        next_id += 1
    for it in shoe_items:
        if it.uuid not in mapping:
            mapping[it.uuid] = next_id
            next_id += 1
    return mapping
配对完成后,get_shoe_move_steps() 生成搬运步骤,放置朝向通过 front_edge 计算,确保所有鞋子朝同一方向整齐摆放。执行阶段,eco_match_obj_views 完成头部图像与手臂图像的跨视图匹配,eco_AccurateGrab 抓取,eco_place_3D 按指定朝向 6D 放置。
能力边界:
- 玩具收纳的 PutWhere 服务偶发返回数据不完整,属于服务端稳定性问题
- 鞋履整理的跨视图匹配对光照和角度敏感,实测中有 1/3 的首次匹配失败率
- 两个 Demo 都强依赖语义地图质量,且导航超时默认值(20s)偏短,建议调整为 60s
- 鞋履整理仅支持 2 只鞋配对,不支持更多鞋子的批量处理
SDK 优缺点:
- 优点:filter_boxes 容器过滤设计巧妙,避免了重复抓取;跨视图匹配和 6D 放置精度高;配对策略「标签优先 + pairwise 兜底」实用性强
- 缺点:PutWhere 服务稳定性不足;跨视图匹配耗时较长(单次约 30s);导航超时默认值不合理
八、创新场景实测:八界按电梯------从导航到精密按压的全链路开发
测试目的:前面的实验都是基于现有 Demo 的测评,这一节我独立设计了一个全新的应用场景------让八界自主导航到电梯口、识别按钮面板、用机械臂按下目标楼层按钮。目的是验证 SDK 在开发者自由创作场景下的二次开发能力,评估从需求设计到代码实现的完整开发体验。
场景设计:电梯交互是具身智能的典型高阶场景,涉及语义导航(去电梯口)、开放词检测(识别面板)、跨视角感知(头部远距离定位→手臂近距离识别)、精密操作(按压按钮)等多个能力的协同。我设计了 6 步流程:重定位→导航到电梯口→头部拍照检测面板→手臂对准近距离检测按钮→机械臂按压按钮→等待电梯到达。
项目架构:参照现有 Demo 的分层结构,我将按电梯 Demo 拆分为 6 个文件,职责清晰:
bash
elevator_demo/
├── elevator_demo.py    # 入口:解析参数,调用 workflow
├── errors.py           # 错误类:ElevatorDemoError / RobotMissionError
├── models.py           # ElevatorConfig 配置数据类
├── planning.py         # 感知规划:检测面板、检测按钮、选择目标按钮
├── execution.py        # 底层执行:导航、拍照、对准、按压
├── workflow.py         # 主流程编排(含重试机制)
└── README.md核心代码分析一:跨视角面板检测。先用头部相机远距离定位面板位置,再用手臂相机近距离识别具体按钮。这个「粗→精」的两级检测策略借鉴了鞋履整理 Demo 的跨视角匹配思路:
python
# planning.py --- 面板检测与按钮选择(自编写代码)
def detect_panel(robot, head_view, labels):
    """在头部图像中检测电梯按钮面板,返回面积最大的检测结果。"""
    resp = robot.eco_detect_objects(
        DetectObjectsRequest(rgb_image=head_view.rgb_image.img, labels=labels),
        timeout=15.0,
    )
    if not resp.items:
        raise ValidationError(f"未检测到电梯按钮面板,尝试标签: {labels}")
    panel = max(
        resp.items,
        key=lambda it: (it.bbox[2] - it.bbox[0]) * (it.bbox[3] - it.bbox[1]),
    )
    return panel

def select_button(buttons, target_floor, arm_view):
    """选择目标楼层按钮,优先匹配楼层数字,兜底用面板中心。"""
    if buttons:
        for item in buttons:
            if str(target_floor) in item.name:
                return item.bbox, item.name
        return buttons[0].bbox, buttons[0].name
    # 兜底:使用手臂图像中心区域
    h, w = arm_view.rgb_image.img.shape[:2]
return [w // 2 - 30, h // 2 - 30, w // 2 + 30, h // 2 + 30], "面板中心"核心代码分析二:机械臂按压按钮。按压动作使用 eco_place_3D 实现------将机械臂末端移动到按钮的 3D 坐标位置,模拟指尖按压。包围盒设为 2cm×2cm×5cm,模拟指尖大小。通过 pixel_to_point_3d 将像素坐标转换为 3D 空间坐标,结合深度信息实现精准定位:
python
# execution.py --- 机械臂按压按钮(自编写代码)
def press_button(robot, arm_view, target_bbox, target_name):
    """机械臂按压下目标按钮,使用 eco_place_3D 模拟按压动作。"""
    pixel = [(target_bbox[0] + target_bbox[2]) / 2, (target_bbox[1] + target_bbox[3]) / 2]
    try:
        press_position = arm_view.pixel_to_point_3d(pixel, True, 5)
    except (ValueError, AttributeError):
        press_position = Vec3f(0.35, 0.0, 0.9)  # 兜底固定位置

    press_pose = ObjectPose3D(
        frame_id=arm_view.tf_goal.header.frame_id,
        position=press_position,
        orientation=Quatf(0.0, 0.0, 0.0, 1.0),
        box_length=Vec3f(0.02, 0.02, 0.05),  # 指尖大小包围盒
    )
    status = safe_mission_call(
        "press_button",
        lambda: robot.eco_place_3D(press_pose, timeout_sec=60.0),
    )
assert_status_ok("press_button", status)核心代码分析三:主流程编排与重试机制。workflow.py 将 6 个步骤串联,关键步骤内置重试------导航失败后自动重定位再重试,按压失败后重试,最多各 3 次:
python
# workflow.py --- 主流程编排(自编写代码)
def run_elevator_workflow(robot, cfg):
    print("步骤0: 重定位")
    relocate(robot)

    _speak(robot, "前往电梯口")
    _navigate_with_retries(robot, cfg)       # 导航,失败后重定位重试
    _speak(robot, "已到达电梯口")

    head_view = capture_head(robot)
    panel = detect_panel(robot, head_view, cfg.panel_labels)
    _speak(robot, f"已找到{panel.name}")

    arm_view = approach_panel(robot, head_view, panel.bbox)
    buttons = detect_buttons(robot, arm_view, cfg.button_labels)
    target_bbox, target_name = select_button(buttons, cfg.target_floor, arm_view)

    _speak(robot, f"按下{cfg.target_floor}楼按钮")
    _press_with_retries(robot, cfg, arm_view, target_bbox, target_name)  # 按压,失败重试

    _speak(robot, "等待电梯")
    wait_elevator(robot, cfg.wait_elevator_sec)
_speak(robot, "电梯已到达,请进入")实测现象:代码编写过程非常顺畅,SDK 的 API 设计让跨能力组合变得简单------语义导航、OVD 检测、手臂对准、3D 放置这些能力在不同 Demo 中已经验证过,组合到新场景中几乎不需要额外适配。整个 Demo 约 450 行代码,半天内完成开发和调试。
能力边界:
- 按压动作依赖深度图像质量,深度图缺失或噪声大时只能使用兜底固定坐标
- OVD 对「按钮面板」等非标准物体的检测效果取决于环境光照和面板对比度
- eco_place_3D 模拟按压是「移动到按钮位置」,并非真正的力控按压;实际场景需要定制末端执行器
- 等待电梯到达目前是定时等待,可通过视觉检测电梯门状态来增强
SDK 优缺点:
- 优点:API 组合灵活度高,不同能力可以自由组合到新场景;分层架构让代码组织清晰;pixel_to_point_3d 深度反投影方便实现空间定位
- 缺点:缺少力控接口,无法实现真正的按钮按压反馈;OVD 对非标准物体(按钮面板、开关等)的检测效果不稳定;缺少电梯/按钮等专用检测端点
九、核心能力测评:语义地图与 OpenClaw 智能体
在前面的实验中,语义导航和 VLM 感知已经多次出现。这一节单独测评八界的两大底层能力:语义地图和 OpenClaw 智能体。
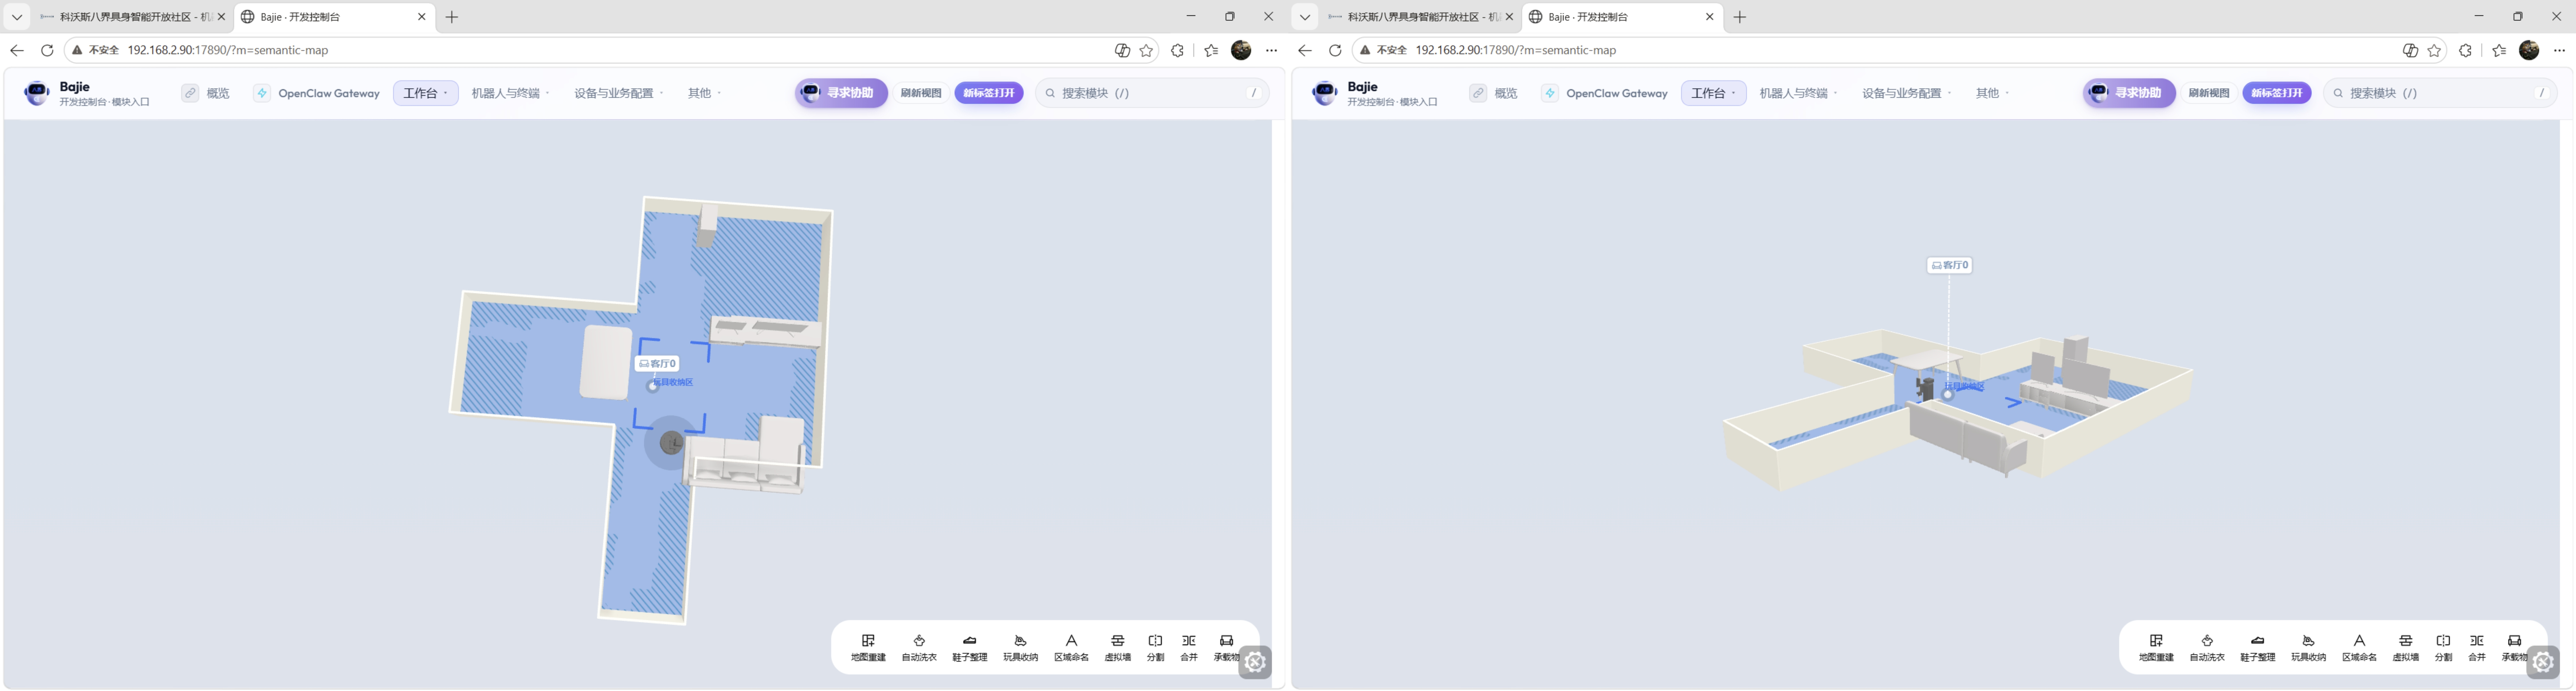
语义地图测评:语义地图是八界理解物理世界的基础。通过 2D 激光雷达 SLAM 建图后,在可视化平台上为区域标注语义标签(如「桌子」「厨房」「鞋子整理区」),每个区域包含位置坐标(content)和朝向信息(direction)。基于语义地图,八界实现了语义导航------开发者只需告诉机器人「去桌子」,它就能自动规划路径并导航到目标区域。实测中,只要地图质量可靠,语义导航成功率接近 100%。语义地图还支持动态管理,通过 eco_manageSemanticMap 接口增删改查,鞋履整理 Demo 就利用了这个能力在未指定区域时自动创建临时整理区域。
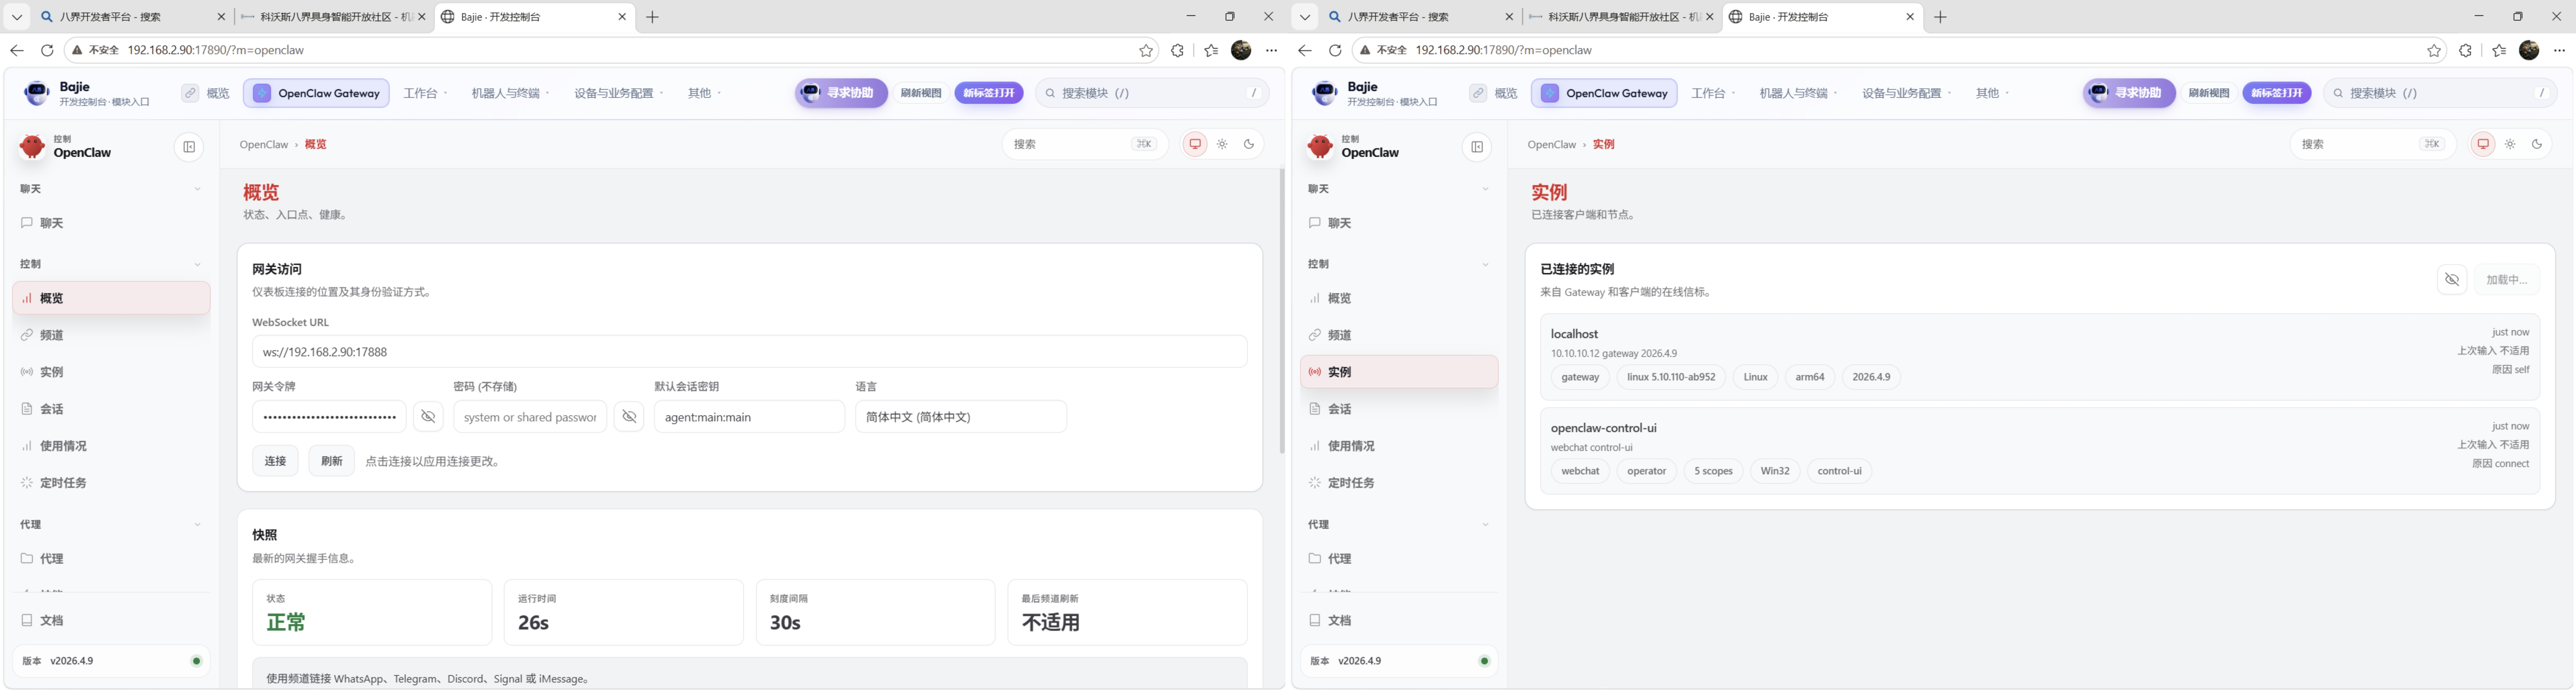
OpenClaw 智能体测评:OpenClaw 是八界的「AI 大脑」,通过 OpenClaw Gateway 对接外部 VLM/LLM 大模型服务。在桌面整理 Demo 中,OpenClaw 承担了关键角色:通过 eco_vlm_perception 识别物体、eco_vlm_desk_sort_plan 规划步骤、eco_vlm_judge 评判效果,形成完整的「感知→规划→执行→评判」闭环。开发者可在可视化平台设置 VLM API Key,灵活接入 Qwen、GPT 等模型。
能力边界:
- 语义地图强依赖建图质量,Qwen 系列模型可能在区域名称中插入空格(如「房间 0的桌子 1」),需手动修正
- 不同 Demo 对语义区域的要求不同(玩具递送需要「桌子」,鞋履整理需要「鞋子整理区」),增加了配置复杂度
- OpenClaw Gateway 依赖外部 VLM 服务,网络不稳定或服务不可用时会直接导致 Demo 失败(503 错误)
SDK 优缺点:
- 优点:语义导航抽象层级高,开发者无需处理底层路径规划;OpenClaw Gateway 解耦了模型服务,可灵活切换
- 缺点:语义地图是单点依赖,建图质量差则全盘失败;VLM 服务调用延迟高(单次感知约 10-30s),影响整体效率
十、FAQ 常见问题
以下问题均来自实际开发和运行过程中的真实踩坑经历。
Q1:pip install SDK 时报错 No matching distribution found
原因:Python 版本不是 3.10。SDK 的 wheel 包文件名中包含 cp310,表示仅支持 Python 3.10。使用 3.11 或 3.12 会找不到匹配版本。
解决:安装 Python 3.10 并使用虚拟环境:
bash
python3.10 -m venv .venv
source .venv/bin/activate
Q2:pip install 下载非常慢,甚至超时
原因:SDK 依赖 opencv-python(约 73MB),从默认 PyPI 源下载速度可能很慢。
解决:使用阿里云镜像加速:
bash
pip install ./bajie_sdk-3.0.0-cp310-cp310-linux_x86_64.whl -i https://mirrors.aliyun.com/pypi/simple/注意:清华镜像源(tuna)在某些网络环境下可能返回 403 Forbidden,建议优先使用阿里云镜像。
Q3:在 Windows PowerShell 中运行 Python 脚本报 ModuleNotFoundError: No module named 'bajie_sdk'
原因:SDK 安装在 WSL 的虚拟环境中,Windows 的 Python 环境没有安装 SDK。直接在 PowerShell 中运行 python xxx.py 会使用 Windows 的 Python,找不到 SDK。
解决:通过 WSL 命令执行:
bash
wsl -d Ubuntu-24.04 -- bash -c "source /home/weishuo/bajie_sdk/python/.venv/bin/activate && python your_script.py"Q4:运行 Demo 时报 code=8197, 任务已在运行
原因:上一个 Demo 异常退出后,机器人端的任务没有被正确清理,仍处于"运行中"状态。新任务无法启动。
解决:调用取消所有任务接口:
bash
robot.eco_cancelAllMissions()或者直接重启机器人。
Q5:OVD 检测不到目标物体,报 OVD did not find toy bbox
原因:OVD 的识别标签与实际物体不一致。例如语义地图中搜索到的是"玩具",但 OVD 在手臂相机图像中识别出的名称是"玩偶"。这是最常见的失败原因之一。
解决:尝试不同的检测标签组合:
bash
labels=["玩偶", "玩具", "毛绒玩具", "公仔"]也可以先不指定 labels,让 OVD 返回所有检测结果,观察实际返回的名称。
Q6:机械臂报 code=57346, 找不到可达自适应抓取点,物体放的太靠里面
原因:物体超出了机械臂的可达范围。八界机械臂最大臂展约 50cm,物体放得太远或太低都会导致够不着。
解决:将目标物体放在机器人正前方 30-50cm 范围内的地面上,避免放在角落或过远位置。
Q7:语义导航报 code=9984, 语义查询返回结果无效
原因:语义地图中没有标记指定的区域名称。例如代码中指定 --area-name 书桌,但地图中只标记了"桌子"。
解决:
- 在可视化平台的"语义地图"模块确认已标记的区域名称
- 确保代码中的区域名称与地图中完全一致(包括空格、数字等)
- 注意:如果使用 Qwen 系列模型,可能会在区域名称中插入空格(如"房间 0的桌子 1"),需要手动在可视化平台修改为不含空格的名称
Q8:语义导航报 code=131072, 区域导航点生成失败,请排查正向边是否对、地图是否干净
原因:语义地图质量不佳。可能是建图时环境中有移动物体干扰,或者地图中存在大量噪声点。
解决:在可视化平台重新构建语义地图,建图时确保环境中没有移动物体,保持地图整洁。
十一、测评总结
最让我印象深刻的三点:
- 语义导航的稳定性:只要地图正确,导航成功率接近 100%,几乎不需要反复调试。这在具身智能领域是非常难得的。
- 鞋履整理的精准度:跨视图匹配和 6D 放置令人惊艳------机器人能从散落的鞋子中配对出「一双」,抓取后整齐摆放且朝向一致。这背后是头部相机与手臂相机的精确协同,以及 get_shoe_move_steps() 中 front_edge 朝向计算的巧妙设计。
- SDK 的开发者友好度:API 命名清晰、全链路打通、4 个示例 Demo 代码分层合理、10 节入门课程、可视化平台一站式操作。我在半天内独立完成了按电梯 Demo 的开发,说明 SDK 的二次开发门槛确实很低。
需要改进的地方:
- 运行时长偏长:鞋履整理 2 只鞋子耗时约 5 分钟,跨视图匹配单次约 30s,VLM 感知单次 10-30s。全流程串行执行,无法并行优化。
- 服务端稳定性:PutWhere 服务偶发返回数据不完整,导致放置失败;VLM 服务不可用时直接导致 Demo 失败。
- 语义地图的单点依赖:所有 Demo 都强依赖语义地图质量,建图质量差则全盘失败。不同 Demo 对语义区域的要求不同,增加了配置复杂度。
- OVD 标签体系不透明:开发者需要反复试探可用标签,「玩具」展开为子类「玩偶」的行为没有明确文档说明。
总的来说,八界是一个诚意十足的开源具身智能平台。从 SDK 设计到可视化平台,从示例 Demo 到入门教程,每个环节都能感受到对开发者的用心。它不是完美的------运行时长、服务端稳定性、语义地图依赖都是当前具身智能行业共同面临的挑战。但作为科沃斯首款开源机器人,八界已经迈出了坚实的一步。如果你是具身智能方向的开发者、研究者或教育工作者,八界值得你投入------它会让你真切地感受到,AI 走进物理世界的第一步,已经开始了。