本文是「Spring Boot + AI 全栈后端」系列第 09 篇。前几篇我们解决了模型能不能对话、能不能省钱、能不能按格式输出、能不能查实时数据、能不能读私有文档、能不能自己串任务、能不能统一接入内部系统。这一篇回到用户体验本身:点发送之后那几秒的空窗,怎么变成一句一句往外蹦的打字机。示例基于 Spring AI 2.0 / Boot 4.1。
一个"等了六秒,用户关掉了页面"的场景
给客户做第一期 AI 助手上线后,产品经理甩过来一条用户反馈:用户问"帮我写一份下周的营销活动方案",页面上的按钮转圈转了六秒,用户以为卡死了,直接关掉。
六秒其实不算慢------模型要生成一份几百字的方案,本来就是这么久。问题不在速度,在感知:用户盯着一个转圈,没有任何反馈,六秒里他的耐心就耗完了。如果把生成过程换成一句一句往外蹦,用户第一秒就看到字在动,剩下五秒他是在"看内容",不是在"等结果"。
这个体验差别,背后是两种完全不同的接口形态:
| 维度 | 一次性返回(call) | 流式返回(stream) |
|---|---|---|
| 首字延迟 | 要等整段都生成完 | 模型吐出第一段就发出去 |
| 用户感知 | 转圈 → 突然一大段 | 打字机 → 跟着读 |
| 断线恢复 | 整段重来 | 已收到的部分还在 |
| 服务端内存 | 攒整段答案 | 边生成边发送,压力平摊 |
| 实现复杂度 | 一行 .content() |
多几行,还要处理取消和异常 |
一句话:流式不改变"生成要多快",它改变"用户感觉有多快"。对长文生成、代码补全、报告写作这类场景,流式几乎是标配。
一、ChatClient 切到流式,其实只差一个方法
第 02 篇里,拿一次完整答案是这样写的:
java
String answer = chatClient.prompt()
        .system("你是智能写作助手")
        .user(question)
        .call()          // 一次性:等整段
        .content();
切成流式,把 .call() 换成 .stream(),返回类型从 String 变成 Flux<String>:
java
Flux<String> answerStream = chatClient.prompt()
        .system("你是智能写作助手")
        .user(question)
        .stream()        // 流式:一段一段来
        .content();
Flux<String> 是 Reactor 的响应式类型,代表"未来会一个接一个到来的字符串序列"。Spring AI 把 stream() 之后的三个出口都给你了:content() 只要文本片段,chatResponse() 要带元数据的完整响应,chatClientResponse() 要包括工具调用在内的全过程。做打字机,content() 就够。
这层抽象的好处是:业务代码不关心底层模型是 OpenAI 还是别的什么 。只要是 Spring AI 支持的模型,stream() 的行为一致,你换模型不用改这行代码。
二、光吐字不够:流式接口有四个必须处理的边角
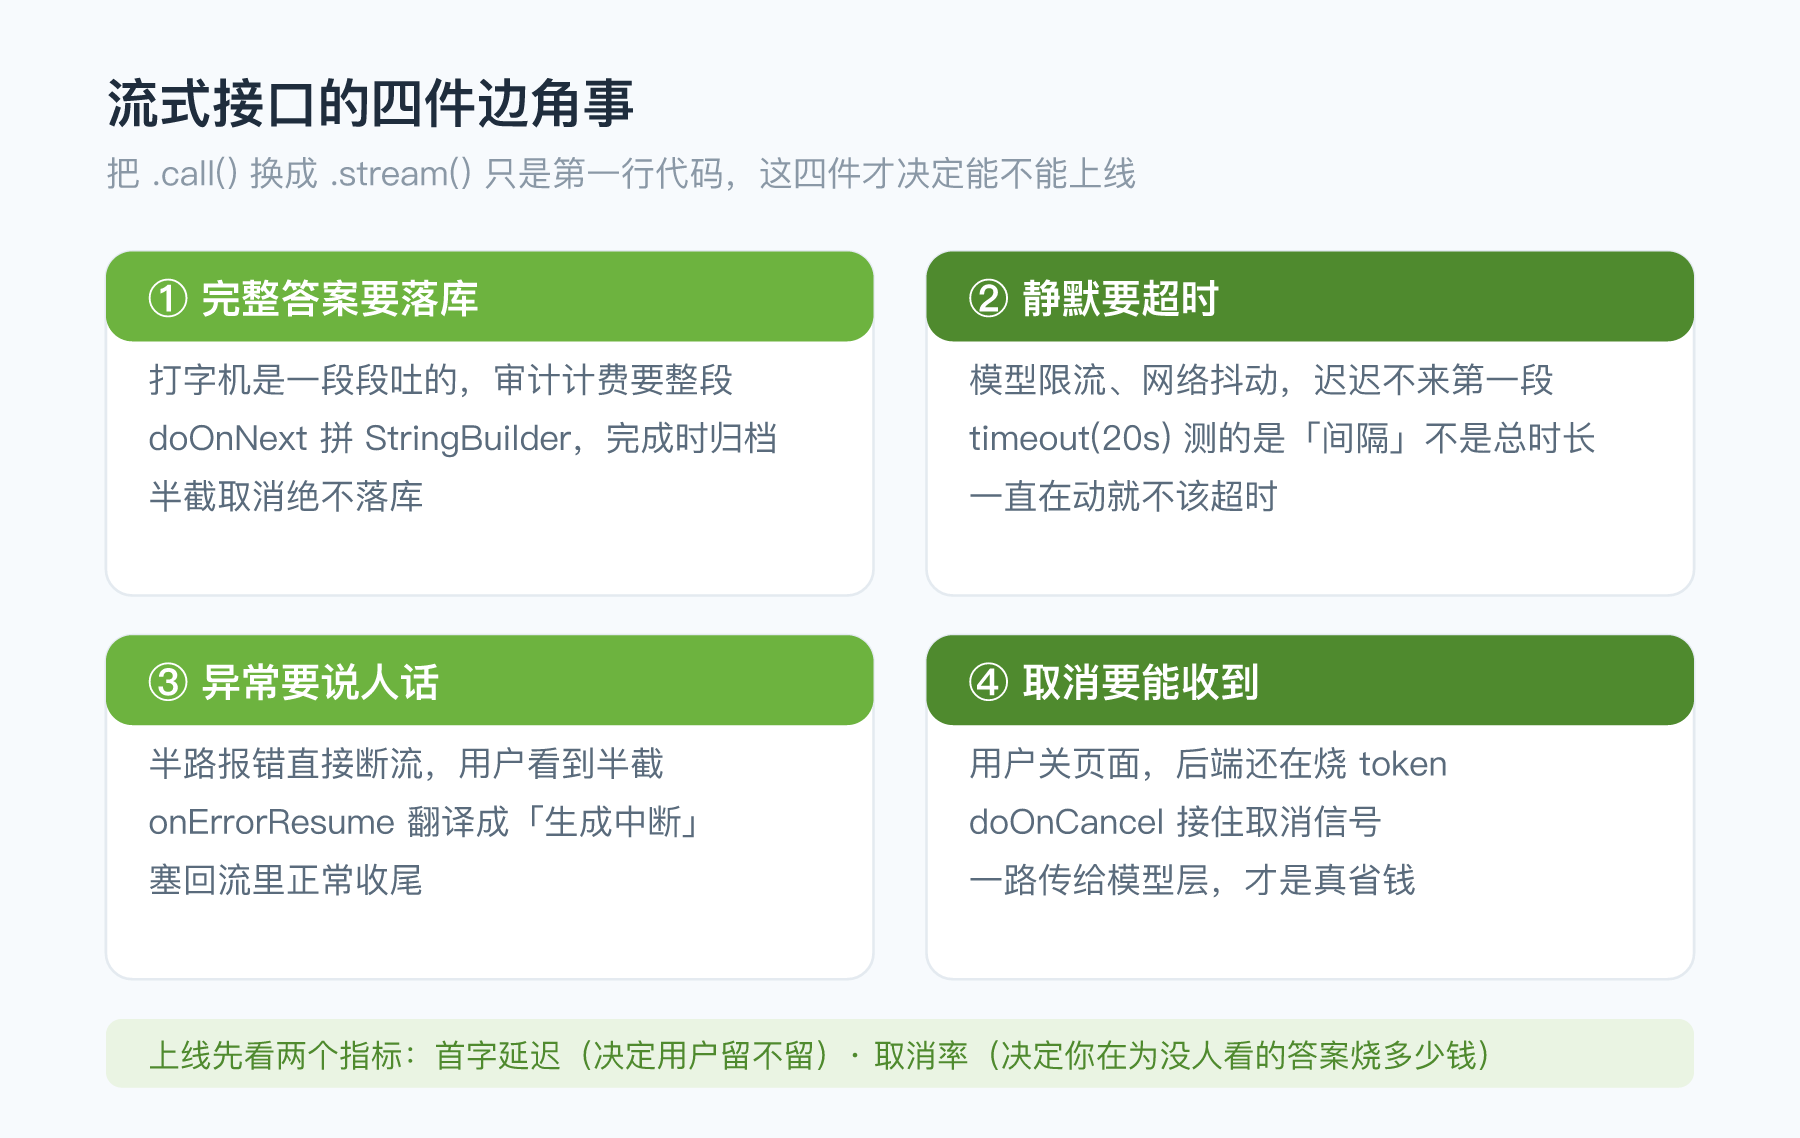
很多人以为流式就是"把 .call() 换成 .stream() 就完了"。V哥 告诉你,真上线你会撞上四件事,每一件都能让这个功能翻车:
第一件:完整答案从哪来。 打字机是一段一段吐给前端的,但审计、计费、质量抽检要的是整段。你不能指望前端把碎片拼好了再回传给你------那不可靠。正确做法是服务端在吐的同时自己把碎片拼一份,流结束的时候归档。
第二件:迟迟不来第一段怎么办。 模型那边限流了、网络抖了,Flux 可能一直没元素。前端转圈事小,连接占着不释放事大。要给它加一个静默超时。
第三件:半路断了怎么收场。 模型生成到一半报错,如果你不做处理,SSE 连接会直接断,用户看到一半字停在那里,比没字更难受。要把异常翻译成一句人话,塞进流里再正常收尾。
第四件:用户关页面了,后端知道吗。 这是最容易被忽略、也最费钱的一点。用户看到一半关掉页面,如果后端收不到取消信号,模型还在为一份没人看的答案继续吐 token,钱照花。Flux 的取消信号必须被接住。
把这四件事写进一个 Service,长这样:
java
@Service
public class StreamingChatService {

    private static final String SYSTEM_PROMPT = """
            你是智能写作助手,回答要口语化,一段话控制在三句以内,方便在打字机效果里阅读。
            """;

    private static final Duration SILENCE_TIMEOUT = Duration.ofSeconds(20);

    private final ChatClient chatClient;
    private final AnswerArchive archive;
    private final StreamMetrics metrics;

    public StreamingChatService(ChatModel chatModel, AnswerArchive archive, StreamMetrics metrics) {
        this.chatClient = ChatClient.builder(chatModel).build();
        this.archive = archive;
        this.metrics = metrics;
    }

    public Flux<String> streamAnswer(String question) {
        StringBuilder full = new StringBuilder();

        return chatClient.prompt()
                .system(SYSTEM_PROMPT)
                .user(question)
                .stream()
                .content()
                .doOnNext(chunk -> {
                    metrics.onChunk();
                    full.append(chunk);
                })
                .timeout(SILENCE_TIMEOUT)
                .doOnCancel(metrics::onCancel)
                .doOnComplete(() -> archive.save(question, full.toString()))
                .doOnError(e -> metrics.onError())
                .onErrorResume(ex -> Flux.just("[生成中断:" + friendlyMessage(ex) + "]"));
    }

    public String answerAll(String question) {
        return streamAnswer(question).reduce(String::concat).block();
    }

    private static String friendlyMessage(Throwable ex) {
        String name = ex.getClass().getSimpleName();
        return switch (name) {
            case "TimeoutException" -> "等待模型响应超时,请重试";
            case "ResourceAccessException" -> "连接模型服务失败";
            default -> "后端生成异常";
        };
    }
}
几个 Reactor 算子,逐个说清楚它们为什么必须在这里:
doOnNext:每来一段就拼进StringBuilder。这个变量是闭包捕获的,每个订阅者一份,流结束的时候就是完整答案;timeout(20s):两段之间的静默超过 20 秒,就往下游发TimeoutException。注意它测的是间隔,不是总时长------打字机本来就是慢慢吐的,只要一直在动就不该超时;doOnComplete:正常吐完,把完整答案归档。这是"完整答案从哪来"的答案;doOnCancel:前端断开时触发,这里只做了计数。真实项目里,这个信号应该再往上游传,让模型真正停下来------很多模型 SDK 的stream()都支持把取消传到网络层,那才是真省钱;onErrorResume:把任何异常都翻译成一句[生成中断:...],塞回流里正常收尾。前端拿到这句就知道"不是网络断了,是后端出了问题",展示体验完全不一样。
AnswerArchive 和 StreamMetrics 是配套的两个小类。归档用内存 Map 示意(生产换 MySQL),指标就是三个计数器:吐了多少段、取消几次、失败几次。这三个数是你判断流式接口健不健康的直接依据------取消率居高不下,说明要么太慢,要么用户根本不需要那么长的答案。
三、前端怎么接:两种姿势,各有用武之地
前端侧,最简单的是用浏览器原生的 EventSource:
javascript
const es = new EventSource('/api/stream/ask-get?question=' + encodeURIComponent(question));
es.onmessage = (e) => {
    textArea.value += e.data;   // 一段一段往上拼
};
es.onerror = () => es.close();
不过 EventSource 只支持 GET,参数只能放 URL 里,长问题不合适。生产里 V哥 更推荐用 fetch 读流,能带 POST body,也能精确控制取消:
javascript
const controller = new AbortController();
const resp = await fetch('/api/stream/ask', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ question }),
    signal: controller.signal,   // 用户点停止,就触发后端的 doOnCancel
});
const reader = resp.body.getReader();
const decoder = new TextDecoder();
while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    textArea.value += decoder.decode(value, { stream: true });
}
AbortController 这条线要重点画出来:前端"停止"按钮调 controller.abort(),请求断开,后端 Flux 收到取消,doOnCancel 被触发------这才是取消链路真正闭环的地方。少了这一步,你做的取消只是一个前端动画,后端该怎么烧钱还怎么烧。
四、后端怎么返回:Flux 直返 vs SseEmitter
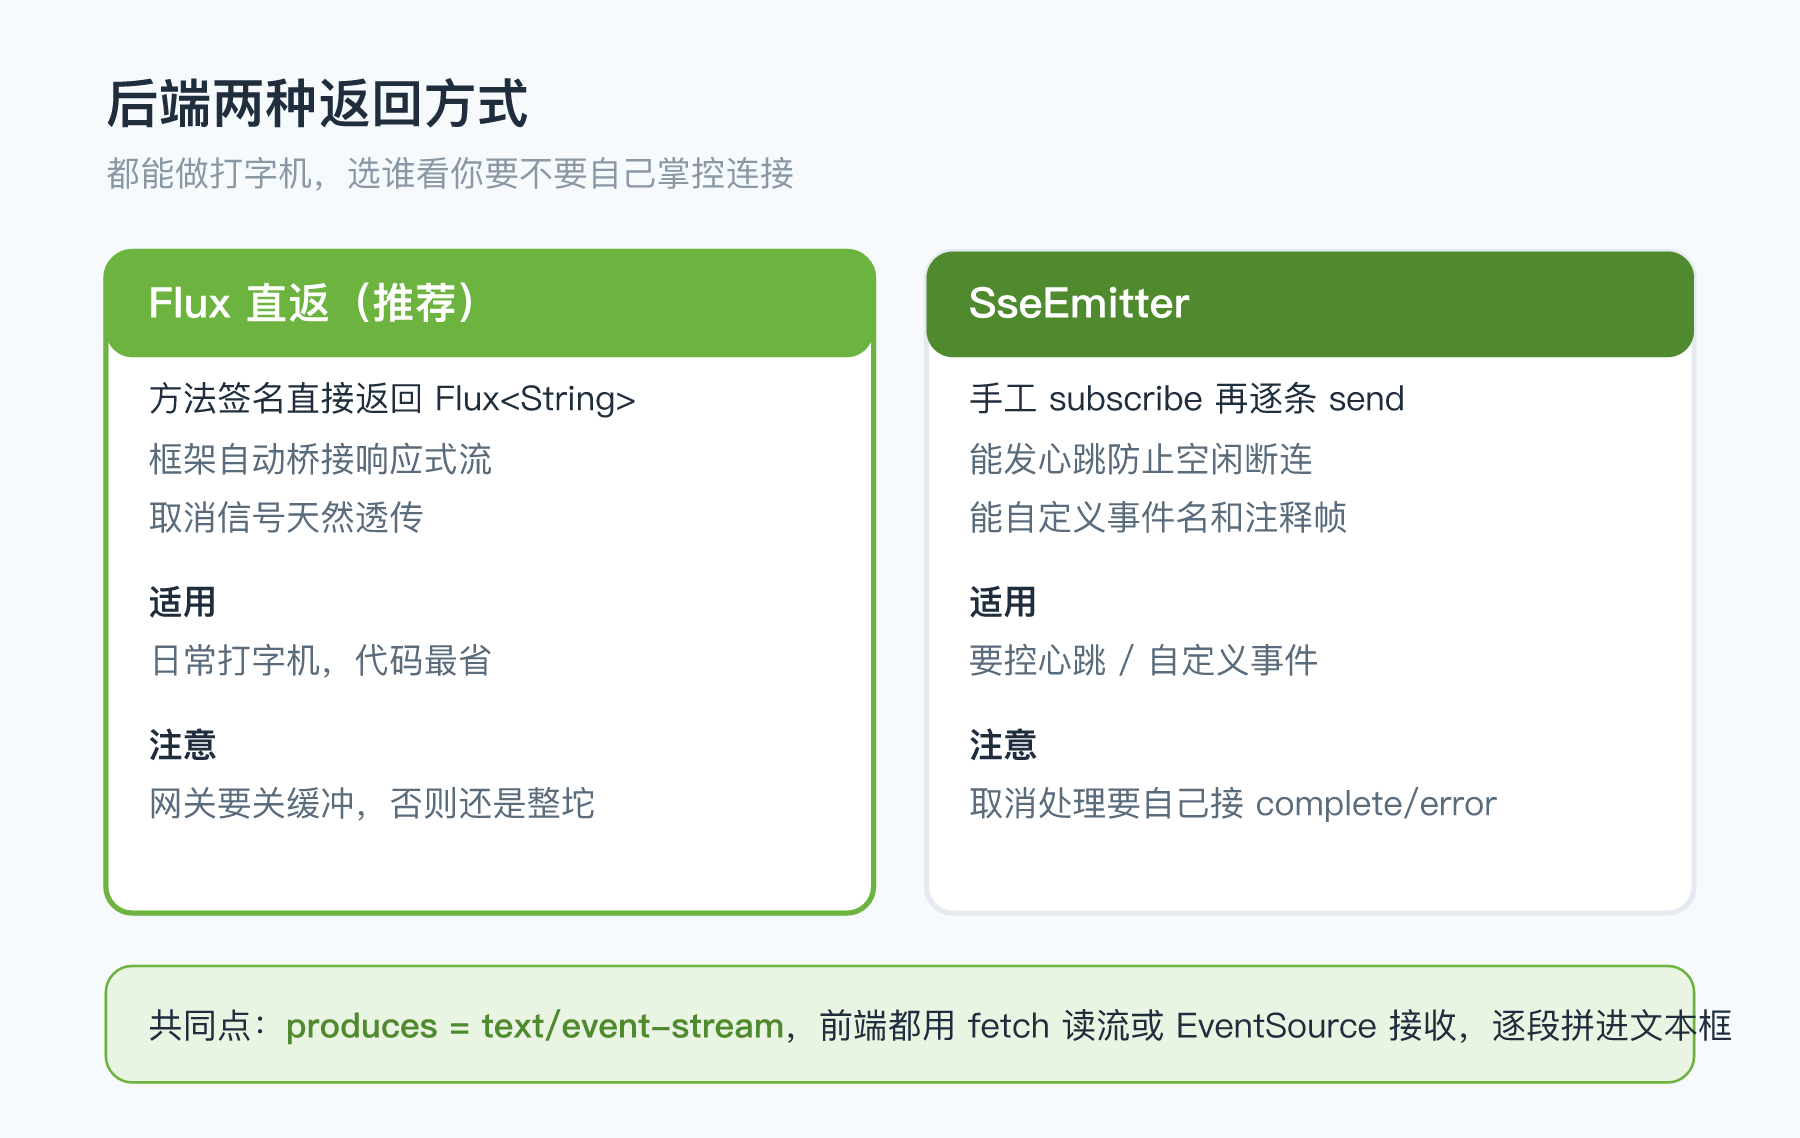
Controller 层,Spring Boot 给了两条路:
java
@RestController
@RequestMapping("/api/stream")
public class StreamAskController {

    private final StreamingChatService service;

    public StreamAskController(StreamingChatService service) {
        this.service = service;
    }

    // 路线一:直接把 Flux 返回出去,框架自动按 text/event-stream 处理(推荐)
    @PostMapping(value = "/ask", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
    public Flux<String> ask(@Valid @RequestBody StreamAskRequest request) {
        return service.streamAnswer(request.question());
    }

    // 路线二:SseEmitter,适合还要手工塞心跳、自定义事件名的场景
    @PostMapping("/ask-emitter")
    public SseEmitter askEmitter(@Valid @RequestBody StreamAskRequest request) {
        var emitter = new SseEmitter(30_000L);
        service.streamAnswer(request.question())
                .subscribe(chunk -> {
                    try {
                        emitter.send(chunk);
                    } catch (IOException ex) {
                        emitter.completeWithError(ex);
                    }
                }, emitter::completeWithError, emitter::complete);
        return emitter;
    }
}
两条路的取舍很清晰:
- Flux 直返:代码最省,框架帮你把响应式流桥接到 HTTP,取消信号天然透传。日常做打字机,V哥 默认用这条;
- SseEmitter :传统的 Servlet 异步模型,好处是你可以完全掌控发什么。比如每隔 15 秒手工
emitter.send(SseEmitter.event().comment(""))发个心跳,防止网关把空闲连接掐断;或者用event().name("meta")发自定义事件,把"预计还要 10 秒"这种提示单独推给前端。
入参还是老规矩,空问题直接 400:
java
public record StreamAskRequest(
        @NotBlank(message = "问题不能为空") String question) {
}
五、离线环境怎么验证这条链
流式接口的难点在"时间"和"信号",这两样用桩都能模拟。桩只要覆写 stream(Prompt),把一段固定答案切成几片往外吐:
java
public class StreamingStubChatModel extends StubChatModel {

    private final List<String> chunks;

    public StreamingStubChatModel(List<String> chunks) {
        super(String.join("", chunks));
        this.chunks = chunks;
    }

    @Override
    public Flux<ChatResponse> stream(Prompt prompt) {
        return Flux.fromIterable(chunks)
                .map(text -> ChatResponse.builder()
                        .generations(List.of(new Generation(new AssistantMessage(text))))
                        .build());
    }
}再配一个故障桩,stream() 直接 Flux.error(...),用来验证异常翻译:
java
public class FailingStreamStubChatModel extends StubChatModel {
    private final RuntimeException failure;

    public FailingStreamStubChatModel(RuntimeException failure) {
        super("不可用");
        this.failure = failure;
    }

    @Override
    public Flux<ChatResponse> stream(Prompt prompt) {
        return Flux.error(failure);
    }
}有了这两个桩,就能离线断言下面这些关键点:片段按顺序到达、拼起来是完整答案、正常结束后归档完整答案、取消时归档保持旧值 (半截答案不该落库)、异常变成 [生成中断:...] 而不是断流、answerAll() 返回整段、HTTP 端点返回 text/event-stream 且内容里带生成的文本、空问题返回 400。这些覆盖的是"流式接口的工程正确性",跟模型聪明不聪明无关,而前者才是上线前必须锁死的部分。
尤其"取消时归档保持旧值"这一条,V哥 每次都会单独写一个测试:流式答案必须在完整到达后才落库,中途取消绝不能把半截答案存进去,否则下一次质检、审计拿到的就是一份残废数据。
六、几个上线必踩的坑
| 现象 | 原因 | 处理 |
|---|---|---|
| 前端收到的是一整坨,不是打字机 | 中间有代理/网关(Nginx)开了缓冲 | 关掉 proxy_buffering,或给响应头加 X-Accel-Buffering: no |
| 用户关页面后 token 还在烧 | 取消信号没传到模型层 | 从 doOnCancel 一路把取消传进 SDK 的流,并加取消计数监控 |
| 半路断了用户看到半截 | 异常没翻译就直接断流 | onErrorResume 塞一句人话,正常收尾 |
| 首字等了 8 秒 | 模型冷启动 / 首 token 慢 | 监控首字延迟,必要时上缓存或更快的档位(呼应第 03 篇路由) |
| 完整答案归档重复 | 业务层又 collect 了一遍 | 归档只做一次,统一在 Service 里 doOnComplete 完成 |
关于第一条,单独多说一句:流式上线后第一件事不是看正确率,是看"首字延迟"和"取消率"两个指标。首字延迟决定了用户会不会关页面,取消率决定了你在为一个没人看的答案烧多少钱。这两条曲线稳了,再谈生成质量。
最后一句 :流式输出的本质不是让模型吐得更快,而是让用户每一秒都拿到反馈 ------把 .call() 换成 .stream() 只是第一行代码,真正值钱的是那四件边角事:完整答案要落库、静默要超时、异常要说人话、取消要能收到;把这四件做扎实,打字机才不是一个花架子。下一篇(10)带你把"看字"升级成"看图":让模型同时读图片和文字,做商品图审核和发票识别。