Paimon 系列把订单链路铺到了"数据怎么存"这一步------Kafka 订单流经 Flink 流写进 Paimon,湖内再由 Flink 流算(Join 维表、窗口聚合)和 Spark 批算(T+1 报表)加工成 ADS 结果。链路最后还差一个出口:ADS 层的结果怎么查得快 ------BI 报表要求亚秒响应,分析师写一句 SQL 不能等 Spark 启动半分钟------这就是 OLAP 引擎的位置。
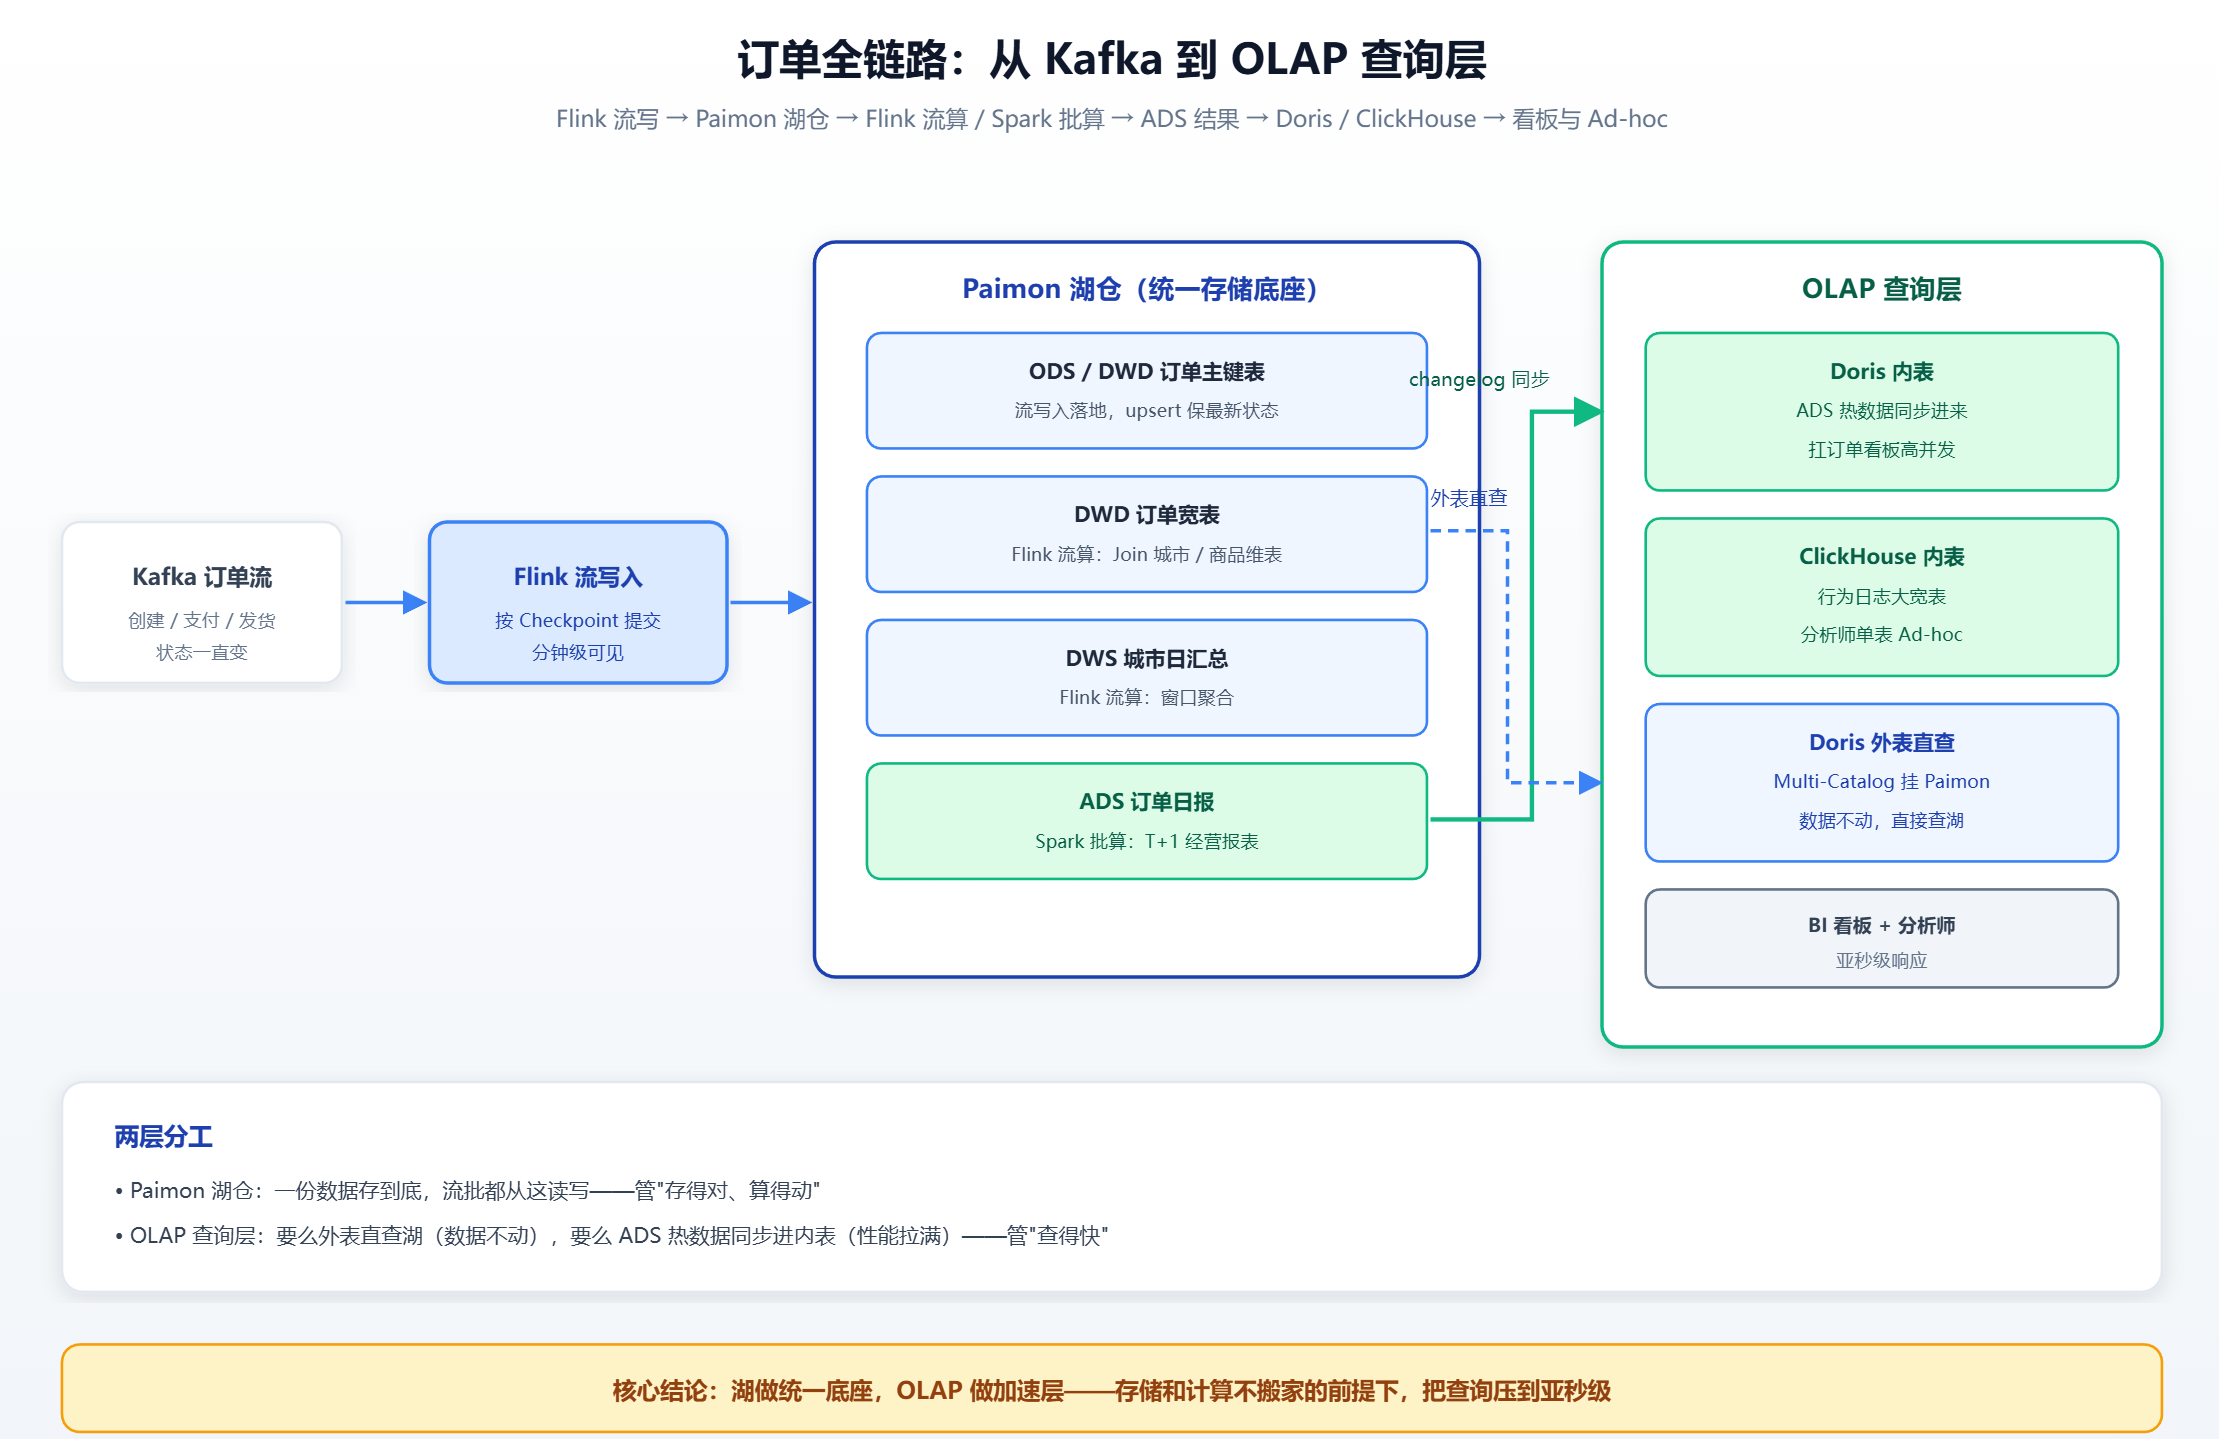
这层是 OLAP 引擎的地盘。这篇以 Doris 为主线------百度 Palo 出身、Apache 顶级项目,目前国内数仓报表场景的主流默认;ClickHouse (Yandex,2016 开源)作为对照组出场------单表分析的老牌选手,把它放在对照位上,Doris 的取舍会看得更清楚。核心回答一个问题:链路最后的查询出口,什么场景选谁。
一 为什么需要 OLAP 引擎:数据湖不够吗
Paimon、Iceberg 这些湖格式为"扫描吞吐"和"流批一体"优化------Parquet 列存大文件顺序读,跑批效率很高。但回到订单链路看,两类分析场景它们不擅长:
- Ad-hoc 交互式查询 :分析师对着 DWD 订单宽表写一句
SELECT city, SUM(amount) FROM dwd_orders GROUP BY city,期望秒级出结果。走湖上引擎(Spark SQL)光任务启动调度就是几秒到几十秒 - 高并发报表:ADS 订单日报挂上 BI 看板,几十上百人同时刷新,湖格式及其执行引擎没有为"高并发点查 + 聚合"做过优化
这里把第一个名词解释一下。Ad-hoc(即席)查询和"预定义查询"相对:
- 预定义查询:SQL 是固定的------每天 8 点跑的日报、看板上的固定图表。查询模式已知,可以提前优化:预聚合、物化视图、索引全按已知 SQL 配好
- Ad-hoc 查询:分析师临时想到什么查什么------今天查城市分布,明天拆时段转化,列组合、过滤条件、聚合方式都不固定。没法预计算,引擎必须现场扫原始数据现场算
"交互式"说的是使用姿势:写一句 → 等结果 → 基于结果写下一句,像对话一样迭代着逼近结论。延迟超过几秒思路就断了,所以"秒级返回"是硬指标,不是锦上添花。
两个词合起来才是完整约束:查询模式不可预知 + 人对延迟敏感。这正是湖上批处理引擎最不适配的组合------不可预知就没法提前准备,延迟敏感又要求每次都现场算还得快。后文会反复看到这个词:ClickHouse 的稀疏索引、Doris 的 Rollup,取舍都和"要扛住 Ad-hoc"直接相关。
OLAP 引擎补的就是这层:数据加载进引擎自己的存储(或以外表直查湖仓),用专门的执行器把分析查询压到亚秒级。
二 共同基因:为什么两个都快
Doris 和 ClickHouse 的技术路线不同,但快的来源是同一套三件套:
- 列式存储 :分析查询只碰少数几列。订单宽表 50 列,
SUM(amount)只读 amount 一列------列存按列连续存放,IO 只碰需要的列,同列数据类型一致压缩率还高 - MPP(大规模并行处理):查询拆成子任务分发到多节点多核并行算,中间结果逐级汇总。8 个分片就是 8 倍扫描能力
- 向量化执行:不按"一行一行"处理,按"一列一批"处理(一批几千行进 CPU),缓存友好、能用 SIMD 指令一次算多个值
三层叠加,才有亚秒级分析。
需要先澄清一个概念边界,否则会和已知事实产生矛盾:Paimon 也是列存。Paimon 的 LSM 树落盘文件就是 Parquet/ORC 列存,所以单就"列式存储"这一层而言,湖格式和 OLAP 引擎是对等的。LSM 和列存本是正交的两个层面:LSM 负责"写入如何攒批、多版本文件如何组织合并",列存负责"单个文件内部按行还是按列排布"。Paimon 是"LSM 组织 + 列存文件";Doris 的 compaction 和 ClickHouse 的 MergeTree(part 后台合并)同样是类 LSM 结构 + 列存文件------在这一点上三者并无本质差异。
既然如此,湖上跑 Ad-hoc 为什么仍然慢?差距不在文件格式,在三件套的后两件及其运行方式:
- 执行模型:Spark 扫 Paimon 是"来一个查询起一个作业",调度、申请资源先烧掉几秒。OLAP 引擎常驻进程 + 数据在自己盘上,SQL 进来直接进执行器
- 裁剪粒度:湖格式的裁剪靠文件级统计(Paimon manifest 的 minKey/maxKey、Parquet footer 的 min/max),粒度是"跳过整个文件 / 整个 row group";OLAP 引擎在此之上叠了主键索引定位、页级 zone map、BloomFilter,裁剪能压到文件内部
归纳来看:列存决定"读得省",MPP + 向量化 + 常驻执行器 + 索引决定"算得快、响应快" ------湖格式只具备前者,OLAP 引擎则覆盖了全部。区别不在"快不快",而在于各自把优化重心放在了哪里------这也是 Doris 与 ClickHouse 的分岔点。
三 Doris 核心机制:把数仓报表做到开箱即用
Doris 的出身是百度广告报表系统的 Palo 项目(2017 开源、2018 捐给 Apache、2022 年毕业为顶级项目),场景是实时报表 + 多维分析 + 高并发看板 。官方定位中两个能力标签值得注意:既能扛高并发点查(报表看板),也能扛高吞吐复杂分析(Ad-hoc)------"两头都要"是它和老牌单表引擎的取向差异。
1 架构设计:FE + BE,两种部署模式
Doris 采用 MySQL 协议接入 ,BI 工具(FineBI、Tableau、Superset)和各类客户端当 MySQL 直接连接 ,零适配成本。部署上按硬件环境与业务需求可选存算一体 或存算分离两种架构。
存算一体架构 (经典部署):
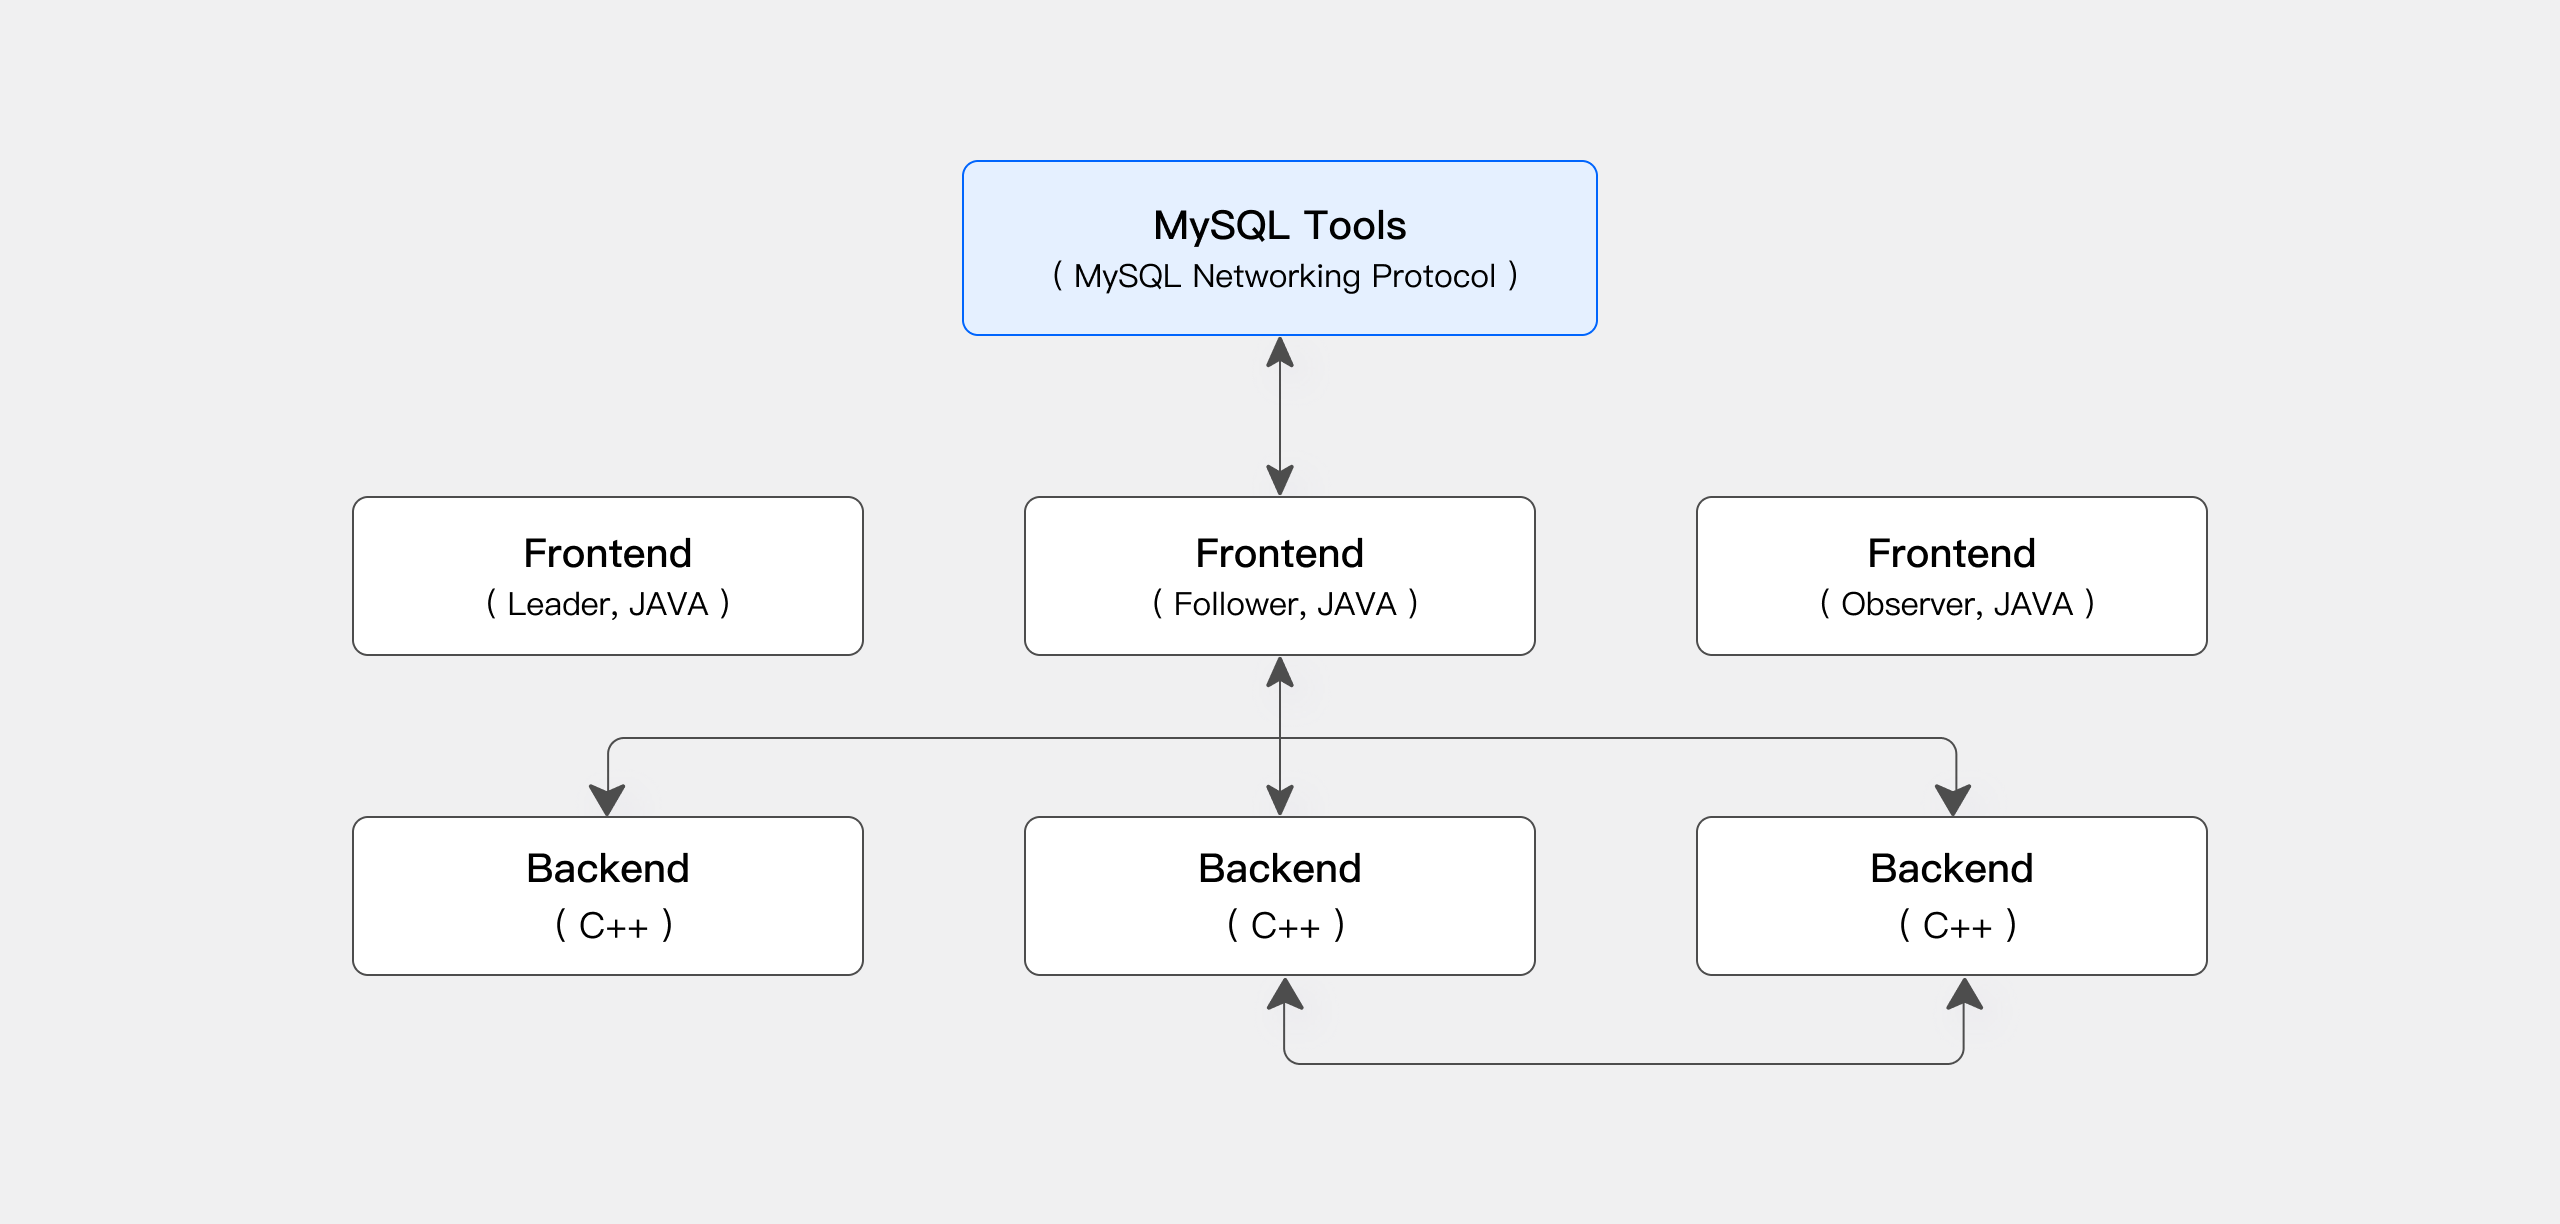
查询过程如下:
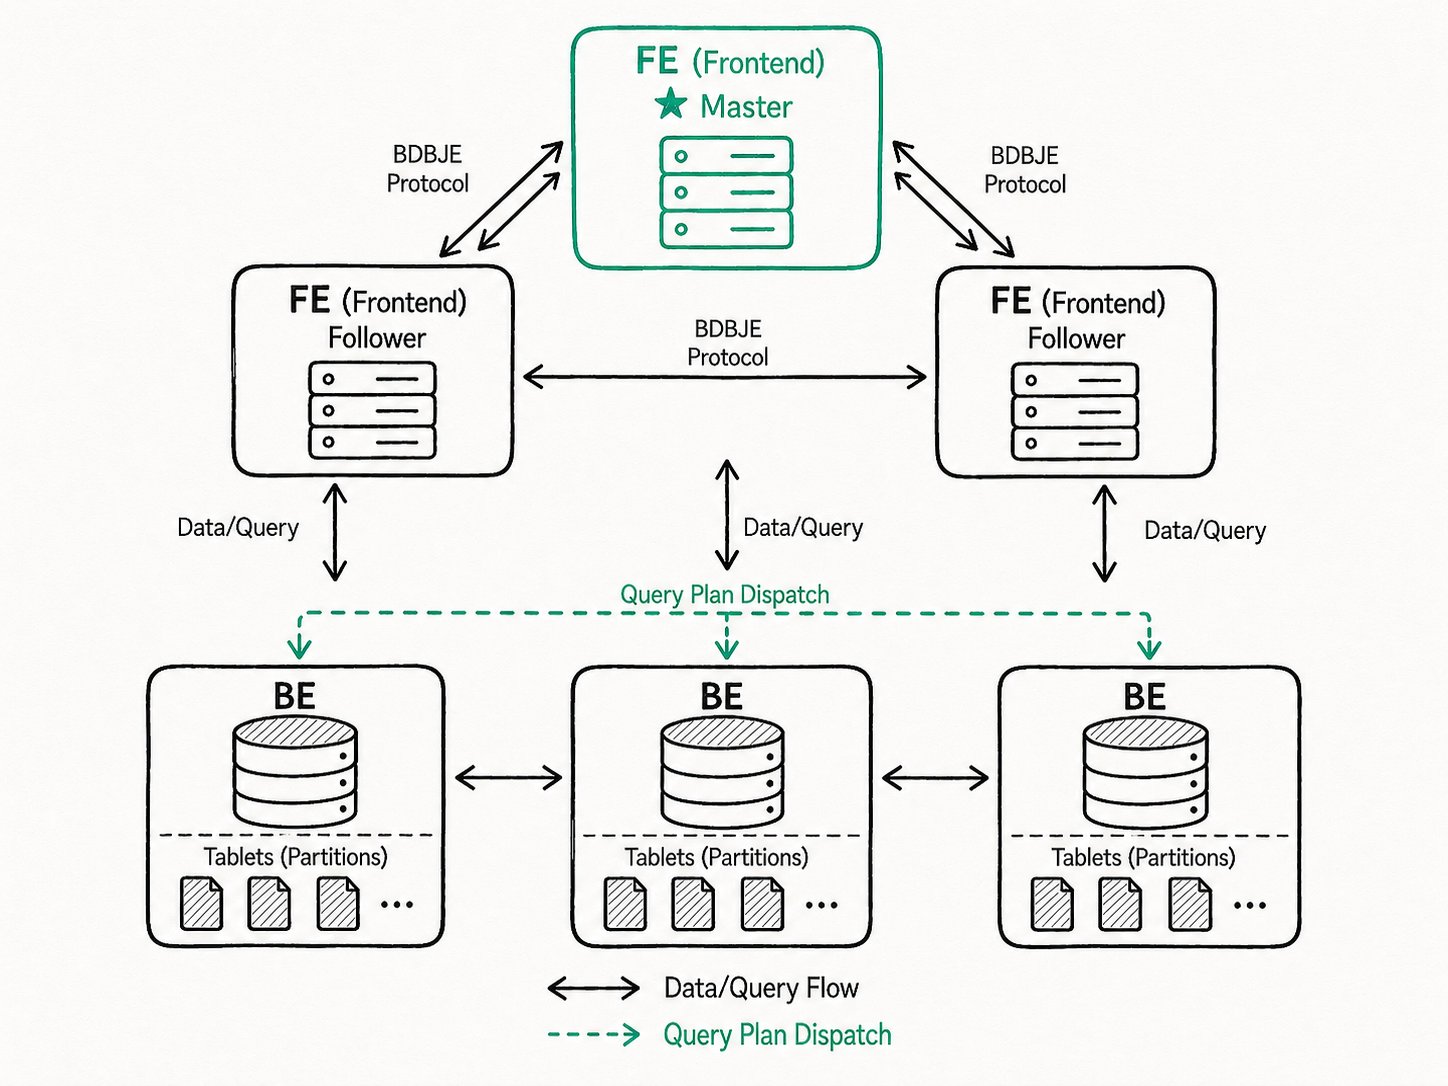
仅两类进程,精简易维护:
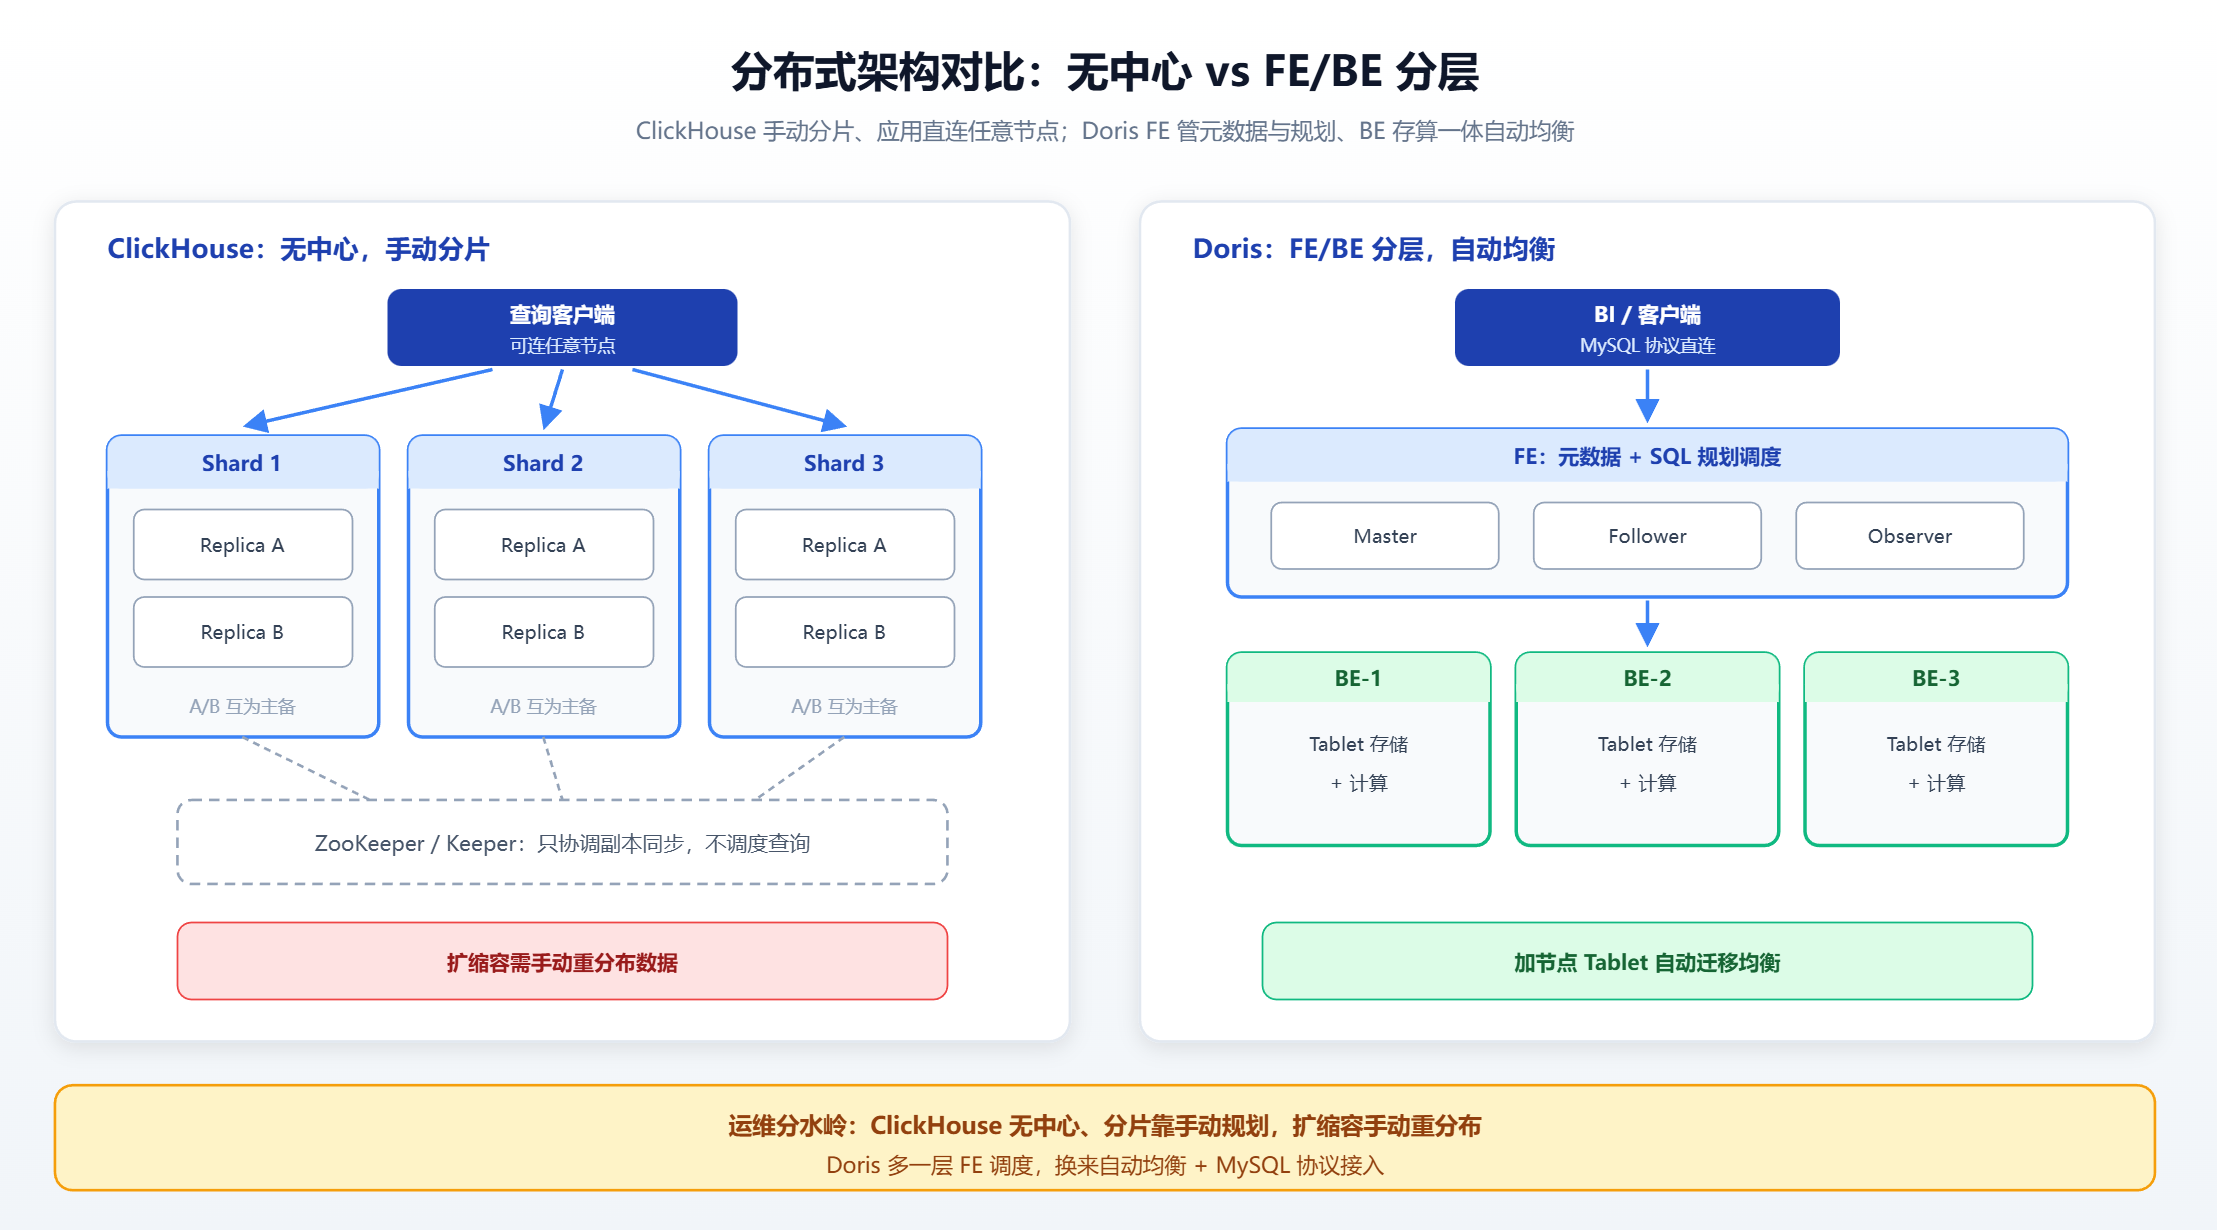
- FE(Frontend) :接收用户请求、查询解析和规划、元数据管理、节点管理。生产环境部署多个 FE 节点做容灾,每个 FE 维护完整元数据副本,分三种角色:
- Master:负责元数据读写,变更通过 BDB JE 协议同步
- Follower:读元数据,Master 故障时选主
- Observer:只读,扩查询并发,不参与选主
- BE(Backend) :存储 + 计算一体,数据切分为分片(Tablet)多副本分布。扩缩容自动均衡------加节点,Tablet 自动迁移
FE 和 BE 均可横向扩展,单集群支持数百台机器、数十 PB 存储;通过一致性协议保证高可用和数据可靠。
存算分离架构 (3.0 起可选):
Apache Doris 存算分离版使用统一的共享存储层作为数据存储空间。存储和计算分离后,用户可以独立扩展存储容量和计算资源,从而实现最佳性能和成本效益。存算分离架构分为以下三层:
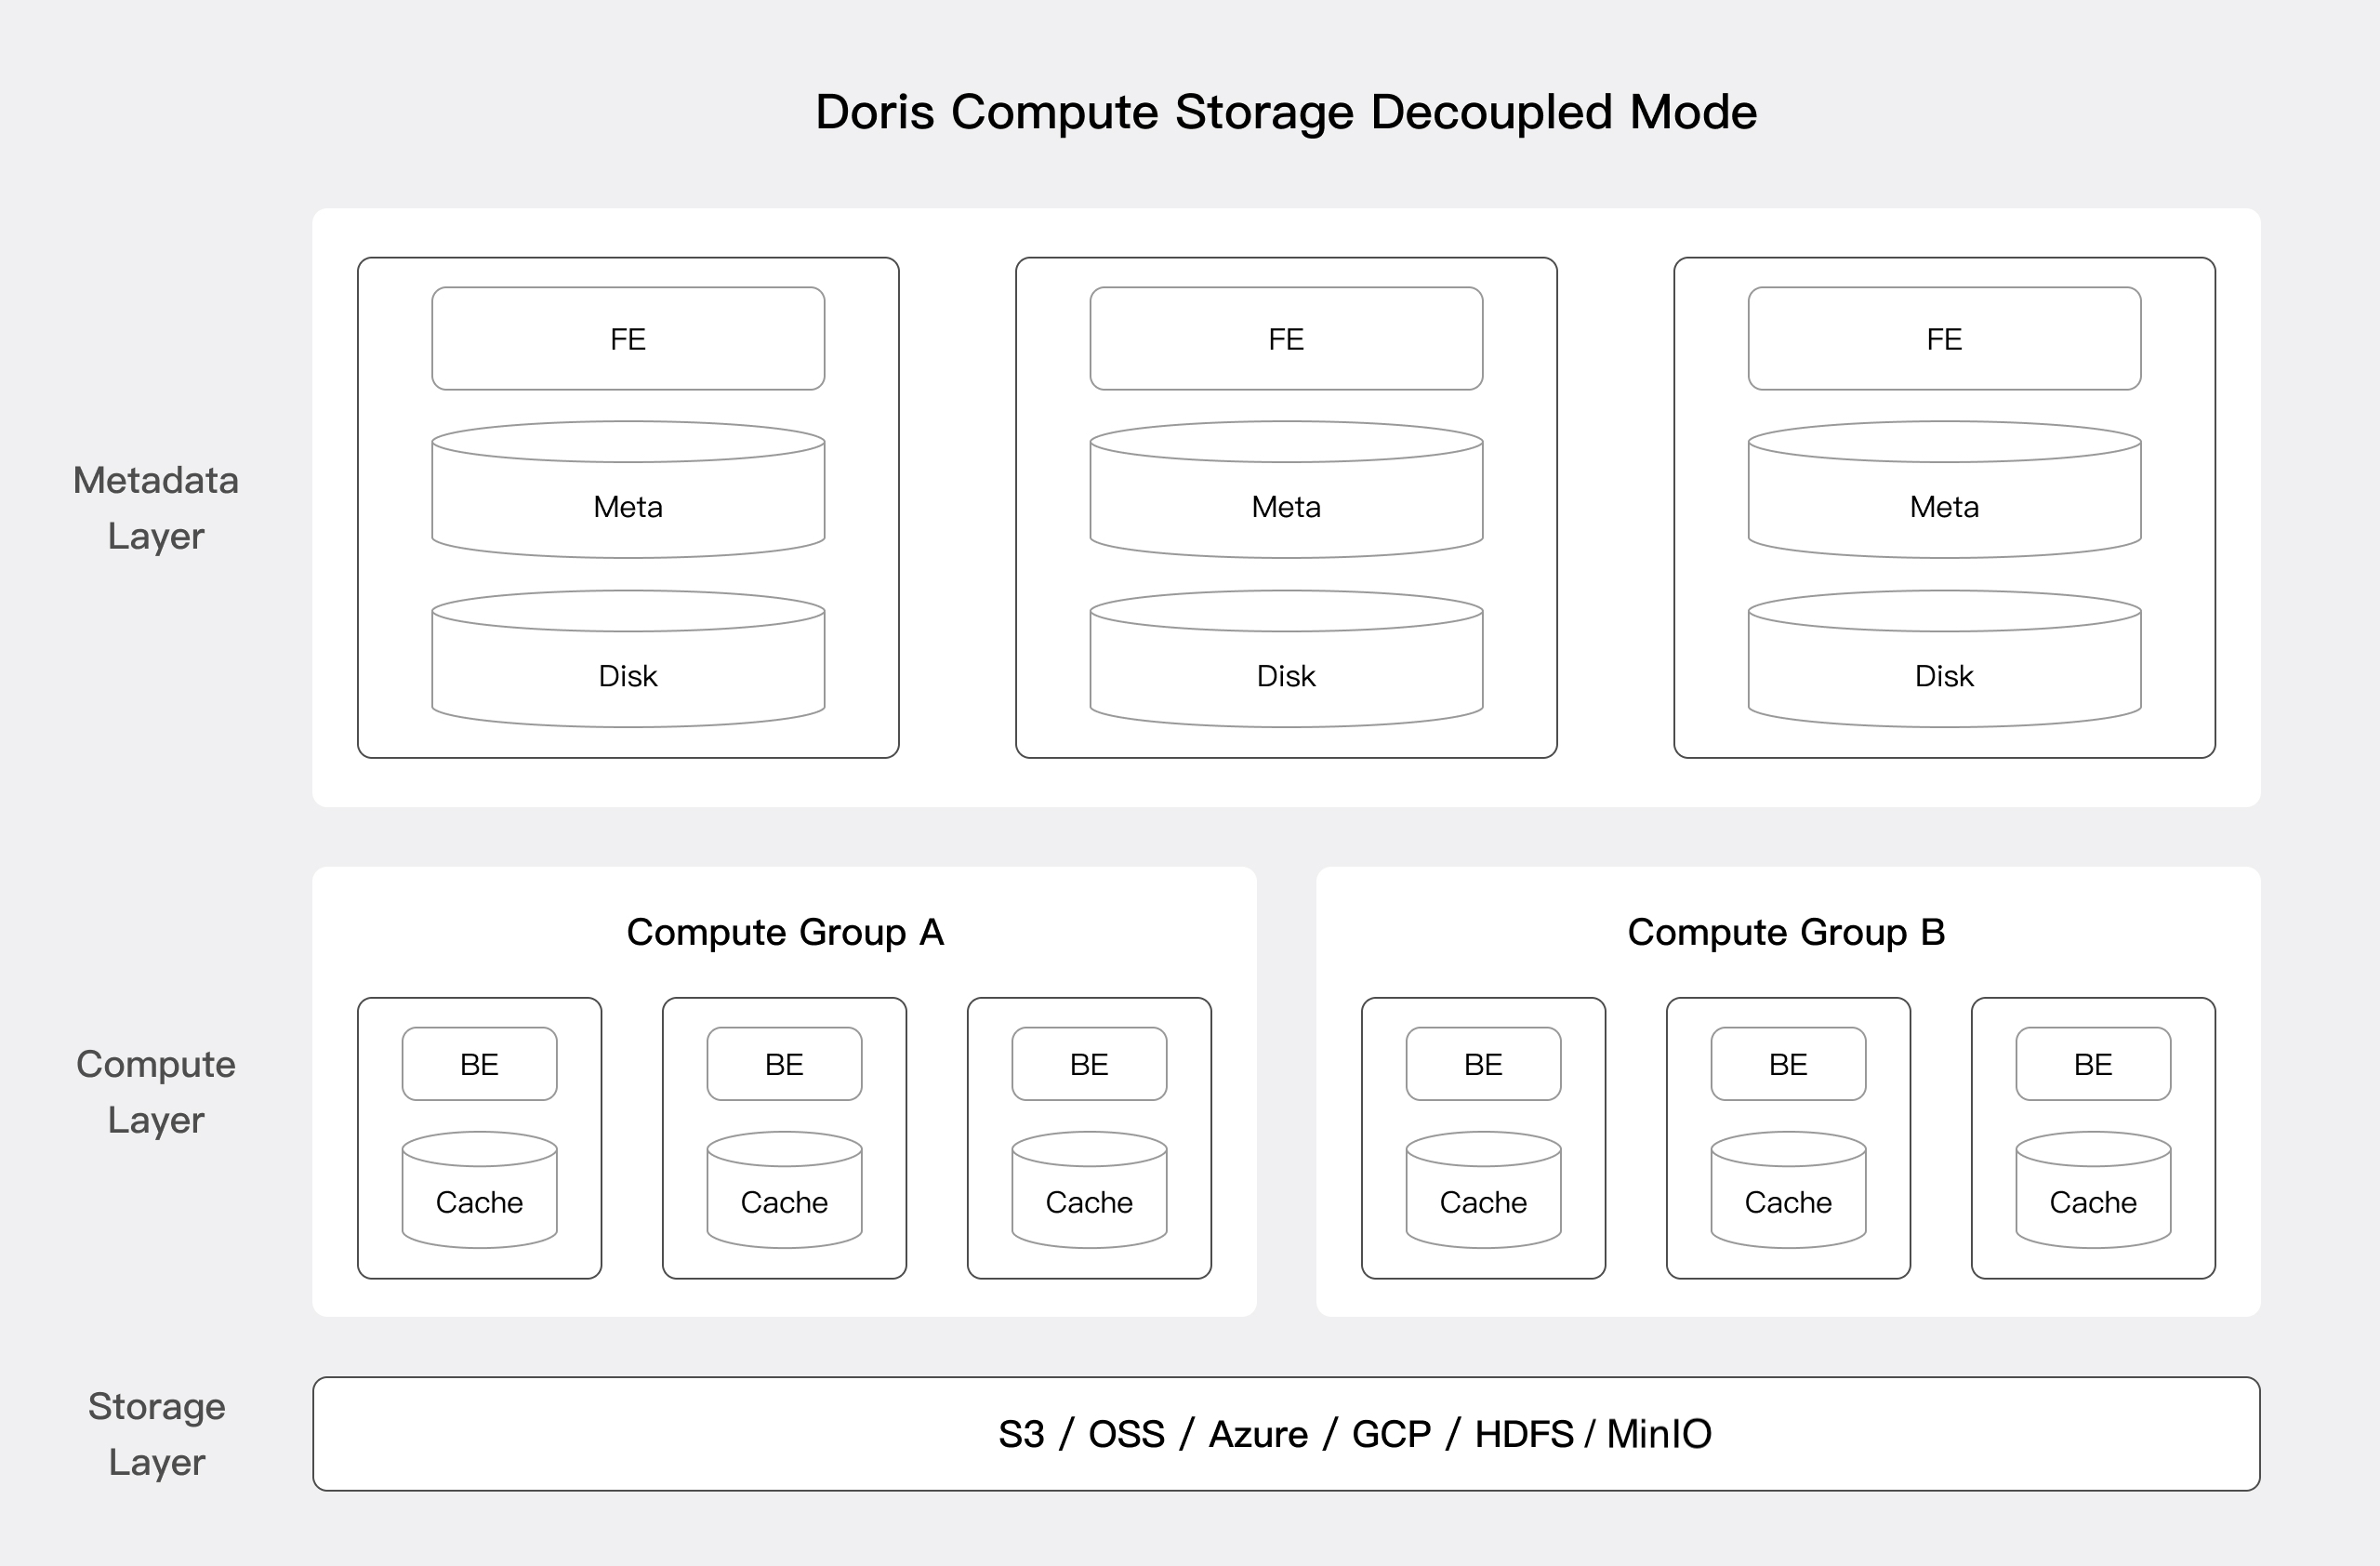
查询过程如下
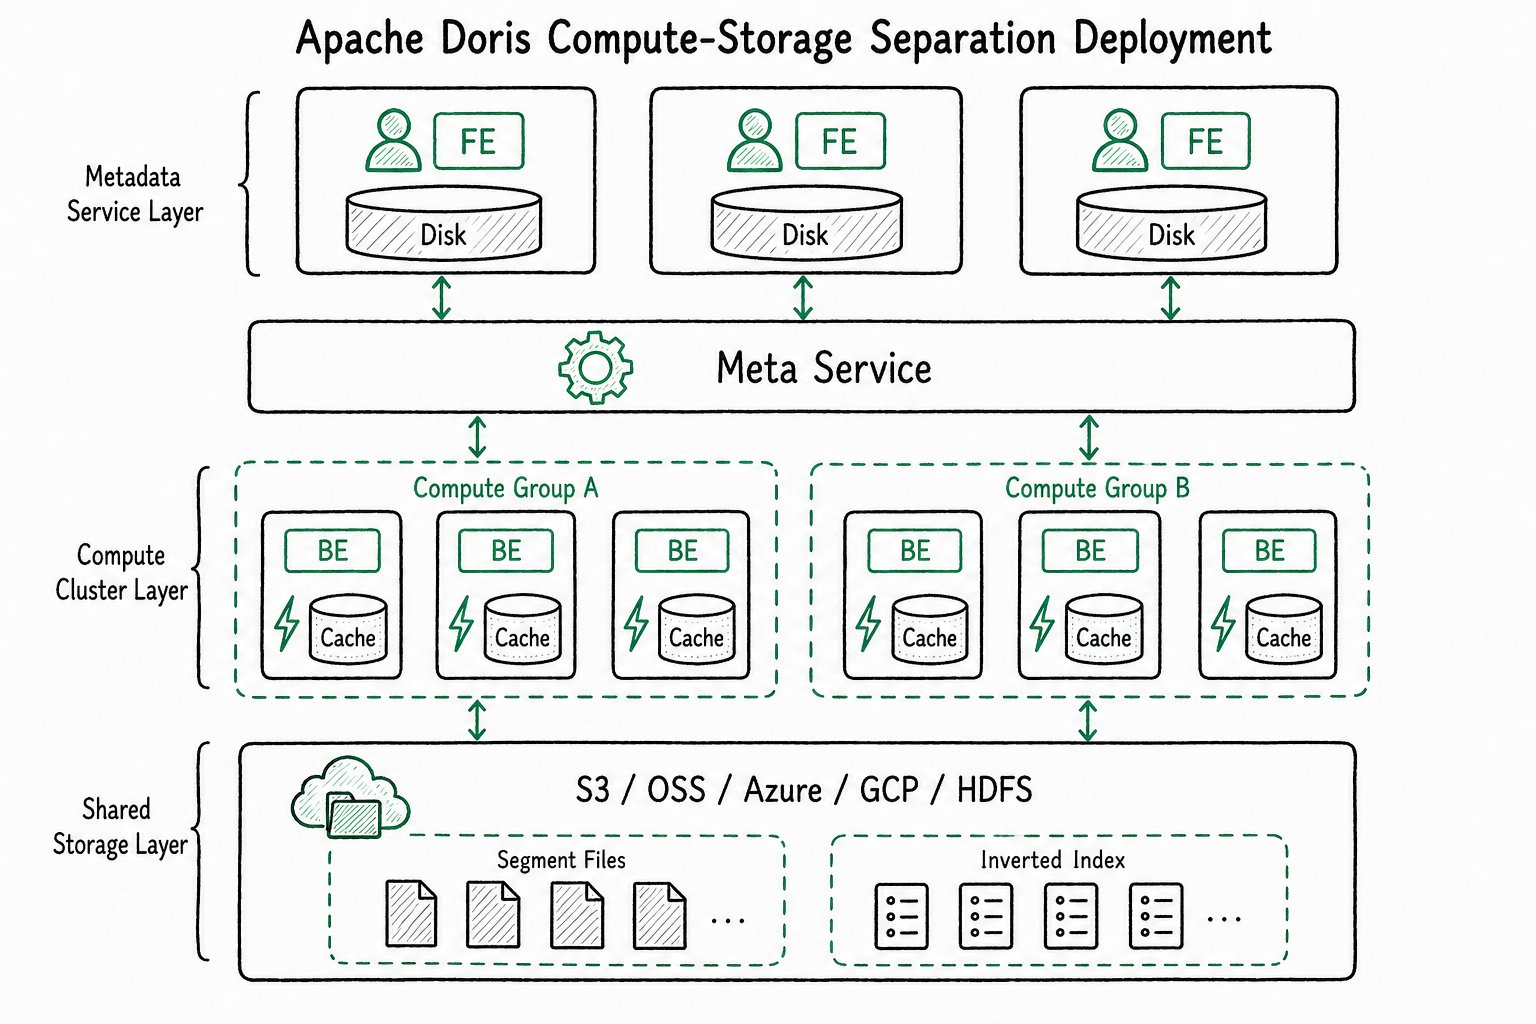
数据放 S3/HDFS/OSS/COS/OBS/Minio/Ceph 等共享存储,BE 变无状态计算组,存储和计算独立扩缩。三层分工:
- 元数据层: 负责请求规划、查询解析以及元数据的存储和管理。
- 计算层: 由多个计算组组成。每个计算组可以作为一个独立的租户承担业务计算。每个计算组包含多个无状态的 BE 节点,可以随时弹性伸缩 BE 节点。
- 存储层: 可以使用 S3、HDFS、OSS、COS、OBS、Minio、Ceph 等共享存储来存放 Doris 的数据文件,包括 Segment 文件和反向索引文件等。
存算一体是经典部署方式,存算分离则面向"湖仓统一底座"的新架构------数据在湖里一份不动,计算资源按需拉起。
2 三种数据模型:建表时决定数据的合并语义
- Duplicate Key(明细模型):数据原样存,只按排序键组织------对应订单链路的 DWD 订单宽表、埋点日志
- Aggregate Key(聚合模型):同 key 的数据写入时按聚合函数(SUM/MIN/MAX/REPLACE)合并------对应 DWS 城市日汇总这类预聚合报表
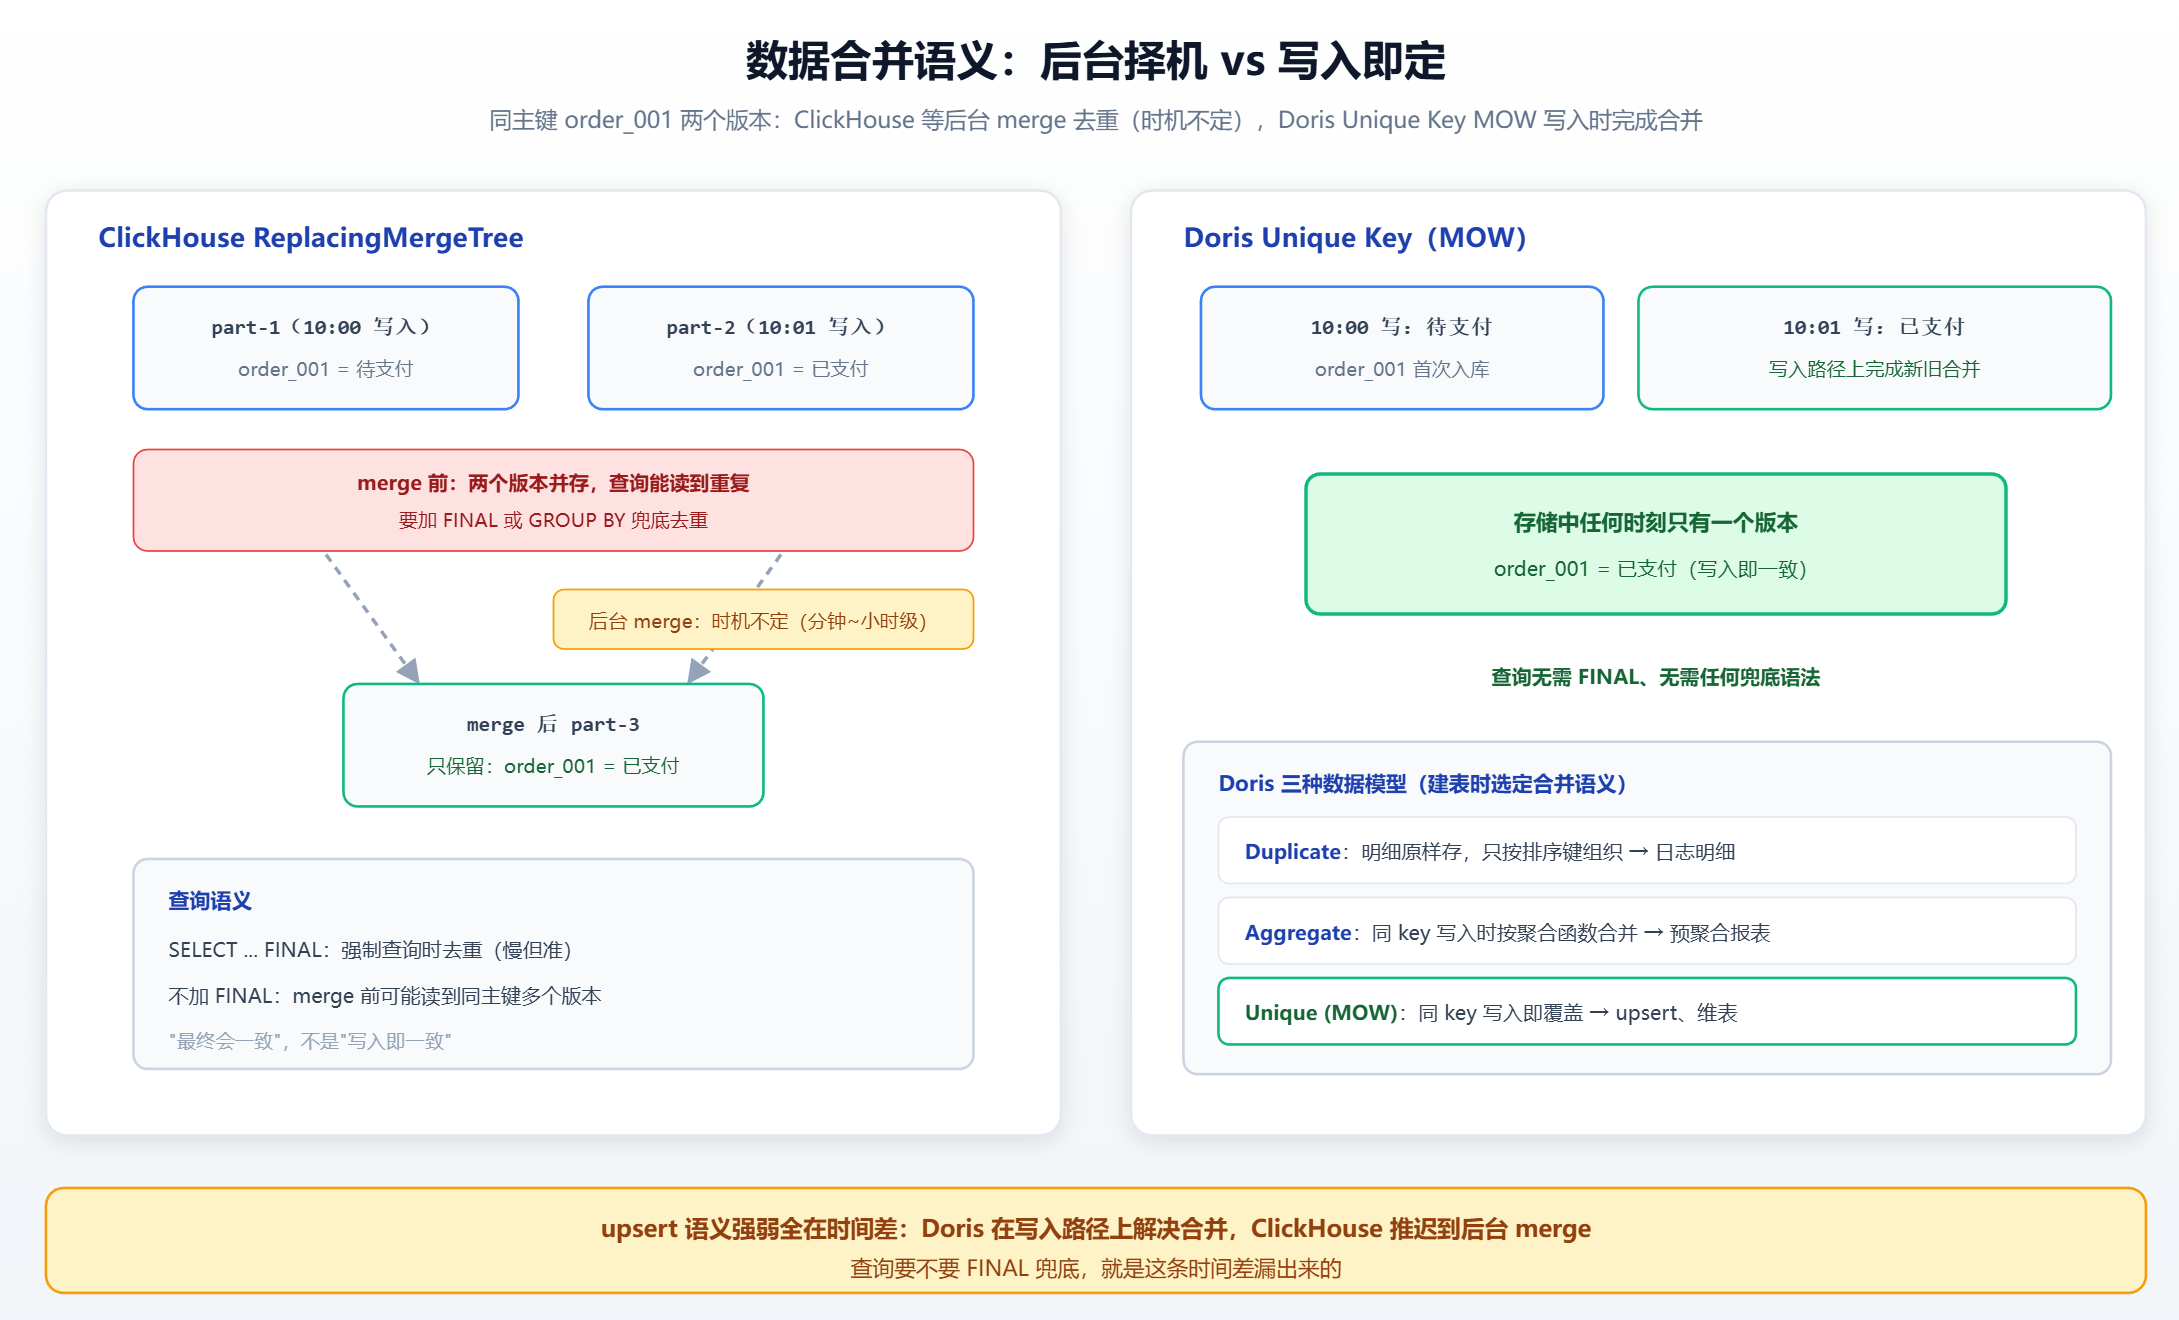
- Unique Key(主键模型) :同 key 覆盖更新,行级数据更新。MOW(Merge-on-Write)模式写入时就完成新旧版本合并,读时直接取唯一版本------upsert 是原生强语义,"写入即一致"。对应 ADS 订单日报这种"结果会随上游变更反复刷新"的表
对照组的 ReplacingMergeTree(下一章详述):同样是"同主键保留最新",Doris 在写入路径上解决,ClickHouse 推迟到后台 merge------这就是两者 upsert 语义强弱的根源。
3 Rollup、物化视图与索引体系
- Rollup / 物化视图:单表物化视图(Rollup)按不同维度组合预聚合存多份,写入自动同步、查询自动路由到最省的一份------报表常用维度提前算好;另有多表物化视图(定时刷新),降低建模复杂度
- 索引体系 (按用途选):
- Sorted Compound Key(排序复合键索引):最多 3 列复合排序,数据裁剪主力,高并发报表靠它
- Min/Max 索引:数值列等值/范围过滤
- BloomFilter 索引:高基数列等值裁剪
- Inverted Index(倒排索引):任意字段快速检索------日志检索场景的核心能力
- 思路与 ClickHouse 的稀疏索引同源:都为"扫一片"优化而非点查,但 Doris 补充的索引类型更多,点查和文本检索能力更全
4 查询引擎的三个关键词
官方文档中三个执行层名词,了解其作用即可:
- Pipeline 执行引擎:查询拆成子任务流水线并行,限制线程数防膨胀,吃满多核
- Runtime Filter:Join 时在运行时生成过滤器(In/Min-Max/BloomFilter)推到 Probe 端 Scan 节点,先过滤再关联------大表 Join 提速的关键手段
- 自适应优化(RBO + CBO + HBO):规则优化(谓词下推、子查询重写)+ 代价优化(Join Reorder)+ 基于历史查询推荐计划
5 强项与弱项
- 强项 :
- Join 完整:Shuffle Join / Broadcast Join / Colocate Join 齐备,星型模型(事实表 + 多维度表)原生支持,不用预拼宽表
- 高并发:面向报表场景优化,千级 QPS 扛得住
- upsert 原生:Unique Key MOW 写入即一致
- 湖仓一体:Multi-Catalog 直接查 Hive/Iceberg/Paimon/Hudi 外表,联邦查询消除数据孤岛
- 弱项:单表极致扫描性能略逊 ClickHouse(差距在持续缩小,且只在超大单表 Ad-hoc 场景可感知)
四 ClickHouse:把单表做到极致(对照组)
与 Doris 相比,ClickHouse 的取舍方向正好相反。ClickHouse 为 Yandex Metrica(网站流量分析)而生,场景是海量事件追加写入、单表 Ad-hoc 分析 。它并不追求"数仓全链路顺手",所有设计取舍都围绕一个目标:把单表扫描/聚合做到极限------这也是它至今仍保持优势的领域。
1 MergeTree:写入即排序,后台再合并
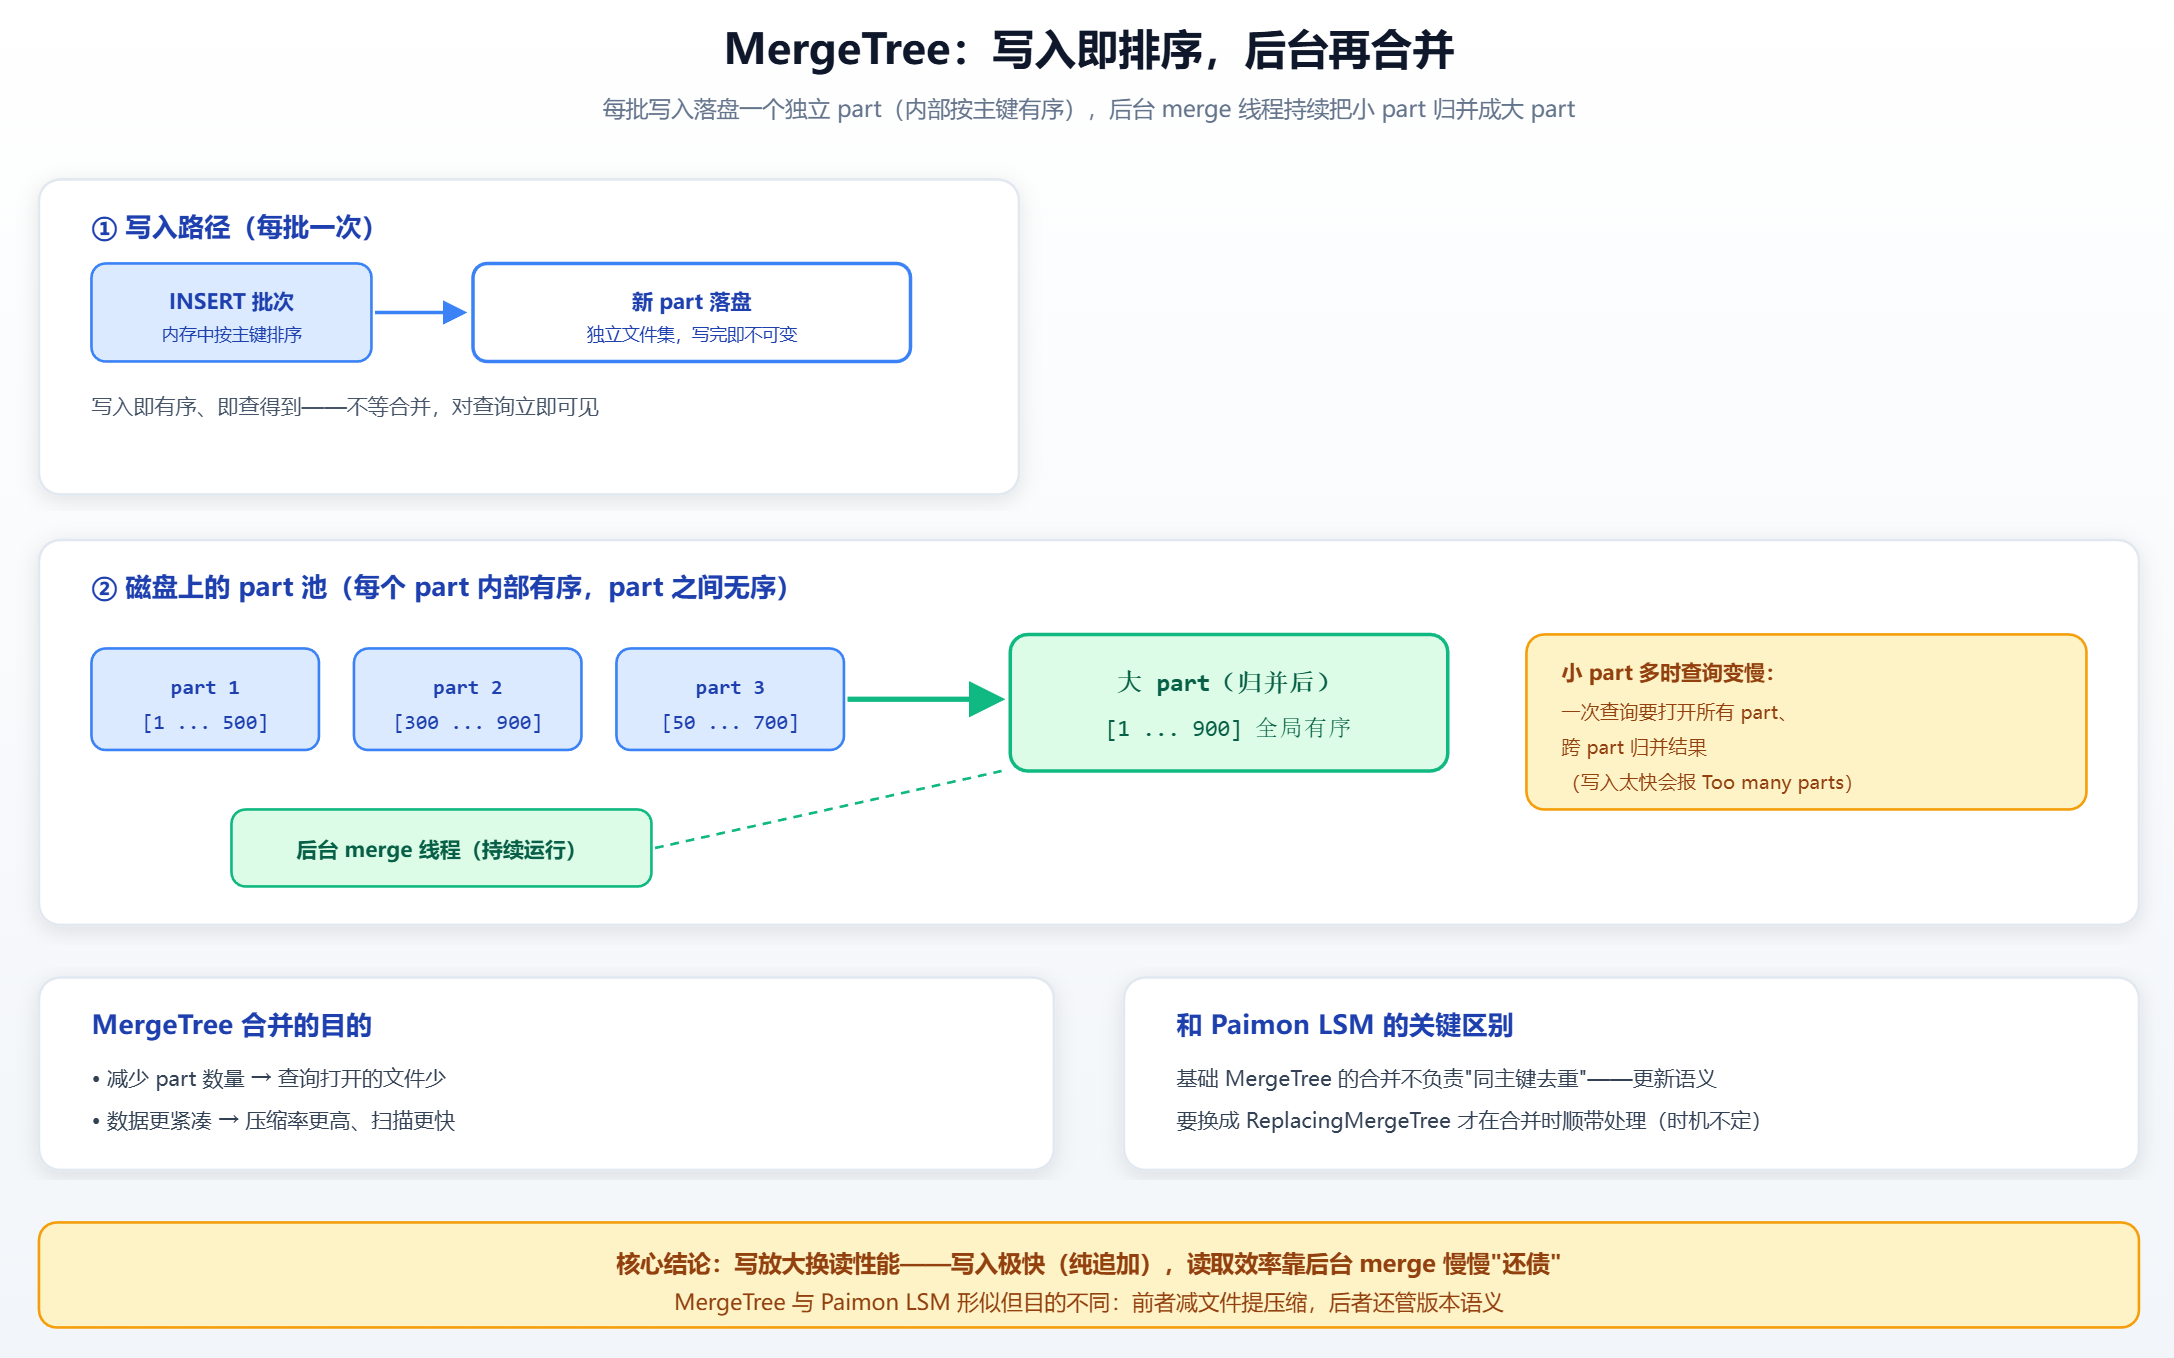
每批写入落盘成一个 part(数据按主键排序的独立文件集),后台 merge 线程持续把小 part 合并成大 part。和 Paimon 的 LSM 形似------都是"追加写 + 后台合并";但目的不同:MergeTree 的合并主要为减少 part 数量、提升压缩率,不承担"保证更新语义"的职责(这点下面详述)。
MergeTree 是一个引擎家族:基础的 MergeTree 只管存储;ReplacingMergeTree 在后台 merge 时对同主键数据只保留最新一版;SummingMergeTree / AggregatingMergeTree 在 merge 时做预聚合。
2 稀疏主键索引:为扫描优化,不为点查
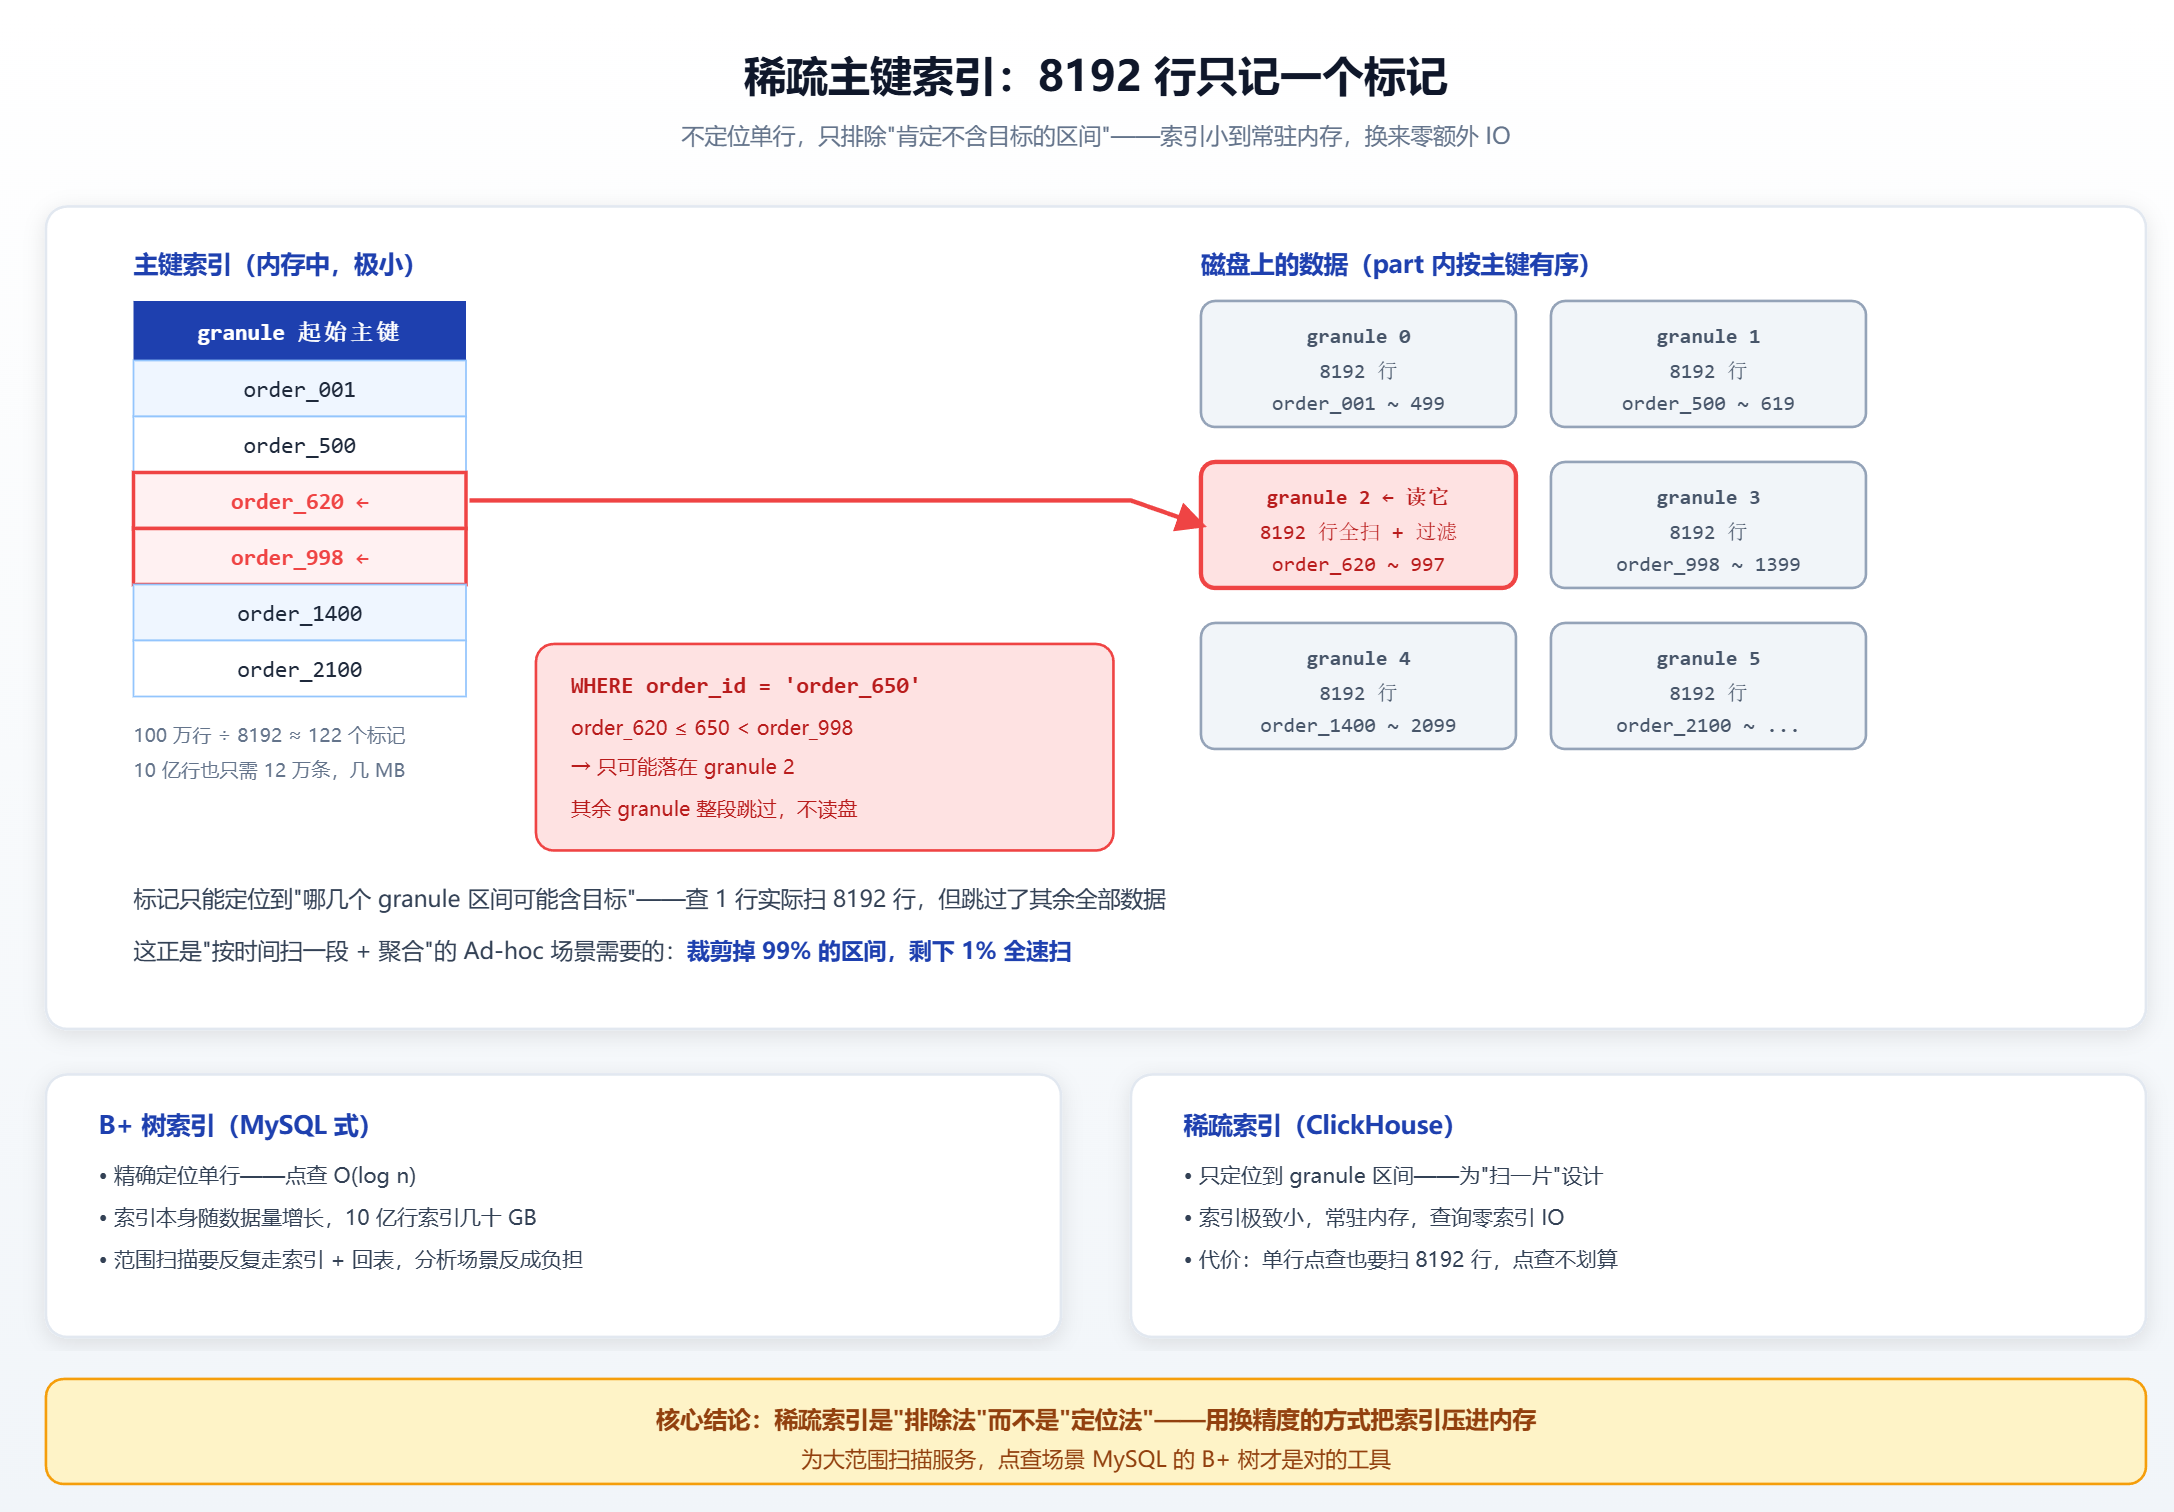
ClickHouse 的主键索引不是 B+ 树:每 8192 行(一个 granule)只记一个主键标记,索引小到可以常驻内存。查 WHERE order_id = 'order_650' 时,标记只能定位到"哪几个 granule 区间可能含目标",然后把这个区间的几万行扫出来过滤。
对比 B+ 树(精确定位单行):稀疏索引是为"大范围扫描"设计的------Ad-hoc 分析绝大多数是"按时间扫一段 + 聚合",定位到区间就够了,索引做到极致小换来的是全内存、零额外 IO。代价是点查不划算。
3 分片与副本:无中心,手动管理
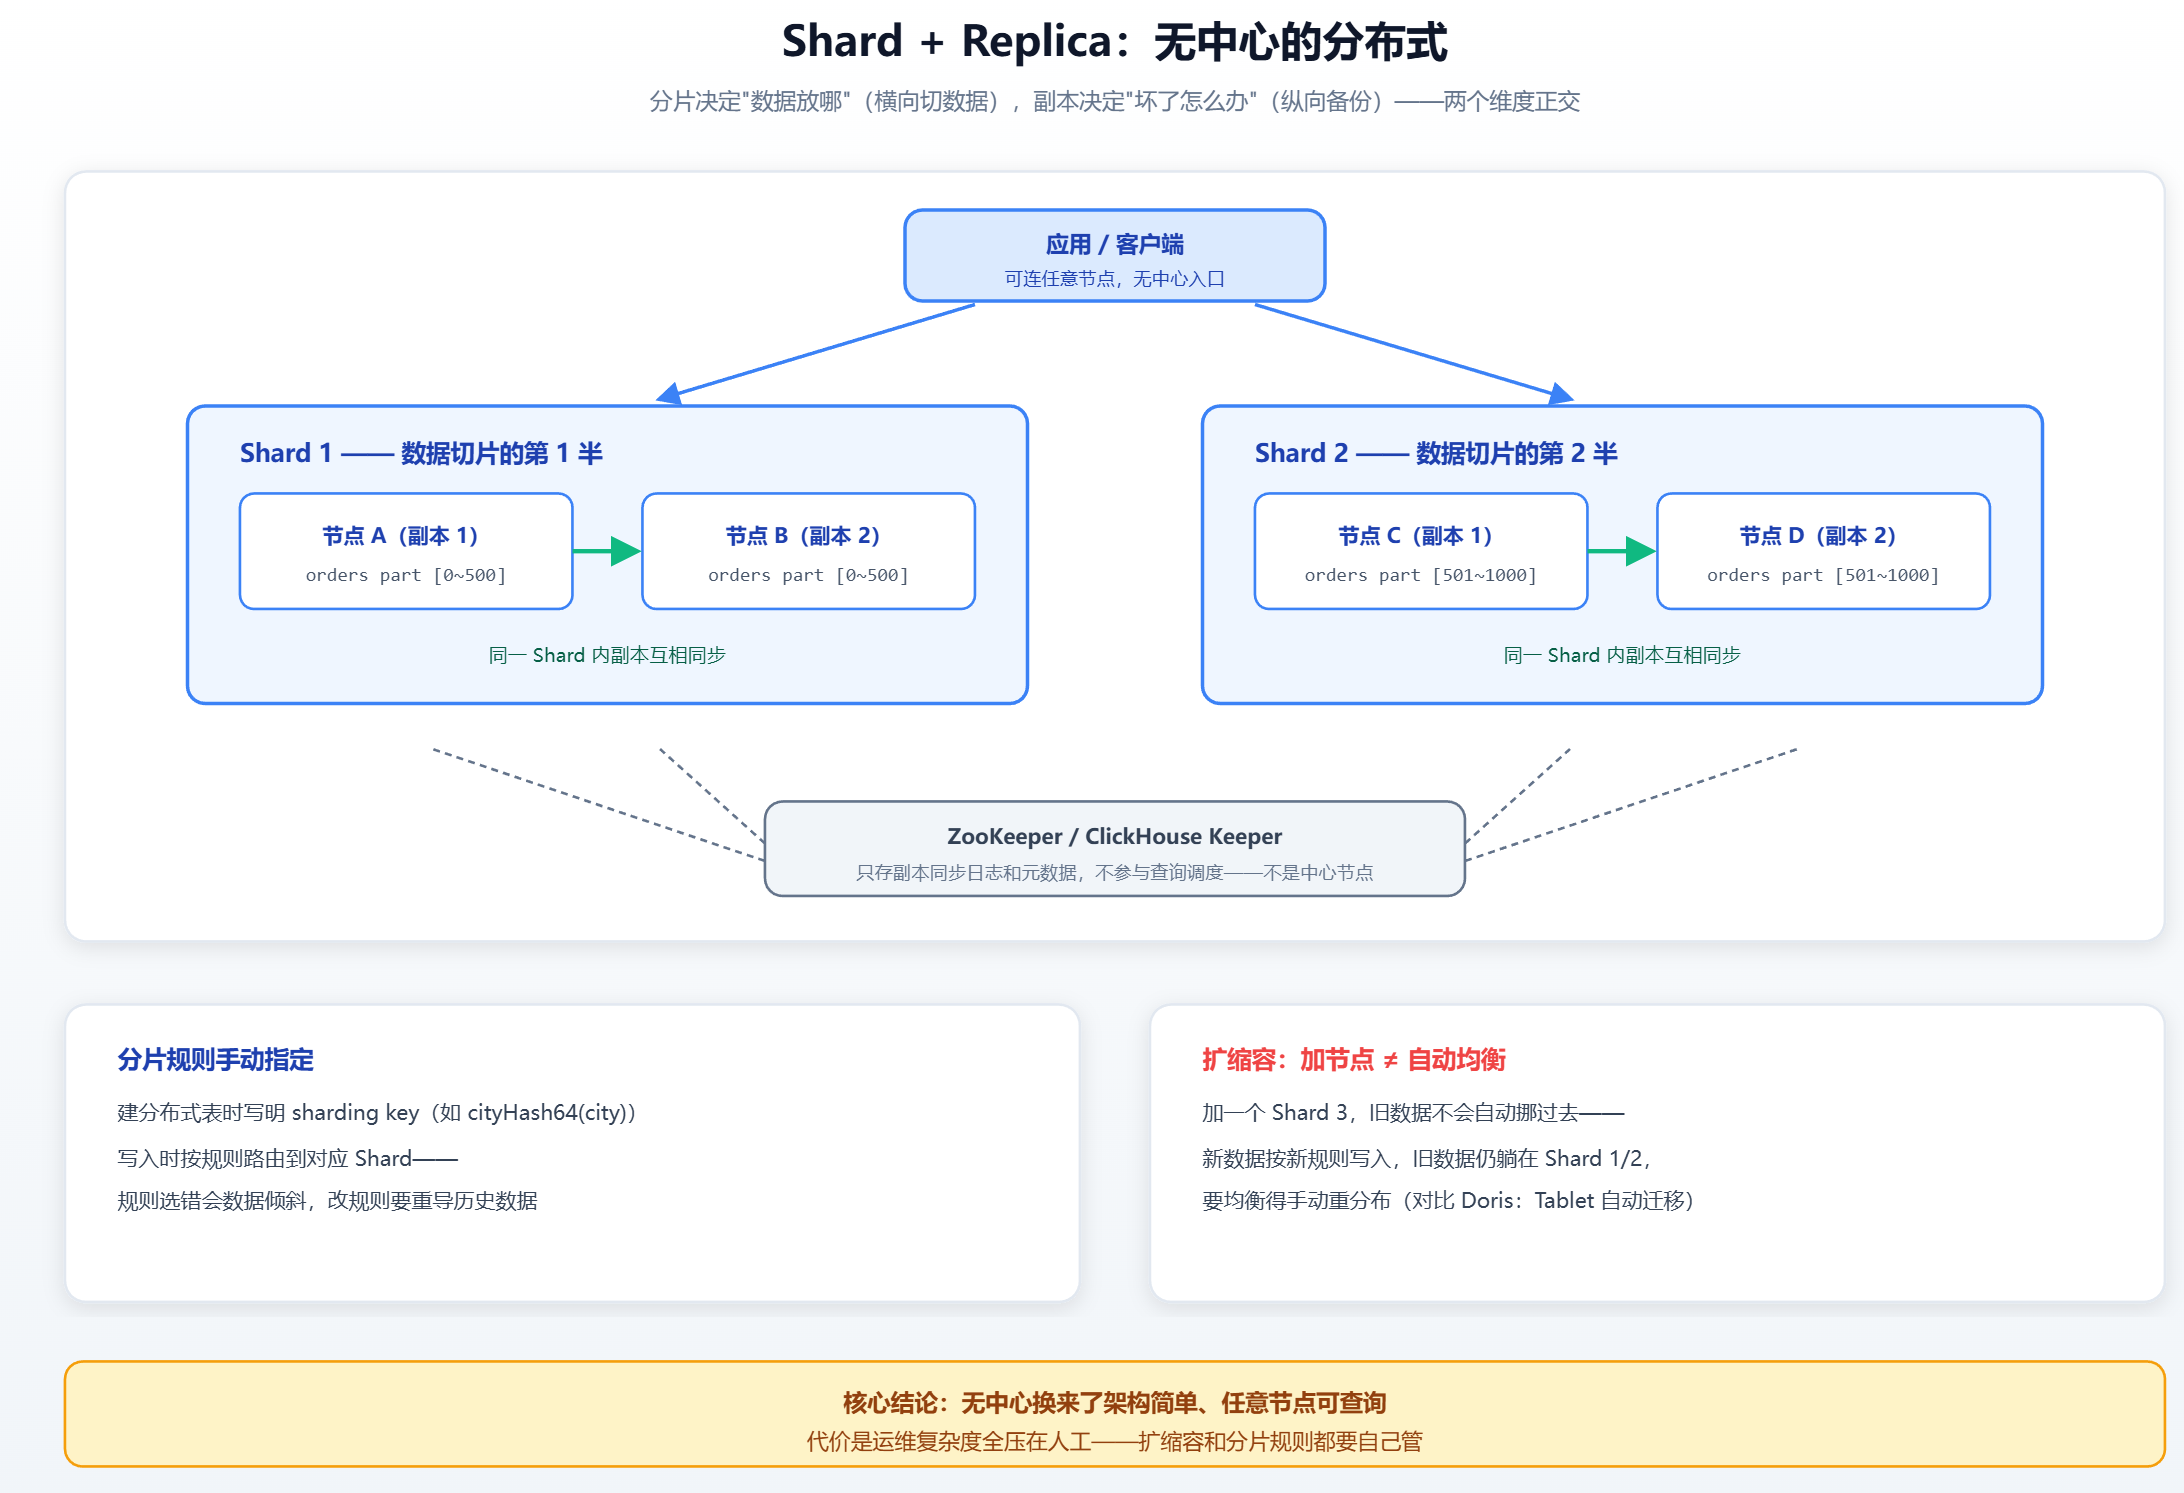
分布式靠 Shard(分片)+ Replica(副本):数据手动指定分片规则切开,副本间靠 ZooKeeper/Keeper 同步。没有中心调度节点,应用可以连任意节点查询。代价是扩缩容要手动重分布数据------加一个节点,旧数据不会自动挪过去。
4 强项与弱项
- 强项:单表扫描和聚合的性能极致。宽表(几百列)Ad-hoc 是它的优势场景
- 弱项 ,每一条都与"为单表优化"的取舍对应:
- Join 弱:多表关联(尤其大表 Join)缺乏完整的分布式关联优化,生产上普遍"写入前预拼宽表"绕开 Join
- 更新删除重 :UPDATE/DELETE 是 mutation 操作------异步重写整个 part,一次小改动可能重写几十 GB
- upsert 语义弱 :ReplacingMergeTree 只在后台 merge 时去重,merge 时机不确定;merge 之前查询能读到同主键多个版本,需要加
FINAL或 GROUP BY 处理------"最终会一致"而不是"写入即一致" - 并发低:单查询倾向吃满整机资源,并发能力在几十 QPS 级别,高并发需要外部队列/代理处理
五 正面对比:架构、模型、选型
1 分布式架构对比
ClickHouse 无中心节点,分片手动规划、扩缩容手动重分布;Doris FE/BE 分层,扩缩容自动均衡。运维复杂度差异主要在这里。
2 数据合并语义对比
同样面对"同主键两个版本",ClickHouse 推迟到后台 merge(时机不定,查询需要 FINAL 处理),Doris Unique Key MOW 写入时完成合并。upsert 语义强弱全在这条时间差里。
3 对比总表
| 维度 | ClickHouse | Doris |
|---|---|---|
| 设计重心 | 单表 Ad-hoc 极致 | 数仓报表全链路 |
| Join 能力 | 弱,生产靠预拼宽表 | 强,星型模型原生 |
| upsert | ReplacingMergeTree,merge 时才去重,弱语义 | Unique Key MOW,写入即一致,强语义 |
| 更新删除 | mutation 异步重写 part,重 | 轻量 |
| 并发能力 | 低(几十 QPS 级) | 高(千级 QPS) |
| 接入协议 | 自有 TCP / HTTP | MySQL 协议,BI 直连 |
| 部署形态 | 存算一体 | 存算一体 / 存算分离(3.0+,数据可放 S3/HDFS) |
| 扩缩容 | 手动重分布 | 自动均衡 |
| 湖仓外表 | 支持,但主流姿势是数据搬进内表 | Multi-Catalog,联邦查询是主推能力 |
| SQL 兼容 | 类 SQL 方言,非标准 SQL | 标准 SQL,兼容 MySQL 语法 |
| 更新粒度 | 整 part 重写 | 行级更新,支持部分列更新 |
| 典型场景 | 日志/行为分析、漏斗、超大宽表 | 实时报表、BI 看板、多维分析、画像 |
4 基准测试:榜单数据怎么看
官方技术对比页给出了四组基准测试,数据值得参考,但需要注意这是 Doris 官方发布的对比,立场需要打折扣:
- ClickBench(单表宽表聚合,ClickHouse 优势场景):Doris 2022/2024 两次进前三,与 ClickHouse 轮流领先------单表极限上两者已是同一量级
- SSB-Flat(星型模型压平成大宽表):同样聚焦单表,互有胜负
- TPC-H(22 条复杂查询):ClickHouse 有 7 条没跑完(OOM),Doris 全量完成------复杂查询的稳定性差距
- TPC-DS(99 条查询,大量关联子查询):测试时(2024.09)ClickHouse 约半数查询无法执行------关联子查询支持的代差
怎么读这些数据:单表场景两者打平,复杂查询场景差距拉开------和前面的机制分析(Join 能力、优化器、upsert 语义)完全互证。同时注意 ClickBench 恰恰是"为单表场景设计"的榜单,Doris 在对手优势场景打平,说服力不弱。
真实替换案例(官方收录):快手用 Doris 替换 ClickHouse 升级湖仓一体(直查湖上数据、物化视图治理);某日志平台 50 台服务器 2PB 数据,全文检索提升 3~7 倍、峰值写入 6GB/s、500+ 并发(较原 ClickHouse 集群提升 2 倍+)。
5 既然 Doris 全面占优,ClickHouse 还剩什么场景
上面四组数据读下来,一个自然的疑问是:单表打平、复杂查询领先、upsert 和并发全面占优------那还选 ClickHouse 干什么?几个现实原因:
- 存量与惯性:ClickHouse 2016 年开源,在行为分析/日志场景应用多年,存量集群规模庞大。集群在稳定运行、团队有经验,没有痛点就没有迁移动力
- 单表极限仍是它的优势领域:ClickBench 这类第三方榜单 ClickHouse 长期领先------"轮流领先"的另一面是 Doris 追平而非超越;且上面的对比页是 Doris 官方发布的,口径本身有立场,极端单表场景应当自行压测验证
- 部署轻:单节点一个二进制就能跑,嵌入式 chDB 甚至能进程内直接分析本地 Parquet 文件------小场景不用维护 FE + BE 两类进程的集群
- 生态配套:Grafana 插件、Vector/Fluent Bit 等日志管道直连,大量开源可观测方案默认后端就是它
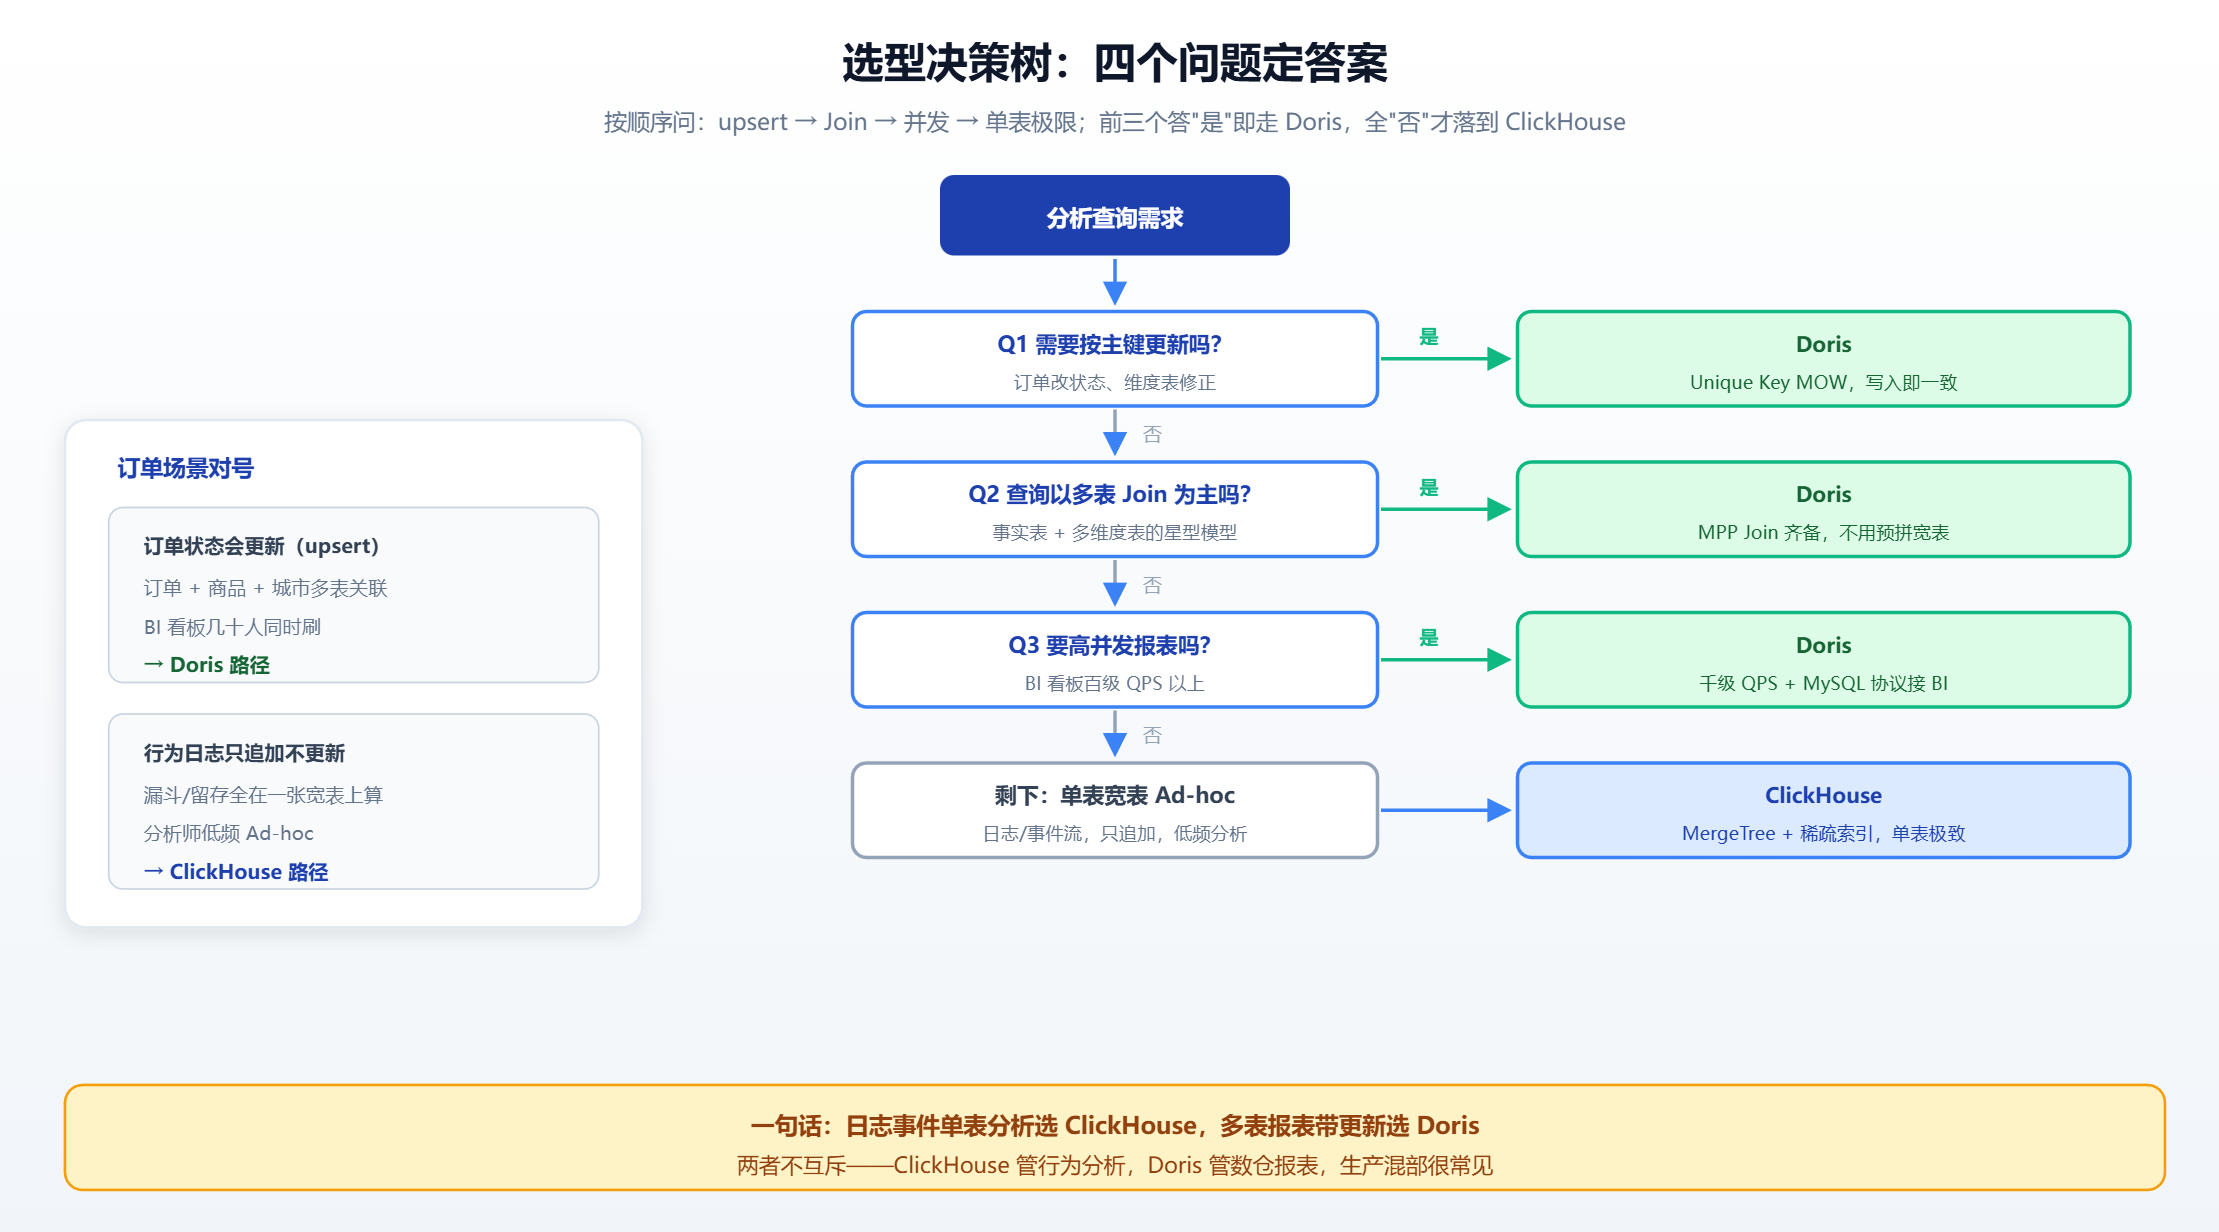
因此可以归纳为一个结论:新建数仓、报表、多表分析,Doris 是主流默认;纯追加的日志行为单表、或团队已有 ClickHouse 存量,继续用它也成立。两者不互斥,生产上混部很常见。
6 选型决策树
四个问题,按顺序问自己:
六 外表直查和数据进内表
数据都在湖里了,ADS 还要搬进 Doris 吗?两条路都在用,对应"不想搬"和"要最快"两种诉求。
1 外表直查(湖仓一体):数据一份不动
Doris 的 Multi-Catalog 可以把 Paimon 表挂载进来直接查------订单明细留在湖里,Doris 只做查询入口。机制上四步:
- 建 Catalog :一条
CREATE CATALOG指向 Paimon 的 warehouse(或对接 metastore),FE 由此拿到湖表的元数据入口,库表结构自动同步,不用逐张建外表 - 规划时读湖的元数据:查询进来,FE 读 Paimon 当前 snapshot 的 manifest(正是 Paimon 系列讲的 base + delta 那套),确定本次要读哪些数据文件,并用 manifest 里的 minKey/maxKey 先做一轮文件级裁剪
- BE 直扫 Parquet:BE 用内置向量化 Parquet reader 直接读湖上文件,列裁剪、谓词下推都压到 reader 层;BE 本地带 file cache,热数据块缓存住,重复查询不再拉远端存储
- 全程不落盘:Doris 内表里没有这份数据,查的就是湖里那一份
外表直查的性能优势来自哪里?需要先明确对比基准:不是 Doris 内表,而是"拉起批作业去查湖"(Spark SQL、Flink 批) 。差距的主要来源仍是第二节的分水岭------批引擎每查一次要申请资源、启动 driver/executor,几十秒才能读到第一条数据;Doris 的 FE/BE 进程常驻,SQL 进来毫秒级规划完直接扫描(常驻的是执行器进程,不是把数据放内存)。再叠加三层优化:MPP 让所有 BE 并行分片扫描湖上文件(而非单机 reader)、file cache 将重复查询的热数据挡在远端存储之外、manifest 文件裁剪 + reader 列裁剪两层压缩 IO------比批引擎查湖快一个数量级。顺带澄清一个概念:"不建 Doris 表"节省的是存储冗余和同步链路维护成本,那是架构收益,不是性能来源。
代价同样需要说明:外表没有内表的索引、预聚合和 compaction,数据不在 BE 本地盘、依赖远端存储带宽,file cache 未命中时性能落差尤其明显------比内表慢一个量级。定位因此清晰:比批引擎查湖快一个量级,比内表慢一个量级。适合**探索性分析、低频报表、或者"数据不方便 / 不愿意再存一份"**的场景。
2 热数据进内表:主流高性能姿势
很多团队的常规做法------把 Paimon 数据导入 Doris 再查------并没有被外表否定,它本来就是对性能有要求时的正确选择,正是 Paimon 系列讲的 changelog 流读的用武之地:Flink 流式读 Paimon 表的 changelog,实时 INSERT 进 Doris 内表(Unique Key 模型消化 -U/+U),引擎自己的存储、索引、预聚合全力加速。湖做统一底座,Doris 做加速层。
两条路的关系:外表直查管"不想搬",内表同步管"要最快"。生产上常见组合是------明细层外表直查做探索,ADS 热数据进内表扛看板。
七 小结
- OLAP 引擎补的是数据湖不擅长的两层:亚秒级 Ad-hoc 查询 和高并发报表。快的共同来源是列存 + MPP + 向量化,真正的分水岭在执行模型(常驻执行器 vs 按查询起作业)和索引裁剪粒度
- Doris 是数仓分析的主流默认:FE/BE 分层自动均衡、三种数据模型覆盖明细/预聚合/upsert、Unique Key MOW 写入即一致、Join 完整、千级 QPS、MySQL 协议接 BI、Multi-Catalog 直查湖仓------报表、多表、带更新的场景开箱即用
- ClickHouse 把单表做到极致,日志/行为单表 Ad-hoc 仍有它的位置(存量、轻量、生态);代价是 Join 弱、mutation 重、upsert 弱语义、并发低
- 回到订单链路:湖做统一底座,OLAP 做查询出口------外表直查管"不想搬",ADS 热数据进内表管"要最快"
官方应用现状补充一个信心锚点:Doris 已在 5000+ 中大型企业生产环境使用,中国市值/估值前 50 的互联网公司超 80% 在用(百度、美团、小米、京东、字节、阿里、腾讯等),国内主要云厂商均有托管服务------选型的社区和生态风险基本可以忽略。
参考:Apache Doris 官网 | Apache Doris 官方简介(3.x) | Apache Doris vs ClickHouse 官方技术对比 | ClickHouse 官网