1. NumPy 是什么:分层引擎之上的 Python API
可以把源码理解为一组契约:Python 名称、协议、核心对象、原生循环。
NumPy 对外提供简洁的 Python API,但用户看到的行为来自多个协同层。调用 np.add(a, b) 时,程序通常会经历输入规范化、dtype 解析、广播、迭代器准备以及内层循环。理解这些边界,可以让调试、性能分析和架构设计更加系统。
- Python 公共模块负责组织易发现的功能,并维护稳定的用户词汇。
- ndarray 保存 shape、strides、dtype、数据位置和 flags;这些元数据决定数据如何被解释。
- ufunc 机制负责逐元素运算,同时处理广播、类型提升和可选输出缓冲区。
- 原生 C/Cython 层执行紧凑循环,部分线性代数工作会交给 BLAS/LAPACK。
- 测试和文档是可执行规格,用于保护边界条件、数值行为和兼容性。
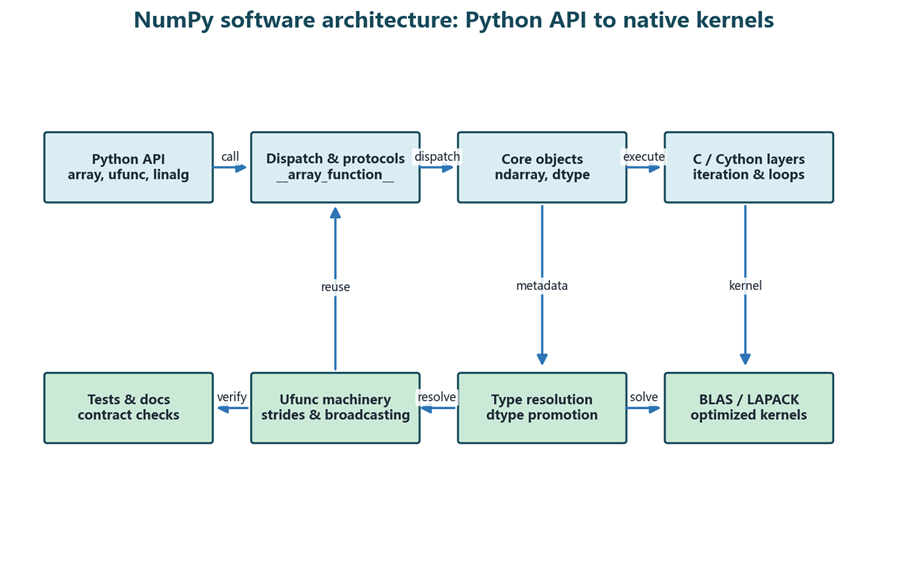
图 1:NumPy 的概念架构以及主要执行路径。
源码导航策略
|----------|----------------|-------------------------------|
| 问题 | 起点 | 需要收集的证据 |
| 数组如何表示? | ndarray/核心对象定义 | shape、strides、dtype、flags、所有权 |
| 函数如何分发? | Python 包装器和协议 | 转换、覆盖钩子、错误路径 |
| 热点循环在哪里? | ufunc/迭代器实现 | 内层循环、连续和跨步情况 |
| 如何保证正确性? | 测试和文档 | 边界条件、警告、期望输出 |
2. ndarray 内部:数据、元数据与视图
同一段字节可以通过不同的形状和步长模式解释。
理解 ndarray 的一个好方法是:它是一个带类型的多维内存视图。数据缓冲区保存字节,元数据告诉 NumPy 如何定位逻辑元素。reshape 很多时候只修改元数据而不搬移数值;切片可以产生新的偏移和步长。相反,当请求的布局或所有权保证无法满足时,某些操作必须分配副本。
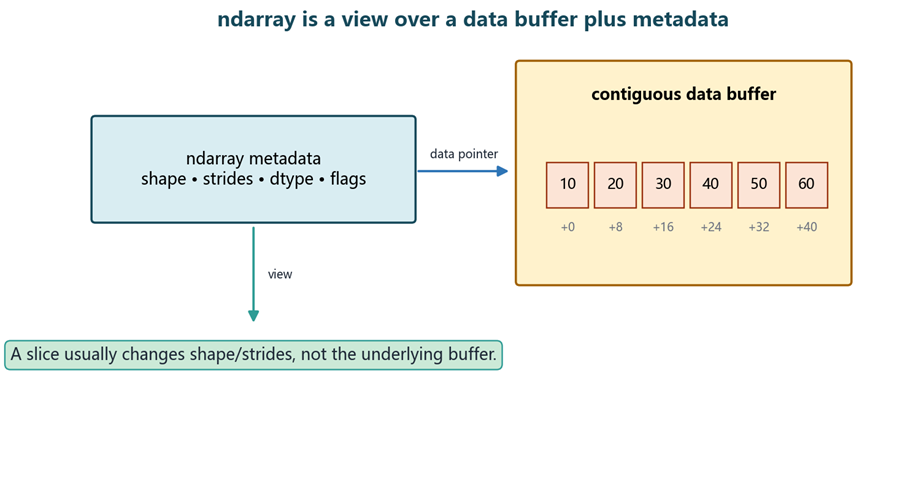
图 2:ndarray 元数据与数据缓冲区的概念关系。
一个小型检查实验
import numpy as np
a = np.arange(12, dtype=np.int64).reshape(3, 4)
view = a:, ::2
copy = a:, ::2.copy()
print(a.shape, a.strides, a.flags'C_CONTIGUOUS')
print(view.shape, view.strides, np.shares_memory(a, view))
print(copy.shape, copy.strides, np.shares_memory(a, copy))
|---------|-----------------|-------------------|
| 元数据 | 含义 | 为什么重要 |
| shape | 每个轴的长度 | 决定索引和广播是否兼容 |
| strides | 沿某轴移动一个元素所需的字节数 | 决定访问模式和缓存行为 |
| dtype | 元素解释方式和大小 | 决定类型提升、精度和内存占用 |
| flags | 连续性、所有权、可写性 | 决定是否可以使用快速路径或必须复制 |
工程含义
- 把视图当作别名:可写视图的修改可能会改变源数组。
- 当操作看似简单却异常缓慢时,检查 strides。
- 在 API 边界明确复制,而不要把复制作为不确定时的偶然反应。
3. ufunc 与广播:从调用到内层循环
逐元素 API 隐藏了一个分阶段的分发与迭代流水线。
通用函数(ufunc)提供稳定的逐元素语义。在处理数值前,NumPy 要确定操作数、解析兼容 dtype、通过广播对齐形状、选择输出布局,并选择内层循环。随后循环按照 strides 遍历缓冲区。这种分离让同一个公共操作可以支持多种 dtype 和内存布局。
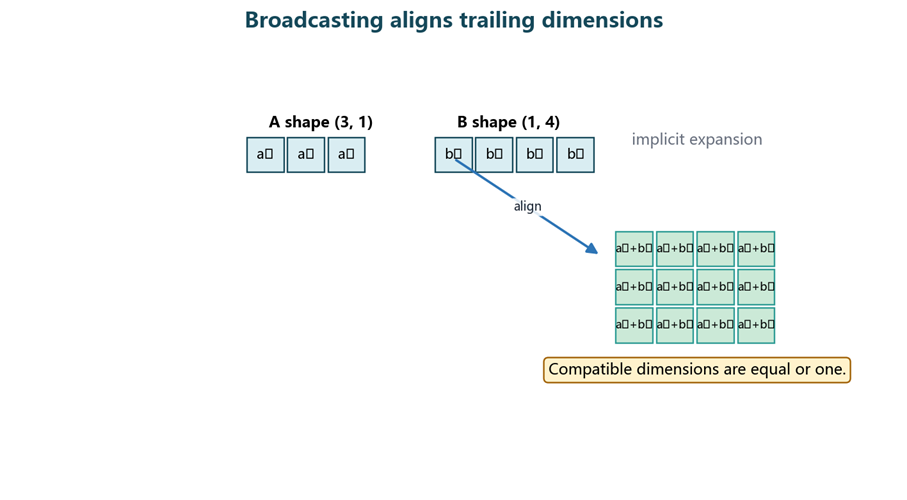
图 3:形状为 (3, 1) 与 (1, 4) 的操作数进行广播。
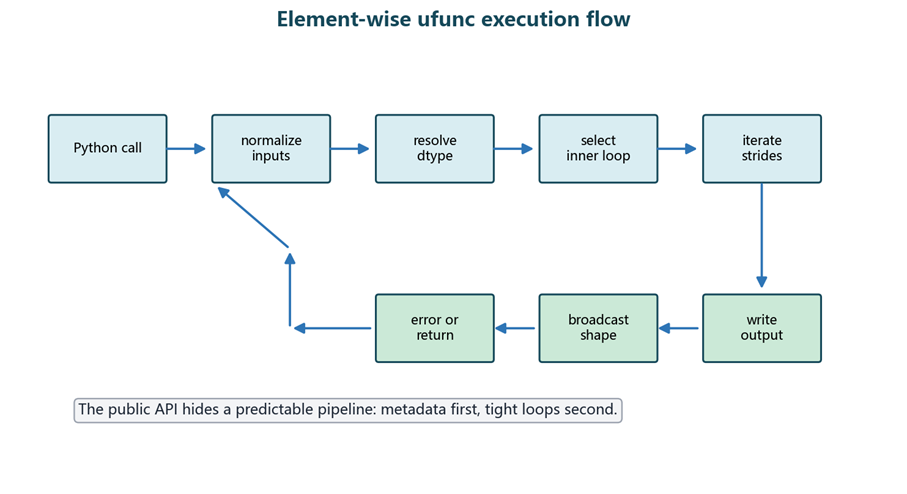
图 4:ufunc 从 Python 调用到输出的概念流程。
广播规则
|--------|----------------|-------------------|
| 步骤 | 规则 | 例子 |
| 对齐 | 从尾部开始比较维度 | (3, 1) 与 (1, 4) |
| 兼容 | 维度必须相等或其中一个为 1 | 3 对 1;1 对 4 |
| 扩展 | 长度为 1 的轴表现为重复值 | 结果形状为 (3, 4) |
| 拒绝 | 否则抛出形状错误 | (3, 2) 与 (4,) 不兼容 |
rows = np.arange(3):, None
cols = np.arange(4)None, :
grid = rows + cols # shape (3, 4),不需要显式嵌套循环
scaled = np.multiply(grid, 2, dtype=np.int64)
4. 索引、赋值与内存安全
索引负责选择数据;赋值还要处理校验、广播和修改语义。
索引并不是单一操作。基本切片通常保留与原始缓冲区的关系,而使用整数数组或布尔数组的高级索引通常会生成新结果。赋值也有独立路径:NumPy 会校验目标选择,在允许时广播右值,把数值转换为目标 dtype,并写回选定位置。
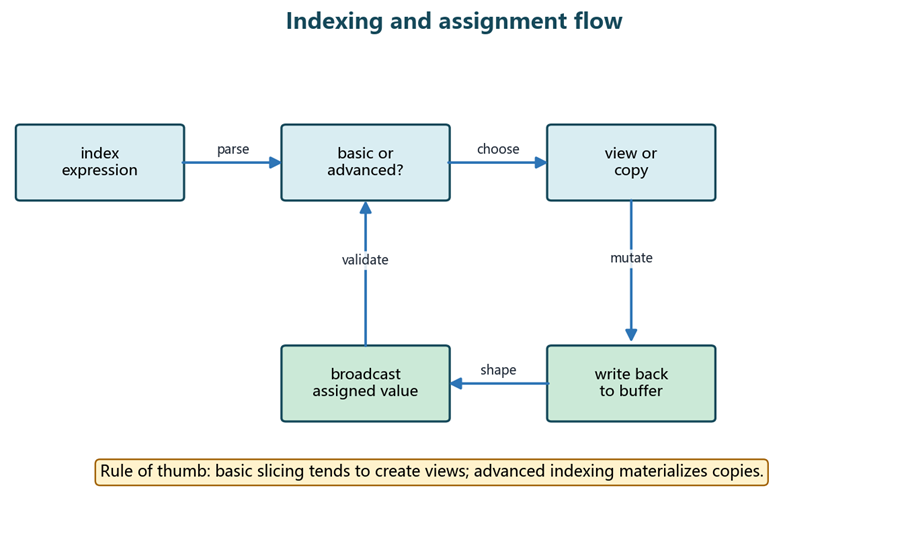
图 5:索引和赋值的概念流程。
值得跟踪源码的例子
a = np.arange(10)
basic = a2:8:2 # 通常是具有步长的视图
advanced = a\[2, 4, 6] # 高级索引结果
mask = a % 2 == 0
amask = -1 # 校验选择后写回
|-------------------|-----------|------------------|
| 表达式 | 典型结果 | 审查问题 |
| a2:8:2 | 带偏移和步长的视图 | 消费者是否预期别名关系? |
| a\[2, 4, 6] | 包含所选值的新数组 | 分配内存是否可以接受? |
| aa \> 5 | 布尔高级索引结果 | 掩码形状是否正确? |
| amask = value | 原地修改 | value 能否广播并安全转换? |
防御性习惯
- 调查时可以使用 np.shares_memory 或 np.may_share_memory,但它们不能代替明确的所有权契约。
- 在可能被观察到修改的 API 边界使用显式副本。
- 测试空选择、单例维度、负索引和非连续输入。
5. 线性代数与数值执行
高级例程会校验形状、选择算法、调用优化内核,并提供残差或诊断信息。
NumPy 线性代数例程很好地体现了分层执行。Python API 检查维度和选项,把数组准备成后端期望的布局,再把分解或矩阵乘法交给编译实现。结果不只是一个数字:数值可靠性还取决于条件数、缩放、dtype,以及计算解的残差。
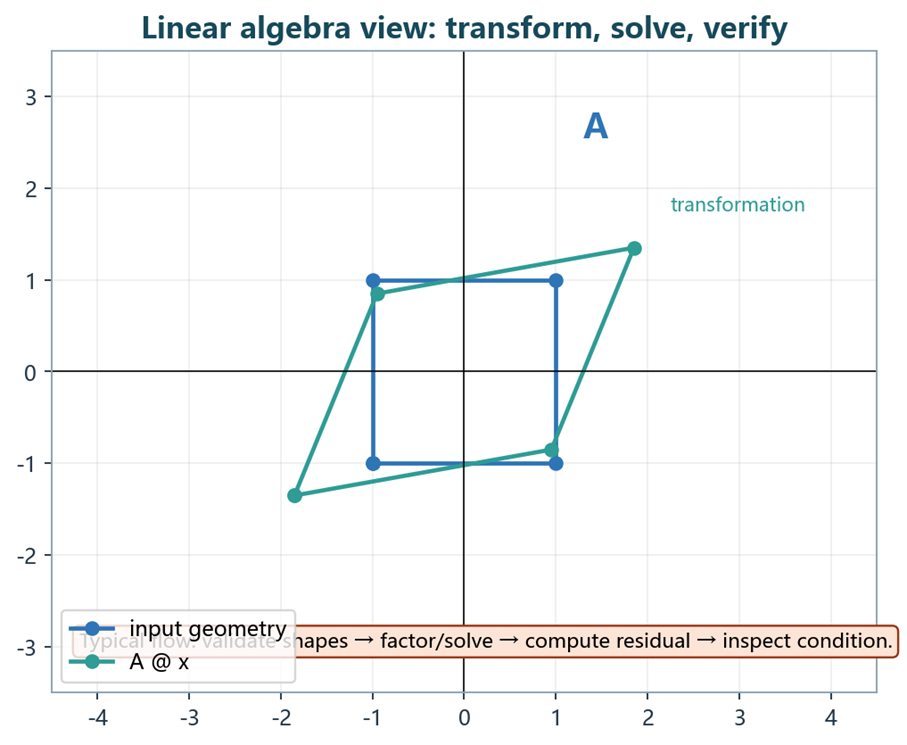
图 6:线性代数流程:变换、求解和验证。
A = np.array(\[3.0, 1.0, 1.0, 2.0])
b = np.array(9.0, 8.0)
x = np.linalg.solve(A, b)
residual = np.linalg.norm(A @ x - b)
condition = np.linalg.cond(A)
print(x, residual, condition)
|------------|---------------|------------------|
| 例程族 | 典型源码关注点 | 实用诊断 |
| matmul / @ | 形状分发和 BLAS 布局 | 检查形状、dtype、连续性 |
| solve | 分解和奇异性 | 检查残差和条件数 |
| svd | 迭代和收敛 | 观察奇异值衰减 |
| eig | 复数结果和稳定性 | 验证 A @ v ≈ λ @ v |
6. 测试、分发协议与可扩展性
源码阅读既要跟踪成功路径,也要跟踪扩展点。
NumPy 通过协议和明确的转换规则支持互操作。第三方数组类型可以实现约定钩子参与运算,而 NumPy 仍需保持可预测的回退行为。因此源码分析不应只包括 ndarray 路径,还应覆盖协议优先级、错误传播,以及混合类型操作的测试。
协议问题清单
- 覆盖钩子何时执行?多个操作数之间如何决定优先级?
- 哪些输入会立即转换?哪些输入会延迟到分发阶段?
- 不支持的组合会返回 NotImplemented、抛异常,还是回退到基础实现?
- 警告类别、异常类型和错误信息是否属于已测试的契约?
|---------|------------------|-----------|
| 测试层 | 示例目标 | 失败信号 |
| 单元 | dtype 提升或标量边界 | 值或异常错误 |
| 集成 | ufunc 加非连续输入 | 形状或内存行为错误 |
| 协议 | ndarray 与自定义数组混合 | 分发优先级错误 |
| 性能 | 大规模跨步或连续数组 | 异常分配或回归 |
| 文档 | 示例和 API 参考 | 过时或无法复现 |
一个紧凑的契约测试
x = np.arange(6, dtype=np.float64).reshape(2, 3)
y = np.ones((1, 3))
result = np.add(x, y)
assert result.shape == (2, 3)
assert result.dtype == np.float64
阅读实际 NumPy 源码时,建议维护一张小地图:公共入口 → 校验 → 分发 → 内核 → 测试。这样源码学习就不会变成互不连接的文件清单。
7. 性能审查与生产检查清单
先优化数据路径,同时保护正确性和可度量的契约。
NumPy 的性能通常来自减少 Python 层循环、选择合适 dtype,以及为操作提供适合高效循环的内存布局。更快的内核无法弥补重复分配、不必要的转换或糟糕的算法形状。应使用有代表性的规模进行基准测试,并报告预热、波动和内存观察结果。
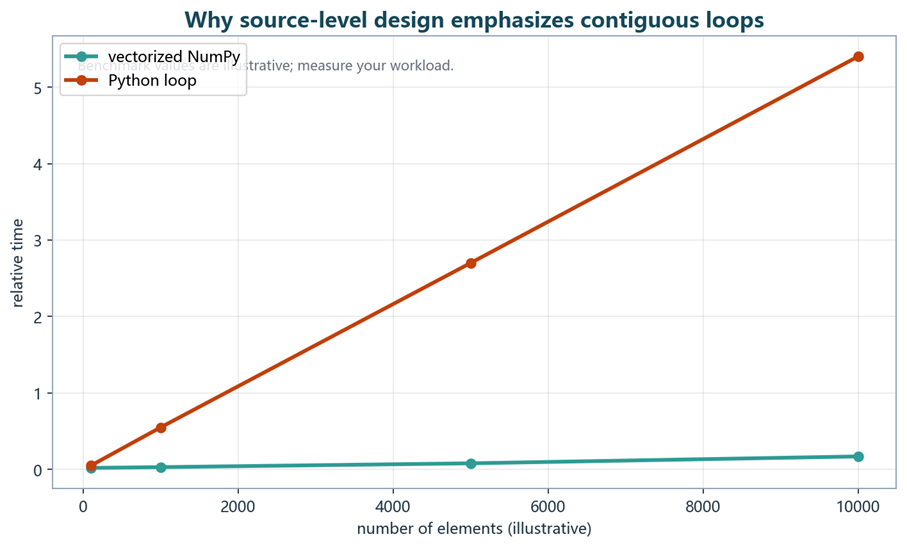
图 7:向量化执行与 Python 循环执行的示意对比。
|----------|-----------------------|-------------|
| 审查领域 | 检查问题 | 证据 |
| 正确性 | 是否定义形状、dtype、空值和 NaN? | 测试和不变量文档 |
| 内存 | 视图/副本和所有权是否有意? | 共享内存检查和分配分析 |
| 速度 | 热点路径是否向量化并考虑布局? | 可重复基准 |
| 数值 | 是否考虑溢出、精度和条件数? | 残差、容差和警告 |
| 兼容性 | 支持的数组类型是否可以分发? | 协议集成测试 |
| 维护 | 新贡献者能否找到契约? | 源码地图和聚焦文档 |
结尾学习计划
- 从一个公共函数开始,完整跟踪一次成功调用。
- 再用非连续数组、不同 dtype 和非法形状重复跟踪。
- 修改实现假设前,先阅读最近的测试。
- 把观察记录为契约:输入、输出、所有权、错误和复杂度。
参考阅读: