一句话看懂
项目地址:github.com/noahdunnaga... 
fsearch 是一个用 Rust 写的 macOS 全盘搜索工具,核心卖点是快:七百七十万个文件的磁盘上,按文件名查找的 p50 只要 1.3 毫秒,搜文件内容的 p50 是 9 毫秒。它既能当命令行工具直接用,也能当 Rust crate 嵌进别的程序,给 GUI 应用或自己写的工具提供搜索能力。
它解决什么问题
fsearch 要解决的是给开发者一个专门为"全盘范围 + 文件名/内容双模式"设计的索引引擎,把查询变成毫秒级操作,同时保持索引常驻更新,而不是每次重新扫盘。
研究笔记给出一个直接对比:同样查询下,fsearch 查文件名用 1.1 毫秒,另一个同类工具 fff 用了 13.8 毫秒;fsearch 启动后 50 毫秒就能响应查询,fff 要 2.5 秒;内存占用上 fsearch 守护进程 50MB,fff 是 358MB。这组数据来自作者自己的对比脚本,不是第三方评测,后面独立分析部分会单独说明。
核心概念速览
trigram index(三元组索引) :把文本按每三个连续字符切一段,比如"apply_dir"会被切成"app""ppl""ply"等片段,给每个片段建倒排索引,记录它出现在哪些文件里。查询时把搜索词也切成三元组,找到同时包含这些片段的候选集,再精确核对。fsearch 在 src/content.rs 里实现这套机制,专门负责内容搜索,不用整盘扫内容,先靠三元组缩小范围。
FSEvents :macOS 系统自带的文件系统事件通知机制,文件被创建、修改、删除时系统会推送事件,不需要应用自己轮询扫描。fsearch 在 src/fsevents.rs 里接入这个机制,首次建完整索引之后,后续增量更新全靠监听事件,新增或删除一个文件大约 0.1 秒就能反映到索引里。
mmap(内存映射文件) :把磁盘上的文件直接映射到进程的内存地址空间,读写这块内存就等于读写文件,不需要显式系统调用。fsearch 的文件名索引(src/index.rs)和内容索引(src/content.rs)底层存储都用 mmap,索引文件可以很大,但进程常驻内存不多,这也是守护进程只占 30-135MB 的原因之一。
Full Disk Access(全磁盘访问权限) :macOS 系统级权限,很多目录(Mail、Messages、某些系统文件夹)默认对普通进程隔离,必须用户显式授权才能访问。fsearch 在 src/engine.rs 里的处理方式比较直接:没有这个权限,受限制的文件夹就被跳过,不会弹窗提醒,也不会报错中断。
架构拆解
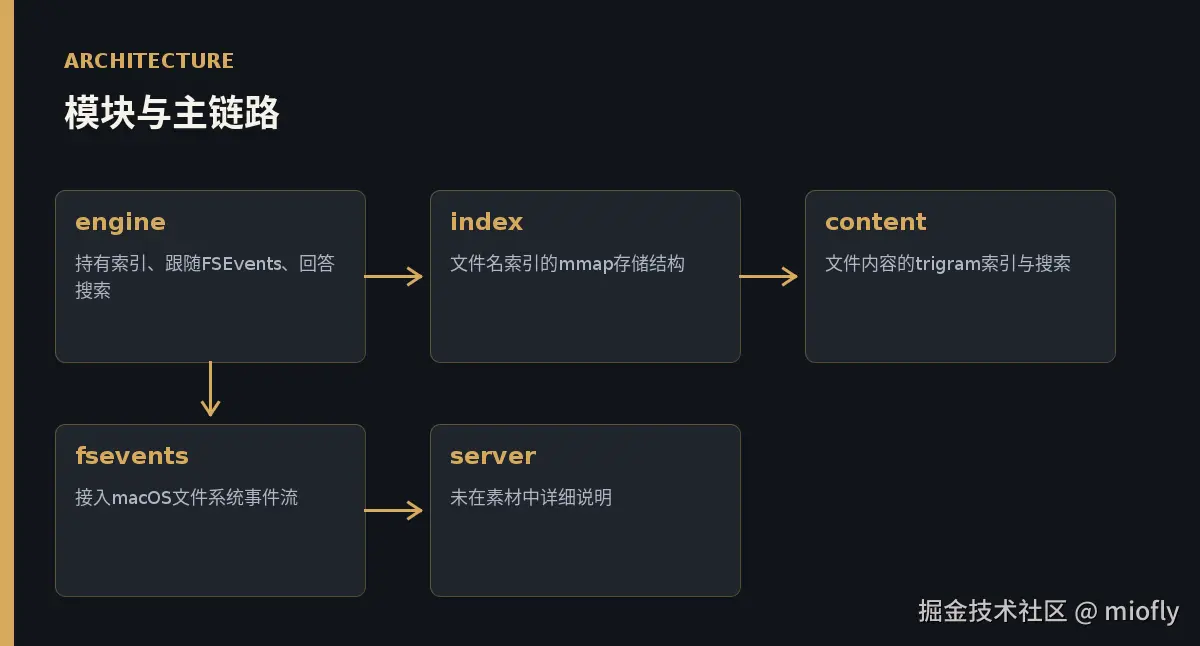
fsearch 核心是一个常驻引擎(Engine),围绕它展开几个各司其职的模块。src/engine.rs 是调度中心,负责持有索引、跟随 FSEvents 事件、回答外部查询;src/index.rs 专门管理文件名索引,用 mmap 结构存储,按文件夹分区,支持按路径范围查询;src/content.rs 负责文件内容的 trigram 索引和搜索逻辑,复用了 index.rs 里关于"section 文件布局"的设计,没有另起一套存储格式;src/fsevents.rs 专门对接 macOS 文件系统事件流,是增量更新的入口;另外还有 src/server.rs,研究笔记没有展开它的具体职责,但从命名和项目描述能推断它承担对外接口(Unix socket 或 stdio 的 JSON 行协议)的角色。
这几个模块的关系是:engine 持有并查询 index 做文件名搜索,同时持有并同步 content 模块做内容搜索,还要监听 fsevents 推送的变更事件,把变更同步进两套索引。content 和 index 之间也有联系,前者复用了后者的文件布局设计,底层存储结构有共用部分,降低了维护成本。
从启动流程看,Engine::start 先创建锁文件判断自己是不是"owner"(第一个启动的进程),如果是 owner 就尝试 Index::load 加载已有索引,加载失败就触发 full_build 做一次全盘爬取。owner 进程随后调用 Shared::watch 开始监听 FSEvents,后续同一台机器上再启动的 fsearch 进程不会重复爬盘,而是共享 owner 持有的索引,保证数据一致性,也避免资源浪费。
关键实现走读
研究笔记摘录了 src/content.rs 里定位某个路径前缀下直接子项的函数:
rust
    fn direct_children(&self, prefix: &[u8]) -> Vec<u32> {
        let bp = self.by_path();
        let mut out = Vec::new();
        let mut i = bp.partition_point(|&d| self.path(d) < prefix);
        while i < bp.len() {
            let p = self.path(bp[i]);
            if !p.starts_with(prefix) {
                break;
            }
            match p[prefix.len()..].iter().position(|&b| b == b'/') {
                None => {
                    if !self.is_dead(bp[i]) {
                        out.push(bp[i]);
                    }
                    i += 1;
                }
                Some(k) => {
                    let mut hi = p[..prefix.len() + k + 1].to_vec();
                    *hi.last_mut().unwrap() = b'/' + 1;
                    i += bp[i..].partition_point(|&d| self.path(d) < hi.as_slice());
                }
            }
        }
        out
    }
做了什么:这个函数接收一个路径前缀,返回这个目录下所有直接子项(文件或子目录)的编号列表。先拿到按路径排序的编号表 bp,二分查找定位到第一个路径不小于 prefix 的位置,然后往后扫描。每一项先确认以 prefix 开头,否则 break 退出。如果路径在前缀之后没有斜杠,说明是直接文件,只要没被标记"已删除"就加入结果。如果还有斜杠,说明是更深层路径,这时构造一个"上界"字节串(把斜杠后面一位加一,构造出刚好大于该子目录所有路径的下界),再用一次二分查找直接跳到这个子目录范围末尾,一次性跳过整个子树。
为什么这样写:核心诉求是在排序好的路径表里,既要查某个目录下的直接子项,又不能被深层嵌套文件拖慢。如果老老实实遍历前缀范围内每一条路径,子目录套子目录、文件再多的情况下,时间复杂度会跟着文件总数线性增长。这里用两次二分查找配合"构造上界跳过整段子树"的技巧,把一次子目录跳过的代价从 O(该子目录内文件数) 降到 O(log n),是能在百万级文件规模下还保持毫秒级响应的关键细节之一。
没有它会怎样:如果去掉跳过子树的逻辑,改成逐条扫描判断,面对像 node_modules、.git、构建产物目录这类动辄几万个文件的深层子树,一次查询可能要多扫描成千上万条无关记录,延迟会随目录规模明显膨胀,"文件名查询 p50 1.3 毫秒"这类数字就很难保持。这段代码把"前缀范围查询"从暴力扫描变成结构化跳跃,是性能承诺能落地的技术细节。
动手上手
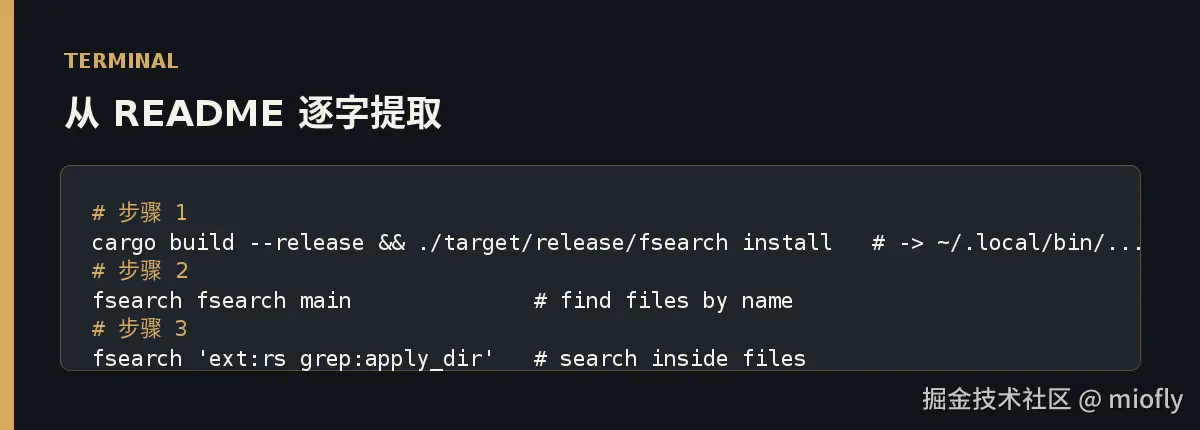
先编译并安装:
bash
cargo build --release && ./target/release/fsearch install # -> ~/.local/bin/fsearch这一步用 Rust 发布模式编译项目,再调用 fsearch 自带的 install 子命令把二进制放到 ~/.local/bin/fsearch。可验证的结果是:执行完在终端输入 fsearch --version 或 which fsearch,应该能看到路径指向 ~/.local/bin/fsearch,说明安装生效。
按文件名搜索:
bash
fsearch fsearch main # find files by name这条命令在已建立索引的磁盘范围内按名称查找包含"main"相关的文件。可验证的结果是终端打印出一批匹配的文件路径列表,根据性能数据,这类查询在数百万文件规模下的 p50 延迟应该在 1 到 2 毫秒量级,实际体验是几乎输入完就能看到结果。
按内容搜索:
bash
fsearch 'ext:rs grep:apply_dir' # search inside files这条命令用了两个查询语法:ext:rs 把搜索范围限定在 .rs 后缀文件,grep:apply_dir 在这些文件内容里查找包含"apply_dir"字符串的位置。可验证的结果是终端输出命中的文件路径以及匹配到的具体位置或片段,这类内容搜索的 p50 延迟大约在 9 毫秒左右,仍是人感觉不到等待的级别。
应用场景
对日常写代码的开发者,最直接的用处是在体量较大的代码仓库里快速定位文件,比如忘了某个模块具体文件名,只记得大概关键词,用全盘范围搜索比在 IDE 里一个个翻目录树快得多。配合 ext: grep: regex: sym: 这些过滤器,也能当成轻量的代码内容检索工具,不打开 IDE、不等待索引重建就能直接定位符号或字符串位置。
对需要管理多台机器或经常在本机做系统级排查的管理员,全盘搜索可以用来找配置文件、日志文件或排查某类后缀文件分布在哪些目录,省掉手写 find 命令配合复杂参数的麻烦。
对想把搜索能力嵌入自己工具链的开发者,fsearch 本身是一个 Rust crate,可以直接在自己的程序里调用 Engine::start 启动引擎,用 Query::parse 解析查询字符串,拿到结果后自己决定怎么展示,比如集成进自定义文件管理器、编辑器插件或命令面板类工具,不需要重新实现一套索引和增量更新机制。
独立分析
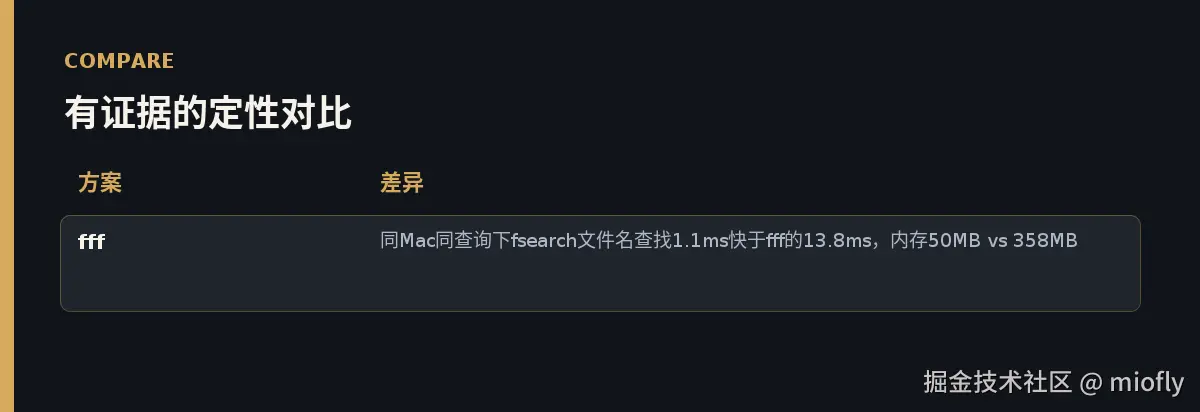
研究笔记里的性能对比数据(文件名查找 1.1ms vs 13.8ms,启动后响应 50ms vs 2.5s,内存 50MB vs 358MB)全部来自作者自己写的对比脚本 demo/vs_fff.py,属于项目方自测结果,不是第三方中立评测。这类自测数字在方法论透明、代码公开的前提下有一定参考价值,但读者需要清楚它反映的是"作者选定测试场景下"的表现差异,实际使用中受磁盘类型、文件总量、目录结构深浅等因素影响,结果会有波动,不宜直接当成普适结论。
另外值得注意,仓库创建于 2026 年 10 月,到最近一次 push 之间只有一天左右的活跃窗口,当前 star 数到 1148、fork 到 83,但当日新增 star 是 0,说明项目曾有一波关注高峰,眼下处于相对平静阶段。open issue 只有 3 个,结合仓库的年轻程度,现在还不足以判断社区维护的长期活跃度和响应速度,需要观察更长的时间线才能有更稳的结论。
局限与风险
研究笔记列出的几个具体限制值得仔细看:在 Linux 上测试的九万六千文件规模下,文件名搜索速度和 fff 打平,没有体现出 macOS 上的优势,说明目前的高性能更多是针对 macOS 平台优化的结果,跨平台一致性还没验证到位。内容搜索方面,fff 实际会搜索比 fsearch 多 9% 的文件,原因是 fsearch 默认跳过了 build、vendor 这类目录,这是性能和覆盖面之间的权衡,对某些确实需要搜索构建产物或第三方依赖目录内容的场景,可能会漏掉结果。
权限管理上有个容易踩坑的细节:每次重建索引之后,都需要在系统设置里重新手动授予 Full Disk Access 权限,而且如果用户没有授权,受限制的文件夹是被直接跳过的,不会弹出任何提示或报错。这意味着用户可能在不知情的情况下漏搜了某些目录的内容,却以为搜索范围是完整的全盘,这是一个需要额外留意的隐性风险点。
结论卡片
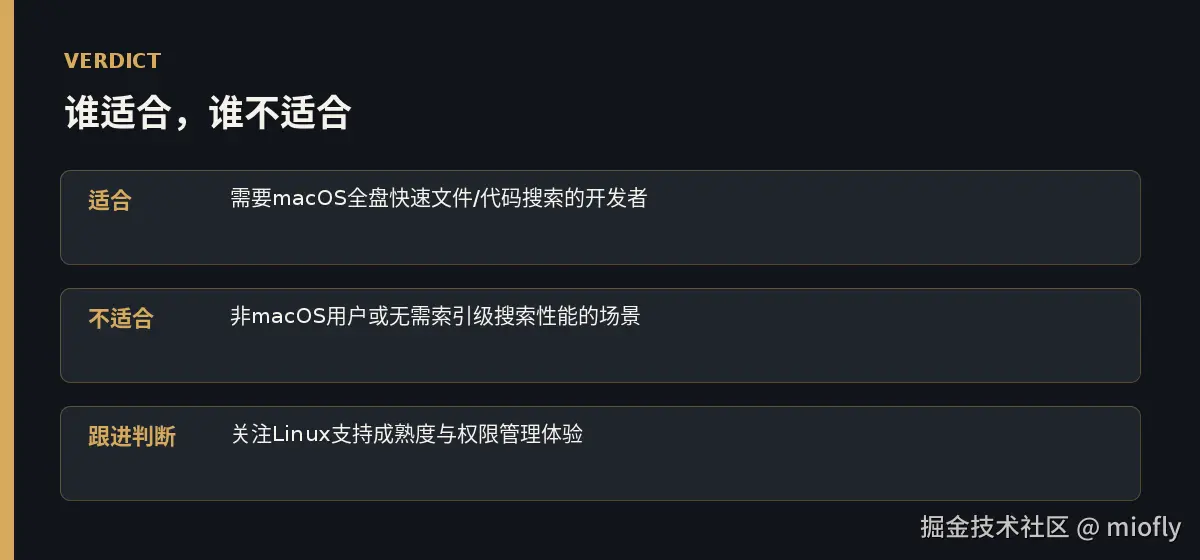
适合谁:日常在 macOS 上处理大量文件、需要全盘范围内对文件名或代码内容做快速检索的开发者,尤其是经常在大型仓库或多项目并行环境下工作的人。
不适合谁:非 macOS 用户目前拿不到同等的性能体验,Linux 支持还处于早期验证阶段;如果日常搜索需求用系统自带工具或 IDE 内置搜索就能满足,引入这个工具的收益也不明显。
后续关注点:Linux 支持的成熟程度会不会进一步提升,以及 Full Disk Access 的权限管理体验(比如重建后免重新授权,或未授权时给出更明确提示)是否会在后续版本里得到改善,这两点决定了它的适用范围能不能进一步扩大。