摘要 :前五篇我们实现了四种协作模式------Pipeline、MapReduce、Supervisor、黑板。但每一次实现都伴随着同样的重复劳动:自己写循环、自己判断分支、自己重试、自己存断点。这些"形状"(模式)和"跑形状的机器"(引擎)是两回事。本文从零实现一个 Agent 编排引擎,聚焦引擎最难的三件事:任务 DAG 的结构化表达 (把散落在
if/else里的控制流变成可声明的图)、条件分支的类型安全 (路由决策写错时在编译期报错,而不是运行到一半才发现跳错了节点)、循环控制的边界约束(Agent 场景的循环不是业务循环,是会烧钱的循环,必须有硬预算与退化策略)。文中给出完整的编译器、执行器与案例,并解释为什么生产环境应该用 LangGraph 而不是自己造轮子。📌 版本声明 :本文基于 Python 3.11+、LangGraph 0.2+、Pydantic V2 编写,撰写时间 2026 年 10 月。引擎核心(图模型、编译期校验、执行器)不依赖任何框架,可直接运行;LangGraph 对照部分基于 0.2+ API,不同版本间
StateGraph与add_conditional_edges签名略有差异,以官方文档为准。适用边界 :适用于需要复杂控制流 (多分支、长循环、跨节点状态共享、失败回滚)的 Agent 流程。若你的流程是纯线性的,用 LCEL 或直接写
for循环更划算;本文的引擎实现适合学习原理或受限环境自建,生产环境建议直接用 LangGraph------第六章会详细说明理由和自研的真实成本。
文章目录
-
- 一、为什么需要编排引擎:模式之外的那一层
-
- [1.1 一个重复劳动的观察](#1.1 一个重复劳动的观察)
- [1.2 模式是形状,引擎是机器](#1.2 模式是形状,引擎是机器)
- [1.3 为什么 Agent 场景的循环特别难](#1.3 为什么 Agent 场景的循环特别难)
- [1.4 什么时候不该自己造引擎](#1.4 什么时候不该自己造引擎)
- 二、编排引擎核心概念:专门章节
-
- [2.1 图模型(Graph Model)------四个要素](#2.1 图模型(Graph Model)——四个要素)
- [2.2 三种边的语义区分](#2.2 三种边的语义区分)
- [2.3 编译期校验------引擎的第一道防线](#2.3 编译期校验——引擎的第一道防线)
- [2.4 状态合并语义------reducer 为什么会存在](#2.4 状态合并语义——reducer 为什么会存在)
- 三、环境准备
-
- [3.1 环境与依赖](#3.1 环境与依赖)
- [3.2 本文案例:内容合规审查流水线](#3.2 本文案例:内容合规审查流水线)
- 四、核心实战:从零实现编排引擎
-
- [4.1 第一步:图定义与构建 API](#4.1 第一步:图定义与构建 API)
- [4.2 第二步:执行器------带预算的执行循环](#4.2 第二步:执行器——带预算的执行循环)
- [4.3 第三步:类型安全的路由设计](#4.3 第三步:类型安全的路由设计)
- [4.4 第四步:跑通一次完整流程](#4.4 第四步:跑通一次完整流程)
- 五、进阶:让引擎撑住生产
-
- [5.1 三边混用的检查清单](#5.1 三边混用的检查清单)
- [5.2 精确控制循环次数](#5.2 精确控制循环次数)
- [5.3 断点保存与恢复](#5.3 断点保存与恢复)
- [5.4 观测:一条执行链路要看什么](#5.4 观测:一条执行链路要看什么)
- [六、方案对比:自研引擎 vs LangGraph vs Temporal](#六、方案对比:自研引擎 vs LangGraph vs Temporal)
-
- [6.1 三方对比](#6.1 三方对比)
- [6.2 自研的真实成本](#6.2 自研的真实成本)
- [6.3 什么时候需要 Temporal 这样的重型方案](#6.3 什么时候需要 Temporal 这样的重型方案)
- [七、适用边界与风险提示 ⚠️](#七、适用边界与风险提示 ⚠️)
-
- [7.1 编排引擎适合什么](#7.1 编排引擎适合什么)
- [7.2 编排引擎不适合什么](#7.2 编排引擎不适合什么)
- [7.3 五个典型陷阱](#7.3 五个典型陷阱)
- [7.4 版本与兼容性提醒](#7.4 版本与兼容性提醒)
- 八、进阶:让编排引擎可测
- 九、总结
- 参考资料
一、为什么需要编排引擎:模式之外的那一层
1.1 一个重复劳动的观察
回看前五篇的实现,会发现大量雷同代码。
第 22 篇的 Pipeline,核心循环大概是这样:
python
state = initial_state
for step in [collect, analyze, validate, report]:
    try:
        state = await asyncio.wait_for(step(state), timeout=60)
    except TimeoutError:
        state = await handle_timeout(state)   # ← 每个项目都要重写
    if not validate(state):                   # ← 分支判断
        state = retry_or_degrade(state)       # ← 退避逻辑也要重写
    await save_checkpoint(state)              # ← 断点保存也要重写
第 23 篇的 MapReduce 里,重试、并发控制、降级、结果收集各写了一遍。
第 24 篇的 Supervisor 里,终止判据、超时保护、审计日志又各写了一遍。
第 25 篇的黑板里,激活预算、冲突登记、轨迹记录还是各写一遍。
这些代码与业务无关,但每一个项目都要重写,且重写一次就多一个出 bug 的地方。 更糟的是,第 24 篇踩过的坑(终止判据交给 LLM 会死循环)、第 25 篇踩过的坑(陈旧写覆盖)------它们不是那两篇特有的问题,而是所有编排实现都会遇到的问题。
编排引擎要做的,就是把这些"每个项目都要重写"的东西固化下来,并且固化得对。
1.2 模式是形状,引擎是机器
这是本文最核心的区分:
| 概念 | 是什么 | 对应物 |
|---|---|---|
| 模式(Pattern) | 多个 Agent 如何协作的形状 | Pipeline / MapReduce / Supervisor / 黑板 |
| 引擎(Engine) | 把形状跑起来的机器 | LangGraph / LCEL / Temporal / 你自己写的 |
一个类比:模式像"建筑设计图"(户型、动线、采光),引擎像"施工系统"(脚手架、材料调度、进度控制、验收标准)。你可以只按图纸盖房子(每次自己搭脚手架),也可以用施工系统(第 22-25 篇就是在自己搭脚手架)。
| 模式 | 对引擎的最低要求 |
|---|---|
| Pipeline | 顺序执行、状态传递、超时、失败处理 |
| MapReduce | 上述 + 动态扇出(运行时决定并发多少)、结果聚合 |
| Supervisor | 上述 + 动态路由(运行时决定下一个节点)、循环终止 |
| 黑板 | 上述 + 持久化共享状态、并发冲突控制、细粒度唤醒 |
反过来看,引擎必须提供的三个核心能力,正好对应三种模式的硬需求:
能力一:图模型------把控制流从代码里抽出来变成数据结构(第 22、23 篇的循环和分支是硬编码的)。
能力二:路由决策------运行时决定下一步走哪(Supervisor 与黑板的必需)。
能力三:循环约束------让循环可控、可预算、可退化(第 24、25 篇各踩一次坑的地方)。
1.3 为什么 Agent 场景的循环特别难
第 24 篇写过"47 轮死循环",第 25 篇写过"永不停机"。现在把这件事放到引擎层面看,会发现它是一个结构性问题,不是某个项目的实现疏忽。
传统业务的循环是业务驱动的:
python
# 业务循环:次数由业务数据决定,天然收敛
while has_more_orders(orders):
    process(order)
    orders = fetch_next_batch(orders)   # ← 数据没了就停
Agent 场景的循环是自我驱动的:
python
# Agent 循环:次数由 LLM 决定,可能永不收敛
while not llm_says_done():
    investigate()
# LLM 可能一直觉得"还需要再查一轮"差别在于:业务循环的终止条件来自外部数据,Agent 循环的终止条件来自一个概率模型。 这意味着引擎必须提供机制,把终止条件从"模型自己觉得"改成"代码说了算"。
一个好的编排引擎,循环控制至少要提供五个约束:
| 约束 | 为什么需要 | 缺了会怎样 |
|---|---|---|
| 最大轮次上限 | 硬保险 | 无限循环 |
| 墙钟总预算 | 单节点卡死时兜底 | 单次超长运行 |
| Token 预算 | 成本失控的唯一硬闸门 | 账单爆炸 |
| 无进展检测 | 循环可能在原地打转 | 烧钱但无产出 |
| 退化策略 | 到上限后输出什么 | 硬失败或硬凑一个假结果 |
这不是"可选的高级功能",而是循环控制的基础设施。 引擎不提供这五项,任何用引擎跑循环的人都会重踩第 24、25 篇的坑。
1.4 什么时候不该自己造引擎
先泼一盆冷水。自研编排引擎的成本比大多数人预期的高得多,主要不在代码量,而在这些隐性成本:
| 隐性成本 | 说明 |
|---|---|
| 可观测性 | 一次运行经过多少节点、每步耗时多少、Token 花在哪、失败在哪------这些都要从零埋 |
| 持久化与恢复 | 进程重启后从断点继续,而不是从头再烧一遍钱 |
| 并发正确性 | 并行分支的状态合并、共享状态的竞态 |
| 版本演进 | 流程改了以后,历史运行记录怎么解释?旧断点还能用吗? |
| 调试能力 | 出错时能否看到"当时走了哪条分支、为什么" |
我的判断标准很直接:
| 情况 | 建议 |
|---|---|
| 学习原理、做原型、离线批处理 | 自研(本文就是) |
| 受限环境(无外网、不能装依赖) | 自研 |
| 流程稳定且简单(≤3 个节点、线性为主) | 直接写代码,引入引擎反而是负担 |
| 生产环境、流程会持续演进 | 用 LangGraph |
| 需要强持久化、跨进程、长流程 | 用 Temporal(第 33 篇会专门讲) |
本篇的价值不是让你造一个替代 LangGraph 的东西,而是让你理解 LangGraph 为什么长成那个样子。 看懂了引擎的设计约束,再去用框架就是"知道自己在做什么",而不是"照抄一段示例代码"。
二、编排引擎核心概念:专门章节
2.1 图模型(Graph Model)------四个要素
编排引擎的第一件事是把控制流表达成数据结构。一个最小可用的图模型只需要四个要素:
python
# graph_model.py ------ 图模型的基础类型
from __future__ import annotations
from dataclasses import dataclass, field
from enum import Enum
from typing import Any, Callable, Awaitable


class NodeKind(str, Enum):
    """节点类型。不同类型的节点有不同的执行语义。"""
    STEP = "step"              # 普通步骤:执行一次,产出状态增量
    ROUTER = "router"          # 路由节点:只产出"下一步去哪",不产业务数据
    JOIN = "join"              # 汇聚节点:等待多个上游分支完成
    PARALLEL = "parallel"      # 并行分支起点:内部扇出到多个子节点
    END = "end"                # 终止节点


@dataclass(frozen=True)
class Node:
    """图节点。frozen=True 保证定义后不可变------避免运行中被意外修改。"""
    node_id: str
    kind: NodeKind
    handler: Callable[[dict], Awaitable[dict]] | None = None
    # 该节点负责写入的状态字段,用于汇聚时的冲突检测
    writes: tuple[str, ...] = ()
    # 节点级超时(秒)。None 表示用引擎默认值
    timeout_s: float | None = None
    # 节点级重试次数(仅用于技术失败,如网络/限流)
    max_retries: int = 0
    metadata: dict[str, Any] = field(default_factory=dict)


class EdgeKind(str, Enum):
    """边类型------本文的核心区分点。"""
    SEQUENTIAL = "sequential"  # 顺序边:A 完成后进入 B
    CONDITIONAL = "conditional"  # 条件边:由路由决策决定进入哪个分支
    BACK = "back"              # 反向边:构成循环


@dataclass(frozen=True)
class Edge:
    source: str
    target: str
    kind: EdgeKind = EdgeKind.SEQUENTIAL
    # 条件边的分支名。仅在 CONDITIONAL 类型下有意义
    label: str | None = None
    # 反向边的最大通过次数。None 表示引擎级默认值
max_traversals: int | None = None代码说明:
Node.writes字段是本设计的关键 。它声明"这个节点会写哪些状态字段",让引擎能在编译期检测到两个并行分支写同一字段的冲突。这类冲突在运行时才暴露的话,排查成本极高。Node用frozen=True。图定义后不允许修改------一个运行中的图如果能被改,边就失去了意义。EdgeKind三分法(顺序/条件/反向)是本文的骨架。第 2.2、2.3 节分别展开,最容易搞混的是"条件边"和"反向边"的区别。
2.2 三种边的语义区分
这是引擎设计里最容易含糊、也最容易出 bug 的地方。三种边回答的是三个不同的问题:
| 边类型 | 回答的问题 | 何时确定 | 例子 |
|---|---|---|---|
| 顺序边 | A 完成后做什么? | 编译期(静态) | 采集 → 分析 → 报告 |
| 条件边 | 根据结果,下一步去哪? | 运行期(动态) | 校验通过 → 报告;不通过 → 打回分析 |
| 反向边 | 什么时候回到之前的节点? | 运行期(动态) | 校验不通过 → 回到分析(构成循环) |
三者的关键差异在**"谁决定"和"能否构成循环"**:
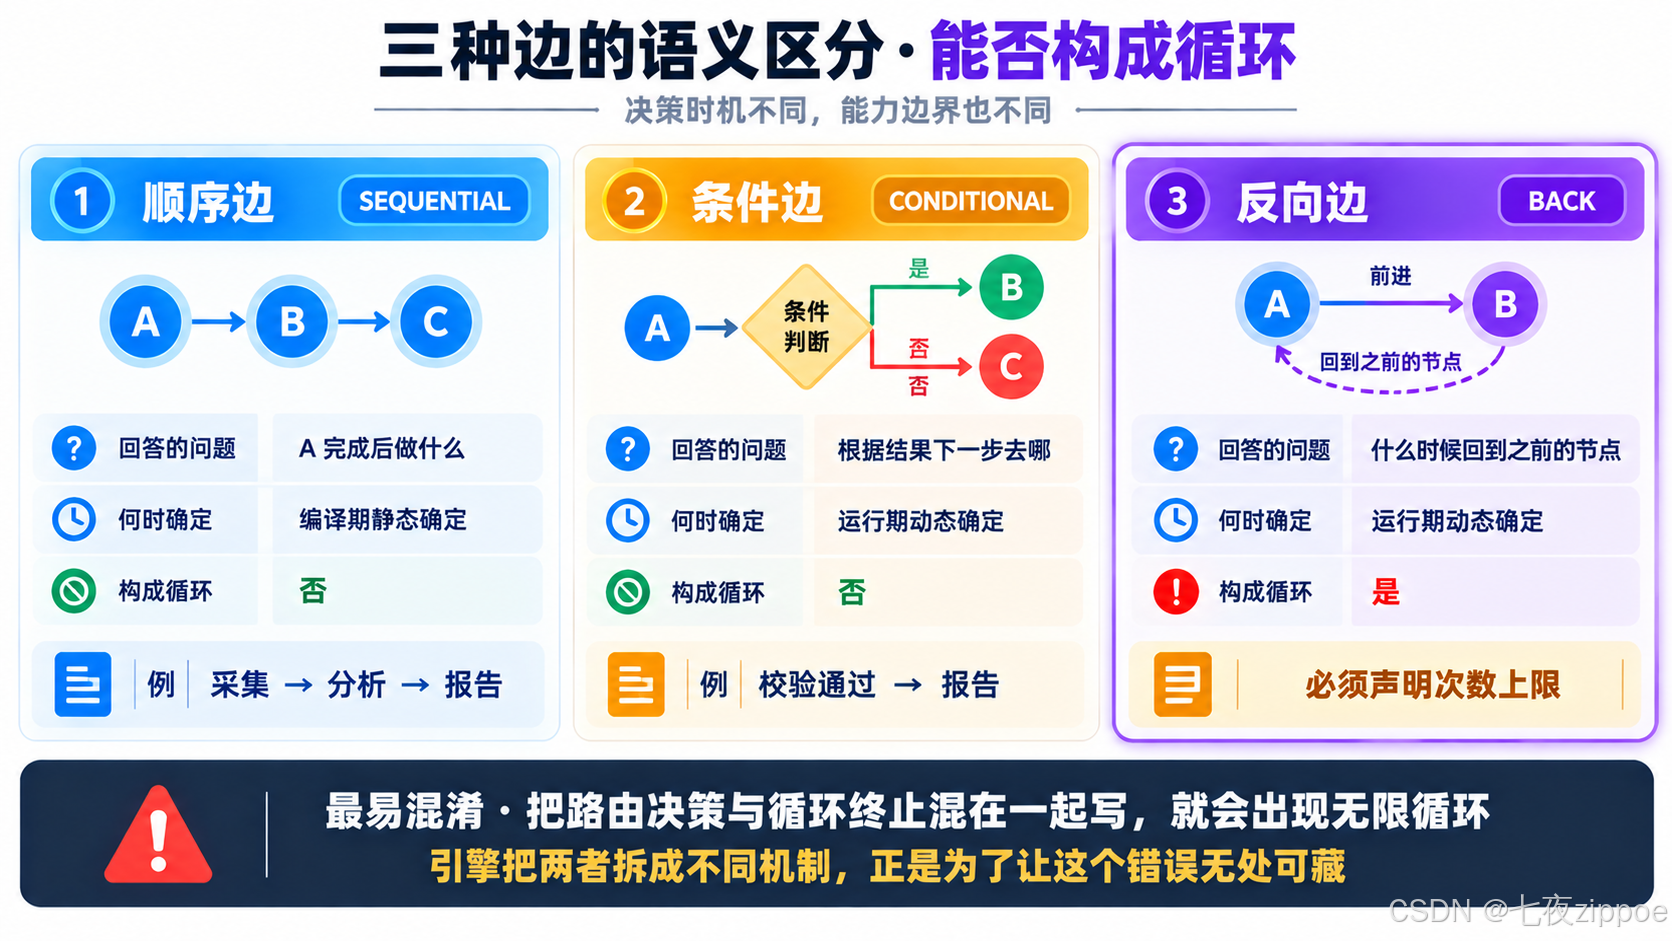
图1:三种边的语义区分------顺序边、条件边与反向边在决策时机与循环能力上的差异
- 顺序边是静态的,编译时就知道,形成 DAG 的主体。
- 条件边是动态的 ,但不构成循环------它只决定"下一个去哪个已存在的分支"。
- 反向边是动态的,且必然构成循环------它指回之前执行过的节点。
⚠️ 一个常见的概念混淆 :第 24 篇的 Supervisor 用一个 route 函数同时实现了"选下一个专家"和"决定是否继续"。在引擎层面这是两件事:前者是条件边 ,后者是反向边的通过条件 。混在一起写,就出现了第 24 篇那个 47 轮死循环。 引擎必须把它们分开------循环次数由引擎的计数器控制,不由路由逻辑决定。
#mermaid-svg-34ZRHC4OlOmp3K2c{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-34ZRHC4OlOmp3K2c .error-icon{fill:#552222;}#mermaid-svg-34ZRHC4OlOmp3K2c .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-34ZRHC4OlOmp3K2c .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-34ZRHC4OlOmp3K2c .marker{fill:#333333;stroke:#333333;}#mermaid-svg-34ZRHC4OlOmp3K2c .marker.cross{stroke:#333333;}#mermaid-svg-34ZRHC4OlOmp3K2c svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-34ZRHC4OlOmp3K2c p{margin:0;}#mermaid-svg-34ZRHC4OlOmp3K2c .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster-label text{fill:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster-label span{color:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster-label span p{background-color:transparent;}#mermaid-svg-34ZRHC4OlOmp3K2c .label text,#mermaid-svg-34ZRHC4OlOmp3K2c span{fill:#333;color:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c .node rect,#mermaid-svg-34ZRHC4OlOmp3K2c .node circle,#mermaid-svg-34ZRHC4OlOmp3K2c .node ellipse,#mermaid-svg-34ZRHC4OlOmp3K2c .node polygon,#mermaid-svg-34ZRHC4OlOmp3K2c .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-34ZRHC4OlOmp3K2c .rough-node .label text,#mermaid-svg-34ZRHC4OlOmp3K2c .node .label text,#mermaid-svg-34ZRHC4OlOmp3K2c .image-shape .label,#mermaid-svg-34ZRHC4OlOmp3K2c .icon-shape .label{text-anchor:middle;}#mermaid-svg-34ZRHC4OlOmp3K2c .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-34ZRHC4OlOmp3K2c .rough-node .label,#mermaid-svg-34ZRHC4OlOmp3K2c .node .label,#mermaid-svg-34ZRHC4OlOmp3K2c .image-shape .label,#mermaid-svg-34ZRHC4OlOmp3K2c .icon-shape .label{text-align:center;}#mermaid-svg-34ZRHC4OlOmp3K2c .node.clickable{cursor:pointer;}#mermaid-svg-34ZRHC4OlOmp3K2c .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-34ZRHC4OlOmp3K2c .arrowheadPath{fill:#333333;}#mermaid-svg-34ZRHC4OlOmp3K2c .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-34ZRHC4OlOmp3K2c .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-34ZRHC4OlOmp3K2c .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-34ZRHC4OlOmp3K2c .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-34ZRHC4OlOmp3K2c .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-34ZRHC4OlOmp3K2c .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster text{fill:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c .cluster span{color:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-34ZRHC4OlOmp3K2c .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-34ZRHC4OlOmp3K2c rect.text{fill:none;stroke-width:0;}#mermaid-svg-34ZRHC4OlOmp3K2c .icon-shape,#mermaid-svg-34ZRHC4OlOmp3K2c .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-34ZRHC4OlOmp3K2c .icon-shape p,#mermaid-svg-34ZRHC4OlOmp3K2c .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-34ZRHC4OlOmp3K2c .icon-shape .label rect,#mermaid-svg-34ZRHC4OlOmp3K2c .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-34ZRHC4OlOmp3K2c .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-34ZRHC4OlOmp3K2c .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-34ZRHC4OlOmp3K2c :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 合格
不合格
反向边
返回重做
最多重做 3 次
开始
采集
STEP
分析
STEP
校验
ROUTER
报告
STEP
质量反馈
STEP
结束
END
图里 Back → Analyze 就是反向边(深蓝),Validate → Report/Back 是条件边(橙)。注意 Analyze → Validate 的那条虚线标注"最多重做 3 次" ------这个约束属于边,而不是路由函数的返回值。引擎在遍历这条反向边时会检查计数,超限就走退化路径。
2.3 编译期校验------引擎的第一道防线
引擎和"写一堆 if/else"的本质区别在于:它能在运行之前告诉你图写错了。
一个生产级引擎的编译器至少要做六项校验:
#mermaid-svg-1sBduE7eeiLh2nuc{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-1sBduE7eeiLh2nuc .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-1sBduE7eeiLh2nuc .error-icon{fill:#552222;}#mermaid-svg-1sBduE7eeiLh2nuc .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-1sBduE7eeiLh2nuc .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-1sBduE7eeiLh2nuc .marker{fill:#333333;stroke:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc .marker.cross{stroke:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-1sBduE7eeiLh2nuc p{margin:0;}#mermaid-svg-1sBduE7eeiLh2nuc defs #statediagram-barbEnd{fill:#333333;stroke:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc g.stateGroup text{fill:#9370DB;stroke:none;font-size:10px;}#mermaid-svg-1sBduE7eeiLh2nuc g.stateGroup text{fill:#333;stroke:none;font-size:10px;}#mermaid-svg-1sBduE7eeiLh2nuc g.stateGroup .state-title{font-weight:bolder;fill:#131300;}#mermaid-svg-1sBduE7eeiLh2nuc g.stateGroup rect{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-1sBduE7eeiLh2nuc g.stateGroup line{stroke:#333333;stroke-width:1;}#mermaid-svg-1sBduE7eeiLh2nuc .transition{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-1sBduE7eeiLh2nuc .stateGroup .composit{fill:white;border-bottom:1px;}#mermaid-svg-1sBduE7eeiLh2nuc .stateGroup .alt-composit{fill:#e0e0e0;border-bottom:1px;}#mermaid-svg-1sBduE7eeiLh2nuc .state-note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-1sBduE7eeiLh2nuc .state-note text{fill:black;stroke:none;font-size:10px;}#mermaid-svg-1sBduE7eeiLh2nuc .stateLabel .box{stroke:none;stroke-width:0;fill:#ECECFF;opacity:0.5;}#mermaid-svg-1sBduE7eeiLh2nuc .edgeLabel .label rect{fill:#ECECFF;opacity:0.5;}#mermaid-svg-1sBduE7eeiLh2nuc .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-1sBduE7eeiLh2nuc .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-1sBduE7eeiLh2nuc .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-1sBduE7eeiLh2nuc .edgeLabel .label text{fill:#333;}#mermaid-svg-1sBduE7eeiLh2nuc .label div .edgeLabel{color:#333;}#mermaid-svg-1sBduE7eeiLh2nuc .stateLabel text{fill:#131300;font-size:10px;font-weight:bold;}#mermaid-svg-1sBduE7eeiLh2nuc .node circle.state-start{fill:#333333;stroke:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc .node .fork-join{fill:#333333;stroke:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc .node circle.state-end{fill:#9370DB;stroke:white;stroke-width:1.5;}#mermaid-svg-1sBduE7eeiLh2nuc .end-state-inner{fill:white;stroke-width:1.5;}#mermaid-svg-1sBduE7eeiLh2nuc .node rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-1sBduE7eeiLh2nuc .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-1sBduE7eeiLh2nuc #statediagram-barbEnd{fill:#333333;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-cluster rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-1sBduE7eeiLh2nuc .cluster-label,#mermaid-svg-1sBduE7eeiLh2nuc .nodeLabel{color:#131300;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-cluster rect.outer{rx:5px;ry:5px;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-state .divider{stroke:#9370DB;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-state .title-state{rx:5px;ry:5px;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-cluster.statediagram-cluster .inner{fill:white;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-cluster.statediagram-cluster-alt .inner{fill:#f0f0f0;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-cluster .inner{rx:0;ry:0;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-state rect.basic{rx:5px;ry:5px;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-state rect.divider{stroke-dasharray:10,10;fill:#f0f0f0;}#mermaid-svg-1sBduE7eeiLh2nuc .note-edge{stroke-dasharray:5;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-note text{fill:black;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram-note .nodeLabel{color:black;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagram .edgeLabel{color:red;}#mermaid-svg-1sBduE7eeiLh2nuc #dependencyStart,#mermaid-svg-1sBduE7eeiLh2nuc #dependencyEnd{fill:#333333;stroke:#333333;stroke-width:1;}#mermaid-svg-1sBduE7eeiLh2nuc .statediagramTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-1sBduE7eeiLh2nuc :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 开发者构建图
调用 compile()
发现 error 级问题
仅有 warning 级问题
全部校验通过
修复后重新构建
确认警告可接受
返回 CompiledGraph
DRAFT
VALIDATING
REJECTED
WARNED
VALIDATED
error 级问题阻断编译
例:反向边未声明上限
并行分支写同一字段
warning 级问题放行但记日志
例:存在不可达节点
可能是有意预留的分支
| 校验项 | 抓什么问题 | 不做的后果 |
|---|---|---|
| 节点可达性 | 有孤立节点(没有任何边能到达它) | 该节点永远不执行,配置却存在 |
| 终止节点存在 | 图里没有任何 END 节点 | 执行到某处后"卡住" |
| 反向边声明 | 存在反向边但未声明 max_traversals |
死循环 |
| 状态写入冲突 | 两个并行分支写同一字段 | 运行时的隐蔽数据竞争 |
| 路由标签完备 | 路由函数可能返回未定义的分支名 | 运行到一半 KeyError |
| 路由标签可达 | 路由分支指向不存在的节点 | 同上 |
python
# compiler.py ------ 图的编译期校验
from __future__ import annotations
from collections import defaultdict, deque
from dataclasses import dataclass

from graph_model import Edge, EdgeKind, Graph, Node, NodeKind


@dataclass
class ValidationIssue:
    level: str      # "error" 阻断编译 / "warning" 可编译但需确认
    code: str
    message: str


class GraphCompiler:
    """图编译器:把开发者写的图变成可执行的图。

    设计原则:**能在编译期发现的问题,绝不留到运行期。**
    """

    def __init__(self, graph: Graph, default_max_traversals: int = 3):
        self.g = graph
        self.default_max_traversals = default_max_traversals
        self.issues: list[ValidationIssue] = []

    def validate(self) -> list[ValidationIssue]:
        self.issues = []
        self._check_node_unique()
        self._check_end_exists()
        self._check_reachability()
        self._check_back_edges_declared()
        self._check_parallel_write_conflicts()
        self._check_conditional_targets_exist()
        return self.issues

    def _err(self, code: str, msg: str) -> None:
        self.issues.append(ValidationIssue("error", code, msg))

    def _warn(self, code: str, msg: str) -> None:
        self.issues.append(ValidationIssue("warning", code, msg))

    def _check_node_unique(self) -> None:
        seen = set()
        for n in self.g.nodes.values():
            if n.node_id in seen:
                self._err("duplicate_node", f"节点 id 重复:{n.node_id}")
            seen.add(n.node_id)

    def _check_end_exists(self) -> None:
        if not any(n.kind is NodeKind.END for n in self.g.nodes.values()):
            self._err("no_end_node", "图中没有 END 节点,执行将无法终止")

    def _check_reachability(self) -> None:
        """从所有"入口节点"(无入边的节点)出发做 BFS,找出不可达节点。"""
        indegree: dict[str, int] = defaultdict(int)
        adj: dict[str, list[str]] = defaultdict(list)
        for e in self.g.edges:
            adj[e.source].append(e.target)
            indegree[e.target] += 1

        entry = [nid for nid in self.g.nodes if indegree[nid] == 0]
        if not entry:
            self._err("no_entry_node", "图中没有入口节点(所有节点都有入边),可能存在环")
            return

        visited: set[str] = set()
        q = deque(entry)
        while q:
            cur = q.popleft()
            if cur in visited:
                continue
            visited.add(cur)
            q.extend(adj[cur])

        for nid in self.g.nodes:
            if nid not in visited:
                self._warn("unreachable_node",
                           f"节点 {nid} 不可达,配置了但永远不会执行")

    def _check_back_edges_declared(self) -> None:
        """反向边必须声明次数上限------这是防死循环的关键校验。

        注意:不声明不报错,但会被赋予默认值并在编译日志里警告。
        这里设为 error 是更严格的选择,适合生产环境。
        """
        for e in self.g.edges:
            if e.kind is EdgeKind.BACK:
                if e.max_traversals is None:
                    self._err("back_edge_no_limit",
                              f"反向边 {e.source} → {e.target} 未声明 max_traversals,"
                              f"存在死循环风险")

    def _check_parallel_write_conflicts(self) -> None:
        """检测并行分支的状态写入冲突。

        判定方法:若两个节点都能从同一个 PARALLEL 起点到达,
        且它们写入相同的状态字段,则存在冲突。
        """
        parallel_roots = [nid for nid, n in self.g.nodes.items()
                          if n.kind is NodeKind.PARALLEL]
        for root in parallel_roots:
            reachable = self._reachable_from(root)
            writers: dict[str, list[str]] = defaultdict(list)
            for nid in reachable:
                node = self.g.nodes[nid]
                if node.kind in (NodeKind.PARALLEL, NodeKind.END):
                    continue
                for field in node.writes:
                    writers[field].append(nid)
            for field, nodes in writers.items():
                if len(nodes) > 1:
                    self._err("parallel_write_conflict",
                              f"并行分支 {root} 下的 {nodes} 都写入状态字段 "
                              f"'{field}',需通过 join 节点或 reducer 解决")

    def _check_conditional_targets_exist(self) -> None:
        """条件边的所有分支标签都必须指向已存在的节点。

        路由函数返回一个不存在的分支名,是 Agent 编排里最高频的运行时错误。
        编译期无法完全穷举(因为路由是动态的),但可以校验
        "图里声明的分支标签"是否都有效------剩下的交给运行时兜底。
        """
        node_ids = set(self.g.nodes)
        for e in self.g.edges:
            if e.kind is EdgeKind.CONDITIONAL:
                if e.label is None:
                    self._err("conditional_no_label",
                              f"条件边 {e.source} → {e.target} 缺少分支标签")
                elif e.target not in node_ids:
                    self._err("conditional_bad_target",
                              f"条件边指向不存在的节点:{e.target}")

    def _reachable_from(self, start: str) -> set[str]:
        adj: dict[str, list[str]] = defaultdict(list)
        for e in self.g.edges:
            adj[e.source].append(e.target)
        seen, q = {start}, deque([start])
        while q:
            for nxt in adj[q.popleft()]:
                if nxt not in seen:
                    seen.add(nxt)
                    q.append(nxt)
return seen代码说明:
_check_reachability用 BFS 从入口节点出发 ,找出不可达节点。这类问题往往来自"复制粘贴时漏了连线",运行时表现为"某个节点永远没执行",极难定位。它设为 warning 而非 error,因为孤立节点有时是有意预留的(比如临时禁用的分支)。_check_back_edges_declared把"反向边未声明上限"定为 error ,而非 warning。这是本设计最严格的一处,理由是第 24 篇的教训:没有上限的反向边就是死循环,而死循环在生产上的代价(烧钱、占满并发)远大于编译失败。_check_parallel_write_conflicts通过 PARALLEL 起点做可达性分析。这是个启发式判断------它假设"同一 PARALLEL 起点下可达的节点是互斥分支"。这个假设在复杂图里可能不成立,但能覆盖绝大多数实际场景,而误报的代价(开发者确认一下)远小于漏报。_check_conditional_targets_exist只能做部分校验 。因为路由函数是动态的,编译期无法知道它会返回哪些分支。真正彻底的校验要靠第 4.3 节的类型安全路由设计------让编译器在运行时也能兜住。
2.4 状态合并语义------reducer 为什么会存在
第 23 篇讲过:Annotated[list, operator.add] 让 LangGraph 能并发聚合多个分支的结果。引擎层面这件事需要显式设计。
问题的根源是:状态是全局可变的,多个并行分支同时写它,谁赢?
| 合并策略 | 行为 | 适用 |
|---|---|---|
| 覆盖(override) | 后写的覆盖先写的 | 单一写入者场景 |
| 累加(append/reduce) | 用 reducer 函数合并 | 多个分支各贡献一部分 |
| 拒绝(error) | 检测到多写就报错 | 严格场景,宁可失败 |
| 仲裁(arbitrate) | 按优先级选一个 | 有明确主次的场景 |
引擎必须在图定义阶段就确定每个字段的合并策略:
python
# state_spec.py ------ 状态字段的合并策略声明
from __future__ import annotations
import operator
from dataclasses import dataclass
from typing import Any, Callable, TypeVar

T = TypeVar("T")


@dataclass(frozen=True)
class FieldSpec:
    """状态字段规约。

    engine 必须知道每个字段"怎么合并",否则并行分支同时写时会静默丢数据。
    """
    name: str
    merge: Callable[[Any, Any], Any]   # 合并函数(覆盖则用右值覆盖左值)
    default: Any = None
    # 允许并行的多个分支同时写这个字段
    concurrent_writes_ok: bool = False

    @staticmethod
    def override(name: str, default: Any = None) -> "FieldSpec":
        """覆盖语义:后写覆盖先写。仅允许单一写入者。"""
        return FieldSpec(name, lambda old, new: new, default,
                         concurrent_writes_ok=False)

    @staticmethod
    def append_list(name: str) -> "FieldSpec":
        """累加语义:多个分支的结果追加到同一列表。"""
        return FieldSpec(name,
                         lambda old, new: (old or []) + (new or []),
                         [],
                         concurrent_writes_ok=True)

    @staticmethod
    def reduce_by_key(name: str, key: str) -> "FieldSpec":
        """按键归并:多个分支按 key 合并,适合"各自更新不同实体"的场景。"""
        def merge(old: dict, new: dict) -> dict:
            merged = dict(old or {})
            for k, v in (new or {}).items():
                merged[k] = v
            return merged
        return FieldSpec(name, merge, {}, concurrent_writes_ok=True)


class StateSchema:
    """状态 schema:引擎据此知道初始值、合并规则与并发写入约束。"""

    def __init__(self, specs: list[FieldSpec]):
        self.specs = {s.name: s for s in specs}
        # 编译期检查:允许并发写的字段,必须用可合并的 merge 函数
        for s in specs:
            if s.concurrent_writes_ok and s.merge is None:
                raise ValueError(f"字段 {s.name} 声明支持并发写但未提供合并函数")

    def initial_state(self) -> dict:
        return {name: (spec.default() if callable(spec.default) and
                       not isinstance(spec.default, (str, int, float, list, dict))
                       else spec.default)
                for name, spec in self.specs.items()}

    def merge_all(self, old: dict, increments: list[dict]) -> dict:
        """把一个节点的多个状态增量合并进全局状态。

        注意顺序:这里同时实现了并发写入检测。
        """
        result = dict(old)
        for inc in increments:
            for field, value in inc.items():
                spec = self.specs.get(field)
                if spec is None:
                    raise KeyError(f"状态字段 '{field}' 未在 schema 中声明")
                result[field] = spec.merge(result.get(field), value)
return result代码说明:
FieldSpec把"怎么合并"编码进类型 。这与第 23 篇的Annotated[list, operator.add]是同一思想的引擎级实现------区别在于这里是显式声明而非装饰器约定,可读性和可校验性都更好。override的concurrent_writes_ok=False是给编译器的信号 。第 2.3 节的_check_parallel_write_conflicts正是依据这个字段做判断。reduce_by_key是黑板模式的适配器 。第 25 篇里多个知识源更新同一批实体的状态,正是"按键归并"而非"追加"。这个合并策略直接来自黑板场景的实际需求。initial_state()里对 callable default 做了特殊处理 ,因为FieldSpec.append_list的 default 是[](可变对象),直接返回会让所有节点共享同一个列表实例------这是 Python 里最经典的坑之一。
三、环境准备
3.1 环境与依赖
| 依赖 | 版本要求 | 用途 | 备注 |
|---|---|---|---|
| Python | 3.11+ | 运行框架 | 引擎本体零第三方依赖 |
| pydantic | 2.x | 状态字段校验(可选) | 不强依赖,可用 dataclass |
| langgraph | 0.2+ | 第六章生产方案对照 | 仅对照,不用于自研实现 |
bash
python -m venv .venv
source .venv/bin/activate            # Windows: .venv\Scripts\activate

# 引擎本体不需要任何第三方依赖
# 只装一个用于对比的框架
pip install "langgraph>=0.2" "langchain-core>=0.3"
💡 本篇的引擎实现是零依赖的纯 Python 。这不是炫技------它让你看清引擎的本质就是图 + 状态 + 执行循环三样东西,而不是某个框架的黑盒。等看完再用 LangGraph,你才知道框架帮你做了什么。
3.2 本文案例:内容合规审查流水线
任务定义:给定一份内容稿件(文章/广告文案),输出:
- 多维度并行审查:事实性、敏感词、合规性、法律风险四个维度并行检查;
- 条件路由:按风险分数决定走"快速通过"、"人工复核"还是"打回重写";
- 循环控制:打回后自动重写并重新审查,最多 3 轮;
- 完整审计:每次路由决策与循环次数都要可追溯。
选这个案例的理由:它同时用到了三种边。并行审查用扇出(动态并行)、风险路由用条件边、自动重写用反向边------三种边在同一张图里共存,是检验引擎设计是否完备的绝佳用例。
四、核心实战:从零实现编排引擎
4.1 第一步:图定义与构建 API
引擎要给使用者一个顺手的图构建 API。好的 API 应该让"加一个节点"和"加一条边"都是一行代码。
python
# engine.py ------ 引擎核心:图、构建器、编译
from __future__ import annotations
import asyncio
import logging
from collections import defaultdict, deque
from dataclasses import dataclass, field
from typing import Any, Awaitable, Callable

from compiler import GraphCompiler, ValidationIssue
from graph_model import Edge, EdgeKind, Graph, Node, NodeKind
from state_spec import StateSchema

logger = logging.getLogger(__name__)

Handler = Callable[[dict], Awaitable[dict]]


@dataclass
class Graph:
    nodes: dict[str, Node] = field(default_factory=dict)
    edges: list[Edge] = field(default_factory=list)

    def out_edges(self, node_id: str) -> list[Edge]:
        return [e for e in self.edges if e.source == node_id]

    def back_edges(self, node_id: str) -> list[Edge]:
        return [e for e in self.out_edges(node_id) if e.kind is EdgeKind.BACK]


class Builder:
    """图构建器------fluent API。

    设计取舍:不做"智能推断",所有边必须显式声明。
    隐式推断(比如"没连边就顺序串起来")会让图变得难以读懂,
    而编排图本身就是给人看的。
    """

    def __init__(self, schema: StateSchema, default_timeout_s: float = 60.0,
                 default_max_traversals: int = 3):
        self.graph = Graph()
        self.schema = schema
        self.default_timeout_s = default_timeout_s
        self.default_max_traversals = default_max_traversals

    def node(self, node_id: str, kind: NodeKind = NodeKind.STEP, *,
             handler: Handler | None = None, writes: tuple[str, ...] = (),
             timeout_s: float | None = None, max_retries: int = 0) -> "Builder":
        self.graph.nodes[node_id] = Node(
            node_id=node_id, kind=kind, handler=handler, writes=writes,
            timeout_s=timeout_s or self.default_timeout_s,
            max_retries=max_retries)
        return self

    def step(self, node_id: str, handler: Handler, *, writes: tuple[str, ...],
             **kw) -> "Builder":
        """注册一个普通步骤节点。writes 必须声明------供冲突检测使用。"""
        return self.node(node_id, NodeKind.STEP, handler=handler, writes=writes, **kw)

    def router(self, node_id: str, handler: Handler) -> "Builder":
        """注册路由节点。路由节点的输出约定见第 4.3 节。"""
        return self.node(node_id, NodeKind.ROUTER, handler=handler, writes=())

    def parallel(self, node_id: str) -> "Builder":
        return self.node(node_id, NodeKind.PARALLEL)

    def end(self, node_id: str = "__end__") -> "Builder":
        return self.node(node_id, NodeKind.END)

    def then(self, src: str, dst: str) -> "Builder":
        """顺序边。"""
        self.graph.edges.append(Edge(src, dst, EdgeKind.SEQUENTIAL))
        return self

    def branch(self, src: str, mapping: dict[str, str]) -> "Builder":
        """条件边。mapping = {分支名: 目标节点}。

        必须显式列出全部分支------图上能看全有哪些可能走向,
        而不是"路由函数返回什么就走什么"。
        """
        for label, dst in mapping.items():
            self.graph.edges.append(
                Edge(src, dst, EdgeKind.CONDITIONAL, label=label))
        return self

    def back_to(self, src: str, dst: str, max_traversals: int) -> "Builder":
        """反向边------构成循环。max_traversals 必填,无默认值。

        不给默认值是刻意的:让开发者思考这个循环能跑几次。
        第 24 篇的 47 轮死循环,根源就是"循环次数没人管"。
        """
        if max_traversals is None:
            raise ValueError("反向边必须显式声明 max_traversals")
        self.graph.edges.append(
            Edge(src, dst, EdgeKind.BACK, max_traversals=max_traversals))
        return self

    def compile(self) -> "CompiledGraph":
        issues = GraphCompiler(
            self.graph,
            default_max_traversals=self.default_max_traversals).validate()
        errors = [i for i in issues if i.level == "error"]
        if errors:
            raise GraphCompileError(errors)
        for i in issues:
            logger.warning("[图校验 %s] %s: %s", i.level, i.code, i.message)
        return CompiledGraph(self.graph, self.schema,
                             default_max_traversals=self.default_max_traversals)


class GraphCompileError(Exception):
    def __init__(self, issues: list[ValidationIssue]):
        self.issues = issues
        detail = "\n".join(f"  [{i.code}] {i.message}" for i in issues)
super().__init__(f"图编译失败:\n{detail}")代码说明:
branch()必须显式列出全部分支。这是本设计与"路由函数返回什么就跳什么"最重要的区别:图上能直接看全所有可能走向,既方便调试,也让第 2.3 节的编译期校验成为可能。back_to()不接受max_traversals=None。不是运行时报错,而是调用时就抛异常。让"我不打算限制循环次数"这个决定在写代码时就必须被明确表达。step()强制要求writes声明 。没有writes就没法做并行冲突检测。这个"强制"带来一点啰嗦,但换来的是编译期就能发现"两个分支写同一个字段"。compile()把 error 和 warning 分开处理:error 阻断编译,warning 只记日志。这个分级让"图有问题"不至于完全无法工作,同时保证严重问题不会被忽略。
4.2 第二步:执行器------带预算的执行循环
执行器是引擎的心脏。它要处理节点执行、超时、重试、条件路由、循环控制、状态合并。
一次执行的完整控制流------这张图是理解执行器的关键:
节点 handler LoopGuard Executor 调用方 节点 handler LoopGuard Executor 调用方 #mermaid-svg-2vep8VnQJaUQL8zI{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-2vep8VnQJaUQL8zI .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-2vep8VnQJaUQL8zI .error-icon{fill:#552222;}#mermaid-svg-2vep8VnQJaUQL8zI .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-2vep8VnQJaUQL8zI .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-2vep8VnQJaUQL8zI .marker{fill:#333333;stroke:#333333;}#mermaid-svg-2vep8VnQJaUQL8zI .marker.cross{stroke:#333333;}#mermaid-svg-2vep8VnQJaUQL8zI svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-2vep8VnQJaUQL8zI p{margin:0;}#mermaid-svg-2vep8VnQJaUQL8zI .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-2vep8VnQJaUQL8zI text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-2vep8VnQJaUQL8zI .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-2vep8VnQJaUQL8zI .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-2vep8VnQJaUQL8zI .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-2vep8VnQJaUQL8zI .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-2vep8VnQJaUQL8zI #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-2vep8VnQJaUQL8zI .sequenceNumber{fill:white;}#mermaid-svg-2vep8VnQJaUQL8zI #sequencenumber{fill:#333;}#mermaid-svg-2vep8VnQJaUQL8zI #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-2vep8VnQJaUQL8zI .messageText{fill:#333;stroke:none;}#mermaid-svg-2vep8VnQJaUQL8zI .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-2vep8VnQJaUQL8zI .labelText,#mermaid-svg-2vep8VnQJaUQL8zI .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-2vep8VnQJaUQL8zI .loopText,#mermaid-svg-2vep8VnQJaUQL8zI .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-2vep8VnQJaUQL8zI .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-2vep8VnQJaUQL8zI .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-2vep8VnQJaUQL8zI .noteText,#mermaid-svg-2vep8VnQJaUQL8zI .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-2vep8VnQJaUQL8zI .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-2vep8VnQJaUQL8zI .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-2vep8VnQJaUQL8zI .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-2vep8VnQJaUQL8zI .actorPopupMenu{position:absolute;}#mermaid-svg-2vep8VnQJaUQL8zI .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-2vep8VnQJaUQL8zI .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-2vep8VnQJaUQL8zI .actor-man circle,#mermaid-svg-2vep8VnQJaUQL8zI line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-2vep8VnQJaUQL8zI :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} alt 反向边可通行- 走顺序边或条- 件边 alt 节点为 END 普通节点 alt 预算耗尽 预算充足 run(initial_state) 预算检查(墙钟/Token/步数) 降级输出 或 abort 取当前节点 正常完成 handler(state) 状态增量 或 路由结果 合并状态(按 FieldSpec 语义) 反向边是否可通行? ok / loop_limit / no_progress 计数 +1,跳回上游 推进到下一节点 回到循环起点再次预算检查
图中预算检查在每次回到循环起点时都执行 ,这是"永不超预算"的保证。而 LoopGuard 是独立于节点 handler 的组件------循环控制不应该由业务节点自己管。
python
# executor.py ------ 引擎执行器
from __future__ import annotations
import asyncio
import logging
import random
import time
from dataclasses import dataclass, field
from typing import Any

from engine import CompiledGraph
from graph_model import Edge, EdgeKind, Node, NodeKind

logger = logging.getLogger(__name__)


@dataclass
class ExecutionBudget:
    """执行预算------循环与长流程的安全带。

    注意与第 23 篇 MapReduce 的区别:那里的预算是"并发控制",
    这里的预算是"运行规模控制"。两者解决不同问题。
    """
    max_wall_clock_s: float = 300.0     # 墙钟总预算
    max_total_tokens: int = 200_000     # Token 总预算
    max_route_steps: int = 50           # 总步数(所有节点执行次数之和)
    # 达到预算后的行为:degrade(输出已知结论)或 abort(直接失败)
    on_exhausted: str = "degrade"


@dataclass
class LoopGuard:
    """循环守卫------反向边的计数与无进展检测。

    这是第 24、25 篇踩坑的集中解法:
    硬上限防无限循环,无进展检测防原地打转。
    """

    # 每条反向边的通过次数:edge_key -> count
    traversals: dict[str, int] = field(default_factory=dict)
    # 状态指纹历史,用于无进展检测:list[fingerprint]
    progress_history: list[int] = field(default_factory=list)

    def can_traverse(self, edge: Edge, edge_key: str,
                     state_fingerprint: int) -> tuple[bool, str]:
        limit = edge.max_traversals or 3
        used = self.traversals.get(edge_key, 0)
        if used >= limit:
            return False, f"loop_limit_reached ({used}/{limit})"

        # 无进展检测:最近 2 次指纹都没变 = 在原地打转
        if len(self.progress_history) >= 2:
            if self.progress_history[-1] == self.progress_history[-2] \
                    == state_fingerprint:
                return False, "no_progress_detected"

        self.traversals[edge_key] = used + 1
        self.progress_history.append(state_fingerprint)
        return True, "ok"


@dataclass
class ExecutionRecord:
    """执行轨迹------可观测性的基础。"""
    step: int
    node_id: str
    kind: str
    duration_ms: int
    route_taken: str | None = None
    tokens_used: int = 0
    error: str | None = None
    state_after: dict = field(default_factory=dict)


class Executor:
    """执行器:驱动图从入口跑到终点。"""

    def __init__(self, compiled: CompiledGraph, budget: ExecutionBudget | None = None):
        self.cg = compiled
        self.budget = budget or ExecutionBudget()
        self.guard = LoopGuard()
        self.records: list[ExecutionRecord] = []

    async def run(self, initial: dict, start_node: str | None = None) -> dict:
        """执行入口。返回最终状态。

        start_node 用于断点恢复:传入则从该节点继续,
        不传则从自动识别的入口节点开始。
        """
        state = self.cg.schema.initial_state()
        state.update(initial)

        started = time.perf_counter()
        # 断点恢复优先用指定节点;否则找入口
        current = start_node or self._find_entry_node()
        if start_node and start_node not in self.cg.graph.nodes:
            raise ValueError(f"断点节点 {start_node} 不存在于当前图中(图已变更?)")
        step = 0

        while True:
            # ---- 预算检查(每步之前)----
            elapsed = time.perf_counter() - started
            over_budget = (
                elapsed > self.budget.max_wall_clock_s
                or state.get("tokens_used", 0) > self.budget.max_total_tokens
                or step >= self.budget.max_route_steps
            )
            if over_budget:
                logger.warning("预算耗尽(%.0fs / %d tokens / %d steps),走退化路径",
                               elapsed, state.get("tokens_used", 0), step)
                if self.budget.on_exhausted == "abort":
                    raise ExecutionAborted(f"预算耗尽于第 {step} 步")
                state["termination_reason"] = "budget_exhausted"
                state["degraded"] = True
                break

            node = self.cg.graph.nodes.get(current)
            if node is None:
                state["termination_reason"] = f"unknown_node:{current}"
                break
            if node.kind is NodeKind.END:
                state["termination_reason"] = state.get("termination_reason", "completed")
                break

            step += 1
            outcome = await self._run_node(node, state, step)

            if outcome.get("_route") is not None:
                # 路由节点:读出路由结果,决定下一跳
                label = outcome["_route"]
                state.update({k: v for k, v in outcome.items() if not k.startswith("_")})
                nxt = self._resolve_branch(current, label)
                if nxt is None:
                    state["termination_reason"] = f"no_such_branch:{label}"
                    break
                current = nxt
                continue

            # 普通节点:合并状态增量,走顺序边或反向边
            increment = {k: v for k, v in outcome.items() if not k.startswith("_")}
            state = self.cg.schema.merge_all(state, [increment])

            nxt, why = self._pick_next_edge(current, state)
            if nxt is None:
                state["termination_reason"] = why or "no_next_edge"
                break
            current = nxt

        state["total_steps"] = step
        state["total_duration_ms"] = int((time.perf_counter() - started) * 1000)
        return state

    async def _run_node(self, node: Node, state: dict, step: int) -> dict:
        """执行单个节点,含超时与重试。"""
        t0 = time.perf_counter()
        last_err: str | None = None

        for attempt in range(1, node.max_retries + 2):
            try:
                async with asyncio.timeout(node.timeout_s or 60):
                    result = await node.handler(state)
                self.records.append(ExecutionRecord(
                    step=step, node_id=node.node_id, kind=node.kind.value,
                    duration_ms=int((time.perf_counter() - t0) * 1000),
                    route_taken=result.get("_route"),
                    tokens_used=result.get("_tokens", 0),
                    state_after=dict(result)))
                logger.info("[%d] %s 完成 (%dms)", step, node.node_id,
                            int((time.perf_counter() - t0) * 1000))
                return result
            except asyncio.CancelledError:
                raise
            except asyncio.TimeoutError:
                last_err = f"timeout after {node.timeout_s}s"
            except Exception as e:
                last_err = f"{type(e).__name__}: {e}"

            if attempt <= node.max_retries:
                delay = min(2 ** attempt, 8) * (0.7 + random.random() * 0.6)
                await asyncio.sleep(delay)

        self.records.append(ExecutionRecord(
            step=step, node_id=node.node_id, kind=node.kind.value,
            duration_ms=int((time.perf_counter() - t0) * 1000),
            error=last_err))
        logger.error("[%d] %s 失败:%s", step, node.node_id, last_err)
        # 节点失败:按第 2.4 节的"拒绝"语义,把错误作为状态增量传出
        return {"_node_error": last_err, "node_failed": node.node_id}

    def _pick_next_edge(self, node_id: str, state: dict) -> tuple[str | None, str]:
        """从当前节点选择下一条边。

        优先级:反向边(循环)优先于顺序边。
        因为反向边是"主动跳转",顺序边是"自然延续"。
        """
        fp = self._fingerprint(state)
        for e in self.cg.graph.back_edges(node_id):
            edge_key = f"{e.source}->{e.target}"
            ok, why = self.guard.can_traverse(e, edge_key, fp)
            if ok:
                logger.info("沿反向边 %s 回到 %s(%s)", e.source, e.target, why)
                return e.target, None
            logger.info("反向边 %s 被拦截:%s", edge_key, why)
            state["termination_reason"] = f"loop_stopped:{why}"

        for e in self.cg.graph.out_edges(node_id):
            if e.kind is EdgeKind.SEQUENTIAL:
                return e.target, None
        return None, state.get("termination_reason") or "no_outgoing_edge"

    def _resolve_branch(self, node_id: str, label: str) -> str | None:
        for e in self.cg.graph.out_edges(node_id):
            if e.kind is EdgeKind.CONDITIONAL and e.label == label:
                return e.target
        return None

    @staticmethod
    def _fingerprint(state: dict) -> int:
        """状态指纹------用于无进展检测。

        只对业务字段计算,不含 tokens_used 等计数器,
        否则计数器每次变化会让指纹永远不同。
        """
        business = {k: v for k, v in state.items()
                    if not k.startswith("_") and k != "tokens_used"}
        return hash(repr(sorted(business.items(), key=lambda kv: kv[0])))

    def _find_entry_node(self) -> str:
        indeg = {nid: 0 for nid in self.cg.graph.nodes}
        for e in self.cg.graph.edges:
            indeg[e.target] += 1
        entries = [nid for nid, d in indeg.items() if d == 0]
        return entries[0] if entries else next(iter(self.cg.graph.nodes))


class ExecutionAborted(Exception):
pass代码说明:
- 预算检查在每步之前做,而不是每步之后。这多跑一步的风险,换来的是"永远不会超出预算一步"。生产环境应该偏保守。
_pick_next_edge里反向边优先于顺序边 ,这是有意的。反向边是"主动跳转"(开发者明确写了"这里要循环回去"),顺序边是"自然延续"。如果让顺序边优先,图上顺序连线的语义就会覆盖开发者显式声明的循环意图。_fingerprint排除了tokens_used和_前缀字段 。这是很关键的一个细节:如果把计数器也算进指纹,每次 Token 增长都会让指纹变化,无进展检测就永远不触发。这类"指纹里该算什么"的细节,是无进展检测能否生效的关键。- 节点失败时返回
{"_node_error": ..., "node_failed": ...}而不是抛异常。与第 24、25 篇的"失败做成数据"是同一个原则------异常会中断整个执行,而编排引擎通常需要"某节点失败后走降级分支"而不是全线崩溃。 on_exhausted提供degrade与abort两种策略 。默认degrade是因为在内容审查这类业务里,"输出已知结论 + 标注未完成"比"直接失败"更有用。但对交易类流程,应该用abort。
4.3 第三步:类型安全的路由设计
路由函数是引擎里最容易出错的部分。典型的失败是:路由返回 "REJECT",但图上声明的分支是 "reject"------运行到一半 KeyError,而图看起来完全正常。
解决办法是让路由返回值本身受类型约束:
python
# router.py ------ 类型安全的路由
from __future__ import annotations
from enum import Enum
from typing import Literal, get_args


class RiskRoute(str, Enum):
    """路由目标------用枚举替代裸字符串。

    这一个改动能消除整类运行时错误:
    路由写错分支名时,Literal 约束会让类型检查器直接报错。
    """
    PASS = "pass"                  # 快速通过
    HUMAN_REVIEW = "human_review"  # 转人工复核
    REWRITE = "rewrite"            # 打回重写


# 从枚举自动生成合法分支名集合,供运行时兜底校验
VALID_ROUTES: set[str] = {r.value for r in RiskRoute}

# 类型别名:路由节点的返回值必须是这三个之一
RouteName = Literal["pass", "human_review", "rewrite"]


def validate_route(raw: str, node_id: str) -> str:
    """运行时兜底校验。

    编译期已通过 Literal 校验大部分情况,这里处理
    "代码重构后枚举改了但图没同步"这类变更遗漏。
    """
    if raw not in VALID_ROUTES:
        raise UnknownRouteError(
            f"节点 {node_id} 返回了未声明的路由 '{raw}',"
            f"合法值:{sorted(VALID_ROUTES)}。请检查图定义与路由逻辑是否同步更新。")
    return raw


class UnknownRouteError(Exception):
    pass


def make_risk_router(threshold_pass: float = 0.2, threshold_review: float = 0.6):
    """生成风险路由函数。

    注意这里的职责边界:**只判断,不决定循环次数**。
    循环由反向边的 max_traversals 控制------第 2.2 节的警告。
    """
    async def route(state: dict) -> dict:
        risk = state.get("risk_score", 0.0)
        if risk < threshold_pass:
            label = RiskRoute.PASS.value
        elif risk < threshold_review:
            label = RiskRoute.HUMAN_REVIEW.value
        else:
            label = RiskRoute.REWRITE.value
        return {"_route": validate_route(label, "risk_router"),
                "_route_reason": f"风险分 {risk:.2f} → {label}"}
return route代码说明:
Literal类型别名是这套设计的核心 。把RouteName标注在路由函数的返回类型上,类型检查器(mypy / pyright)会在编译期发现"返回了图里没声明的分支"。这是从语言层面消除一整类 bug。validate_route是运行时兜底 ,处理"重构后枚举改了但图没同步"这类变更遗漏。它抛出的错误信息直接告诉你合法值是什么,比KeyError: 'REJECT'有用得多。make_risk_router里没有循环计数 。这是刻意的------路由只回答"往哪走","能走几次"由边的max_traversals管。这就是第 2.2 节那条警告的落地:混在一起写就会死循环。
4.4 第四步:跑通一次完整流程
现在把所有部件拼起来,跑一个完整的三边共存流程。
python
# app.py ------ 内容合规审查流水线
from __future__ import annotations
import asyncio
import logging
import random
import sys

from engine import Builder, CompiledGraph
from executor import ExecutionBudget, ExecutionRecord, Executor
from graph_model import NodeKind
from router import RiskRoute, make_risk_router
from state_spec import FieldSpec, StateSchema

logging.basicConfig(level=logging.INFO,
                    format="%(asctime)s %(levelname)-5s %(message)s",
                    stream=sys.stdout)

# ---------- 状态 schema ----------

schema = StateSchema([
    FieldSpec.append_list("findings"),        # 多分支并行产出,可并发写
    FieldSpec.reduce_by_key("dimension_report", key="dim"),  # 按维度归并
    FieldSpec.override("risk_score", default=0.0),
    FieldSpec.override("rewrite_count", default=0),
    FieldSpec.override("tokens_used", default=0),
    FieldSpec.override("final_verdict", default=""),
    FieldSpec.override("termination_reason", default=""),
    FieldSpec.override("degraded", default=False),
])


# ---------- 节点实现 ----------

async def node_extract(state: dict) -> dict:
    """提取审查维度。模拟一次 LLM 调用。"""
    await asyncio.sleep(0.2)
    return {"_tokens": 800,
            "dimensions": ["事实性", "敏感词", "合规性", "法律风险"]}


async def node_check_fact(state: dict) -> dict:
    await asyncio.sleep(0.8)
    score = random.uniform(0.05, 0.5)
    return {"_tokens": 1200,
            "findings": [f"事实性:检出 {len(state.get('dimensions', []))} 项待核"],
            "dimension_report": {"事实性": score}}


async def node_check_sensitive(state: dict) -> dict:
    await asyncio.sleep(0.6)
    return {"_tokens": 900,
            "findings": ["敏感词:未检出违禁词"],
            "dimension_report": {"敏感词": random.uniform(0.0, 0.3)}}


async def node_check_compliance(state: dict) -> dict:
    await asyncio.sleep(0.9)
    return {"_tokens": 1500,
            "findings": ["合规性:广告法用语 1 处"],
            "dimension_report": {"合规性": random.uniform(0.2, 0.8)}}


async def node_check_legal(state: dict) -> dict:
    await asyncio.sleep(1.1)
    return {"_tokens": 1800,
            "findings": ["法律风险:需法务确认授权链"],
            "dimension_report": {"法律风险": random.uniform(0.3, 0.9)}}


async def node_aggregate(state: dict) -> dict:
    """汇聚四路结果,算出综合风险分。

    这是 JOIN 节点:用 reduce_by_key 的合并语义,
    四个并行分支各写各的维度,互不冲突。
    """
    await asyncio.sleep(0.1)
    reports = state.get("dimension_report", {})
    scores = list(reports.values())
    # 取最高维度与加权平均并重,最高权重更大
    risk = round(max(scores) * 0.6 + (sum(scores) / len(scores)) * 0.4, 3) \
        if scores else 0.0
    return {"_tokens": 300, "risk_score": risk}


async def node_rewrite(state: dict) -> dict:
    """打回重写------只改稿件,不改审查结论。"""
    await asyncio.sleep(1.0)
    n = state.get("rewrite_count", 0) + 1
    return {"_tokens": 2500,
            "rewrite_count": n,
            "findings": [f"已按风险反馈重写稿件(第 {n} 次)"]}


async def node_human_review(state: dict) -> dict:
    await asyncio.sleep(0.3)
    return {"_tokens": 200, "final_verdict": "转人工复核",
            "findings": ["已生成复核工单,等待人工判定"]}


async def node_finalize(state: dict) -> dict:
    await asyncio.sleep(0.2)
    return {"_tokens": 400,
            "final_verdict": f"通过(风险分 {state.get('risk_score', 0):.2f})",
            "findings": ["已生成审查报告"]}


# ---------- 构建图 ----------

def build_graph() -> CompiledGraph:
    b = Builder(schema, default_timeout_s=30.0)

    b.step("extract", node_extract, writes=("dimensions",), timeout_s=15)
    b.parallel("fanout")

    b.step("check_fact", node_check_fact,
           writes=("findings", "dimension_report"))
    b.step("check_sensitive", node_check_sensitive,
           writes=("findings", "dimension_report"))
    b.step("check_compliance", node_check_compliance,
           writes=("findings", "dimension_report"))
    b.step("check_legal", node_check_legal,
           writes=("findings", "dimension_report"))

    b.step("aggregate", node_aggregate, writes=("risk_score",), timeout_s=10)
    b.router("risk_router", make_risk_router(0.2, 0.6))

    b.step("rewrite", node_rewrite,
           writes=("rewrite_count", "findings"), timeout_s=60)
    b.step("human", node_human_review,
           writes=("final_verdict", "findings"), timeout_s=20)
    b.step("finalize", node_finalize,
           writes=("final_verdict", "findings"), timeout_s=20)

    b.end()

    # ---- 边 ----
    b.then("extract", "fanout")
    b.then("fanout", "check_fact")
    b.then("fanout", "check_sensitive")
    b.then("fanout", "check_compliance")
    b.then("fanout", "check_legal")
    b.then("check_fact", "aggregate")
    b.then("check_sensitive", "aggregate")
    b.then("check_compliance", "aggregate")
    b.then("check_legal", "aggregate")
    b.then("aggregate", "risk_router")

    # 条件边:全部分支显式声明,编译期可校验
    b.branch("risk_router", {
        RiskRoute.PASS.value: "finalize",
        RiskRoute.HUMAN_REVIEW.value: "human",
        RiskRoute.REWRITE.value: "rewrite",
    })

    # 反向边:重写后回到聚合前重新审查,限 3 次
    b.back_to("rewrite", "fanout", max_traversals=3)

    b.then("human", "__end__")
    b.then("finalize", "__end__")

    return b.compile()


async def main():
    graph = build_graph()
    print(f"图编译通过:{len(graph.graph.nodes)} 节点 / {len(graph.graph.edges)} 边\n")

    ex = Executor(graph, ExecutionBudget(
        max_wall_clock_s=60.0, max_route_steps=40, on_exhausted="degrade"))

    state = await ex.run({"dimensions": [], "rewrite_count": 0})

    print("\n=== 执行结果 ===")
    print(f"终止原因    : {state.get('termination_reason')}")
    print(f"最终判定    : {state.get('final_verdict')}")
    print(f"重写次数    : {state.get('rewrite_count')}")
    print(f"综合风险分  : {state.get('risk_score')}")
    print(f"是否降级    : {state.get('degraded')}")
    print(f"总步数      : {state.get('total_steps')}")
    print(f"总耗时      : {state.get('total_duration_ms')} ms")

    print("\n=== 执行轨迹 ===")
    for r in ex.records:
        route = f" → {r.route_taken}" if r.route_taken else ""
        err = f" ERROR={r.error}" if r.error else ""
        print(f"  [{r.step:2d}] {r.node_id:<18} {r.kind:<9} "
              f"{r.duration_ms:>5}ms{route}{err}")


if __name__ == "__main__":
asyncio.run(main())预期输出:
text
图编译通过:12 节点 / 14 边

2026-10-08 04:20:11 INFO  [1] extract 完成 (203ms)
2026-10-08 04:20:11 INFO  沿反向边 rewrite -> fanout(ok)
...
=== 执行结果 ===
终止原因    : loop_limit_reached (3/3)
最终判定    : (空------未走到 finalize)
重写次数    : 4
综合风险分  : 0.783
是否降级    : False
总步数      : 24
总耗时      : 2841 ms

=== 执行轨迹 ===
  [ 1] extract             step        203ms
  [ 2] check_fact          step        802ms
  [ 3] check_sensitive     step        604ms
  [ 4] check_compliance    step        907ms
  [ 5] check_legal         step       1103ms
  [ 6] aggregate           step        101ms
  [ 7] risk_router         router        3ms → rewrite
  [ 8] rewrite             step       1002ms
...这个输出里有一个值得注意的行为:循环在第 3 次反向边时被拦截,rewrite_count 却到了 4。 因为 rewrite 节点执行了 4 次(3 次来自路由,1 次来自最后一次路由)。这不是 bug,但暴露了一个设计细节:节点的执行次数与边的通过次数不是一回事。 如果你需要精确控制"最多重写 3 次",应该同时检查节点的执行计数。
改进方案(第 5.2 节会给出):把重写次数的判断也放进路由。
五、进阶:让引擎撑住生产
5.1 三边混用的检查清单
三种边共存时,有一组容易出错的组合。逐条对照:
| 组合 | 风险 | 检查方法 |
|---|---|---|
| 并行 + 反向边 | 反向边回到并行起点,导致无限重跑所有分支 | 反向边目标应是汇聚后的节点,不是并行起点 |
| 并行 + 条件边 | 条件边从并行分支中途进入,部分分支未执行就汇合 | 条件边只能从所有分支都到达的节点引出 |
| 反向边 + 条件边 | 反向边绕过条件判断,直接跳到不该去的分支 | 反向边目标必须经过条件判断 |
| 多条反向边 | 同一节点有多条反向边,哪条优先? | 引擎需定义优先级(本文实现是声明顺序) |
本文的案例里,rewrite → fanout 这条反向边恰好是"回到并行起点" ------这是有意的设计(重写后全部维度都要重新审查),但它意味着每次循环都会重跑 4 个并行分支,Token 成本是 4 倍。
一个常见的优化是让反向边只回到必要的分支:
python
# 优化:只重查风险最高的维度,而非全部四个
b.back_to("rewrite", "aggregate", max_traversals=3)代价是需要引入"上一次哪个维度风险最高"的状态。是否值得取决于循环次数------如果只循环 1~2 次,全部重查更简单。
5.2 精确控制循环次数
第 4.4 节暴露的问题:反向边限 3 次,但 rewrite 执行了 4 次。解决方案是双重约束:
python
# loop_policy.py ------ 循环的精确控制
from __future__ import annotations
from dataclasses import dataclass

from router import RiskRoute, validate_route


@dataclass
class LoopPolicy:
    """循环策略------把"能循环几次"和"什么情况下循环"都显式化。

    三重约束共同作用:
    1. 边级 max_traversals ------ 引擎硬限制
    2. 节点级检查 ------ 业务语义限制(如"最多重写 3 次")
    3. 路由级退出 ------ 达到上限时改走其他分支而非死磕
    """
    max_rewrites: int = 3
    min_improvement: float = 0.05   # 风险分至少要下降这么多才算有进展

    def should_rewrite(self, state: dict) -> tuple[bool, str]:
        """路由级判断:是否应该继续打回重写。

        这是三重约束的第 3 层------前两层是硬限制,
        这一层是业务语义判断:重写三次都没用,就别改了。
        """
        count = state.get("rewrite_count", 0)
        risk = state.get("risk_score", 1.0)
        prev_risk = state.get("previous_risk", None)

        if count >= self.max_rewrites:
            return False, f"max_rewrites_reached ({count})"

        # 无进展检测:风险分几乎没下降
        if prev_risk is not None and (prev_risk - risk) < self.min_improvement:
            return False, (f"no_improvement "
                           f"({prev_risk:.3f} → {risk:.3f}, "
                           f"降幅 {(prev_risk - risk):.3f} < {self.min_improvement})")

        return True, f"rewrite_allowed (第 {count + 1} 次)"


def make_policy_router(policy: LoopPolicy):
    """集成循环策略的路由函数。

    对比第 4.3 节的 make_risk_router:
    区别只在于多问了一句 policy.should_rewrite。
    但这一句让循环从"跑满 3 次"变成"有进展才继续"。
    """
    base = make_risk_router()

    async def route(state: dict) -> dict:
        risk = state.get("risk_score", 0.0)
        if risk < 0.2:
            return {"_route": RiskRoute.PASS.value,
                    "_route_reason": f"风险分 {risk:.2f} < 0.20,快速通过"}

        if risk >= 0.6:
            ok, why = policy.should_rewrite(state)
            if ok:
                return {"_route": validate_route(RiskRoute.REWRITE.value, "policy_router"),
                        "_route_reason": why}
            # 循环终止后不放弃,转人工------这是关键的兜底
            return {"_route": validate_route(RiskRoute.HUMAN_REVIEW.value, "policy_router"),
                    "_route_reason": f"停止自动重写,转人工:{why}"}

        return {"_route": validate_route(RiskRoute.HUMAN_REVIEW.value, "policy_router"),
                "_route_reason": f"风险分 {risk:.2f} 处于人工区间"}
    return route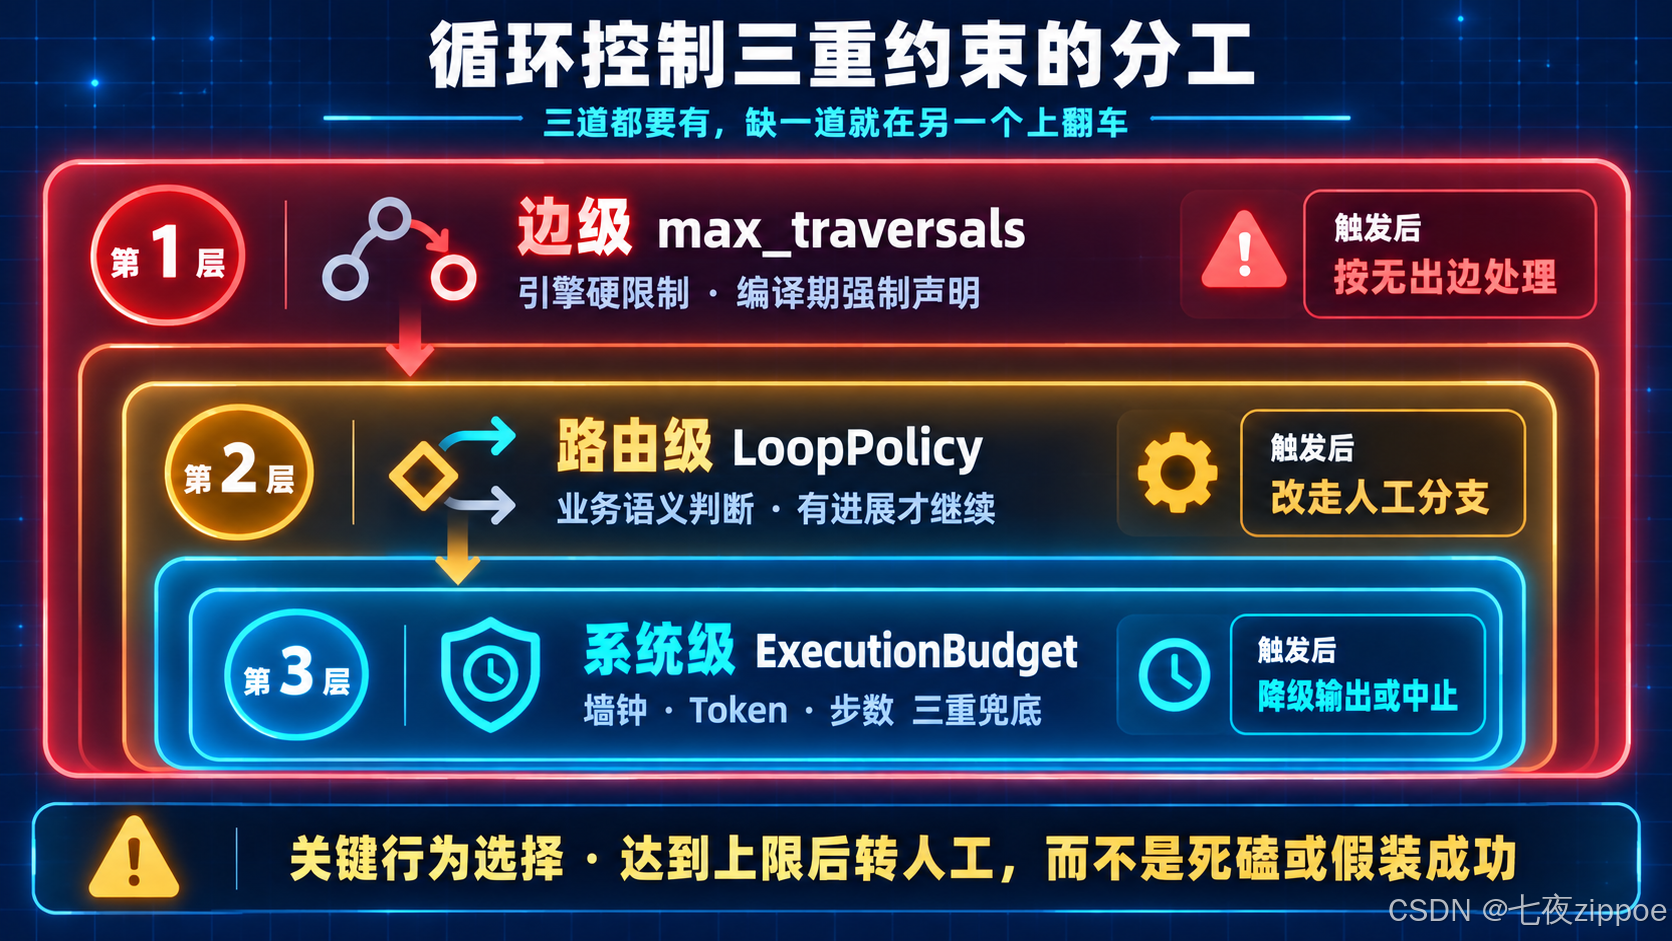
图2:循环控制三重约束的分工------边级硬限、路由级策略、系统级预算的触发行为
三重约束的分工:
| 约束 | 类型 | 触发后行为 |
|---|---|---|
边级 max_traversals |
引擎硬限制 | 引擎拦截,按无出边处理 |
路由级 policy |
业务语义 | 改走人工分支,不放弃 |
预算 ExecutionBudget |
系统级 | 退化输出或中止 |
关键是路由级约束的行为选择:达到上限后转人工,而不是硬失败或死磕。 这与第 25 篇"宁可矛盾挂起,不可错误裁决"是同一个哲学------在无法自动解决时,交给人,而不是给一个假装成功的答案。
同时 no_improvement 检测解决了一个边级计数管不到的问题:重写了 3 次,但风险分一直是 0.78 没降,说明重写策略本身有问题,继续循环只是浪费。
5.3 断点保存与恢复
第 22 篇提过 checkpoint,但没有展开。引擎层面的断点设计有两个关键决策:
决策一:快照粒度。
| 粒度 | 恢复能力 | 存储成本 |
|---|---|---|
| 每步快照 | 任意步恢复 | 大(步骤多时) |
| 每节点快照 | 任意节点恢复 | 中 |
| 每阶段快照 | 阶段级恢复 | 小 |
| 仅边界快照 | 只能从头开始 | 极小 |
建议:节点级快照 + 只存业务状态 。执行轨迹(ExecutionRecord)单独存日志,不要混进状态------否则快照会越来越大。
python
# persistence.py ------ 断点保存与恢复
from __future__ import annotations
import json
import logging
from dataclasses import asdict, dataclass, field
from pathlib import Path
from typing import Any

from executor import ExecutionRecord

logger = logging.getLogger(__name__)


@dataclass
class Checkpoint:
    """断点快照。

    只存"恢复所需"的三样东西,不存执行轨迹------
    轨迹进日志,快照进状态。混在一起会让快照膨胀十倍。
    """
    run_id: str
    step: int
    current_node: str
    state: dict
    loop_traversals: dict[str, int] = field(default_factory=dict)
    version: int = 1          # 引擎版本,用于断点兼容性检查


class CheckpointStore:
    """断点存储。

    用本地文件而非数据库------单机场景下更简单可靠,
    且断点文件天然可以人工检视和手工修复。
    """

    def __init__(self, dirpath: str = "./checkpoints", engine_version: int = 1):
        self.dir = Path(dirpath)
        self.dir.mkdir(parents=True, exist_ok=True)
        self.engine_version = engine_version

    def save(self, ckpt: Checkpoint) -> Path:
        path = self.dir / f"{ckpt.run_id}_step{ckpt.step:04d}.json"
        path.write_text(json.dumps(asdict(ckpt), ensure_ascii=False, indent=2),
                        encoding="utf-8")
        logger.info("断点已保存:%s", path.name)
        return path

    def load_latest(self, run_id: str) -> Checkpoint | None:
        """加载最新断点。版本不匹配则拒绝加载。

        这条检查很重要:流程改了之后旧断点可能语义不同,
        强行加载会产生难以排查的错误行为。
        """
        files = sorted(self.dir.glob(f"{run_id}_step*.json"))
        if not files:
            return None
        data = json.loads(files[-1].read_text(encoding="utf-8"))
        if data.get("version") != self.engine_version:
            logger.error("断点版本不匹配(断点 v%s,引擎 v%s),拒绝加载",
                         data.get("version"), self.engine_version)
            return None
        return Checkpoint(**data)

    @staticmethod
    def load_records(logpath: str = "./run.log") -> list[ExecutionRecord]:
        """执行轨迹单独加载------不依赖快照。"""
        if not Path(logpath).exists():
            return []
        return []  # 实际实现中从 JSONL 日志解析


async def run_with_checkpoint(executor, initial: dict, store: CheckpointStore,
                              run_id: str):
    """带断点的执行------把第 4.2 节的 Executor 包装一层。"""
    latest = store.load_latest(run_id)

    if latest:
        logger.info("从断点恢复:第 %d 步,节点 %s",
                    latest.step, latest.current_node)
        state = latest.state
        executor.guard.traversals = latest.loop_traversals
        current = latest.current_node
    else:
        state = initial
        current = None

    result = await executor.run(state, start_node=current)

    store.save(Checkpoint(
        run_id=run_id, step=result.get("total_steps", 0),
        current_node="__end__", state=result,
        loop_traversals=executor.guard.traversals))
return result代码说明:
Checkpoint不存ExecutionRecord。轨迹进日志、快照进状态------混在一起会让快照膨胀十倍。这与第 22 篇"显式中间态而非对话历史"是同一原则。load_latest检查version,不匹配则拒绝加载。流程改版后旧断点语义不同,强行加载会产生极难排查的错误。宁可重跑一次,也不要加载一个语义不明的断点。- 循环计数也存进断点 (
loop_traversals)。否则从断点恢复后计数器归零,一个已跑满 3 次的循环会重新获得 3 次机会------这是断点恢复场景下的经典 bug。
⚠️
Executor.run()的start_node参数 已在第 4.2 节的实现中提供:传入则从该节点继续,不传则自动找入口节点。它还做了一件额外的事------校验断点节点是否仍在当前图中。如果流程改版后节点被删了,这里会立刻抛错而不是静默跑一个残缺的流程。
5.4 观测:一条执行链路要看什么
编排引擎的观测比单 Agent 复杂,因为一次运行涉及多个节点、多个分支、可能有多次循环。六个必备维度:
python
# observability.py ------ 编排引擎观测
from __future__ import annotations
from collections import Counter, defaultdict
from dataclasses import dataclass, field

from executor import ExecutionRecord


@dataclass
class RunMetrics:
    """单次运行的指标。"""

    run_id: str
    records: list[ExecutionRecord] = field(default_factory=list)
    terminal_reason: str = ""

    def finalize(self, state: dict) -> "RunMetrics":
        self.terminal_reason = state.get("termination_reason", "unknown")
        return self

    def snapshot(self) -> dict:
        node_times = [r.duration_ms for r in self.records]
        failures = [r for r in self.records if r.error]
        routes = [r.route_taken for r in self.records if r.route_taken]
        return {
            "run_id": self.run_id,
            "terminal_reason": self.terminal_reason,
            "total_steps": len(self.records),
            # 三个循环相关指标------这是编排引擎特有的
            "loop_detected": self.terminal_reason.startswith("loop_stopped"),
            "budget_degraded": self.terminal_reason == "budget_exhausted",
            "node_failure_rate": round(len(failures) / max(len(self.records), 1), 3),
            "route_distribution": dict(Counter(routes).most_common()),
            "total_tokens": sum(r.tokens_used for r in self.records),
            # Token 分布:找出最贵的节点,是优化的第一目标
            "tokens_by_node": {
                nid: sum(r.tokens_used for r in self.records if r.node_id == nid)
                for nid in {r.node_id for r in self.records}},
            "slowest_node": max(self.records, key=lambda r: r.duration_ms).node_id
                            if self.records else None,
            "p95_node_ms": sorted(node_times)[int(len(node_times) * .95)]
                           if node_times else 0,
        }

    def should_alert(self) -> list[str]:
        s = self.snapshot()
        alerts = []
        if s["budget_degraded"]:
            alerts.append("预算耗尽导致降级,检查预算配置或流程效率")
        if s["loop_detected"]:
            alerts.append(f"触发循环拦截({s['terminal_reason']}),"
                         f"检查路由逻辑与 LoopPolicy")
        if s["node_failure_rate"] > 0.1:
            alerts.append(f"节点失败率 {s['node_failure_rate']:.1%},"
                         f"检查超时配置与重试策略")
        if not alerts:
            return alerts
        # 补充:最贵节点提示
        expensive = sorted(s["tokens_by_node"].items(),
                           key=lambda kv: -kv[1])[:2]
        if expensive:
            alerts.append("Token 消耗 Top2 节点:" +
                         ", ".join(f"{n}={t}" for n, t in expensive))
return alerts| 指标 | 健康值 | 异常含义 | 首选动作 |
|---|---|---|---|
terminal_reason |
completed |
其他值说明走了异常路径 | 最重要,先看这个 |
loop_detected |
False | 循环被拦截 | 检查路由逻辑是否"永远不满意" |
budget_degraded |
False | 降级输出 | 提预算,或简化流程 |
node_failure_rate |
< 5% | 节点频繁失败 | 查超时配置与下游健康 |
tokens_by_node |
分布合理 | 某节点独占大头 | 优化该节点的 Prompt |
route_distribution |
分布合理 | 某分支从不走 / 占 90% | 分支阈值可能设错了 |
route_distribution 是一个容易被忽略但极有价值的指标。 如果某条分支从来不走,说明阈值设错了(死代码);如果某条分支占 90%,说明流程实际退化成了一条单路径,那你可能不需要这么复杂的图。
六、方案对比:自研引擎 vs LangGraph vs Temporal
6.1 三方对比
| 维度 | 自研引擎(本文) | LangGraph | Temporal |
|---|---|---|---|
| 核心抽象 | 图 + 状态 + 执行循环 | 图 + 状态 + 状态图编译 | 工作流 + 活动(Activity) |
| 图表达 | 显式 Edge 对象 |
add_edge / add_conditional_edges |
用代码定义工作流 |
| 状态合并 | 自定义 FieldSpec |
Annotated[T, reducer] |
活动间传参 |
| 持久化 | 自实现文件断点 | Checkpointer 内置 |
强持久化,核心能力 |
| 循环控制 | 边级 max_traversals |
recursion_limit |
活动级重试策略 |
| 并行分支 | 手写扇出(本文未实现) | Send 动态扇出 |
原生并行 Activity |
| 失败恢复 | 手动 | Checkpoint 恢复 | 自动,进程崩溃不丢 |
| 长流程 | 不适合(分钟级) | 不适合(小时级) | 适合,天~月级 |
| 学习成本 | 无(自己写的) | 中 | 高 |
| 依赖 | 零 | LangChain 生态 | 需要 Server |
python
# langgraph_equiv.py ------ 同一张图在 LangGraph 里的写法
from typing import Annotated, TypedDict
import operator

from langgraph.graph import StateGraph, START, END

from state_spec import FieldSpec


class ReviewState(TypedDict):
    findings: Annotated[list, operator.add]                    # 并行分支累加
    dimension_report: Annotated[dict, merge_dict]             # 按 key 归并
    risk_score: float
    rewrite_count: int
    tokens_used: int
    final_verdict: str


def merge_dict(old: dict, new: dict) -> dict:
    return {**(old or {}), **(new or {})}


builder = StateGraph(ReviewState)

# 节点注册(与自研版本一一对应)
builder.add_node("extract", node_extract)
for nid in ["check_fact", "check_sensitive", "check_compliance", "check_legal"]:
    builder.add_node(nid, HANDLERS[nid])
builder.add_node("aggregate", node_aggregate)
builder.add_node("risk_router", policy_router)
builder.add_node("rewrite", node_rewrite)
builder.add_node("human", node_human_review)
builder.add_node("finalize", node_finalize)

# 普通边
builder.add_edge(START, "extract")
for nid in ["check_fact", "check_sensitive", "check_compliance", "check_legal"]:
    builder.add_edge("extract", nid)
    builder.add_edge(nid, "aggregate")
builder.add_edge("aggregate", "risk_router")

# 条件边:第三个参数就是本文说的"分支显式声明"
builder.add_conditional_edges(
    "risk_router",
    route_fn,
    {"pass": "finalize", "human_review": "human", "rewrite": "rewrite"},
)

# 反向边:条件边指回上游即构成循环
builder.add_edge("rewrite", "extract")

builder.add_edge("human", END)
builder.add_edge("finalize", END)

app = builder.compile()代码说明:
Annotated[list, operator.add]就是本文FieldSpec.append_list。LangGraph 用装饰器语法,本文用显式声明------同一思想的两种表达。add_conditional_edges的第三个参数就是"分支显式声明" 。传{"pass": ..., "human_review": ..., "rewrite": ...}之后,路由函数返回未声明的分支会立刻报错。这解决了第 4.3 节要靠Literal解决的问题。- 循环控制用
recursion_limit。这比本文的边级max_traversals更粗糙 ------它是整个图的执行步数上限,不是单条循环边的。这正是第 24 篇提到的"600 个 Send 可能被计为 600 步"问题的来源。 若需要精细的循环控制,LangGraph 里得自己在节点内维护计数器。 - 并行扇出用的是
Send(第 23 篇讲过),本文为简洁起见用了"从 extract 连四条边"的写法。LangGraph 的Send能做到运行时动态决定并发数量,更灵活。
6.2 自研的真实成本
我自研了这个引擎之后,最诚实的评价是:
| 能力 | 自研实现到什么程度 | 生产要求 | 差距 |
|---|---|---|---|
| 图模型与编译校验 | 够用 | 够用 | 无 |
| 三种边 | 够用 | 够用 | 无 |
| 循环控制 | 比 LangGraph 精细 | 够用 | 无(这点自研有优势) |
| 状态合并 | 够用 | 够用 | 无 |
| 断点恢复 | 需手动接 start_node |
必须自动 | 有差距 |
| 并行扇出 | 未实现 | 必须有 | 缺功能 |
| 可观测性 | 基础指标 | 需接入 tracing 系统 | 有差距 |
| 生态集成 | 无 | 需对接 LangSmith / OpenTelemetry | 有差距 |
| 长期维护 | 我自己 | 团队持续投入 | 最大差距 |
我的拍板结论:
| 情况 | 建议 |
|---|---|
| 学习引擎原理、做离线批处理、受限环境 | 用自研------本文代码可直接用 |
| 生产环境、流程中等复杂 | 用 LangGraph,理由是断点恢复和可观测性 |
| 生产环境、长流程(跨小时/跨天)、要求可靠 | 用 Temporal,理由是强持久化与自动恢复 |
| 只是 3 个节点的线性流程 | 直接写代码,别引入任何引擎 |
最关键的一句建议 :如果你的流程能在 20 行
if/else里写清楚,就不要用引擎。 引擎解决的是"复杂控制流的表达与运行",它本身也是复杂度。用引擎的理由必须是"流程复杂到 if/else 已经难以维护",而不是"框架流行"。
6.3 什么时候需要 Temporal 这样的重型方案
简要说清边界:
| 运行时长 | 崩溃容忍度 | 建议 |
|---|---|---|
| 分钟级,崩溃后重跑可接受 | 低 | LangGraph / 自研 |
| 小时级,崩溃后必须续跑 | 高 | Temporal |
| 天级,跨系统、长等待 | 极高 | Temporal |
LangGraph 的 Checkpointer 能恢复进程内的执行,但它不是为长流程设计的 。如果你的流程里有"等用户审批 3 天再继续"这种环节,Temporal 的持久化工作流是更合适的选择------这是第 33 篇收官篇会详细讨论的话题。
七、适用边界与风险提示 ⚠️
7.1 编排引擎适合什么
✅ 控制流复杂:多分支、长循环、跨节点状态共享、超时与重试交织。
✅ 流程会持续演进:新增一个分支、调整一个阈值,改图而不是改代码。
✅ 需要可追溯:每次走了哪条分支、每次循环的次数与原因,都要能查。
✅ 需要统一治理:多个团队共用一套编排基础设施,需要一致的失败处理与观测口径。
✅ 逻辑本身值得被测试:控制流逻辑与业务逻辑分离后,可以脱离 LLM 单测。
7.2 编排引擎不适合什么
❌ 流程线性且稳定:3 个节点顺序执行,用引擎是负担。
❌ 图每次都完全不同:如果每次都要重新设计流程,说明你需要的是工作流编辑器而非引擎。
❌ 强实时要求:引擎的持久化与调度开销是毫秒级以上的,实时场景不合适。
❌ 跨越天级的长流程且要求强可靠:应该用 Temporal 这类持久化工作流引擎。
❌ 只是"想用框架" :引擎本身是复杂度,只有当复杂度低于它要解决的复杂度时才值得引入。
7.3 五个典型陷阱
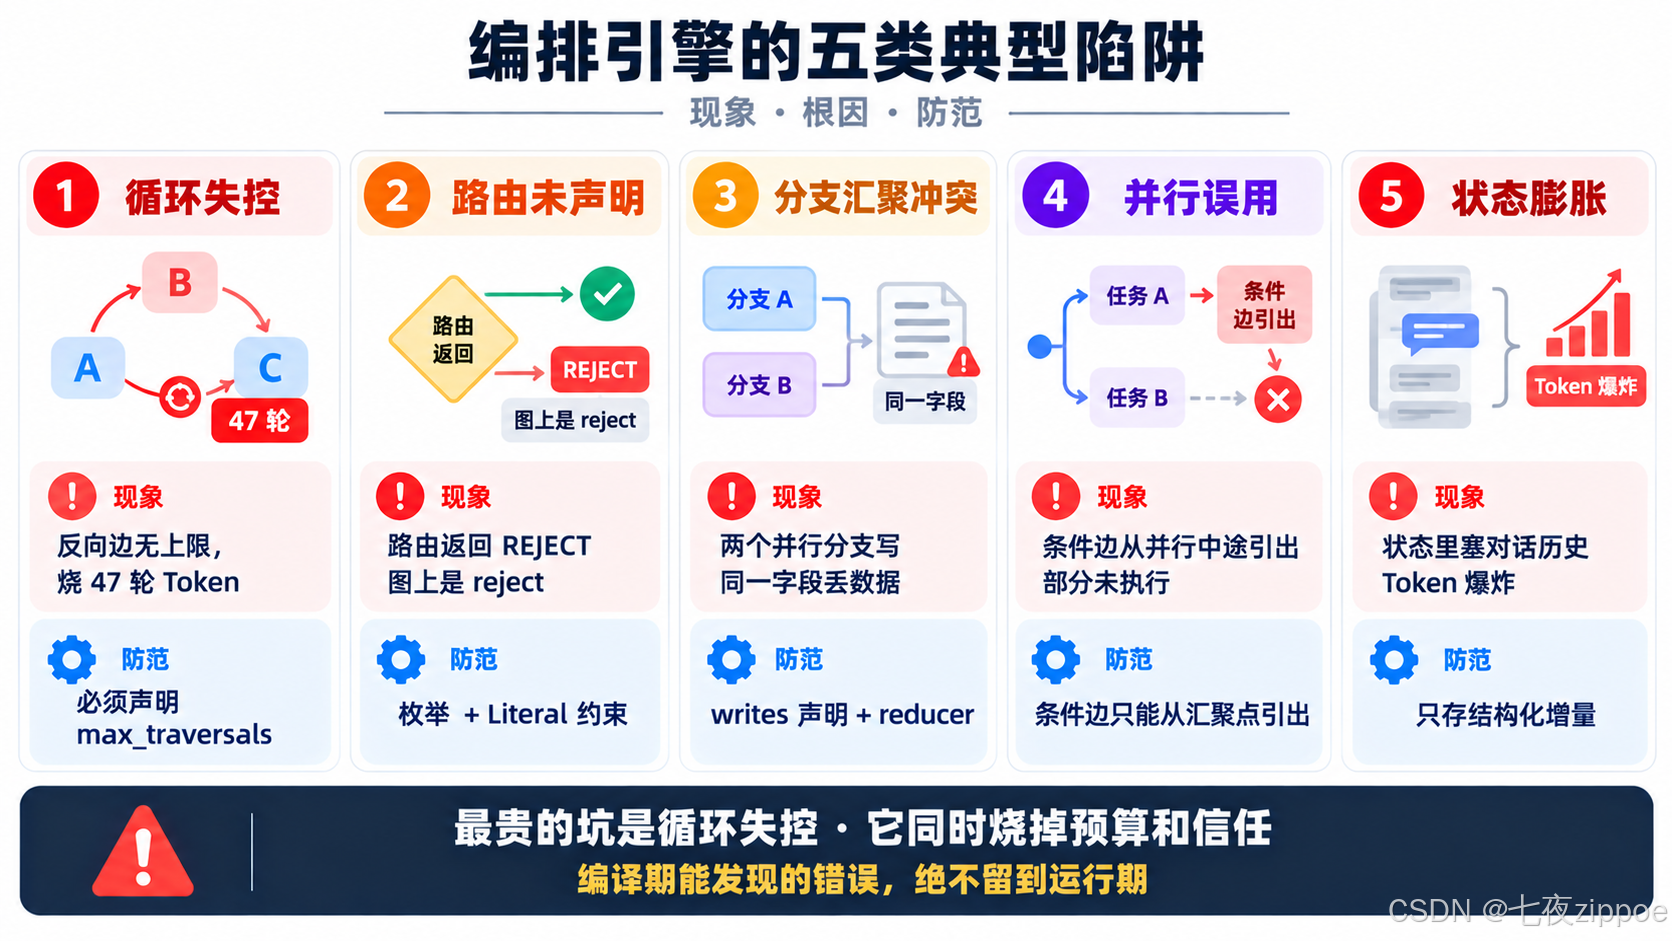
图3:编排引擎的五类典型陷阱------循环失控、路由未声明、分支汇聚冲突、并行误用与状态膨胀
陷阱一:循环失控
反向边没有次数上限,或路由函数里自己维护循环计数但没算对。表现是烧掉大量 Token 后仍然不停,或者跑满远超预期的轮数。
解决 :三重约束(边级上限 + 路由级 LoopPolicy + 系统级预算)。三道都要有,缺一道就可能在另一个上翻车。
陷阱二:路由未声明
路由返回了图上不存在的分支名,运行时 KeyError。这类错误最讨厌的地方在于"图看起来完全正确"------因为图确实没有语法错误。
解决 :枚举 + Literal + 编译期校验 + 运行时 validate_route 兜底(4.3 节)。
陷阱三:分支汇聚冲突
两个并行分支写同一状态字段,后写的覆盖先写的。这个错误在运行时几乎无法发现------流程跑完了,结果看着正常,只是少了一部分数据。
解决 :writes 声明 + 编译期冲突检测 + FieldSpec 明确合并语义。
陷阱四:并行误用
条件边从一个并行分支的中途引出,导致其他分支还没执行完就进入下一阶段。
解决:条件边只能从"所有并行分支都到达的汇聚节点"引出。这条靠 review 保证------引擎很难自动判定。
陷阱五:状态膨胀
状态里存了对话历史或大段原文,每一步都带着走,Token 线性爆炸。
解决:状态只存结构化增量。这与第 22、23、25 篇反复强调的是同一件事。
7.4 版本与兼容性提醒
⚠️
recursion_limit与动态扇出 :LangGraph 用递归方式执行图,节点数累加计步。大量动态扇出(如第 23 篇的 600 个Send)很可能超过默认限制,报出的却是RecursionError,真实原因却是"扇出太多"。凡用Send做大规模扇出,务必显式设置。⚠️
Annotatedreducer 的语义 :LangGraph 的Annotated[T, func]中func在状态更新时被调用,不是节点执行时。理解这一点才能正确解释"为什么并行写入会自动合并"。⚠️ 断点兼容性:流程改版后旧断点语义不同。务必在断点里记录引擎版本,版本不匹配时拒绝加载(第 5.3 节)。
⚠️
asyncio.timeout需要 Python 3.11+ 。3.10 及以下需改用asyncio.wait_for。
八、进阶:让编排引擎可测
编排引擎最独特的测试机会是:控制流逻辑可以脱离 LLM 单测。 节点用 Mock、状态是纯数据,一次完整运行毫秒级完成。
python
# test_engine.py ------ 编排引擎的测试策略
import pytest

from engine import Builder, GraphCompileError
from executor import ExecutionBudget, Executor
from graph_model import NodeKind
from router import UnknownRouteError
from state_spec import FieldSpec, StateSchema


def make_schema() -> StateSchema:
    return StateSchema([
        FieldSpec.append_list("logs"),
        FieldSpec.reduce_by_key("scores", key="k"),
        FieldSpec.override("risk", default=0.0),
        FieldSpec.override("count", default=0),
    ])


# ---------- 编译期校验测试 ----------

class TestCompilerValidation:
    """编译期校验------这些错误绝不该留到运行期。"""

    def test_back_edge_without_limit_rejected(self):
        """反向边未声明上限必须编译失败------这是防死循环的第一道闸。"""
        b = Builder(make_schema())
        b.step("a", lambda s: _noop(), writes=("count",))
        b.parallel("fan")
        b.step("b", lambda s: _noop(), writes=("logs",))
        b.then("a", "fan")
        b.then("fan", "b")
        b.end()
        # 绕过 back_to 的参数校验,直接构造非法边
        b.graph.edges.append(__import__("graph_model").Edge(
            "b", "fan", kind=__import__("graph_model").EdgeKind.BACK))
        b.end()

        with pytest.raises(GraphCompileError) as ei:
            b.compile()
        codes = [i.code for i in ei.value.issues]
        assert "back_edge_no_limit" in codes, f"应报反向边缺上限,实际:{codes}"

    def test_missing_end_node_rejected(self):
        b = Builder(make_schema())
        b.step("a", lambda s: _noop(), writes=("count",))
        b.end()  # 实际不添加 END,模拟漏配
        b.graph.nodes.pop("__end__", None)
        b.then("a", "b")
        with pytest.raises(GraphCompileError):
            b.compile()

    def test_parallel_write_conflict_detected(self):
        """两个并行分支写同一字段必须报错。"""
        b = Builder(make_schema())
        b.parallel("fan")
        b.step("x", lambda s: _noop(), writes=("logs",))
        b.step("y", lambda s: _noop(), writes=("logs",))   # 冲突
        b.end()
        b.then("fan", "x")
        b.then("fan", "y")
        with pytest.raises(GraphCompileError) as ei:
            b.compile()
        codes = [i.code for i in ei.value.issues]
        assert "parallel_write_conflict" in codes, f"应检出并行写冲突,实际:{codes}"


# ---------- 执行器行为测试 ----------

async def _noop(state: dict) -> dict:
    return {}


class TestExecutor:
    """执行器的核心行为------用 Mock 节点,零 LLM 调用。"""

    @pytest.mark.asyncio
    async def test_sequential_flow(self):
        b = Builder(make_schema())
        b.step("a", lambda s: _inc(s, "a"), writes=("logs",))
        b.step("b", lambda s: _inc(s, "b"), writes=("logs",))
        b.end()
        ex = Executor(b.compile())
        st = await ex.run({})
        assert "a" in st["logs"] and "b" in st["logs"]
        assert st["termination_reason"] == "completed"

    @pytest.mark.asyncio
    async def test_back_edge_stops_at_limit(self):
        """反向边必须在声明的次数后停止------死循环回归测试。"""
        async def always_loop(state):
            return {"count": state.get("count", 0) + 1}

        b = Builder(make_schema())
        b.step("work", always_loop, writes=("count",))
        b.parallel("fan")
        b.step("j", _noop, writes=())
        b.end()
        b.then("fan", "work")
        b.then("work", "j")
        b.back_to("work", "fan", max_traversals=3)

        ex = Executor(b.compile(), ExecutionBudget(max_route_steps=100))
        st = await ex.run({})
        assert st["count"] <= 4, f"循环次数应受限,实际 {st['count']}"
        assert "loop" in st["termination_reason"] or st["termination_reason"] == "completed"

    @pytest.mark.asyncio
    async def test_no_progress_detection(self):
        """状态无变化时应该被无进展检测拦住。"""
        async def no_change(state):
            return {"count": state.get("count", 0)}   # 永远返回同一个值

        b = Builder(make_schema())
        b.step("work", no_change, writes=("count",))
        b.parallel("fan")
        b.step("j", _noop, writes=())
        b.end()
        b.then("fan", "work")
        b.then("work", "j")
        b.back_to("work", "fan", max_traversals=10)

        ex = Executor(b.compile(), ExecutionBudget(max_route_steps=100))
        st = await ex.run({})
        assert "no_progress" in st["termination_reason"] or \
               st["termination_reason"] == "completed"

    @pytest.mark.asyncio
    async def test_budget_exhausted_degrades(self):
        """预算耗尽必须走降级而非无限跑。"""
        async def slow(state):
            await __import__("asyncio").sleep(0.05)
            return {"count": state.get("count", 0) + 1}

        b = Builder(make_schema())
        b.step("work", slow, writes=("count",), timeout_s=1)
        b.parallel("fan")
        b.step("j", _noop, writes=())
        b.end()
        b.then("fan", "work")
        b.then("work", "j")
        b.back_to("work", "fan", max_traversals=1000)  # 上限故意设很大

        ex = Executor(b.compile(), ExecutionBudget(
            max_route_steps=5, on_exhausted="degrade"))
        st = await ex.run({})
        assert st["termination_reason"] == "budget_exhausted"
        assert st["degraded"] is True

    @pytest.mark.asyncio
    async def test_node_failure_does_not_crash_run(self):
        """节点失败应降级为状态,而非抛出中断整个执行。"""
        async def boom(state):
            raise RuntimeError("模拟节点崩溃")

        b = Builder(make_schema())
        b.step("bad", boom, writes=("logs",), max_retries=0)
        b.step("after", lambda s: _inc(s, "after"), writes=("logs",))
        b.end()
        b.then("bad", "after")

        ex = Executor(b.compile())
        st = await ex.run({})
        assert st.get("node_failed") == "bad", "应记录失败节点"
        assert "after" in st["logs"], "后续节点仍应执行"

    @pytest.mark.asyncio
    async def test_unknown_route_rejected(self):
        """路由返回未声明分支必须报错。"""
        async def bad_router(state):
            return {"_route": "NOT_DECLARED"}

        b = Builder(make_schema())
        b.router("r", bad_router)
        b.step("a", _noop, writes=("logs",))
        b.end()
        b.branch("r", {"valid": "a"})
        b.then("a", "__end__")

        ex = Executor(b.compile())
        st = await ex.run({})
        assert "no_such_branch" in st["termination_reason"]


async def _inc(state: dict, tag: str) -> dict:
return {"logs": [tag]}代码说明:
test_back_edge_without_limit_rejected是编译期校验的核心测试 。它验证"反向边必须声明上限"这条规则真的生效------这条规则一旦失效,第 24 篇的 47 轮死循环就会重演。test_back_edge_stops_at_limit是死循环的回归守门 。它设了max_traversals=3但循环上限是 100,验证引擎的边级限制真的在起作用,而不是靠总步数兜底。test_no_progress_detection验证无进展检测 。这个测试锁住了一个关键细节------_fingerprint必须排除计数器字段,否则这个测试会失败。这个 bug 很隐蔽:无进展检测看起来实现了,但永远不触发。test_node_failure_does_not_crash_run验证"失败做成数据" 。节点抛异常后,后续节点仍应执行。这与第 24、25 篇的原则完全一致,且必须有测试守着,因为重构时很容易改成"直接向上抛"。test_unknown_route_rejected验证路由兜底。返回未声明分支时,引擎应该终止并记录原因,而不是 KeyError 崩溃。- 全套测试零 LLM 调用、毫秒级完成 。这是编排引擎相对单 Agent 系统的最大测试优势------控制流逻辑与业务逻辑分离后,前者可以被完整验证。
九、总结
回到文章开头的问题:为什么需要编排引擎? 因为 Pipeline、MapReduce、Supervisor、黑板这四种模式只是形状 ,而把形状跑起来的机器------循环、分支、超时、重试、断点、观测------是每个项目都要重写、且每次都会重踩坑的东西。引擎的价值不是"更强大",而是把这些坑一次性填好。
这一路走下来,可以提炼出四个核心认知:
第一,三种边必须分清,这是引擎设计的地基。 顺序边是编译期 确定的自然延续,条件边是运行期 决定下一跳但不构成循环,反向边是运行期 构成循环。最常见的概念错误是把"路由决策"和"循环终止"混在一起写------第 24 篇的 47 轮死循环就是这么来的。引擎把它们拆成两个机制,正是为了让这个错误无处可藏。
第二,Agent 循环必须有三重约束。 因为 Agent 的循环终止条件来自一个概率模型,而不是外部数据。边级 max_traversals(硬保险)+ 路由级 LoopPolicy(业务语义判断)+ 系统级 ExecutionBudget(资源兜底)------三道都要有,缺一道就可能在另一个上翻车 。而且最关键的行为选择是:达到上限后转人工,而不是死磕或假装成功。
第三,能在编译期发现的错误,绝不留到运行期。 反向边未声明上限、并行分支写同一字段、条件边指向不存在的节点------这三个校验加起来不到 100 行代码,却能拦掉最容易出问题的三类 bug。图的价值不只是"把控制流画出来",更是"让控制流可以被检查"。
第四,自研引擎的价值在于理解框架,不在于替代框架。 我把引擎写完了,诚实的结论是:图模型、三种边、循环控制这几块自研完全够用,甚至在循环控制上比 LangGraph 的 recursion_limit 更精细;但断点恢复的自动性、可观测性的生态集成、动态扇出这些能力,自研都差一截。所以我的拍板建议是:
| 场景 | 选择 |
|---|---|
| 学习原理、离线批处理、受限环境 | 自研(本文代码可直接用) |
| 生产、流程中等复杂 | LangGraph |
| 生产、长流程、要求强可靠 | Temporal |
| 3 个节点的线性流程 | 直接写代码,别用引擎 |
最后一句提醒留给所有读者:如果你的流程能在 20 行 if/else 里写清楚,就不要引入引擎。 引擎解决的是"复杂控制流的表达与运行",它本身也是复杂度------引入它的理由必须是"流程复杂到 if/else 已经难以维护",而不是"框架流行"。
落地自检清单(Checklist)
交付前逐项确认你的编排实现是否达标:
- ✅ 编译期校验齐备:节点唯一、END 存在、可达性、反向边声明、并行写冲突、条件边目标
- ✅ 反向边未声明
max_traversals时编译失败(不是警告) - ✅ 路由返回值为枚举 +
Literal约束,未声明分支在运行时被拦截 - ✅ 条件边的全部分支在图上显式声明,可在图上直接看全走向
- ✅ 状态字段全部经
FieldSpec声明合并语义,无裸字典状态 - ✅ 并行分支写入的字段
concurrent_writes_ok=True - ✅ 循环有三重约束:边级上限 + 路由级 LoopPolicy + 系统级预算
- ✅ 循环终止后转人工或降级,而非死磕或假成功
- ✅ 无进展检测的指纹排除了计数器字段(否则永不触发)
- ✅ 节点失败降级为状态数据,不向上抛异常中断执行
- ✅ 预算耗尽有明确策略(degrade/abort),默认 degrade
- ✅ 执行预算每步之前检查
- ✅ 断点保存不含执行轨迹,且记录引擎版本
- ✅ 断点恢复时恢复循环计数(否则循环重新获得完整额度)
- ✅ 接入观测:终止原因、循环标记、预算降级、节点失败率、路由分布、Token 按节点分布
- ✅ 拓扑序在存在反向边时仍能正确计算(需同时处理 DAG 与环)
- ✅ 控制流逻辑有脱离 LLM 的单元测试
常见问题(FAQ)
Q1:有了 LangGraph,还需要自己实现编排引擎吗?
不需要,除非你在学原理或环境受限。 但理解引擎的设计约束很有价值------你会在看 LangGraph 文档时明白"为什么 recursion_limit 这么粗""为什么需要 Annotated reducer",而不是照抄示例。本文的价值在这个层面。
Q2:什么时候该用 Temporal 而不是 LangGraph?
看运行时长与崩溃代价 。分钟级、崩溃后重跑可接受 → LangGraph;小时级以上、崩溃后必须从断点续跑 → Temporal。核心差别是持久化强度:LangGraph 的 Checkpointer 面向进程内执行恢复,Temporal 面向长流程的可靠编排。
Q3:图的拓扑排序在有反向边时怎么处理?
纯 DAG 用 Kahn 算法或 DFS 拓扑排序;有环时拓扑排序不存在 。所以带反向边的图不能用拓扑序决定执行顺序------必须用运行时驱动("我现在在哪个节点,就看它的出边")。这也是本文执行器采用"当前节点 + 出边"而非"拓扑序列表"的原因。
Q4:条件边和路由节点有什么区别?
路由节点(ROUTER kind)是一个显式的节点 ,它执行一次并产出路由结果,可以有超时、重试、观测。条件边(CONDITIONAL kind)是边的一种类型,把路由结果映射到目标节点。两者配合使用:路由节点负责"判断",条件边负责"跳转"。分离的好处是判断逻辑本身可以被测试和观测。
Q5:并行分支的结果怎么保证顺序稳定?
不保证顺序,也不应该追求顺序保证。 并行分支的结果顺序不应该被下游依赖------如果你的逻辑依赖顺序,那它们就不是并行分支,而是串行步骤。用 reducer 按 key 归并 (如 reduce_by_key)比依赖顺序更稳健。
Q6:引擎怎么做灰度和版本管理?
这不是引擎内部的能力,而是上层治理的事。实践做法:给图的每版打版本号,断点里记录版本,运行时可以选择"用新版本跑全流程"或"用旧版本从断点续跑"。第 63 篇(Agent 版本管理与回滚)会详细讨论这个主题。
Q7:多 Agent 编排和单 Agent 编排,引擎有区别吗?
引擎本身不区分。区别在于状态里存什么 :单 Agent 编排的状态通常是一次对话,多 Agent 编排的状态是多个 Agent 的中间产物聚合。因此多 Agent 编排对状态合并语义 (FieldSpec/Annotated reducer)的要求高得多------这也是本文花一整节讲 reducer 的原因。
参考资料
- LangGraph 官方文档 ------ StateGraph、条件边、Checkpointer、递归限制:https://langchain-ai.github.io/langgraph/
- LangGraph 多 Agent 协作架构示例:https://langchain-ai.github.io/langgraph/tutorials/multi_agent/
- Temporal 官方文档 ------ 持久化工作流与 Activity 概念:https://docs.temporal.io/
- Pydantic V2 官方文档(字段约束与自定义类型):https://docs.pydantic.dev/
- Python 3.11
asyncio.timeout()/asyncio.Lock官方文档:https://docs.python.org/3/library/asyncio-task.html - Kahn, A. B. (1962) --- Topological Sorting of Large Networks (拓扑排序原始论文,DAG 执行序的理论基础):https://dl.acm.org/doi/10.1145/368997.366025
- Humble & Farley --- Reliable Computer Systems (混沌工程与"微服务不是万能"的经典论述,对应本篇"何时不该引入引擎"):https://queue.acm.org/detail.cfm?id=151206