前言
大家好,这里是程序员阿亮!
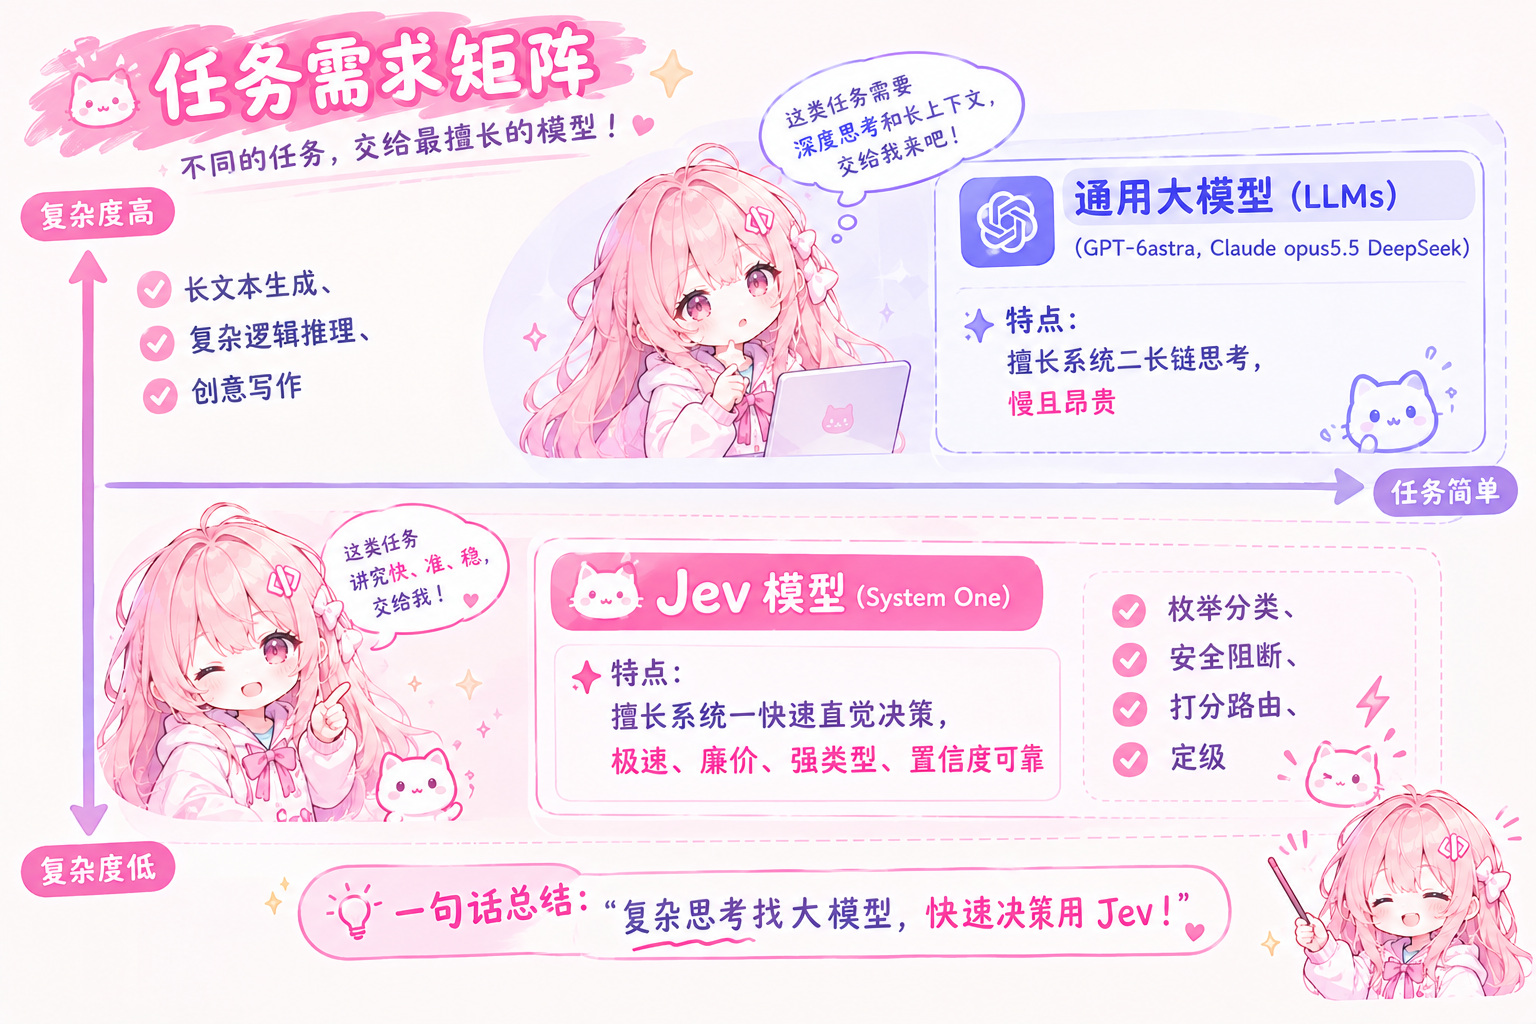
大家好,今天来给大家讲解一下Jev模型~
这个模型是前阵子突然爆火网络的模型,甚至你在抖音都能一直刷到它那么为什么它会走红呢?本文带你看明白~
一、 溯源:为什么传统的 ChatGPT 类大模型又慢、又贵、还爱抽风?
要彻底搞懂 Jev 的底层原理,必须先看清楚普通大语言模型(LLM)在骨子里是怎么运转的。
1. 为什么大模型必须"一个字一个字吐"?(自回归机制)
普通的 GPT 模型在底层叫 自回归模型(Autoregressive Model) 。
它的运行本质是一个死循环:
-
给出一段输入,让庞大的神经网络算一整轮,预测出下一个词(Token);
-
把这个新词追加到输入末尾,再重新跑一整轮神经网络,预测下下一个词......
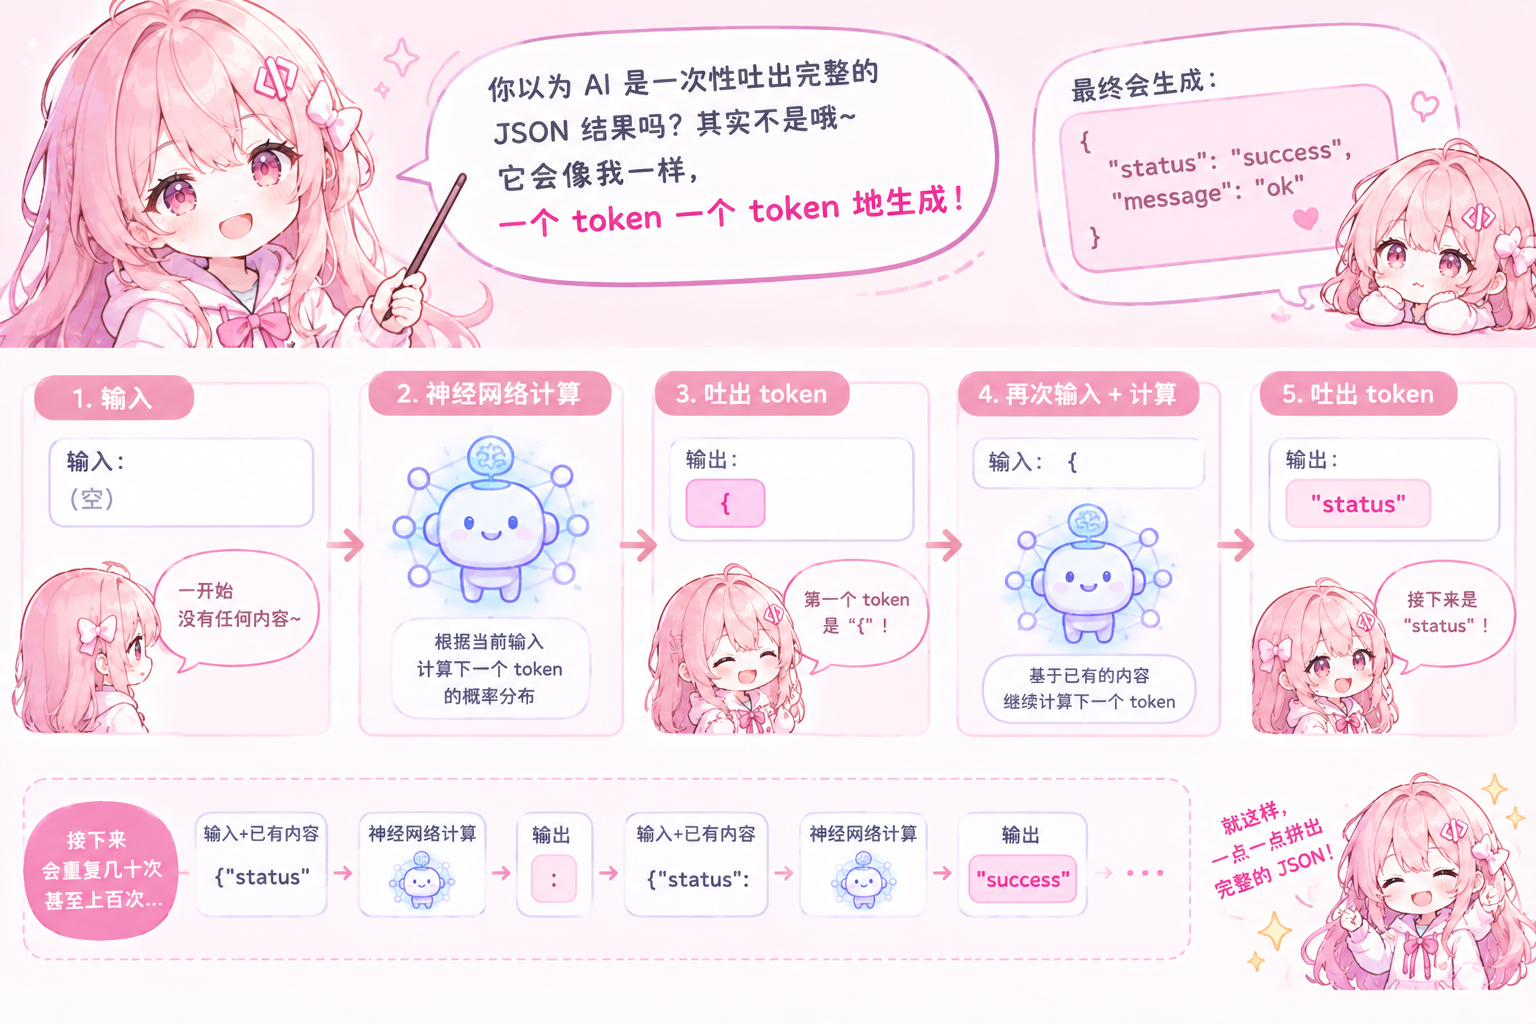
这种机制在写文章、编故事时非常强大,但它的物理缺陷是致命的:
-
延迟高:哪怕你要的只是一个布尔值 true,只要输出一串 JSON,GPU 就得串行循环几十次。硬件的显存带宽全被这种重复的数据搬运榨干了。
-
格式会抽风:大模型本质上是在"概率拼字"。哪怕你再三强调"只能返回 JSON",只要神经网络在某一轮采样中算错了一个字符(比如漏了右引号或多了句客套话),整个后端的 JSON 解析器就会当场崩溃。
二、 Jev 的底层架构原理:把"发声器官"换成"物理开关"
Jev 彻底打破了这种自回归机制。它在模型架构上做了三处颠覆性的改造:
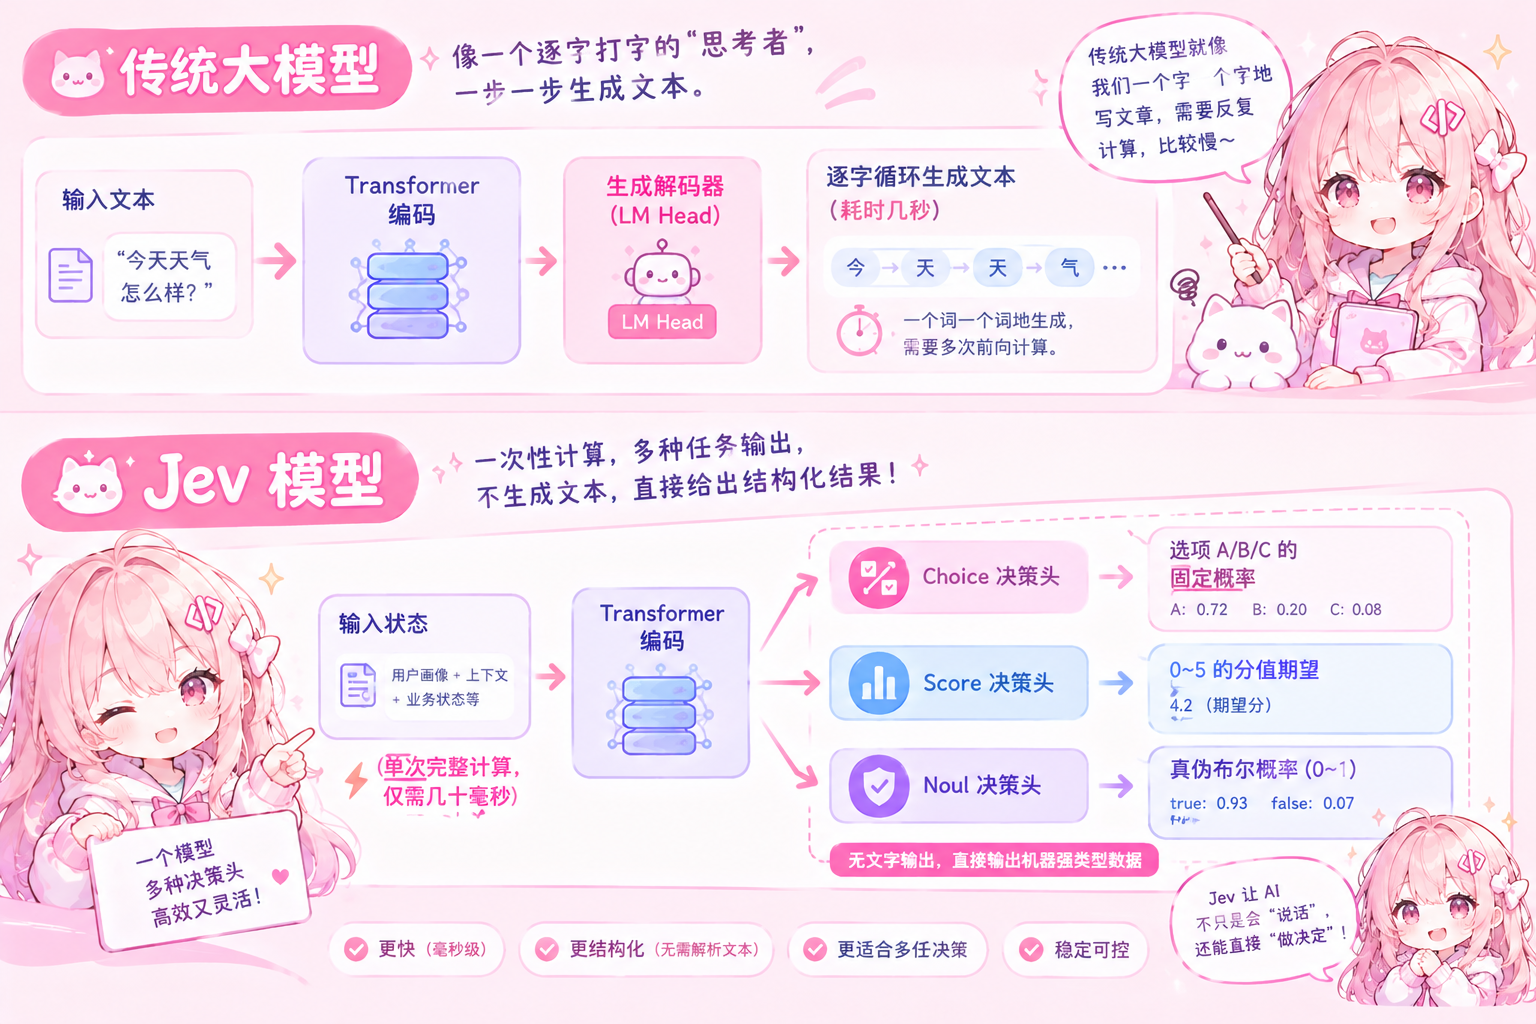
1. 砍掉生成式词表,换成"专用决策头"(Decision Heads)
普通大模型的最后一层是一个拥有几万到十几万词汇的"词表预测器"(LM Head)。
Jev 直接把这个笨重的词表给切掉了 。它保留了擅长理解文本含义的 Transformer 语义编码骨干,但在输出端换成了极简的物理决策头:
-
当你要做选择题时,最后一层输出直接对接一个只有固定槽位(最多 255 个)的 Softmax 分类层;
-
当你要打分时,最后一层直接对接一个回归/分布层。
2. 单次前向传播(Single Forward Pass):70ms 的秘密
因为不需要"一个字一个字地吐",Jev 处理任务时只跑一次前向计算 :
数据进入网络,所有的注意力机制并行计算一遍,各决策头的数值瞬间落定。
没有循环、没有反复的内存读取。GPU 可以在一次矩阵乘法中,耗时几十毫秒直接给出全部答案。
3. "物理级"类型安全(Type-Safe by Construction)
为什么 Jev 敢宣称结构化错误率是绝对的 0%?
-
普通大模型的做法:在软件外层加"监工"(通过正则约束或 JSON Mode 强行修正输出文本),这是"事后补救",依然可能因为超时或死循环出错。
-
Jev 的做法 :在数学和网络结构层面,压根就没有"文本"这个出口。
如果你定义了 options: "A", "B", "C",底层网络在物理上就只激活 3 个神经元输出节点。它无论如何都不可能输出第四个选项,更不可能吐出乱码,从根源上杜绝了数据格式损坏。
三、 Jev 的训练黑科技:怎么治好 AI 的"满嘴跑火车"?
很多工程师会问:"这不就是多分类模型吗?BERT 早就能做分类了,Jev 有什么了不起?"
Jev 最硬核的创新并不只是分类,而是它解决了 AI 的过度自信与幻觉问题 。这依赖于其研发团队独创的 RLCD(校准决策强化学习) 原理。
1. 传统 AI 的通病:虚荣与盲目自信
平时的大模型之所以经常"一本正经地胡说八道",是因为传统的训练方法(交叉熵损失与 RLHF 人类偏好对齐)在鼓励模型"就算不懂,也要猜得极其肯定"。
结果就是:一个模型给出的预测概率是 99%,但真实正确率可能只有 60%。 这种不可靠的概率在金融、安防、自动化工业系统中是绝对致命的。
2. RLCD 的底层原理:用"惩罚打赌"逼 AI 讲真话
Jev 抛弃了讨好人类的打分机制,引入了统计学中的严格适度评分规则(Strictly Proper Scoring Rules,如 Brier Score)。
你可以把这套训练机制理解为一场极其残酷的"信誉对赌考核":
-
规则设定:
-
如果你对一件事情判断正确,且你报出的信心度是 95%,你获得满分;
-
如果你对一件事情判断错误 ,但你刚才报出的信心度居然高达 95%,你将遭到天文数字般的惩罚扣分;
-
相反,如果你对某个模糊问题判断错了,但你提前老实报备"我只有 40% 的把握",系统不仅不重罚,反而会因为你的诚实给予奖励分。
-
在数万亿次这种机制的强化学习训练后,Jev 的神经网络被硬生生调教出了统计学意义上的高度校准(Probability Calibration):
当 Jev 告诉你这个决策的置信度是 85% 时,拿 1000 个同样评级的样本去复测,真实的命中率一定是精确地收敛在 85% 左右。
这种"自知之明",让工程师第一次敢在代码里写这样的逻辑:
如果 置信度 >= 0.90:
全自动执行(无需人工)
否则:
推送给人工审核 / 唤醒更昂贵的大模型复核
四、 Jev 的三大底层决策原语是如何运算的?
Jev 将所有非结构化的业务判断,归一化为了三个数学原语:
|------------|------------------------------------|----------------------------------|--------------------------|
| 原语名称 | 对应的业务语义 | 底层数学机制 | 输出内容 |
| Choice | 在多个候选项中选一个 (对齐代码的 switch-case) | 动态维度的 Softmax 离散概率分布 | 命中选项 + 每个选项的精确概率 + 整体置信度 |
| Score | 程度评估与风险定级 (对齐代码的连续/离散数值对比) | 排序概率分布(Ranked Probability)的期望值计算 | 连续分值(如 3.75 星)+ 离散置信度 |
| Noul | 命题真伪判定 (对齐代码的 if 条件判断) | 经过精确校准的 Sigmoid 二元概率映射 | 事件为"真"的概率(0.0 ~ 1.0) |
更重要的是,这三个原语可以在一次网络前向计算中"并行"求出。你传入一段长文本,可以让它在一个 70ms 内同时做:1个分类 + 2个打分 + 1个真假判断。
五、 Jev的业务价值?
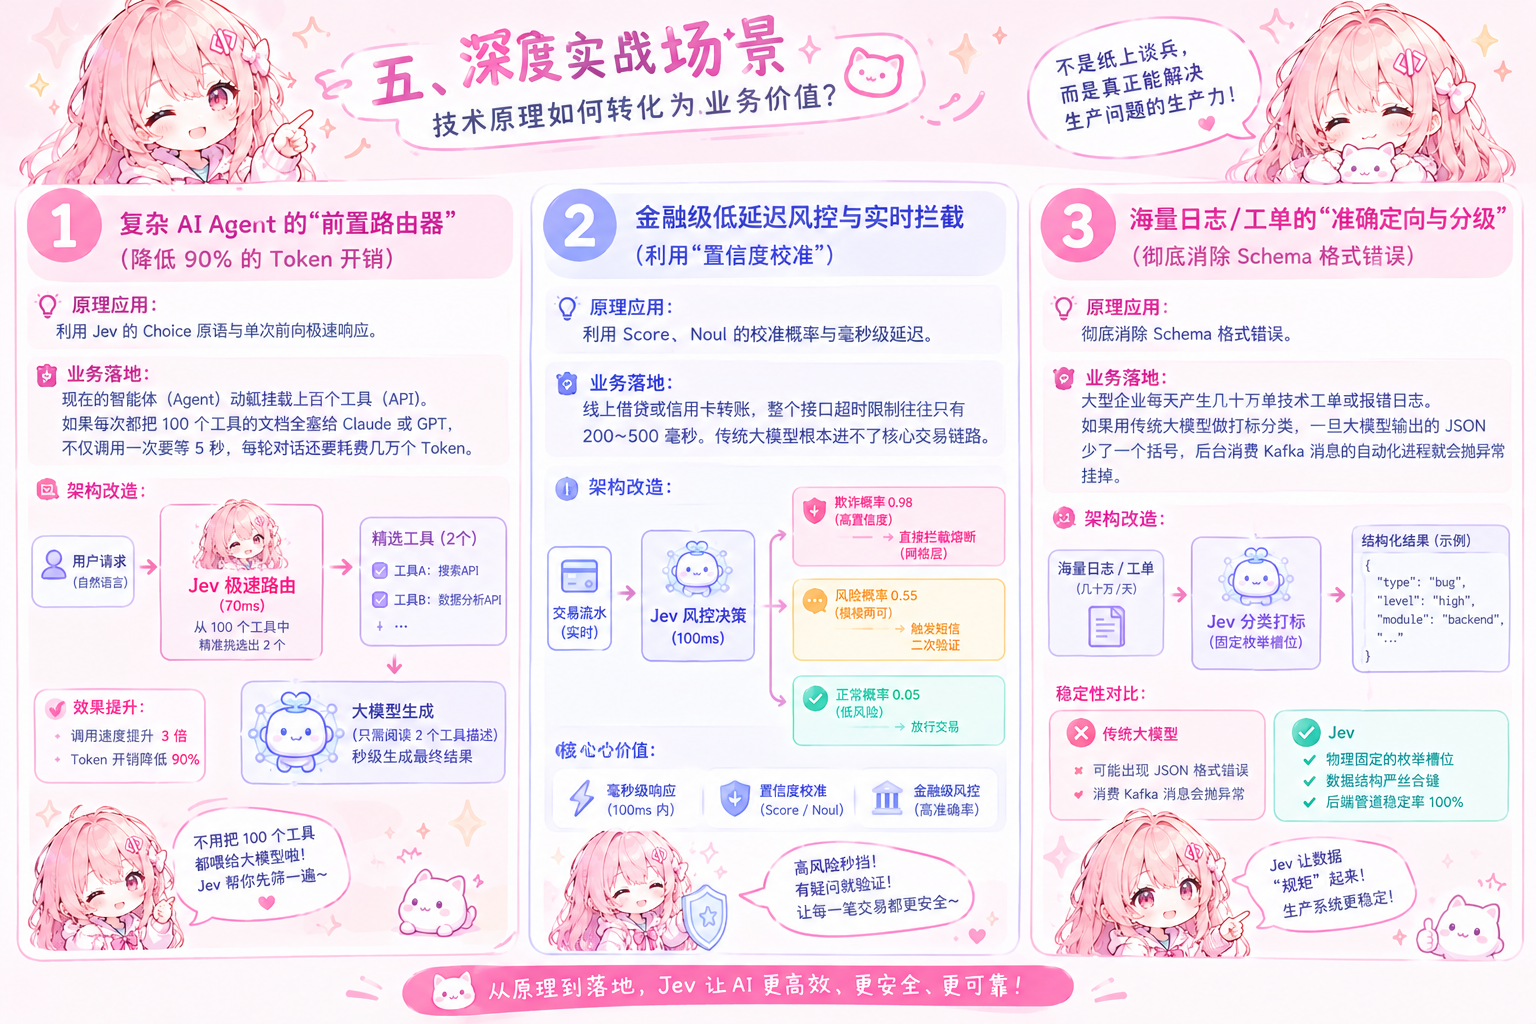
理解了上述原理,我们再看它是如何在具体的生产系统里大显身手的:
1. 复杂 AI Agent 的"前置路由器"(降低 90% 的 Token 开销)
-
原理应用:利用 Jev 的 Choice 原语与单次前向极速响应。
-
业务落地:现在的智能体(Agent)动辄挂载上百个工具(API)。如果每次都把 100 个工具的文档全塞给 Claude 或 GPT,不仅调用一次要等 5 秒,每轮对话还要耗费几万个 Token。
-
架构改造:在最前端挂一个 Jev。用户一句话进来,Jev 在 50ms 内从 100 个工具中选出最相关的 3 个,只把这 3 个注入给主大模型。响应速度提升 3 倍,账单直接砍掉大半。
用户请求
↓
[Jev 极速路由] (70ms) ──> 快速剪枝,从 100 个工具中精准挑选出 2 个
↓
[大模型生成] ──> 只需阅读 2 个工具的描述,秒级生成最终结果
2. 金融级低延迟风控与实时拦截(利用"置信度校准")
-
原理应用:利用 Score、Noul 的校准概率与毫秒级延迟。
-
业务落地:线上借贷或信用卡转账,整个接口超时限制往往只有 200~500 毫秒。传统大模型根本进不了核心交易链路。
-
架构改造:实时交易流水直接过 Jev。Jev 在 100ms 内给出风控打分:
-
若"欺诈概率"判定为 0.98(高置信度):直接在网络层拦截熔断;
-
若判定为 0.55(模棱两可):后台自动触发短信二次验证。
-
3. 海量日志/工单的"准确定向与分级"
-
原理应用:彻底消除 Schema 格式错误。
-
业务落地:大型企业每天产生几十万单技术工单或报错日志。如果用传统大模型做打标分类,一旦大模型输出的 JSON 少了一个括号,后台消费 Kafka 消息的自动化进程就会抛异常挂掉。
-
架构改造:切换为 Jev,因为底层是物理固定的枚举槽位,哪怕跑 1000 万次,返回的数据结构都严丝合缝,后端管道稳定率达到 100%。
总结
Jev 的定位:它不是大模型的替代者,而是大模型的"前哨站与分流阀"。