论文:Leveraging Self-Supervised Learning for Speaker Diarization
简称:WavLM + Conformer 局部 EEND(开源工具包 DiariZen)
作者:Jiangyu Han, Federico Landini, Johan Rohdin, Anna Silnova, Mireia Diez, Lukáš Burget
单位:Brno University of Technology, Speech@FIT(BUT)
出处:arXiv:2409.09408v3(2024-10-21)
代码:https://github.com/BUTSpeechFIT/DiariZen
任务:Speaker Diarization,回答"谁在什么时候说话"
场景:远场单通道会议数据(AMI / AISHELL-4 / AliMeeting / CHiME-8 NOTSOFAR-1)
前言
DiariZen 是 pyannote 的演进,沿用 pyannote 的整条流水线,把局部 EEND 模块换成 WavLM + Conformer。核心思想是用 SSL 大模型来提升性能,解决说话人日志任务缺数据的问题。精度上,在 AMI、AISHELL-4 上刷到了当时(2024-08)的 SOTA;数据效率方面,只用 5% 的训练数据(14.4 小时),就比用全部 288.3 小时训练的 pyannote 基线还好。
一、推理管线
论文完整沿用 pyannote 的 pipeline,只换 EEND 模块。
text
输入:一条长录音
  │
  ① 切成互相重叠的短段(本文:8s 段,hop 0.8s)
  │
  ② 对每段跑局部 EEND  ->  段内每个说话人的逐帧活动
  │
  ③ 对段内每个说话人,在其"纯净语音"(无重叠)帧上提 speaker embedding
  │     论文用 WeSpeaker 的 ResNet34-LM(VoxCeleb2 训练)
  │
  ④ 把所有段的所有 embedding 做层次聚类(AHC)
  │     ★约束:同一段内的不同 embedding 不允许落进同一个簇
  │     (因为它们在段内已被 EEND 判定为不同的人)
  │
  ⑤ 聚类结果给出跨段的说话人映射
  │
  ⑥ 重叠段上同一说话人的概率取平均,聚合成最终输出
  ▼
输出:整条录音的 "谁在什么时候说话"
第 ④ 步把"段内 EEND 的判断"当作可信的负样本约束注入聚类,避免把同一段里的两个人合并。
推理超参:
| 项 | 值 |
|---|---|
| 段长 / hop | 8 s / 0.8 s(训练时 hop 6s ) |
| speaker embedding | WeSpeaker ResNet34-LM(VoxCeleb2) |
| AHC 簇数范围 | 最少 2,最多 8 |
| 最小簇大小 | 30 |
| 余弦相似度聚类阈值 | 固定 0.7(不随数据集调) |
| 模型权重 | 最后 5 个 checkpoint 参数平均 |
二、把局部 EEND 换成 WavLM + Conformer
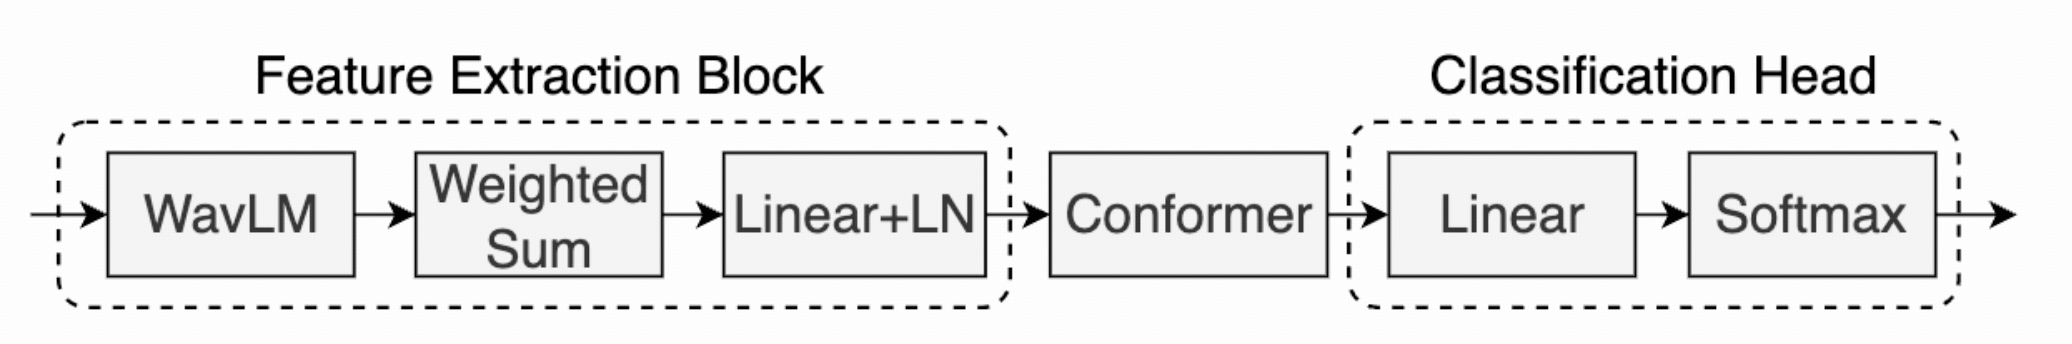
图 1 DiariZen 的 EEND 模块
2.1 改动前后
text
pyannote3 的局部 EEND:
   波形 -> SincNet -> 4 层 BiLSTM -> 分类头

本文的局部 EEND:
   波形 -> WavLM Base+ -> 各层加权求和 -> Linear+LN -> 4×Conformer -> Linear -> Softmax
图 1 把它分成两块:特征提取块 (WavLM + Weighted Sum + Linear+LN)与分类头(Conformer + Linear + Softmax)。
2.2 完整维度流(8 秒输入)
text
8 s @ 16 kHz 波形                                    (128000,)
  │ WavLM Base+ 的 CNN 前端(帧移 20 ms)
  ▼
13 个层的输出:conv 输出 + 12 个 transformer 层       13 × (T, 768),  T = 8s/20ms ≈ 400
  │ ★逐帧加权求和(13 个可学习标量权重)
  ▼
融合表示                                             (T, 768)
  │ Linear(768 → 256) + LayerNorm
  ▼
                                                     (T, 256)
  │ 4 × Conformer block(去掉位置编码)
  ▼
                                                     (T, 256)
  │ Linear(256 → 11)
  ▼
                                                     (T, 11)
  │ Softmax(沿 11 个 powerset 状态)
  ▼
每帧一个 11 维概率分布参数量:WavLM 94.7 M + Conformer 6.1 M ,分类头只占 6%,绝大部分参数来自预训练好的 WavLM。
由于自监督模型的不同层编码的信息是分层的:
text
浅层  ->  更偏声学 / 说话人特性(音色、信道)
中层  ->  音素、发音单元
深层  ->  更偏语义、内容
所以 DiariZen 采用融合表示。设 WavLM 第 l l l 层在第 t t t 帧的输出为 h t ( l ) ∈ R 768 \mathbf{h}_t^{(l)} \in \mathbb{R}^{768} ht(l)∈R768,融合表示
h t = ∑ l = 0 L w l h t ( l ) , L = 12 \mathbf{h}t \;=\; \sum{l=0}^{L} w_l \, \mathbf{h}_t^{(l)}, \qquad L = 12 ht=l=0∑Lwlht(l),L=12
其中 w l w_l wl 是可学习的标量权重 (共 13 个,对应 conv 前端输出 + 12 个 transformer 层),通常经 softmax 归一化保证 ∑ l w l = 1 \sum_l w_l = 1 ∑lwl=1。
2.3 Conformer
Conformer block 把自注意力的全局建模和卷积的局部建模叠在一起:
x ~ = x + 1 2 F F N ( x ) x ′ = x ~ + M H S A ( x ~ ) x ′ ′ = x ′ + C o n v ( x ′ ) y = L a y e r N o r m ( x ′ ′ + 1 2 F F N ( x ′ ′ ) ) \begin{aligned} \tilde{\mathbf{x}} &= \mathbf{x} + \tfrac{1}{2}\,\mathrm{FFN}(\mathbf{x}) \\ \mathbf{x}' &= \tilde{\mathbf{x}} + \mathrm{MHSA}(\tilde{\mathbf{x}}) \\ \mathbf{x}'' &= \mathbf{x}' + \mathrm{Conv}(\mathbf{x}') \\ \mathbf{y} &= \mathrm{LayerNorm}\!\left(\mathbf{x}'' + \tfrac{1}{2}\,\mathrm{FFN}(\mathbf{x}'')\right) \end{aligned} x~x′x′′y=x+21FFN(x)=x~+MHSA(x~)=x′+Conv(x′)=LayerNorm(x′′+21FFN(x′′))
论文配置:
| 超参 | 值 |
|---|---|
| block 数 | 4 |
| 模型维度 d d d | 256 |
| FFN 隐层 | 1024 |
| 注意力头数 | 4 |
| 卷积 kernel | 31 |
| dropout | 0.1 |
| 位置编码 | ★去掉 |
说话人切换点是局部 事件(需要卷积的局部感受野),说话人嵌入需要全局比较,Conformer 同时提供两者。
论文的对照实验也证实了这一点:即使只用传统 Fbank 特征,换成 Conformer 后就已经全面超过 pyannote 基线 。收益有两个独立来源:一份来自 Conformer 架构,一份来自 WavLM 表示。
三、powerset 多分类
这是 pyannote 的设计,细节可参考 powerset loss 论文。
3.1 传统 EEND :多标签 + 阈值
经典 EEND 对每个说话人输出一个独立的 sigmoid 概率,用二元交叉熵训练:
L B C E = − 1 T N ∑ t = 1 T ∑ n = 1 N y t n log y \^ t n + ( 1 − y t n ) log ( 1 − y \^ t n ) \mathcal{L}{\mathrm{BCE}} = -\frac{1}{TN}\sum{t=1}^{T}\sum_{n=1}^{N}\Bigy_{tn}\\log \\hat{y}_{tn} + (1-y_{tn})\\log\\big(1-\\hat{y}_{tn}\\big)\\Big LBCE=−TN1t=1∑Tn=1∑Nytnlogy\^tn+(1−ytn)log(1−y\^tn)
其中 y t n ∈ { 0 , 1 } y_{tn}\in\{0,1\} ytn∈{0,1} 表示第 n n n 个说话人在第 t t t 帧是否活跃。
问题 是推理时必须选一个决策阈值 τ \tau τ 来判定 y ^ t n > τ \hat{y}_{tn} > \tau y^tn>τ 是否算"在说话"。这个阈值极敏感,换个数据集就要重调。
3.2 powerset :枚举所有"活跃组合"
powerset 不再对每个说话人单独判断,而是把"当前帧处于哪一种活跃组合"当成一个多分类问题。
本文设定:最多 N = 4 N=4 N=4 个说话人,最多 K = 2 K=2 K=2 人同时说话。那么所有可能的状态数是:
∣ P ∣ = ∑ k = 0 K ( N k ) = ( 4 0 ) + ( 4 1 ) + ( 4 2 ) = 1 + 4 + 6 = 11 |\mathcal{P}| \;=\; \sum_{k=0}^{K}\binom{N}{k} \;=\; \binom{4}{0} + \binom{4}{1} + \binom{4}{2} \;=\; 1 + 4 + 6 \;=\; \mathbf{11} ∣P∣=k=0∑K(kN)=(04)+(14)+(24)=1+4+6=11
逐个列出来就是:
text
静音(0 人)                                   :  1 类   {}
单人说话(1 人)                               :  4 类   {1} {2} {3} {4}
两人重叠(2 人)                               :  6 类   {1,2} {1,3} {1,4} {2,3} {2,4} {3,4}
                                                  ------
                                                   11 类
所以最后那个 Linear 的输出维度是 11。训练用标准的多分类交叉熵:
L P S = − 1 T ∑ t = 1 T ∑ c = 1 ∣ P ∣ z t c log z ^ t c , z ^ t = s o f t m a x ( W y t + b ) \mathcal{L}{\mathrm{PS}} = -\frac{1}{T}\sum{t=1}^{T}\sum_{c=1}^{|\mathcal{P}|} z_{tc}\,\log \hat{z}_{tc}, \qquad \hat{\mathbf{z}}_t = \mathrm{softmax}\big(\mathbf{W}\mathbf{y}_t + \mathbf{b}\big) LPS=−T1t=1∑Tc=1∑∣P∣ztclogz^tc,z^t=softmax(Wyt+b)
其中 z t \mathbf{z}_t zt 是 one-hot 向量(第 t t t 帧真实处于哪个 powerset 状态)。
因为 11 个状态是互斥 的,softmax 之后直接取 arg max \arg\max argmax 就得到了当前帧的活跃组合。
解码时再把状态映射回每个说话人的逐帧活动,比如状态 {1,2} 就意味着说话人 1、2 都活跃,即可送入 pipeline 的后续步骤。
powerset loss 的缺点是类别数随 N N N、 K K K 组合增长 , ( N k ) \binom{N}{k} (kN) 易爆炸,需预设"最多几人、最多重叠人数"。这也限制了 EEND 方法的窗长设定,5~8 秒短窗内 3 人同时说话的概率很低,如果 30 秒窗长,再限制最多 3 个说话人,就不合理了。
四、训练
4.1 数据
论文用三个公开数据集的远场单通道数据,并将其合并成一个复合数据集,
| 数据集 | Train #files / #spk / #hrs | Dev | Test |
|---|---|---|---|
| AMI | 134 / 3-5 / 79.7 h | 18 / 4 / 9.7 h | 16 / 3-4 / 9.1 h |
| AISHELL-4 | 173 / 3-7 / 97.2 h | 18 / 3-7 / 10.3 h | 20 / 5-7 / 12.7 h |
| AliMeeting | 209 / 2-4 / 111.4 h | 8 / 2-4 / 4.2 h | 20 / 2-4 / 10.8 h |
| Compound | 516 / 2-7 / 288.3 h | 44 / 2-7 / 24.2 h | 56 / 2-7 / 32.6 h |
AISHELL-4 原本没有 dev 集,论文从 train 里按房间各取 10% 作为 dev,剩下的作为新 train。
4.2 训练
| 项 | 值 |
|---|---|
| 训练段长 / hop | 8 s / 6 s |
| 有效 batch size | 64 |
| Fbank 对照 | 80 维,25 ms 窗,10 ms 帧移 |
| 优化器 | AdamW |
| 学习率 | WavLM 1e-5 ,其他 1e-3(联合更新时);其他实验统一 1e-3 |
| epoch | 最多 100,验证 loss 连续 10 轮不降则早停 |
| 梯度裁剪 | AutoClip :阈值取训练中观测到的梯度范数的 90 分位数,自适应 |
五、实验结果
5.1 主结果
Table II(DER %)
| 系统 | 特征 | AMI | AISHELL-4 | AliMeeting | AMI | AISHELL-4 | AliMeeting |
|---|---|---|---|---|---|---|---|
| collar=0 s | collar=0.25 s | ||||||
| Pyannote3(原论文) | SincNet | 22.0 | 16.9 | 23.3 | - | - | - |
| +fine-tuning(原论文) | SincNet | 22.9 | 13.2 | 24.5 | 15.3 | 7.6 | 15.8 |
| Pyannote3(本文复现基线) | SincNet | 21.1 | 13.9 | 22.8 | 13.7 | 7.7 | 13.6 |
| 本文 | Fbank | 19.7 | 12.5 | 21.0 | 12.9 | 6.9 | 12.6 |
| 本文 | WavLM-frozen | 17.0 | 11.7 | 19.9 | 10.9 | 6.1 | 12.0 |
| ★本文 | WavLM-updated | 15.4 | 11.7 | 17.6 | 9.8 | 5.9 | 10.2 |
| 2024-08 时的 SOTA | - | 17.1 | 12.2 | 13.4 | 13.3 | 7.6 | 6.1 |
① 收益有两份。
text
Pyannote3 基线(SincNet+BLSTM)   21.1 / 13.9 / 22.8
      │ 只换架构:Conformer + Fbank         <- 第一份收益:架构
      ▼                            19.7 / 12.5 / 21.0
      │ 再换表示:WavLM(冻结)              <- 第二份收益:SSL 表示
      ▼                            17.0 / 11.7 / 19.9
      │ 再解冻联合微调                       <- 第三份收益:联合优化
      ▼                            15.4 / 11.7 / 17.6
② 相对基线的降幅(collar=0 s) :AMI −26.6% 、AISHELL-4 −15.8% 、AliMeeting −22.8%。
③ AMI 与 AISHELL-4 达到了当时 SOTA(15.4 vs 17.1;11.7 vs 12.2)。
④ ★AliMeeting 差于 SOTA (17.6 vs 13.4)。论文分析 AliMeeting 每场只有 2~4 个说话人 ,这种"人少"的场景更适合完全端到端的方法(如 EEND-M2F)来建模,而本文这套"短块 EEND + 聚类"的架构优势在于处理人多、录音长的情况。
5.2 数据量效应
论文从复合数据集里随机抽 75% / 50% / 25% / 5% 做子集(并保证小集合总是大集合的子集),重新训练。
Figure 2(宏平均 DER)
text
Macro DER
  28 ┤                                              ● Fbank  28.2 (+58.9%)
  26 ┤
  24 ┤
  22 ┤                                          ◆ WavLM-frozen ~21 (+27.8%)
  20 ┤                      ●               ▲ WavLM-updated 18.1 (+21.5%)
  18 ┤        ●       ●
  16 ┤  ●  ◆     ◆      ◆
  14 ┤  ▲  ▲     ▲      ▲
     └──100%───75%────50%────25%─────5%──> 训练数据比例
       Fbank:      +1.7%   +7.3%  +19.x%  +58.9%
       WavLM-frozen:+2.5%  +4.3%   +9.9%  +27.8%
       WavLM-updated:+2.0%  +2.0%  +14.1%  +21.5%
Table III(WavLM-updated 各数据集 DER,collar=0 s)
| 数据比例 | 小时数 | AMI | AISHELL-4 | AliMeeting | 宏平均 |
|---|---|---|---|---|---|
| 100% | 288.3 | 15.4 | 11.7 | 17.6 | 14.9 |
| 75% | 216.2 | 15.9 | 12.1 | 17.7 | 15.2 |
| 50% | 144.1 | 16.1 | 12.5 | 17.0 | 15.2 |
| 25% | 72.1 | 18.1 | 12.5 | 20.4 | 17.0 |
| ★5% | 14.4 | 19.7 | 12.8 | 21.7 | 18.1 |
① SSL 表示对数据稀缺的鲁棒性远超 Fbank。 数据砍到 5% 时,Fbank 退化约 60% ,而两个 WavLM 系统都不到 30%。
② 用 5% 数据(14.4 小时) 训练的 WavLM-updated,宏平均 18.1 ;而用全部 288.3 小时 训练的 pyannote 基线,宏平均是 ( 21.1 + 13.9 + 22.8 ) / 3 = 19.3 (21.1+13.9+22.8)/3 = 19.3 (21.1+13.9+22.8)/3=19.3。
5.3 仿真数据效果
论文从 LibriSpeech 生成了 1000 小时宽带仿真对话(每条含 2~4 人,比例 1:1:2),对比三种训练策略。
Figure 3(宏平均 DER)
| 真实数据量 | Fbank real | Fbank simu | Fbank simu+real | WavLM real | WavLM simu | WavLM simu+real |
|---|---|---|---|---|---|---|
| 100% | 17.7 | 27.5 | 17.8 | ★14.9 | 19.5 | 15.1 |
| 50% | 19.0 | 27.5 | 21.4 | ★15.2 | 19.5 | 15.9 |
| 5% | 28.2 | 27.5 | ★22.2 | ★18.1 | 19.5 | 18.3 |
simu一列在三行里都是同一个数(Fbank 27.5 / WavLM 19.5),纯仿真训练没用到真实数据,与真实数据比例无关。
结论
- 真实数据效果好于仿真数据(14.9 vs 19.5);
- 对 WavLM 系统,仿真数据无效;
- 唯一仿真有用的情况 是 Fbank + 5% 数据(28.2 → 22.2)。
当然这个结论也可能与作者的仿真方式有关。
六、总结
这篇论文在 pyannote 管线的基础上,用WavLM + Conformer + powerset 组合,达到一个很好的 DER 结果。代码开源在 DiariZen。