FNN通常来讲是单向多层的,信息从输入层开始不断传递至输出层。不难看出,"前馈"就是指输入信号的传递方向是前向的(朝向输出层的)。
FNN在"前馈"传递的过程中并不涉及权值更新。现代的FNN在一轮计算结束后会通过反向传播算法(BP算法)来将误差损失从输出层开始逐层向后传递,以实现权值的更新。BP是非线性映射的,理论上可以逼近任意连续函数。
注:没有BP 算法,则FNN只能输出预测结果,却无法根据误差优化自己。
1.感知器
感知器(感知机)是最基本的FNN,常见于求解分类问题。 值得注意的是,感知器没有BP支持,且也是最古老的ANN(1957年提出,只借鉴了神经元模型理论,但并没有实现学习机制)。
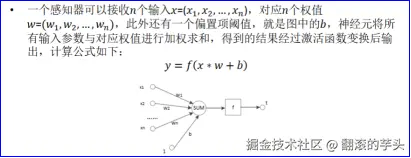
激活函数是对神经元 "加权输入和"(x * w + b)进行非线性变换的函数,记为"f(·)"。它的核心作用是为模型引入非线性,让神经网络能够拟合复杂的非线性关系。如果没有激活函数,感知器的输出会是 "输入与权重的线性组合"(y = x * w + b),此时整个模型是线性模型,只能拟合 "输入与输出呈直线关系" 的简单问题(如二分类中的线性可分问题)。但现实中大部分任务(如图像识别、自然语言处理)的输入输出关系是非线性的。最后,激活函数一般只有在激活变量不为0时才被激活(运作、处理、正常输出)。
偏置项 b 是感知器的 "可调节阈值",核心作用是提升模型的拟合灵活性,让神经元能适配不同的输入分布。没有偏置项的问题如果去掉偏置项 b,感知器的输出会变成 y = f(x * w)。此时,模型的 "激活条件" 完全由 "输入与权重的内积是否为 0" 决定 ------ 相当于强制要求 "输入加权和为 0" 是神经元激活的唯一分界点。但现实中,输入的 "有效激活区间" 不一定以 0 为中心,缺少偏置会导致模型无法灵活调整 "激活阈值"。
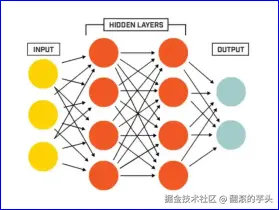
感知器的变体是多层感知器。学过深度学习的人可以于下图看出,其只有一个输入层、一个或多个隐藏层、一个输出层,且隐藏层均为全连接层。
2.BP神经网络
BP神经网络即带有BP算法的FNN(能够进行权值更新了)。BP网络中,激活函数要求 "处处可导",本质是为了让反向传播算法能计算梯度、优化算法能更新权重,最终实现神经网络的有效训练与收敛。
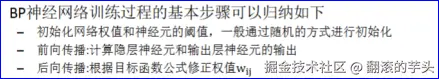
前馈过程中,模型只能在输出层得到 "全局损失"(比如预测值和真实标签的差距),但无法知道:这个损失是由 "输入层到隐藏层的权重" 导致的,还是 "隐藏层到输出层的权重" 导致的?隐藏层中某一个神经元的权重,对损失的影响到底有多大?
BP 算法通过链式法则,从输出层开始,将 "全局损失" 转化为各层的 "局部误差信号",逐层反向传递到输入层附近的隐藏层:
- 对输出层:误差信号源于损失函数(比如 MSE、交叉熵)对输出层神经元的梯度
- 对隐藏层:误差信号由 "下一层(更靠近输出层)的误差信号" 反向推导而来
知道了各层的误差信号后,BP 算法的第二个关键作用,是基于误差信号计算每个权重参数对损失的梯度(利用到各层的激活函数),比如:某隐藏层到输出层的权重 W1,其梯度为 - 0.8(绝对值大、符号负),说明 "增大 W1 能大幅降低损失",后续优化时就会重点往大调整 W1
BP 算法的最终作用,是为 "权重更新" 提供直接依据:有了各权重的梯度后,模型会结合优化器(如梯度下降法),按照 "梯度反方向" 更新所有权重
值得注意的是,损失函数的值只在BP开始时有用;损失函数只写于输入终端配备(常规情况下,隐藏层没有独立的损失函数,其损失由BP反向推导而来)
3.径向基函数神经网络(RBFNN)
RBFNN也是一种FNN,但RBF神经网络与BP神经网络的结构略有不同。RBF神经网络通常包含三个层:输入层、隐含层和输出层。但是,隐含层的每个神经元都是一个径向基函数(RBF),而不是BP神经网络中的节点。径向基函数的作用是将输入数据映射到高维空间,并计算每个神经元与输入数据之间的距离。隐含层的输出是所有径向基函数的计算结果的线性组合。输出层通常只有一个神经元,用于进行分类或回归预测。
注:基函数是数学中 "构建函数空间的基本单元",强调 "线性组合表示所有函数"------ 类似于泰勒展开(泰勒展开中,1、x、x^2... 其实就是一组基函数)
万能逼近定理表明:只要隐藏层神经元数量足够多,三层(输入层、单隐藏层、输出层)/单隐藏层的神经网络(比如RBF)就可以拟合任何一个函数。 BPNN虽然理论上 "单隐藏层足够",但实际应用中, BP 网络常需多层隐藏层才能拟合复杂非线性------即,在单隐藏层的前提下,BPNN(反向传播神经网络)通常需要比 RBFNN(径向基函数神经网络)更多的隐藏层节点才能达到相似的函数拟合效果(毕竟,BPNN就靠一个大的激活函数干活,而RBFNN在隐藏层有很多个径向基参与细化计算处理、再进行综合)
注:RBF 神经网络的激活函数特指隐藏层神经元使用的 "径向基函数"
相比之下,BP 网络的所有层权重都需通过反向传播 "迭代更新",参数多、计算量大,而 RBF 的权重数量更少、隐藏层更少,并且权重并不通过反向传播更新(通常会利用聚类算法计算),学习和推理速度远快于 BP。
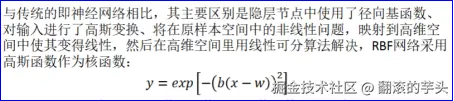
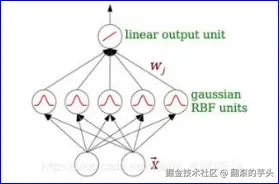
注:在深度学习中,"核"函数和卷积"核"没多大关联。 核函数(Kernel Function) 的核心思想源于传统机器学习(如支持向量机 SVM),但其本质是一种 "隐式高维映射工具":通过计算低维空间中两个样本的 "相似度",间接实现 "将低维非线性问题映射到高维线性空间" 的效果,从而让模型能更轻松地捕捉数据中的复杂非线性关系,且无需显式计算高维映射的具体形式(避免 "维度灾难")------RBFNN涉及到高维空间映射,因此需要核函数,而高斯函数是比较经典的核函数。