模型量化完全指南:GGUF、GPTQ、AWQ 怎么选
同一份权重,为什么发布页上挂着一串 Q4_K_M、Q8_0、AWQ 后缀?4bit 省下的是什么、丢掉的又是什么?前几篇里这些词反复出现,这一篇集中说清:量化的本质(显存为什么能除以二、除以四)、GGUF / GPTQ / AWQ 三套体系各自的适用范围,以及选档位的真实标准------不是"谁压得最狠",而是"你的显存配哪一档最划算"。
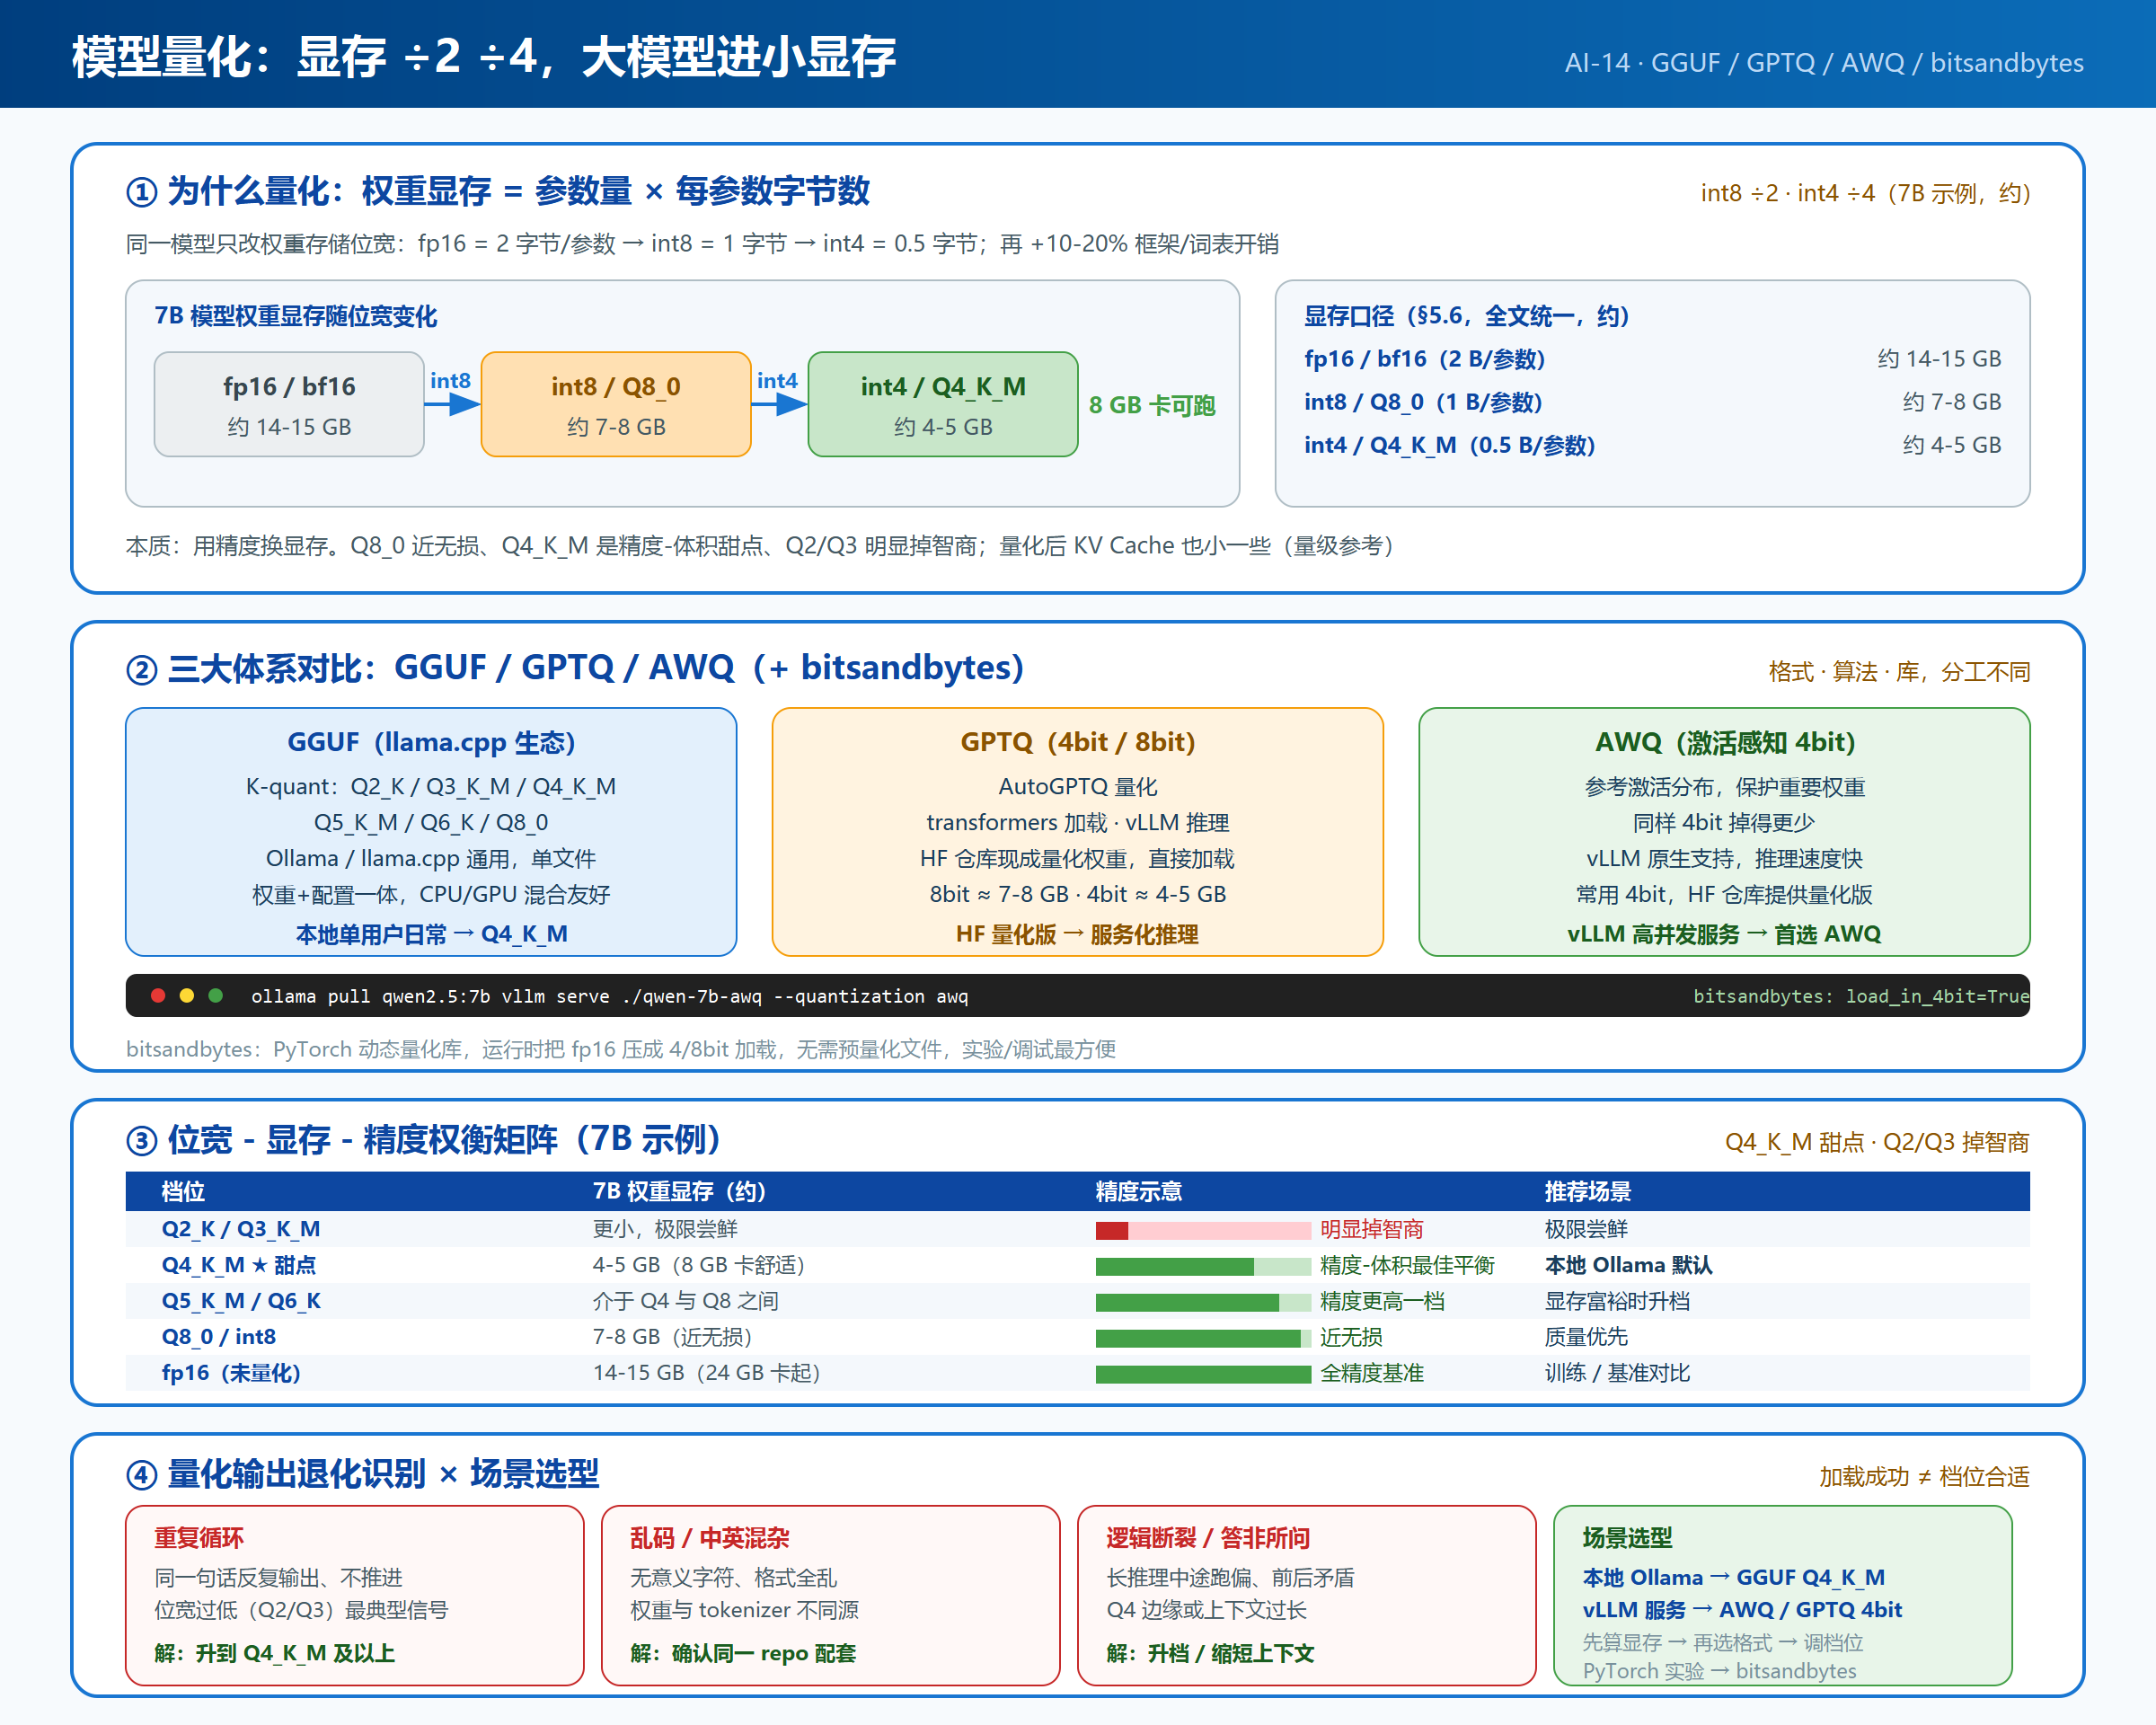
一、为什么需要它
量化的本质只有一句话:把每个参数的存储精度调低,用一点精度换一大截显存。 模型权重默认用 fp16/bf16 存,每参数 2 字节;量化到 int8 就是 1 字节(显存 ÷2),量化到 int4 就是 0.5 字节(显存 ÷4)。按《AI-05 显存计算与模型选择》的统一标准,7B 模型:fp16 权重约 14-15 GB → int8 约 7-8 GB → int4 约 4-5 GB------除以 2、再除以 4,就这么来的。
为什么这是必学内容?因为显存是本地部署第一瓶颈 :8 GB 的卡想跑 7B,fp16 根本装不下,4bit 才能舒适;24 GB 的卡想上 32B,也只有 Q4(约 20 GB 级)够得着;48 GB 专业卡才轮到 70B int4(约 40 GB+)。"模型量化""4bit 量化""AWQ 是什么"长期是本地部署的高搜索词,本质都是同一个问题:我的卡,配哪一档量化更划算?
还要建立预期:量化不是免费的。位宽越低,丢的信息越多 ------Q8 接近无损,Q4 是"大多数人日常问答感觉不出差距"的甜点,Q2/Q3 则会明显掉智商(输出重复、变笨、逻辑断裂)。所以本篇的结论不是"越省越好",而是按场景和显存选对档:个人本地用 GGUF Q4_K_M,高并发服务用 AWQ/GPTQ 4bit,PyTorch 里做实验用 bitsandbytes 动态 4bit。
还要补一个实际跑起来才会注意到的细节:量化省的不只是权重显存。生成时模型还维护着 KV Cache(已生成 token 的注意力缓存),它随上下文长度和并发增长;量化模型会把它一起压缩,整体占用更小(量级参考见《AI-05》)。这就是为什么 Q4 的 7B 在 8 GB 卡上开 4K 上下文还能留出并发余量,而 fp16 连加载都做不到------位宽降一档,权重和缓存同时变轻,余量是双重增加的。
二、环境要求
| 路线 | 环境要求 | 说明 |
|---|---|---|
| GGUF(Ollama / llama.cpp / LM Studio) | N 卡可选,纯 CPU 也能跑 | 装 Ollama 或下 llama.cpp 即可(《AI-07》《AI-12》),门槛最低 |
| AWQ / GPTQ(vLLM 服务) | N 卡 + CUDA + Python 3.9-3.12 | pip install vllm(《AI-13》),模型需先下好量化版 |
| GPTQ(transformers + AutoGPTQ) | N 卡 + CUDA + PyTorch | PyTorch 装对应 cuXXX 版 wheel(《AI-02》) |
| bitsandbytes(PyTorch 实验) | N 卡 + PyTorch | pip install bitsandbytes,4bit 对 N 卡支持好 |
三条路线的模型都来自 HuggingFace(或镜像):国内必配 HF_ENDPOINT=https://hf-mirror.com 或 ModelScope,下载细节见《AI-06 模型下载全攻略》。模型一律放非 C 盘,7B 级 Q4 约 4-5 GB、Q8 约 7-8 GB、fp16 约 14-15 GB。
三、安装与部署:三大体系各走各的路
3.1 GGUF 路线(Ollama / llama.cpp,K-quant 家族)
GGUF 是 llama.cpp 系的统一文件格式:量化权重 + 模型配置打进一个 .gguf 单文件,CPU/GPU 混合推理友好,Ollama、LM Studio、llama.cpp 三家通用(结构详解见《AI-12 llama.cpp与GGUF格式》)。它的量化档属于 K-quant 家族 :Q2_K / Q3_K_M / Q4_K_M / Q5_K_M / Q6_K / Q8_0,其中 Q4_K_M 是"精度-体积"甜点,默认推荐。
Ollama 拉取(默认档通常就是 Q4_K_M,带后缀可指定档,具体可用档以 ollama.com/library 页面为准):
ollama pull qwen2.5:7b
ollama pull qwen2.5:14b-instruct-q4_K_M
想自己量化(从已有权重生成目标档 .gguf),用 llama.cpp 仓库自带的 llama-quantize,Q4_K_M 为默认推荐档,按显存余量再选更高/更低档。
3.2 AWQ 路线(vLLM 服务首选)
AWQ(Activation-aware Weight Quantization,激活感知)常见 4bit :量化时参考激活分布,保住对激活重要的权重,同样的 4bit 掉得更少,推理快、服务吞吐高------这是它成为 vLLM 服务场景主流 4bit 选择的原因。做法:从 HF(或镜像)下载目标模型的 AWQ 版本,用 vLLM 起服务(命令见《AI-13 vLLM高吞吐推理引擎》):
vllm serve D:\models\qwen2.5-7b-awq --port 8000 --max-model-len 8192 --quantization awq4bit 权重体积与 Q4 同档(7B 约 4-5 GB),显存预算照《AI-13》第六节口径算。
3.3 GPTQ 路线(transformers + AutoGPTQ)
GPTQ 常见 4bit / 8bit ,属于 HF/PyTorch 生态:用 AutoGPTQ 量化的权重可直接被 transformers 加载,vLLM 也支持 GPTQ 量化模型 (加载时的量化参数名以 vllm serve --help / 官方文档为准)。8bit 档权重体积 ≈ int8(7-8 GB),4bit 档 ≈ int4(4-5 GB)。如果你的服务栈已经围绕 transformers 搭建、或需要 GPTQ 现成的量化权重,走这条路;纯追求服务吞吐时,AWQ + vLLM 通常是更省心的组合。
3.4 bitsandbytes 路线(PyTorch 里动态量化)
bitsandbytes 是 PyTorch 生态的动态 4bit/8bit 方案:不用提前量化权重文件,加载时一个参数就压下去,很适合"想在 PyTorch 代码里快速跑起来试试"的实验场景:
pip install bitsandbytes -i https://pypi.tuna.tsinghua.edu.cn/simple
python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B-Instruct")
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen2.5-7B-Instruct",
    load_in_4bit=True,   # bitsandbytes 动态 4bit
)
8bit 同理换一个参数(参数名以官方文档为准)。注意:bitsandbytes 4bit 对 N 卡支持较好,且它解决的是"实验时显存装不下",不是服务吞吐------要对外提供服务还是回到 3.1/3.2/3.3。
四、验证:三步确认量化生效、质量没掉
- 显存对账(关键) :
nvidia-smi看模型显存占用。7B 级:Q4 档权重约 4-5 GB、Q8 档约 7-8 GB、fp16 约 14-15 GB(均为权重量级,KV Cache 另计)。量化的账一眼就能对上:如果选了 4bit 却看到 14 GB 级的权重占用,说明量化根本没生效,大概率还是 fp16 在跑。 - 档位确认 :Ollama 用
ollama list看模型名后缀(如:7b-q5_K_M,可用后缀以 ollama.com/library 页面为准);vLLM 看启动日志里识别到的量化方式(应显示你传入的--quantization对应的格式);bitsandbytes 用model.is_loaded_in_4bit之类的属性查看(具体属性以官方文档当前版本为准)。 - 质量对比 :准备 5-10 个固定问题(中文常识、简单推理、代码各几个),量化版与未量化(或 Q8)版各跑一遍人工对比。通顺、要点齐全、无重复循环 = 通过;出现第五节说的三类信号就降档处理。
一个实测心得:Ollama 默认拉的多是 Q4_K_M,很多人第一次跑本地模型就是这档;而 vLLM 直接加载 HF 原始仓库时默认是 fp16,不显式换量化权重,24 GB 卡跑 7B 会白白浪费一半以上显存给权重------量化不是"锦上添花",是"决定装不装得下"的第一道开关。
五、进阶技巧
5.1 量化输出的退化识别(三大信号)
模型加载成功不等于量化档位合适------量化过低的典型症状是输出质量退化,而不是报错。三个识别信号:
- 重复循环:同一句话反复输出、不推进、停不下来------这是位宽过低的典型信号;
- 乱码 / 中英混杂 :输出无意义字符、中英文乱搅、格式全乱------除了位宽过低,还要重点怀疑权重与 tokenizer 不同源(两个来自不同 repo 的组件混用);
- 逻辑断裂 / 答非所问:短问题还能答,长推理中途跑偏、前后矛盾------Q4 边缘或上下文过长时常见。
我的实测经验:Q2_K 档的 7B 模型回答"介绍一下量子计算"会连续复读同一段话;换成 Q4_K_M 后立刻正常,显存也只多 1 GB 出头。这种"同题 A/B 对比"比看任何 benchmark 数字都直接,也是定位"位宽问题"还是"组件混用问题"的直接办法:重复循环先升位宽,乱码先查 repo 配套。
5.2 场景选型对照(与配图一致)
| 场景 | 推荐格式 | 推荐档位 | 说明 |
|---|---|---|---|
| 本地 Ollama 日常问答 | GGUF | Q4_K_M(默认甜点) | 显存富裕升 Q5_K_M / Q6_K(《AI-07》《AI-12》) |
| 质量优先、显存 ≥ 16 GB | GGUF | Q8_0 | 近无损,体积约为 Q4 两倍 |
| vLLM 多用户服务 | AWQ(首选)/ GPTQ | 4bit | 推理快、vLLM 原生支持(《AI-13》) |
| PyTorch 实验 / 调试 | GPTQ 8bit 或 bitsandbytes | 8bit / 动态 4bit | 加载即量化,不用手动转换文件 |
选型原则:先算显存、再选格式、最后调档位 。显存不够时优先降位宽(fp16→Q8→Q4),其次才动上下文长度------上下文是体验,位宽是底线;而 Q4_K_M 是日常问答的下限,再往下(Q3 及以下)只适合"24 GB 卡极限塞 70B"这类尝鲜场景,日常用会明显掉智商。
5.3 一句话带过 K-quant:Q4_K_M 为什么是甜点
GGUF 用的 K-quant 家族(Q2_K 到 Q8_0)是 llama.cpp 生态当前的主流量化方案:把权重拆成小块、分块量化,量化误差比整层一刀切的旧方式更小,同样 4bit 下日常问答基本可用------这就是"K"档被 Ollama 选作默认档的原因。选型时不用记复杂规则:日常用 Q4_K_M;显存富余想更稳升 Q5_K_M / Q6_K;质量优先用 Q8_0;Q4 以下(Q2_K/Q3_K_M)只建议"极限塞大模型"尝鲜,日常用会明显掉智商(量化过程与参数细节见《AI-12》)。
六、故障排查(按层定位)
| # | 症状(报错原文) | 层 | 原因 | 解决 |
|---|---|---|---|---|
| 1 | 模型加载成功但输出乱码/重复 | 量化 | 量化位宽过低(Q2/Q3)或 tokenizer 不匹配 | 升量化位宽(Q4_K_M 起);确认权重与 tokenizer 来自同一 repo |
| 2 | CUDA error: out of memory / torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate ... |
显存 | 模型/上下文/批太大,量化档没选对 | 降量化位宽(fp16→Q8→Q4);降上下文长度;nvidia-smi 查占用后清进程 |
| 3 | HuggingFace 下载卡住 / ConnectionError / 超时 | 网络 | 国内访问 huggingface.co 受限 | set HF_ENDPOINT=https://hf-mirror.com(Win)/ export HF_ENDPOINT=https://hf-mirror.com(Linux);或改 ModelScope(见《AI-06》) |
| 4 | CUDA driver version is insufficient for CUDA runtime version |
驱动 | 驱动低于框架所需 CUDA | 升级 NVIDIA 驱动(只升 Toolkit 没用),见《AI-01》 |
| 5 | ModuleNotFoundError: No module named 'torch' |
环境 | 激活了错误环境 / 全局 vs venv | which python / where python 确认解释器;重新 source .venv/bin/activate 再跑 |
| 6 | ImportError: DLL load failed while importing ...(Windows) |
依赖 | VC 运行库缺失 / 位数不匹配(32/64) | 装 VC++ 2015-2022 Redistributable x64;确保 64 位 Python(bitsandbytes 等 C 扩展库敏感) |
| 7 | Ollama 拉模型中途断(网络抖动) | 网络 | 大文件传输中断 | 重新 ollama pull(支持断点续传,继续拉即可,见《AI-07》) |
| 8 | CUDA error: no kernel image is available for execution on the device |
框架/CUDA | PyTorch 编译的 CUDA 版本与显卡架构不匹配 | 换与显卡架构匹配的 PyTorch wheel(pytorch.org 选择器),见《AI-02》 |
排错顺序照分层定位法走:先 nvidia-smi 确认驱动层,再 torch.cuda.is_available() 确认框架层,然后 nvidia-smi 看显存占用对不对账(量化显存对不上就按第四节第 1 步查"量化没生效"),最后才看输出质量。
七、本篇自检清单
- 能说出量化本质:每参数字节数降低,显存 ÷2(int8)÷4(int4),7B 权重 fp16 约 14-15 GB → Q8 约 7-8 GB → Q4 约 4-5 GB
- 能区分三大体系:GGUF(llama.cpp 生态、K-quant、Q4_K_M 甜点)、GPTQ(AutoGPTQ、4/8bit)、AWQ(激活感知 4bit、vLLM 推理快),以及 bitsandbytes 动态量化的适用场景
- 能背出选型结论:本地 Ollama → GGUF Q4_K_M;vLLM 服务 → AWQ/GPTQ 4bit;PyTorch 实验 → bitsandbytes
- 会用
ollama pull(带档位后缀)、vllm serve --quantization awq、load_in_4bit=True三条路线分别把量化模型跑起来 - 会用
nvidia-smi显存对账,判断"量化是否生效" - 能识别量化退化的三大信号(重复循环 / 乱码混杂 / 逻辑断裂)并给出对应解法
- 遇到
CUDA out of memory知道先降位宽、再降上下文、最后清进程