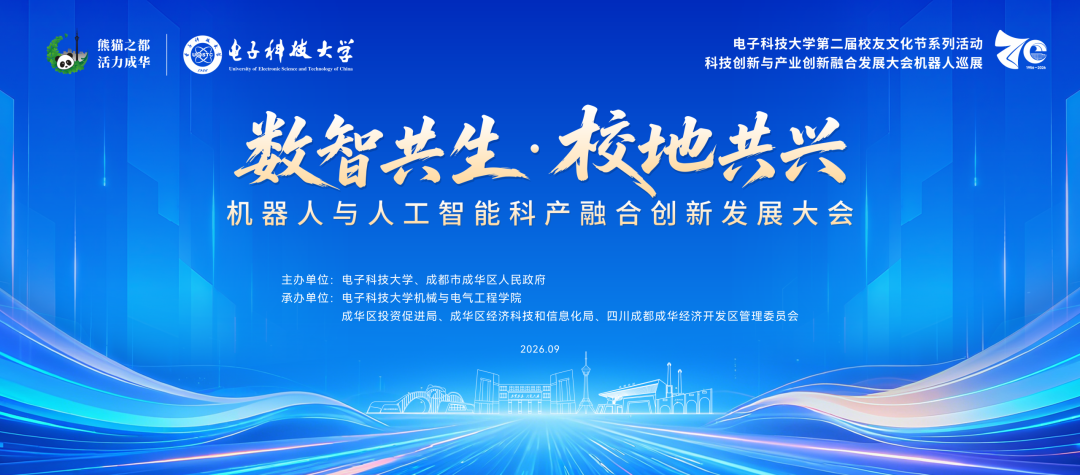
9月26日、27日,电子科技大学沙河校区逸夫楼前广场热闹非凡。作为电子科技大学建校70周年暨第二届校友文化节系列活动之一,由电子科技大学与成都市成华区人民政府共同主办的**"数智共生·校地共兴"机器人与人工智能科产融合创新发展大会及机器人巡展**在此举行。
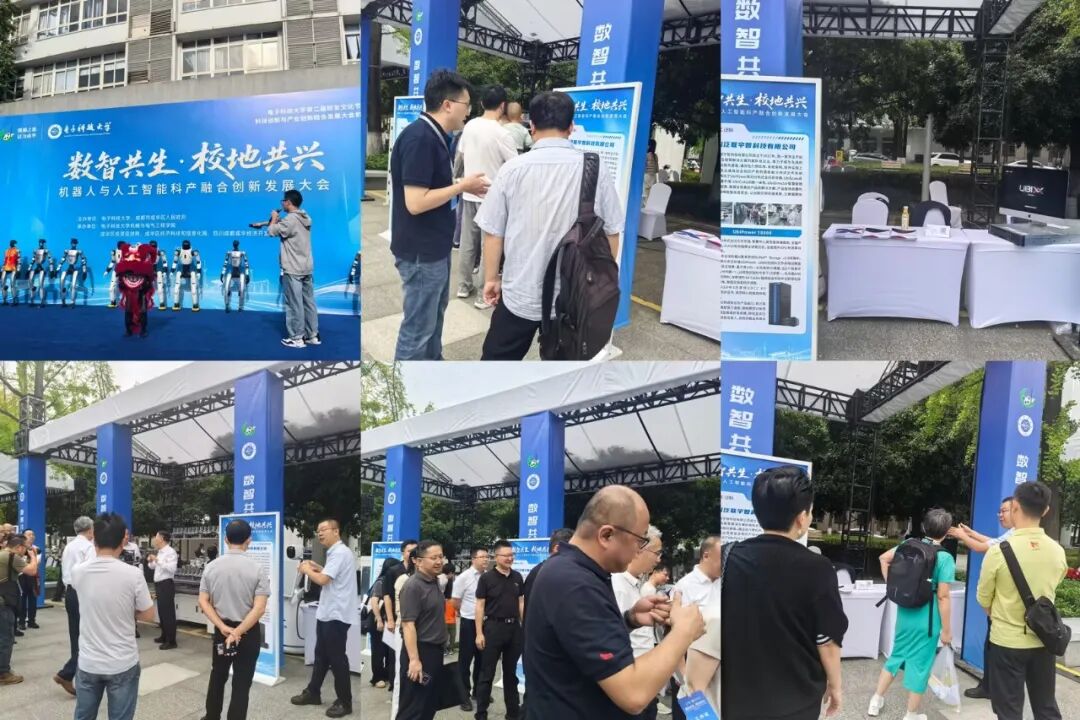
广场上,人形机器人轮番登台、四足机器狗表演特技、熊猫造型机器人翻滚招手、工业协作设备与智能医疗装备静候体验。而在一众机器人载歌载舞、吸睛无数的展台之中,泛联的展位显得有些与众不同:这里没有灵动展演的人形机器人,陈列的是看上去并不起眼的存储设备,屏幕播放的是产品架构与测评结果。参展人员为到访的校友、来宾热情讲解高性能存储背后的技术价值。泛联,一家专注于创新存储产品及智算解决方案的高科技企业,为什么会出现在机器人展上?
看不见的"含金量",藏在存储里
今天的人形机器人、四足机器人,越来越多开始跑大模型------视觉理解、动作规划、语言交互,都离不开AI训练推理。而模型不是凭空来的:海量传感器数据、遥操作数据、仿真数据,需要被采集、标注清洗,并反复用于训练与迭代,每一步都离不开存储。
普通观众看机器人跳舞觉得很酷;但懂行的校友和行业专家,目光会自然落到背后的算力链路上。训练一个大模型,动辄需要数千张GPU跑上数周;每隔几小时就要保存一次Checkpoint(模型快照),单次快照从数十GB到数TB不等。存储带宽一旦跟不上,成百上千张GPU只能集体空转,每一秒空转都是真金白银。
训练之外,推理同样离不开存储。大模型推理,一靠"加载快",二靠"记性好"。启动时,几百GB的模型权重需从存储快速加载到GPU,加载慢,服务上线就慢。运行时,每轮对话还要记住历史内容,这些记忆叫 KV Cache。但 GPU 显存有限,长上下文、高并发下根本存不下,导致重复计算、响应变慢、成本飙升。存储的作用,就是既做模型的"高速装载机",又做 KV Cache 的"超大记忆仓库":模型秒级加载,KV Cache 随取随用。GPU 不空等、不反复算,推理更快、并发更高、成本更低。
机器人是舞台上的明星,存储则是幕后那个"不抢戏但不能掉链子"的角色。
让训练不等,推理不卡的存储底座
这次校庆展上,泛联带来的明星产品,是刚在全球权威AI基准测评MLPerf Storage v3.0中交出亮眼成绩单的分布式全闪存存储------UbiPower 18000。
本次测评吸引了全球19家顶尖科技企业参与,泛联是业内唯一完整跑完AI文件存储训推基准全部10个测试场景的厂商。送测的UbiPower 18000,按每U归一化性能统计(每U归一化,指单位机柜空间内所能提供的有效存储性能),在10个训推测试场景中斩获8项第一(含并列第一),26项核心性能指标中有15项位列第一。在考验读写带宽的Checkpoint场景Llama3-450B、Llama3-1250B两项测试中实现每U读写带宽双双登顶。在KV Cache推理加速场景Llama3-8B Storage only、Llama3-70B Storage only测试中,每U读写带宽、每U Token吞吐量均取得第一的优异成绩。实现训练、推理双场景同步领跑。
这份成绩的背后,依托于UbiPower 18000"一机多模,训推一体"的架构优势:单套集群同时兼顾训练与推理,系统资源支持动态调度、弹性互通;训练时以高带宽支撑Checkpoint高速保存恢复,缩短GPU等待;推理时支持KV Cache卸载,加速推理响应、提升推理并发,让GPU利用率最大化。
机器人台前绽放,存储幕后铸基
存储的高性能优势,对机器人企业意味着更实际的价值:同样的GPU集群,存储越快,有效训练时间占比越高,单位成本越低;模型迭代更快,机器人才能更快学会新动作。
回到开头那个问题------存储厂商,为什么出现在机器人展上?因为机器人能否"跑"起来、跑得好,背后离不开数据的高效存储与快速调用。从训练Checkpoint的高带宽保存,到推理KV Cache的实时卸载与复用,存储直接影响着GPU的利用效率和推理成本。当机器人在台前亮相时,泛联在幕后把数据底座打牢。
此次亮相电子科技大学校庆展,对泛联而言不仅是一次产品展示,更是一次与机器人产业深度对话的契机。机器人是AI技术集大成的载体,而存储是AI数据基础设施的基石。泛联希望以高性能存储为纽带,与机器人企业、科研机构在数据采集、模型训练、推理加速等环节展开合作,共同推动机器人从"能动"走向"会思考"。泛联期待与产业伙伴协同,推动机器人智能化与数据基础设施持续完善。