导读 :在生产环境中,无休止的模型微调(Fine-tuning)正逐渐暴露出其沉重的工程代价:高昂的算力开销、不可逆的灾难性遗忘,以及复杂的跨租户隔离风险。2026 年 10 月的多项顶尖研究(包括 Meta 与 Berkeley 联合提出的 Agent Plasticity 理论、Skill-V 可验证技能库,以及大规模 Agent Skill Evolution 实证)正在宣告一种全新的范式转向:真正的在线终身学习不必改造模型参数,而是应当在"底座模型权重绝对冻结(Frozen Weights)"的前提下,构建一套独立于神经元的外部程序性记忆(Procedural Memory)与 SkillOps 自演进控制平面。
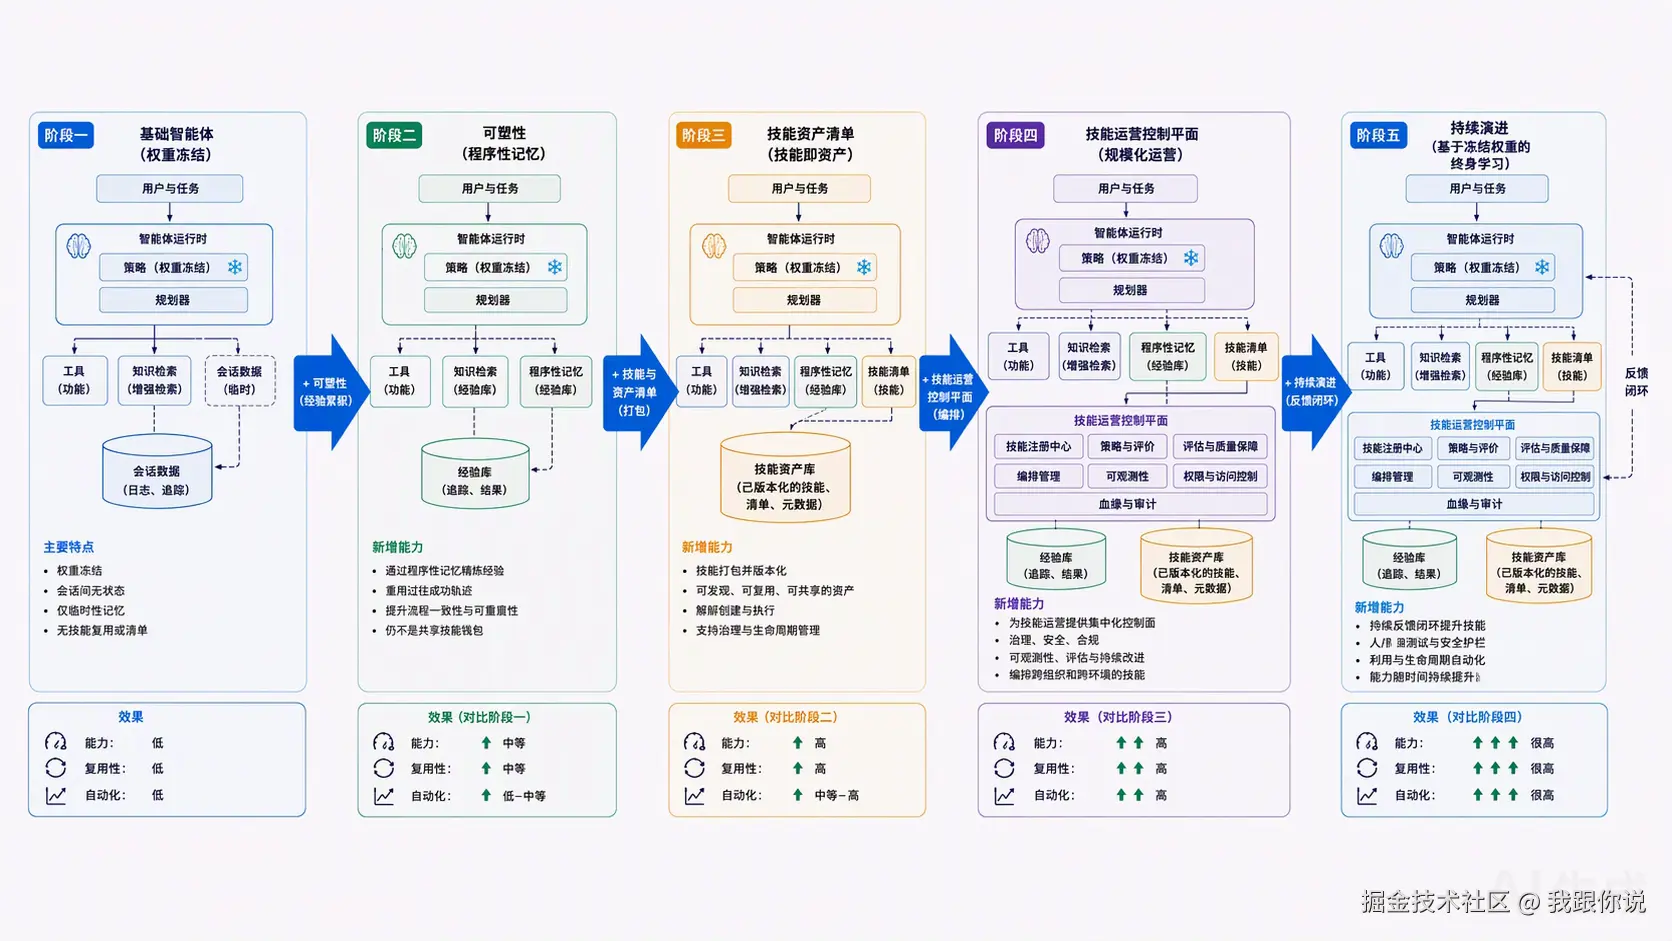 概念示意:从冻结权重的基础智能体,到由程序性记忆和技能运营控制平面支撑的持续演进系统。
01. 终身学习的工程困境:为什么我们必须冻结模型权重?
想象一个极具代表性的企业场景:
公司来了一位能力拔尖的 AI 助手。第一天处理退款时它绕了远路并报了错,工程师在会话中耐心地纠正它:"遇到这类订单,必须先查支付流水,再核对幂等键,最后才能决定是否重试。"它点头回应:"已深刻理解并吸取教训。"
然而第二天,当面对完全相同的业务单据时,它却像遭遇了失忆症,把昨天的坑原封不动地重新踩了一遍。
目前绝大多数自主智能体(AI Agent)都停留在这种"单次会话聪明,跨越任务失忆"的断层状态。
面对这一困境,行业最习惯的技术本能往往是: "那就收集数据,继续微调(Fine-tuning)模型参数,把教训焊进神经元里。"
1. 持续微调的"三重工程代价"
在单体的实验室玩具中,微调(SFT)或许是包治百病的解药;但在服务数百个业务线、支撑高并发线上流量的生产系统中,频繁修改底层模型权重,无异于一场工程灾难:
① 灾难性遗忘(Catastrophic Forgetting):捡了芝麻,丢了西瓜
根据前沿持续微调研究(Luo et al., arXiv:2308.08747),让模型按顺序学习五类新任务后,BLOOMZ-7.1B 在领域知识、逻辑推理和阅读理解上的能力底盘分别暴跌了 18.37%、13.62% 和 26.75% 。为了让模型记住某个特定客户的退款规则,反向传播算法极易撕裂它原本坚固的通用推理逻辑。
② 轻量化幻觉:LoRA 无法拯救系统复杂性尽管 LoRA 压缩了参数,S-LoRA 实现了单卡并发 2000 个适配器,但"更轻"不等于"零负担"。企业必须深陷底座、权重文件、训练语料与业务代码之间极度繁琐的血缘追踪。更致命的是,微调根本无法解决多租户场景下的数据硬隔离与合规责任归因。
③ 迭代脱节:用"月级"的兵器,打"天级"的仗业务线真实的 SOP、权限策略和 API,通常是以天甚至小时为单位演进 的;而模型权重的更新,必须历经数据清洗、对齐、红队安全审查、全量评测与金丝雀灰度,其发布周期必然以月为单位。这种系统节拍的彻底错位,注定了微调无法承载高频的业务演进。
scss
           ┌────────────────────────────────────────────────────────┐
           │                  双层学习架构工程分工                    │
           └────────────────────────────────────────────────────────┘
                                        │
        ┌───────────────────────────────┴───────────────────────────────┐
        ▼                                                               ▼
 ┌─────────────────────────────┐                 ┌─────────────────────────────┐
 │  底座参数层 (Weight Layer)   │                 │  外置技能层 (Skill Layer)    │
 ├─────────────────────────────┤                 ├─────────────────────────────┤
 │ • 属性:低频迭代、全局通用   │                 │ • 属性:高频演进、团队特定  │
 │ • 载体:模型内部参数权重     │                 │ • 载体:SKILL.md / 脚本 / SOP│
 │ • 定位:像【操作系统】内核   │                 │ • 定位:像【应用程序】热更新│
 │ • 职责:提供通用语言、推理与 │                 │ • 职责:沉淀特定环境避坑经验│
 │         常识认知能力         │                 │         与确定性动作规范    │
 └─────────────────────────────┘                 └─────────────────────────────┘
2. 架构定调:两层学习的分工哲学
因此,冻结权重并非拒绝学习,而是一种成熟的系统工程分工:
- 能力底座(Capabilities)沉淀于参数:通用编程常识、复杂指令遵循与跨模态表征,必须依赖基座模型的参数供给;
- 环境经验(Experience)外置于技能库:特定系统中的避坑指南、接口鉴权顺序与排障策略,应当沉淀在完全透明、可编辑、可隔离、可秒级回滚的外置技能库中。
我们不应当为了修改一个快捷键而重装整个操作系统。真正优雅的 Agent 终身学习,必须发生在冻结的权重之外。
02. 可塑性(Plasticity):量化智能体的"经验转化效率"
如果模型参数保持绝对冻结,我们该如何科学判断一个 Agent 到底有没有"自学能力"?
2026 年 10 月 6 日,来自 Meta Superintelligence Labs、UC Berkeley、华盛顿大学与普林斯顿大学的联合研究团队(Singh et al., arXiv:2610.08902)正式提出了颠覆性的评价维度------Agent Plasticity(智能体可塑性) 。
1. 从"期末成绩"到"转化投资回报率(ROI)"
传统排行榜只关注 Agent 的最终绝对得分(Endpoint Capability),但这完全掩盖了模型的学习潜质。可塑性理论关注的是:花同样的试错与反思成本,谁能把踩过的坑最有效地转化为未来未知任务上的表现增益?
论文将可塑性定义为在保留任务(Held-out Tasks)上的得分增益与学习成本的比值:
- 分子( ST−S0) :Agent 在经过多轮任务反思与演进后,在从未直接训练过的全新留出任务上的净能力提升。这直接杜绝了 Agent 靠"硬背死记具体答案"来刷分。
- 分母( CT) :Agent 在演进生命周期中所消耗的全部学习开销(包括执行试错、自我批评、经验抽象所调用的 Token 与计算费用)。
2. 真实测算:终点能力与学习效率的惊人分流
论文将可塑性归一化换算为"每投入 1,000 美元学习成本所获得的能力净增益分值"。在复杂棋类等环境的综合测试中,各主流前沿模型展现出了巨大的分化:
| 评测模型 | 终点绝对能力表现 | 成本归一化饱和可塑性 ( Pscore) | 学习转化特征 |
|---|---|---|---|
| GPT-5.6 Sol | 极高 (Tier 1) | 298 | 高转化率:反思精炼,能迅速凝练出高价值跨任务规则 |
| Claude Opus 5 | 极高 (Tier 1) | 233 | 高转化率:具有极强的情境泛化与工具抽象能力 |
| Claude Fable 5 | 中等 (Tier 2) | 57 | 中等转化率:试错开销相对偏高,规则泛化偏窄 |
| Claude Opus 4.8 | 良好 (Tier 2) | 14 | 低转化率:反思冗余,需多轮反复踩坑才能形成微弱有效经验 |
| GPT-5.6 Luna | 基础 (Tier 3) | 0 | 零可塑性:Token 持续空转,无法形成有效的留出任务迁移 |
ini
    留出任务增益 (Score Gain)
             ▲
             │               / GPT-5.6 Sol (P=298)
             │              /
             │             /  Claude Opus 5 (P=233)
             │            /
             │           /
             │          /     Claude Fable 5 (P=57)
             │         /────
             │        /─────── Claude Opus 4.8 (P=14)
             │       /
             │      /────────────────────────── GPT-5.6 Luna (P=0)
└─────┴───────────────────────────────► 学习与反思成本 ($)这一实验数据彻底撕破了行业认知误区:静态评测第一名的模型,绝不等于最适合做自主演进的模型。
有些模型虽然初始能力极高,但它的"自我反思"往往冗长而空洞,像一位才华横溢却从不总结工作流的专家,长期运营成本极高;而高 Plasticity 的系统则像一个训练有素的工程团队,能迅速把一次偶发故障结晶成一本标准运行规程(SOP)。
3. 持久化资产清单(Inventory of Artifacts)的现实阻碍
在测试中,Agent 的临时上下文在任务结束后全部清空,留给下一代实例的唯一纽带是外置资产清单(Python 工具、自然语言规则、参考文档) 。
然而,拥有工具箱并不代表工作就能做对。实验暴露出一个极为深刻的工程真相:
- 建立了强资产复用机制的 Agent,在相关决策上的失败率从对照组的 0.38 骤降至 0.16;
- 但在这些剩余的 0.16 失败案例中,高达 83% ~ 99% 的错误发生在其已经成功调用了相关工具的情况下!
这说明:检索与调用只是门槛,真正的瓶颈在于规则的质量、上下文适配度以及执行参数的精密对齐。
03. 认知三元论:为什么传统 RAG 无法构建程序性技能?
为什么市面上堆砌了大量文档检索(RAG)的 Agent,在真实业务中依然错漏百出?答案在于记忆类型的认知错位。
根据认知科学与 CoALA(Sumers et al., 2023)对语言智能体架构的经典梳理,系统的长期记忆必须严格划分为三个截然不同的层次:
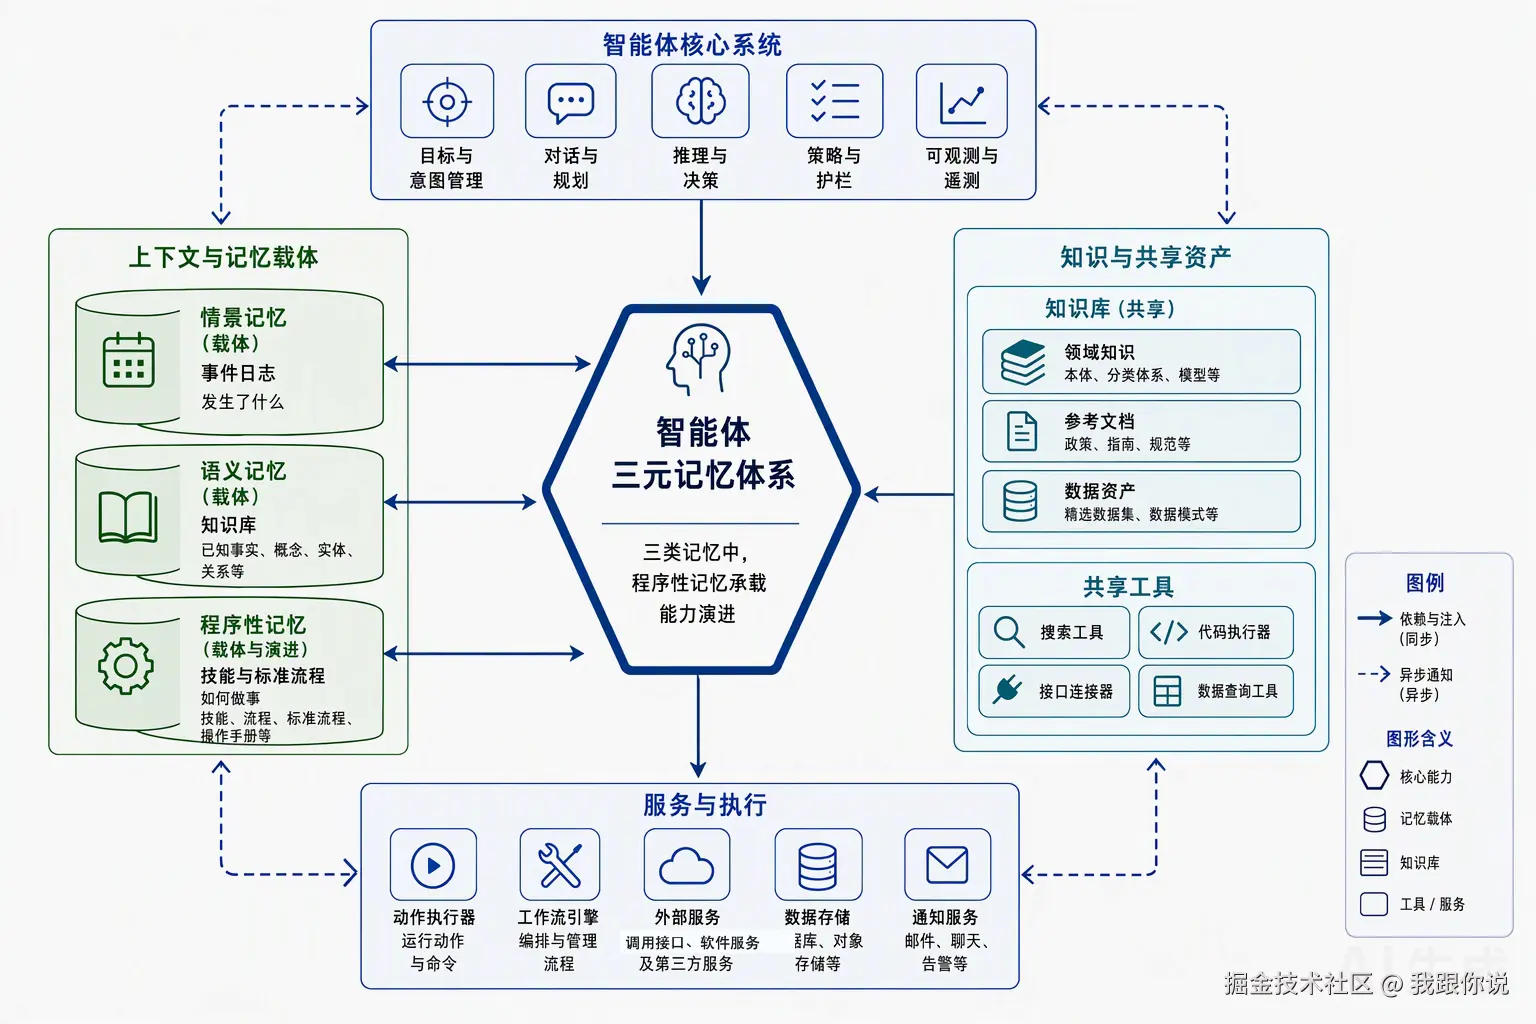 概念示意:智能体三元记忆结构------情景记忆(发生过什么)、语义记忆(世界事实)与程序性记忆(SOP与操作规约)。
记忆类型全景对比矩阵
| 记忆维度 | 核心回答的问题 | 常见系统物理载体 | 典型表现形式 | 局限性与风险 |
|---|---|---|---|---|
| 情景记忆 (Episodic) | "上次任务发生了什么?" | Redis 会话缓存、持久化日志轨迹 | "10:05 处理订单 1002 时,调用支付接口返回 504 Gateway Timeout" | 充斥大量瞬时噪音;若全量保留,上下文将在 3 轮内爆满 |
| 语义记忆 (Semantic) | "客观世界的概念与事实是什么?" | 向量检索库 (Chroma/Milvus)、知识图谱 | "生产环境订单数据库的只读从库域名为 db-ro.internal" |
擅长回答"是什么",但完全不具备指导"下一步该干什么"的执行能力 |
| 程序性记忆 (Procedural) | "遇到特定情境,标准化操作流是什么?" | 本地代码仓库、SKILL.md 规则集合、可执行工具脚本 |
"遇 504 超时,严禁盲目重试;必须先调 check_tx_status 查单,确认未扣款后方可补单" |
这是让 Agent 真正获得确定性执行力、具备可审查性和回滚能力的唯一记忆形态 |
传统 RAG 只能扮演图书管理员的角色,它能告诉 Agent"数据库连接池最大是 100";但只有显式的程序性记忆,才能在突发流量洪峰时强行约束 Agent 按照正确的步骤去限流降级。
从"便利贴"到"工业级技能"的四道门槛
把一次失败的惨痛教训,沉淀为真正能够拦住系统崩溃的程序性记忆,必须在工程上跨越四道铁闸:
- 阈值一 错误精准捕获:从数千行的执行日志中切除环境噪音,精准定位状态转移崩塌的"案发现场"。
- 阈值二 深度因果归因:摒弃大模型常犯的"表面关联",排除偶然的网络抖动巧合,刺透失败的真实逻辑根因。
- 阈值三 动作化表征 (Actionable) :严禁输出空洞的口号,必须将反思翻译为具象的 API 参数规约、Bash 退出码断言或强制工具前置调用。
- 阈值四 影子回归 (Shadow Replay) :在新规则上线前,强制进入历史沙箱回放。任何引发历史成功用例失败(回归)的规则,一律格杀勿论。
💡 核心洞察 : 没有经过严苛执行验证的反思,充其量只是贴在上下文里的一张"便利贴";只有经受住了反事实验证的经验法则,才配被系统称之为"技能"。
04. 微观机制:什么样的经验规则才能让 Agent 免于犯错?
如果我们要把经验落盘为具体的规则文档,什么样的表述方式才能产生真正的控制力?
大规模实证研究《Agent Skill Evolution》(Wang et al., arXiv:2610.04832)对 3,159 个规则文件、2,608 次演进版本与 21 个主流模型进行了深度分析,给出了极具指导意义的定量结论:
1. 笼统原则是"毒药",具象约束才是"良药"
在 prompt 工程中,很多人喜欢写"请务必仔细小心"、"确保代码高质量"。在自主智能体系统中,这种笼统的原则不仅毫无约束力,反而会白白污染上下文。
实证数据显示:在成功的技能版本演进中,有高达 41% 的修订,其核心动作是增加具体的检查指令(明确点出 CLI 命令、工具名、文件绝对路径或状态退出码)。这种"极度硬核"的规约化修订,带来了降维打击般的质变:
- 动作合规率激增 :在 80 个标准沙箱任务上,加入具象约束后,编码 Agent 严格执行标准动作的比率平均提升了 +0.23 (95% CI:
[+0.15, +0.31])。 - 任务绝对胜率提升 :在复杂的可判定任务中,人类盲评正确率平均净增 +0.10 (95% CI:
[+0.04, +0.17])。 - 软性提示的彻底溃败 :对比那些仅仅在上下文中堆砌"模糊关键词"的软性提示,具象化规则 额外带来了 0.15 的净遵从度提升。
2. 负面与正面规约的设计范本
yaml
# 典型低效规则(正确但毫无价值的废话)
# 对模型的行为修正率几近于 0,白白占用上下文 Token
rules:
  - "在提交代码或下发配置前,请务必保证质量,并做好充分的错误捕获。"
  - "如果接口调用异常,请仔细分析日志,并尝试以优雅的方式进行重试。"

--------------------------------------------------------------------------------

#  生产级黄金规则(具象、确定、带有不可违背的断言与停止条件)
# 显著降低动作偏航,产生强约束力
---
name: git-commit-verify-standard
trigger_patterns:
  - "git commit"
  - "git push"
---
rules:
  1. 执行任何 git commit 之前,必须在终端强制前置运行代码静态扫描:
     `npm run lint -- --quiet`
  2. 捕获命令退出码:
     - 若退出码非 0,绝对禁止使用 `--no-verify` 强行绕过,立即中断任务并输出报错文件列表;
     - 若退出码为 0,方可继续组装 commit message 并提交。
  3. 严禁单次提交超过 20 个文件的变更,若检测到暂存区文件 > 20,强制拆分为原子 commit。
3. 上下文膨胀悖论与按需装载(On-demand Loading)
经验规则不是越多越好。当规则库膨胀时,全量加载将引发灾难性的系统副反应:
- Token 开销膨胀 :实测显示,若将技能库全文一股脑注入上下文,单个任务的端到端 Token 消耗将急剧攀升 37% ~ 57%(平均约 50%) ;
- 注意力涣散:过长的系统指令会引发"迷失在中间(Lost in the Middle)"效应,导致 Agent 忽略初始用户意图。
解法:三级按需装载架构(Three-Tier On-demand Hierarchy)
- Tier-1 索引层(~100 Tokens) :在系统主上下文仅常驻技能的唯一 ID 与极简触发描述(Name & Description);
- Tier-2 规则层(< 5,000 Tokens) :仅在命中特定任务关键词或触发场景时,通过前置路由器动态注入具体规约正文;
- Tier-3 资产层(On Execution) :辅助执行的大型 Python 脚本、参考文档与历史用例,仅在模型发出显式调用指令时挂载到沙箱容器中。
工程权衡数据 :采用按需装载机制后,虽然动作执行率的增益从全量挂载的
+0.23微跌至+0.12(保留了约 51% 的增强效果,区间[28%, 75%]),但将全流程的 Token 冗余开销降低了近 90% ,在工业落地中达到了最佳的综合 ROI。
05. 架构沉淀:工业级 SkillOps 双平面控制系统
基于上述认知与实证,一个生产级具备自演进能力的智能体系统,必须彻底摒弃"单体 Agent 既干活又反思"的混乱设计,在系统架构上实现数据平面与控制平面的彻底解耦。
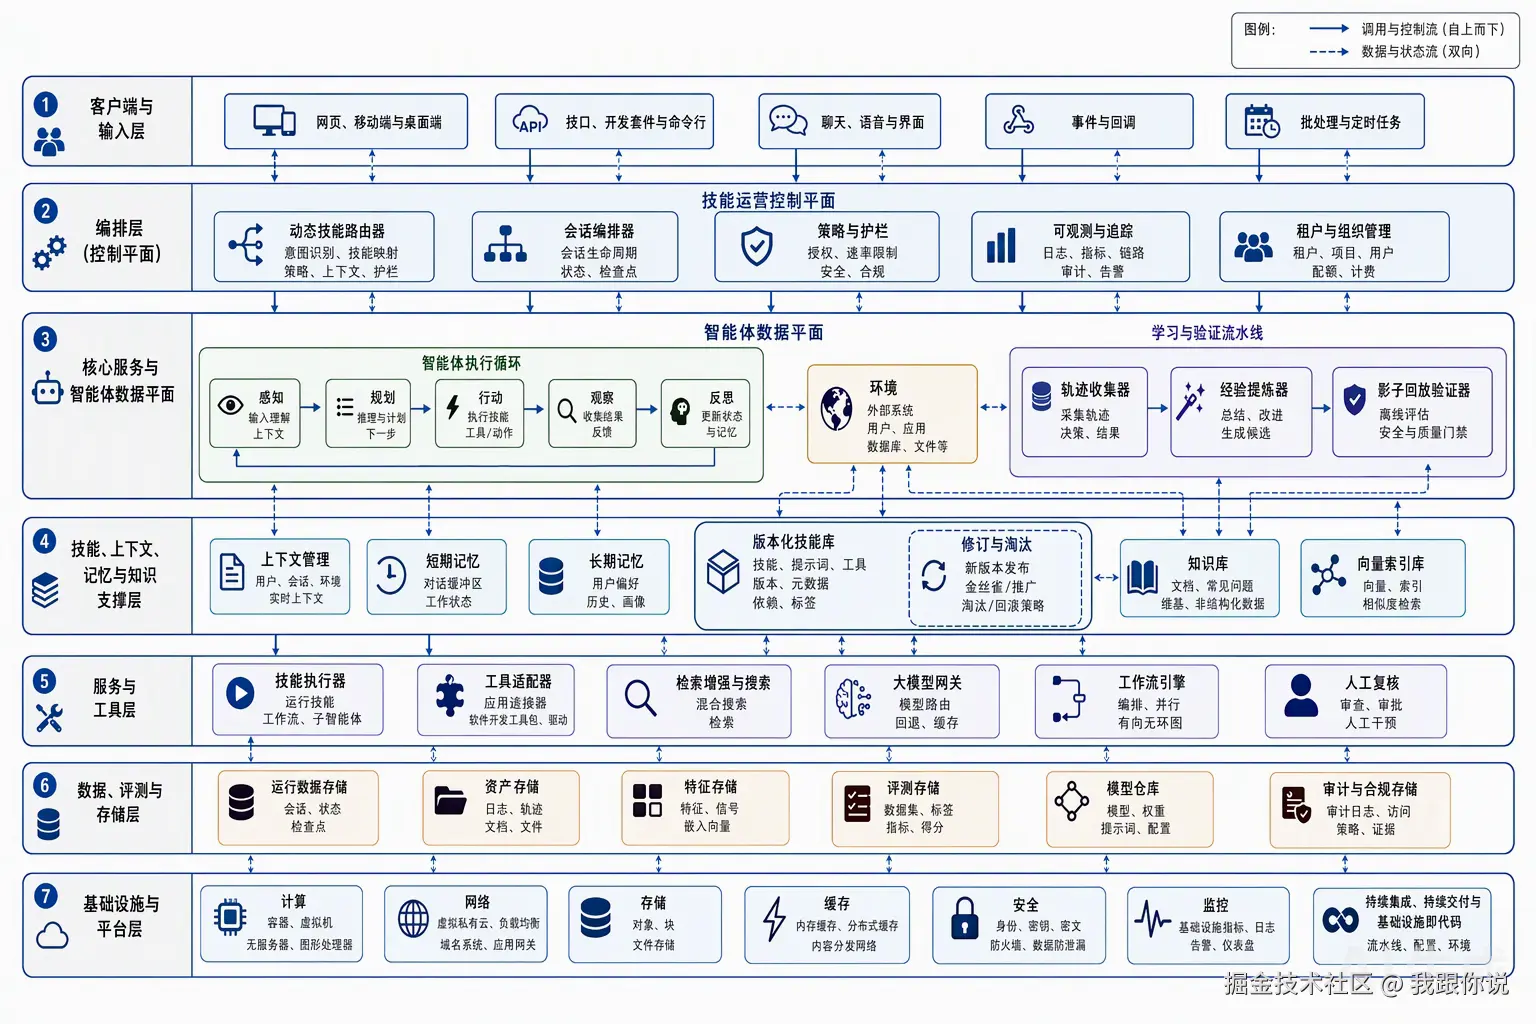 概念示意:数据平面负责在线低时延执行,控制平面负责经验提炼、影子回放验证与版本治理。
1. 数据平面(Data Plane):保障在线执行的吞吐与稳定性
数据平面的唯一 KPI 是以最低的时延与 Token 成本,高确定性地交付业务结果:
- 它绝不运行复杂的自我反思推理流,避免在用户会话链路中增加几十秒的额外时延;
- 技能路由器负责在毫秒级内完成 Tier-1 匹配,将筛选后的规约切片动态拼入当轮 Prompt;
- 沙箱环境对每一次工具调用的返回码、网络调用包与 I/O 输出进行完整的被动式遥测录制,并异步投递到事件总线。
2. 控制平面(Control Plane):经验的严格守门与进化
控制平面完全运行在后台,是智能体系统的"免疫系统与进化工坊":
核心机制 A:证据守门人与影子回归回放(Skill-V 机制)
一个能够自己写规则的 Agent,绝不能拥有直接上线规则的特权。 最新发表的 Skill-V 研究(arXiv:2610.11781)设计了极其严格的"证据守门人(Evidence Gate)":
- 当经验提炼引擎生成一份新的候选技能文件后,系统首先进行静态 AST 语法检查与权限范围断言;
- 随后拉起独立的影子沙箱,调取历史积累的任务用例集进行反事实回放(Counterfactual Replay)。
Skill-V 的实测治理数据 : 在缺乏证据守门机制的基线系统中,Agent 提出了 46 次技能变更,但其中只有 37 次没有造成历史任务回归(近 20% 的变更引入了隐形 Bug );
而在接入完整的证据守门人后,系统极其克制地只批准了 10 次更新,但这 10 次上线后在历史回归测试集上实现了 100% 的非回归通过率!
核心机制 B:基于反事实回放的技能消歧与淘汰(SkillBrew 机制)
技能库绝不能只增不减。SkillBrew 研究(arXiv:2605.29440)提出了基于留一法(Leave-one-out)的反事实评估机制,系统支持对规则的 Add(新增)、Keep(保留)、Rewrite(改写)和 Remove(删除):
- 控制平面定期在后台剔除单条技能并回放任务,如果移除某条规则后任务成功率没有统计学下降,该规则立即被标记为"冗余废代码"并自动注销;
- 在 ALFWorld 任务中,这套治理机制将基线 ReAct 的 31.2% 成功率大幅拉升至 59.0% ;在 WebShop 中将成功率由 19.5% 翻倍至 38.4%,同时技能库在经历 9~10 轮迭代后自然收敛趋稳,彻底避免了规则无限通胀。
核心机制 C:最高合法决策------"保持现状(no-op)"
在传统组织复盘中,团队经常陷入"为了证明开会有用,必须强行写出整改措施"的形式主义陷阱,智能体反思同样存在这种过度拟合冲动。
真正成熟的 SkillOps 控制平面,必须把 no-op(确认属于小概率环境噪音,不对技能库做任何变更)视为一个一等公民级别的合法且经常正确的决策选项。
06. 治理指标矩阵:如何度量一套技能库的健康度?
评价一个团队的 Agent 自演进水平,最业余的做法是统计"技能库里沉淀了多少个文件"。一个拥有上千条规则却互相死锁、冲突不断的技能库,只是一个随时会引爆系统的技术债垃圾场。
生产级系统必须建立起全生命周期的技能质量工程量化矩阵:
| 指标维度 | 核心量化公式 / 判定依据 | 目标阈值基线 | 异常处置动作 |
|---|---|---|---|
| 可塑性转化率 (Plasticity ROI) | ΔHeld-out Score/Learning Cost | 持续维持在正向斜率 | 若 ROI 出现边际递减甚至归零,立即暂停该领域自动学习,介入人工分析 |
| 规则命中率 (Hit Rate) | 相关业务场景总调用次数特定规则被 Router 激活次数 | >85 | 若命中率低下,重构该规则的 YAML 触发语义与关键词索引 |
| 执行有效转化率 (Action Efficacy) | 规则总激活次数规则被激活且任务成功且动作合规数 | >90 | 若激活后依然频繁报错,判定为"低质量/幻觉规则",下线并重新提炼 |
| 非回归通过率 (Zero-Regression) | 历史标准基准用例总数新版本通过历史用例回归数 | 100% (硬性死线) | 任何引入历史能力倒退的候选规则,一票否决,直接阻断合并 |
| 规则腐化淘汰率 (Eviction Rate) | 当前活跃规则总数季度内通过 SkillBrew 淘汰规则数 | 10 | 长期淘汰率为 0 意味着缺乏审慎清理机制,必须强制执行死代码扫描 |
07. 架构的暗面:双平面系统的工程局限与隐性代价
高级的架构设计从不迷信银弹。在享受"不改权重"带来的高可用与自演进红利的同时,企业也必须正视这套系统在真实落地中的三大隐性代价:
1. 影子沙箱的基建深水区:如何 Mock 整个商业世界?
Skill-V 的"反事实回放(Counterfactual Replay)"理论极其优雅,但它的前提是拥有一个高保真、无状态且可极速回滚的测试环境。在纯代码计算域(如执行 Python 脚本)极易实现;但在真实的商业流中,当 Agent 的动作涉及调用微信支付、下发真实短信或修改远端 SaaS 配置时,构建一个能够拦截状态并精准回放的影子沙箱,其工程研发成本往往会超过智能体应用本身。
2. 概念漂移(Concept Drift)与经验的"集体坍塌"
外置技能库对业务底座的变更高度敏感。如果底层业务 API 发生了一次非向下兼容的核心重构(例如订单接口全量升级),那些曾经过千锤百炼、非回归率 100% 的 SKILL.md 可能会在瞬间沦为技术债。智能体会因为"固执地遵循旧有的成功经验"而产生连续故障。在应对剧烈的范式转移时,系统必须提供一键清空的"失忆"机制,并依赖人类工程师介入冷启动。
3. 数据平面的"路由延迟(Routing Latency)"惩罚
即便采用了轻量级的三级按需装载(On-demand Loading),前置的技能路由器依然需要执行文本匹配或向量检索。对于极度渴求低延迟的实时交互场景(如语音流式对话、高频交易辅助),多增加一层 Router 拦截,就不可避免地会带来几十到上百毫秒的系统响应膨胀。
正视这些物理局限,才能在选型时做出最务实的架构折中。
08. 结语:软件工程师的下一站,是做 Agent 的"园丁"
当我们彻底穿透了"微调才能实现终身演进"的思维定势,智能体系统的工程全景变得无比清晰且确定。
底座大模型是人类通识与推理逻辑的"超级反应堆",它如同现代计算机系统中的 CPU;而环绕在它周围的程序性记忆与 SkillOps 控制系统,则是真正让系统在严苛工业泥潭中扎根生长的软件栈。
这一范式的代际转移,也将不可逆转地重塑软件工程的分工谱系:
- 过去的工程师:日复一日手写僵化的业务分支逻辑,或者在模型外部无休止地拼装脆弱的 Prompt 提示词;
- 未来的核心工程师,将转型为 Agent 技能资产的"系统架构师与园丁"------我们负责构建零污染的沙箱环境、设计严密不可篡改的证据守门人(Evidence Gate),并在智能体自主繁衍的技能森林中,冷酷地修剪杂草、淘汰过时的旧流程,呵护真正具有泛化生命力的程序性经验。
冻结神经元,演进工作流。
这不仅是规避大模型工程风险的最优解,更是构建高可靠、高可用、可审计的企业级自进化系统的唯一康庄大道。
参考文献
- Singh et al., Agent Plasticity: Measuring Self-Improvement Through Experience, arXiv:2610.08902, Meta Superintelligence Labs, UC Berkeley, UW, Princeton, 2026.
- Luo et al., An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning, arXiv:2308.08747, 2023.
- Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, arXiv:2106.09685, 2021.
- Sheng et al., S-LoRA: Serving Thousands of Concurrent LoRA Adapters, arXiv:2311.03285, 2023.
- Sumers et al., Cognitive Architectures for Language Agents, arXiv:2309.02427 (CoALA), 2023.
- Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, NeurIPS 2023.
- Wang et al., Voyager: An Open-Ended Embodied Agent with Large Language Models, arXiv:2305.16291, 2023.
- Wang et al., Agent Workflow Memory, arXiv:2409.07429 (AWM), 2024.
- Wang et al., Agent Skill Evolution: How Revisions Affect Coding Agents, arXiv:2610.04832, 2026.
- Agent Skills Standard, Specification for Modular Agentic Extensions, 2026.
- Skill-V: Verifiable Self-Evolving Skill Library for Interactive Agents, arXiv:2610.11781, 2026.
- SkillBrew: Evolving Agent Skills through Counterfactual Replay, arXiv:2605.29440, 2026.