本文收录于专栏 AI Agent智能体系列 ------ 专栏系统覆盖 AI Agent 工具链、MCP 与蛋白质设计自动化实战,点击订阅可跟踪后续更新。
你要用 MCP 让 LLM 调度蛋白质设计------靶点界面分析、RFdiffusion 出 binder 骨架、LigandMPNN 设计序列、Boltz-2 折叠验证、PyRosetta 算界面能,github路线(protein-design-mcp)是一个 265 GiB 解压的 Docker 巨镜像,单机塞不下;裸机装又会撞上引擎前缀、外挂资产、SDK 配对三座暗墙。
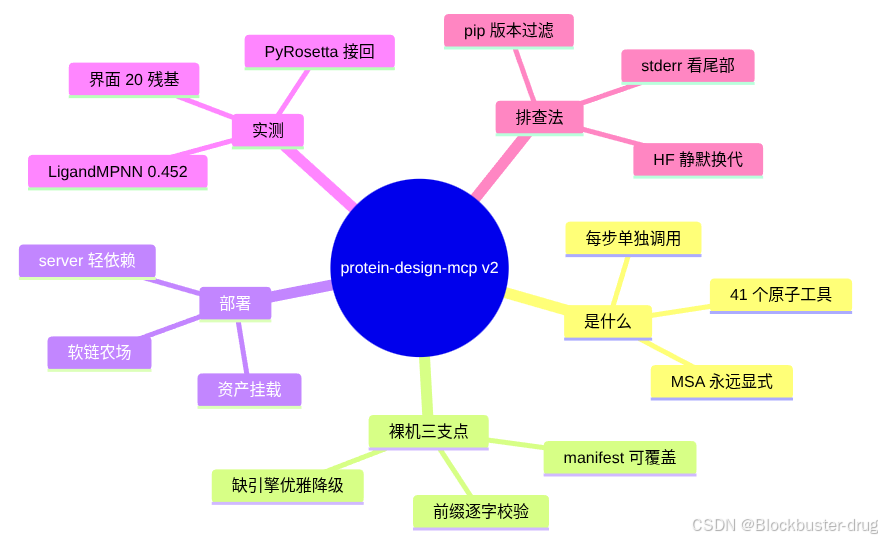
这篇在 Ubuntu 22.04 加消费级 GPU(12 GB 显存)上把 protein-design-mcp v2.4.5 的 41 个原子工具不走 Docker 完整部署:让 14 个工具立即可用,本地已有权重零重复下载全部接入;run_mpnn、run_interface_residues、ESMFold2 三轮全链实测出真数字(泛素设计 confidence 0.452、BCL-2 复合物 20 界面残基 / 951.8 Ų、ESMFold2 泛素 RMSD 1.28 Å);部署要点全部通用化给出(路径假设表 + 资产挂载结构),并附两条硬核排查法:HF 仓库静默换代导致的 checkpoint 错配怎么定位、低版本 pip 查不到高版本包的陷阱。照着做完,你按需补引擎就能接入自己的 MCP 客户端,让 agent 一步步显式调度整条设计链路。
关键字:protein-design-mcp、MCP、原子工具、RFdiffusion、LigandMPNN、PyRosetta、软链农场、裸机部署
目录
- 1. protein-design-mcp是什么:41 个工具的设计哲学
- §2. 裸机可行性的三个源码依据
- §3. 部署:server、软链、资产挂载
- §4. 实测一:run_mpnn 序列设计全链
- §5. 实测二:run_interface_residues 界面分析
- §6. 接入 MCP 客户端与使用模式
- §7. 局限、参考来源与资产包
§1. protein-design-mcp 是什么:41 个工具的设计哲学
protein-design-mcp 是给 LLM agent 用的蛋白质设计 MCP server。v2(2.4.5 线)是一次破坏性重写:39 个 run_* 工具,每个只跑一个引擎 ,外加 describe_tool 和 get_job_status 两个元工具。生成、序列设计、折叠、对齐、打分永不打包在一次调用里------agent 每选一个引擎、每定一个参数都是显式动作,可以在任何一步插手或换引擎对比。
两条用之前必须知道的纪律:
MSA 永远显式传入 。所有折叠工具的 msa 参数没有默认值:null = 明确 MSA-free,路径 = 用该文件,缺省 = 拒绝。没有 "auto"。原因有二:折叠工具内置 MSA 搜索会让两次预测不可比(模型差异和 MSA 差异混在一起);多个引擎默认走远程 MSA 服务器,新设计序列会静默外发。
chains 永不推断。binder 单独折叠和在复合物里折叠是调用者的显式决定------同一个 binder 跑两种设置是两个实验。
39 个工具按功能分十类:binder 生成 7、单体生成 6、序列设计 2、结构预测 11、MSA 2、打分 4、运行分析 4、靶点分析 2、结构准备 1、元工具 2。引擎覆盖 27 个:RFdiffusion 1/2/3、Genie 2/3、FrameFlow、MultiFlow、La-Proteina、Protpardelle、Proteina-Complexa、BoltzGen、LigandMPNN、ESMFold2、Boltz-2、Chai-1、Protenix、OpenFold3、Promera、RoseTTAFold3、AlphaFold 3、AF2-Multimer、MMseqs2、ColabFold、ipSAE、PRODIGY、PyRosetta、OpenMM。
一个工具 = 一个 YAML manifest,零 Python 。manifest 同源生成四样东西:MCP Tool 的 inputSchema、describe_tool 的应答、dispatch 入口、文档页。400 个参数每个都有描述(做什么、移动它会改变什么、合理范围),75% 带 enum/min/max/pattern 约束;manifest 只钉 plumbing(PYTHONPATH、缓存位置、CUDA_HOME),不钉任何科学选择。
§2. 裸机可行性的三个源码依据
官方推荐路线是 265.78 GiB 的集成镜像(181.41 GiB 压缩层,含全部 21 个引擎环境与公共权重)。单机可能不现实------但读源码发现三个机制天然支持裸机按需部署:
依据一:缺引擎优雅降级 (manifest/registry.py)。启动时对每个 manifest 做可用性检查:引擎环境前缀不存在、或外挂资产缺失 → 该工具被排除并在 stderr 给出原因,server 照常启动。装几个引擎用几个,不追求全集。
依据二:引擎启动走绝对路径前缀 (dispatch/env.py)。每个引擎进程以 micromamba run -p <prefix> <entry> 启动,prefix 是 manifest 里写死的绝对路径,校验只做 is_dir() + os.access() ------软链即可命中 。名字解析型(env: <name>)则走 ~/micromamba/envs/<name>(MAMBA_ROOT_PREFIX 默认)。
依据三:manifest 目录可覆盖 (app.py)。PROTEIN_MCP_MANIFEST_DIR 环境变量可指向自改副本,不动上游代码就能改任何工具的引擎前缀或入口。
§3. 部署:server、软链、资产挂载
裸机部署的本质是三件事:装一个轻量 server、用软链满足 manifest 对路径的三个假设、把已有权重挂到 manifest 要求的位置。以下命令中的 <...> 都是要按你机器替换的占位。
第一步:server 本体。依赖极轻(mcp/uvicorn/numpy/biopython/aiofiles/pyyaml/tqdm 七件套),独立环境十分钟:
conda create -n pd-mcp python=3.11 -y
conda activate pd-mcp
git clone https://github.com/jasonkim8652/protein-design-mcp
cd protein-design-mcp
pip install -e . --no-deps
pip install "mcp>=1.25,<2" uvicorn numpy biopython aiofiles pyyaml tqdm
第二步:满足 manifest 的三个路径假设。启动时 registry 逐个 manifest 做可用性检查,检查的就是三类路径------任何一个不满足,对应工具被排除并在 stderr 说明原因(这本身就是你的部署待办清单):
| 路径假设 | manifest 写死的值 | 满足方式 |
|---|---|---|
| 引擎环境前缀 | /opt/conda/envs/<name> |
软链你的 conda env 根目录过去:sudo ln -sfn <conda envs 目录> /opt/conda/envs |
| 引擎入口脚本 | /app/scripts/engines/<name>.py |
软链 repo 的 scripts/ 子目录 (不是 repo 根,否则 /app/scripts/engines 解析到不存在的 repo根/engines):sudo ln -sfn <repo>/scripts /app/scripts |
| 名字解析型环境 | ~/micromamba/envs/<name> |
少数 manifest 用 env: <name> 而非 prefix,逐个软链映射,如 ln -sfn <你的RFdiffusion env> ~/micromamba/envs/mpnn |
第三步:外挂资产挂载。少数工具要求特定的资产文件存在于特定位置(weights、license 包、数据库)。全部用软链,零复制。两个容易踩的结构细节:
# PyRosetta: 检查的是两层路径 /data/licenses/pyrosetta/pyrosetta/__init__.py
# → 挂载点必须是包的父目录 (site-packages), 软链到包本身会少一层
sudo ln -sfn <env>/lib/python3.11/site-packages /data/licenses/pyrosetta
AlphaFold 3: prefix 是 /alphafold3_venv (从官方镜像抽取的 venv 命名, 非 conda 约定)
资产另走 /data/models/alphafold3
sudo ln -sfn <AF3 env> /alphafold3_venv
sudo ln -sfn <af3.bin 所在目录> /data/models/alphafold3缺哪个引擎就装哪个引擎环境(各引擎的安装方法见其官方仓库),装完软链进上表的对应位置即可------不需要一次凑齐 27 个。
第四步:启动验收。三条 JSON-RPC 报文管子进去,看可用工具数和 stderr 缺口清单:
(printf '%s\n' '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"t","version":"1"}}}'; sleep 8; \
 printf '%s\n' '{"jsonrpc":"2.0","method":"notifications/initialized"}'; sleep 4; \
 printf '%s\n' '{"jsonrpc":"2.0","id":2,"method":"tools/list","params":{}}'; sleep 15) \
 | protein-design-mcp 2>stderr.log
Linux 实测(Ubuntu 22.04 + 消费级 GPU,复用已有的 RFdiffusion / Boltz-2 / OpenMM / AF2 / PyRosetta 环境):14 个工具立即可用 ,stderr 同时给出其余各工具的逐条缺口原因。引擎报错时注意看 stderr 的尾部------引擎的进度条占满头部,真 traceback 在最后。
个别引擎还要补依赖才能跑通(以 LigandMPNN 为例,三个坑:它官方仓库是平铺脚本不是 pip 包,要手工收进 ligandmpnn/ 目录并把内部 from data_utils 改成 from ligandmpnn.data_utils;它的 side-chain packing 要 import openfold,把仓库自带的 openfold 子目录软链到 site-packages 顶层并补 ml_collections dm-tree;它的 checkpoint 默认路径是相对 cwd 的 ./model_params/ 而 dispatch 的 cwd 是临时 scratch 目录,且权重文件名带 proteinmpnn_ 前缀------权重软链双名并存 + run.py 默认路径改绝对路径)。
遇到"权重在本地却加载失败"的通用排查法 :卡在 MISMATCH / missing keys 时,第一动作是查 HF 仓库的 lastModified------仓库可能已静默换代,你手里的本地副本是上一代架构(ESMFold2 就是这样:2026-09 仓库换代后,旧单文件 checkpoint 与任何 PyPI 版本的 transformers 都配不上,换新 6 分片 checkpoint 后 2 秒加载成功)。另一个副坑:用低版本 Python 的 pip 查包看不到要求更高 Python 的版本(py3.11 的 pip 查 esm 最高只显示 3.2.1,实际 3.4.0 存在只是要求 ≥3.12)------查版本用 PyPI JSON API 的 requires_python 字段,不要信低版本 pip 的版本列表。
§4. 实测一:run_mpnn 序列设计全链
run_mpnn 的引擎是 LigandMPNN (不是裸 ProteinMPNN------v2 换了引擎),entry 为 python -m ligandmpnn.run。裸机跑通要补的三件事见上节末段。
实测输入:泛素晶体结构(PDB 1UBQ,76 残基),2 条设计。
实测输出(Ubuntu 22.04 + 消费级 GPU,全程约 3 分钟):
{"designs": [
  {"id": 1, "sequence": "MTIKVKFEDGTTLTLEVNPDDTIAKLKEKIEAKTGIPPEEQKLIYKGKELEDDKTLADYNIQAGDTIELKLVPAGG", "overall_confidence": 0.4519},
  {"id": 2, "sequence": "MTIKVKREDGTTLELEVSPSDTIAKLKKKIEEKTGIPPEEQVLIYKGKELEDDKTLADYNIQEGDTIELRLKPAGG", "overall_confidence": 0.4368}],
 "num_designs": 2}
设计序列对泛素 wt 保持高同源(T=0.1 采样下约 55% 恢复率量级),说明同一套模型权重换了调度框架后行为正常。输出还带 designs_fasta 落盘路径,下游折叠工具直接吃。
§5. 实测二:run_interface_residues 界面分析
这是 v2 靶点分析类的代表工具:测量 (而非预测)一个已有复合物里哪些靶点残基真的在与 binder 接触、各埋没多少表面积。它没有新几何代码------就是把 server 自己已测试的 get_interface_residues(CA-CA 接触)和 calculate_sasa(溶剂可及面积)接到 CLI 上。
实测输入:一个 BCL-2 / mini-binder 复合物 PDB(靶点链 A,binder 链 B,接触阈值默认 8.0 Å)。
实测输出:
n_interface_residues: 20
total_buried_sasa_a2: 951.8
hotspot_tags: [A206, A207, A108, A201, A118, A146, A136, A202, A111, ...]
输出里的 hotspot_tags("<链ID><残基号>" 列表,按埋没面积降序)不经任何重排直接喂给四个 binder 生成工具 :run_rfdiffusion_binder 的 hotspot_res、run_genie3_binder 的 hotspot_residues、run_protpardelle 的 hotspots 接 JSON 数组,run_rfdiffusion3_binder 接逗号拼接串------manifest 明文保证了这套 token 语法在各工具间一致。
一个诚实的精度注记(manifest 自己写明的):SASA 实现把所有原子的范德华半径都按碳处理(1.70 Å),绝对数值是系统性近似,当排序用可靠、当物理量读需谨慎;is_contact 来自独立的 CA 距离计算不受影响。
§6. 接入 MCP 客户端与使用模式
以 Hermes(任何支持 stdio MCP 的客户端等价)为例:
mcp_servers:
  protein_design:
    command: ~/anaconda3/envs/pd-mcp/bin/protein-design-mcp
    args: []
    timeout: 1800            # 引擎单次上限 30 分钟, 默认 120s 会掐死
    connect_timeout: 90
    env:
      PATH: ~/anaconda3/bin:/usr/local/bin:/usr/bin:/bin   # micromamba 要在 PATH
    enabled: true
改配置重启网关后日志应出现工具注册条目。对话式调度的样子------一条 binder 设计链拆成显式步骤,每步可换引擎、可插手:
"对 complex.pdb 跑 run_interface_residues 拿热点 →
 run_rfdiffusion_binder 用热点出 5 条骨架 →
 run_mpnn 每条 3 个序列 →
 run_boltz 逐条折叠 (msa: null 显式声明) →
 pLDDT>80 的送 run_rosetta_interface 算 dG"
12 GB 显存的现实约束:各 GPU 引擎都是按调用起停的子进程,串行调度天然无冲突;ESMFold 级模型常驻约占 8-9 GB,不与 Boltz/RFdiffusion 同时驻留。
局限、参考来源与资产包
局限:41 工具里本机 14 个可用(缺的按 stderr 清单逐个补);run_prodigy 的亲和力数值是排序参考非实验值;PyRosetta 学术免费商用付费;AF3 权重非商业 license;Boltz/ColabFold 的 MSA 服务器依赖外网。
| 资源 | 链接 | 与本文关系 |
|---|---|---|
| protein-design-mcp 仓库 | github.com/jasonkim8652/protein-design-mcp | 本文对象,v2.4.5 |
| 工具全表 | docs/TOOLS.md | 39 工具与设计规则 |
| LigandMPNN | github.com/dauparas/LigandMPNN | run_mpnn 引擎 |
| RFdiffusion | github.com/RosettaCommons/RFdiffusion | binder 生成引擎 |
| Boltz | github.com/jwohlwend/boltz | 结构预测引擎 |
| PyRosetta | pyrosetta.org | 物理打分,license 门控 |
| MCP 规范 | modelcontextprotocol.io | 协议层 |
系列导航 :专栏全集 AI Agent智能体系列
更多专栏:
| 蛋白 / 抗体 / 多肽 / 核酸 | 分子模拟 / 动力学 / 对接 | 药物 / 设计 / 案例 | AI / Agent / 大模型 |
|---|---|---|---|
| 开源蛋白结构预测 | 分子模拟基础 | 小分子药物设计案例 | AI Agent系列 |
| 开源蛋白生成方法实践 | 分子动力学模拟-Amber | 蛋白药物设计案例 | 化学大模型 |
| 开源多肽设计模型 | 分子动力学模拟-Gromacs | 多肽药物设计案例 | 《AI Agent原理与实战》 |
| 开源多肽性质预测 | 分子动力学模拟-OpenMM | 开源小分子生成设计 | CADD中的机器学习模型 |
| DNA/RNA药物设计 | 結合自由能 | 开源药代动力学软件 | 高效计算配置 |
| siRNA药物设计模型 | UCSF DOCK系列 | 我胡师兄说药 | |
| ASO药物设计模型 | rDock系列 LeDock系列 gnina系列 |