一、先给一条能被当场推翻的断言:库里没有"边"
一条审批单打开,流程图上走过的线是绿的、当前那一格是橙的。直觉上这套颜色该来自数据库里"走过的边"的记录------但建表 SQL 里八张 wf_* 表,没有一个字段用来存边。可以这么自证:
bash
grep -icE 'edge|transition|line' schema-mysql.sql
# 输出 0
任务表 wf_process_task 里跟画布对得上的只有两列:task_name 说明这一行发生在哪个节点 (注释写着"任务名称编码",存的是画布节点 id),task_parent_id 说明这一行是从哪一行 推进来的。没有第三列回答"经过哪条线"------节点有行,线没有行。
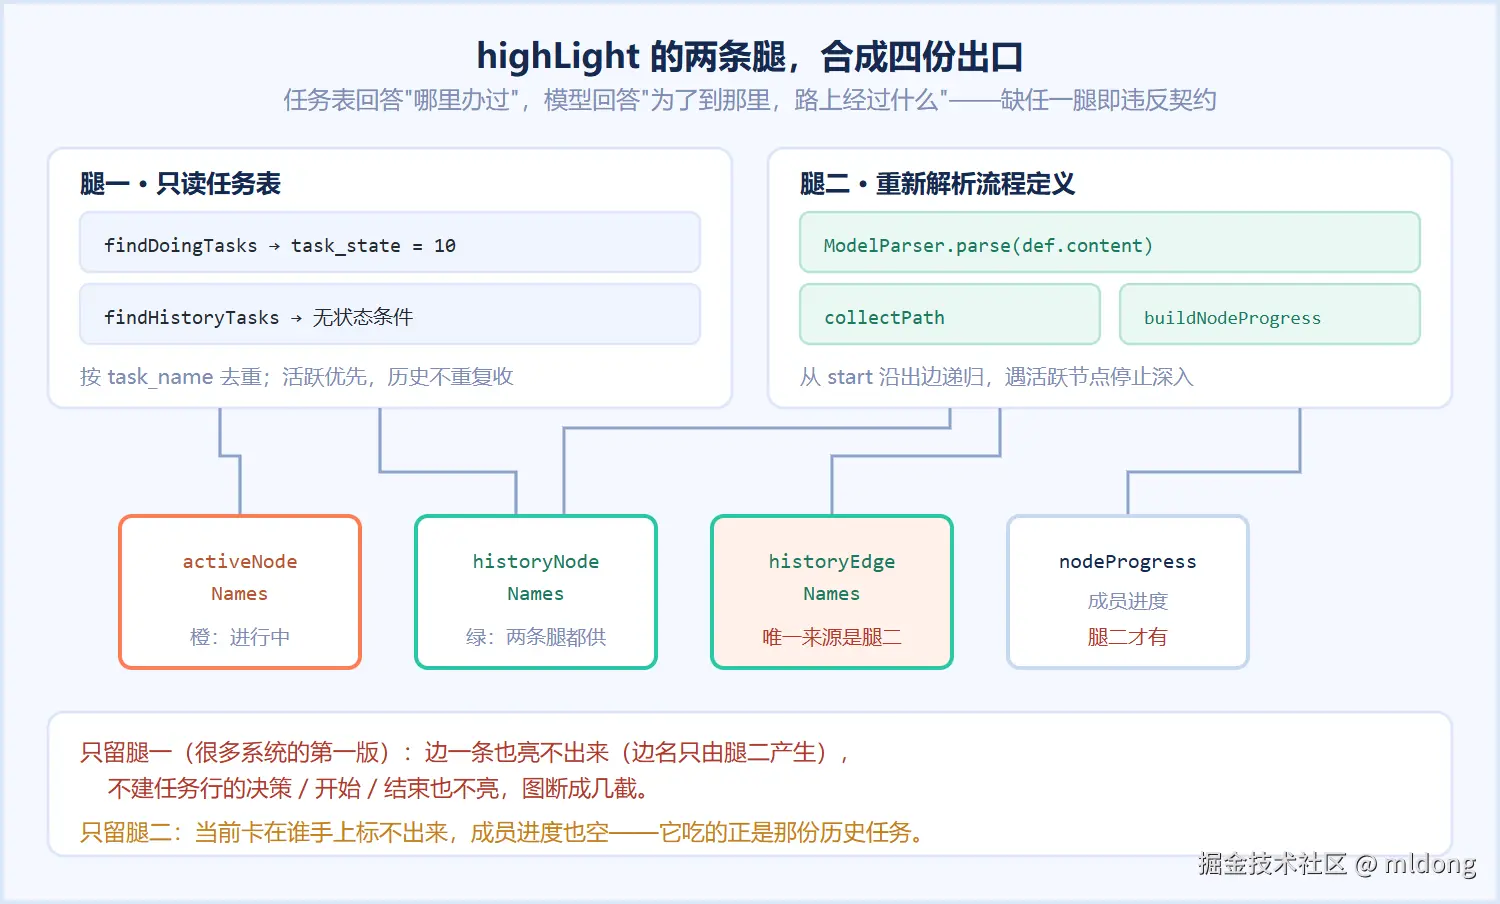
那屏幕上那些绿的线是什么?答案是:每次请求现场算出来的 。processInstance/highLight 这个动作返回的四个键里,historyEdgeNames 是唯一描述"走过哪些线"的,而它的全部来源是一个递归函数------引擎重新解析一遍流程定义的 JSON,从开始节点沿出边往前推,推过的边名就当作走过的边。
这件事本身不难,难的是它有三个反直觉的推论,每一个都会影响你怎么写详情页、怎么写测试:
- 亮着的节点,可能根本没产生过任务行(第三节);
- 高亮是一次"重放",不是"读取记录",所以它有可能和当时真实走的路不一致(第四、五节);
- 有一条线该亮而不亮,往往是递归写法的问题,不是数据的问题(第六节)。
二、highLight 有两条腿,缺一条就少一块
highLight 的实现分成清清楚楚的两段。第一段只读任务表:
java
List<ProcessTask> doing =
        repository.findDoingTasks(instanceId, null);
for (ProcessTask t : doing) {
    if (!activeNodeNames.contains(t.getTaskName()))
        activeNodeNames.add(t.getTaskName());
}
List<ProcessTask> history = repository.findHistoryTasks(instanceId);
for (ProcessTask t : history) {
    if (!activeNodeNames.contains(t.getTaskName())
            && !historyNodeNames.contains(t.getTaskName())) {
        historyNodeNames.add(t.getTaskName());
    }
}
第二段把流程定义重新解析成模型,再从模型算出剩下的东西:
java
ProcessInstance.ProcessDefine def =
        repository.findDefineById(inst.getDefineId());
if (def != null) {
    ProcessModel model = ModelParser.parse(def.getContent());
    nodeProgress = buildNodeProgress(model, history);
    collectPath(model.getStart(), activeNodeNames, historyNodeNames,
            historyEdgeNames, new java.util.HashSet<>(),
            inst.getVariables(), history);
}两条腿的分工是:任务表回答"哪里办过",模型回答"为了到那里,路上经过什么" 。这条分工不是实现细节,它已经写进规范成了契约义务------spec/06 视图端点一节对 historyNodeNames 的原话是"必须=任务行去重 ∪ 模型可达补全两条腿,缺任一腿即违反契约",给出的理由很具体:只读任务表会漏掉不产生任务行的网关、结束节点。
三、亮着的节点,你没办过;亮着的线,你可能不想让它亮
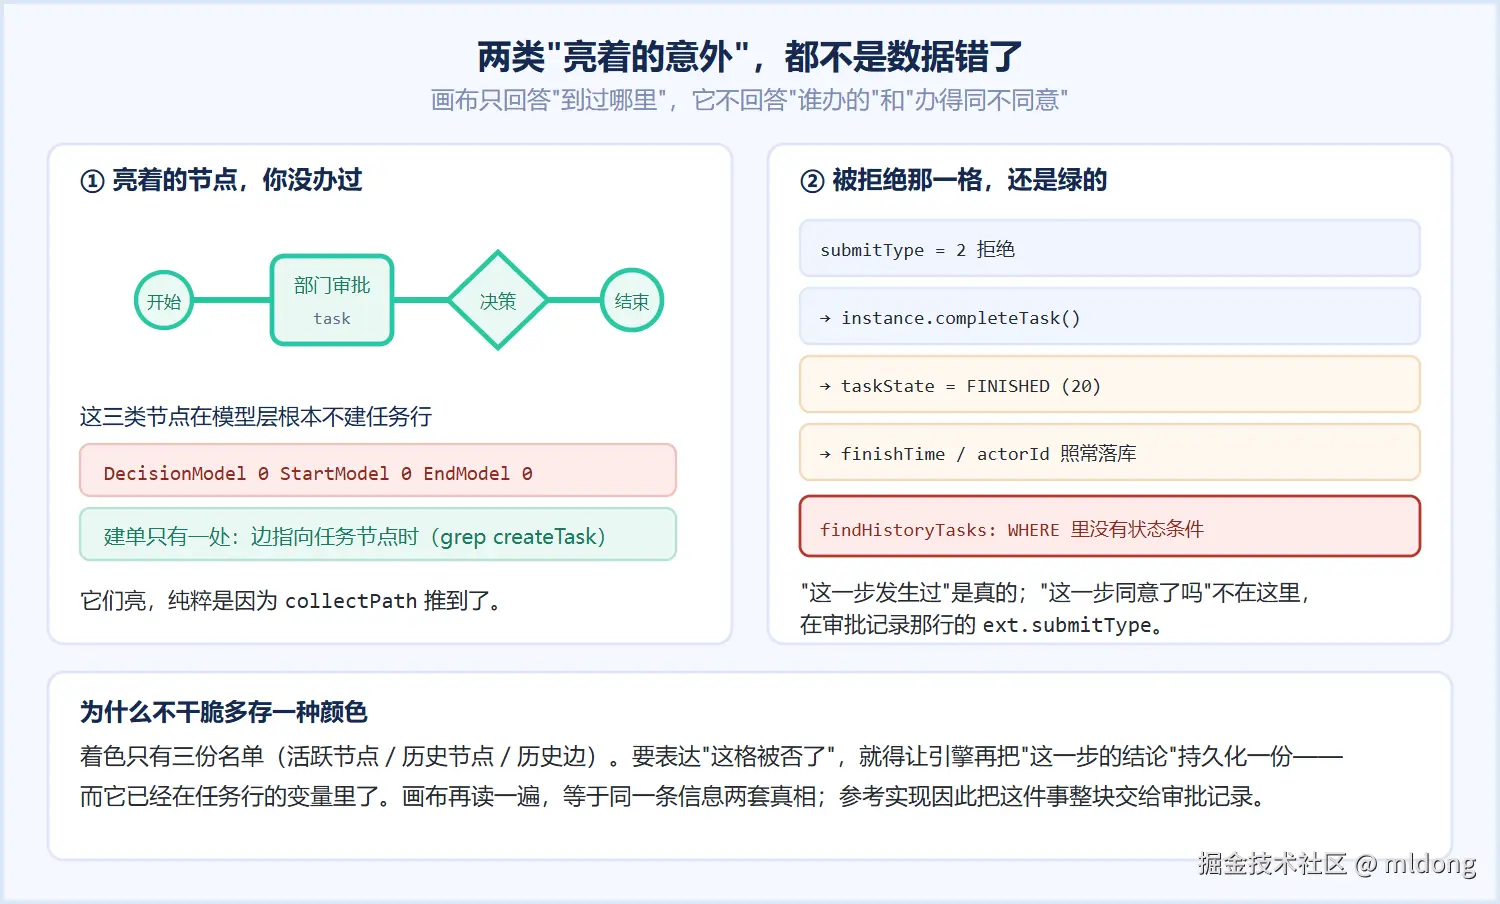
先说第一类意外。开始节点、决策节点、结束节点这三类节点,在参考实现里一次任务行都不建------可以直接验证:
bash
grep -c createTask DecisionModel.java StartModel.java EndModel.java
# 三个都是 0
它们在图上会亮,纯粹是因为 collectPath 推到了它们。所以"图上绿的就是某人办过的"这句话是错的,正确说法是"绿的是从起点沿边走、一路推到当前待办所经过的节点"。这通常是好事:网关和结束节点本来就没有办理人,不补它们的话,图会画成断开的。
第二类意外更值得留意:被拒绝、被退回来的那一格,也还亮着。原因在那两条 SQL 的差别上:
sql
-- 活跃节点:只取进行中
SELECT * FROM wf_process_task
WHERE process_instance_id = ? AND task_state = 10

-- 历史节点:没有任何状态条件
SELECT * FROM wf_process_task
WHERE process_instance_id = ? ORDER BY id ASC
findHistoryTasks 不带状态过滤。而任务办结时走的是同一个 finish():
java
this.taskState = ProcessTaskStateEnum.FINISHED.getCode();
this.actorId = operator;
if (args != null) {
    this.variables.putAll(args);
}
this.finishTime = LocalDateTime.now();也就是说,"拒绝"这个动作在数据层面并没有把那一格标成"没发生过"------它照常办结、照常留下完成时间和办理人,只是紧接着流程走向终止节点。所以图上那条线留着是对的:它记录的是"这一步发生过",而不是"这一步被同意了" 。要区分同意还是拒绝,得出口的审批记录(那行里的 ext.submitType),画布着色不承担这个信息。
为什么不留一个"被拒绝"的颜色? 因为着色这套名单只有三个集合(活跃节点、历史节点、历史边),一旦要表达"这格被否了",就得让引擎额外持久化一个"这一步的结论"------而它已经在任务行的变量里了,画布再去读一遍变量,等于把同一条信息做成两套真相。参考实现的选择是:画布只画"走到过哪儿",别的都归审批记录。
四、高亮是重放,不是查记录:为什么不"办一次就记一条边"
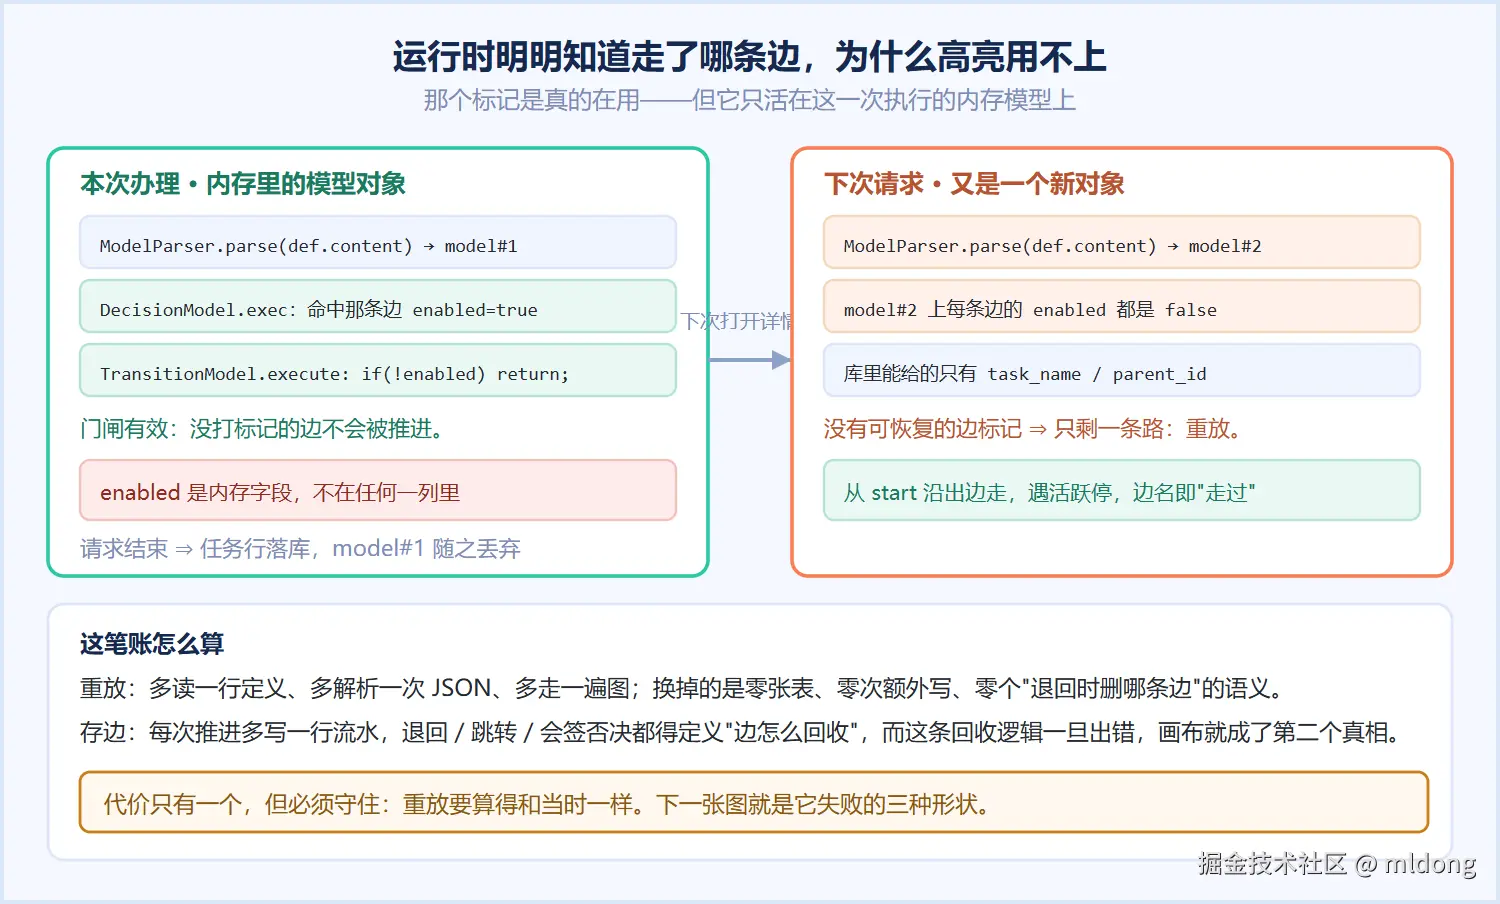
最容易想到的替代方案是:既然运行时本来就知道走了哪条边,那办理时顺手把边名写进库,查询时直接读,不就省心了?
参考实现里其实有这个标记,而且它在运行时是真用的。决策节点定支时会给选中的边打标记:
java
// DecisionModel.exec:表达式为 true 的那条边
tm.setEnabled(true);
tm.execute(execution);
而边自己的执行第一行就是读这个标记:
java
public void execute(Execution execution) {
    if (!enabled) return;
    ...
}那为什么高亮不能靠它?因为这个标记只活在那一次执行的内存模型里:
- 流程定义每次都是从
content字段现解析出一个新模型(ModelParser.parse(def.getContent())),上一次执行打的那个enabled早就不在这个对象上了; - 模型对象不落库,它是一次执行的临时结构;
- 真要持久化,就得加一张"实例-边"的流水表,于是每条流程推进多一次写,还要处理退回时"删掉哪条边"。
对比一下代价,重放的方案是:多读一行定义、多解析一次 JSON、多走一遍图,换零张表、零次额外写、零个"边怎么回收"的语义。对一个只在打开详情页时才发生、且页面本来就要求画整张图的操作,这笔账通常是划算的。
但重放有一个必须守住的前提------重放得算出和当时一样的结果。这就是下一节。
五、重放要对得上,难点在三个地方
运行时那次求值的原料是这样的:办理提交时,本次参数会先并进实例变量,再交给引擎执行:
java
FlowData mergedArgs = FlowData.create();
mergedArgs.setAll(instance.getVariables());
if (args != null) mergedArgs.setAll(args);
门面重放时拿不到"当时那次提交的参数",它只有库里的东西。所以它的原料是这样组的:
java
Map<String, Object> args = new HashMap<>();
if (instanceVars != null) args.putAll(instanceVars);
// 再并入决策节点前置任务(第一条输入边的源节点)的变量
for (ProcessTask t : historyTasks) {
    if (src.getName().equals(t.getTaskName())
            && t.getVariables() != null) {
        args.putAll(t.getVariables());
        break;
    }
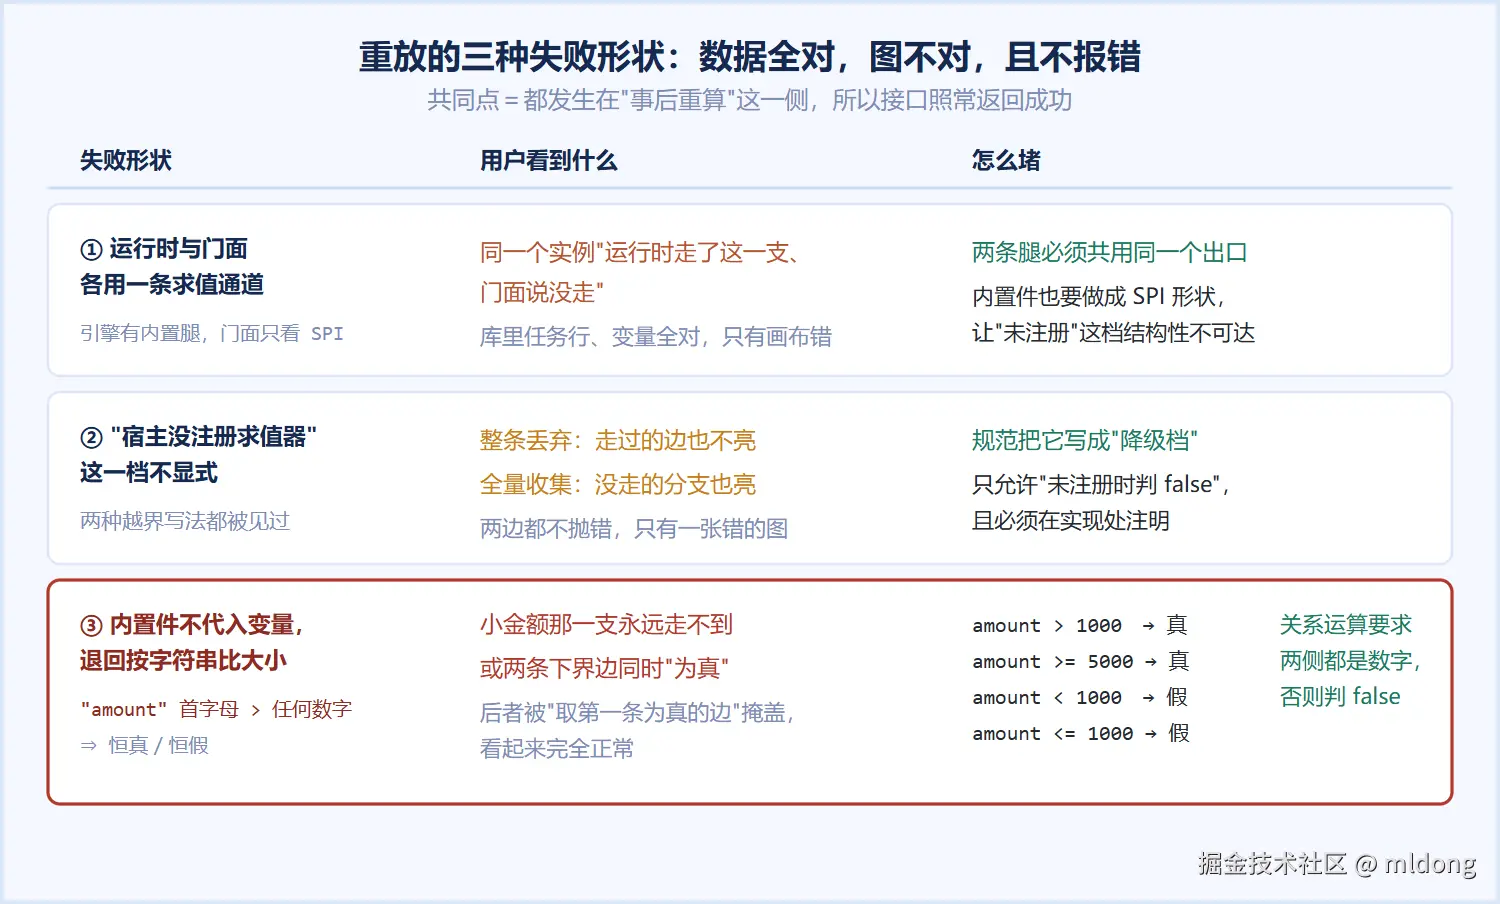
}这两份原料能对上,靠的是办理时那份参数同时落进了实例变量和任务变量------重放才有机会复现。围绕这个复现,有三处会算错,规范里逐条立了义务:
其一,求值通道必须是同一条。 运行时给决策定支用的求值器,和门面重算用的求值器,必须是同一个出口。如果引擎自带内置求值、而门面只看"宿主有没有注册那个 SPI",就会出现同一个实例"运行时走了这一支、门面说没走那一支"------线画错,而库里数据完全正确,这种不一致最难查。
其二,"未注册求值器"这一档必须显式。 参考实现里这一档是判 false:
java
IExpressionEvaluator evaluator =
        ServiceContext.find(IExpressionEvaluator.class);
if (evaluator == null) return false;规范把它写成降级档并要求在实现处注明;同时明确禁止另外两种写法------"把带表达式的边整条丢弃"(那会连走过的那条一起丢掉)和"不求值全量收集"(那会把没走的分支也点亮)。
其三,内置求值不能不代入变量。 这一条有个特别好记的反例。某语言旧版内置求值器只替换 ${var} 这种写法,裸写的 amount > 1000 里,amount 根本不被代入;接着它两侧解析不成数字,就退回按字符串比大小。而 "amount" 的首字母在 ASCII 里排在所有数字字符后面,于是:
| 表达式 | 旧内置件的结果 | 和 amount 实际值有关吗 |
|---|---|---|
amount > 1000 |
真 | 无关,恒真 |
amount >= 5000 |
真 | 无关,恒真 |
amount < 1000 |
假 | 无关,恒假 |
amount <= 1000 |
假 | 无关,恒假 |
后果有两种,都很难看见。如果决策节点两条出边写成"> 1000"和"<= 1000"这对互补条件,那么小金额那一支一次都走不到 ------不管金额是 5 还是 50;如果两条边都写成下界(> 1000 与 >= 5000),那就两支同时为真,而实现是"取第一条为真的边",顺序掩盖了它,跑起来一切正常。
现在规范对关系运算(> >= < <=)加了一句硬要求:两侧都必须是数字,否则判 false;内置件还补了一条------裸变量名查得到才代入。
自查方法很简单,一行请求就够:把那个变量设成明显小于常量的值(比如 amount = 5),再跑一次。 如果流程仍然走进 amount > 1000 那一支,你的求值器就是在按字典序蒙方向,而不是在求值。
六、"通向当前待办的那根线"最容易不亮
有一类症状长得很特别:节点都亮对了,唯独连着当前待办那一格的那条线不亮。它不是数据问题------那一格确实是从上一格推进来的,任务行、父子行都在。问题出在递归写法上:
java
for (TransitionModel tm : node.getOutputs()) {
    // ① 决策节点:表达式为 false 的分支,边名与目标都不收
    if (node instanceof DecisionModel
            && StringUtils.isNotEmpty(tm.getExpr())
            && !evalDecisionExpr(...)) {
        continue;
    }
    String edgeName = tm.getName();
    if (edgeName != null && !edges.contains(edgeName)) {
        edges.add(edgeName);          // ← 收边名
    }
    NodeModel next = tm.getTarget();
    if (next == null) continue;
    if (!active.contains(next.getName())
            && !history.contains(next.getName())) {
        history.add(next.getName());  // ← 补节点
    }
    if (active.contains(next.getName())) continue; // 遇活跃停止深入
    collectPath(next, active, history, edges, visited, ...);
}顺序是关键:先把边名收进结果,再判断"要不要继续下钻" 。"遇活跃节点停止深入"只应该停掉递归,不应该顺带把那一跳的边名丢掉。如果实现是"把边集合作为递归实参一路传下去",那么在 continue 那一支上,边名就跟着递归一起被跳过了------通向当前待办的那根线永远不亮。
这条坑真正的价值在于它的测试 。想验证这一点,很多团队的第一个用例是"发起→一级审批→二级审批"这种线性流:跑一遍,边集齐全,测试通过。但线性流测不到这一跳 ------它没有分支,continue 那一支根本不会走到。同样,"分支已经办完、令牌停在分支之后"的流程也测不到,因为那一跳早已落在任务行里、不需要图补全。
真正能测到的夹具只有一种形状:流程停在决策节点之后的那个任务节点上,此时"进入该节点的那条边"既不在任务行里、又是必须亮的,两者一夹就把写法逼出来了。所以如果要做这类回归,判据可以抄这三条:
- 夹具必须停在分支后的第一格,不能是线性流,也不能让分支节点本身办完;
- 断言要同时比边集 和节点集 ------只比
code==0等于没测; - 加一个反档:把表达式求值那一步摘掉,用例必须红。红不了的用例测的是巧合。
七、前端只做一件事:按 id 给画布元素打状态
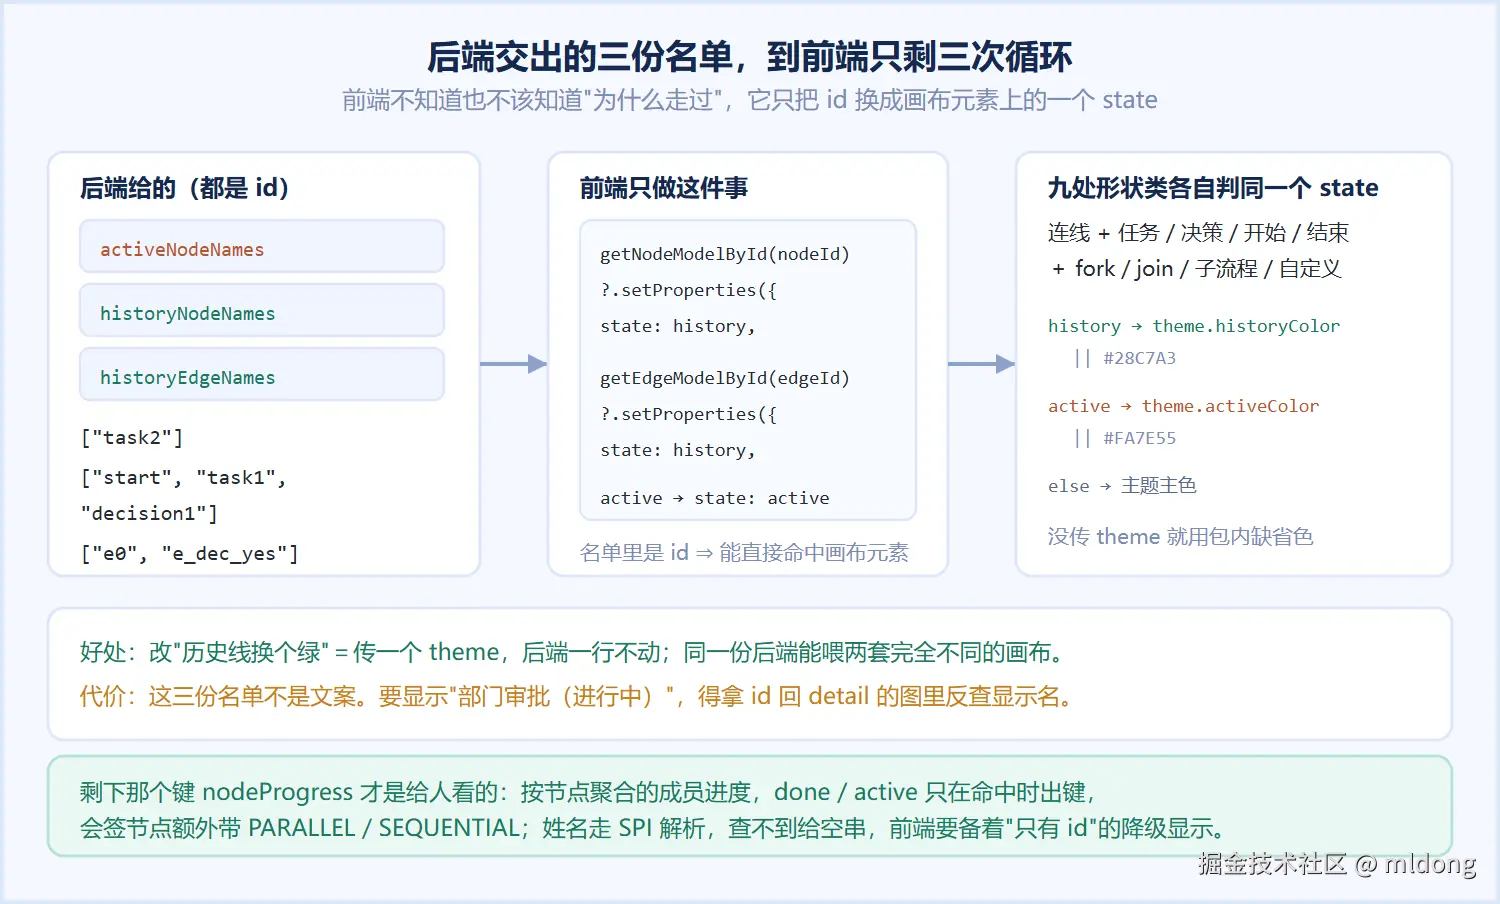
后端交出的三份名单,到前端只剩一段循环(为窄屏折行,源码里还各有一层空数组判断):
ts
const setHighLight = (data) => {
  data.historyNodeNames.forEach((nodeId) => {
    lf.getNodeModelById(nodeId)?.setProperties({
      state: NodeStateEnum.history,
    })
  })
  data.historyEdgeNames.forEach((edgeId) => {
    lf.getEdgeModelById(edgeId)?.setProperties({
      state: NodeStateEnum.history,
    })
  })
  data.activeNodeNames.forEach((nodeId) => {
    lf.getNodeModelById(nodeId)?.setProperties({
      state: NodeStateEnum.active,
    })
  })
}
注意这里传的参数名是 nodeId 。这三份名单里装的是画布节点 id(LogicFlow 的节点 id),不是中文节点名------名字字段在建模时就被赋成了 id,任务行的 task_name 也是同一个 id,两边天然对齐。
拿到 state 之后,颜色由谁决定?不是某个集中的主题表,而是每一种节点、连线的形状类各写一份同样的三分支。连线是这段:
ts
// edge/Transition.ts
getEdgeStyle() {
  const theme = this.graphModel.props.theme;
  const style = super.getEdgeStyle();
  if (this.properties.state == NodeStateEnum.history) {
    style.stroke = theme.historyColor || ColorEnum.historyColor;
  } else if (this.properties.state == NodeStateEnum.active) {
    style.stroke = theme.activeColor || ColorEnum.activeColor;
  } else {
    style.stroke = theme.edgePrimaryColor
      || ColorEnum.edgePrimaryColor;
  }
  return style;
}决策、开始、结束、fork、join、子流程、任务、自定义这八类节点,加上连线,一共九处 都在判同一个 state。这个形状跟第三节正好接上:那些不建任务行的节点(决策/开始/结束/fork/join),在画布上各有自己的形状类,所以后端补全它们之后,前端才画得出、也才亮得上。
这个分工是有意的:
- 后端只回答"哪些 id 走过 / 哪些 id 在当前",它不知道也不该知道画布怎么画;
- 前端只把 id 翻译成画布元素上的一个
state属性 ,颜色由形状类按theme覆盖值取,没覆盖就用包内缺省色; - 所以"历史线想换个绿"改的是传入的
theme,一屏后端代码都不用碰。
代价是:谁要在页面上显示"部门审批(进行中)"这种文字,得自己拿 id 回到 detail 返回的图里反查显示名------名单不是给人看的文案,是画布定位键。
八、拿去自查:六个问题
- 你存边吗? 如果流程图上的线要亮,先问一句这条线在库里是哪一行。答不上来,说明你也在重放------那就要接着问第 2 条。
- 重放用的是同一条求值通道吗? 运行时定支的求值器和"重算走过哪些边"的求值器,是不是同一个出口?不是的话,会出现库对、图错的分裂。
- "未注册求值器"这一档你显式吗? 整条丢弃、还是不求值全收,两种都会画出错的图,且都不报错。
- 内置求值有没有代入变量? 造一支
数字变量 > 常量的表达式,把变量设成小于常量再跑一次:如果两次都"为真",你的求值器在按字典序蒙。 - 你的高亮测试里有"停在分支后第一格"这个夹具吗? 线性流测不到那一跳;只断言接口返回成功,等于没测。
- 画布只画"到过",不画"同意"。 被拒绝、被退回的格子仍然亮,这是这份数据的定义。要展示结论,去读审批记录里的提交类型,别在着色里塞第二套语义。
结语
"高亮"这件事看上去是纯前端的表现层,实际是一套不落库的路径重放:库里只有任务行,线是每次请求从流程定义重新推出来的。它换来的好处是简单------不用维护边的流水、不用处理退回时回收哪条线;代价是必须守住"重放要算得和当时一样"这个前提,而这件事的失败方式很不显眼:数据全对,图不对,且不报错。
如果你的系统里也有这么一张会亮的图,值得先做一次很朴素的验证:手工挑一条分支走完,把页面上亮着的线一根一笔记下来,再打开数据库看这些线分别是哪一行。对不上的那几根,就是你重放逻辑的位置。
参考资料
- jeeflow 工作流引擎文档站:jeeflow-doc.mldong.com
- 动作与参数契约(规范 06 · 门面,视图端点一节含高亮三条义务):jeeflow-doc.mldong.com/spec/06-fac...
- 状态机与提交类型(规范 03):jeeflow-doc.mldong.com/spec/03-sta...
- GitHub(Java 参考实现):github.com/mldong/jeef...
- mldong 快速开发框架:github.com/mldong/mldo...