🌈个人主页 :一条泥憨鱼(欢迎各位大佬莅临)
❄️《数据结构》 ❄️《AI与Agent那些事》
❄️《从0开始学计算机网络》 ❄️《后端开发》
前言:
你是否碰到过这种情况:ping 一台服务器,前几个包延迟都是 20ms,突然冒出一个 200ms 甚至直接超时?或者用抓包工具看数据时,发现一个明明不大的请求,却被拆成了好几个包发出去?
这些现象背后,都跟 IP 协议头部里几个平时不太起眼的字段有关。这篇会把 IP 数据报的首部拆开,讲清楚 TTL、标识、分片偏移这三个字段各自管什么,分片和重组怎么配合,以及 IPv4 和 IPv6 在这些机制上有什么区别。串起来看,它们其实是同一条线:一个 IP 包从发出到抵达,中间要过哪些关卡,每个关卡靠什么字段做判断。
IP 数据包长什么样------先把"信封"拆开看
寄快递的时候,包裹外面要贴一张单子,上面写着收件人地址、寄件人地址、包裹重量、是否易碎。IP 数据包也一样:真正要送的数据(比如你请求的网页内容)是"包裹里的东西",而包裹外面那张单子,就是IP 首部(IP header)。
IP 首部里字段不少,先认识几个关键的:
版本:标明这是 IPv4 还是 IPv6
首部长度:这张"快递单"本身有多长
总长度:整个包裹(首部 + 数据)有多大
标识(Identification):一个编号,标记"这个包属于哪一批"
标志(Flags):几个开关位,最重要的是"后面还有没有分片"
分片偏移(Fragment Offset):这个包在原始数据里的位置
-TTL(Time To Live):还能活多久
协议:里面的数据是 TCP 还是 UDP
源 IP 地址 / 目的 IP 地址:从哪来、到哪去
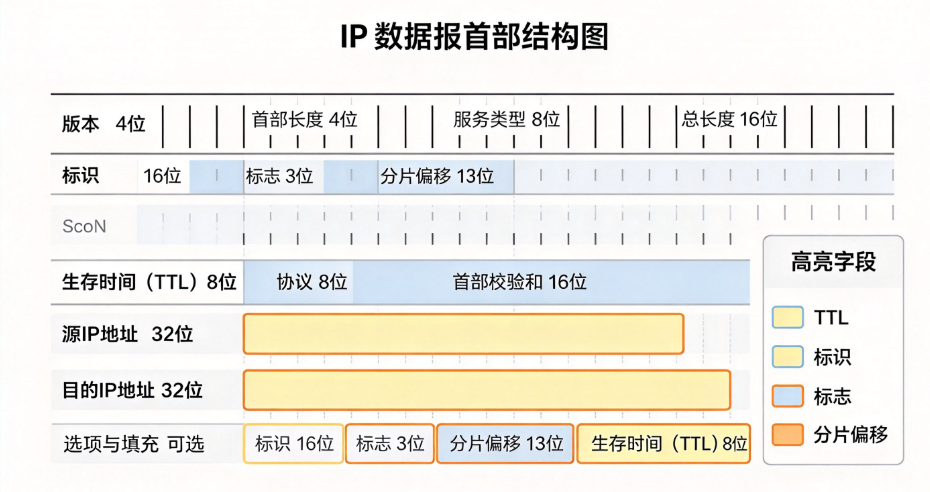
这里面源地址、目的地址最好理解,协议也不难。真正容易让人懵的是 TTL、标识、标志、分片偏移这四个,它们不像地址那样直观,但恰恰是排查网络问题时最有用的线索。
TTL------一个会"倒计时"的数字
TTL 全称 Time To Live,直译"生存时间"。但这名字有点误导,它跟"时间"没多大关系 ,真正管的是跳数。
TTL 就是一个初始值,比如 64。数据包每经过一个路由器,TTL 减 1。减到 0,路由器就把这个包丢掉,然后回一个"超时"消息给发送方。
为什么要这么设计?想象没有 TTL 的世界:如果路由表配错了,形成一个环------A 转给 B,B 转给 C,C 又转回 A------这个包就会永远在几个路由器之间转圈,把带宽全耗光。TTL 就是给包设了个"最多能走多少步"的上限,走完就死,防止死循环。
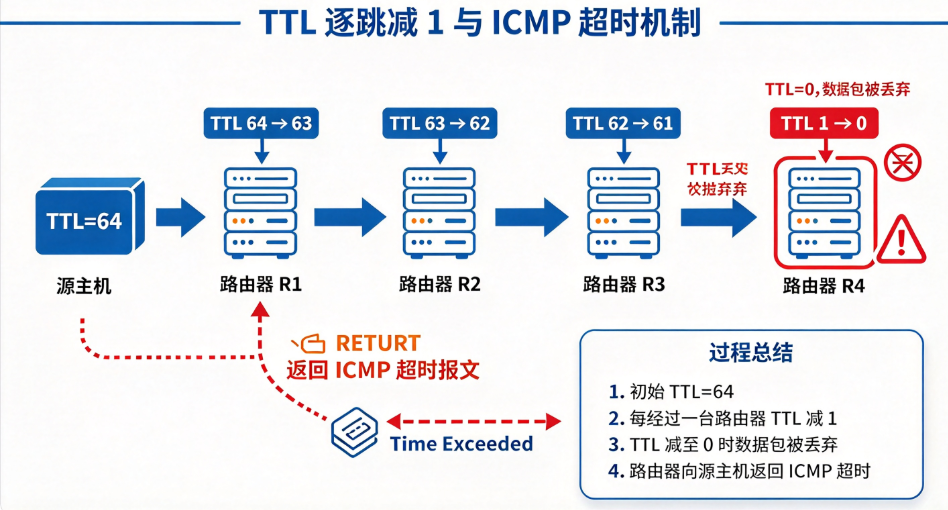
这里有个很实用的副产品:**traceroute(Windows 上叫 tracert)**就是靠 TTL 工作的。它的做法是:先发一个 TTL=1 的包,第一个路由器收到后减到 0,丢弃并回一个超时消息,这样第一跳是谁就知道了。然后发 TTL=2 的包,拿到第二跳地址。一路加上去,整条路径上的路由器就都摸出来了。
所以下次用 traceroute 看到某一跳延迟特别高,大概率是那个路由器本身比较忙,或者它到下一跳的链路有问题。
TTL 的初始值一般是 64、128 或 255,取决于操作系统,Linux 常用 64,Windows 常用 128。这也是一个判断小技巧:ping 某个地址返回 TTL 是 52,如果你知道对方是 Linux(默认 64),那中间大概经过了 12 跳(64 - 52 = 12)。
分片与重组------大包怎么过小门
分片这个概念要理解得先知道另一个词:MTU(Maximum Transmission Unit,最大传输单元)。
每种网络链路能传输的单个数据包大小有上限。以太网最典型,MTU 是 1500 字节。把 MTU 理解成"门框高度"------包裹再大,也得能塞过这个门。
那一个 3000 字节的 IP 数据包,门框只有 1500,怎么办?答案就是分片(fragmentation):把这个大包切成几个小片,每片都能过门,到了目的地再拼起来。
切的时候,靠三个字段配合:
标识:同一个原始包切出来的所有分片,标识字段值一样。接收方靠它判断"这几个片是不是一伙的"。
标志 :其中有一位叫 MF(More Fragments),意思是"后面还有片"。最后一个分片的 MF 设为 0,表示"到此为止"。
分片偏移:标明这个片在原始数据里的位置,单位是 8 字节。
举个具体例子。假设一个 IP 数据报总长 3000 字节,首部 20 字节,数据部分 2980 字节,要通过 MTU=1500 的链路。
每个分片最多能带 1500 - 20 = 1480 字节数据。但偏移量必须是 8 的倍数,1480 正好是 8 的倍数(1480 ÷ 8 = 185),没问题。
于是切成:
分片 1:数据 1480 字节,偏移 0,MF=1
分片 2:数据 1480 字节,偏移 185(1480 ÷ 8 = 185),MF=1
分片 3:数据 20 字节,偏移 370(2960 ÷ 8 = 370),MF=0
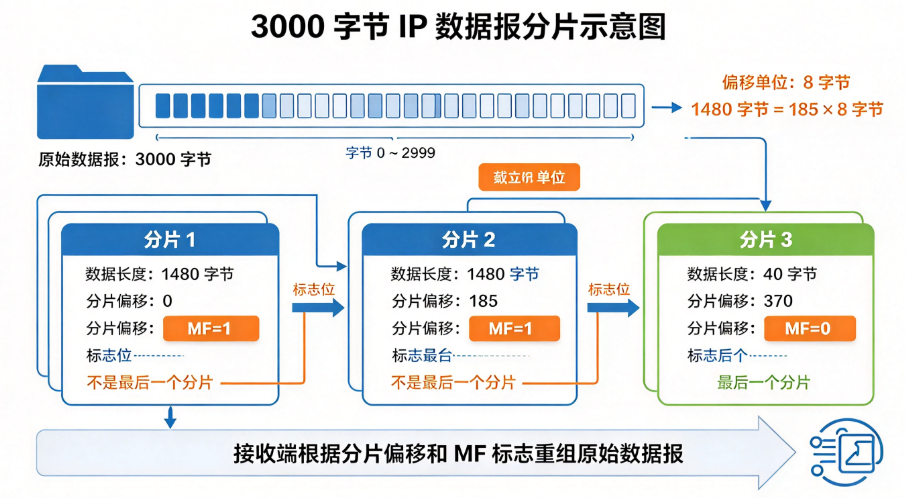
接收方收到这三个片后,看标识相同,就知道是一批的;按偏移量排序,拼回原来的 2980 字节数据;看到 MF=0 那个片,就知道拼完了。
这里有个坑要强调:分片是有代价的 。只要一个分片丢了,整个原始数据报就得重传,因为接收方拼不齐。而且分片和重组会消耗路由器和主机的 CPU。所以现代网络更倾向于在发送前用路径 MTU 发现(Path MTU Discovery)探明整条路径上最小的 MTU,直接把包切成合适大小,避免中途分片。
有些防火墙会直接丢弃分片包,导致大文件传输或 VPN 连接莫名其妙失败。如果你遇到"小请求正常、大请求超时",可以往分片这个方向查。
IPv4 和 IPv6
前面讲的都是 IPv4 的机制。IPv6 作为下一代协议,在这些地方做了不少改动。
最直观的区别是地址长度。IPv4 地址 32 位,写成 `192.168.1.1` 这样;IPv6 是 128 位,写成 `2001:0db8:85a3::8a2e:0370:7334` 这样。地址空间大了无数倍,这是 IPv6 最出名的特点。
但在我们关心的这几个字段上,变化更值得注意:
**TTL 改名叫 Hop Limit。**功能完全一样,还是每跳减 1,只是名字更准确------它本来就是限制跳数的,叫"生存时间"确实容易误解。
分片机制变了。I Pv6 里,路由器不再负责分片 。如果包太大过不去,路由器直接丢弃,然后回一个 ICMPv6 "包太大"的消息,让发送方自己重新调整大小。分片和重组只由发送方和接收方来做。这样做减轻了路由器负担,也让路径 MTU 发现变成必须的机制。
**首部结构简化了。**IPv4 首部是变长的(20 到 60 字节),因为有一堆可选字段;IPv6 首部固定 40 字节,把可选功能挪到了扩展首部里。字段也精简了,比如 IPv4 里的首部校验和,IPv6 直接取消,因为链路层和传输层已经有校验,重复校验没必要。
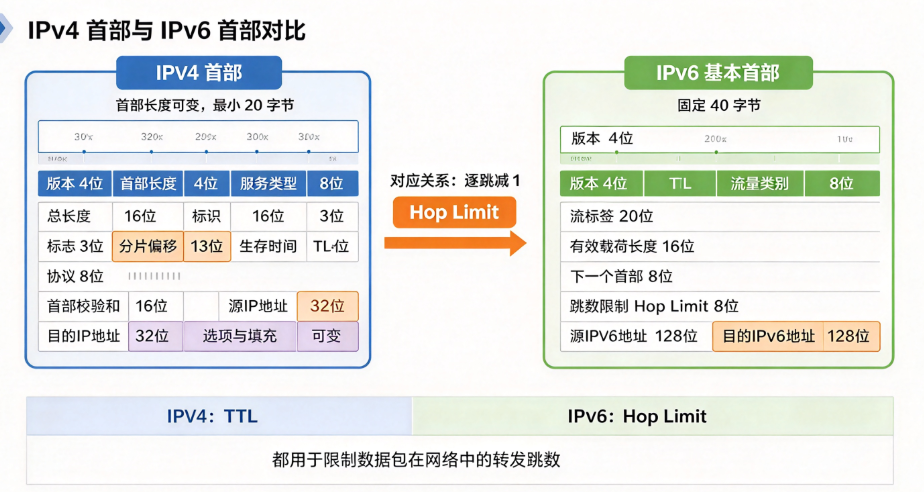
标识、标志、分片偏移这几个字段,在 IPv6 的基本首部里是不存在的,只有需要分片时,才会出现在一个叫"分片扩展首部"的地方。也就是说,IPv6 默认情况下根本不带这些字段,只有真要分片了才加。
收个尾
把这条线串一下:一个 IP 包发出去,TTL 负责限制它能走多远、防止死循环;标识、标志、分片偏移负责在包太大时把它切开、到地方再拼回来;IPv6 则在这些机制上做了简化和调整,把分片的负担从路由器挪回了端系统。
这些字段平时不显眼,但排查网络问题时特别有用。**遇到网络不通或丢包,先看 TTL 和分片相关的字段。**TTL 异常小,可能是路由环路或者路径有问题;大包失败、小包正常,多半是 MTU 或分片被拦了。