文章目录
- 一、数据导入与导出
-
- [1.1 CSV 文件](#1.1 CSV 文件)
- [1.2 JSON 文件](#1.2 JSON 文件)
- 二、数据清洗
-
- [2.1 查看是否是缺失值](#2.1 查看是否是缺失值)
- [2.2 查看缺失值个数](#2.2 查看缺失值个数)
- [2.3 填充缺失值](#2.3 填充缺失值)
- [2.4 重复数据处理](#2.4 重复数据处理)
- [2.5 数据类型转换](#2.5 数据类型转换)
- 三、数据特征构造
-
- [3.1 数据变形](#3.1 数据变形)
- [3.2 数据分列](#3.2 数据分列)
- [3.3 数据分箱](#3.3 数据分箱)
-
- [3.3.1 等据分箱](#3.3.1 等据分箱)
- [3.3.2 等频分箱](#3.3.2 等频分箱)
- [3.3.3 数据分箱应用](#3.3.3 数据分箱应用)
- [3.4 设置索引、修改列名](#3.4 设置索引、修改列名)
- [3.5 分组聚合](#3.5 分组聚合)
-
- [3.5.1 单条件分组聚合](#3.5.1 单条件分组聚合)
- [3.5.2 多条件分组聚合](#3.5.2 多条件分组聚合)
- 四、综合案例
-
- [4.1 企鹅数据分析](#4.1 企鹅数据分析)
- [4.2 睡眠质量分析](#4.2 睡眠质量分析)
一、数据导入与导出
xml
python-numpy-pandas/
├── .venv/                  # Python虚拟环境目录
├── data/                   # 数据集文件夹,包含csv、json两类测试数据
│   ├── data1.json
│   ├── products.json
│   ├── test.json
│   ├── employees.csv
│   ├── house_sales.csv
│   ├── penguins.csv
│   ├── sleep.csv
│   ├── weather.csv
│   └── weather_withna.csv
├── 工程文件1.ipynb
└── 工程文件2.ipynb
└── ......
1.1 CSV 文件
python
import pandas as pd
# 导入csv
df = pd.read_csv("data/employees.csv")
# 导出csv
df.to_csv('data/test_employees.csv')
1.2 JSON 文件
形式1:
json
[
  {"id": 1, "name": "张三", "age": 25},
  {"id": 2, "name": "李四", "age": 30},
  {"id": 3, "name": "王五", "age": 28}
]
python
import pandas as pd
# 导入json
df = pd.read_json("data/data1.json")
形式2:
json
{
  "users": [
    {
      "id": 1,
      "name": "张三",
      "age": 28,
      "email": "zhangsan@example.com",
      "is_active": true,
      "join_date": "2022-03-15"
    },
    {
      "id": 2,
      "name": "李四",
      "age": 35,
      "email": "lisi@example.com",
      "is_active": false,
      "join_date": "2021-11-02"
    },
    {
      "id": 3,
      "name": "王五",
      "age": 24,
      "email": "wangwu@example.com",
      "is_active": true,
      "join_date": "2023-01-20"
    }
  ]
}
python
import json

# 导入json
with open('data/test.json', encoding="utf-8") as f:
    data = json.load(f)
df = pd.DataFrame(data['users'])
导出json:
python
df.to_json('data/test_employee.json')二、数据清洗
数据清洗是数据分析的前置核心步骤,对原始数据集里的 缺失值、重复值、异常值、格式错误、多余字段 进行处理,修正脏数据,保证后续分组、聚合、统计分析结果可靠。
python
import numpy as np
import pandas as pd

s = pd.Series([1, 2, np.nan, None, pd.NA])
df = pd.DataFrame(
    [[1, pd.NA, 2],
     [2, 3, 4],
     [None, 4, 5]],
    columns=['第1列', '第2列', '第3列'])
注:后文默认导入 numpy 和 pandas
2.1 查看是否是缺失值
python
print(s.isna()) # np.nan, None, pd.NA 都是na
print(s.isnull()) # 结果同上
print(df.isna())
print(df.isnull())
2.2 查看缺失值个数
python
print(s.isnull().sum()) # 3
print(s.isna().sum())

print(df.isna().sum())  # 按照列去看
print(df.isna().sum(axis=1))  # 按照行去看
# 第1列    1
# 第2列    1
# 第3列    0
# dtype: int64
# 0    1
# 1    0
# 2    1
# dtype: int64
剔除缺失值:
python
print(s.dropna())

print(df.dropna())  # 删除一整条(一行)
print(df.dropna(how='all'))  # 如果所有的值都是缺失值,才删除一行
print(df.dropna(thresh=2))  # 如果至少有n个值不是缺失值,就保留
print(df.dropna(axis=1))  # 剔除一整列
print(df.dropna(subset=['第1列']))  # 如果某列有缺失值,则删除这一行
2.3 填充缺失值
python
df = pd.read_csv('data/weather_withna.csv')
print(df.isna().sum())  # 统计缺失值数量
print(df.tail())  # 查看后 5 条

print(df.fillna({'temp_max': 222, 'temp_min': 111}).tail())  # 使用字典去填充
print(df.fillna(df[['wind']].mean()).tail())  # 用指定列的统计值填充
print(df.ffill().tail())  # 用前面的相邻值填充
print(df.bfill().tail())  # 用后面的相邻值填充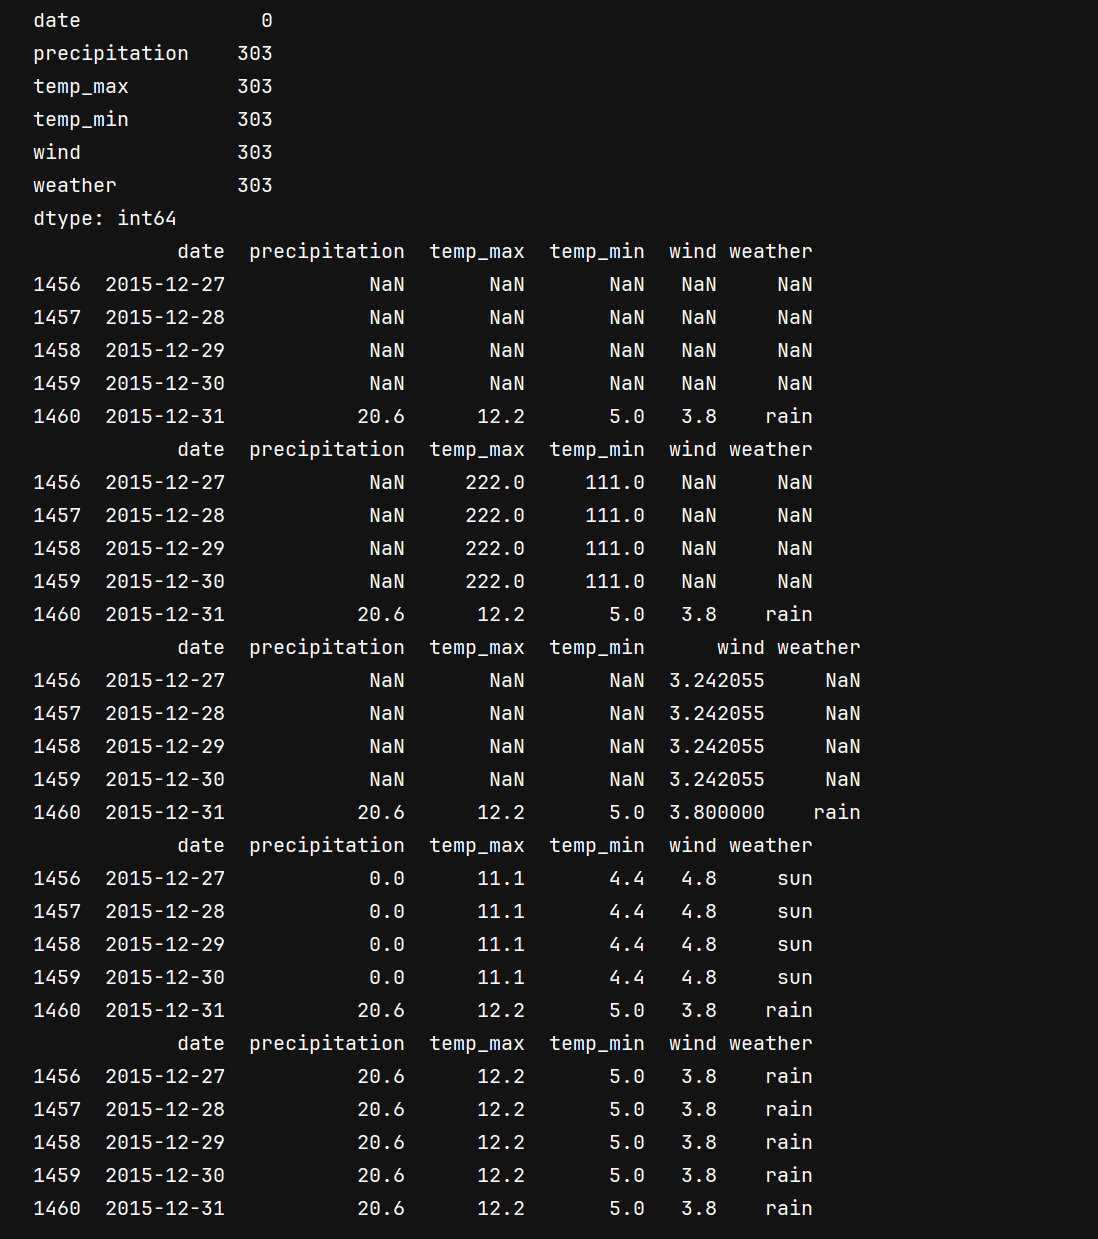
注:
python
# 写法1:df[['wind']].mean()得到Series,只填充wind列
df.fillna(df[['wind']].mean())
# 写法2:df['wind'].mean()得到单纯数字,所有的NaN全部填充这个均值
df.fillna(df['wind'].mean())
2.4 重复数据处理
python
data = {
    'name': ['alice', 'alice', 'bob', 'alice', 'jack', 'bob'],
    'age': [26, 25, 30, 25, 35, 30],
    'city': ['NY', 'NY', 'LA', 'NY', 'SF', 'LA']
}
df = pd.DataFrame(data)
print(df)
print(df.duplicated())  # 如果一整条记录都是一样的,则标记为重复,返回true
print(df.drop_duplicates())  # 删除重复记录
print(df.drop_duplicates(subset=['name']))  # 按照指定列去重
print(df.drop_duplicates(subset=['name'], keep='last'))  # 按照最后出现的去重
2.5 数据类型转换
python
df = pd.read_csv('data/sleep.csv')
print(df.dtypes)
# gender                         str
# age                          int64
# ...

df['age'] = df['age'].astype('int16')
print(df['age'].dtypes)
df['gender'] = df['gender'].astype('category')  # 字符串改成分类
print(df.gender.dtypes)

df['is_male'] = df['gender'].map({'Female': True, 'Male': False})  # 新建一列,通过gender列进行映射
print(df.is_male.dtypes)  # category
三、数据特征构造
3.1 数据变形
python
data = {
    'ID': [1, 2],
    'name': ['alice', 'bob'],
    'Math': [90, 85],
    'English': [88, 92],
    'Science': [95, 89]
}
df = pd.DataFrame(data)
df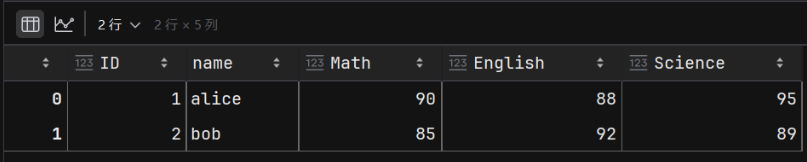
宽表转换成长表:
python
# id_vars 传入不变的列
# var_name 把列的名字(如:Math English Science)重新起名字
# value_name 把里面的值重新起名字
df2 = pd.melt(df, id_vars=['ID', 'name'], var_name='科目', value_name='分数')
df2.sort_values('name')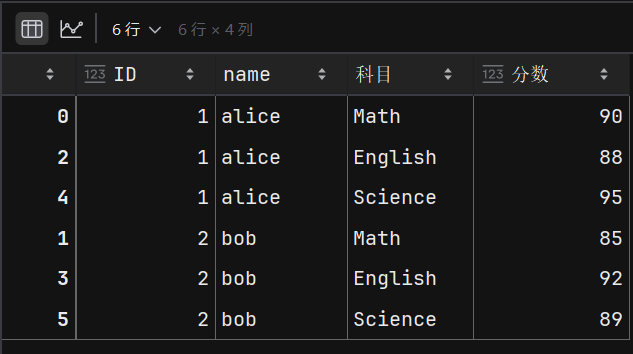
长表转宽表:
python
pd.pivot(df2, index=['ID', 'name'], columns='科目', values='分数')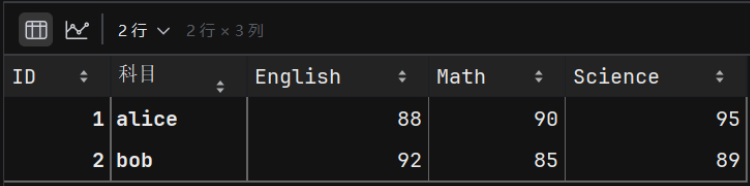
3.2 数据分列
python
# 分列
data = {
    'ID': [1, 2],
    'name': ['alice smith', 'bob smith'],
    'Math': [90, 85],
    'English': [88, 92],
    'Science': [95, 89]
}
df = pd.DataFrame(data)
print(df)

# name列按照空格切分,拆成两列,分别赋值给新列 first、last
df[['first', 'last']] = df['name'].str.split(" ", expand=True) 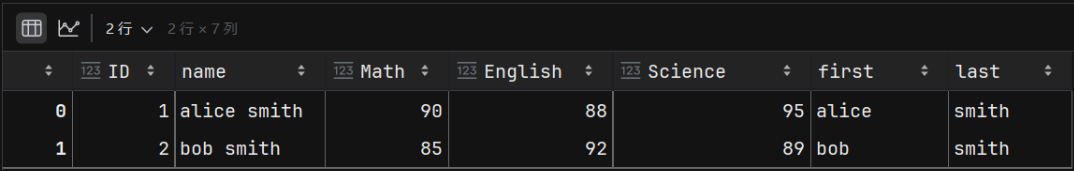
3.3 数据分箱
数据分箱 :将 连续型数值 ,按照规则切分成若干区间,转化为离散类别。本质:连续变量 → 分类变量。
作用:
- 消除异常值的影响,弱化极端值干扰
- 简化模型、降低噪声,适合统计分析 / 建模
- 方便做分组对比(如年龄:0-18 青年,18-40 中年,40 + 老年)
两种常用类型:
- 等据分箱:每个区间跨度一样。例:工资每 2000 一档
- 等频(等深)分箱:每个区间样本数量一样,区间宽度可变。
测试数据如下:
python
# 数据分箱 pd.cut(x,bins,labels)
df = pd.read_csv('data/employees.csv')
df1 = df.head(10)[['employee_id', 'salary']]
df1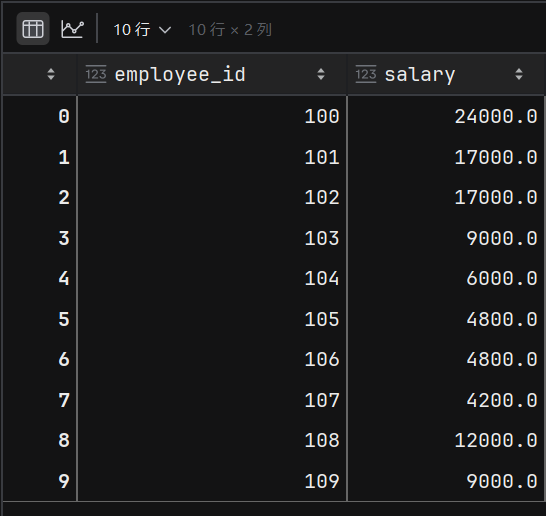
3.3.1 等据分箱
pd.cut:区间宽度一样,样本数量不一定相等
示例1:bins = N
python
cut1 = pd.cut(df1['salary'], bins=2)
print(cut1)
# bins=n,表示分成 N 段区间
# 起始值、结束值是所有数据的最小值 4200、最大值 24000
# 总跨度:(24000 - 4200 = 19800),单段宽度 = (19800 / 2 = 9900)
# 第 1 段:[4200, 14100]、第 2 段:(14100, 24000]
cut1.value_counts()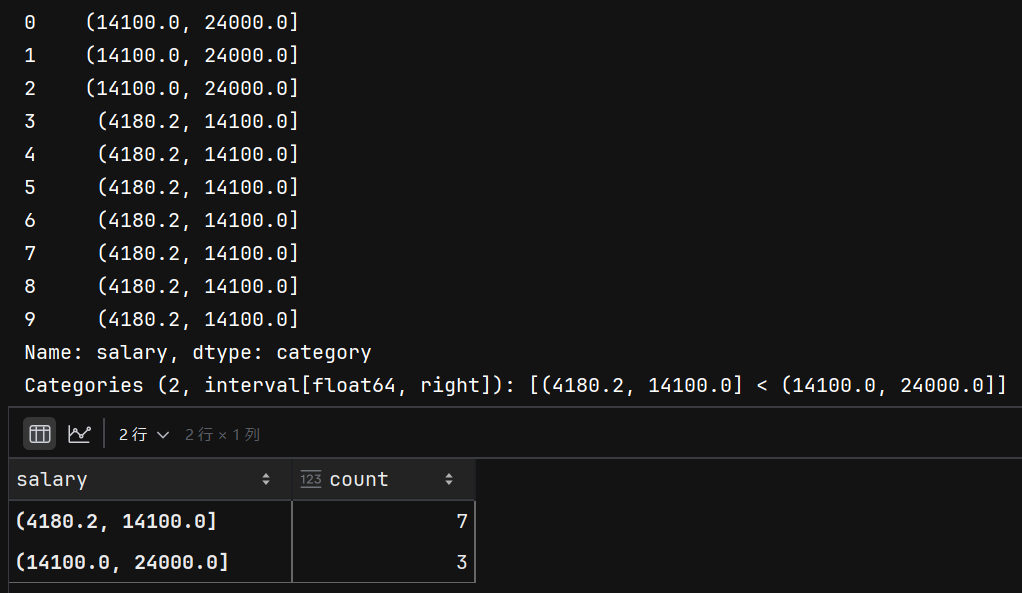
示例2:bins=list
python
cut2 = pd.cut(df1['salary'], bins=[0, 10000, 20000, 30000])  # bins=list,表示分成N段区间
print(cut2)
cut2.value_counts()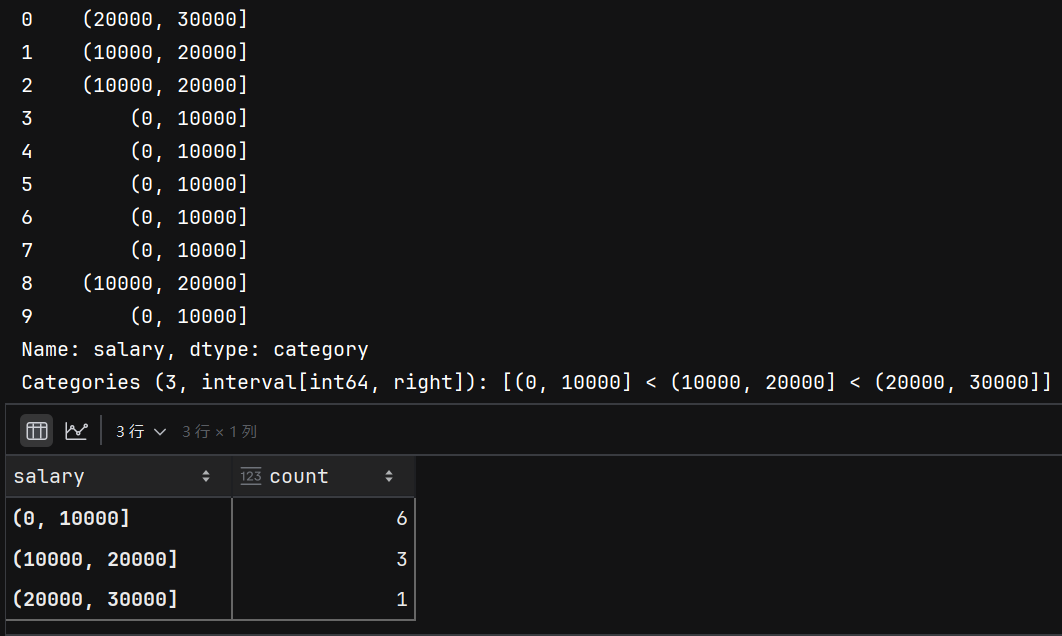
示例3:bins=list,并设置 labels
python
cut3 = pd.cut(
    df1['salary'],
    bins=[0, 10000, 20000, 30000],
    labels=['低', '中', '高']
)  # bins=list,表示分成N段区间
print(cut3)
df1['收入范围'] = pd.cut( # 新增数据列
    df1['salary'],
    bins=[0, 10000, 20000, 30000],
    labels=['低', '中', '高']
)
df1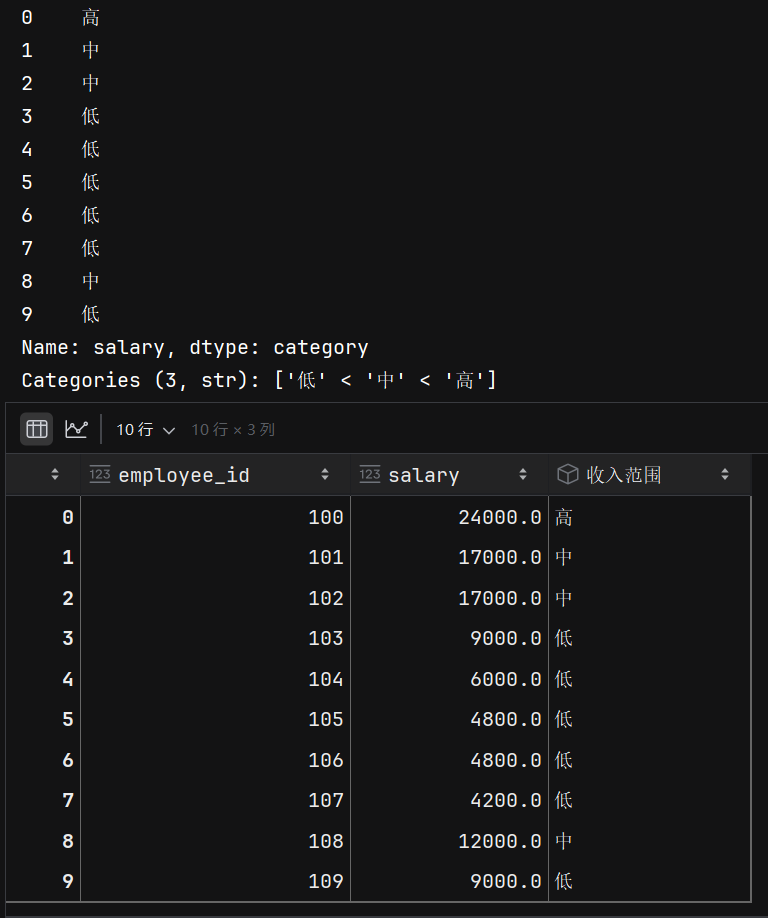
3.3.2 等频分箱
pd.qcut:每个箱子样本数量差不多,区间宽度可变
python
pd.qcut(df1['salary'], 3).value_counts()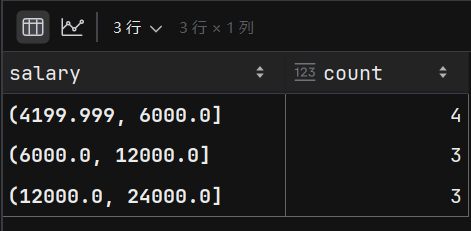
3.3.3 数据分箱应用
数据分箱主要服务于统计分析:
- 字符串类型本身可直接转为 category 类别类型,再开展统计;
- 数值型数据需要先执行分箱操作,生成 category 类别特征,再进行统计分析。
示例1:字符串类型统计
python
df['gender'] = df['gender'].astype('category') # 转换为category
df['gender'].value_counts()
# gender
# Female    201
# Male      199
示例2:数值型数据统计
python
df = pd.read_csv('data/sleep.csv')
df2 = df.head(10)[['person_id', 'sleep_quality']]
df2['睡眠质量'] = pd.cut(
    df2['sleep_quality'],
    bins=3,
    labels=['差', '中', '优秀']
)
print(df2['睡眠质量'].value_counts())
# print(df2['睡眠质量'].dtype)  # 睡眠质量: category
df2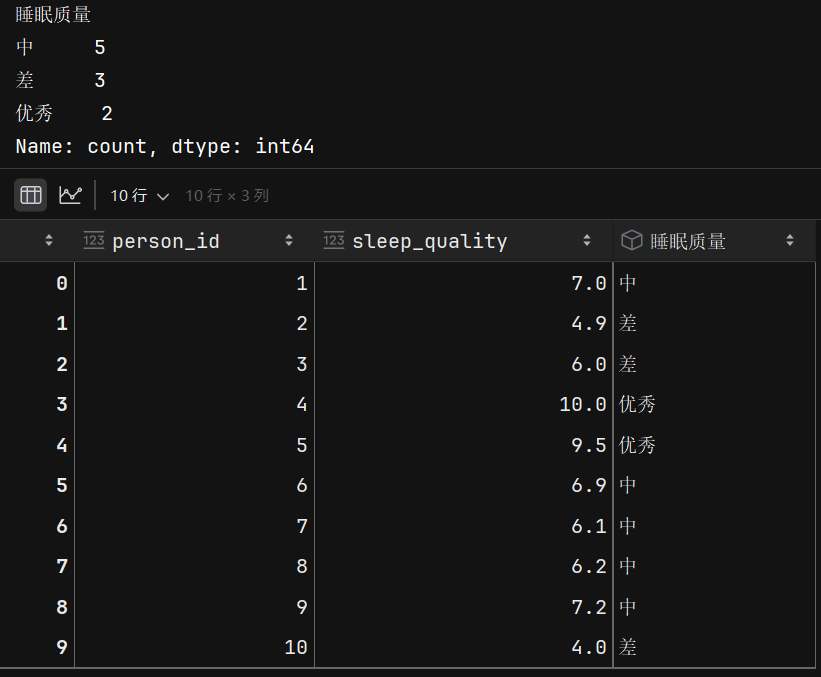
3.4 设置索引、修改列名
python
df.rename():修改列名或行索引名称,不改变数据结构
df.set_index():设索引,拿某一列当行索引
df.reset_index():还原索引,把索引变回普通列,重建 0 开始数字索引
python
df = pd.DataFrame({
    'name': ['jack', 'alice', 'tom', 'bob'],
    'age': [20, 30, 40, 50],
    'gender': ['female', 'male', 'male', 'female']
})
#     name  age  gender
# 0   jack   20  female
# 1  alice   30    male
# 2    tom   40    male
# 3    bob   50  female

# `inplace=True`:就地修改原数据,不返回新 DataFrame;
# `inplace=False`(默认):生成副本,原数据不变。

# df.set_index('name', inplace=True)  # 设置name列为索引
df = df.set_index('name')  # 推荐用
#        age  gender
# name
# jack    20  female
# alice   30    male
# tom     40    male
# bob     50  female
df = df.reset_index()

df.rename(columns={'age': '年龄'}, index={0: 4})  # age列名改成年龄,索引0改成4
# 也可批量设置
df.index = [1, 2, 3, 4]
df.columns = ['姓名', '年龄', '性别']
3.5 分组聚合
分组聚合 :先按照指定字段对数据集分组 ,再对每组数据执行统计计算,将每组多条记录压缩成一条汇总结果。
核心思想 :拆分 → 应用函数 → 合并 (Split-Apply-Combine)。
df.groupby('分组的字段')['聚合的字段'].聚合函数()
测试数据如下:
python
df = pd.read_csv('data/employees.csv')
# 数据处理
print(df['department_id'].isna().sum())  # 检查数据department_id列是否有na
df.dropna(subset=['department_id'], inplace=True)  # 只检查department_id中有na并删除
df['department_id'] = df['department_id'].astype('int64')  # 转换数据类型
df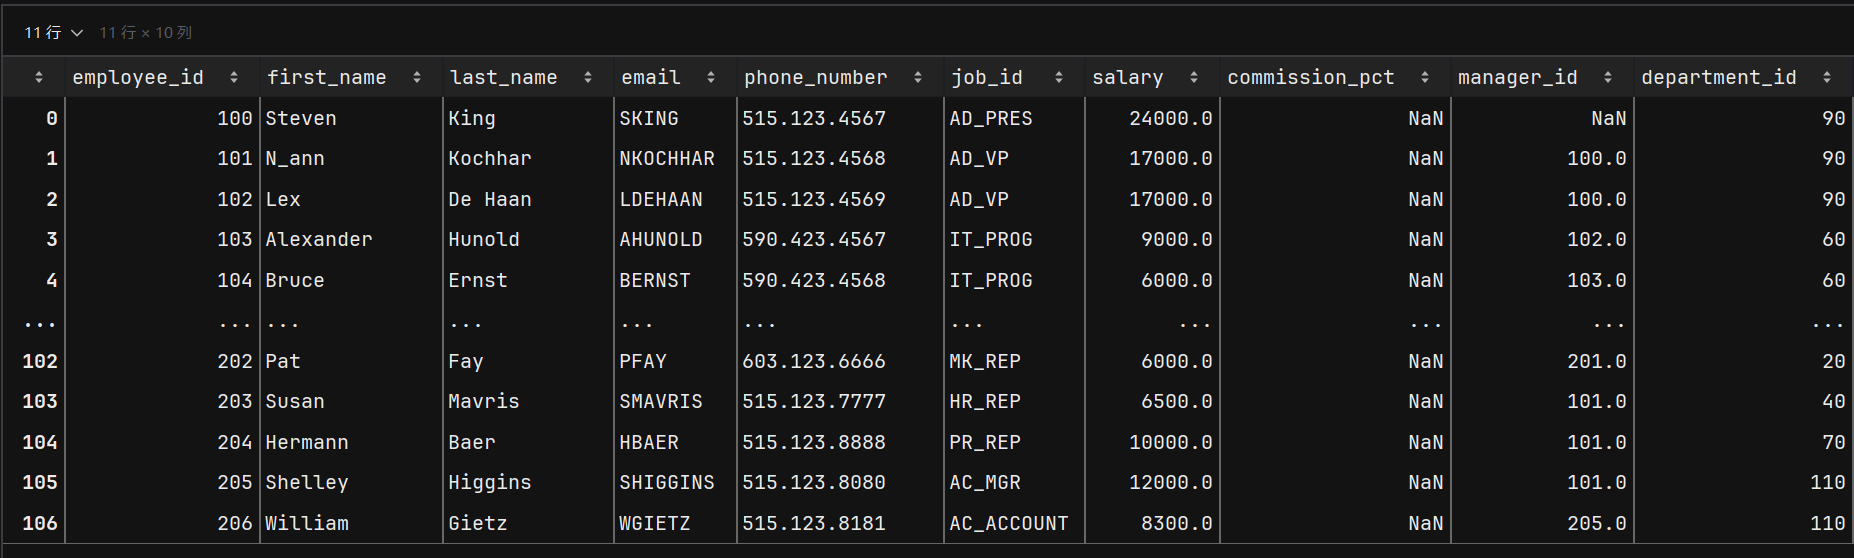
3.5.1 单条件分组聚合
示例1:计算不同部门的平均薪资:
python
print(df.groupby('department_id').groups)  # 查看分组
# {10: [100],
# 20: [101, 102],
# 30: [14, 15, 16, 17, 18, 19],
# 40: [103],
# 50: [20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 80, 81, 82, 83, 84, 85, 86, 87, 88, 89, 90, 91, 92, 93, 94, 95, 96, 97, 98, 99],
# 60: [3, 4, 5, 6, 7],
# 70: [104],
# 80: [45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71, 72, 73, 74, 75, 76, 77, 79],
# 90: [0, 1, 2],
# 100: [8, 9, 10, 11, 12, 13],
# 110: [105, 106]}
print(df.groupby('department_id').get_group(20))  # 查看具体的某个分组的数据

# 计算不同部门的平均薪资
df.groupby('department_id')['salary'].mean()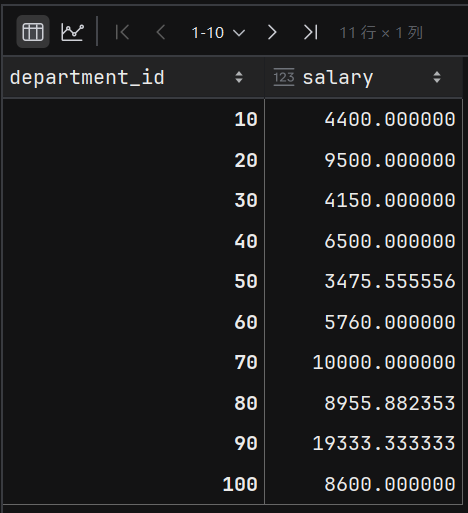
python
# 小数点保留两位
res = df.groupby('department_id')['salary'].mean().round(2)
# 重新设置索引,否则默认当department_id为索引
res = res.reset_index()
# 排序
res.sort_values('salary', ascending=False)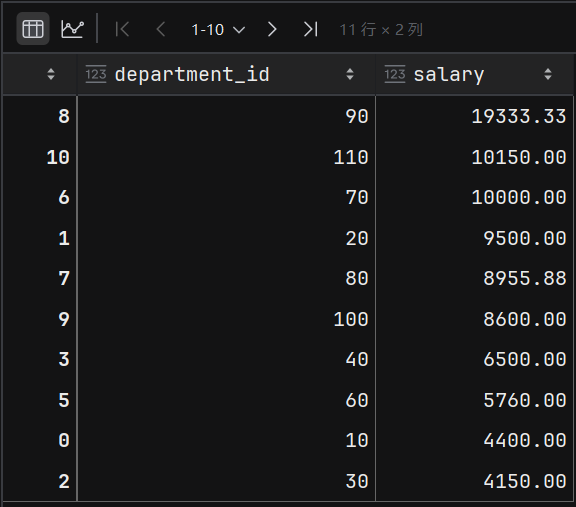
3.5.2 多条件分组聚合
示例2:计算不同部门不同岗位的人的平均薪资
python
res3 = df.groupby(['department_id', 'job_id'])['salary'].mean()
res3.reset_index()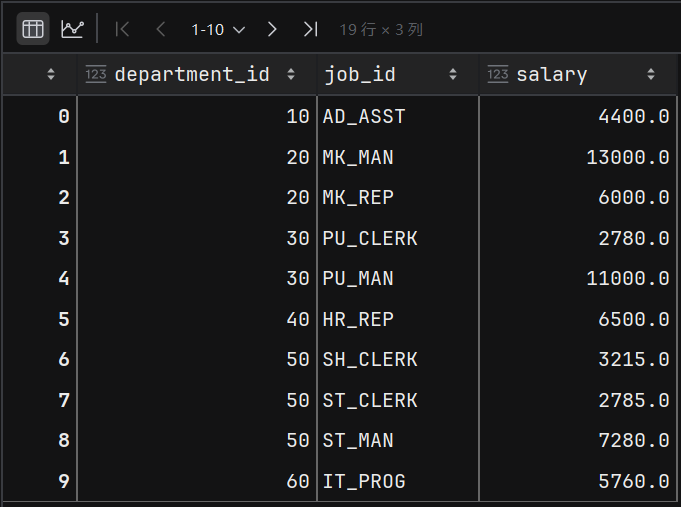
四、综合案例
4.1 企鹅数据分析
把体重分为低中高三个等级
按照性别分组分析
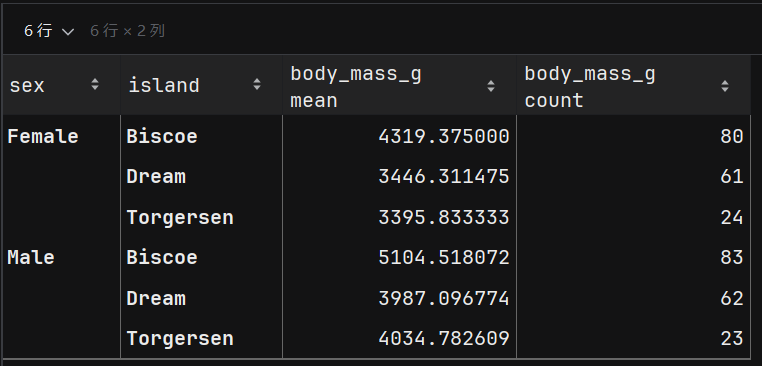
按岛屿和性别分组
python
# 1. 导入必要的库
import numpy as np
import pandas as pd

# 2. 导入数据
df = pd.read_csv('data/penguins.csv')
print(df.head(5))
print(df.info())

# 3. 数据清洗
print(df.isna().sum())
# species               0
# island                0
# bill_length_mm        2
# bill_depth_mm         2
# flipper_length_mm     2
# body_mass_g           2
# sex                  11
df.dropna(inplace=True)
print(df.isna().sum()) # 验证数据清洗

# 4. 数据特征的构造
df['sex'] = df['sex'].astype('category') # 转换数据类型,用于数据统计
df['bill_ratio'] = df['bill_length_mm']/df['bill_depth_mm']

# 5. 数据分析
# 体重分箱:把体重分为低中高三个等级
labels = ['低', '中', '高']
df['mass_level'] = pd.cut(df['body_mass_g'], bins=3, labels=labels)
print(df['mass_level'].value_counts())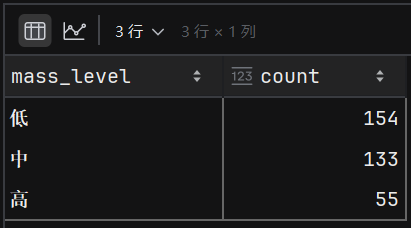
python
# 按照性别分组分析
df.groupby('sex').agg({
    'body_mass_g': ['mean', 'count'],
})
# 按性别分组,每组的`body_mass_g`列,同时算出平均值和样本数量。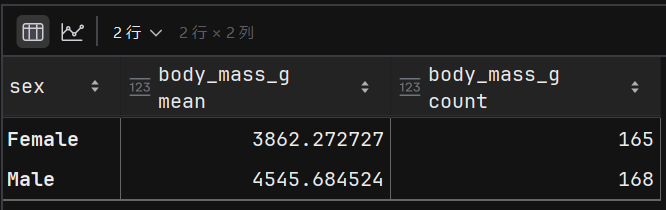
注:.agg() 是聚合函数,是 groupby 里用来一次性执行多个聚合计算的方法。
python
# 按岛屿和性别分组
df.groupby(['sex', 'island']).agg({
    'body_mass_g': ['mean', 'count'],
})
4.2 睡眠质量分析
python
# 1. 导入库
import numpy as np
import pandas as pd

# 2. 导入数据
df = pd.read_csv('data/sleep.csv')
print(df.head(5))
print(df.info())

# 3. 数据清洗
print(df.isna().sum())
print(df['sleep_disorder'].value_counts(dropna=False))  # dropna=False 表示顺便统计nan的数量,否则只统计非Nan的数量
# sleep_disorder
# NaN            290
# Insomnia        79
# Sleep Apnea     31
# Name: count, dtype: int64
df.drop(columns=['sleep_disorder'], inplace=True)  # 删除一列,不分析sleep_disorder列
print(df.isna().sum())  # 验证数据清洗

# 4. 数据特征构造
df['gender'] = df['gender'].astype('category')
df['occupation'] = df['occupation'].astype('category')
df['bmi_category'] = df['bmi_category'].astype('category')
df[['high', 'low']] = df['blood_pressure'].str.split('/', expand=True)  # 数据分列

# 睡眠质量分箱
sleep_quality_labels = ['差', '中', '优']
df['sleep_quality_levels'] = pd.cut(df['sleep_quality'], bins=3, labels=sleep_quality_labels)
age_labels = ['青少年', '中年', '老年']
df['age_level'] = pd.cut(df['age'], bins=3, labels=age_labels)

# 5. 数据统计、分析
df['bmi_category'].value_counts()

# 根据不同bmi进行分组
df.groupby('bmi_category').agg({
    'sleep_duration': 'mean',
    'sleep_quality': 'mean',
    'stress_level': 'mean'
})

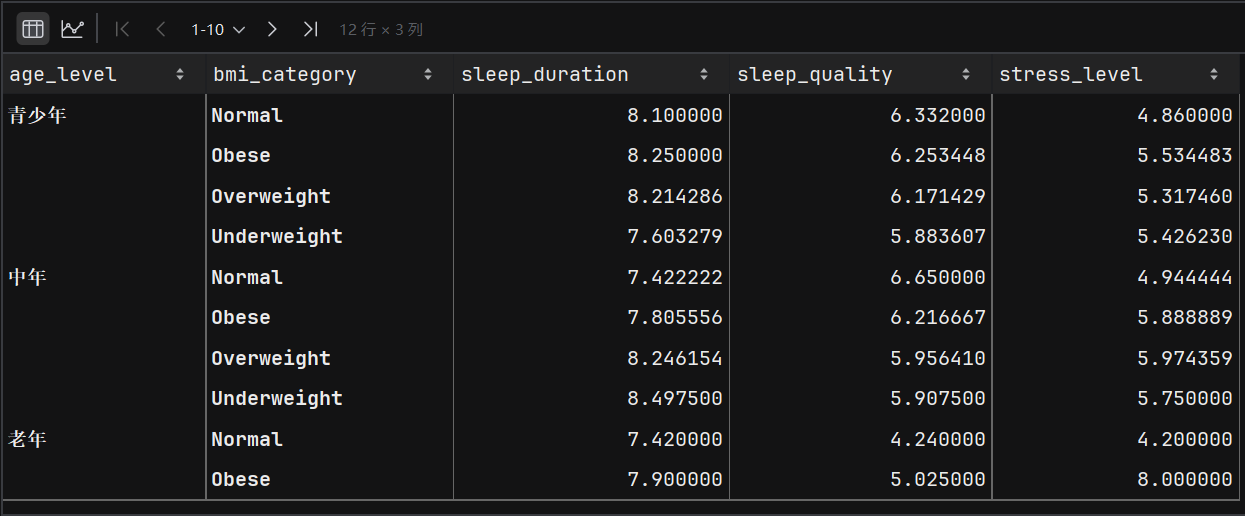
# 根据不同bmi和age_level进行分组
df.groupby(['age_level', 'bmi_category']).agg({
    'sleep_duration': 'mean',
    'sleep_quality': 'mean',
    'stress_level': 'mean'
})