Agent 调用失败后,直接点"重试"并不稳妥。正确顺序是先判断动作有没有副作用,再确认外部系统是否已经收到请求,然后决定自动重试、查状态后继续,还是暂停交给人。读取文件、查询数据、生成草稿通常可以在边界清楚时重试;发送消息、创建工单、修改数据库这类动作,即使界面没有返回成功,也可能已经发生。
这条判断对 Agent Runtime 尤其重要。Runtime 不只是把模型再调用一次,还要记录输入、工具、状态和结果之间的关系。ZGI 的公开仓库把自己定位为可自托管的 Agent Runtime 工作空间,包含工作流编排、模型接入、工具执行和运行日志等能力。对使用团队来说,价值在于把"要不要重试"变成一条能被核对的运行规则,而不是凭感觉多点一次按钮。
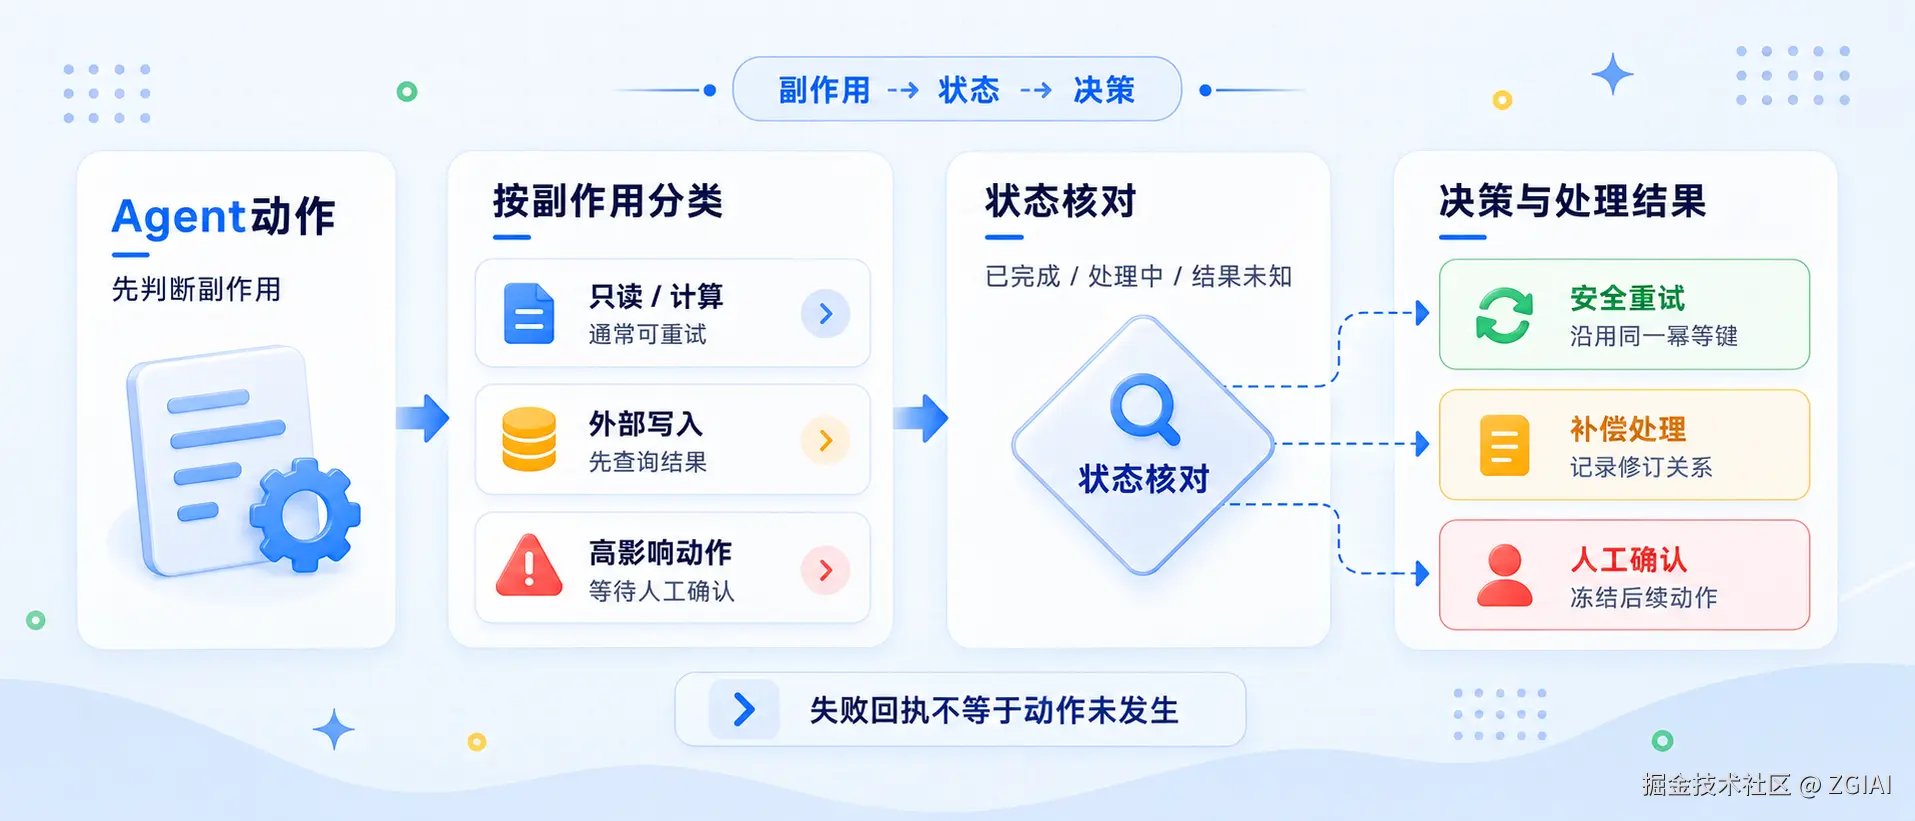
先把动作分成三类
第一类是可安全重试的动作。它们只读取或计算,不会改变外部状态,例如读取文件、查询知识库、调用模型生成临时草稿。重试前仍要确认输入没有变更,并保留同一个任务标识,避免把两次运行误认为两份独立结果。
第二类是需要查状态后重试的动作。请求可能已经发出,只是回执丢失,例如查询接口超时、文件上传卡住、数据库写入返回网络错误。此时不能直接再发一次。应先用请求标识、业务主键或查询接口确认外部系统的现状:已完成就复用结果,处理中就等待,明确失败才重新提交。
第三类是必须人工确认的动作。它们会发送通知、创建工单、触发付款、修改关键记录或对外发布内容。系统无法证明动作是否发生时,暂停比自动补发更安全。人工需要看到原始输入、请求时间、目标对象、返回状态和可能的补偿方式,而不是只看到一句"工具调用失败"。
重试前要留下三份记录
第一份是幂等记录。给一次业务动作分配稳定的幂等键,把任务、步骤和业务对象连起来。相同的键重新到达时,执行器可以返回已有结果或拒绝重复写入。幂等键不能只用当前时间,否则每次重试都会被外部系统当成新请求。
第二份是状态记录。至少区分未开始、执行中、成功、明确失败和结果未知。结果未知不是失败的同义词,它表示系统还不知道外部动作有没有完成。把它单独保留下来,后续才能走查询、等待或人工确认路径。
第三份是补偿记录。对于无法撤销的动作,要提前定义怎么修正:发送了重复通知,就标记并补发更正;写入了错误记录,就记录修订关系;发布动作状态不明,就先冻结后续发布。补偿不是把错误隐藏掉,而是让错误留在可追踪的链路里。
在 ZGI 这类可自托管 Runtime 中,团队可以把模型调用、文件处理、数据库操作、通知和人工审批拆成工作流步骤,再为每一步设置输入、输出和状态。具体的重试次数、幂等策略和人工接管点仍需按业务配置,不能因为系统保存了运行日志,就默认它已经替团队做完了副作用判断。
把"重试"改成一个决策动作
一个可执行的重试规则可以写成:读取类动作直接重试;外部写入先查状态;状态未知且影响范围较大时暂停;确认未发生后再使用同一幂等键提交;完成后重新检查最终结果。这个顺序比"失败就重跑整条流程"多了几步,却能把重复执行的范围压到一个明确节点。
验收时不要只看任务是否显示成功,还要核对哪些步骤复用了旧结果、哪些步骤重新执行、外部系统最终留下了几条记录,以及是否有人工确认。Agent 的可靠性,常常就藏在这些不显眼的运行记录里:每一次重试都有理由,每一次放弃都有边界,每一个未知状态都有下一步。
GitHub:github.com/zgiai/zgi
Gitee:gitee.com/zgiai/zgi