项目:McFit Coach------基于麦当劳 MCP 的健身点餐助手。
开源:github.com/dickeryang/... 。本文只讲一件事:三餐组合算法是怎么三代迭代到可用的。全部数据来自真实回归测试。
一、问题建模
输入:
- 每日目标
T = {kcal, protein_g, fat_g, sodium_max_mg}(Mifflin-St Jeor 公式 + 活动系数 + 目标系数算出) - 可规划餐品集
P = {p | kcal, protein, fat, sodium, price}(菜单与营养表名称对齐后 33 项) - 约束:预算
B(可选)、三餐结构(主餐 + 小食 + 饮品,允许缺省)、全天餐品不重复
输出:三餐方案 + 全天评分。评分函数:
python
# Why: 评分函数就是产品价值观------每一项权重都是可讨论的产品决策
# 热量是主目标(权重 100),蛋白是减脂场景核心痛点(60),脂肪次之(25)
# 钠只罚超限部分,预算罚超支
score = (
    abs(totals["kcal"] - target.kcal) / max(target.kcal, 1) * 100
    + abs(totals["protein"] - target.protein_g) / max(target.protein_g, 1) * 60
    + abs(totals["fat"] - target.fat_g) / max(target.fat_g, 1) * 25
    + max(0.0, totals["sodium"] - target.sodium_max_mg) / 100.0 * 10
    + (max(0.0, totals["price"] - budget) * 12 if budget else 0.0)
)
权重含义:热量是主目标,蛋白是减脂场景的核心痛点(权重 60),脂肪次之,钠只罚超限部分,预算罚超支。
餐位切分:早 30% / 午 40% / 晚 30%,早餐主餐池限定在早餐类目(麦满分、粥、卷类)。
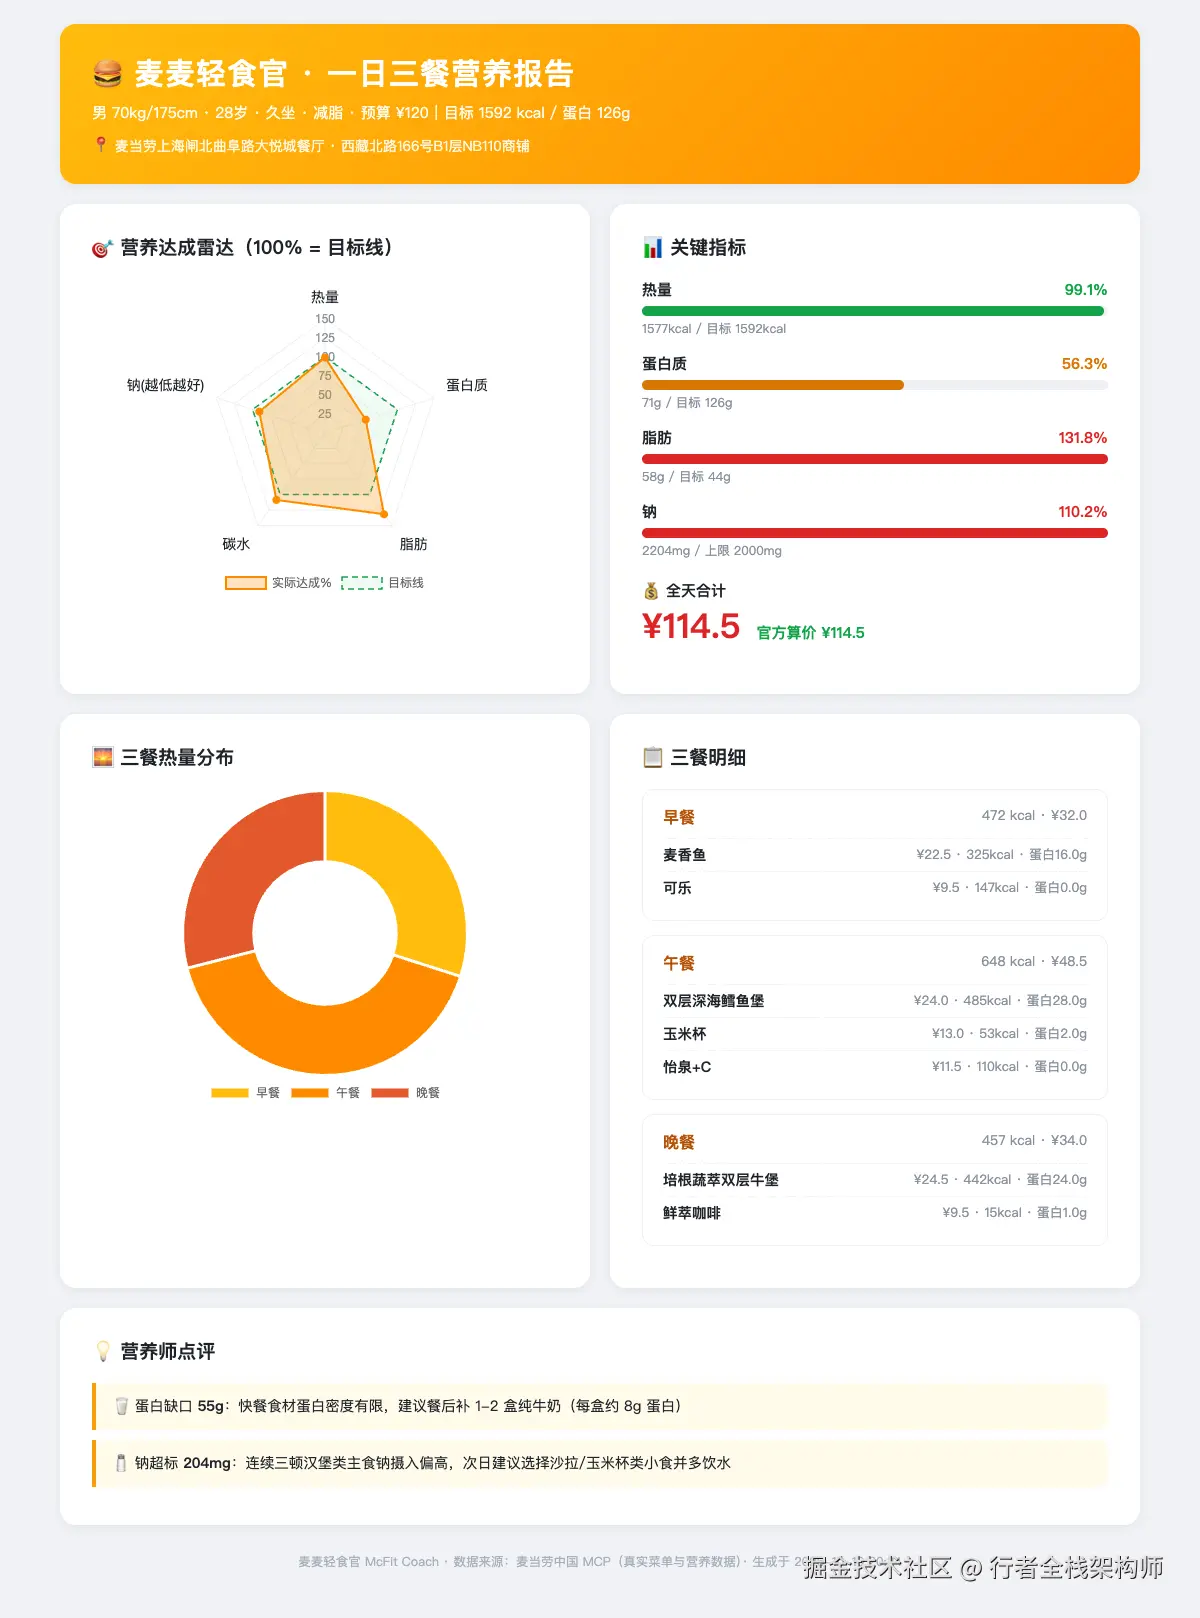
图 1:算法输出的可视化报告。红色/橙色进度条直白呈现「诚实降级」的结果------预算不可行时输出
over_budget: true而不是硬塞方案。
二、v1 贪心 + 硬约束:误差 55%,根因是无解
第一版思路很直觉:每餐从「主餐 + 小食 + 饮品」里贪心选最接近餐位热量目标的组合,预算做硬过滤------价格超过剩余预算的候选直接剔除。
实测男/70kg/减脂/预算 ¥60:早餐花掉 ¥47.5 后,午晚餐剩余预算买不起任何主餐,出现空餐,全天热量误差 55%。
这不是调参能救的。算一笔账:麦当劳主餐单品 ¥22+,¥60 ÷ 3 = ¥20/餐,硬约束下可行域直接为空。贪心 + 随机扰动只是在空集上撒网。
三、v2 软约束:误差 11%,改善但不够
把预算从「过滤」改成「评分惩罚」(超支 ×12 进 score),并对低热量目标允许「轻食餐位」(跳过主餐只配小食+饮品)。误差降到 11%,方案结构完整了,但贪心的局部性暴露:早午晚各自贪各自的,全局组合空间根本没被探索过。
四、v3 两阶段:枚举 + 重组,误差 1~6%
关键观察:每个餐位的组合空间小得惊人。
scss
10 主餐 × (7 小食 + ∅) × (12 饮品 + ∅) − 排除双∅ ≈ 840 种840 种全枚举毫无压力,根本不需要启发式。于是拆成两阶段:
阶段一:餐位内全枚举 Top-K。 对每个餐位枚举全部组合(含缺省的轻食组合;主餐与小食不能同时为空),按「餐位热量偏差 + 蛋白偏差 + 脂肪偏差 + 钠超限 + 轻度价格压力」打分,取 Top-40:
python
# Why: 餐位内局部评分------840 种全枚举里精确排序,取 Top-40 进全局阶段
score = (
    abs(kcal_sum - kcal) / max(kcal, 1) * 100
    + abs(protein_sum - protein) / max(protein, 1) * 40
    + abs(fat_sum - fat) / max(fat, 1) * 20
    + max(0.0, sodium_sum - sodium_cap) * 0.02
    + price_sum * 0.1
)
阶段二:跨餐位 400 轮随机重组。 每轮为三个餐位各选一个组合,选择时有三个惩罚项:
python
# Why: 全局采样近似搜索------局部 840 种精确排序 + 全局 400 轮随机重组
pen = (
    score
    + overlap * 12.0        # 全天去重:与已选餐品重叠的组合被压
    + rng.uniform(0, 6.0)   # 多样性扰动
)
# + 预算软压力:max(0, 已花 + 组合价 - 预算) × 8.0
400 轮取全天评分最优。本质是把全局优化拆成「局部精确 + 全局采样」:局部 840 种里精确排序,全局用随机重组近似搜索。
五、实测数据
| 场景 | v1 | v2 | v3 | v3 耗时 |
|---|---|---|---|---|
| 男 70kg 减脂 / 预算 120 | 空餐 | --- | 误差 1.0%,¥114.5 | ~120ms |
| 女 55kg 均衡 / 预算 100 | --- | 11% | 误差 2.6% | ~90ms |
| 男 65kg 增肌 / 预算 150 | --- | --- | 误差 6.1%,¥147.5 | ~140ms |
且 v3 的价格与麦当劳官方算价接口交叉核验一致(¥114.5 ↔ 11450 分)。
两个工程细节:
- 确定性 :
seed参数贯穿全程随机性,同一 seed 结果可复现------回归测试和报告页演示都依赖这个 - 诚实降级 :预算物理不可行时(如 ¥100 吃满 1721kcal),算法输出
over_budget: true而不是硬塞方案。优化器不撒谎,是设计目标之一
六、名称对齐:另一个隐形工程量
菜单是简化名(「可乐」),营养表是全名(「可乐中杯」),还有全半角括号、规格词(中杯/大杯)、误导性关键词(「麦辣鸡腿堡」含「鸡腿」会被小食规则截胡)。解法:
- 归一化:去空白/装饰符/全半角、统一小写,预计算缓存(对齐循环里不做正则,复杂度从 O(n×m) 次正则降为 O(n×m) 次字典查询)
- 三层匹配:相等 → 互为前缀 → 包含 + 规格偏好排序
- 分类规则有序:主食规则必须在含「鸡腿」的小食规则之前
- 同一营养项只挂第一个菜单项,防重复
最终 99 项菜单对齐 33 项可规划------剩下的组合项(套餐/四件套)营养无法拆解,明确排除而不是硬猜。
七、反思
- 先算组合空间再选算法。如果一开始数了 840 这个数,前两代迭代可以省掉------「空间小就别启发式」这条经验值得刻进肌肉记忆
- 领域数据结构决定算法形态:快餐单价离散度高(¥6 饮品 ~ ¥47 套餐),连续优化的思路全不适用,枚举反而干净
- 评分函数就是产品价值观:蛋白权重 60、钠只罚不奖、预算软压力 ×12------每一项都是可讨论的产品决策,建议读者按自己目标改着玩
仓库里 tests/test_core.py 是样本驱动的离线回归(不需要 Token),欢迎来拆:github.com/dickeryang/...
这是 1024 麦当劳创意开发大赛参赛作品,排名看 Star,觉得算法部分有参考价值就点一个。你写评分函数时会怎么定权重?评论区见。