作者:来自 Elastic David Pilato
我也不太清楚为什么,但我一直非常喜欢邮政地址这个应用场景。在我的职业生涯中,我经常需要处理这类信息。
很多时候,地址信息的格式并不规范,因此当输入的数据集质量不佳时,想要从中找到所需的信息就会变得非常困难。
让我们来看一个简单的应用场景。假设我的数据库中有这样一位用户:
json
`

1.  {
2.    "name": "Joe Smith",
3.    "address": {
4.      "number": "23",
5.      "street_name": "r verdiere",
6.      "city": "rochelle",
7.      "country": "France"
8.    }
9.  }

`AI写代码
如果你住在法国,可能会注意到这个地址的信息相当不完整。如果我们想给 Joe 寄一封信,恐怕会很困难。
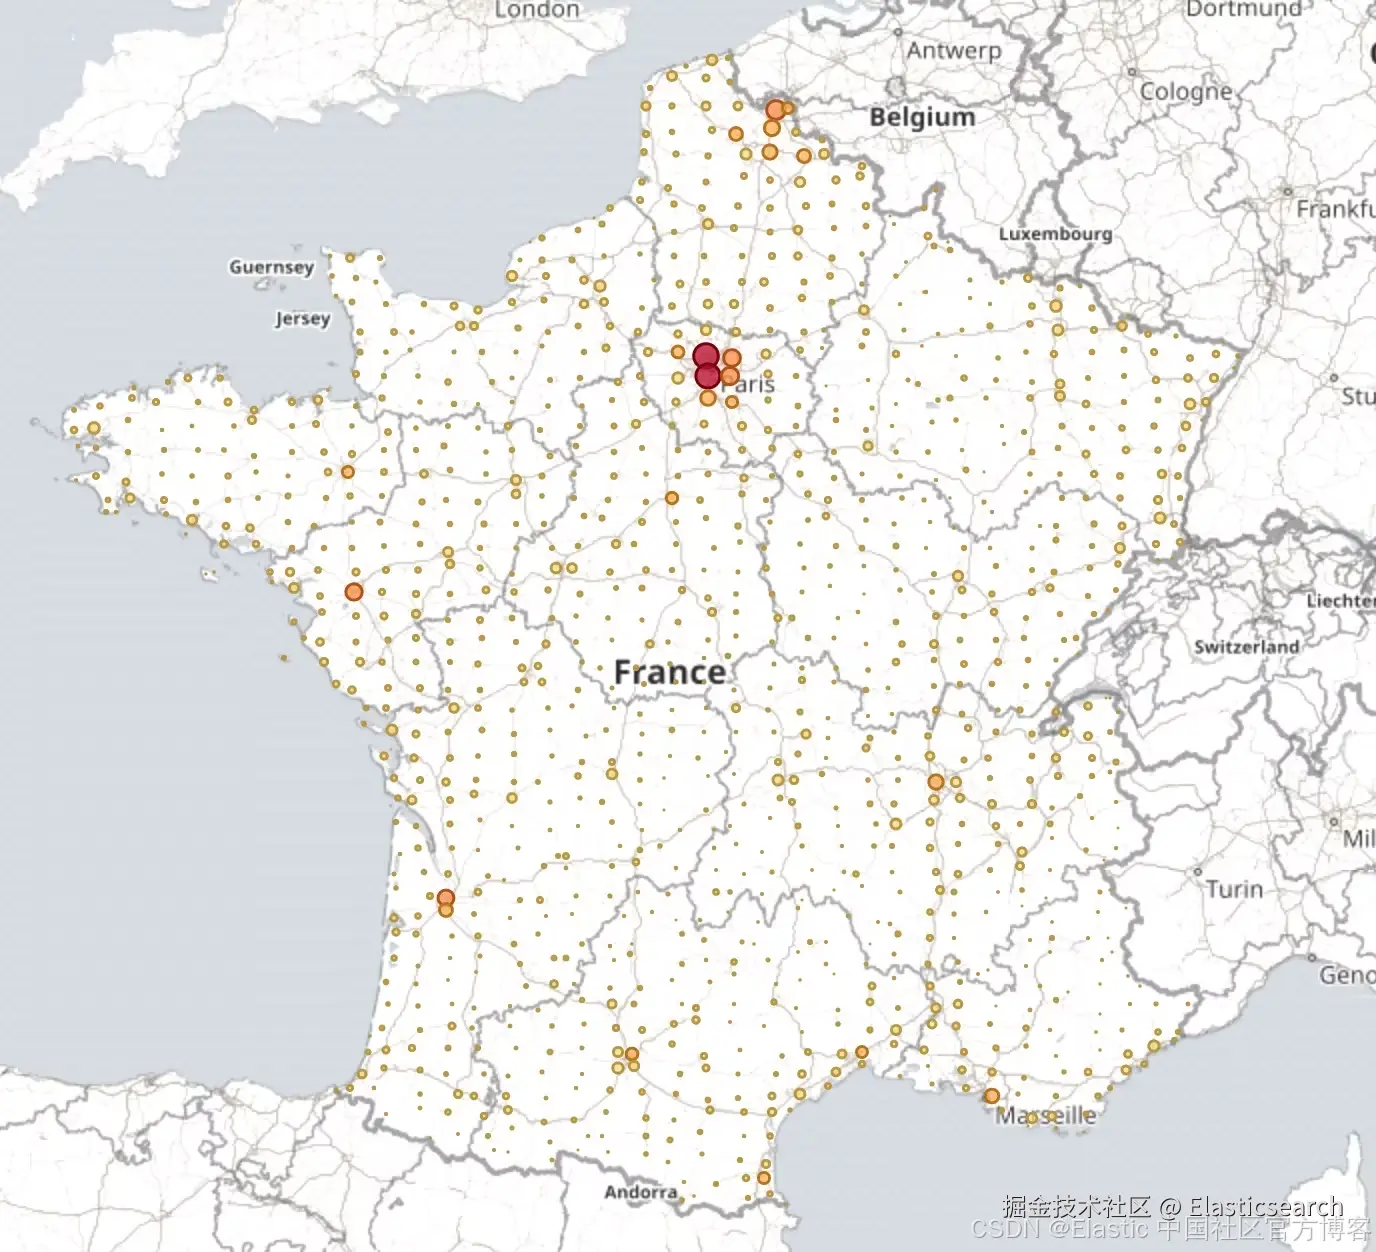
此外,我还非常希望能够在地图上展示我的客户在法国的地理位置分布。
反过来,我们再考虑另一种场景。假设我正在通过一款移动应用收集数据,这款应用用于记录我与朋友见面的情况,而我希望它能够自动记住上次聚会地点的具体地址。
基本上,我拥有的数据如下:
markdown
`

1.  {
2.    "name": "Joe Smith",
3.    "location": {
4.      "lat": 46.15735,
5.      "lon": -1.1551
6.    }
7.  }

`AI写代码
我希望能够根据这些地理位置信息,反向获取与之对应的邮政地址。
那么,我们该如何实现呢?
我们需要一种能够丰富现有数据的解决方案:既可以修正和补全地址信息,并提供对应的实际地理坐标,也可以反过来,根据地理坐标获取对应的邮政地址。
BANO
我们可以使用 Google Maps API 之类的服务,在每次需要时调用外部 API 来实现这些功能。
但在我看来,这种方式存在两个主要问题:
-
数据隐私与安全问题: 我们需要与外部服务通信,而公司的安全策略可能不允许将客户数据等敏感信息发送到互联网上的第三方服务。
-
网络延迟问题: 每次调用外部服务都可能产生一定的网络延迟,而且我们很难控制或优化外部服务的响应速度。毕竟,光速存在物理限制,跨越大洋进行网络通信始终可能带来额外的延迟。
因此,我们需要一种能够在本地运行的解决方案。
幸运的是,在法国,我们拥有一个名为 BANO 的公共数据集。
BANO 是 Base d'Adresses NatiOnale 的缩写,意为"国家地址数据库"(National Address Database),由 OpenStreetMap 生态系统提供。
该项目每天都会导出一份覆盖法国各地的已知地址列表。
下面是该数据集中的一部分示例数据:
markdown
`
1. -rw-r--r--@ 1 dpilato staff 11183891 27 nov 02:03 bano-88.csv
2. -rw-r--r--@ 1 dpilato staff 25014545 27 nov 02:04 bano-85.csv
3. -rw-r--r--@ 1 dpilato staff 3888078 27 nov 02:04 bano-971.csv
4. -rw-r--r--@ 1 dpilato staff 12107391 27 nov 02:04 bano-92.csv
5. -rw-r--r--@ 1 dpilato staff 3443396 27 nov 02:04 bano-972.csv
6. -rw-r--r--@ 1 dpilato staff 1218424 27 nov 02:05 bano-973.csv
7. -rw-r--r--@ 1 dpilato staff 455986 27 nov 02:05 bano-976.csv
8. -rw-r--r--@ 1 dpilato staff 21634994 27 nov 02:05 bano-91.csv
9. -rw-r--r--@ 1 dpilato staff 15848802 27 nov 02:05 bano-93.csv
10. -rw-r--r--@ 1 dpilato staff 14779208 27 nov 02:05 bano-94.csv
11. -rw-r--r--@ 1 dpilato staff 17515805 27 nov 02:06 bano-95.csv
12. -rw-r--r--@ 1 dpilato staff 17713007 27 nov 02:07 bano-974.csv
13. -rw-r--r--@ 1 dpilato staff 71133336 27 nov 02:08 bano-59.csv
`AI写代码每个 CSV 文件都对应法国的一个行政区划单位,我们称之为 省(Department,法语为 Département)。它类似于大区(Region),但行政范围更小,同时又比城市更大。
下载 BANO CSV 文件
我编写了一个简单的 Shell 脚本,将所需的所有文件下载到本地。不过,你也可以直接使用 Logstash 的 http_poller 插件,从 HTTP 数据源读取 CSV 文件,而无需事先将其下载到本地。
bash
`
1. #!/bin/bash
2. set -e
4. download () {
5. wget http://bano.openstreetmap.fr/data/$1 --timestamping --directory-prefix=bano-data -c --no-verbose --show-progress
6. }
8. DEPTS=95
9. for i in {01..19} $(seq 21 $DEPTS) {971..974} {976..976} ; do
10. DEPT=$(printf %02d $i)
11. echo Downloading bano department $DEPT
12. download bano-$DEPT.csv
13. done
`AI写代码这些编号是怎么回事呢?
法国的行政区划并不是一成不变的。有时,一些省份会被合并,这可能解释了为什么我们现在已经找不到编号为 20 的省份。
此外,法国还有一些省份位于距离法国本土非常遥远的海外地区。这些省份的编号通常以 97x 开头。
在法国,事情似乎永远都没那么简单。😅
将数据加载到 Elasticsearch
现在,让我们解析这些数据并将其加载到 Elasticsearch 中,以便后续能够搜索地址信息。
如果我们查看其中一个 CSV 文件,可以看到如下内容:
markdown
`
1. 976030950H-26,26,RUE DISMA,97660,Bandrélé,CAD,-12.891701,45.202652
2. 976030950H-28,28,RUE DISMA,97660,Bandrélé,CAD,-12.891900,45.202700
3. 976030950H-30,30,RUE DISMA,97660,Bandrélé,CAD,-12.891781,45.202535
4. 976030950H-32,32,RUE DISMA,97660,Bandrélé,CAD,-12.892005,45.202564
5. 976030950H-3,3,RUE DISMA,97660,Bandrélé,CAD,-12.892444,45.202135
6. 976030950H-34,34,RUE DISMA,97660,Bandrélé,CAD,-12.892068,45.202450
7. 976030950H-4,4,RUE DISMA,97660,Bandrélé,CAD,-12.892446,45.202367
8. 976030950H-5,5,RUE DISMA,97660,Bandrélé,CAD,-12.892461,45.202248
9. 976030950H-6,6,RUE DISMA,97660,Bandrélé,CAD,-12.892383,45.202456
10. 976030950H-8,8,RUE DISMA,97660,Bandrélé,CAD,-12.892300,45.202555
11. 976030950H-9,9,RUE DISMA,97660,Bandrélé,CAD,-12.892355,45.202387
12. 976030951J-103,103,RTE NATIONALE 3,97660,Bandrélé,CAD,-12.893639,45.201696
13. \_ ID | \_ Street Name | \ \_ Source \_ Geo point
14. | | \
15. |_ Street Number |_ Zipcode \_ City Name
`AI写代码编写 Logstash Pipeline (数据处理管道)
和往常编写 Logstash Pipeline 一样,我总是先从一个基础配置文件开始。我们将这个文件命名为 bano-data.conf:
markdown
`
1. input {
2. stdin { }
3. }
5. filter {
6. }
8. output {
9. stdout { codec => json }
10. }
`AI写代码让我们运行一下:
bash
`head -1 | logstash-6.2.3/bin/logstash -f bano-data.conf`AI写代码运行后,我们会得到类似下面的结果:
json
`

1.  {
2.    "message":"976030951J-103,103,RTE NATIONALE 3,97660,Bandrélé,CAD,-12.893639,45.201696",
3.    "@timestamp":"2017-12-05T16:00:00.000PST",
4.    "@version":1,
5.    "host":"MacBook-Pro-David.local"
6.  }

`AI写代码
接下来,让我们添加 csv-filter 插件,就像我们之前在 探索 Capitaine Train 数据集 一文中介绍的那样:
ini
`

1.  csv {
2.    separator => ","
3.    columns => [
4.      "id","number","street_name","zipcode","city","source","latitude","longitude"
5.    ]
6.    remove_field => [ "message", "@version", "@timestamp", "host" ]
7.  }

`AI写代码
现在,生成的结果如下:
bash
`
1. {
2. "source":"CAD",
3. "id":"976030951J-103",
4. "number":"103",
5. "street_name":"RTE NATIONALE 3",
6. "zipcode":"97660",
7. "city":"Bandrélé",
8. "latitude":"-12.893639",
9. "longitude":"45.201696"
10. }
`AI写代码接下来,让我们使用 mutate-filter 插件对部分字段进行重命名和数据类型转换:
ini
`
1. mutate {
2. convert => { "longitude" => "float" }
3. convert => { "latitude" => "float" }
4. rename => {
5. "longitude" => "[location][lon]"
6. "latitude" => "[location][lat]"
7. "number" => "[address][number]"
8. "street_name" => "[address][street_name]"
9. "zipcode" => "[address][zipcode]"
10. "city" => "[address][city]"
11. }
12. replace => {
13. "region" => "${REGION}"
14. }
15. }
`AI写代码稍后我会解释 ${REGION} 这个值是从哪里来的。
简单来说,我希望在这个字段中存储地址所属的省份编号。
现在,处理后的结果如下:
bash
`
1. {
2. "source":"CAD",
3. "id":"976030951J-103",
4. "region":"976",
5. "address":{
6. "number":"103",
7. "street_name":"RTE NATIONALE 3",
8. "zipcode":"97660",
9. "city":"Bandrélé"
10. },
11. "location":{
12. "lat":-12.893639,
13. "lon":45.201696
14. }
15. }
`AI写代码我们已经快完成了。现在,让我们添加 elasticsearch-output 插件,将数据加载到 Elasticsearch 中:
dart
`

1.  elasticsearch {
2.    "template_name" => "bano"
3.    "template_overwrite" => true
4.    "template" => "bano.json"
5.    "index" => ".bano-${REGION}"
6.    "document_id" => "%{[id]}"
7.  }

`AI写代码
在上一段代码示例中,有几个值得进一步说明的地方:
-
我们为 Elasticsearch 提供了一个索引模板(Index Template)。
-
我们将
_index名称设置为.bano-${REGION}。同样,稍后会解释${REGION}这个值的来源。 -
我们将文档的
_id设置为 BANO 数据集中提供的id字段值。
BANO 索引模板
正如你所看到的,我们在这里使用了一个名为 bano 的索引模板。每次 Logstash 的 elasticsearch 输出插件启动时,都会加载该模板。
通过设置 template_overwrite,我们可以在需要修改模板规则时覆盖现有的索引模板。
当然,覆盖索引模板并不会自动更新已经存在的索引。
因此,如果希望新的模板规则应用到现有数据,通常需要删除已有索引,然后使用 Logstash 重新解析并导入 BANO 数据。
接下来,让我们看看这个索引模板具体包含哪些内容:
json
`

1.  {
2.    "template": ".bano-*",
3.    "settings": { /* ... */ },
4.    "mappings": { /* ... */ },
5.    "aliases" : { /* ... */ }
6.  }

`AI写代码
该索引模板会应用于所有名称以 .bano- 开头的索引。
模板主要包含以下三个部分:
-
settings:用于配置索引设置。 -
mappings:用于定义文档的字段映射(Mapping)。 -
aliases:用于配置虚拟索引,即索引别名(Alias)。
其中,settings 部分的配置如下:
css
`
1. {
2. "template": ".bano-*",
3. "settings": {
4. "index.number_of_shards": 1,
5. "index.number_of_replicas": 0,
6. "index.analysis": {
7. "analyzer": {
8. "bano_analyzer": {
9. "type": "custom",
10. "tokenizer": "standard",
11. "filter" : [ "lowercase", "asciifolding" ]
12. },
13. "bano_street_analyzer": {
14. "type": "custom",
15. "tokenizer": "standard",
16. "filter" : [ "lowercase", "asciifolding", "bano_synonym" ]
17. }
18. },
19. "filter": {
20. "bano_synonym": {
21. "type": "synonym",
22. "synonyms": [
23. "bd => boulevard",
24. "av => avenue",
25. "r => rue",
26. "rte => route"
27. ]
28. }
29. }
30. }
31. },
32. "mappings": { /* ... */ },
33. "aliases" : { /* ... */ }
34. }
`AI写代码在这里,我们希望为每个索引(即每个省份)只配置一个主分片(Primary Shard),这已经绰绰有余。
由于我们将在单节点集群上运行,因此不需要配置副本分片(Replica Shard)。
注意
副本数量可以动态调整。因此,在完成 BANO 数据导入后,如果我们决定将集群扩展为更大规模,仍然可以随时增加副本数量。
接下来,我们定义了两个分析器(Analyzer)。
第一个分析器名为 bano_analyzer,它与 Elasticsearch 的 standard 分析器类似,但额外添加了一个 asciifolding Token Filter(词元过滤器)。
该过滤器会在索引和搜索阶段,将法语中的重音字符转换为对应的 ASCII 字符。
例如,é、è 和 ê 都会被转换为 e。
第二个分析器名为 bano_street_analyzer,它还增加了同义词处理功能。
实际上,在查看 BANO 数据集中的部分字段值时,我发现同一种道路类型有时会使用不同的名称或缩写。
例如,av 是 avenue(大道)的缩写。
通过使用 synonym Token Filter(同义词过滤器),我们可以对这些不同的表达方式进行标准化处理。
由于该分析器也会在搜索阶段使用,因此即使呼叫中心的工作人员输入 bd 而不是完整的 boulevard(林荫大道),系统也能将其标准化为正确的形式,从而提高地址搜索的准确性。
接下来,mappings 部分的配置如下:
css
`
1. {
2. "template": ".bano-*",
3. "settings": { /* ... */ },
4. "mappings": {
5. "doc": {
6. "properties" : {
7. "address": {
8. "properties" : {
9. "city": {
10. "type": "text",
11. "analyzer": "bano_analyzer",
12. "fields": {
13. "keyword": {
14. "type": "keyword"
15. }
16. }
17. },
18. "number": {
19. "type": "keyword"
20. },
21. "street_name": {
22. "type": "text",
23. "analyzer": "bano_street_analyzer"
24. },
25. "zipcode": {
26. "type": "keyword"
27. }
28. }
29. },
30. "region": {
31. "type": "keyword"
32. },
33. "id": {
34. "type": "keyword"
35. },
36. "source": {
37. "type": "keyword"
38. },
39. "location": {
40. "type": "geo_point"
41. }
42. }
43. }
44. },
45. "aliases" : { /* ... */ }
46. }
`AI写代码这里的大部分配置都比较直观。
对于某些字段,我们使用了 keyword 数据类型,因为我们只需要对这些字段执行精确匹配查询或聚合分析。
street_name 字段使用了前面介绍的 bano_street_analyzer 分析器。
city 字段则以两种方式建立索引:
-
city字段:用于执行全文搜索(Full-text Search)。 -
city.keyword字段:用于执行词项聚合(Terms Aggregation)。
最后,location 字段使用 geo_point 数据类型,用于存储地理坐标信息。
接下来,aliases 部分的配置如下:
json
`

1.  {
2.    "template": ".bano-*",
3.    "settings": { /* ... */ },
4.    "mappings": { /* ... */ },
5.    "aliases" : {
6.      ".bano" : {}
7.    }
8.  }

`AI写代码
这意味着,如果我们在搜索地址时不知道它所属的省份,就可以直接查询 .bano 这个虚拟索引(索引别名)。Elasticsearch 会在后台自动查询所有关联的 BANO 索引。
当然,我们也可以在搜索时使用通配符(Wildcard)来匹配所有相关索引,例如:
bash
`GET .bano-*/_search`AI写代码加载数据
为了启动数据导入过程,让我们编写一个 Shell 脚本:
bash
`
1. import_region () {
2. export REGION=$1
3. FILE=bano-data/bano-$REGION.csv
4. curl -XDELETE localhost:9200/.bano-$REGION?pretty
5. cat $FILE | logstash-6.2.3/bin/logstash -f bano-data.conf
6. }
8. DEPTS=95
9. for i in {01..19} $(seq 21 $DEPTS) {971..974} {976..976} ; do
10. DEPT=$(printf %02d $i)
11. import_region $DEPT
12. done
`AI写代码这里,我们同样使用了一些技巧来处理那些特殊的省份编号。
在 import_region 函数中,我们将省份编号导出为名为 REGION 的环境变量,随后 Logstash 就可以读取并使用这个变量。
对于每个 CSV 文件,我们基本上执行以下操作:
-
如果对应的索引已经存在,则先将其删除。
-
使用
cat命令读取文件内容,并将其传递给 Logstash 进行处理。
其实,我们还可以采用一种更灵活的方式:使用 http 输入插件,让 Logstash 监听 8080 端口,等待接收传入的文档。
我们将在下一节中介绍这种方法。
在我的笔记本电脑上,整个数据导入过程大约花费了 两个半小时。不过,现在所有数据都已经导入完成,可以开始使用了......
BANO 数据统计
那么,现在我们究竟拥有了哪些数据呢?
ini
`GET _cat/indices/.bano*?v&h=index,docs.count,store.size`AI写代码得到的结果如下(这里只展示前几行):
markdown
`

1.  index     docs.count store.size
2.  .bano-80      204930     20.7mb
3.  .bano-50      160820     16.4mb
4.  .bano-60      241276     24.6mb
5.  .bano-34      308056     30.9mb

`AI写代码
我们一共有多少条地址数据?
bash
`

1.  GET .bano/_search
2.  {
3.    "size": 0
4.  }

`AI写代码
得到的结果如下:
bash
`
1. {
2. "took": 24,
3. "timed_out": false,
4. "_shards": {
5. "total": 99,
6. "successful": 99,
7. "skipped": 0,
8. "failed": 0
9. },
10. "hits": {
11. "total": 16402853,
12. "max_score": 0,
13. "hits": []
14. }
15. }
`AI写代码因此,我们现在共有 16,402,853 条地址数据。
接下来,让我们通过 Kibana 查看这些数据。在这里,我创建了一些非常简单的可视化图表。
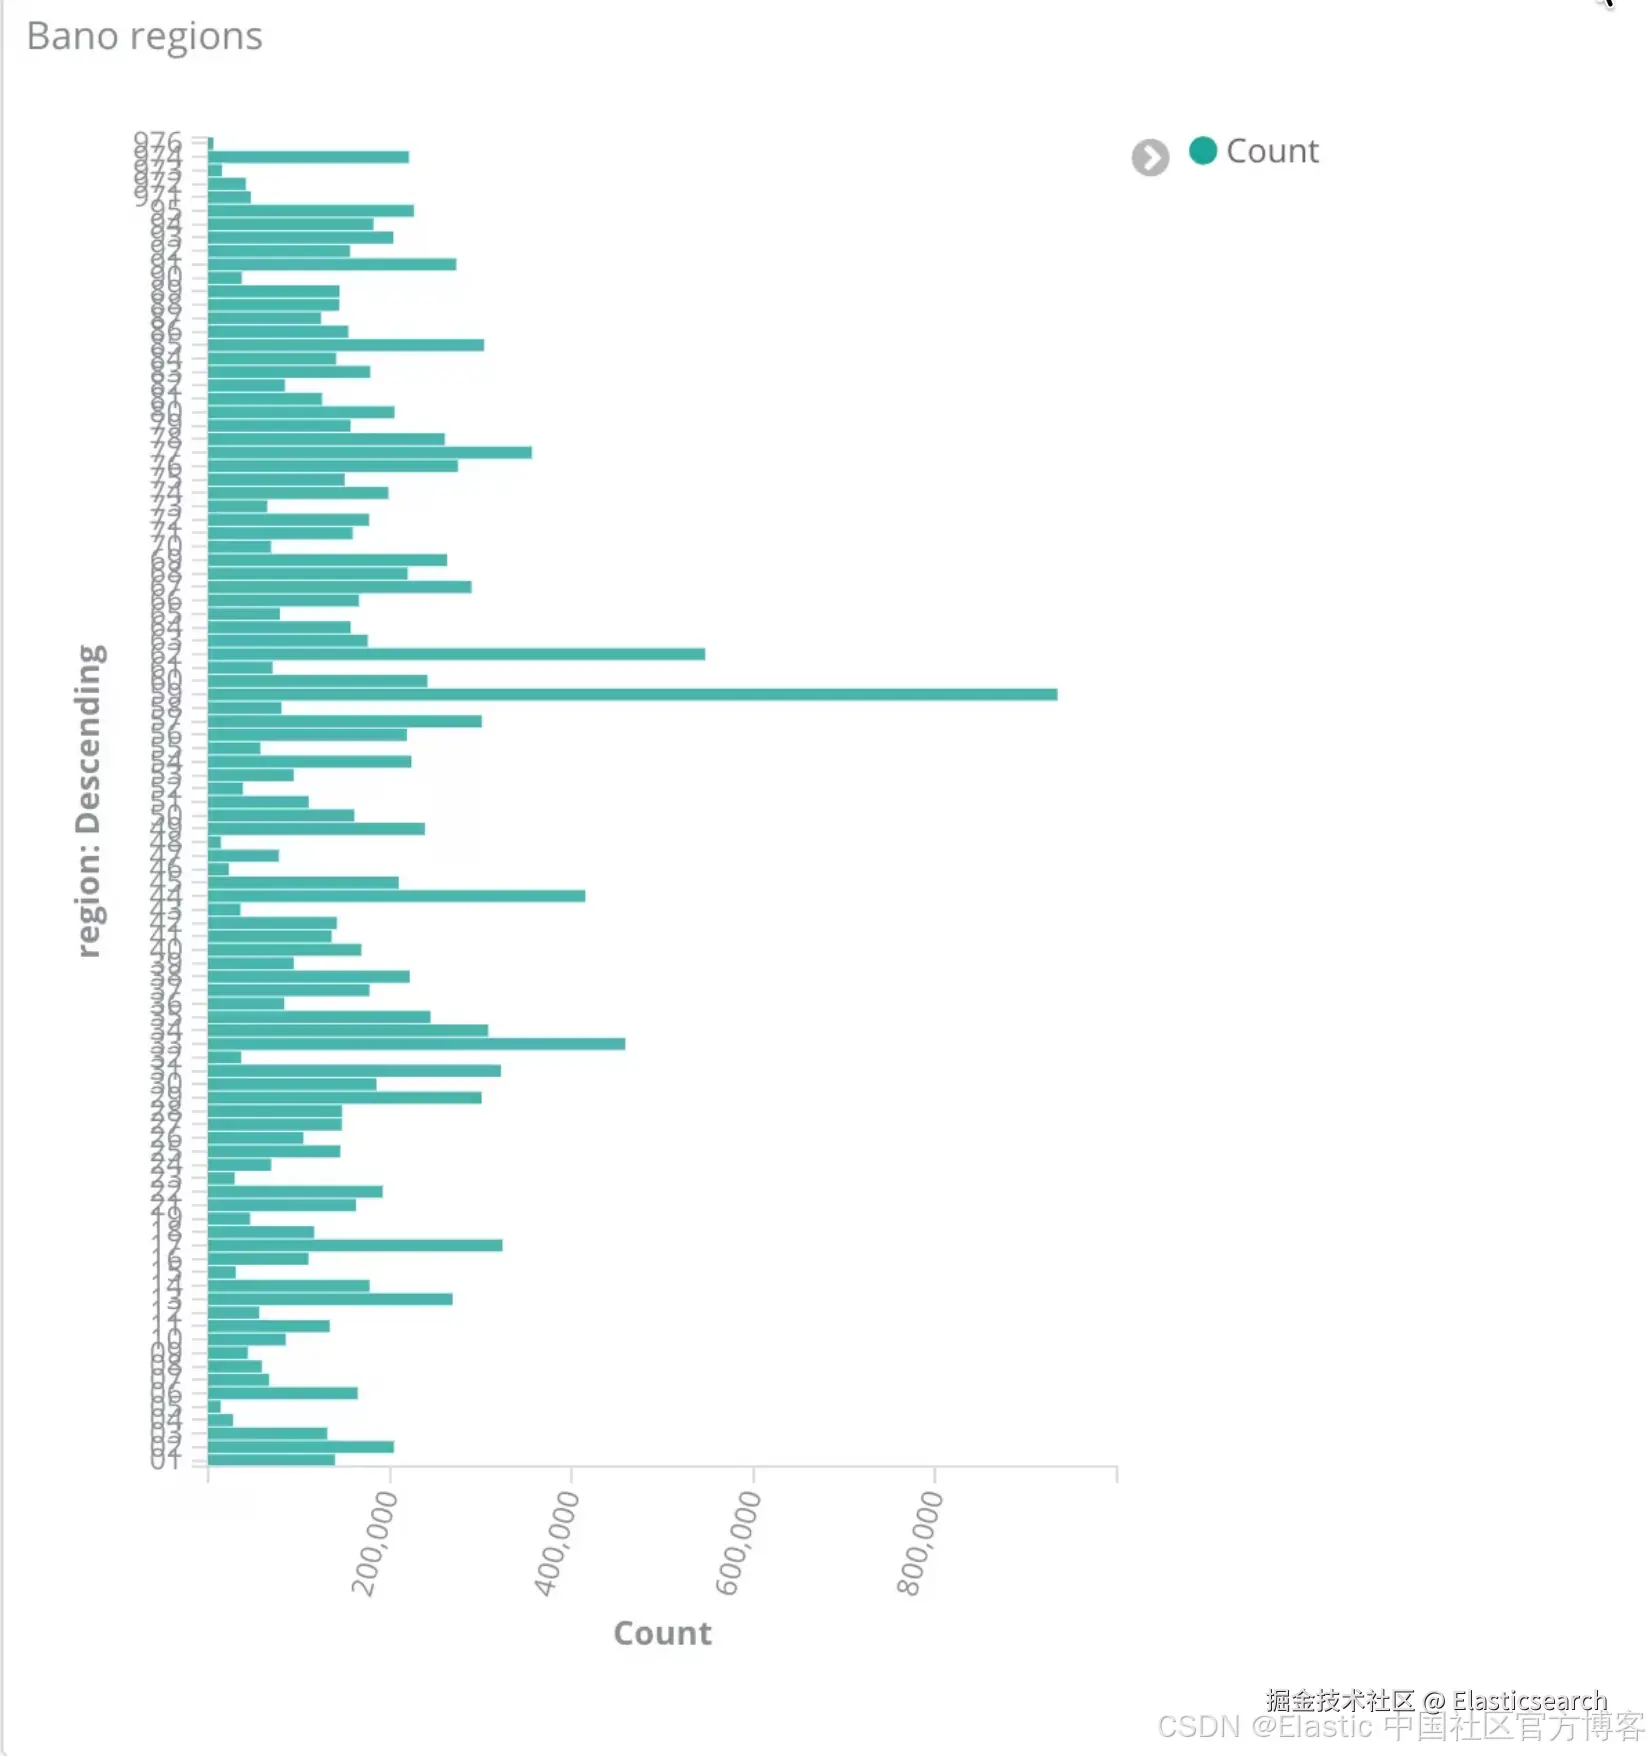
BANO 地址数据按省份编号的分布情况
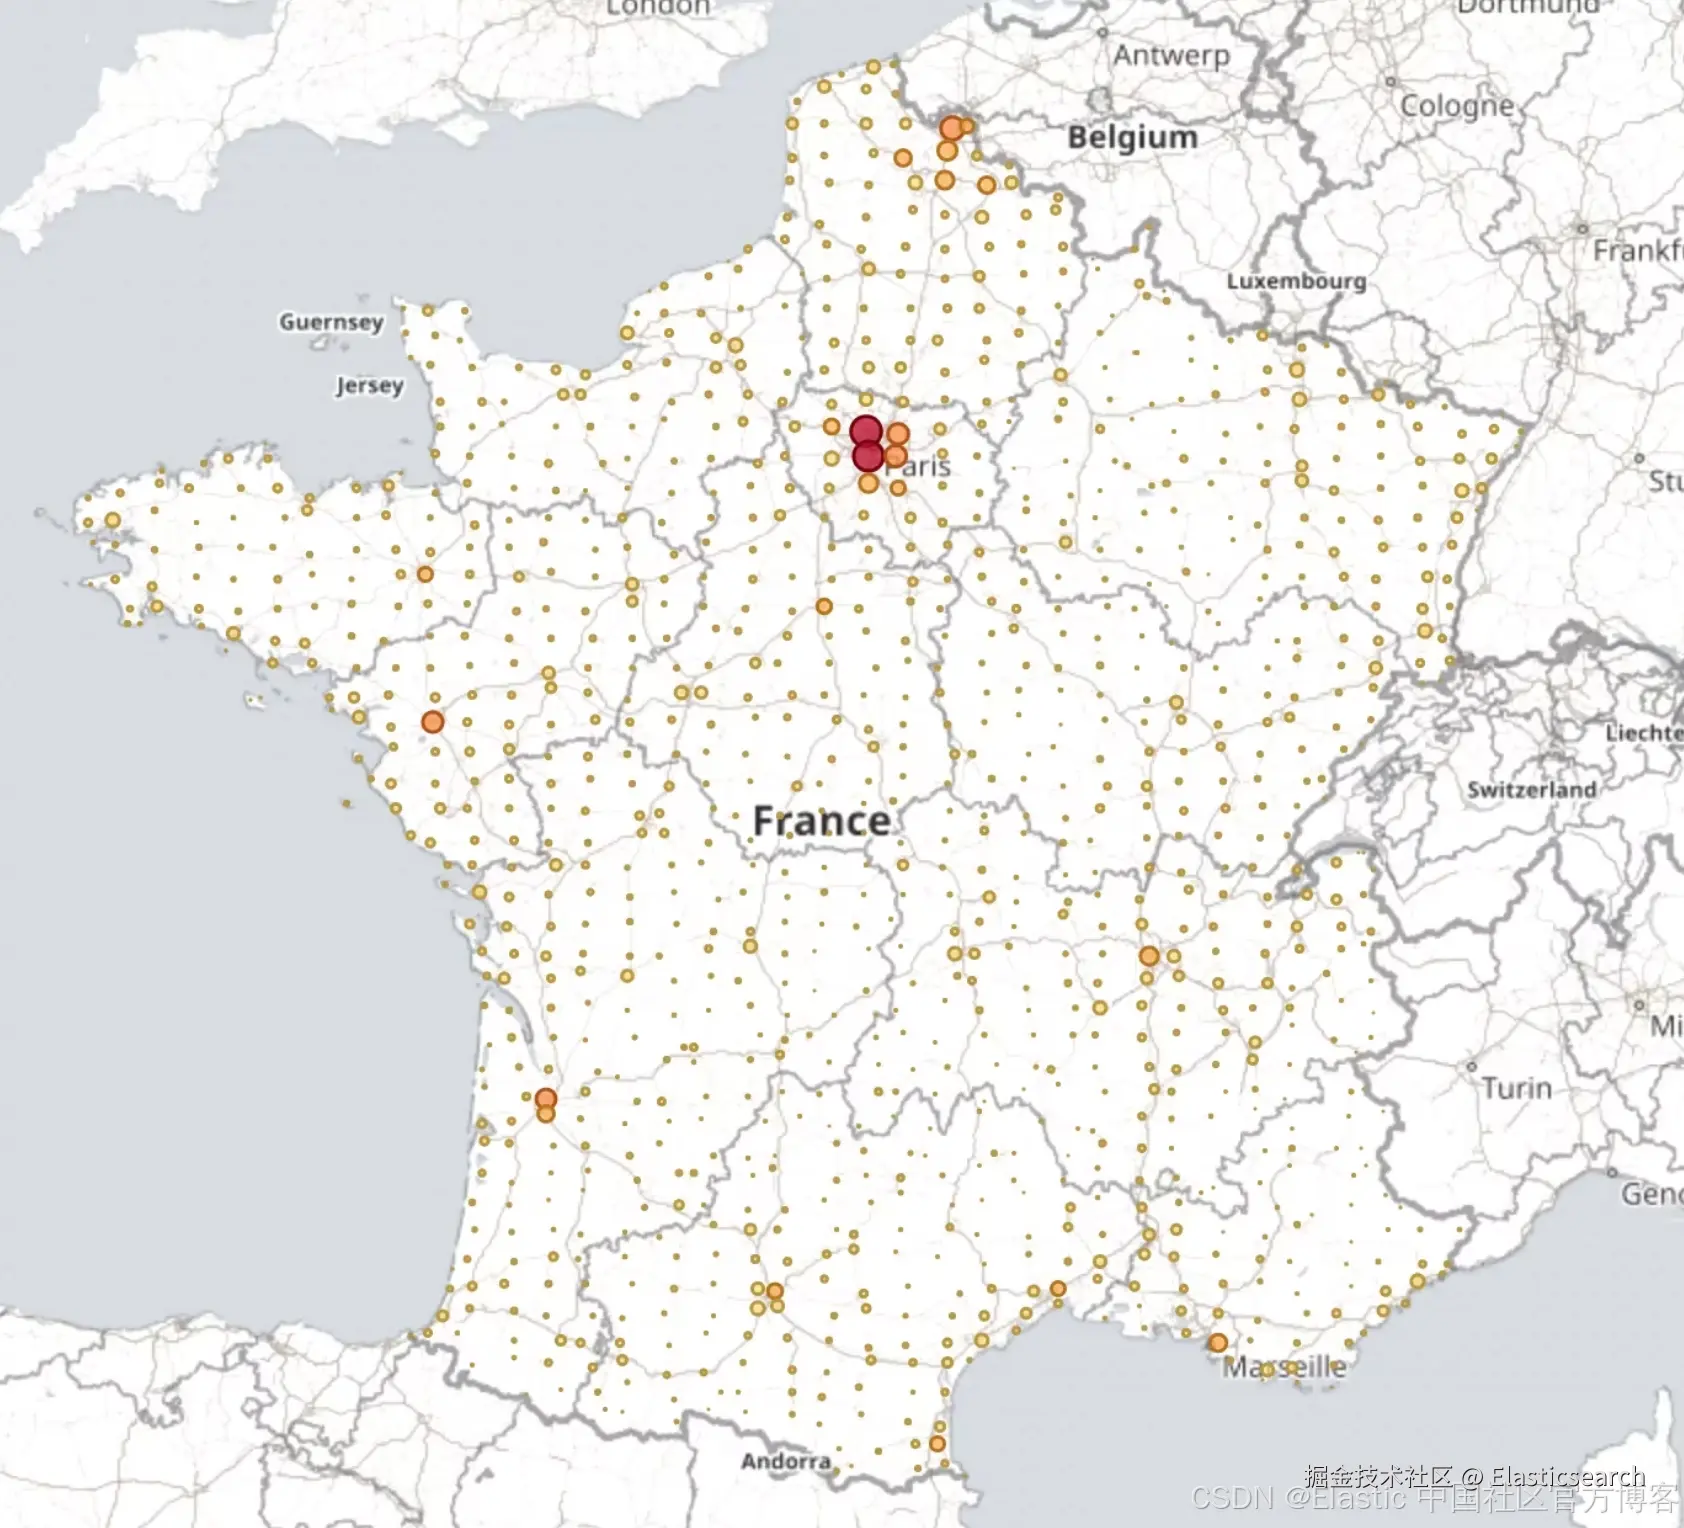
法国本土 BANO 地址分布地图
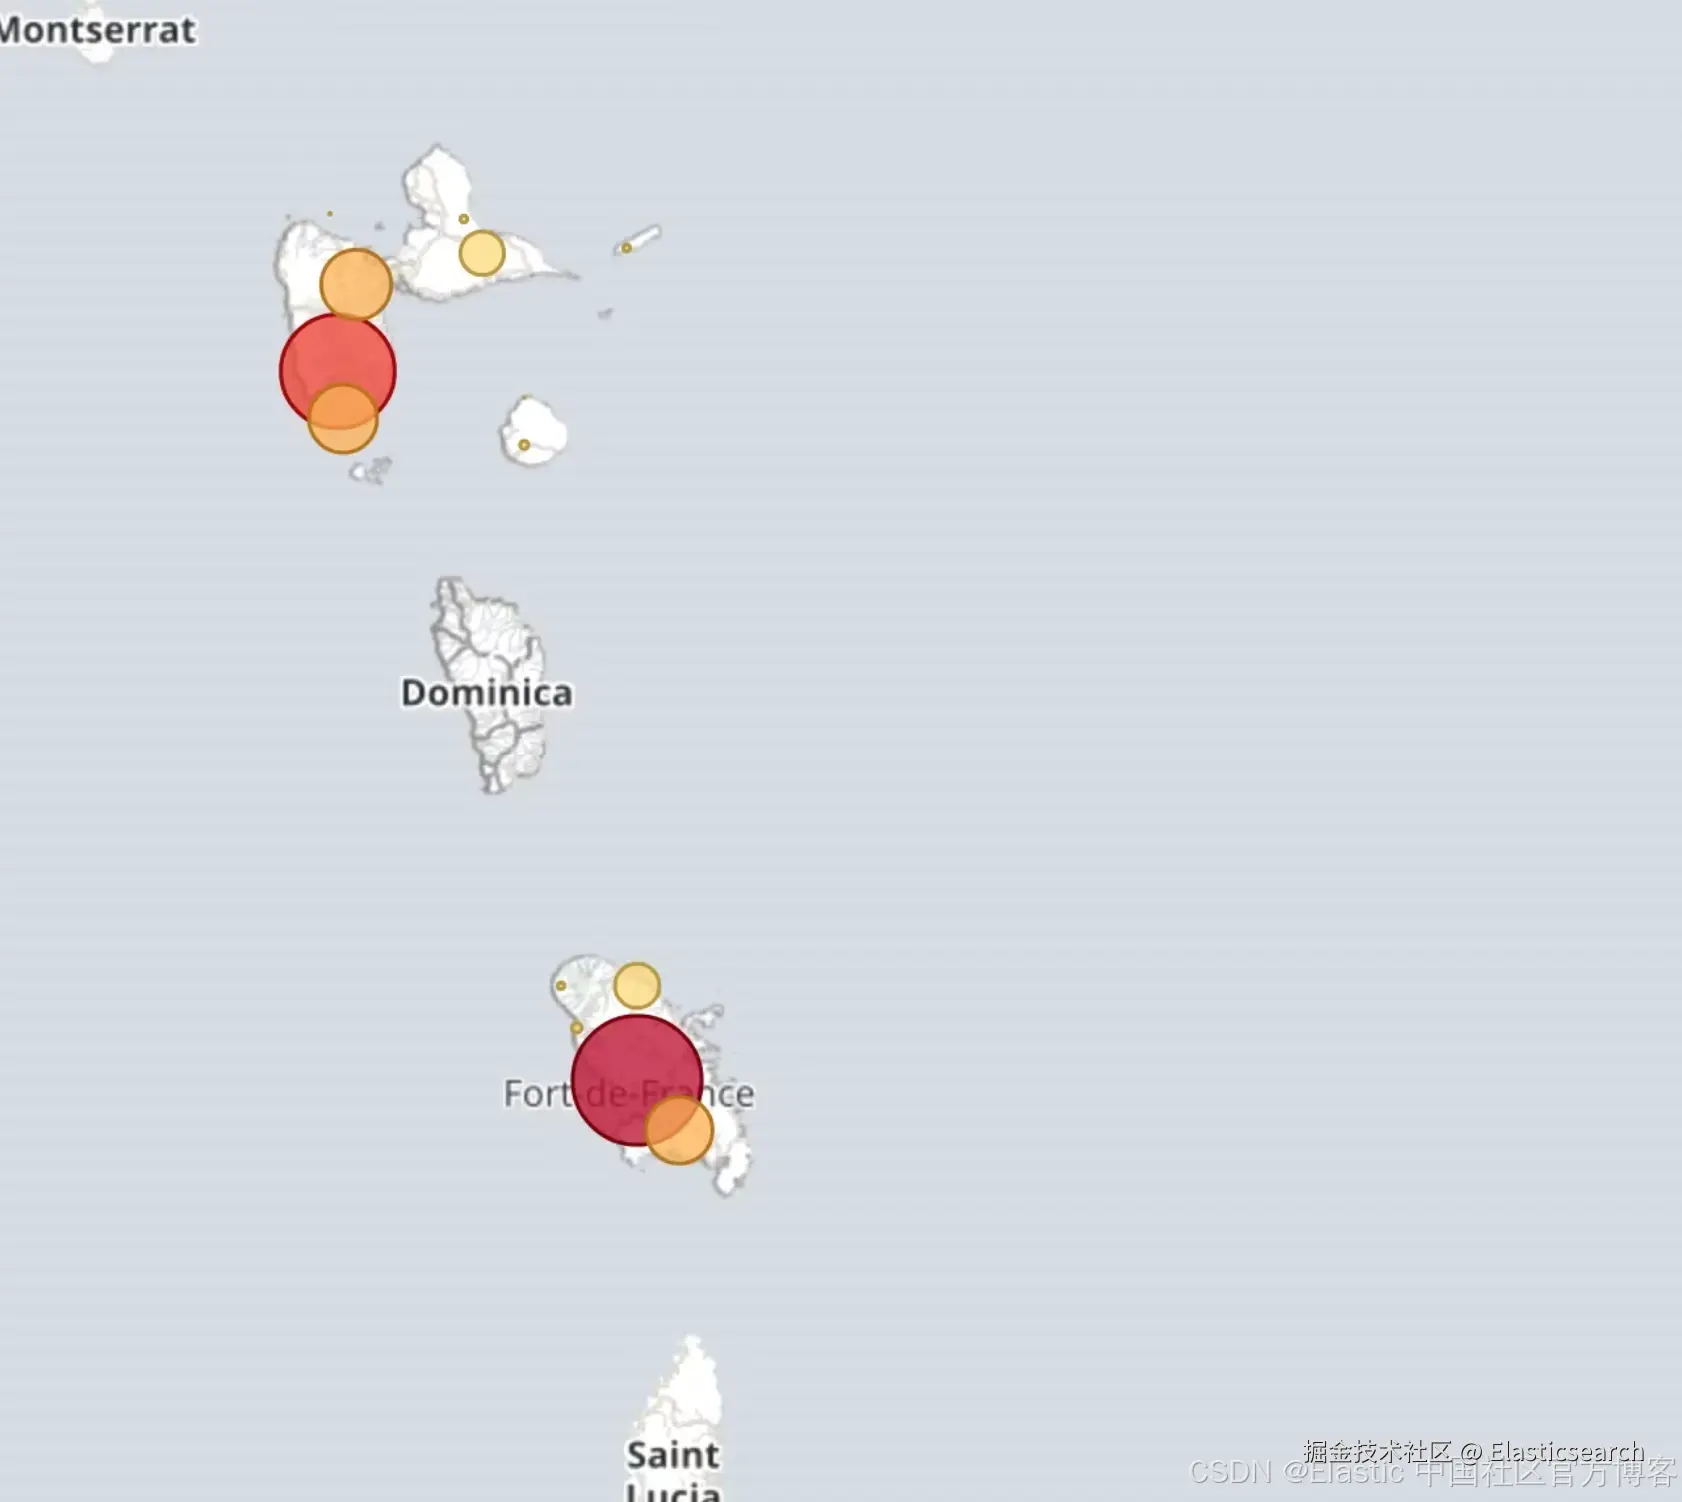
法国部分海外省的 BANO 地址分布地图
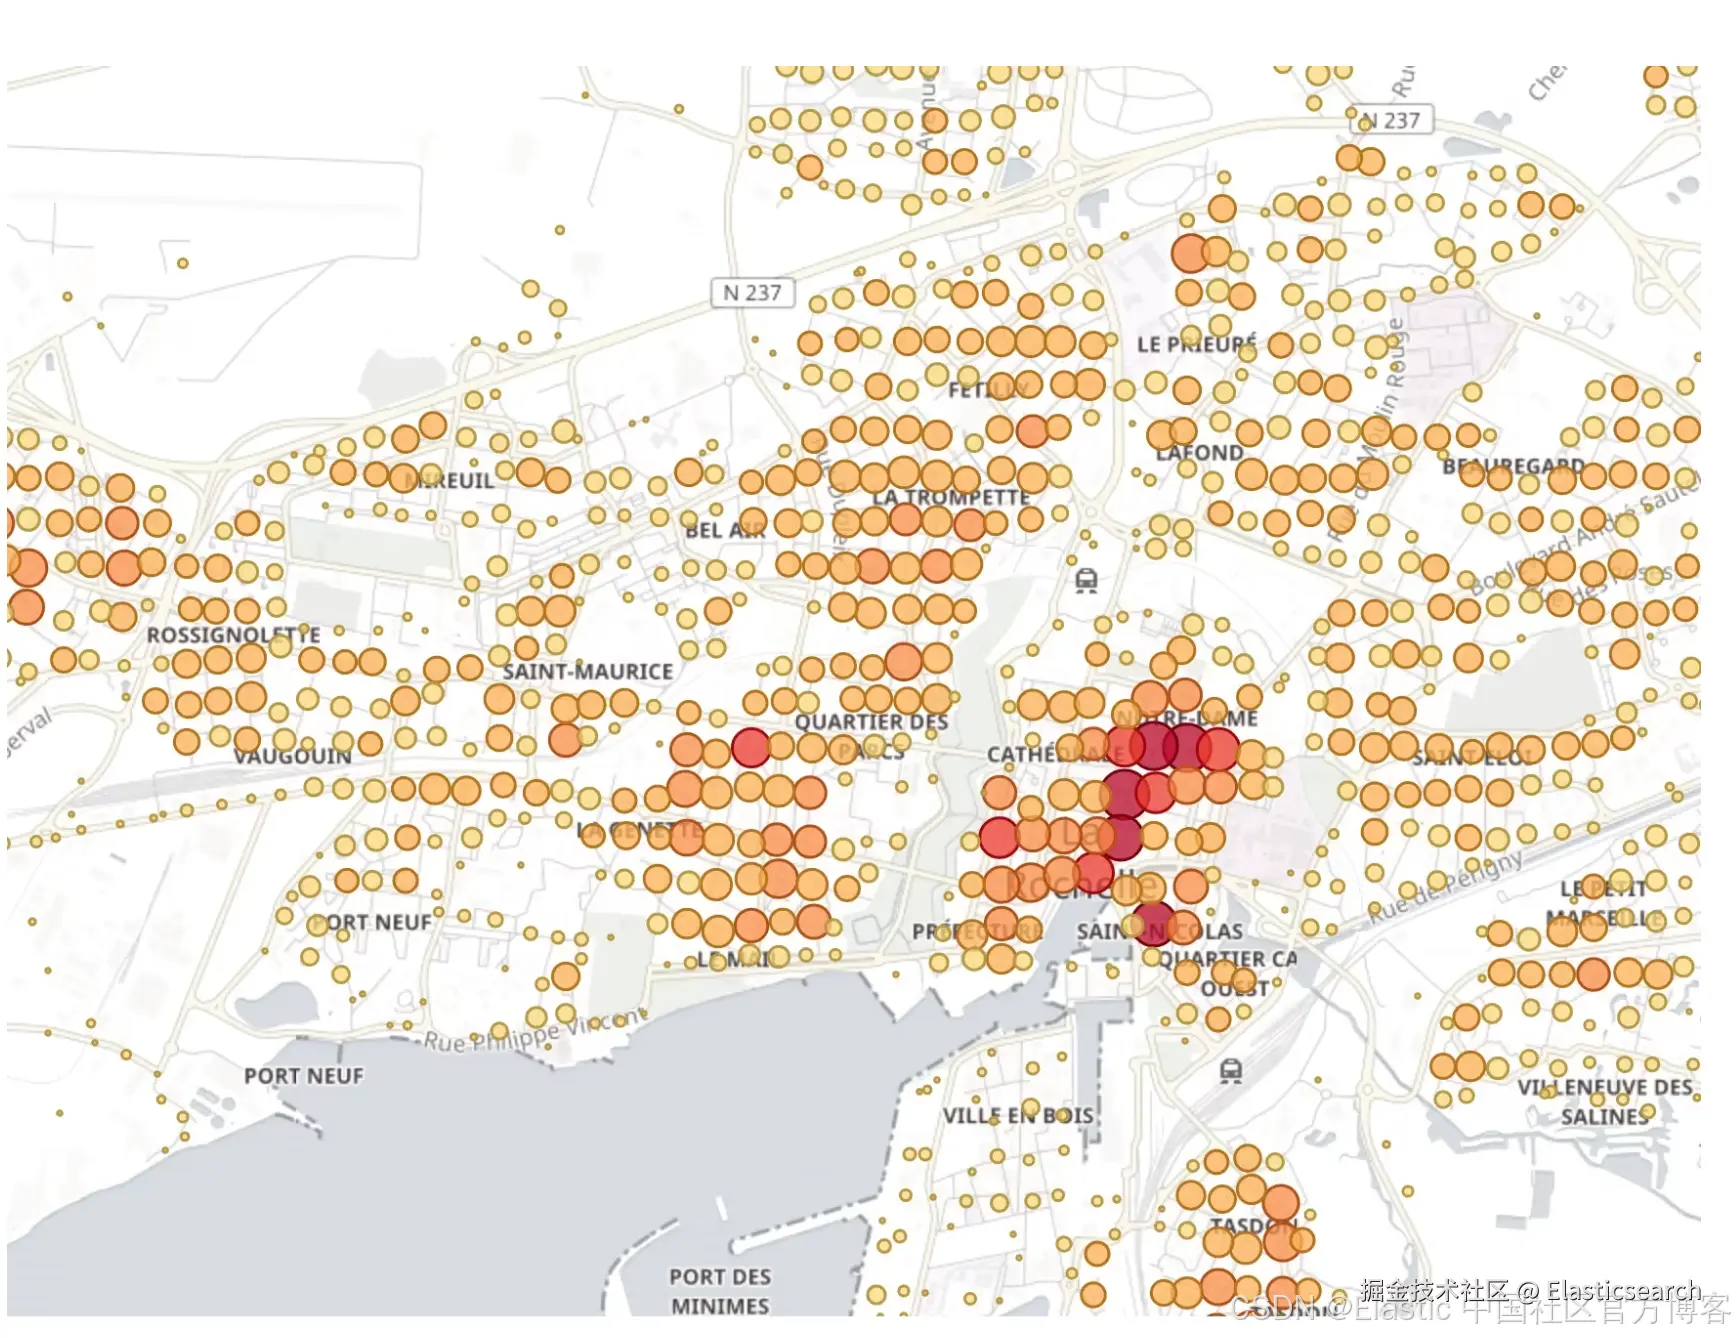
拉罗谢尔(La Rochelle)附近的 BANO 地址分布地图
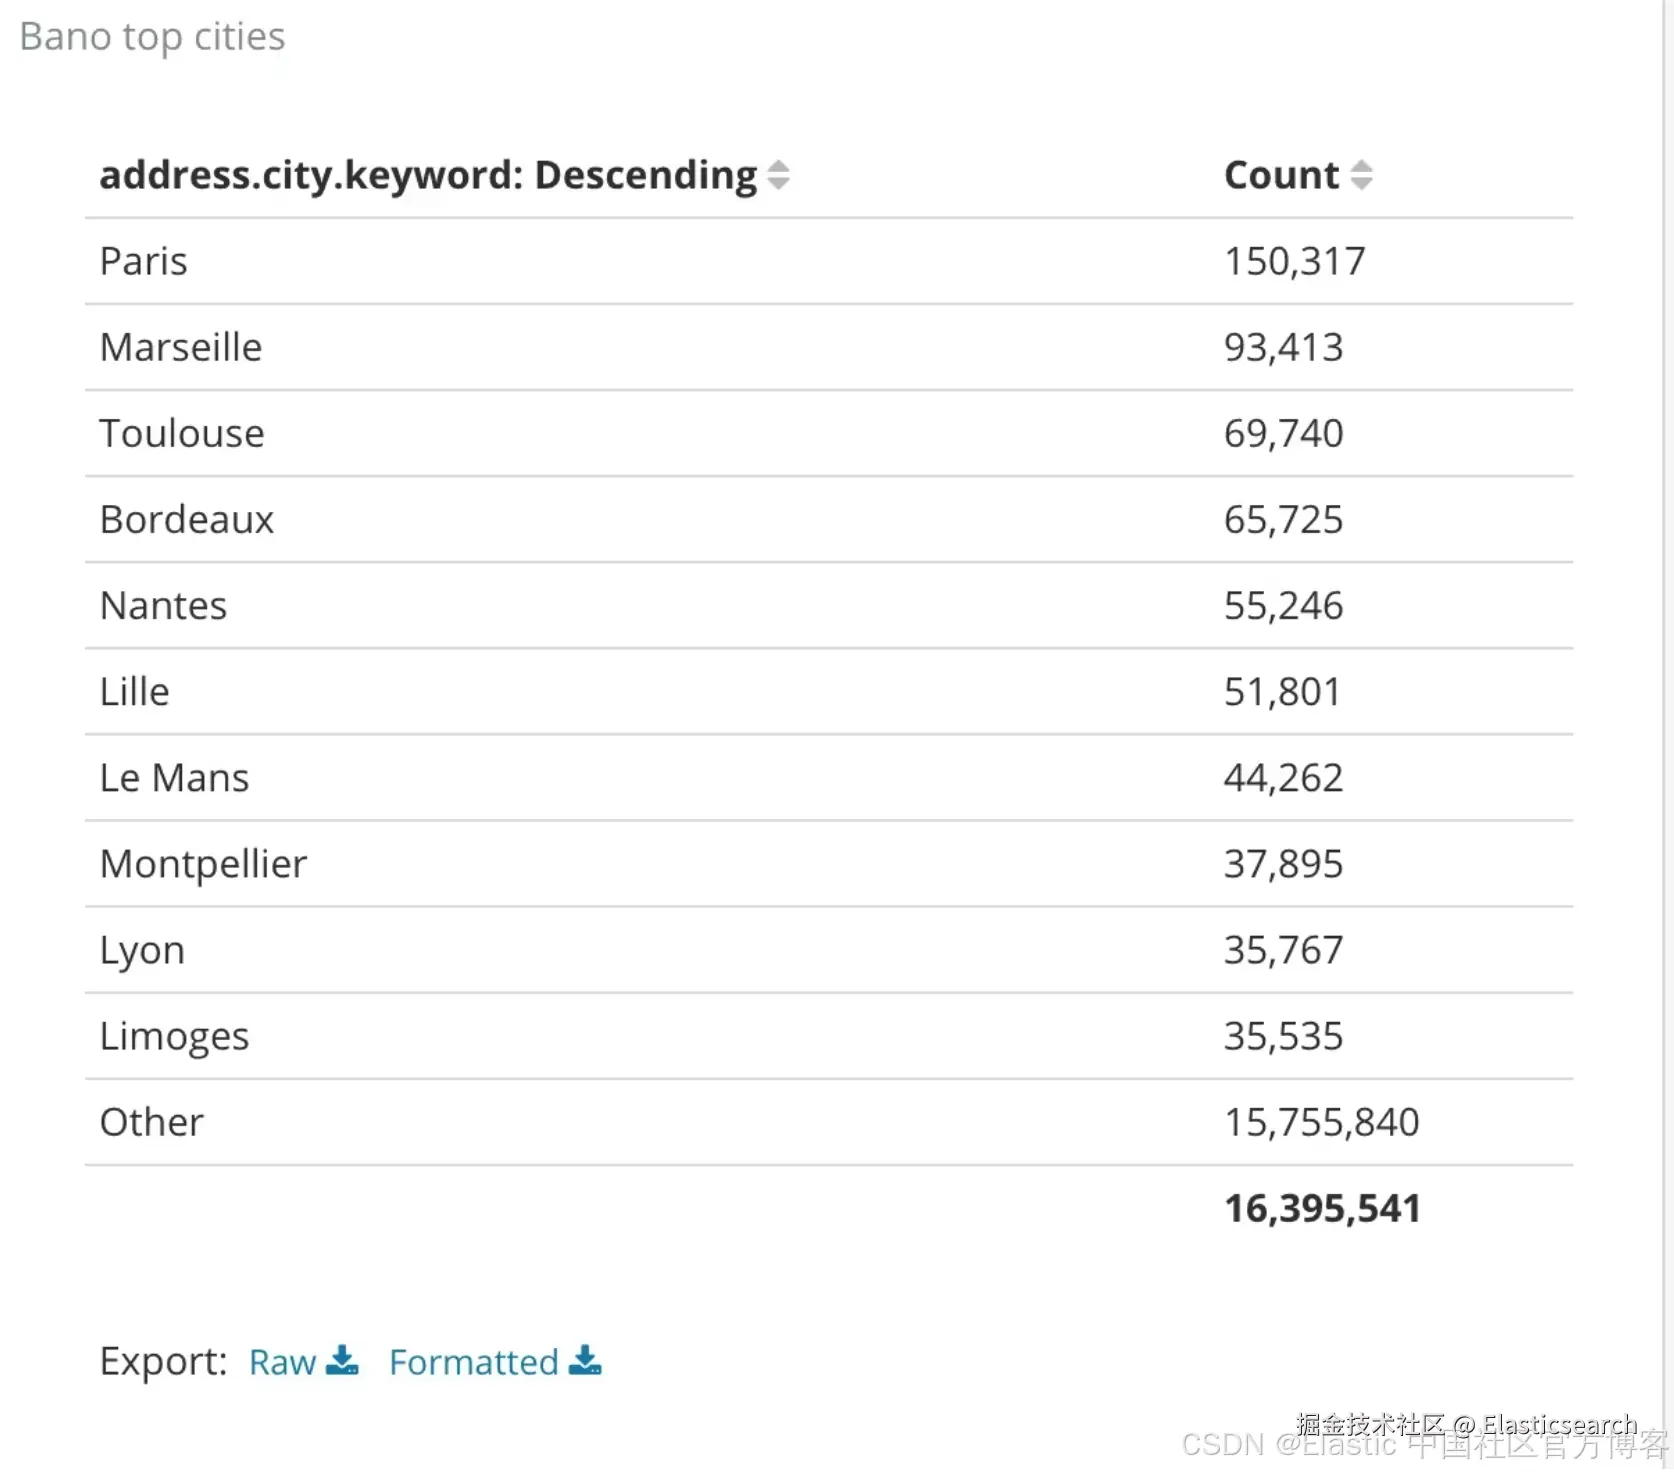
已知地址数量最多的城市排名
这份榜单并不令人意外。通常来说,法国人口规模较大的城市包括:
-
巴黎(Paris)
-
马赛(Marseille)
-
图卢兹(Toulouse)
-
波尔多(Bordeaux)
-
南特(Nantes)
下一步
请阅读下一篇文章,了解如何利用我们已经导入的 BANO 数据集,实现地址纠错和地址转换。
原文:Enriching your postal addresses with Elastic stack - part 1 | David Pilato