很多团队已经在用 RustFS 这类 S3 兼容对象存储,但业务侧一堆老程序只认 POSIX 文件接口,改造成本高。JuiceFS 干的事很直接:在你的对象存储外面套一层 POSIX 文件系统,应用不用碰 S3 SDK,直接 open/read/write 就能落进对象存储。这篇用 RustFS 当后端,把从建桶、起元数据引擎、格式化、挂载到跑基准的完整链路走一遍,重点把元数据引擎这层的取舍讲清楚,因为这是 JuiceFS 能不能上生产的分水岭。全文以社区版(JuiceFS Community)为对象,回收站、GC、Prometheus 指标这些社区版都有,涉及能力边界的地方会单独标明。基准部分会把 juicefs bench 的真实跑法和输出格式讲透,但吞吐数字必须在你自己的 RustFS 上跑,不存在照搬参考值。
数据面和元数据面,是两套东西
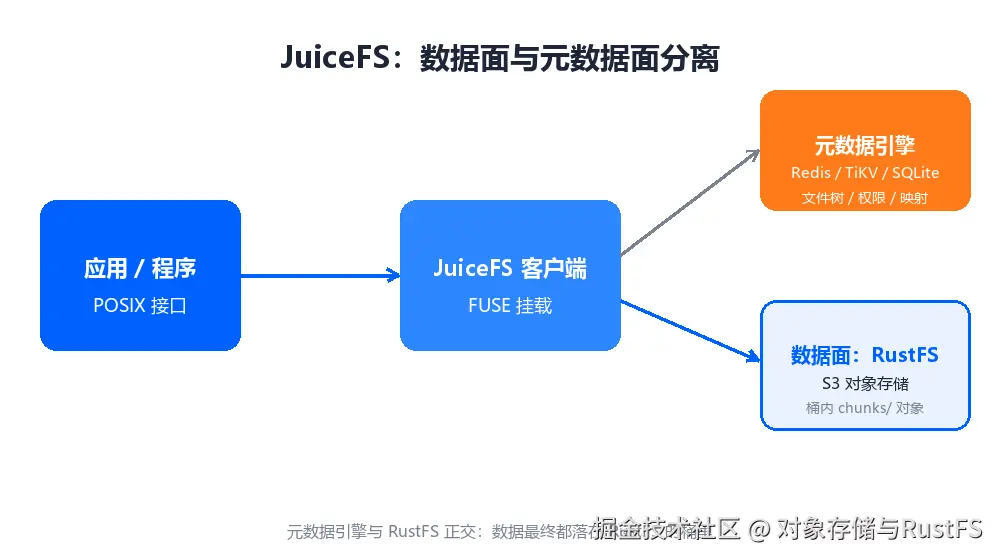
JuiceFS 的核心设计是数据和元数据分离。数据面是你已有的对象存储,RustFS 走 S3 接口接进来;元数据面是一套独立的数据库,记文件名、目录树、权限、chunk 映射这些。两者各管各的,RustFS 完全不知道自己上面还挂了个文件系统。
文件写进去之后会被拆成几层:一个文件先切成 Chunk(上限 64 MiB),Chunk 再切成 Slice,Slice 最后切成 Block(默认上限 4 MiB)。真正落进 RustFS 桶里的是这些 Block,原文件被打散后落在桶内 chunks/ 目录下的一堆对象中。原文件和 Block 的对应关系全在元数据引擎里。
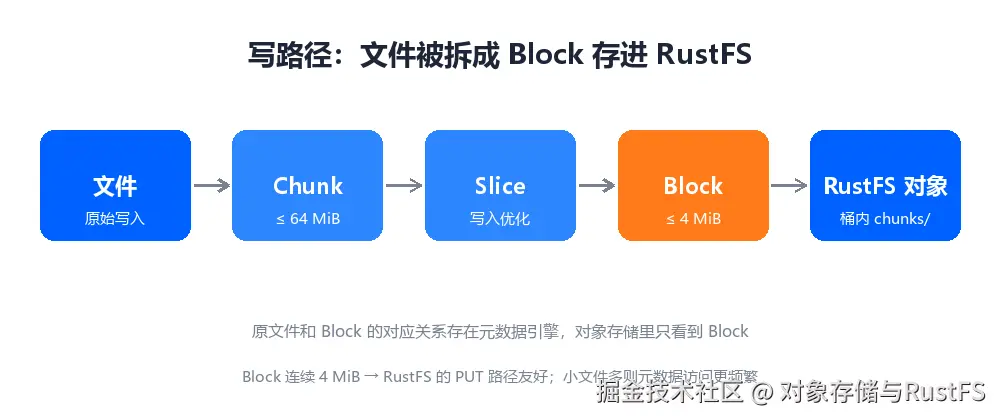
这套拆法解释了 JuiceFS 的两个行为:大文件顺序写时,Block 是连续 4 MiB 对象,RustFS 的 PUT 路径很友好;小文件多时,元数据引擎的访问频率远高于对象存储,所以元数据引擎的延迟基本决定了 ls、建文件这类操作的体感。
在 RustFS 上准备数据面
假设 RustFS 已经起在 :9000,S3 接口通了。JuiceFS 只认桶和访问密钥,不关心底下是谁,所以这一步和接 MinIO 没区别。先建个专用桶和一把密钥,别拿管理员 AK 直接给 JuiceFS 用。
用 mc(MinIO 客户端,对 RustFS 的 S3 接口兼容)建桶和密钥:
sql
mc alias set rustfs http://<rustfs-host>:9000 <admin-ak> <admin-sk> --api S3v4

mc mb rustfs/jfs-data

mc admin user add rustfs jfsUser '换成强密码'

mc admin policy attach rustfs <你的读写策略> --user jfsUser
不想碰命令行,RustFS 的 Web 控制台里「创建访问密钥」也能生成,默认继承当前账号权限。关键是 JuiceFS 拿到的 AK/SK 只有这个桶的读写权,权限收紧到桶级别,别给全局管理员。防误删方面,给桶开版本化(versioning)可以兜住客户端 bug 或误操作删掉的 chunks 对象,代价是旧版本对象会占双份空间,要配生命周期规则定期清;对象锁/WORM 这类禁删策略别开,JuiceFS 的回收站过期和 GC 都要发 DELETE,删不掉对象只会造成空间泄漏。还要注意版本化的保护范围:它只兜底层 chunks 对象,元数据引擎里的数据它管不着,Redis 被误 FLUSH 或损坏,版本化救不了(后面备份一节细说)。
RustFS 走**路径风格(path-style)**寻址,桶名写在路径里(http://host:9000/jfs-data),不是虚拟主机式(https://jfs-data.host/)。这一步后面配 JuiceFS 时要对应上,否则会报 NoSuchBucket。
元数据引擎怎么选,决定你能跑多大
这是整篇的重点。元数据引擎和 RustFS 正交:无论你选哪个,数据最终都落在 RustFS 的桶里,RustFS 只管对象的 PUT/GET/DELETE/List/Multipart。所以选型只看元数据引擎自身的运维代价,不影响 RustFS 侧。JuiceFS 支持的引擎和取舍如下:
| 引擎 | 适合规模 | 优势 | 主要代价 |
|---|---|---|---|
SQLite(sqlite3://) |
单机验证、嵌入 | 零依赖,一条命令起 | 元数据在本地文件,多节点并发挂载无法保证一致 |
| Redis | 中小规模、追元数据性能 | 内存级延迟,部署简单 | 内存随文件数增长,单实例是卷的 SPOF,要副本+哨兵 |
| MySQL / PostgreSQL | 中等规模,复用已有 DB | 持久化可靠,生态成熟 | 高 QPS 下优化成本不低 |
| TiKV | 大规模生产(亿级文件) | 分布式 Raft 强一致,容量按需扩 | 组件多,运维重 |
几个硬数字,来自 JuiceFS 官方文档:键值类引擎(Redis、TiKV)每个文件约占 300 字节 内存,关系型(SQLite、MySQL、PostgreSQL)约 600 字节。按这个算,1 亿个文件,Redis 大约要吃 30 GiB 内存。规划容量时这个数一定要提前算,小文件一多,Redis 内存涨得比很多人预期快。
拿这些口径可以做个端到端的粗算。假设 1 亿个小文件、业务原始数据 100 TiB:元数据引擎按上面口径要预留 30 GiB(KV 类)到 60 GiB(关系型);对象数不会少于文件数(小文件至少占一个 Block 对象),RustFS 侧要按上亿对象去评估元数据开销和 List 性能;开了版本化,底层对象占用接近翻倍;回收站默认留 1 天,删除量大的业务还要再叠加一天的删除数据量。这套加完,实际占用比「原始数据 100 TiB」多出多少,动手前就能算清,别等桶满了才发现。
Redis 还有一些容易忽略的约束。JuiceFS 会要求 maxmemory-policy noeviction,否则内存写满后连 juicefs rmr 删文件都写不进 Redis,会卡死;官方建议单机 Redis 别超过 64 GiB,因为 Redis 是单线程模型,内存越大故障恢复越慢,具体卡在两处:RDB 快照要 fork 进程,内存越大写时复制的开销越大,快照期间延迟毛刺明显;真到故障重启,全量加载 RDB/AOF 的时间也随内存线性涨,期间整个卷不可用。开了 AOF 还要记得配重写(auto-aof-rewrite),JuiceFS 元数据写入频繁,AOF 只涨不重写的话恢复时间会越来越长。哨兵方案能自动切主,但切换那几秒挂载端会出现 IO 报错或卡顿,应用侧要能容忍重试。一个卷的所有元数据键都落在同一个 Redis 实例上(即便用 Redis Cluster,也靠 hash tag 把同一卷路由到同一槽),所以 Cluster 解决的是多卷共享,不解决单卷的容量上限。
落到 RustFS 场景:如果你只是把几个分析任务的结果挂出来读,SQLite 起个 PoC 最快;要上生产、有多个客户端同时挂,Redis 是默认稳妥选择,记得开 AOF + 副本 + 哨兵;文件量奔着亿级去,直接上 TiKV,别拿 Redis 硬扛。
元数据引擎选错了还能迁。JuiceFS 提供 juicefs dump 把元数据导出成 JSON,juicefs load 再灌进新引擎。例如:
bash
juicefs dump redis://localhost/1 /tmp/jfs-backup.json
juicefs load sqlite3:///tmp/jfs-new.db /tmp/jfs-backup.json
迁的时候数据面不用动,RustFS 桶里的 Block 还在。但要对这套迁移的边界有预期:dump/load 是离线方案,全量导出再全量导入,按前面 600 字节/文件的口径,亿级文件的 JSON 本身就是几十 GB,停写窗口要按小时预留;juicefs fsck 校验的是元数据和桶里对象的对应关系,应用层的语义一致性(打开中的文件句柄、锁状态这些)它兜不住;另外社区版没有在线迁移能力,大卷迁移动手前先把停写窗口报给业务方。
迁移之外,dump 还应该当定期备份用,这件事容易被漏掉。数据面这块 RustFS 已经替你扛了(多副本/纠删码保证对象不丢),但元数据引擎的安全是另一回事:Redis 的 RDB/AOF 是引擎自身的持久化,解决的是「进程重启数据还在」,兜不住误操作(比如误 FLUSH)、JuiceFS 自身逻辑 bug 写坏的元数据和引擎级损坏;而且这套架构里元数据一旦没了,RustFS 桶里的 Block 再完好也只是散落的块,拼不回任何文件。所以定期跑一次 juicefs dump 导出 JSON(放在对象存储或另一台机器上),生产环境按天到按周视文件变更频率定;用 TiKV 的,按其官方 br 工具做例行备份,同样的道理。数据面安全不等于文件安全,元数据的备份要单独排期,备份任务本身也要配告警,dump 脚本静默失败比不备份更迷惑人。
格式化加挂载,一条链跑通
以 Redis 当元数据引擎、RustFS 当数据面,格式化一条命令:
arduino
export ACCESS_KEY=jfsUser
export SECRET_KEY='你的 jfsUser 密码'

juicefs format \
  --storage s3 \
  --bucket http://<rustfs-host>:9000/jfs-data \
  --block-size 4M \
  --capacity 1024 \
  redis://127.0.0.1:6379/1 \
  rustfs-jfs
--storage s3 选 S3 后端,--bucket 用 path-style 指到 RustFS 的桶,--block-size 4M 是默认值(和大多数对象存储内部块大小对齐,不用改),--capacity 给卷设个配额(GiB),最后 redis://.../1 是元数据引擎地址,rustfs-jfs 是卷名(也会作为桶里对象的前缀)。生产环境 Redis 带密码就写成 redis://:密码@host:6379/1。
挂载到本地目录,缓存放到本地 SSD:
arduino
juicefs mount redis://127.0.0.1:6379/1 /mnt/jfs \
  --background \
  --cache-dir /data/jfs-cache
--cache-dir 很关键。JuiceFS 读数据时会把 Block 缓到本地盘,命中缓存后读取延迟从几十毫秒掉到微秒级。缓存盘用 NVMe 这类本地 SSD,别挂网络盘,否则缓存回源反而拖慢。挂上之后 df -h /mnt/jfs 能看到,直接 cp/mkdir 都能用,背后就是 RustFS 的桶。
除了 --cache-dir,这几个旗标和 RustFS 配合时要特别留意:
--max-uploads/--max-downloads:限制同时上传到 RustFS 的 PUT 和 GET 连接数。RustFS 虽是高性能后端,但 JuiceFS 客户端一台机器默认并发写很高,可能把单条网络链路打满,也容易在 RustFS 前面触发连接数或 QPS 限制。先压一轮再调,别上来就默认值猛跑。--buffer-size:客户端写缓冲,默认 300 MiB。顺序写大文件时大一点能减少对象存储往返,但内存占用会涨;小文件场景反而没必要。--free-space-ratio:本地缓存盘剩余空间比例,默认 10%。缓存盘如果和系统盘共用,建议设到 20% 以上,避免缓存把系统盘打满。--writeback:异步写回本地缓存再批量上传。默认是关的;开了之后写入延迟会很好看,但掉电或客户端崩溃时可能丢数据。对 RustFS 这种强一致后端来说,没必要开 writeback,关掉更安全。--upload-limit/--download-limit:限制总上传/下载带宽,和 RustFS 隔着公网或专线时特别有用,避免把别的业务挤掉。
这些参数都可以在挂载时直接加,也可以用 juicefs config 后调整。调参前先跑一轮 juicefs bench,有基准再改。
用 juicefs bench 看数字,但别拿别人的数当你的
挂载好就能跑官方自带的基准:
bash
juicefs bench /mnt/jfs它会写大文件、写小文件、读、Stat,最后打印一张表。下面这张是 JuiceFS 官方文档给的示例输出(其参考环境,只用来认表头,不是 RustFS 上的数):
bash
+------------------+-----------------+--------------+
| ITEM             | VALUE           | COST         |
+------------------+-----------------+--------------+
| Write big file   | 1236.96 MiB/s   | 0.83 s/file  |
| Read big file    | 2962.88 MiB/s   | 0.35 s/file  |
| Write small file | 2277.4 files/s  | 0.44 ms/file |
| Read small file  | 2753.0 files/s  | 0.36 ms/file |
| Stat file        | 16603.3 files/s | 0.06 ms/file |
+------------------+-----------------+--------------+
在你自己的 RustFS 上跑出来的数,取决于四件事:网络带宽(JuiceFS 和 RustFS 之间的链路)、RustFS 磁盘介质(NVMe 还是 HDD,直接决定对象 PUT 延迟)、本地缓存命中率(第一次读一定回源,热数据才快)、元数据引擎延迟(小文件建/删/Stat 基本卡在这)。所以这张表只能当格式说明书,真实性能请你在自己的 RustFS 上跑一遍 juicefs bench 再下结论,别直接引用别人的参考值。
想横向比元数据引擎,就把同一个卷用 SQLite 再 format 一份(juicefs format sqlite3:///tmp/jfs-sqlite.db rustfs-jfs-sqlite),挂上跑同样的 bench,小文件类的 ops 差异会非常明显------这正好印证前面那张取舍表。
四个最容易踩的坑
寻址风格写错。 RustFS 是 path-style,JuiceFS 的 --bucket 必须写成 http://host:9000/bucket。写成虚拟主机式 https://bucket.host/ 会直接报桶不存在。
Redis 没设 noeviction。 默认 allkeys-lru 这类策略会在内存满时淘汰键,JuiceFS 的元数据被清掉就乱套了。起 Redis 时加 --maxmemory-policy noeviction,或者挂之前 CONFIG SET maxmemory-policy noeviction。
把缓存盘挂成网络存储。缓存本意是消掉回源延迟,网络盘本身就有延迟,等于负优化。本地 SSD 是底线。
客户端进程崩了别硬等。FUSE 挂载依赖客户端进程活着,进程一崩挂载点就 hung 住,业务进程的读写会原地卡死,这时用 juicefs umount --force 强制卸载再重挂;极端情况下客户端进程卡在不可中断状态,--force 也卸不掉,最后手段是重启节点。容器里跑客户端要留意 FUSE 设备和权限配置,K8s 上用官方 CSI 驱动(mount pod 方式)管理挂载生命周期,别在业务容器里裸 mount;不过要清楚 CSI 只是帮你管挂载,底层走的还是 FUSE,这一层的约束并没有消失。
高并发小文件场景还有一个更底层的口子:FUSE 内核队列。内核对异步请求的限制 max_background 默认只有 12,拥塞阈值取它的 75%(9),在途异步请求一到阈值,内核就开始节流往这个文件系统发请求的进程,表现就是 IO 突然变慢、stall。并发上来后把它调大(挂载时通过 FUSE 选项传,或运行时写 /sys/fs/fuse/connections/<id>/max_background),容器里改这个需要特权。但它也不是越大越好,每条在途异步请求都占客户端内存,拉到几万内存先爆,合理值靠压测压出来,不靠拍脑袋。
一个正向的点:RustFS 提供强一致读(写后立即可读),JuiceFS 的 read-after-write 不会撞到最终一致的窗口,这点和某些最终一致的对象存储比,省掉一类诡异的「刚写完读不到」问题。
删了文件,RustFS 那边空间为什么没少
这是这套组合最常被问的一句。JuiceFS 删除文件走两段:先在元数据里把文件挪进回收站(trash,默认保留 1 天,--trash-days 可调),到期后再异步清理对应的 Block 对象。所以刚删完去 mc ls rustfs/jfs-data 看,chunks/ 里的对象多半还在,这是设计如此,等回收站过期。
怀疑空间泄漏(回收站也过期了、空间还没回落),跑一次 juicefs gc,它会扫出元数据里已无引用的孤儿对象并清掉。运维上还有一点:批量删除会对 RustFS 产生一波密集的 DELETE 请求;gc 自己也不轻,它要对桶做大量 List 来比对对象引用,对象数上亿时这个压力不小。两件事都别压在业务高峰。
有一条禁忌要单独说:别给 jfs-data 这个桶配生命周期自动删除规则。Block 的生死要完全交给 JuiceFS 的回收站和 GC 管,桶侧生命周期是按对象时间和前缀一刀切的,它分不清哪个 Block 还被元数据引用着,真跑起来会把活数据直接删掉,文件系统当场损坏。RustFS 侧对 jfs-data 唯一合理的生命周期配置是清理版本化带来的旧版本对象(前面防误删那处提过),其余一律不碰。
监控也是生产绕不开的一环。JuiceFS 挂载端自带 Prometheus 指标(--metrics 可改暴露地址),重点盯四类:元数据引擎的 QPS 和延迟(小文件操作的命脉)、FUSE 操作延迟(客户端体感的直接来源)、缓存命中率(掉下来就是回源打 RustFS)、GC/回收站的运行状态。再加上前面说的元数据备份任务告警,这套组合的观测面就齐了。
排障顺序和下一步
挂载或性能不对,按这个顺序查:
- 连通性:
mc ls rustfs/jfs-data能列出来,说明 RustFS 的 AK/SK 和桶没问题。 - 元数据引擎:
redis-cli ping返回PONG,说明 Redis 在。 - 挂载:
juicefs status /mnt/jfs能打印卷信息,说明格式和挂载正常。 - 性能:跑
juicefs bench /mnt/jfs,对照上面四件事逐项看瓶颈在哪。
上生产前先决定元数据引擎:文件量小、单节点,SQLite 够用;要并发挂载和高元数据性能,Redis + 副本 + 哨兵;亿级文件,TiKV。数据面交给我们这次用的 RustFS,它只管把 Block 稳妥存好,和元数据选型互不影响。
JuiceFS 加 RustFS 这个组合确实方便,但也不是万能。下面几类负载先别用这套方案硬上:
- 对延迟极度敏感的随机小读:第一次读必回源到 RustFS,再加上 FUSE 和元数据查询,P99 很难做到毫秒级;这类场景需要本地全量热数据,直接用本地盘或分布式文件系统更合适。
- 同一文件高并发随机写:JuiceFS 的 Slice 合并和元数据锁会让多个客户端同时改一个文件时互相阻塞,吞吐掉得厉害。
- 数据库这类写 redo/undo log:对象存储 PUT 的尾延迟会被数据库放大,同时 POSIX FUSE 路径比本地文件系统多一跳,别把它当本地 SSD 用。
这些情况属于 POSIX-over-S3 这条路的固有 trade-off,跟 RustFS 或 JuiceFS 哪家的实现都没关系。认清边界,比硬塞方案更重要。这条路走不通时也有参照:能改代码的,直连 RustFS 的 S3 SDK 少掉 FUSE 和元数据引擎两层;要原生 POSIX 又不想养元数据引擎的,SeaweedFS、CubeFS 这类自带文件语义的分布式文件系统是另一条路。
JuiceFS 的接入文档在 juicefs.com/docs/commun...(元数据引擎对照见 databases_for_metadata),源码在 github.com/juicefs/jui...。RustFS 的 S3 接入与部署见 docs.rustfs.com,仓库在 github.com/rustfs/rust...。